Una alerta de reconocimiento facial obtuvo 0.83: construí el filtro que la bloqueó

Una puntuación bruta de FaceFirst de 0.83 no pudo generar consentimiento para una alerta sintética de reconocimiento facial en Chicago, por lo que el filtro determinista de políticas la bloqueó. Desarrollé ese escenario para probar si un sistema biométrico trata la gobernanza como parte intrínseca de la decisión o como mero trámite documental añadido cuando la decisión ya se encuentra en marcha.
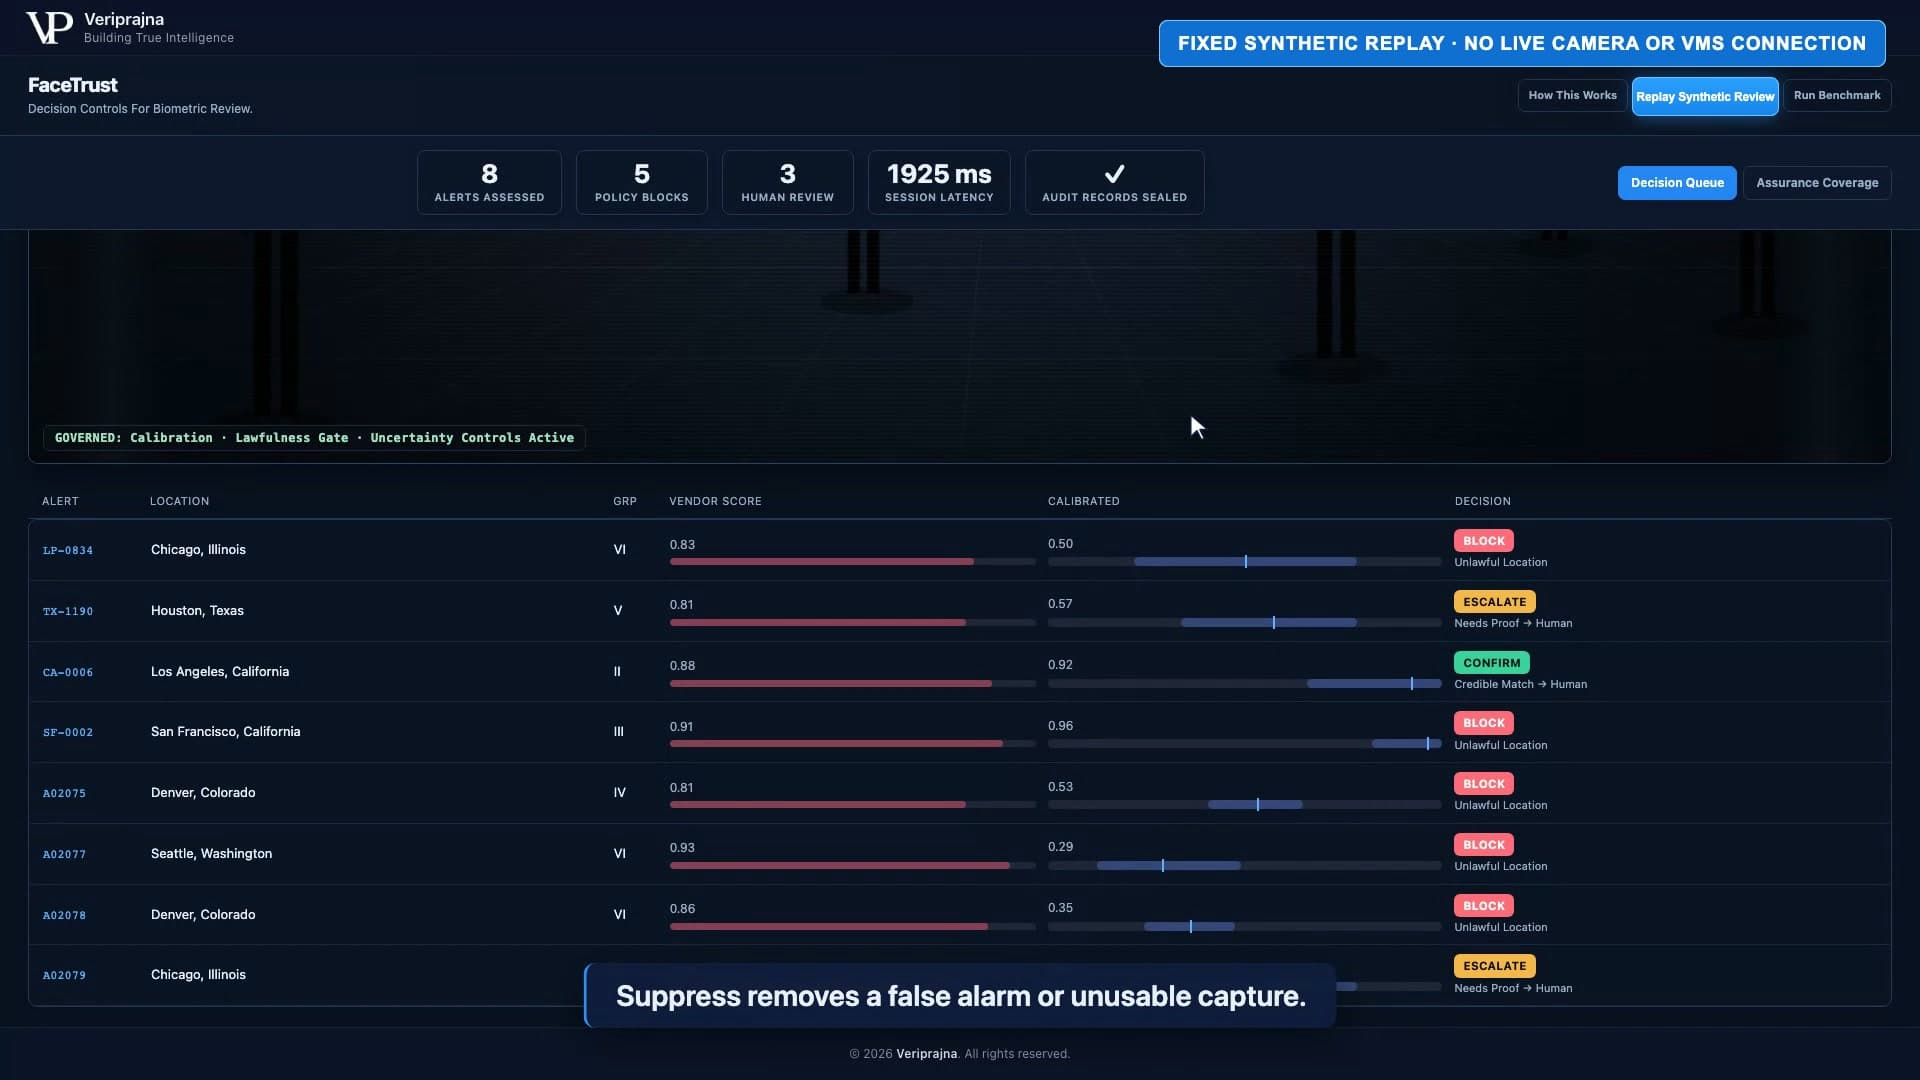
La alerta es LP-0834, un escenario sintético programado deliberadamente en Chicago. No es un evento de cliente, ni una transmisión en vivo, ni el caso de una persona real. La captura de prueba es una toma con baja iluminación de 80 píxeles comparada con una fotografía policial de hace 15 años. FaceTrust calibra la puntuación bruta a 0.50, con un intervalo de [0.217, 0.783] y un conjunto de predicción conforme al 93% que contiene tanto {mate, no_mate}. Pero el hecho determinante es más simple: no consta ningún consentimiento, por lo que el filtro determinista de políticas bloquea el análisis bajo la regla BIPA simulada en la demostración.
Vuelvo constantemente a ese orden de prioridades. Un modelo puede aportar indicios probatorios. No debe corresponderle decidir que un requisito legal ausente puede ignorarse simplemente porque su puntuación parezca convincente.
El desglose completo muestra la interfaz, el vídeo y el funcionamiento del mecanismo. Lo que sigue es la lección más rigurosa que extraje de su diseño: si un control solo puede justificar una mala acción a posteriori, llegó demasiado tarde.
Lo que creí que significaba 0.83
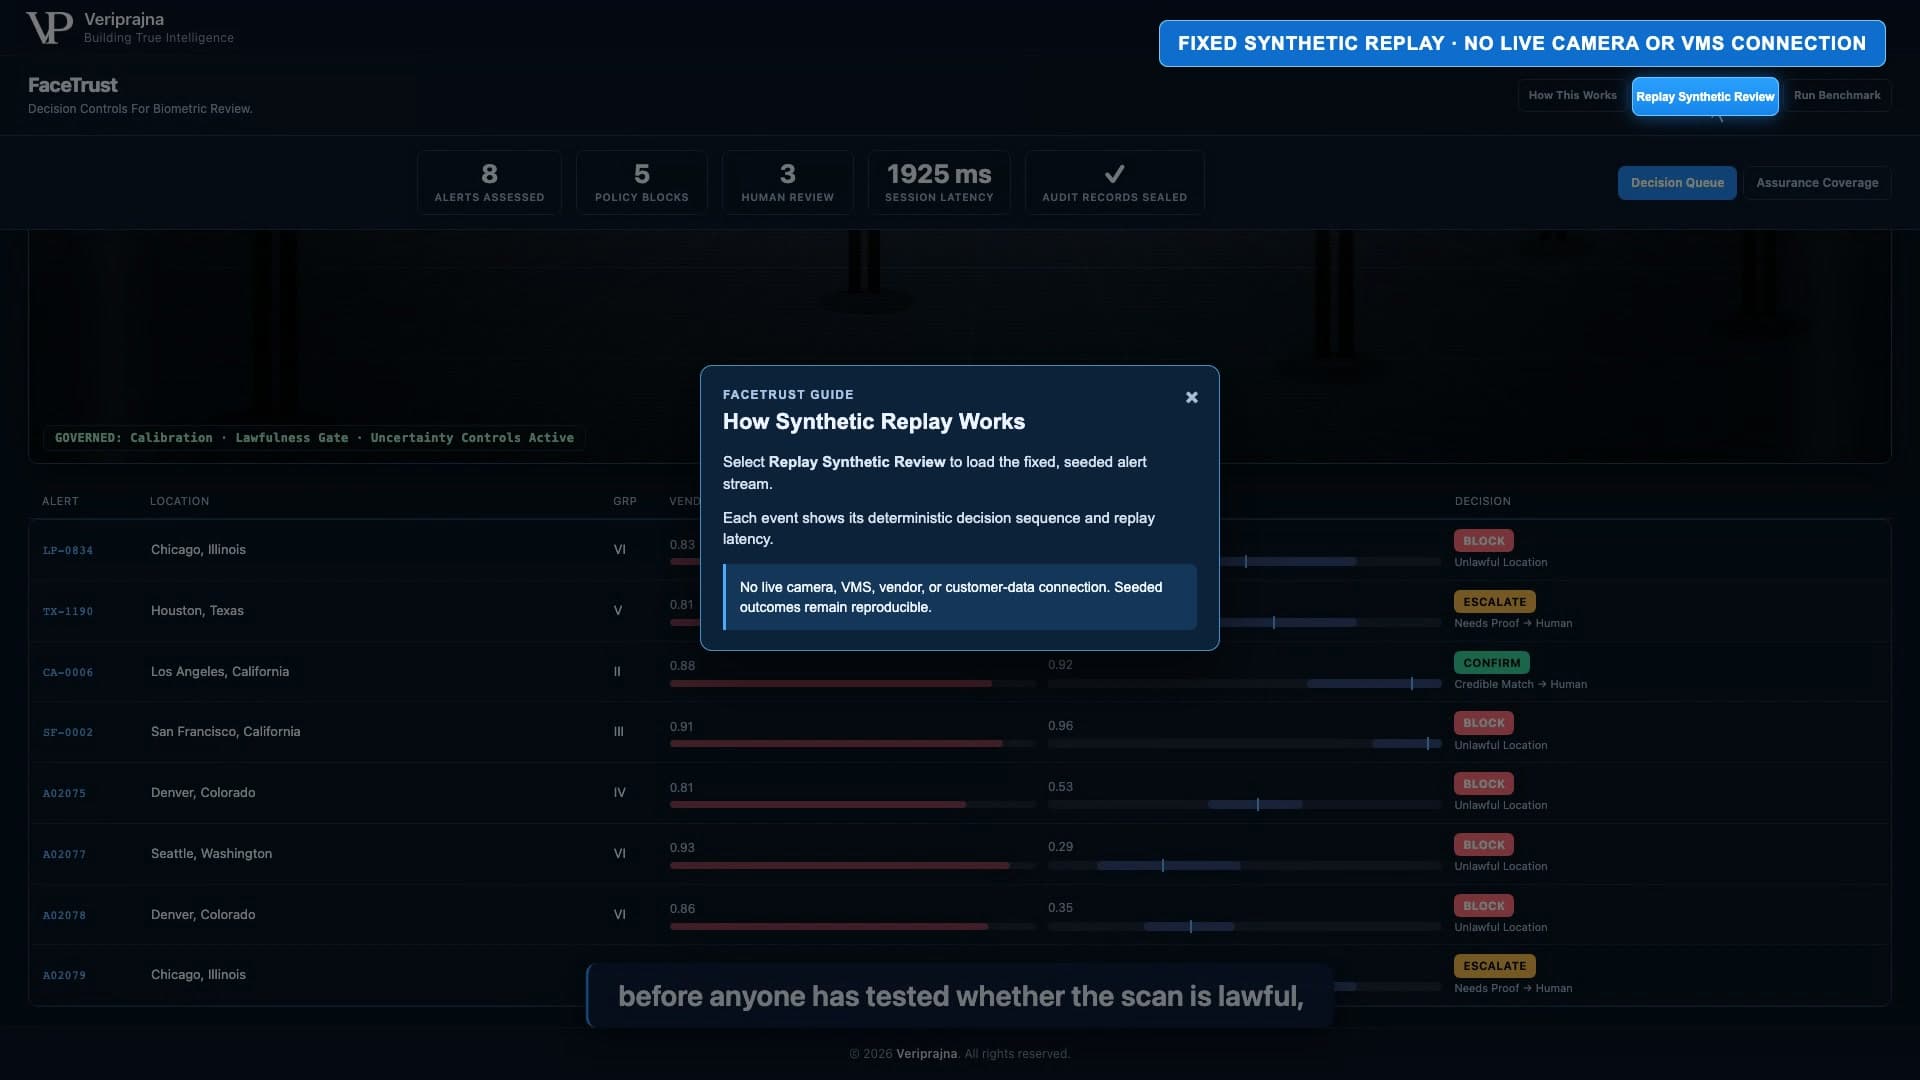
Comencé por la cifra, porque ahí es donde la vista se dirige de forma natural. En la cola sintética, LP-0834 se ubica junto a otras alertas con puntuaciones brutas de 0.81 a 0.91. A simple vista parecen variaciones de un mismo supuesto: coincidencias rotundas que esperan una respuesta operativa. La cola fomentó mi propio reflejo de clasificar primero y cuestionar después.
Ese reflejo es precisamente lo que quería examinar. Una puntuación bruta de proveedor es una entrada procedente de un único sistema de reconocimiento. No me aclara si la recopilación estaba permitida, si la captura era suficiente para la decisión concreta, o si la incertidumbre en torno al resultado calibrado todavía incluye una no coincidencia. Aun así, una puntuación con dos decimales transmite sensación de acabado. Su precisión visual supera a su autoridad decisoria.
Las filas adyacentes me resultaron reveladoras porque me negaron una regla complaciente. TX-1190 presenta una puntuación bruta de 0.81 y se deriva a ESCALATE porque su evidencia calibrada permanece sin resolver. CA-0006 presenta 0.88 y se deriva a CONFIRM, lo que significa que un revisor cualificado puede intervenir, no que el sistema pueda confrontar a nadie de manera automática. SF-0002 presenta la puntuación bruta más alta de las cuatro, 0.91, y aun así se deriva a BLOCK porque la tabla jurisdiccional configurada marca el reconocimiento facial como prohibido en San Francisco.
Las filas son sintéticas por diseño, pero el dilema arquitectónico es tangible: ¿qué información tiene permitido anular la puntuación? Si la respuesta es «ninguna», el proceso periférico de cumplimiento es meramente decorativo. Si la legalidad y la incertidumbre pueden alterar la ruta antes de que la alerta llegue al equipo operativo, la gobernanza se ha vuelto ejecutable.
Una puntuación alta puede reforzar la evidencia. No puede originar un consentimiento ni derogar una prohibición.
El instante en que la puntuación perdió el control
Abrí el expediente de LP-0834 esperando que el panel de calibración acaparara el protagonismo. La puntuación bruta de 0.83 desciende a una probabilidad de coincidencia calibrada de 0.50. El intervalo abarca de 0.217 a 0.783, y el conjunto de predicción contiene ambas etiquetas posibles. La evidencia no respalda la certeza.
Luego mi atención descendió en el panel hacia la determinación del consentimiento. Ahí es donde se zanja la ruta. La captura tiene 80 píxeles, situándose por encima del umbral mínimo de 72 píxeles fijado en la demo. La fotografía policial tiene 15 años, lo que el expediente anota como aviso para el revisor y la auditoría, pero sin erigirlo en filtro de enrutamiento autónomo. La ausencia de consentimiento es distinta: desencadena BLOCK.
Me costó asimilar esta jerarquía más de lo previsto. La calibración resulta matemáticamente atractiva, y un intervalo parece la respuesta sofisticada. Pero si permito que el relato de la incertidumbre acapare todo, corro el riesgo de sugerir que una probabilidad más favorable podría convalidar el escaneo. No puede subsanar una condición previa ausente. El filtro determinista de políticas debe evaluar la legalidad con total independencia de la confianza del modelo.
Esto transformó la manera en que me explicaba el producto a mí mismo. FaceTrust demuestra el Biometric Decision Firewall. No es otro motor de reconocimiento facial. Un adaptador de proveedor normaliza la alerta, un calibrador local expresa la incertidumbre y una serie de controles deterministas eligen entre BLOCK, SUPPRESS, ESCALATE y CONFIRM. El Compliance Reviewer puede redactar un informe inteligible una vez que existen esos hechos estructurados, pero no controla la ruta. En esta demo, dicho informe está precalculado en caché o proviene de una plantilla determinista de respaldo.
Quería que ese límite fuera visible porque los modelos de lenguaje destacan generando explicaciones de apariencia coherente. Un informe coherente no constituye una base legal. El asesoramiento debe llegar después de que la ruta esté fijada por reglas auditables, no antes como un sustituto persuasivo.
Tuve que dejar de tratar la calibración como un veredicto
Insistía en querer que una única probabilidad calibrada hiciera más de lo que podía. Ese fue mi modelo mental erróneo durante el desarrollo: sustituir una puntuación bruta por una mejor, y usar esa mejor puntuación como la decisión. LP-0834 rompió ese atajo porque el resultado de 0.50 todavía precisaba de un intervalo, un conjunto de predicción, una verificación de consentimiento, un control de jurisdicción y un procedimiento humano en torno a cualquier acción permitida.
El conjunto de predicción conforme al 93% es determinante porque transforma el vocabulario del sistema. Cuando el conjunto incluye tanto {mate, no_mate}, FaceTrust no comprime la ambigüedad en una etiqueta categórica. Puede derivar una alerta lícita pero no resuelta a ESCALATE. Cuando los indicios descartan la coincidencia, puede aplicar SUPPRESS. Cuando el conjunto contiene {mate}, una ruta CONFIRM sigue exigiendo la intervención de un revisor cualificado, nunca una confrontación, detención o acusación automática.
Pasé de la cola de trabajo a la vista de aseguramiento porque un expediente aislado no podía resolver la cuestión de la cobertura. En el conjunto de prueba sintético determinista de 3,000 alertas, los conjuntos conformes nominales al 93% alcanzaron al menos un 91.5% de cobertura empírica en los seis grupos Fitzpatrick evaluados. El mínimo de la referencia bruta fue del 40.6%. La interfaz expone la cobertura en los seis grupos Fitzpatrick evaluados.
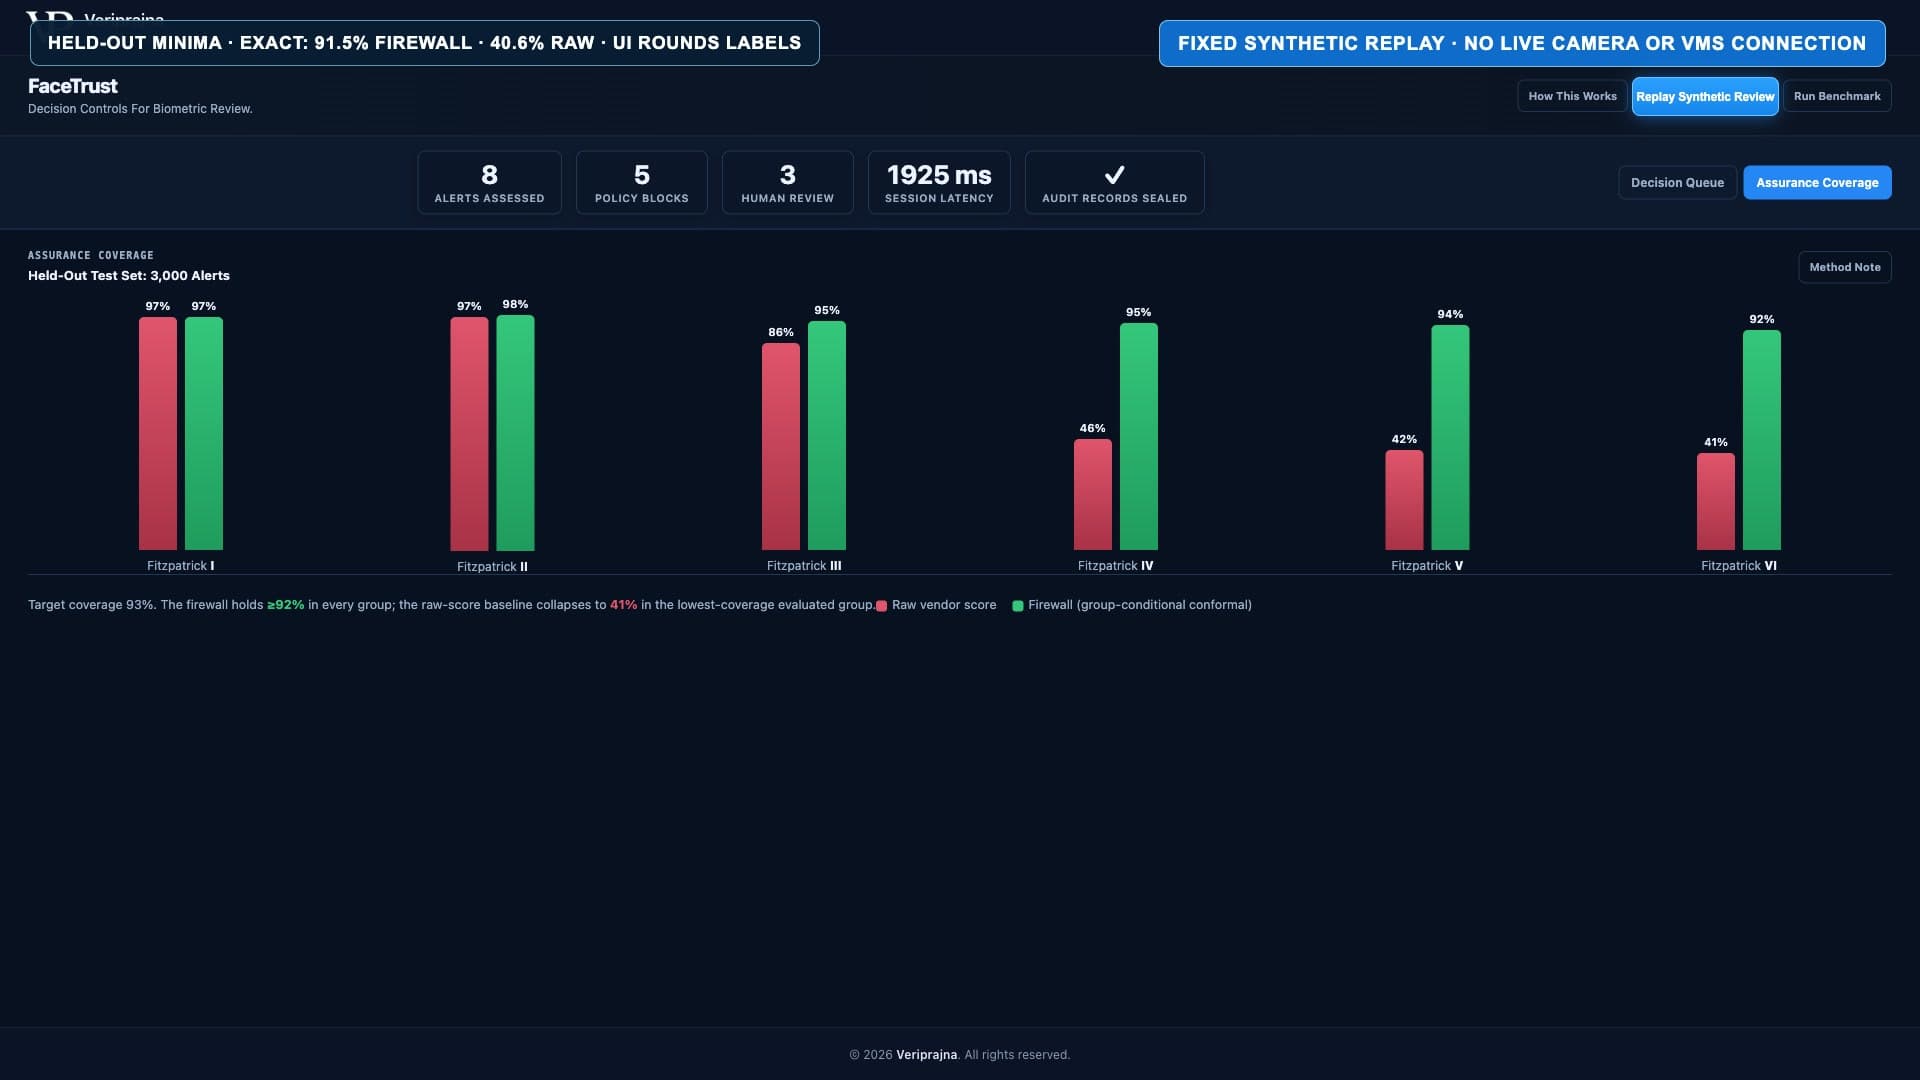
Estas cifras no constituyen afirmaciones de rendimiento en producción. El conjunto de prueba es sintético, diseñado para modelar modos de fallo documentados, y una calibración en producción exigiría el histórico resuelto de un cliente. Aporto este resultado porque muestra lo que conviene auditar en lugar de admirar una cifra global: el grupo evaluado más vulnerable, bajo un diseño de prueba explícito con alcance delimitado.
El gráfico también moderó mi impulso de celebrar el objetivo nominal. Una meta del 93% no significa que cada grupo alcance con exactitud el 93%, y desde luego no implica que el sistema posea una precisión del 93% en el mundo real. La visualización aporta un diagnóstico de cobertura, no una autorización para extrapolar más allá del conjunto de prueba sintético.
La incertidumbre solo resulta provechosa cuando el flujo de trabajo tiene permitido actuar de modo distinto debido a su presencia.
La repetición hizo visible el coste operativo
Ejecuté la repetición sintética fija para comprobar cómo respondería la jerarquía a escala operativa. A lo largo de sus 364 alertas, el umbral bruto desencadenaría 303 confrontaciones. En su lugar, el cortafuegos genera 121 rutas de revisión humana y bloquea 179 alertas, lo que supone una reducción del 60.1% según el método de cómputo de esta repetición. Esta reducción corresponde a esta repetición simulada, no a un despliegue en clientes ni a una promesa de producción.
No interpreté este hallazgo como «la automatización resolvió más». De hecho, el valor de este diseño reside en que rehúsa automatizar la consecuencia humana final. Filtra escaneos prohibidos o sin consentimiento, suprime indicios que descartan una coincidencia y encauza casos no resueltos o verosímiles hacia procedimientos definidos de revisión cualificada. La transición operativa pasa de la inercia impuesta por la puntuación a una responsabilidad específica para cada ruta.
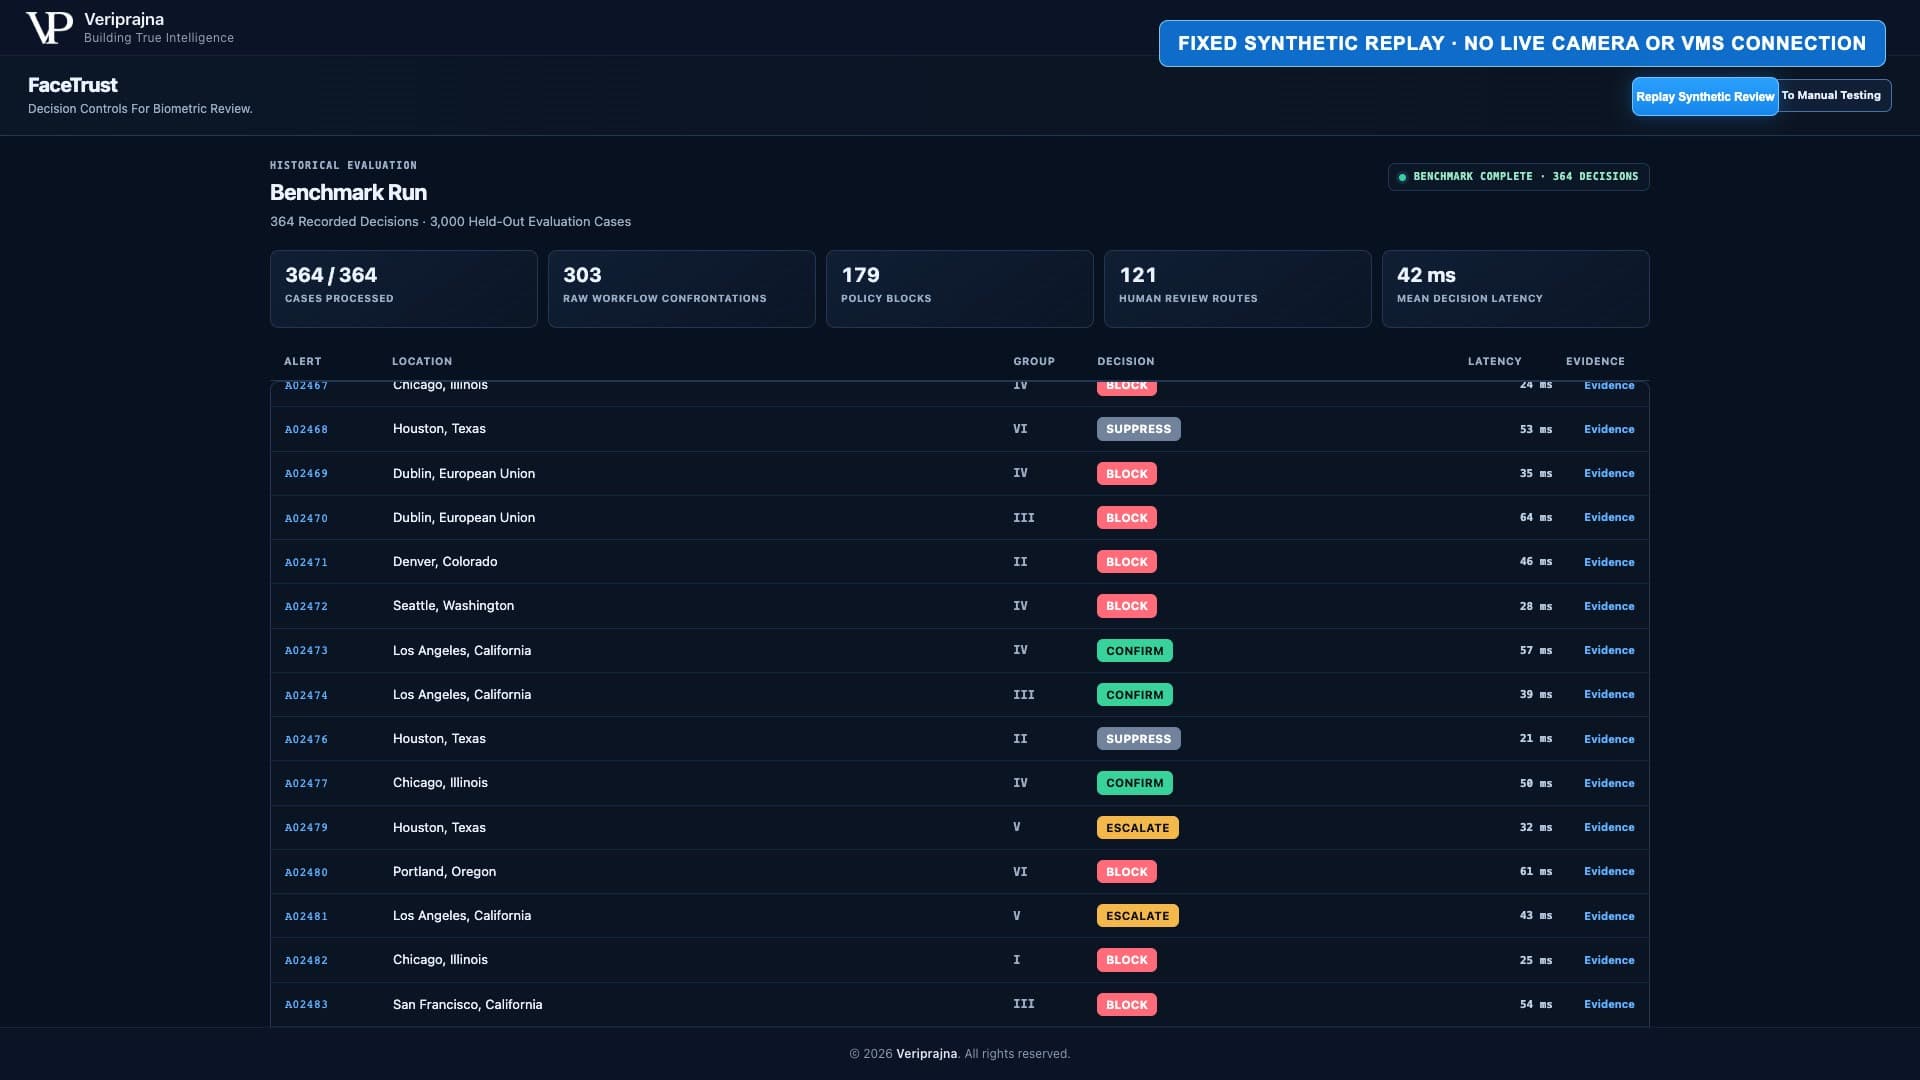
El benchmark de prueba relata una historia igualmente acotada. Entre 1,566 alertas sintéticas de impostores, la referencia bruta confrontaría a un ritmo del 69.3%, mientras que la tasa de confirmación del cortafuegos es del 3.8%, una reducción del 94.5% según esa definición. En 1,434 alertas sintéticas de coincidencias reales, el objetivo permanece en el conjunto de predicción del cortafuegos el 93.1% de las veces, frente al 99.3% de la referencia de umbral bruto. Esta confrontación pone de relieve un compromiso: conservar más coincidencias verdaderas resulta sencillo si el sistema está dispuesto a actuar sobre un número muy superior de impostores.
Ese compromiso modificó mi apreciación de «menos alertas», que por sí solo constituiría un mal objetivo. Un sistema podría reducir la carga de trabajo descartando casos difíciles de manera indiscriminada. Aquí, el fundamento de cada ruta permanece registrado: consentimiento, jurisdicción, suelo de captura, conjunto de predicción calibrado o exclusión probatoria. La ruta resulta explicable porque los parámetros que la alimentan son explícitos.
Esta es también la razón por la que la antigüedad de la captura sigue siendo un aviso contextual y no un filtro independiente en la demo. La fotografía policial de hace 15 años de LP-0834 constituye un contexto valioso para el revisor y la auditoría. Pretender que la demo cuenta con una regla universal sobre la edad añadiría una falsa certidumbre que ni el pliego ni la implementación respaldan.
Quería que la denegación superara cualquier inspección
Abrí la vista de evidencias tras la repetición y examiné la ruta junto a su registro. LP-0834 no concluye como un distintivo coloreado. Cada decisión produce un registro encadenado mediante hash SHA-256, y la interfaz puede exportar un informe de auditoría HTML imprimible. La denegación cuenta con trazabilidad demostrable.
He aprendido a desconfiar de los sistemas cuya explicabilidad radica únicamente en un párrafo generado. Un texto redactado puede resumir los hechos, pero no puede certificar que la ruta se determinó antes de escribir la prosa, ni que el registro subyacente no haya sido alterado con posterioridad. El encadenamiento de hashes no vuelve acertada la decisión por sí mismo. Hace que cualquier alteración posterior dentro de la cadena sea detectable y proporciona al auditor un artefacto inmutable.
Esa distinción preserva la honestidad de la auditoría. Esta demo no constituye una certificación de cumplimiento, ni un dictamen jurídico, ni un sustituto del asesoramiento legal. Emplea un entorno sintético simulado, adaptadores de prueba y tablas normativas modeladas. Carece de conexión con cámaras reales, VMS, motores de proveedores, NIST, pruebas de vida o datos de clientes. Demuestra un mecanismo y una secuencia ordenada, no un resultado en producción.
Puedo anticipar con claridad los requerimientos del futuro: no «muéstreme el informe descriptivo», sino «muéstreme qué sabía el sistema, qué regla determinista actuó, quién conservó la responsabilidad de actuar y si el registro sufrió cambios posteriores». El informe de auditoría está concebido exactamente para esa secuencia de indagaciones.
La directriz que extraje de este desarrollo
Ya no concibo la gobernanza del reconocimiento facial como una capa que se inicia una vez declarada una coincidencia. Para entonces, la alerta ya ha adquirido su propia inercia. Alguien divisa una puntuación alta, el operativo se pone en marcha y cada salvaguarda posterior debe enfrentarse a una conclusión que parece consumada.
El caso de LP-0834 me proporciona una regla más exigente: la legalidad debe evaluarse antes de que la confianza probatoria pueda autorizar una ruta, y la confianza probatoria debe manifestarse con incertidumbre antes de pedirle a una persona que actúe. El revisor cualificado sigue siendo el responsable de lo que acontezca tras una ruta CONFIRM o ESCALATE. BLOCK y SUPPRESS deben ser desenlaces plenamente legítimos, no anomalías a la espera de ser revocadas.
Ese es el principio rector que fundamenta el Biometric Decision Firewall. Los agentes pueden confeccionar síntesis legibles, pero son los controles deterministas los que fijan la ruta. La guía paso a paso y el desglose completo muestran cómo FaceTrust hace tangible esa separación.
Y si prefiere presenciar el sistema en funcionamiento antes que leerme describirlo, aquí tiene la demostración completa de principio a fin.
Comencé con una puntuación que parecía lo bastante sólida como para condicionar el juicio. Concluí con una denegación fundamentada en una condición previa ausente, una evidencia acotada y un registro verificable. La decisión más responsable en el sistema es a veces aquella que impide que la puntuación se convierta en acción.