Riesgo Regulatorio y Preparación para Litigios de IA
Preparamos sus sistemas de IA para un examen legal adversarial: documentación con estándar de litigio, preservación de pruebas, preparación para el descubrimiento y defensa multijurisdiccional.
¿Es su sistema de IA defendible ante un examen adversarial?
Nuestro enfoque consiste en construir la infraestructura técnica diseñada para hacer que los sistemas de IA sean defendibles ante un examen legal — no conformes en el sentido de una casilla marcada, sino defendibles en el sentido de que un litigante pueda explicar a un jurado cómo se tomó una decisión, un representante corporativo designado conforme a la regla 30(b)(6) pueda declarar sobre el comportamiento del sistema sin titubear, y un perito pueda superar una Daubert impugnación sobre la interpretabilidad del modelo.
Este es un trabajo de ingeniería, no de redacción de políticas. Un compromiso se estructura para producir arquitecturas de preservación de pruebas, documentación con estándar de litigio y artefactos listos para el descubrimiento que existen antes de que alguien presente una demanda.
Estos no son riesgos hipotéticos — son expedientes activos con daños reales, órdenes de descubrimiento reales y requisitos de remediación reales. La pregunta para las organizaciones que despliegan IA no es si enfrentan exposición legal. Es si sus sistemas pueden sobrevivir a lo que viene a continuación: descubrimiento adversarial, declaraciones de los ingenieros que construyeron los modelos, testimonio pericial sobre la procedencia de los datos de entrenamiento y exámenes regulatorios donde "usamos una herramienta de un proveedor" no es una defensa — una postura que reemplazamos con infraestructura propia, como se muestra en una demostración funcional de un despliegue de LLM soberano y privado.
Cómo es el descubrimiento en los casos de IA (y por qué la mayoría de las empresas fracasan en él)
En septiembre de 2025, el Distrito Sur de Nueva York estableció estándares de descubrimiento de IA en el litigio de derechos de autor de OpenAI. Los tribunales ahora ordenan la producción de un conjunto básico de artefactos, y los abogados de los demandantes en casos de discriminación algorítmica van considerablemente más allá.
El conjunto básico que los tribunales ahora ordenan
- Indicaciones del usuario
- Salidas del modelo y borradores generados por IA
- Metadatos con marcas de tiempo e identificadores del modelo
- Registros de acceso
- Ajustes de configuración
Lo que los demandantes por discriminación exigen adicionalmente
- Código fuente
- Composición de los datos de entrenamiento
- Informes de validación del modelo
- Resultados de pruebas A/B
- Mensajes internos de Slack sobre sesgos conocidos
- Datos de monitoreo posteriores al despliegue
- Cada versión del modelo que se ejecutó en producción durante el período relevante
La mayoría de las empresas fracasan en el descubrimiento de una de dos maneras. O bien las pruebas no existen porque nadie construyó la infraestructura para capturarlas — lo que lleva a sanciones por destrucción de pruebas e instrucciones de inferencia adversa. O bien las pruebas existen pero resultan perjudiciales, porque las comunicaciones internas revelan que los ingenieros señalaron preocupaciones de sesgo que nunca se abordaron, o que se desplegaron cambios en el modelo sin pruebas documentadas.
Nuestro enfoque aborda ambos modos de fallo. Para el primero, diseñamos sistemas de preservación de pruebas para capturar automáticamente el contexto de la decisión en el momento de la inferencia: el hash de la versión del modelo, las características de entrada, el estado del preprocesamiento, las puntuaciones de confianza y las políticas de gobernanza activas. Para el segundo, diseñamos flujos de trabajo estructurados de gestión de cambios del modelo donde cada modificación se documenta con su justificación, resultados de pruebas y cadenas de aprobación — de modo que el registro del descubrimiento cuente una historia coherente de desarrollo responsable en lugar de una iteración desordenada.
El calendario de aplicación regulatoria no está esperando
Tres plazos importantes de aplicación convergen a mediados de 2026.
- La SB 205 de Colorado entra en vigor el 30 de junio de 2026, con sanciones de hasta $20,000 por infracción y una defensa afirmativa disponible únicamente para las organizaciones que demuestren cumplimiento del NIST AI RMF.
- Las obligaciones de alto riesgo de la Ley de IA de la UE comienzan a aplicarse el 2 de agosto de 2026, con sanciones que alcanzan los 35 millones de euros o el 7 % de la facturación mundial. El artículo 73 exige la notificación de incidentes graves en un plazo de 2 días para muertes o interrupciones de infraestructuras críticas, y de 15 días para otros incidentes.
- La aplicación existente por parte de los fiscales generales estatales ya está activa: Massachusetts resolvió un caso de discriminación en préstamos con IA en julio de 2025, y 36 fiscales generales estatales se opusieron formalmente a la preempción federal para preservar su autoridad de aplicación.
El panorama de aplicación es internamente contradictorio. La CFPB propuso poner fin a la aplicación del impacto dispar conforme a la ECOA en noviembre de 2025, mientras que los fiscales generales estatales presentaron acciones por discriminación de IA bajo las leyes UDAP con sanciones por infracción. La FTC revocó su orden de consentimiento contra Rytr en febrero de 2026, y luego emitió un marco integral de aplicación para agentes de IA en marzo de 2026.
Las organizaciones que construyeron programas de cumplimiento en torno a una única señal regulatoria quedan expuestas cuando esa señal cambia. Nuestro enfoque consiste en diseñar arquitecturas de defensa mapeadas a las obligaciones en sí mismas, no a la postura actual de ningún regulador en particular (fundamentado en nuestra investigación sobre la rendición de cuentas algorítmica).
Documentación con estándar de litigio frente a documentación de cumplimiento
Existe una diferencia significativa entre la documentación que satisface una auditoría de cumplimiento y la documentación que sobrevive a un examen legal adversarial.
| Documentación de cumplimiento | Documentación con estándar de litigio |
|---|---|
| Responde a "¿siguió el proceso?" | Responde a "demuestre que esta decisión específica no fue discriminatoria — con pruebas que un perito de la parte contraria no pueda desmontar en el contrainterrogatorio." |
| Fichas de modelo diseñadas para profesionales del ML | Documentación del modelo preparada para una audiencia Daubert |
La audiencia, el escrutinio adversarial y el estándar probatorio son fundamentalmente diferentes.
Un compromiso se estructura para producir documentación con el estándar de litigio: cada decisión de IA con consecuencias es reconstruible a partir de su registro — la versión exacta del modelo, los datos de entrada, los valores de las características, el estado del pipeline de preprocesamiento y la lógica de decisión son recuperables meses o años después del hecho.
Defensas específicas por dominio que documentamos
- IA de empleo: la defensa de relación con el puesto y necesidad del negocio (el marco de traslado de la carga probatoria Griggs/Wards Cove conforme al Título VII), documentada a nivel de diseño del sistema en lugar de como una racionalización posterior a los hechos.
- IA de préstamos y seguros: la metodología de pruebas de impacto dispar documentada con suficiente rigor como para que el perito estadístico de un demandante no pueda impugnar las pruebas por inadecuadas.
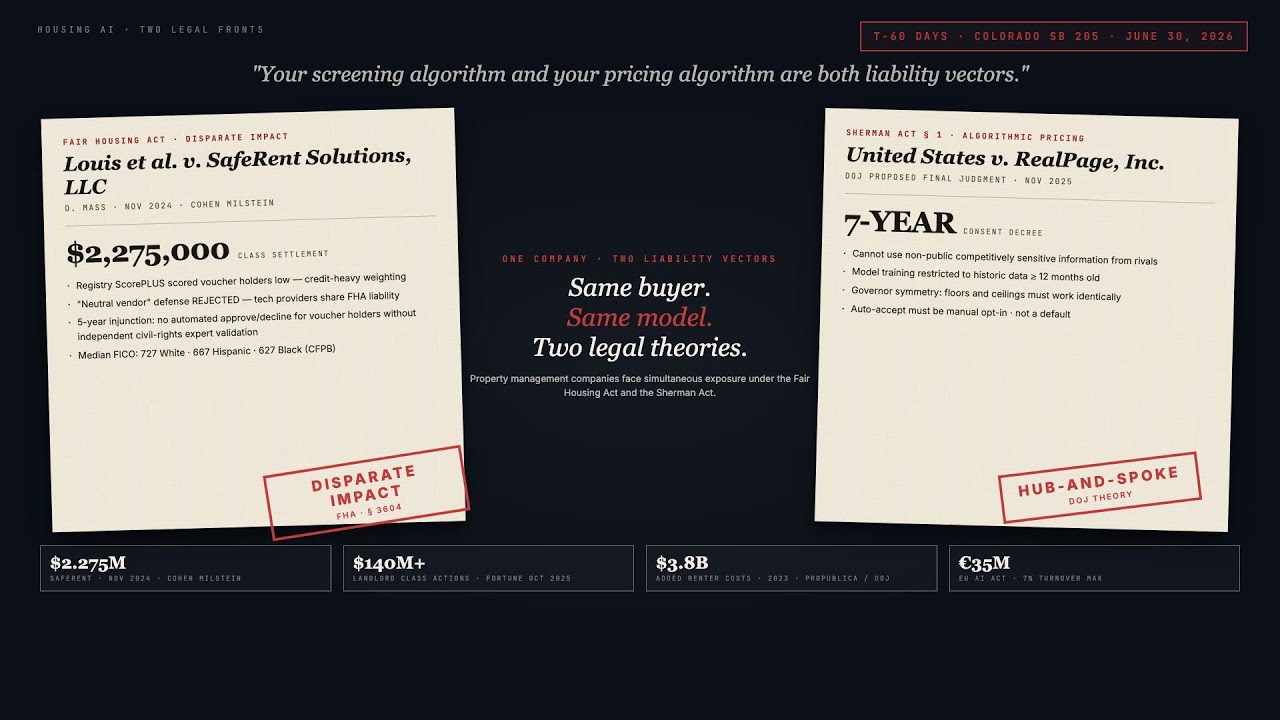
- IA de vivienda: la cadena de pruebas que demuestra que el tratamiento de los titulares de vales no se hizo por medio del historial crediticio o de factores de deuda — el vector de ataque exacto en litigios del tipo SafeRent, donde el algoritmo calificó a los solicitantes usando factores que perjudicaban de manera desproporcionada a los inquilinos negros e hispanos (detallado en nuestra investigación sobre el mandato de integridad algorítmica de SafeRent).
Descubrimiento simulado: encontrar sus debilidades antes de que lo haga el abogado contrario
Un compromiso puede incluir ejercicios adversariales en los que nuestros ingenieros asumen el papel de un perito técnico de un demandante, sondeando sus sistemas de IA en busca de las debilidades que el litigio explotaría:
- Cambios no documentados en el modelo
- Propiedades de equidad no probadas en los grupos protegidos
- Evaluaciones de impacto faltantes
- Lagunas en el rastro de auditoría
- Comunicaciones internas que contradicen las políticas publicadas
- Lagunas en la procedencia de los datos que socavan las afirmaciones sobre la integridad de los datos de entrenamiento
El ejercicio está diseñado para producir una evaluación privilegiada — bajo el privilegio abogado-cliente cuando se realiza junto con un asesor externo — que saque a la luz las debilidades antes de que se conviertan en pruebas ante el tribunal.
Esto no es un ejercicio de mesa. Redactamos los interrogatorios y las solicitudes de documentos que el abogado contrario presentaría, identificamos a los custodios cuyos archivos serían registrados, comprobamos si los sistemas de preservación capturan lo que los tribunales exigen (conforme a los estándares de descubrimiento de IA de 2025 del SDNY) y evaluamos si su representante designado conforme a la regla 30(b)(6) puede declarar sin crear más exposición de la que resuelve. El resultado previsto es una hoja de ruta de remediación organizada por gravedad del riesgo de litigio, con especificaciones de ingeniería para cerrar cada laguna.
Defensa multijurisdiccional sin programas paralelos
Una empresa con clientes en la UE, empleados en Colorado, solicitantes de empleo en Illinois y operaciones de seguros en cualquiera de los 23 estados que adoptaron el Boletín Modelo de IA de la NAIC se enfrenta a al menos cinco regímenes regulatorios superpuestos para un solo sistema de IA. Construir programas de cumplimiento separados por jurisdicción no es escalable, y crea inconsistencias que los abogados de los demandantes explotan:
"Usted dijo a los reguladores de Colorado que su metodología de pruebas de sesgo era X, pero su evaluación de conformidad de la UE la describe como Y. ¿Cuál es?"
Nuestro enfoque consiste en construir un marco de defensa unificado en el que el estándar aplicable más estricto establezca la base.
- Un protocolo de pruebas de impacto dispar que satisface el estándar de discriminación algorítmica de la SB 205 de Colorado produce simultáneamente pruebas para los requisitos de gobernanza de datos del artículo 10 de la Ley de IA de la UE y para la defensa de necesidad del negocio del Título VII.
- Un procedimiento de respuesta a incidentes que cumple con el plazo de notificación de 2 días del artículo 73 satisface automáticamente la ventana de 72 horas de la Ley RAISE de Nueva York y las expectativas de notificación de los fiscales generales estatales.
Las capas de documentación específicas por jurisdicción generan los artefactos correctos para cada regulador o tribunal sin mantener programas paralelos. Cuando se aprueba una nueva ley estatal o la Oficina de IA de la UE emite orientación de aplicación, la capa superpuesta se actualiza. Los controles de base rara vez cambian, porque ya están construidos según el listón más alto.
Responsabilidad a nivel del consejo y la cuestión del deber fiduciario
Los fallos en la gobernanza de la IA crean un riesgo de responsabilidad personal para los directores conforme al estándar Caremark de Delaware. Los consejos que no implementan sistemas de información sobre el riesgo de la IA se enfrentan a demandas derivadas de los accionistas. La SEC incluyó la IA entre sus principales prioridades de examen para 2025-2026, y se espera que los consejos documenten los marcos de supervisión de la IA en las declaraciones de poder para la temporada de poderes de 2026.
Un compromiso se estructura para producir los entregables dirigidos al consejo diseñados para cerrar esta brecha:
- Materiales de informe ejecutivo que traducen el riesgo técnico de la IA a lenguaje de gobernanza
- Registros de riesgos mapeados a las obligaciones fiduciarias
- Sistemas de monitoreo que dan a los directores pruebas documentadas de una supervisión activa
No una presentación trimestral de diapositivas — un sistema de información estructurado que proporciona la base para demostrar una supervisión de buena fe del riesgo de la IA, el estándar específico que exige Caremark.
Puntos clave
- La defendibilidad es ingeniería, no política: las arquitecturas de preservación de pruebas, la documentación con estándar de litigio y los artefactos listos para el descubrimiento deben existir antes de que se presente la demanda.
- El descubrimiento de IA ahora obliga a producir indicaciones, salidas, metadatos, código fuente, datos de entrenamiento y cada versión del modelo en producción — capture el contexto de la decisión en el momento de la inferencia o arriesgue sanciones por destrucción de pruebas.
- Tres plazos de 2026 convergen: la SB 205 de Colorado (30 de junio), las obligaciones de alto riesgo de la Ley de IA de la UE (2 de agosto) y la notificación de incidentes graves del artículo 73.
- Las herramientas de proveedores no transfieren la responsabilidad; un marco unificado con el estándar más estricto y capas superpuestas específicas por jurisdicción supera a los programas paralelos por regulador.
- La supervisión del riesgo de la IA por parte del consejo es ahora una cuestión de deber de diligencia conforme a Caremark, respaldada por las prioridades de examen de la SEC.
Riesgo Regulatorio y Preparación para Litigios de IA
 Ver
IA Ética de Retención de Suscripciones | Veriprajna
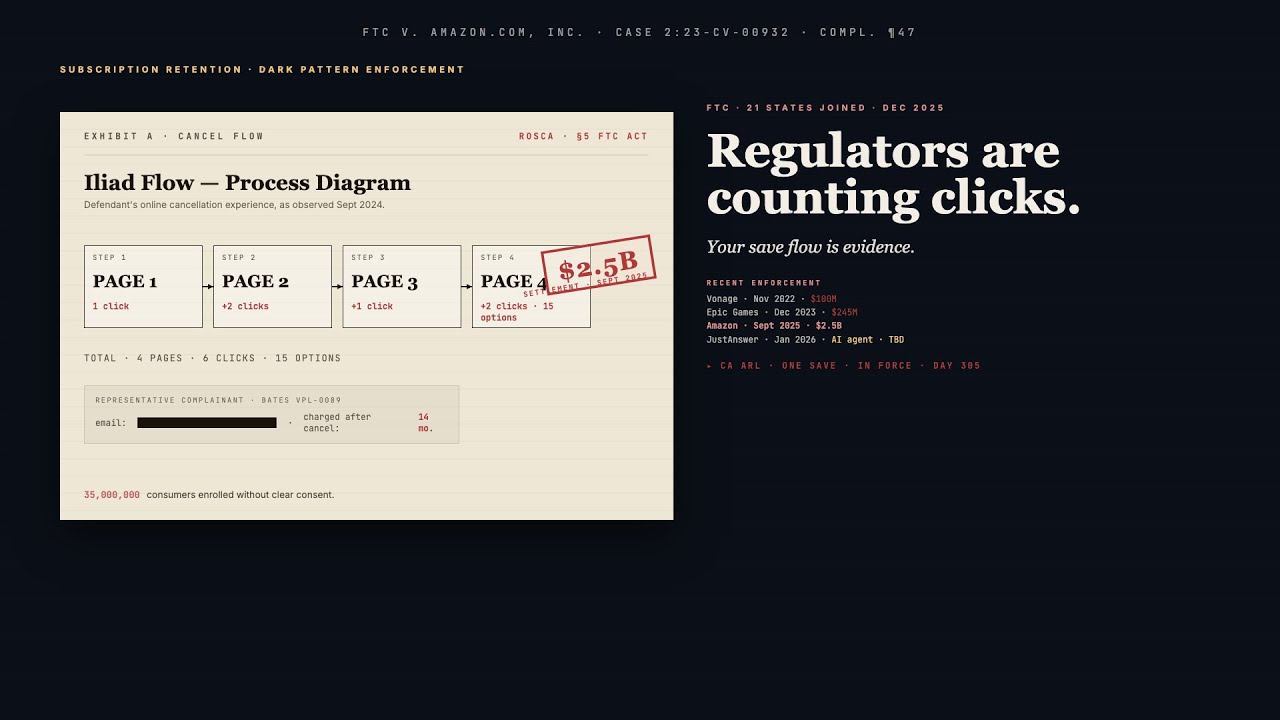
Amazon pagó 2.500 millones de dólares por un flujo de cancelación que requería 6 clics. Uber se enfrenta a 21 fiscales generales estatales por las 23 pantallas necesarias para cancelar.
 Ver
Cumplimiento de IA en vivienda: equidad en la selección de inquilinos y fijación algorítmica de precios | Veriprajna
Las empresas de gestión inmobiliaria afrontan una exposición legal simultánea en dos frentes: la selección de inquilinos que discrimina bajo la Fair Housing Act y la gestión de ingresos que coordina precios bajo la Sherman Act. Auditamos ambos, diseñamos arquitecturas conformes y mapeamos sus sistemas frente a cada jurisdicción que importa.
 Ver
IA soberana e implementación de LLM privados | Veriprajna
Una de cada cinco organizaciones ya ha sufrido una brecha por el uso no autorizado de herramientas de IA. Prohibir la IA no funciona. Construir alternativas seguras y soberanas sí.
Preguntas Frecuentes
¿Qué exige realmente el descubrimiento en litigios de IA y cómo nos preparamos para ello?
Siguiendo los estándares de descubrimiento de IA del SDNY de septiembre de 2025, los tribunales ahora ordenan la producción de indicaciones del usuario, salidas del modelo, borradores generados por IA, metadatos con marcas de tiempo e identificadores del modelo, registros de acceso y ajustes de configuración. Los abogados de los demandantes en casos de discriminación van más allá: código fuente, composición de los datos de entrenamiento, informes de validación del modelo, resultados de pruebas A/B, comunicaciones internas sobre sesgos conocidos y cada versión del modelo en producción durante el período relevante. Prepararse significa construir infraestructura de preservación de pruebas que capture el contexto de la decisión automáticamente en el momento de la inferencia, no ensamblarlo retroactivamente después de que llegue una citación. Diseñamos sistemas que almacenan el hash de la versión del modelo, las características de entrada, el estado del preprocesamiento, las puntuaciones de confianza y las políticas de gobernanza activas para cada decisión con consecuencias, consultables por ID de decisión, rango temporal o clase de resultado.
¿En qué se diferencia la documentación de IA con estándar de litigio de las fichas de modelo estándar o de la documentación de cumplimiento?
La documentación de cumplimiento responde a "¿siguió el proceso?". La documentación con estándar de litigio responde a "demuestre que esta decisión específica no fue discriminatoria, con pruebas que un perito de la parte contraria no pueda desmontar en el contrainterrogatorio". Las fichas de modelo diseñadas para profesionales del ML carecen del estándar de escrutinio adversarial, de la cadena de custodia probatoria y del mapeo al marco legal específico (Daubert para el testimonio pericial, Griggs/Wards Cove para el traslado de la carga probatoria en el impacto dispar, FCRA para las divulgaciones de informes de consumidores) que exige el litigio. Producimos documentación en la que cada decisión con consecuencias es reconstruible a partir de su registro: versión exacta del modelo, datos de entrada, valores de las características, estado del pipeline de preprocesamiento y lógica de decisión, recuperables meses o años después del hecho con integridad a prueba de manipulaciones.
¿Cuáles son los puntos de referencia de sanciones por incumplimiento regulatorio de IA en 2026?
El panorama de sanciones tiene cifras concretas. SB 205 de Colorado (en vigor el 30 de junio de 2026): hasta $20,000 por infracción conforme a la Ley de Protección al Consumidor, con una defensa afirmativa únicamente para las organizaciones que demuestren cumplimiento del NIST AI RMF. Ley de IA de la UE (aplicación de alto riesgo el 2 de agosto de 2026): hasta 35 millones de euros o el 7 % de la facturación anual mundial por prácticas prohibidas, 15 millones de euros o el 3 % por incumplimiento de alto riesgo. AIVFA de Illinois: hasta $5,000 por infracción más demandas privadas, con 37 casos presentados en el primer mes de aplicación. Daños legales de la FCRA: $100-$1,000 por infracción intencional, lo que se multiplica drásticamente en las acciones colectivas como la demanda contra Eightfold AI que abarca datos de más de mil millones de trabajadores. Las leyes UDAP estatales permiten sanciones por infracción sin prueba de daños individuales.
¿Somos responsables de la discriminación de IA cuando usamos la herramienta de un proveedor y no nuestro propio modelo?
Sí. Los empleadores siguen siendo plenamente responsables de los resultados discriminatorios de las herramientas de IA de proveedores conforme al Título VII, la FCRA y las leyes laborales estatales. En Mobley v. Workday (mayo de 2025), el tribunal sostuvo que el "papel de Workday en el proceso de contratación no es menos significativo porque supuestamente ocurra a través de inteligencia artificial en lugar de un ser humano de carne y hueso". La acción colectiva de la FCRA contra Eightfold AI nombra a los empleadores que usaron la herramienta de calificación. La SB 205 de Colorado impone obligaciones separadas a los desplegadores independientemente de si construyeron el sistema de IA. No se puede externalizar la responsabilidad legal externalizando la tecnología. Ayudamos a las organizaciones a construir la infraestructura de documentación, pruebas y supervisión que demuestra que usted ejerció la debida diligencia sobre las herramientas de IA de proveedores, que es la defensa que realmente importa cuando llega la demanda de un demandante.
¿Cómo gestionamos el cumplimiento de la IA cuando los reguladores federales y estatales van en direcciones opuestas?
El entorno actual es internamente contradictorio. La CFPB propuso poner fin a la aplicación del impacto dispar conforme a la ECOA en noviembre de 2025, mientras que los fiscales generales estatales presentaron simultáneamente acciones por discriminación de IA bajo las leyes UDAP estatales. La FTC revocó su orden de consentimiento contra Rytr en febrero de 2026, y luego emitió un marco integral de aplicación para agentes de IA en marzo de 2026. Una orden ejecutiva de diciembre de 2025 propuso la preempción federal de las leyes estatales de IA, pero 36 fiscales generales estatales se opusieron formalmente y, hasta que los tribunales resuelvan, las leyes estatales siguen siendo aplicables. Construimos arquitecturas de defensa mapeadas a las obligaciones legales en sí mismas, no a la postura actual de ningún regulador en particular. Un marco de control unificado con capas de documentación específicas por jurisdicción significa que, cuando cambian las prioridades de aplicación, la capa superpuesta se actualiza mientras que los controles de base se mantienen.
¿Qué es un ejercicio de descubrimiento simulado y qué produce realmente?
Un ejercicio de descubrimiento simulado es una simulación adversarial en la que nuestros ingenieros interpretan el papel de peritos técnicos de un demandante, sondeando sus sistemas de IA en busca de vulnerabilidades ante el litigio. Redactamos los interrogatorios y las solicitudes de documentos reales que el abogado contrario presentaría, identificamos a los custodios cuyos archivos serían registrados, comprobamos si sus sistemas de preservación capturan lo que los tribunales ahora exigen conforme a los estándares de descubrimiento de IA de 2025 del SDNY, y evaluamos si su representante corporativo designado conforme a la regla 30(b)(6) puede declarar sobre el sistema sin crear exposición adicional. El resultado es una hoja de ruta de remediación privilegiada (realizada bajo el privilegio abogado-cliente cuando se combina con un asesor externo) organizada por gravedad del riesgo de litigio, con especificaciones de ingeniería para cerrar cada laguna. Esto difiere de una auditoría de cumplimiento porque estamos probando explícitamente las debilidades adversariales, no verificando frente a un marco de cumplimiento.
¿Los miembros de nuestro consejo enfrentan responsabilidad personal por fallos en la gobernanza de la IA?
Conforme al estándar Caremark de Delaware, los directores incumplen su deber de diligencia cuando no implementan sistemas de información y reporte o no supervisan adecuadamente a la dirección. La gobernanza de la IA está ahora claramente dentro de este marco. La SEC incluyó la IA entre sus principales prioridades de examen para 2025-2026, y se espera que los consejos documenten los marcos de supervisión de la IA en las declaraciones de poder para la temporada de poderes de 2026. No hacerlo arriesga demandas derivadas de accionistas del tipo Caremark, recomendaciones de retención de voto y daño reputacional. Construimos los sistemas de información estructurados que dan a los directores pruebas documentadas de una supervisión activa de la IA: registros de riesgos mapeados a las obligaciones fiduciarias, paneles de monitoreo que muestran el estado de la gobernanza y materiales de informe que traducen el riesgo técnico de la IA al lenguaje de gobernanza que los directores necesitan para demostrar una supervisión de buena fe.
¿Cómo construimos pruebas de impacto dispar que resistan ante el perito estadístico de un demandante?
Los marcos de traslado de la carga probatoria difieren según la ley. El Título VII (Griggs/Wards Cove) exige que el empleador demuestre la relación con el puesto y la necesidad del negocio si un demandante establece un impacto dispar. La ECOA y la FHA tienen sus propios estándares. El perito estadístico de un demandante impugnará los tamaños de muestra, la metodología de pruebas, las definiciones de los grupos protegidos y si la población de comparación se construyó correctamente. Diseñamos protocolos de pruebas a nivel de diseño del sistema, no como un análisis posterior a los hechos: definiendo la segmentación de los grupos protegidos, seleccionando las pruebas estadísticas apropiadas (regla de los cuatro quintos, basadas en regresión, bayesianas), estableciendo poblaciones de comparación de referencia y documentando la justificación de necesidad del negocio para cualquier característica que produzca resultados dispares. La documentación está estructurada de modo que, cuando el perito de un demandante impugna la metodología, la respuesta ya consta en el registro con la justificación de las pruebas, no improvisada durante la declaración.
¿Cómo suelen ser los requisitos técnicos de remediación de un decreto de consentimiento sobre IA?
Los decretos de consentimiento en las acciones de aplicación sobre IA siguen un patrón emergente: restitución algorítmica (destruir los datos recopilados indebidamente y los modelos entrenados con ellos), períodos de prohibición de usos específicos de IA (Rite Aid recibió una prohibición de reconocimiento facial de 5 años), eliminación obligatoria de los datos de consumidores usados en el sistema de IA, auditorías independientes de terceros (normalmente bienales), programas escritos de gestión de riesgos y gobernanza, mecanismos de notificación y exclusión voluntaria para el consumidor, y reportes de cumplimiento continuos al regulador. El decreto de consentimiento de la FTC contra Rite Aid es la plantilla actual. Aplicamos ingeniería inversa a estos requisitos para convertirlos en infraestructura proactiva: seguimiento de la procedencia de los datos que pueda probar la recopilación lícita, documentación del linaje del modelo que pueda demostrar datos de entrenamiento limpios, y programas de gobernanza que ya satisfacen las exigencias de remediación del decreto de consentimiento típico. Construir esto antes de la aplicación es órdenes de magnitud más barato que adaptarlo bajo supervisión judicial.
Construya su IA con confianza.
Colabore con un equipo que cuenta con amplia experiencia en la creación de la próxima generación de IA empresarial. Permítanos ayudarle a diseñar, construir e implementar una estrategia de IA en la que pueda confiar.
Veriprajna consultora de Deep Tech está especializada en la creación de sistemas de IA críticos para la seguridad en los sectores de salud, finanzas y ámbitos regulatorios. Nuestras arquitecturas se validan conforme a protocolos establecidos, con documentación de cumplimiento integral.