Detección de contenido sintético y opiniones falsas

Las opiniones verosímiles también pueden pertenecer a una campaña coordinada.

Campaign Firewall muestra cómo la evidencia de relaciones puede respaldar una ruta de revisión humana cuando la redacción por sí sola pasa por alto el patrón. Todas las opiniones y los historiales de cuentas que se muestran aquí son sintéticos.

4 de 15

Marcadas por la línea base local solo de texto

Campaña modelada totalmente humana, mismo fixture

15 de 15

Enrutadas para revisión humana por el ensamble

Registros sintéticos, sin acción de la plataforma

105 pares de cuentas

Vinculadas a través de un historial compartido de productos

Evidencia de relaciones en el mismo clúster

Estas observaciones del fixture explican una decisión de diseño. Ambos métodos utilizan percentiles de texto derivados del corpus, y el umbral de revisión del ensamble se ajustó con las mismas etiquetas; esto no representa un rendimiento con datos no observados.

Un mensaje verosímil deja abierta la cuestión de la coordinación

Un equipo de protección de marca necesita saber por qué las opiniones parecen estar relacionadas antes de decidir qué escalar. La redacción fluida por sí sola no puede establecer que las cuentas actuaron de forma independiente, y una opinión negativa por sí sola no demuestra fraude.

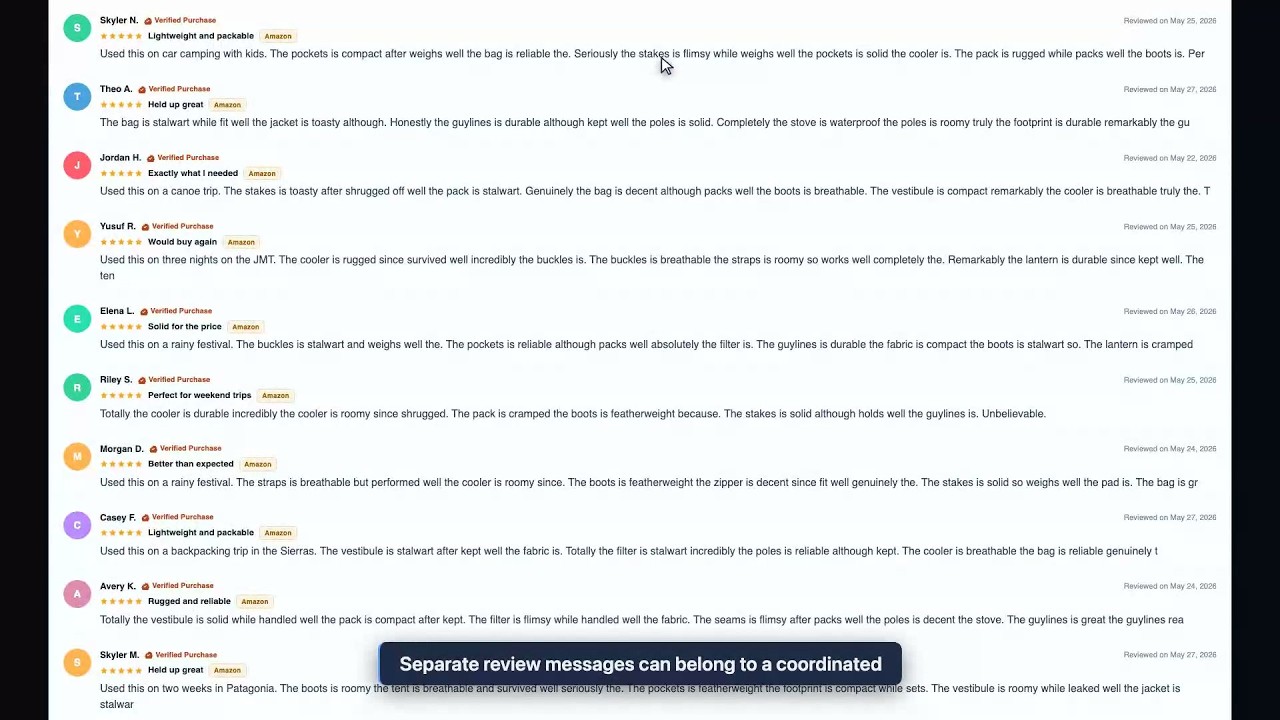
Nuestro ejemplo sintético modela una campaña de 15 opiniones en el perfil de un competidor. Once registros apenas presentan anomalías estilométricas, pero sus historiales compartidos de productos conectan las cuentas. La línea base local solo de texto marca cuatro de las 15; el ensamble enruta las 15 para su revisión.

Esa ruta preserva la incertidumbre. La etiqueta modelada de campaña totalmente humana es la verdad fundamental del fixture, no una prueba de que personas reales hayan escrito estas opiniones o de que alguien haya recibido un pago.

Puntuar las señales, luego explicar el hallazgo

Combinar cuatro familias de señales

Los patrones de redacción, el comportamiento de las cuentas, las concentraciones temporales de picos y las relaciones entre cuentas contribuyen a una puntuación heurística acotada. El fixture modela 90 días de historial; el detector temporal examina ventanas pico de 72 horas. La puntuación no es una probabilidad calibrada.

Exigir una relación entre cuentas

Los dispositivos compartidos o los historiales de productos con suficiente solapamiento crean aristas en el grafo. La superposición de productos exige una similitud de Jaccard de al menos 0.5 dentro del mismo perfil y no más de 72 horas entre registros. La coincidencia temporal por sí sola no genera ningún vínculo.

Mantener la ruta inspeccionable

Los componentes conectados se convierten en clústeres de campaña cuando el tamaño y la cohesión satisfacen las reglas configuradas. La puntuación determinista asigna la idoneidad para CLEAR, REVIEW o el valor modelado AUTO antes de redactar una descripción narrativa. REVIEW continúa siendo una ruta para el criterio humano, no una investigación completada.

Preservar la evidencia detrás de la prosa

La investigación registrada reproduce una respuesta en caché de Codex después de la puntuación. Un filtro determinista verifica números, solapamiento de tokens e inversiones de veredicto; no certifica como verdadera cada oración retenida. El JSON conserva la pertenencia a la campaña, las puntuaciones numéricas de los componentes y un borrador de disputa no presentado. El HTML imprimible muestra el perfil de la campaña, los nombres de las señales por opinión y el borrador; no muestra el desglose numérico de componentes.

El grafo utiliza una agrupación interpretable por componentes conectados. En esta demostración no se implementan redes neuronales de grafos entrenadas ni integraciones con plataformas en producción.

Seguir una campaña de opiniones desde las señales hasta la evidencia

Todas las opiniones, historiales de cuentas, dispositivos y fuentes de plataformas en estas capturas reales de la aplicación son sintéticos. El ejemplo principal sigue 15 opiniones modeladas de la competencia desde el hallazgo de la campaña a través de una ruta de revisión humana hasta el registro exportado.

Ejemplo práctico: 15 opiniones verosímiles, un solo patrón de relaciones

El fixture etiqueta este caso como una campaña pagada totalmente humana, pero el detector no determina la autoría ni el pago. Once de sus 15 opiniones tienen un componente estilométrico de como máximo 4: escasa anomalía en el patrón de redacción en esta implementación. Sus historiales de cuentas aportan la razón para examinarlas conjuntamente.
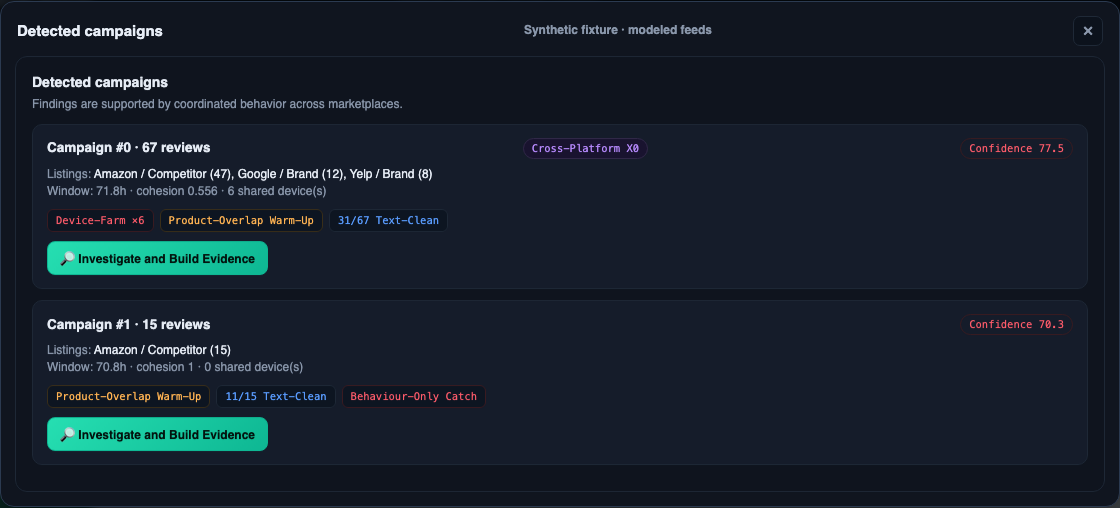
Dos tarjetas de campañas sintéticas: un clúster multiplataforma de 67 opiniones y un clúster de historial de productos de 15 opiniones.
La segunda tarjeta resume el caso de 15 opiniones a lo largo de 70.8 horas. Su etiqueta de confianza media es una puntuación heurística de 70.3/100, no una probabilidad de fraude. Abra la imagen para una inspección a tamaño completo.

1. Inspeccionar qué vincula a las cuentas

Las 15 opiniones comparten historiales de productos con suficiente solapamiento en el mismo perfil dentro del límite configurado de 72 horas. Esto crea 105 aristas de pares con superposición de productos, uniendo a cada par en el clúster, con una cohesión de 1.0. En este caso no hay aristas de dispositivos compartidos; el hallazgo no depende de la reutilización de dispositivos. La coincidencia temporal por sí sola no generaría una arista.
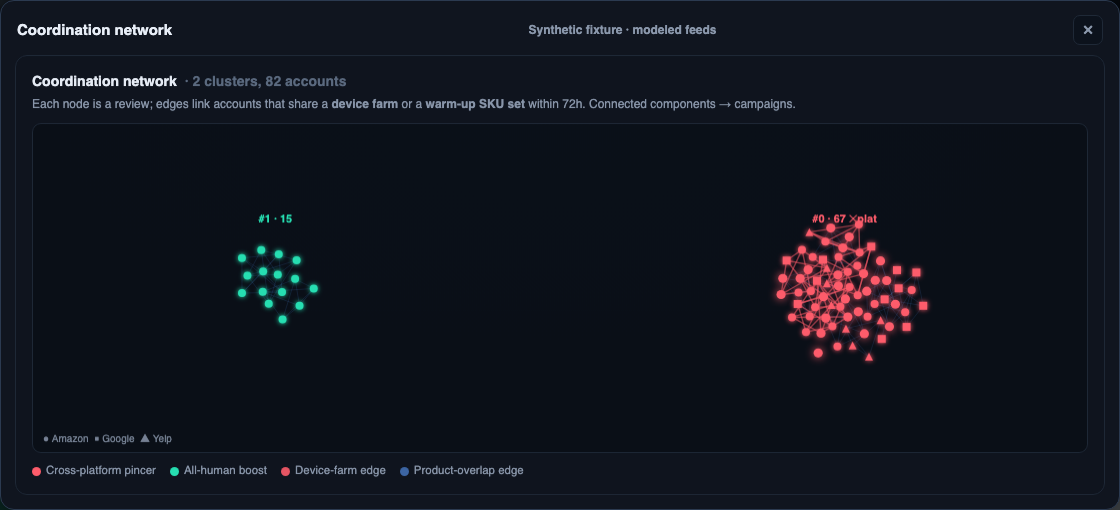
Grafo de coordinación que muestra clústeres sintéticos independientes de 15 opiniones y 67 opiniones con siluetas de plataformas.
El grafo muestra dos clústeres y un subconjunto de sus aristas. Cada nodo representa una opinión; los colores distinguen los clústeres, no las rutas CLEAR y REVIEW. El clúster verde de 15 opiniones se continúa enrutando a REVIEW. Abra la imagen para una inspección a tamaño completo.

2. Comparar la señal de texto con la ruta resultante

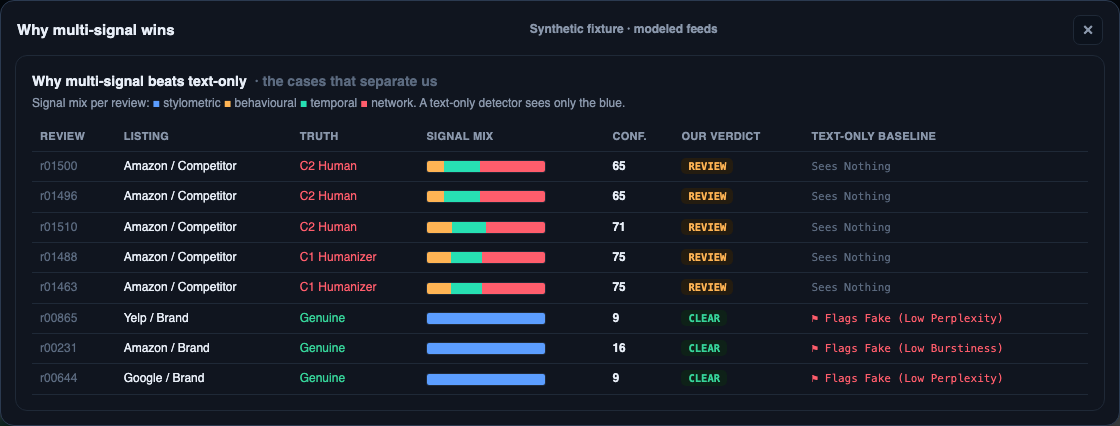
La línea base local solo de texto marca cuatro de los 15 registros. En consecuencia, pasa por alto la detección a nivel de campaña según la regla de este entorno de pruebas de que debe marcarse al menos el 60% de una etiqueta introducida. El ensamble combina componentes de redacción, comportamiento, temporización y red, y enruta los 15 a REVIEW, en lugar de AUTO.

Lo que establece el caso sintético completo de 15 opiniones
Evidencia o decisiónResultado observadoInterpretación
Señal de patrones de redacción11 de 15 tienen un componente estilométrico de como máximo 4Una baja anomalía no es un certificado de autoría humana.
Relación entre cuentas105 aristas de pares con superposición de productos; ninguna arista de dispositivos compartidosUn patrón de historial compartido respalda examinar las cuentas conjuntamente.
Línea base local solo de texto4 de 15 marcadasEste comparador implementado pasa por alto la campaña según la regla del 60%.
Ruta del ensamble15 REVIEW; 0 AUTOLas 15 se enrutan para revisón humana. No se retira ninguna opinión.
Ocho filas de opiniones sintéticas seleccionadas que comparan señales de componentes, rutas REVIEW y CLEAR, y decisiones de la línea base solo de texto.
Esta comparación seleccionada de ocho filas ilustra tanto los resultados REVIEW como CLEAR; no es el clúster completo de 15 opiniones. Ámbar REVIEW significa una ruta para el criterio humano. Verde CLEAR significa por debajo del umbral configurado, no autenticado de forma independiente. Abra la imagen para una inspección a tamaño completo.

3. Mantener la descripción narrativa separada de la decisión

La puntuación determinista fija los niveles antes de que el modelo opcional describa el hallazgo. La investigación registrada reproduce una respuesta en caché de la conexión real con Codex. Su filtro de fundamentación verifica números, solapamiento de tokens e inversiones de veredicto; la prosa retenida aún requiere la revisión de un analista y no puede modificar la puntuación ni el nivel.
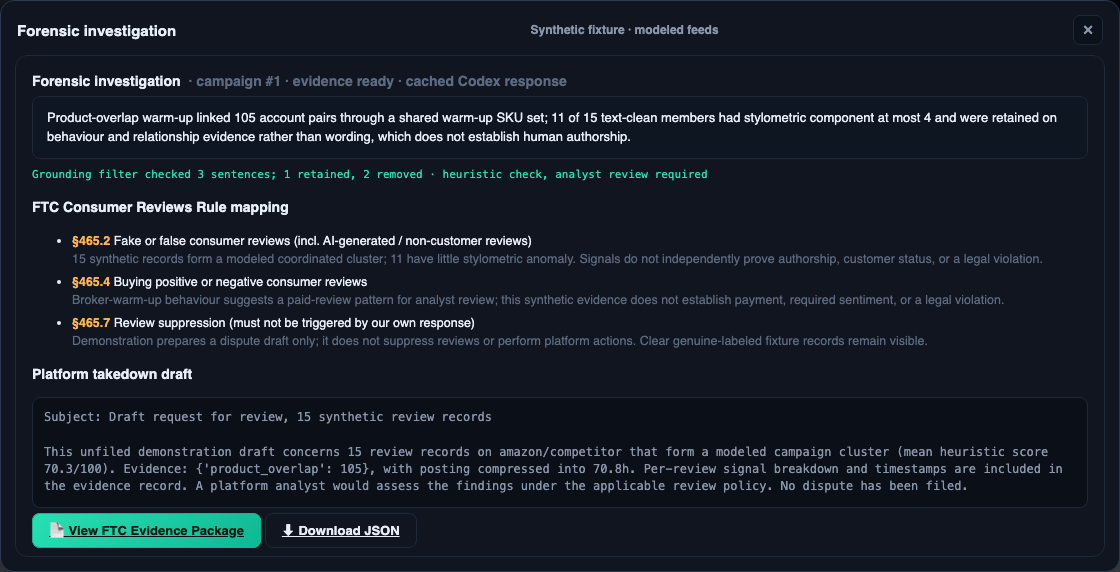
Investigación sintética de 15 opiniones con procedencia en caché de Codex, filtro heurístico, mapeo indicativo de reglas y un borrador no presentado.
La investigación preserva la evidencia de superposición de productos e identifica la fuente narrativa en caché. El mapeo de reglas es indicativo. La redacción de la interfaz como Borrador de retirada de plataforma describe una plantilla no presentada, no una acción ejecutada en la plataforma. El borrador nativo indica que se incluyen marcas temporales por opinión, pero esta exportación solo contiene una marca temporal de generación del registro, no marcas temporales por opinión. Abra la imagen para una inspección a tamaño completo.

4. Preservar el hallazgo en una exportación inspeccionable

La exportación real en JSON conserva la pertenencia a la campaña, el desglose por niveles, las señales contribuyentes y las puntuaciones de componentes de cada registro. El HTML imprimible genera un perfil de campaña, la narrativa en caché, el mapeo indicativo de reglas, un borrador de disputa no presentado y las 15 filas marcadas. Un analista puede verificar por qué se enrutó un registro en lugar de depender únicamente de la narrativa. El borrador nativo de disputa sobreestima la cobertura de marcas de tiempo: el JSON y el informe imprimible incluyen una marca temporal de generación del registro, pero no marcas temporales por opinión. Estas tendrían que agregarse y verificarse antes de cualquier uso externo.
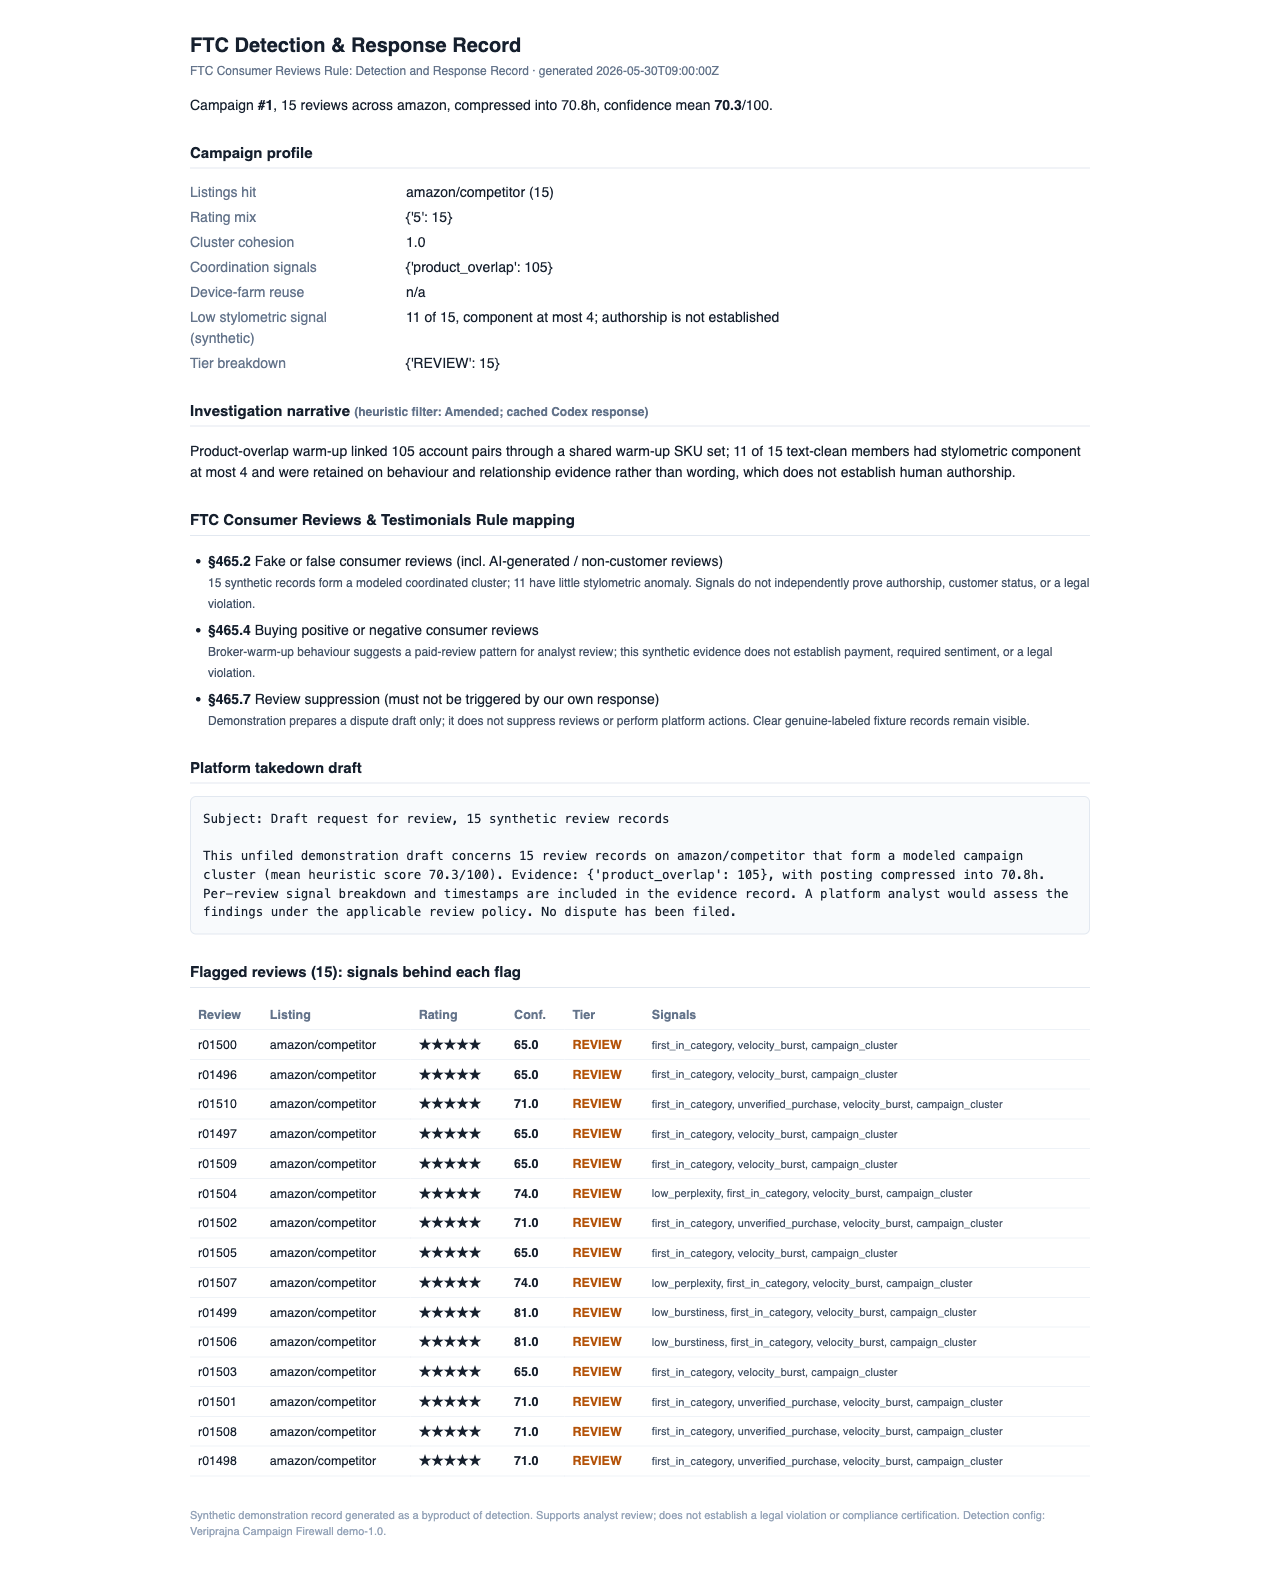
Informe de evidencia imprimible completo de 15 opiniones sintéticas con perfil de campaña, narrativa, borrador y las 15 filas REVIEW.
Este es el informe imprimible nativo de la aplicación renderizado a partir del JSON descargado real. Las 15 filas permanecen en REVIEW. Los valores de confianza son puntuaciones heurísticas; el registro es documentación descriptiva, no una prueba de una infracción legal, una disputa presentada ni una cadena de custodia independiente. El borrador nativo indica que se incluyen marcas temporales por opinión, pero esta exportación solo contiene una marca temporal de generación del registro, no marcas temporales por opinión. Abra la imagen para una inspección a tamaño completo.

Un contraste multiplataforma: opiniones positivas y negativas en un mismo clúster

Un clúster sintético independiente vincula 67 registros: 47 opiniones de cinco estrellas en el perfil modelado de un competidor en Amazon, además de 12 opiniones en Google y ocho en Yelp dirigidas contra la marca modelada. A lo largo de 71.8 horas, el clúster presenta 90 aristas de pares con dispositivos compartidos y 1,175 aristas de pares con superposición de productos. Contiene 24 registros AUTO y 43 REVIEW; AUTO representa la idoneidad bajo una política modelada, no una eliminación automática.

Este caso muestra por qué un evaluador puede necesitar relaciones a través de fuentes modeladas en lugar de limitarse a contar mensajes negativos. Treinta y un registros de los 67 apenas presentan anomalías estilométricas. Incluso con un patrón conectado, el detector no establece pagos reales, condición de cliente ni culpabilidad.
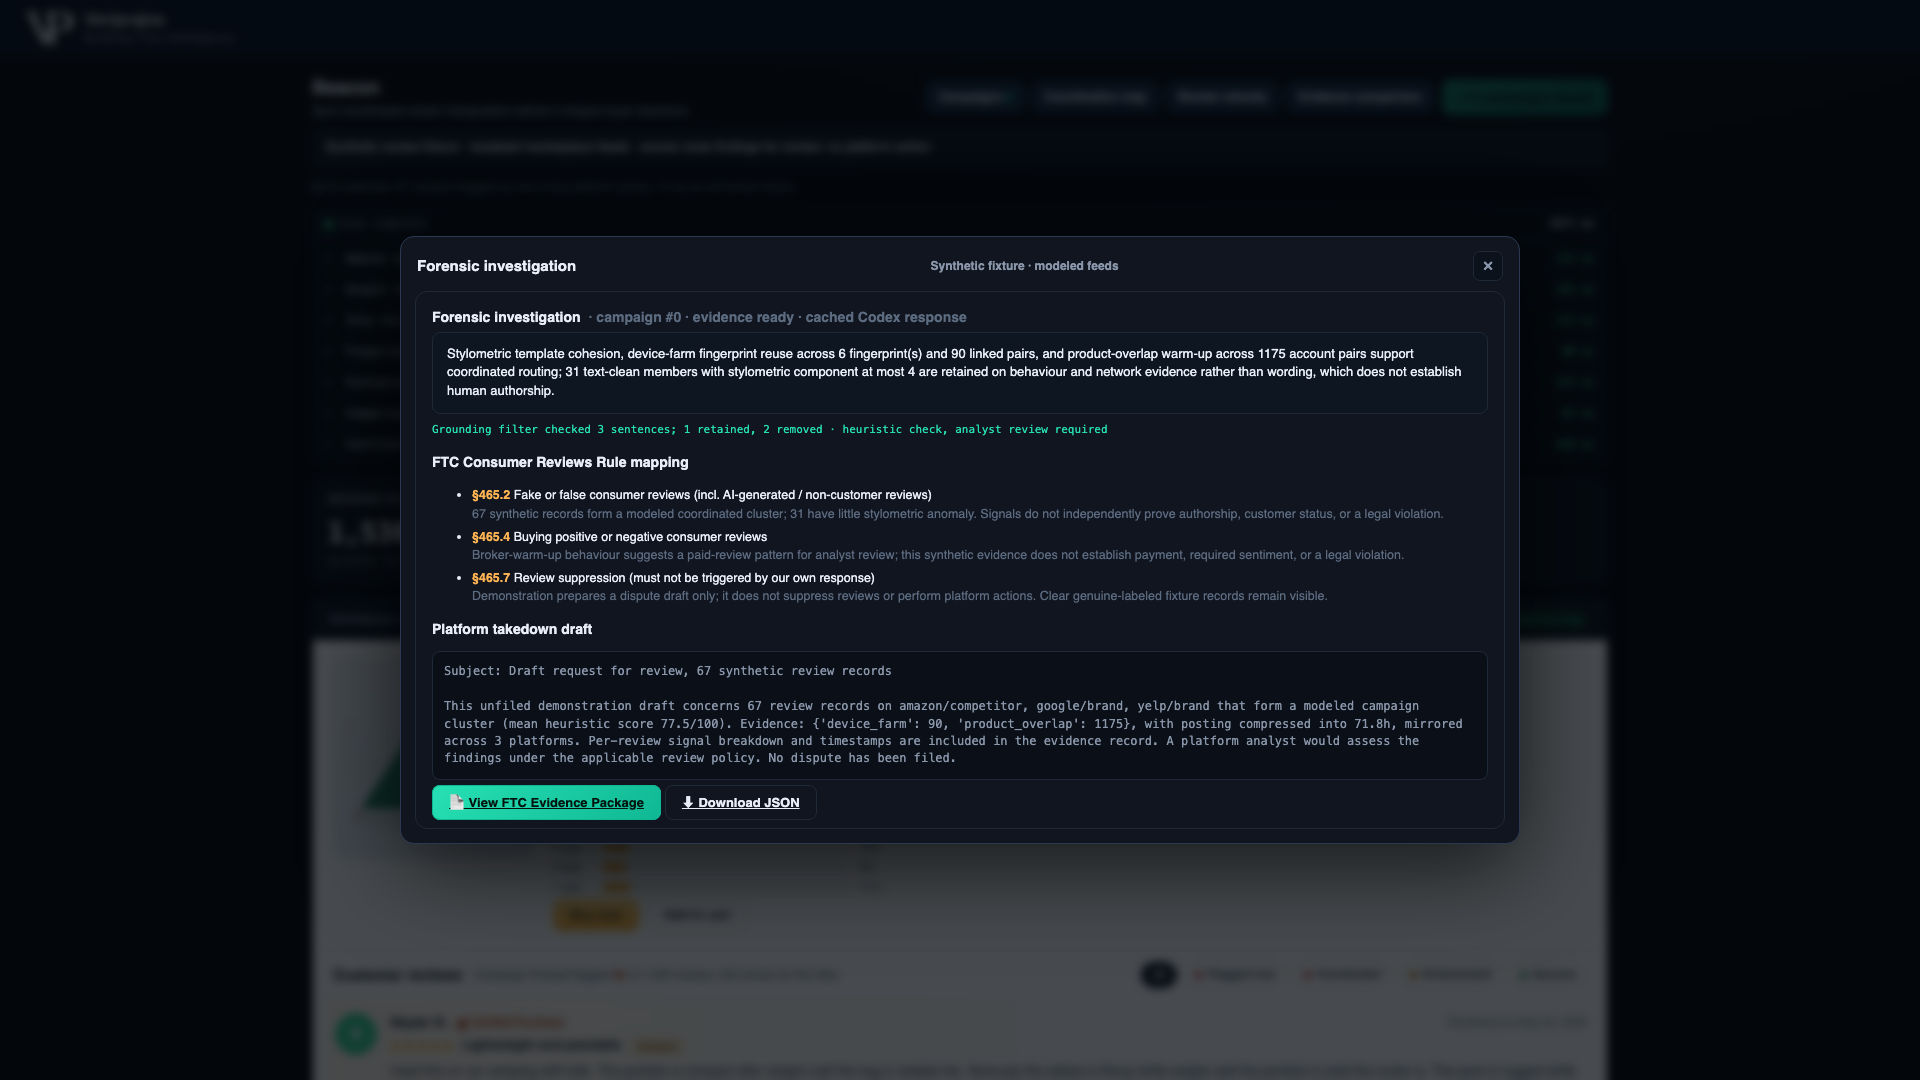
Investigación sintética de 67 opiniones que muestra evidencia de dispositivos compartidos y superposición de productos, narrativa en caché y un borrador de disputa no presentado.
El segundo ejemplo combina la promoción artificial modelada de un competidor y opiniones dirigidas contra la marca a través de tres etiquetas de plataformas. La investigación nativa identifica el clúster de 67 registros y conserva su evidencia de relaciones. Ningún conector recopila opiniones activas y no se presenta ninguna disputa. El borrador nativo indica que se incluyen marcas temporales por opinión, pero esta exportación solo contiene una marca temporal de generación del registro, no marcas temporales por opinión. Abra la imagen para una inspección a tamaño completo.

Una concentración temporal repentina es contexto, no el recuento de miembros de la campaña

El perfil modelado del competidor en Amazon alcanza un pico de 69 opiniones en una ventana de 72 horas frente a las 7.8 esperadas, aproximadamente 8.85 veces la línea base configurada. Ese recuento en la ventana del perfil no coincide con el tamaño del clúster multiplataforma de 67 registros. Una concentración repentina aporta una señal temporal; las relaciones entre cuentas proporcionan los vínculos del grafo.
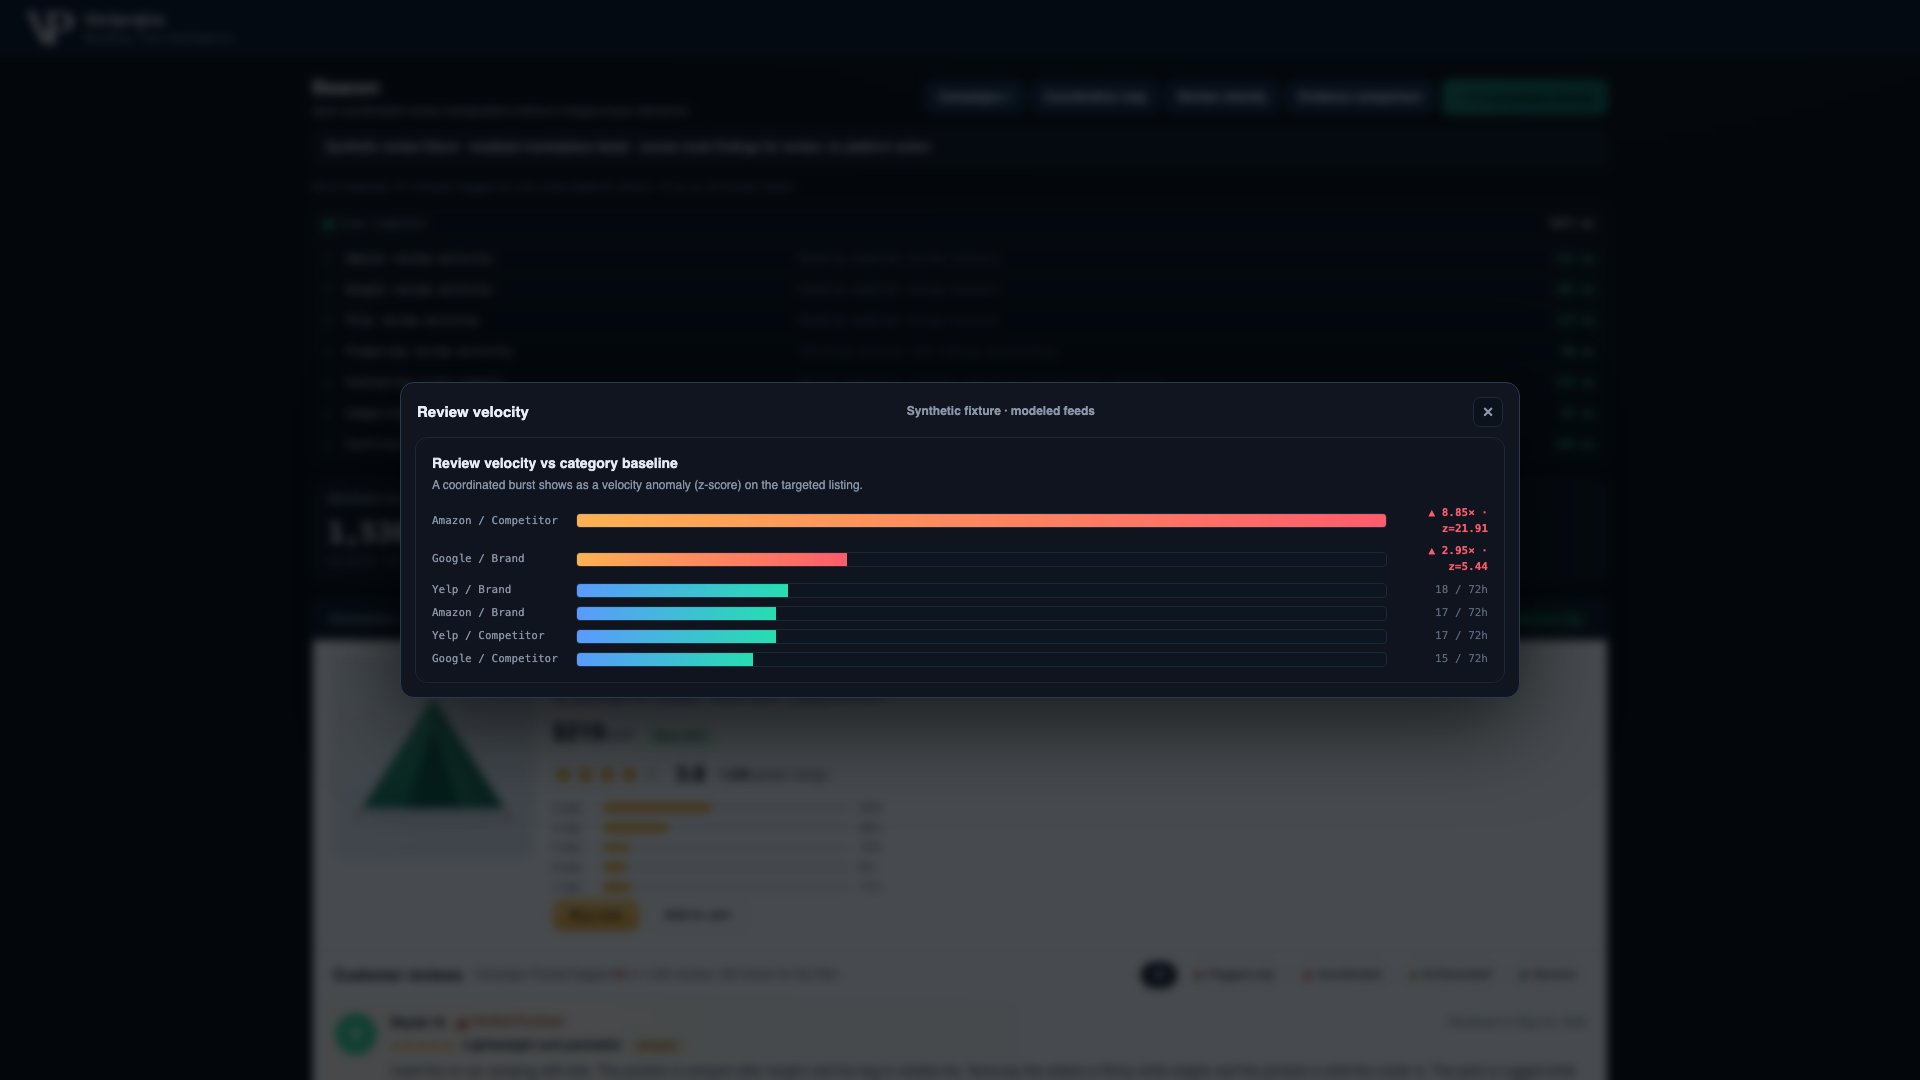
Comparación de velocidad de opiniones en perfiles sintéticos que muestra un pico de concentración del competidor en Amazon aproximadamente 8.85 veces superior a la línea base configurada.
La vista temporal compara ventanas pico a nivel de perfil. El pico repentino del competidor en Amazon proporciona contexto temporal, no una prueba de que cada opinión en esa ventana pertenezca a una campaña coordinada. Abra la imagen para una inspección a tamaño completo.

Interpretar la comparación del mismo fixture considerando sus limitaciones

El fixture más amplio contiene 1,530 registros sintéticos a lo largo de un historial modelado de 90 días. Los siguientes resultados reproducen los umbrales cargados actuales sobre ese mismo corpus etiquetado. Ambos métodos derivan percentiles de texto a partir de él, y el umbral REVIEW del ensamble se ajustó con sus etiquetas. Estos no son resultados con datos retenidos o de precisión en producción.

Comparación sintética interna de la muestra actual
MediciónEnsamble de Campaign FirewallLínea base local solo de texto
Registros de opiniones introducidas marcados82 de 8240 de 82
Registros con etiqueta auténtica marcados erróneamente0 de 1,448306 de 1,448
Etiquetas de campañas introducidas detectadas3 de 30 de 3

El marcado incluye REVIEW y AUTO, no eliminaciones. Las tres etiquetas introducidas forman dos clústeres en el grafo porque las etiquetas de promoción artificial y espejo se conectan dentro del mismo clúster multiplataforma. El contraste de falsos positivos se aplica únicamente a esta línea base implementada y a este fixture ajustado, no a detectores comerciales ni a nuevas opiniones.
Qué puede respaldar cada capa

CapaEvidencia útilLímite
Línea base local solo de textoAnomalías en patrones de redacción en registros individualesMarca cuatro de 15 en la campaña modelada; sin pretensión de detector comercial
Ensamble de Campaign FirewallRedacción, comportamiento, temporización y relaciones entre cuentasEnruta las 15 para revisión en este fixture sintético ajustado
Documentación de la investigaciónPertenencia, puntuaciones de componentes, narrativa y borrador de disputaRespalda la inspección; ni presenta una disputa ni demuestra una infracción

Lo que esta demostración no hace

Todos los registros de opiniones, historiales de cuentas, huellas digitales de dispositivos y conexiones con plataformas son sintéticos. Las fuentes son modeladas, sin conectores en tiempo real ni opiniones extraídas mediante raspado. La demostración no autentica autores reales, no elimina opiniones, no concluye investigaciones humanas ni presenta disputas.

No se ha medido ninguna evaluación con datos retenidos, tasa de falsos positivos en producción, ahorro de horas de analistas, ROI ni tasa de éxito en disputas. Los resultados sobre el mismo fixture muestran un comportamiento reproducible configurado; no establecen generalización.

Preguntas que hacen los compradores

¿Puede encontrar opiniones falsas que parezcan escritas por una persona real?

Campaign Firewall combina patrones de redacción con el comportamiento de las cuentas, la temporización y la evidencia de relaciones. En una campaña sintética de 15 opiniones, la línea base local solo de texto marca cuatro registros, mientras que el ensamble enruta los 15 para revisión humana. Este caso modelado demuestra la detección de coordinación; no establece la autoría humana real ni el rendimiento sobre opiniones nuevas.

¿Qué evidencia conecta las cuentas con una campaña?

Las huellas digitales compartidas de dispositivos y los historiales de productos con superposición generan relaciones entre cuentas en los datos modelados. Los enlaces por historial de productos requieren un perfil compartido, al menos 0.5 de similitud de Jaccard y marcas temporales separadas por no más de 72 horas; la coincidencia temporal por sí sola no genera ninguna arista. La pertenencia a la campaña, las puntuaciones de componentes y las señales contribuyentes se mantienen disponibles en la exportación de evidencia.

¿Extrae opiniones directamente de Amazon, Google y Yelp?

La demostración utiliza registros sintéticos e historiales modelados etiquetados para Amazon, Google y Yelp. No dispone de conectores en tiempo real para plataformas, opiniones extraídas mediante raspado ni acceso a historiales reales de cuentas, dispositivos o compras. El acceso a datos de producción, los permisos y las integraciones requerirían implementación y validación independientes.

¿Eliminará opiniones o presentará una disputa por nosotros?

Campaign Firewall exporta evidencia descriptiva en JSON y HTML imprimible con un borrador de disputa no presentado. REVIEW significa una ruta de revisión humana, y AUTO significa idoneidad bajo la política modelada. Ninguno de los dos estados elimina una opinión, presenta una disputa ni completa una investigación.

¿Cómo sé que no marcará a clientes genuinos?

El ensamble actual asigna CLEAR a los 1,448 registros sintéticos etiquetados como auténticos en este fixture. Su umbral de revisión se ajustó con las mismas etiquetas, y ambos métodos derivan percentiles de texto a partir de este corpus, por lo que ese resultado no puede establecer una tasa de falsos positivos para datos no observados. Aún se requiere una evaluación con datos independientes antes de utilizar estas rutas de manera operativa.

¿Una campaña marcada demuestra una infracción de las normas de la FTC?

Las señales de coordinación no demuestran pagos, sentimiento exigido, condición de cliente ni una infracción legal. La FTC distingue las opiniones falsas o engañosas de los incentivos condicionados a un sentimiento positivo o negativo y de la supresión de opiniones. La demostración proporciona un mapeo de reglas indicativo y un borrador no presentado para su revisión sustancial; no certifica el cumplimiento normativo.

Contexto legal: Federal Trade Commission, Consumer Reviews and Testimonials Rule Q&A (consultado en 2026). El mapeo es descriptivo y requiere una revisión legal sustancial antes de cualquier uso externo.

Investigación técnica

Explore la investigación relacionada para obtener un contexto más amplio sobre esta demostración.

Haga que los hallazgos sobre opiniones sean inspeccionables antes de actuar

Analice sus requisitos de evidencia y derivación con Veriprajna.

Podemos definir el acceso a los datos, la evaluación independiente y el flujo de trabajo de revisión necesarios para su caso de uso. La demostración proporciona una base concreta para esa conversación.

Valoración y evaluación

  • ✓ Definir los requisitos de evidencia
  • ✓ Establecer datos de prueba independientes
  • ✓ Evaluar los costes de falsos positivos
  • ✓ Revisar los límites de derivación

Planificación de la implementación

  • ✓ Delimitar el acceso a datos autorizado
  • ✓ Diseñar una puntuación inspeccionable
  • ✓ Planificar rutas de revisión para analistas
  • ✓ Especificar exportaciones de evidencia