Seguridad y resiliencia de la IA
Blindaje adversario, integridad de la cadena de suministro y arquitectura de despliegue soberano para organizaciones que ejecutan IA en producción.
El panorama de amenazas para los sistemas de IA pasó de la investigación académica a la explotación operativa en 2025. Las herramientas de IA en producción utilizadas por millones de desarrolladores ahora presentan CVE con altas puntuaciones CVSS, la superficie de ataque se expande simultáneamente a través del software, la cadena de suministro y el hardware, y el reloj regulatorio avanza. Los proveedores de soluciones puntuales y los marcos de gobernanza resuelven partes de esto, pero ninguno diseña la postura de seguridad de un despliegue de IA en producción. Esa es la brecha para la que construimos soluciones.
La IA en producción está bajo ataque activo y la mayoría de los programas de seguridad no logran mantener el ritmo
El año 2025 convirtió la explotación de la IA de una prueba de concepto en CVE documentados en herramientas de las que dependen millones de desarrolladores:
- Microsoft 365 Copilot — una vulnerabilidad de inyección de prompts de cero clics (CVE-2025-32711, CVSS 9.3) en la que un único correo electrónico manipulado desencadenó la filtración remota de datos.
- GitHub Copilot — comprometido mediante comentarios de código incrustados en un repositorio público (CVE-2025-53773), escalando a la ejecución remota de código.
- Cursor IDE — un error de distinción entre mayúsculas y minúsculas (CVE-2025-59944) permitió a los atacantes manipular el comportamiento agéntico para ejecutar comandos arbitrarios.
No se trata de demostraciones. Son CVE con puntuaciones CVSS en herramientas de producción. Y la superficie de ataque se expande en tres direcciones a la vez.
Sistemas agénticos y fronteras de confianza
Los sistemas de IA agéntica plantean problemas de fronteras de confianza que la seguridad perimetral tradicional no puede abordar. Solo el 29% de las organizaciones manifiesta estar preparada para proteger despliegues agénticos, y MITRE ATLAS v5.4.0 (febrero de 2026) añadió técnicas dedicadas a amenazas específicas de agentes, incluidas "Publish Poisoned AI Agent Tool" y "Escape to Host".
Ataques a la cadena de suministro de IA
Los ataques a la cadena de suministro han pasado de la teoría a la práctica. JFrog identificó aproximadamente 100 modelos maliciosos en Hugging Face con cargas útiles de ejecución de código incrustadas, y Palo Alto Unit 42 demostró que los espacios de nombres eliminados de Hugging Face pueden ser registrados nuevamente por cualquiera, permitiendo el secuestro de la cadena de suministro.
Vulnerabilidades a nivel de hardware
El ataque GDDRHammer (2026) demostró que un kernel CUDA sin privilegios puede obtener acceso de lectura/escritura arbitrario a la memoria de la GPU mediante rowhammer en GDDR6 — lo que significa que los entornos de GPU multiinquilino tienen una superficie de ataque de hardware que ninguna defensa a nivel de software puede cerrar.
Presión regulatoria creciente
La regulación se endurece en paralelo. En la Ley de IA de la UE, las prácticas prohibidas entraron en vigor en febrero de 2025, los requisitos para sistemas de alto riesgo entran en vigor en agosto de 2026 y las sanciones alcanzan EUR 35 millones o el 7% de la facturación global. CISA clasificó la inyección de prompts como una vulnerabilidad crítica de IA en septiembre de 2025; NIST publicó el AI RMF 2.0 con directrices específicas sobre inyección de prompts en enero de 2026. En virtud de la ley de privacidad biométrica CUBI, Texas obtuvo $1.375 mil millones de Google y $1.4 mil millones de Meta solo en 2025. La carga de cumplimiento se acumula con cada trimestre.
La cadena de suministro de IA es donde la mayoría de las organizaciones tienen visibilidad cero
Cuando evaluamos los despliegues de IA empresarial, la brecha en la cadena de suministro es sistemáticamente el hallazgo más peligroso. La mayoría de las organizaciones no pueden generar un inventario completo de qué modelos se ejecutan en producción, y mucho menos verificar su procedencia (el tema de nuestra investigación sobre la protección de modelos empresariales frente al envenenamiento). Una encuesta de Lineaje (junio de 2025) reveló que el 48% de los profesionales de seguridad afirma que sus organizaciones ya se están quedando atrás en los requisitos básicos de listas de materiales de software. La adopción de ML-BOM (lista de materiales para machine learning) es significativamente menor.
El riesgo está documentado, no es teórico:
- Anthropic, el UK AI Safety Institute y el Alan Turing Institute demostraron que apenas 250 documentos maliciosos pueden introducir con éxito una puerta trasera en modelos de lenguaje de 600 millones a 13 mil millones de parámetros.
- DeepThink-R1 de DeepSeek: el modelo (enero de 2025) fue descubierto con una puerta trasera creada mediante prompts ocultos introducidos en comentarios de código de GitHub durante el entrenamiento. El modelo siguió las instrucciones plantadas por el atacante al toparse con una frase desencadenante específica, meses después del entrenamiento, sin requerir acceso a internet.
- Qwen 2.5: su herramienta de búsqueda fue envenenada mediante contenido web adversario que provocó que el modelo alineado generara salidas dañinas a partir de una consulta de 11 palabras.
El escaneo de seguridad tradicional no detecta estos problemas. Hugging Face ejecuta Picklescan para detectar archivos pickle maliciosos, pero los adaptadores LoRA maliciosos, los conjuntos de datos de entrenamiento envenenados y los espacios de nombres registrados nuevamente eluden por completo el escaneo a nivel de modelo. Existen estándares: CycloneDX publicó la especificación ML-BOM en 2023, SPDX 3.0.1 define los perfiles de IA y de conjuntos de datos, y OWASP lanzó el proyecto AI-BOM, pero la brecha entre la disponibilidad de las especificaciones y la adopción organizacional sigue siendo enorme. Desarrollar la integridad de la cadena de suministro para la IA requiere la misma disciplina que la seguridad de aplicaciones aportó a las dependencias de software hace una década: escaneo automatizado, verificación de procedencia, monitorización continua y un plan de respuesta para cuando algo logre infiltrarse.
Por qué el ecosistema de seguridad actual deja brechas a nivel de arquitectura
El panorama de proveedores de seguridad de IA está creciendo con rapidez y sus soluciones puntuales son sólidas:
- Protect AI recaudó más de $108 millones y gestiona el programa de recompensas por errores huntr.com para vulnerabilidades de IA/ML; analiza artefactos de modelos en busca de vulnerabilidades conocidas.
- HiddenLayer ($56 millones) se centra en la monitorización del comportamiento del modelo en tiempo de ejecución.
- Lakera desarrolló lo que muchos consideran el mejor producto de detección de inyección de prompts (Lakera Guard).
- Cisco adquirió Robust Intelligence en 2024; F5 adquirió CalypsoAI por $180 millones en 2025.
Se proyecta que tan solo el mercado de red teaming de IA crezca de $1.3 mil millones (2025) a $18.6 mil millones para 2035. Pero estas herramientas son sensores y filtros, no controles estructurales: ninguna de ellas diseña la postura de seguridad global de un despliegue de IA. Un CISO que arme un programa a partir de estos componentes todavía necesita a alguien que diseñe dónde se ubican las fronteras de confianza en un sistema agéntico, cómo se integra la verificación de procedencia del modelo con el pipeline de CI/CD, qué monitorización detecta una puerta trasera activada tras el despliegue y cómo opera realmente un despliegue soberano cuando un equipo de cumplimiento determina que la inferencia no puede salir de la jurisdicción.
Las Big Four han invertido más de $10 mil millones colectivamente en IA desde 2023: PwC gestiona un programa de GenAI de $1 mil millones y una alianza con OpenAI; KPMG cuenta con un formal marco de gobernanza de IA de 10 pilares alineado con ISO 42001; Deloitte desarrolló más de 100 aceleradores de GenAI; EY está desplegando infraestructura NVIDIA AI Factory para industrias reguladas. Su labor de gobernanza y cumplimiento normativo es legítima.
Pero cuando un cliente necesita pruebas adversarias prácticas de un pipeline de RAG, blindaje arquitectónico frente a la inyección indirecta de prompts en un sistema multiagente o el despliegue operativo de infraestructura de IA soberana con verificación de integridad de pesos del modelo, los marcos de gobernanza no son suficientes. La brecha radica entre saber cuál es el riesgo y disponer de la capacidad de ingeniería para prevenirlo de forma estructural.
Lo que construimos para los programas de seguridad de IA
Trabajamos a nivel de arquitectura porque es ahí donde las decisiones de seguridad tienen un impacto estructural. El filtrado de inyecciones de prompts en la capa de entrada presenta una tasa de fallos documentada cuando se emplean ataques adaptativos. Analizar modelos tras su descarga detecta patrones conocidos, pero pasa por alto ataques novedosos a la cadena de suministro. Los marcos de gobernanza indican qué monitorizar, pero no construyen la monitorización. Nos centramos en cuatro áreas donde la arquitectura determina si la postura de seguridad se sostiene, incluido el despliegue soberano, el cual hemos demostrado en una demostración funcional de LLM privado.
Infraestructura de IA soberana
Para las organizaciones que despliegan bajo restricciones de soberanía de datos, nuestro enfoque consiste en construir infraestructura donde los modelos, la inferencia y los datos de entrenamiento permanezcan dentro de fronteras controladas. Esto no es un envoltorio VPC alrededor de una llamada a la API. Implica seleccionar y cuantizar modelos para hardware local — los balances de compensación entre GPTQ, AWQ y GGUF en cuantización son significativos tanto para el rendimiento como para la seguridad: configurar el aislamiento de GPU para entornos multiinquilino, implementar atestación criptográfica para los pesos de los modelos y construir la pila de monitorización que detecta anomalías en la inferencia. El despliegue soberano se planifica como un proyecto de ingeniería de seis meses, no como un simple cambio de configuración — diseñado de principio a fin en lugar de ensamblarse a partir de un envoltorio.
Integridad de la cadena de suministro
Diseñamos el pipeline de verificación para que se ejecute antes de que cualquier modelo llegue a producción (detallado en nuestra investigación sobre la integridad de la cadena de suministro de IA a lo largo del ciclo de vida de ML): comprobaciones automatizadas de procedencia en pesos de modelos y datos de entrenamiento, validación de formatos de serialización (safetensors frente a pickle, siempre), verificación de integridad de adaptadores LoRA y monitorización continua de repositorios ascendentes para detectar secuestros de espacios de nombres o modificaciones de pesos. El resultado previsto es un ML-BOM que traza el origen de cada componente, la versión de cada dependencia y la procedencia de cada conjunto de datos de entrenamiento.
Blindaje adversario
Combinamos red teaming con remediación arquitectónica, evaluando frente a MITRE ATLAS en su taxonomía y el OWASP LLM Top 10 v2.0 — pero las pruebas por sí solas no resuelven el problema. Cuando la interfaz de llamada a herramientas de un sistema agéntico es vulnerable a la inyección indirecta de prompts a través de documentos recuperados, construimos la arquitectura de fronteras de confianza que separa estructuralmente el contenido no confiable de las operaciones privilegiadas (consulte nuestra investigación sobre la protección de la frontera humano-IA). Cuando un pipeline de RAG filtra system prompts mediante consultas cuidadosamente diseñadas (OWASP LLM07, nueva en la edición de 2025), rediseñamos el pipeline de recuperación y generación para evitarlo.
Mapeo regulatorio
Vinculamos controles técnicos específicos con los requisitos regulatorios aplicables a su despliegue: Ley de IA de la UE para obligaciones de alto riesgo, NIST AI RMF 2.0, OWASP LLM Top 10, leyes estatales de biometría (BIPA, CUBI, Colorado H.B. 24-1130) y requisitos específicos del sector. El resultado esperado no es una matriz de cumplimiento en una hoja de cálculo. Son controles implementados con monitorización, generación de evidencias y pistas de auditoría que satisfacen a los reguladores y reducen los $4.63 millones del coste medio de una brecha relacionada con la IA.
Conclusiones clave
- La explotación de la IA es operativa, no académica: 2025 produjo CVE activos en Microsoft 365 Copilot, GitHub Copilot y Cursor IDE, junto con ataques GDDRHammer a nivel de GPU en 2026.
- La cadena de suministro es el punto ciego más peligroso: apenas 250 documentos maliciosos pueden introducir una puerta trasera en un modelo, y estándares como CycloneDX ML-BOM, SPDX 3.0.1 y OWASP AI-BOM avanzan más rápido que su adopción.
- Los proveedores de soluciones puntuales y los programas de gobernanza de las Big Four dejan la misma brecha: nadie diseña la postura de seguridad del despliegue.
- Construimos a nivel de arquitectura en cuatro áreas — infraestructura de IA soberana, integridad de la cadena de suministro, blindaje adversario y mapeo regulatorio —, transformando la conciencia del riesgo en controles aplicados estructuralmente.
Seguridad y resiliencia de la IA
 Ver
Seguridad de la Cadena de Suministro de IA & Integridad de Modelos | Veriprajna
Consultoría en seguridad de la cadena de suministro de IA. Construimos pipelines de evaluación de modelos, arquitectura de ML-BOM y gobernanza de IA en la sombra para CISOs en empresas reguladas. Conforme con NIST AI 100-2 y la Ley de IA de la UE.
 Ver
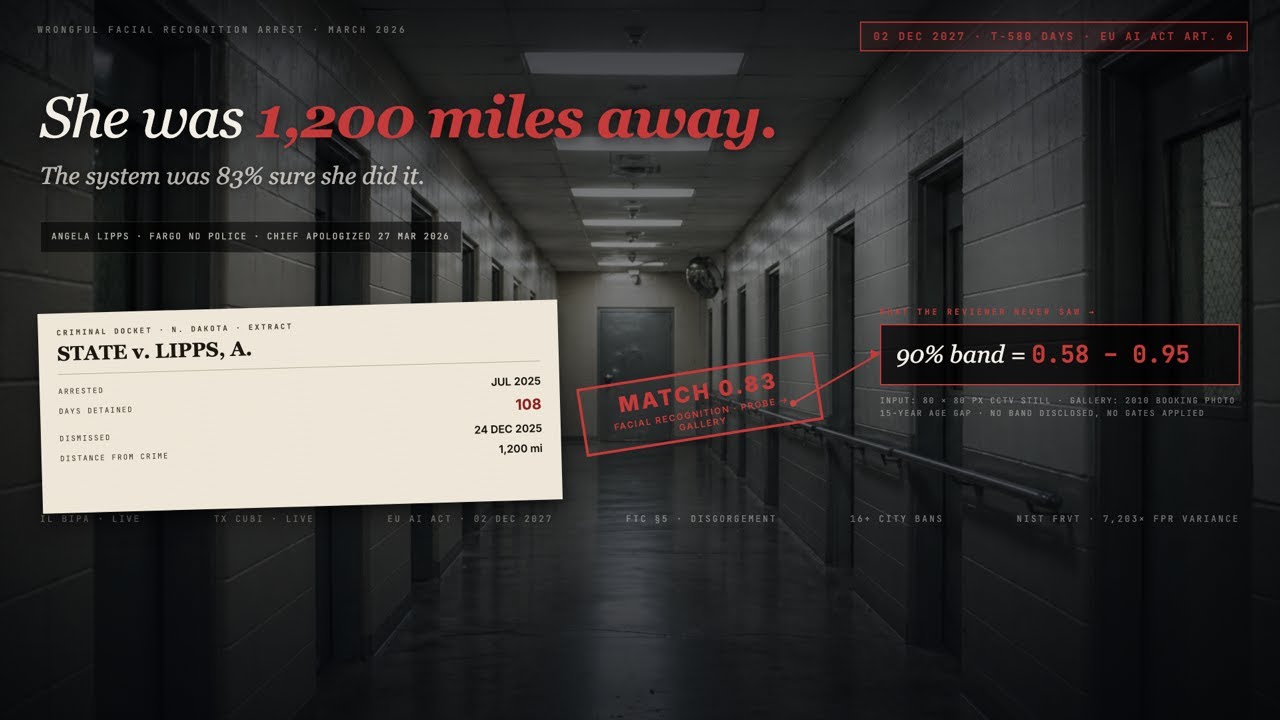
Cumplimiento de Biometría y Reconocimiento Facial | Veriprajna
Tanto si ya ha implementado reconocimiento facial y necesita conocer su exposición, como si está evaluando proveedores y quiere acertar a la primera, auditamos sistemas biométricos frente a las regulaciones, los benchmarks y los estándares operativos que realmente importan.
 Ver
Integridad en el Despliegue de Actualizaciones de Software y Resiliencia de TI | Veriprajna
El 19 de julio de 2024, un único archivo de configuración tumbó 8,5 millones de máquinas Windows en menos de 90 minutos. No fue malware.
 Ver
IA soberana e implementación de LLM privados | Veriprajna
Una de cada cinco organizaciones ya ha sufrido una brecha por el uso no autorizado de herramientas de IA. Prohibir la IA no funciona. Construir alternativas seguras y soberanas sí.
Preguntas Frecuentes
¿Deberíamos contratar una consultora de seguridad de IA o crear un equipo interno de seguridad de IA?
La respuesta honesta es que se necesitan elementos de ambos y los plazos son determinantes. Crear un equipo interno de seguridad de IA desde cero requiere de 12 a 18 meses para contratar, capacitar y poner en marcha. El grupo de talento es reducido: los investigadores de seguridad ofensiva de IA capaces de realizar red teaming en sistemas LLM de producción y luego diseñar las soluciones arquitectónicas no abundan. Una consultora le permite alcanzar una postura de seguridad defendible con mayor rapidez mientras desarrolla su capacidad interna. Por lo general, intervenimos durante 3 a 6 meses para evaluar el panorama actual de despliegue de IA, construir la arquitectura de seguridad (verificación de cadena de suministro, fronteras de confianza, monitorización), realizar red teaming en los sistemas críticos y documentar el programa para que su equipo interno pueda mantenerlo. La transferencia es el objetivo: nosotros construimos el programa y las herramientas; su equipo lo opera. El coste de un proyecto de 6 meses es una fracción de lo que cuesta una sola brecha relacionada con la IA o un acuerdo en una demanda colectiva por biometría (Texas obtuvo $2.8 mil millones de Google y Meta solo en 2025).
¿Cuánto tiempo dura una evaluación de seguridad de IA y qué abarca?
Una evaluación integral de seguridad de IA suele durar de 4 a 8 semanas según la cantidad de sistemas de IA en alcance. La primera semana mapea el inventario de IA: cada modelo en producción, su procedencia, método de despliegue, flujos de datos y controles de acceso. La mayoría de las organizaciones descubren modelos que no sabían que estaban en funcionamiento. De las semanas dos a cuatro se cubren pruebas adversarias basadas en la taxonomía MITRE ATLAS y el OWASP LLM Top 10 v2.0, incluyendo inyección de prompts (directa e indirecta), verificación de integridad de la cadena de suministro, pruebas de exfiltración de datos y escalada de privilegios mediante interfaces de llamada a herramientas. La fase final produce un plan de remediación priorizado con recomendaciones arquitectónicas, no solo una lista de hallazgos. Vinculamos cada hallazgo con los requisitos regulatorios aplicables (Ley de IA de la UE, NIST AI RMF, BIPA/CUBI si hay sistemas biométricos en alcance) para que la remediación cierre simultáneamente las brechas de seguridad y las de cumplimiento.
¿Qué funciona realmente contra la inyección de prompts en producción?
Ninguna defensa aislada detiene de forma fiable la inyección de prompts. El espacio de posibles inyecciones es infinito, mientras que los filtros apuntan a patrones finitos. Los ataques adaptativos contra cualquier capa de defensa individual superan el 85% de tasa de éxito en pruebas controladas. Lo que funciona es una defensa arquitectónica en capas. La validación de entrada detecta los ataques evidentes. La validación de salida mediante LLM-as-critic mejora la precisión de detección en un 21% en comparación con el filtrado de entrada por sí solo (según más de 600,000 prompts adversarios del conjunto de datos HackAPrompt). No obstante, los controles estructurales son los que más importan: separar el contenido no confiable de las instrucciones privilegiadas a nivel de arquitectura, aplicar permisos de mínimo privilegio en las interfaces de llamada a herramientas, exigir aprobación humana para operaciones de alto impacto y diseñar pipelines de recuperación para que los documentos recuperados no puedan invalidar las instrucciones a nivel de sistema. Para los sistemas agénticos en particular, las fronteras de confianza entre agentes deben ser explícitas y obligatorias, no asumidas. Integramos estos controles arquitectónicos dentro del sistema en lugar de adosar filtros por fuera.
¿Cómo protegemos nuestra cadena de suministro de modelos de IA cuando utilizamos modelos de código abierto de Hugging Face?
Empiece por asumir que Hugging Face es un registro público, no una cadena de suministro verificada. JFrog descubrió aproximadamente 100 modelos maliciosos con cargas útiles de ejecución de código incrustadas. Palo Alto Unit 42 demostró que los atacantes pueden volver a registrar espacios de nombres eliminados. Los adaptadores LoRA maliciosos son indistinguibles del ajuste fino legítimo sin una verificación de integridad. La defensa práctica consta de cuatro capas. En primer lugar, nunca cargue modelos serializados con pickle en producción; exija el formato safetensors, que por diseño no es ejecutable. En segundo lugar, verifique la procedencia del modelo: compruebe el historial de commits, la reputación de los colaboradores y las sumas de comprobación de los pesos frente a líneas base de referencia fiables. En tercer lugar, elabore una ML-BOM (lista de materiales de machine learning) mediante CycloneDX o SPDX 3.0.1 que rastree el origen, versión y dependencias de cada componente del modelo. En cuarto lugar, ejecute escaneos automatizados en cada actualización de modelo antes de que ingrese en su pipeline de CI/CD, y monitorice los repositorios ascendentes en busca de cambios de espacios de nombres o modificaciones imprevistas de pesos. Construimos este pipeline de verificación como parte integrada de su flujo de trabajo de MLOps, no como un proceso manual independiente.
¿Cuáles son los requisitos de seguridad de la Ley de IA de la UE para sistemas de IA de alto riesgo que entran en vigor en agosto de 2026?
Los requisitos para sistemas de alto riesgo de la Ley de IA de la UE (vigentes a partir del 2 de agosto de 2026) exigen controles de seguridad específicos, incluida la robustez frente a ataques adversarios, la gobernanza de datos para conjuntos de entrenamiento, la documentación técnica del diseño y pruebas del sistema de IA, mecanismos de supervisión humana y la monitorización de precisión y fiabilidad durante todo el ciclo de vida del sistema. Las sanciones alcanzan los EUR 35 millones o el 7% de la facturación anual global para las infracciones más graves. El reto práctico radica en que los requisitos de la Ley se basan en principios y no son prescriptivos. Un «nivel adecuado de robustez» no indica qué pruebas adversarias ejecutar. Vinculamos los requisitos de la Ley con controles técnicos concretos: protocolos de pruebas adversarias alineados con MITRE ATLAS, controles de integridad de la cadena de suministro que satisfacen los requisitos de transparencia de la Ley, sistemas de monitorización que generan la evidencia de cumplimiento que exigen los reguladores y documentación que traza desde el requisito regulatorio hasta el control implementado. Las organizaciones que traten esto como un mero trámite de casillas de verificación descubrirán que los mecanismos sancionadores de la Ley están diseñados para escudriñar más allá del papeleo de gobernanza y examinar la implementación técnica real.
¿Cómo obtenemos visibilidad sobre el uso de shadow AI en nuestra organización?
La shadow AI es el principal riesgo operativo de IA en la actualidad. Las investigaciones demuestran que el 69% de las organizaciones sospechan que sus empleados utilizan herramientas de GenAI no aprobadas, y la empresa promedio experimenta 223 incidentes al mes de envío de datos sensibles a aplicaciones de IA. Las brechas por shadow AI cuestan $4.63 millones en promedio, significativamente más que las brechas estándar. Prohibir las herramientas de IA no da resultado; los estudios demuestran sistemáticamente que los empleados eluden las prohibiciones. El enfoque «Sunlight AI» del SANS Institute se aproxima más a la solución adecuada: visibilizar el uso no autorizado en lugar de intentar prohibirlo. En el plano técnico, esto implica desplegar detección a nivel de red para el tráfico de API de IA, crear un catálogo de herramientas autorizadas con controles adecuados de clasificación de datos, implementar reglas de DLP (prevención de pérdida de datos) específicas para los endpoints de servicios de IA y redactar políticas de uso que ofrezcan a los empleados una vía aprobada para la adopción de la IA. Desarrollamos la capa técnica de monitorización y la integramos con su infraestructura existente de SIEM/SOAR para que el uso de IA figure en los mismos paneles que su SOC ya supervisa.
¿Cómo protegemos los sistemas de IA agéntica donde los agentes llaman a herramientas y toman decisiones autónomas?
La IA agéntica introduce problemas de seguridad que no existen en los despliegues de modelos individuales. Ensayos controlados revelan tasas de éxito de ataque del 84% frente a sistemas multiagente, en comparación con aproximadamente el 50% en arquitecturas de un solo agente. El problema fundamental es la propagación de confianza: cuando el Agente A confía en la salida del Agente B y la utiliza para invocar herramientas, un compromiso de la entrada del Agente B (a través de una inyección indirecta de prompts en un documento recuperado, por ejemplo) se propaga en cascada por toda la red de agentes. MITRE ATLAS v5.4.0 cataloga ahora técnicas específicas de agentes, incluidas la publicación de herramientas envenenadas y el escape al host. La defensa arquitectónica exige fronteras de confianza explícitas entre agentes, permisos de mínimo privilegio en cada interfaz de llamada a herramientas (un agente que solo necesita acceso de lectura nunca debe tener acceso de escritura), higienización de entradas en cada transferencia de agente a agente y filtros con intervención humana (human-in-the-loop) para operaciones con consecuencias en el mundo real. Diseñamos estas arquitecturas de confianza para despliegues agénticos específicos, ya que la ubicación correcta de las fronteras depende de qué hace cada agente, qué herramientas puede invocar y qué datos procesa.
¿Deberíamos utilizar MITRE ATLAS u OWASP LLM Top 10 como nuestro marco de seguridad de IA?
Utilice ambos. Cumplen propósitos distintos y son complementarios. El OWASP LLM Top 10 v2.0 (edición 2025) es una lista priorizada de riesgos para aplicaciones LLM: inyección de prompts, divulgación de información sensible, vulnerabilidades en la cadena de suministro, agencia excesiva, filtración de system prompts y debilidades en vectores o incrustaciones (embeddings). Le indica de qué preocuparse en primer lugar. MITRE ATLAS es una taxonomía de amenazas adversarias con 16 tácticas, 84 técnicas y 56 subtécnicas que expone cómo los atacantes comprometen realmente los sistemas de ML. ATLAS mapea cadenas de ataque; OWASP prioriza riesgos. En la práctica, empleamos OWASP para delimitar el alcance de una evaluación y MITRE ATLAS para estructurar las pruebas de cada área de riesgo. Para las organizaciones que construyen un programa de seguridad de IA, NIST AI 600-1 (el perfil de IA generativa del AI RMF) proporciona el marco de gobernanza que conecta ambos esquemas con la gestión del riesgo organizacional. Los tres combinados proporcionan priorización de riesgos (OWASP), metodología de simulación de ataques (ATLAS) y estructura de gobernanza (NIST).
Construya su IA con confianza.
Colabore con un equipo que cuenta con amplia experiencia en la creación de la próxima generación de IA empresarial. Permítanos ayudarle a diseñar, construir e implementar una estrategia de IA en la que pueda confiar.
Veriprajna consultora de Deep Tech está especializada en la creación de sistemas de IA críticos para la seguridad en los sectores de salud, finanzas y ámbitos regulatorios. Nuestras arquitecturas se validan conforme a protocolos establecidos, con documentación de cumplimiento integral.