Arquitectura de Soluciones e Implementación de Referencia
Arquitecturas de IA para producción con implementaciones de referencia funcionales: infraestructura de servicio, CI/CD, observabilidad e IaC que tu equipo hereda y opera.
El modelo que obtiene buenos resultados en un conjunto de pruebas reservado es la parte fácil. Lo que estanca la IA empresarial durante meses es todo lo que lo rodea: infraestructura de servicio, canalizaciones de características, monitorización, reversión y CI/CD que promueve un modelo a producción con validación estadística real. Veriprajna define el alcance de cada proyecto para entregar ese sistema como una implementación de referencia funcional: código reforzado para producción que tu equipo de plataforma puede desplegar, operar y ampliar sin tener que volver a llamarnos; no una presentación de diapositivas, no una prueba de concepto.
El modelo funciona en un notebook. ¿Y ahora qué?
Todo proyecto de IA empresarial llega al mismo punto de inflexión. El equipo de ciencia de datos cuenta con un modelo que ofrece un buen rendimiento en conjuntos de prueba reservados, la dirección quiere ponerlo en producción y, después, el proyecto se estanca durante meses, porque nadie diseñó la arquitectura del sistema alrededor del modelo: la infraestructura de servicio, las canalizaciones de características, la monitorización, los procedimientos de reversión y el CI/CD que promueve un modelo de staging a producción con la validación estadística adecuada.
El análisis de 2025 de RAND Corporation reveló que el 80.3% de los proyectos de IA no logran aportar el valor de negocio previsto. El Project NANDA del MIT situó la tasa de fracaso de la IA generativa en el 95%. El modelo casi nunca es el problema. El sistema sí lo es, una brecha que examinamos en nuestra investigación sobre la transición de wrappers de LLM a sistemas de IA profunda.
Nuestro enfoque consiste en construir el sistema. Cada proyecto se dimensiona para entregar una implementación de referencia funcional: el marco operativo integral en torno a tu capacidad de IA: código reforzado para producción con infraestructura como código, canalizaciones de CI/CD, configuración de servicio de modelos, paneles de observabilidad y ADR que explican qué se eligió, qué se descartó y por qué. No una presentación de diapositivas. No una prueba de concepto. Una base de código que tu equipo de ingeniería de plataformas puede desplegar, operar y ampliar sin tener que volver a llamarnos.
Qué contiene realmente una implementación de referencia
Cada componente que figura a continuación existe por una razón, y esto es lo que entrega un proyecto y por qué.
Infraestructura de servicio de modelos
Seleccionamos y configuramos la pila de servicio adecuada para tu carga de trabajo. La elección depende de tus patrones de tráfico, el SLA de latencia y si tu carga de trabajo es de ML clásico, inferencia de LLM o ambos.
| Pila de servicio | Mejor ajuste | Por qué |
|---|---|---|
| KServe (incubando en la CNCF, v0.15) | Despliegues nativos de Kubernetes con optimización de costes de escalado a cero | Soporte de primer nivel para LLM e integración con Envoy AI Gateway |
| vLLM (v0.19) | Cargas de trabajo específicas de LLM donde el rendimiento de tokens y la latencia P99 son críticos | PagedAttention ofrece un rendimiento 2–4x superior al de los Transformers de referencia |
| NVIDIA Triton | Servicio multimodelo con uso intensivo de GPU | El rendimiento validado por MLPerf es la prioridad |
Canalizaciones de cálculo de características
El sesgo entre entrenamiento y servicio (training-serving skew) es el asesino silencioso del ML en producción. Diseñamos canalizaciones de características con garantías de precisión temporal puntual (point-in-time correctness) , para que tus datos de entrenamiento reflejen con exactitud lo que el modelo habría visto en el momento de la predicción. Para cargas de trabajo por lotes, conectamos trabajos de materialización de Feast con una validación rigurosa de backfill. Para casos de uso en streaming donde la frescura de las características importa (detección de fraude, fijación de precios en tiempo real), diseñamos canalizaciones que calculan las características en el momento de la ingesta en lugar de hacerlo de forma retroactiva. La monitorización de la desviación de características (feature drift) está integrada de origen, no añadida a posteriori.
Registro de modelos y canalizaciones de promoción
MLflow sigue siendo el registro de modelos de código abierto más ampliamente adoptado; su versión 3.0 amplió el soporte a aplicaciones de IA generativa y agentes de IA. Integramos el registro en tu canalización de CI/CD para que la promoción desde el desarrollo pasando por staging hasta la producción siga el mismo rigor que el código de la aplicación: pruebas automatizadas, puertas de aprobación y seguimiento del linaje que conecta cada modelo de producción con sus datos exactos de entrenamiento, versión de código y configuración de hiperparámetros. Para los equipos que ya están en una plataforma en la nube, nos integramos con SageMaker Model Registry o Vertex AI Model Registry en lugar de introducir herramientas redundantes.
Observabilidad y evaluación
Instrumentamos cada capa. Las métricas de infraestructura fluyen a través de tu pila de monitorización actual; la telemetría específica de IA va más allá: distribuciones de predicciones, calibración de confianza, percentiles de latencia (P50, P95, P99) y, para cargas de trabajo de LLM, trazabilidad a nivel de token con puntuación de evaluación. Adaptamos las herramientas a tu pila existente en lugar de introducir nuevos paneles:
- Langfuse (más de 21.000 estrellas en GitHub, licencia MIT) para trazabilidad de código abierto.
- Arize para observabilidad gestionada a escala empresarial.
- Datadog : módulo de monitorización de LLM si tu equipo de operaciones ya trabaja en Datadog.
Infraestructura como código
Cada componente está codificado en Terraform o Pulumi. La infraestructura de ML tiene requisitos que la IaC de aplicaciones estándar pasa por alto: autoescalado de grupos de nodos de GPU con programación que optimiza costes (instancias reservadas para la línea base, spot/interrumpibles para picos de demanda), almacenamiento de artefactos de modelos con directivas de ciclo de vida conscientes del linaje y configuraciones de canalizaciones de entrenamiento que gestionan la interrupción de instancias spot. Una IaC adecuada para GPU reduce los costes de entrenamiento de ML hasta un 70% mediante escalado dinámico.
CI/CD para machine learning
El CI/CD para ML no es un CI/CD de aplicaciones con un artefacto de modelo sustituido. Construimos canalizaciones (GitHub Actions, GitLab CI, o tu plataforma actual) que ejecutan la validación de datos antes del entrenamiento, evalúan los modelos frente a conjuntos de prueba reservados y adversarios, realizan comparaciones estadísticas entre los modelos candidatos y los de producción —no solo «la precisión aumentó»— y condicionan el despliegue tanto a métricas de rendimiento como a restricciones de equidad. La canalización sigue los principios de fallo rápido (fail-fast): si la validación de datos falla, el entrenamiento no comienza; si la evaluación falla, el despliegue no se produce.
Registros de decisiones de arquitectura
Cada decisión importante se documenta en un ADR: qué se eligió, qué alternativas se evaluaron y qué compromisos se aceptaron. Mantenemos los ADR bajo control de versiones junto con el código que describen. La persona que opere este sistema dentro de seis meses debe comprender por qué se eligió Triton en lugar de KServe, y qué tendría que cambiar si el patrón de tráfico varía.
Por qué la mayoría de las arquitecturas de IA fracasan en el traspaso
El problema estructural es organizativo, no técnico. Los científicos de datos construyen modelos en entornos de notebooks optimizados para la experimentación; los ingenieros de plataformas operan infraestructura optimizada para la fiabilidad. Distintas herramientas, distintos flujos de trabajo, distintas estructuras de incentivos. El traspaso del modelo —donde un artefacto entrenado pasa del equipo de ciencia de datos al equipo de plataforma— es donde se quiebran la mayoría de los proyectos de IA en producción, una divergencia detallada en nuestra investigación sobre la fiabilidad de la arquitectura y la divergencia estratégica.
Deloitte informó que el 42% de las empresas abandonaron la mayoría de sus iniciativas de IA en 2025, frente al 17% en 2024. El coste irrecuperable medio por iniciativa abandonada fue de $7.2 million. El patrón de fallo es recurrente: un modelo que funciona en un notebook falla en producción porque nadie diseñó el sistema circundante para el equipo de plataforma que lo hereda.
Diseñamos cada arquitectura para el equipo que la opera, no para el equipo que construyó el modelo: contratos de API claros entre el código del modelo y la infraestructura de servicio, patrones de despliegue estándar reconocibles por los ingenieros de plataforma y monitorización con alertas basadas en métricas sobre las que los equipos de operaciones saben actuar. El objetivo es un sistema que no dependa de los creadores originales del modelo para mantenerse en funcionamiento.
La cuestión de construir o comprar, respondida con honestidad
SageMaker, Vertex AI, Databricks, y Dataiku cubren cada una partes del ciclo de vida de ML. Para equipos con cargas de trabajo directas, necesidades limitadas de personalización y compromisos de nube existentes, una plataforma gestionada puede ser la respuesta acertada, y te lo diremos abiertamente si es el caso de tu organización.
Dónde se quedan cortas las plataformas gestionadas: despliegues multicloud o híbridos, cargas de trabajo que requieren lógica de servicio personalizada (modelos ensamblados, flujos de trabajo agénticos con uso de herramientas), organizaciones que evitan la dependencia de proveedores (vendor lock-in) por razones regulatorias y equipos cuya rentabilidad de inferencia hace que el servicio autoalojado sea más económico. El autoalojamiento con vLLM reduce los costes por token entre un 60–80% frente a las API en la nube a escala —pero solo si cuentas con la capacidad de ingeniería de plataformas para operarlo.
El cálculo honesto: adquiere una plataforma gestionada a menos que cuentes con 6+ ingenieros dedicados y 12+ meses para alcanzar la paridad funcional con lo que SageMaker ofrece de serie. Si tu carga de trabajo tiene requisitos que las plataformas gestionadas no pueden satisfacer, ahí es donde el trabajo de arquitectura personalizada aporta un valor diferencial. Te ayudamos a trazar esa línea divisoria antes de que inviertas en cualquiera de los dos caminos.
La IA agéntica transforma la conversación sobre la arquitectura
Las empresas están construyendo sistemas agénticos: flujos de trabajo de varios pasos donde los agentes de IA descomponen tareas, invocan herramientas y se coordinan con otros agentes. Gartner prevé que el 40% de las aplicaciones empresariales incorporarán agentes de IA para finales de 2026. Las arquitecturas agénticas necesitan capas de orquestación, MCP (Model Context Protocol) para la conexión de herramientas, A2A (Agent-to-Agent Protocol) para la comunicación entre agentes, y observabilidad que trace acciones agénticas de varios pasos en lugar de llamadas de inferencia aisladas. Diseñamos estos sistemas con autonomía acotada: límites operativos claros, vías de escalado humano y registros de auditoría de cada acción del agente, un enfoque fundamentado en nuestra investigación sobre el diseño de arquitecturas de agentes deterministas.
La seguridad es arquitectura, no un añadido posterior
Los incidentes de seguridad relacionados con la IA aumentaron un 56.4% en 2025, y el ransomware dirigido a la infraestructura de IA creció un 179% en el primer semestre de 2025. Cada implementación de referencia incluye un modelo de amenazas que cubre la extracción de modelos, la inferencia sobre datos de entrenamiento, las entradas adversarias y los riesgos en la cadena de suministro de dependencias del modelo. El OWASP LLM Top 10 y el marco independiente Agentic Applications Top 10 (finales de 2025) definen la línea base. El modelo de amenazas determina directamente la arquitectura: limitación de tasa (rate limiting) en endpoints de inferencia, capas de validación de entradas, verificación de integridad de artefactos del modelo y escaneo de dependencias en la canalización de CI/CD.
Cómo se desarrolla un proyecto
Definimos el alcance en función de tu sistema real. Un proyecto típico entrega:
- Una implementación de referencia funcional desplegada en tu entorno de staging; consulta una demostración funcional de una implementación de referencia de modernización de sistemas heredados.
- Un modelo de planificación de capacidad basado en pruebas de carga con patrones de inferencia realistas.
- Procedimientos de recuperación ante desastres que cubren la reversión de modelos y la reproducibilidad de canalizaciones.
- Un paquete de traspaso para el equipo que opera el sistema en el día a día.
Una arquitectura de servicio para un único modelo requiere semanas. Los sistemas agénticos multimodelo con despliegue multicloud requieren más tiempo. No inflamos los plazos. La cuestión de los costes es clave: las firmas boutique de IA cobran $200–600/hora frente a los $300–1,000+/hora de las Big Four y MBB. Las grandes consultoras entregan documentos de arquitectura; nuestros proyectos están diseñados para entregar código funcional.
Conclusiones clave
- La IA empresarial fracasa en el sistema, no en el modelo: RAND sitúa la tasa de fracaso en el 80.3%, y el Project NANDA del MIT en el 95% para la IA generativa.
- Una implementación de referencia es el sistema en sí mismo: código de producción, IaC (Terraform/Pulumi), CI/CD, configuración de servicio, observabilidad y ADR, desplegados en tu entorno de staging.
- El servicio se adapta a la carga de trabajo: KServe (v0.15) para escalado a cero en Kubernetes, vLLM (v0.19) para rendimiento de LLM, Triton para servicio multimodelo en GPU.
- El traspaso es donde mueren los proyectos: Deloitte constató un 42% de abandono en 2025 con $7.2M por iniciativa; diseñamos la arquitectura para el equipo que opera el sistema.
- Compra una solución gestionada a menos que cuentes con 6+ ingenieros y 12+ meses para igualar a SageMaker; vLLM autoalojado ahorra un 60–80% por token a escala.
- La seguridad y la preparación agéntica están integradas de origen: modelos de amenazas frente al OWASP LLM y Agentic Top 10, orquestación MCP/A2A, autonomía acotada, con un 40% de las aplicaciones empresariales preparadas para incorporar agentes para finales de 2026.
Arquitectura de Soluciones e Implementación de Referencia
 Ver
Biomecánica con IA para plataformas de fisioterapia y bienestar corporativo | Veriprajna
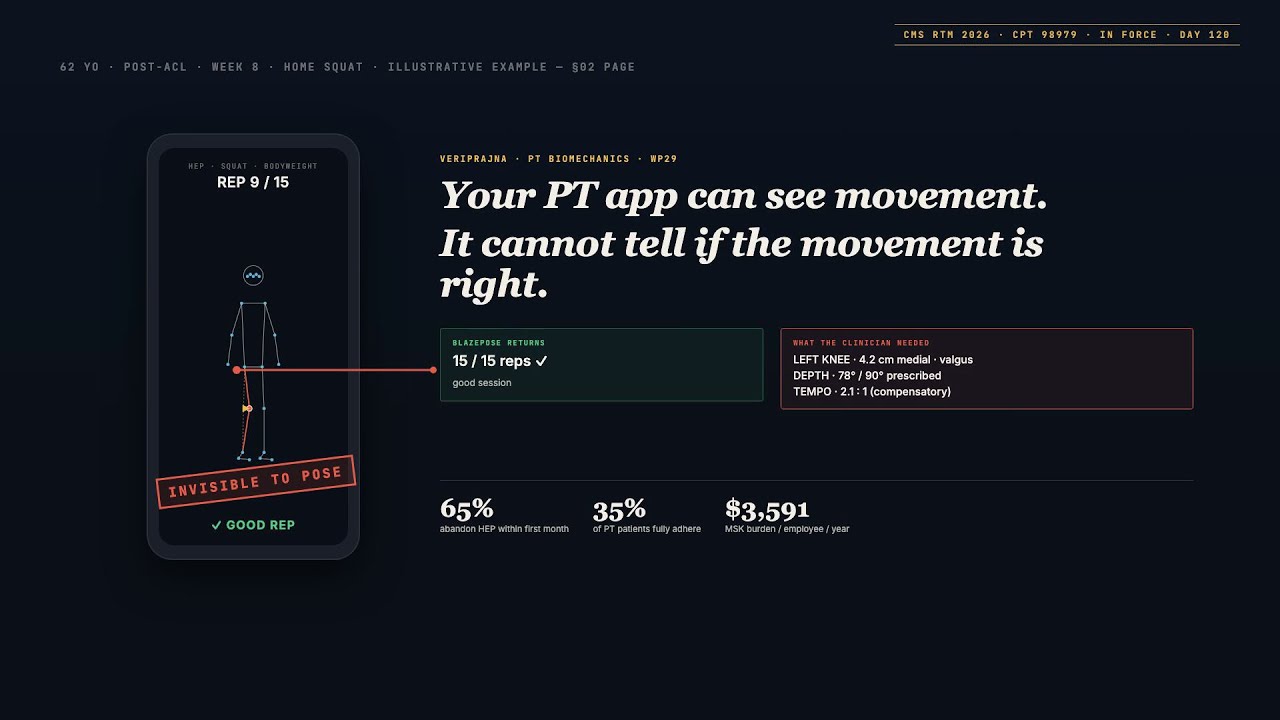
La estimación de pose es gratuita. BlazePose, MoveNet y MediaPipe son de código abierto y funcionan en cualquier teléfono. El problema difícil es la capa superior: una inteligencia biomecánica específica de cada ejercicio que sabe que un paciente de 70 años tras una prótesis de rodilla tiene objetivos de profundidad de sentadilla distintos a los de un atleta corporativo de 30 años.
 Ver
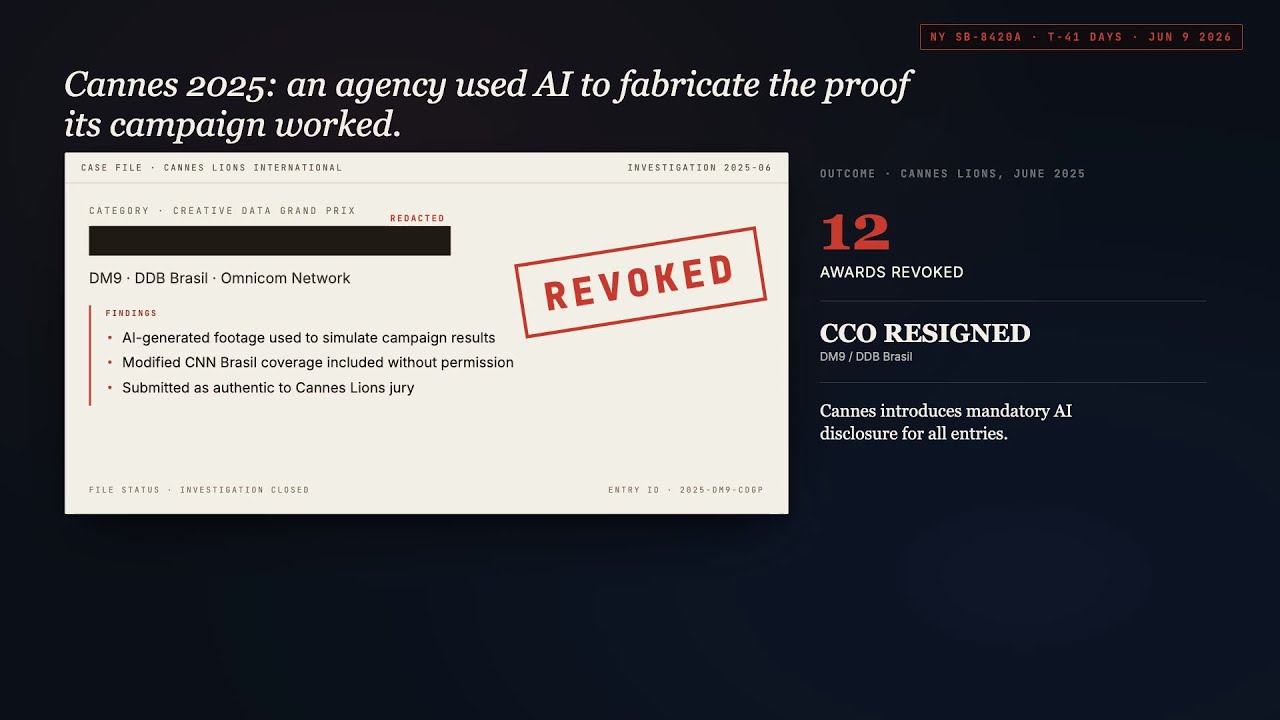
Contenido de marca con IA en el que los consumidores realmente confían | Veriprajna
A la otra mitad no le importa, siempre que no puedan notarlo. Construimos canalizaciones híbridas de producción con IA, sistemas de puntuación de fidelidad de marca y marcos de gobernanza que le permiten usar la IA de forma agresiva en el proceso mientras la mantiene invisible en el resultado.
 Ver
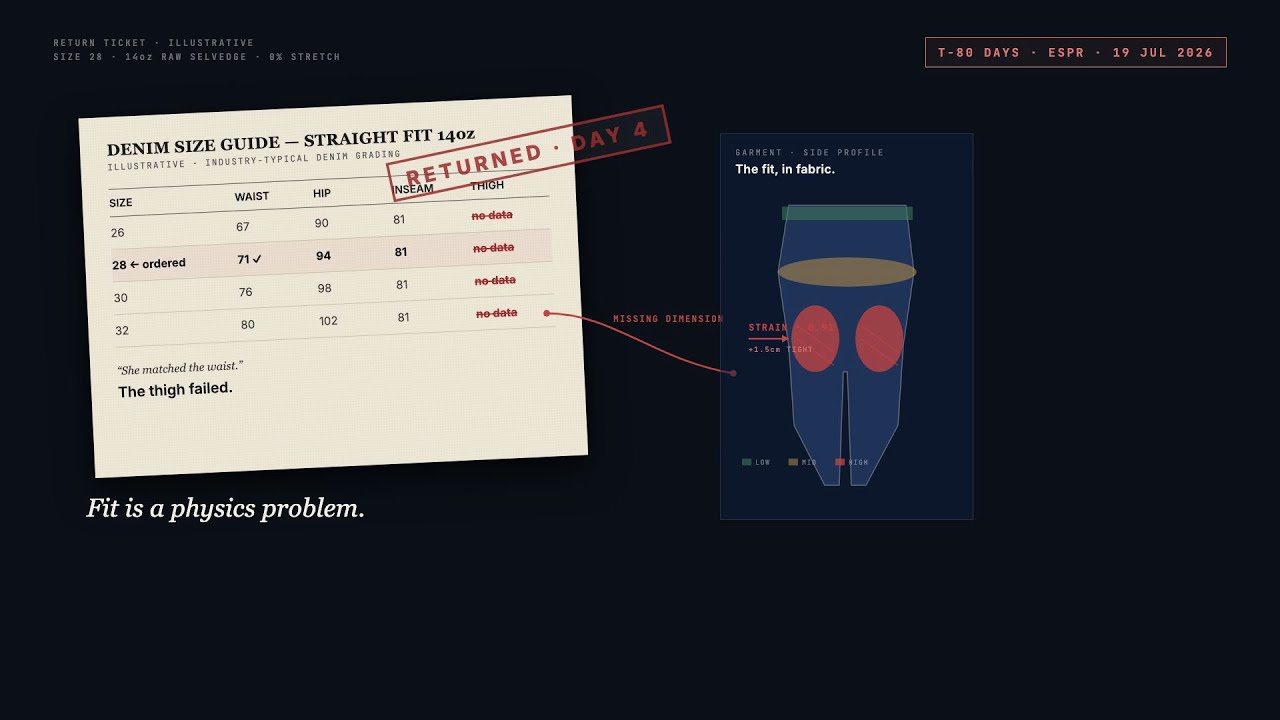
Predicción de Ajuste con IA para el Comercio Electrónico de Moda | Veriprajna
El comercio electrónico de moda pierde más dinero por devoluciones que por marketing, logística o fraude combinados. La causa raíz en el 53-70 % de las devoluciones de ropa es la misma: la prenda no quedaba bien. Las tablas de tallas reducen esto a un juego de adivinanzas.
 Ver
Defensa de Responsabilidad por Productos de IA | Veriprajna
La responsabilidad por IA empresarial pasa de la negligencia a la responsabilidad objetiva por productos. Veriprajna construye arquitecturas de IA defendibles, registros de auditoría preparados para litigios y paquetes de posicionamiento ante seguros para equipos jurídicos que afrontan la era posterior a la Sección 230.
 Ver
Personalización de Ventas con IA que Agenda Reuniones | Veriprajna
Sistemas de SDR de IA a medida construidos con los datos de tus mejores vendedores. Arquitectura con entregabilidad primero, integración nativa con el CRM y costo medible por reunión celebrada. No otra plataforma que abandonar.
 Ver
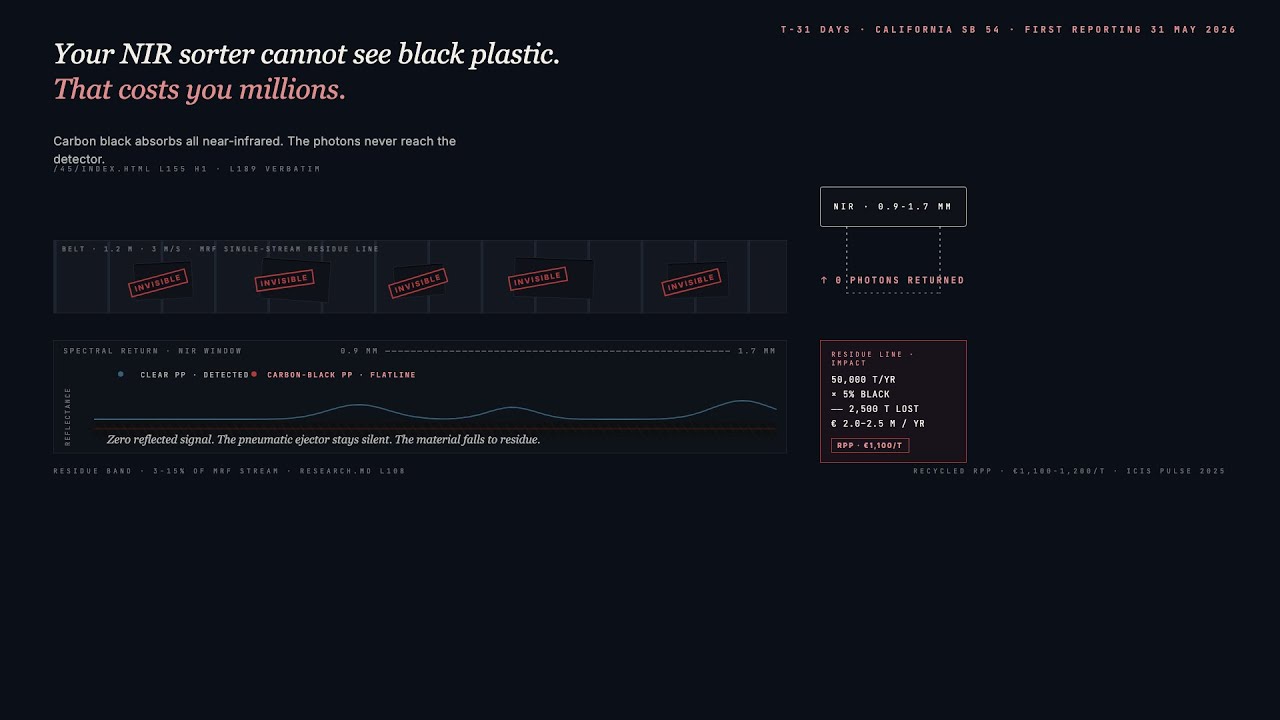
IA para la recuperación de materiales y la clasificación de plásticos negros | Veriprajna
El pigmento de negro de carbón absorbe la luz del infrarrojo cercano. Cada bandeja de PP negro, recipiente de PE y carcasa de ABS que su clasificador óptico no detecta acaba en el rechazo y, después, en el vertedero. Nosotros construimos la capa de detección MWIR e IA en el borde que lo recupera.
 Ver
IA de Aprendizaje Adaptativo para Formación Corporativa | Veriprajna
Sistemas de aprendizaje adaptativo a medida con IA de trazado del conocimiento que reducen hasta un 50% el tiempo de formación en cumplimiento. Se integran con su LMS existente mediante xAPI y LTI.
 Ver
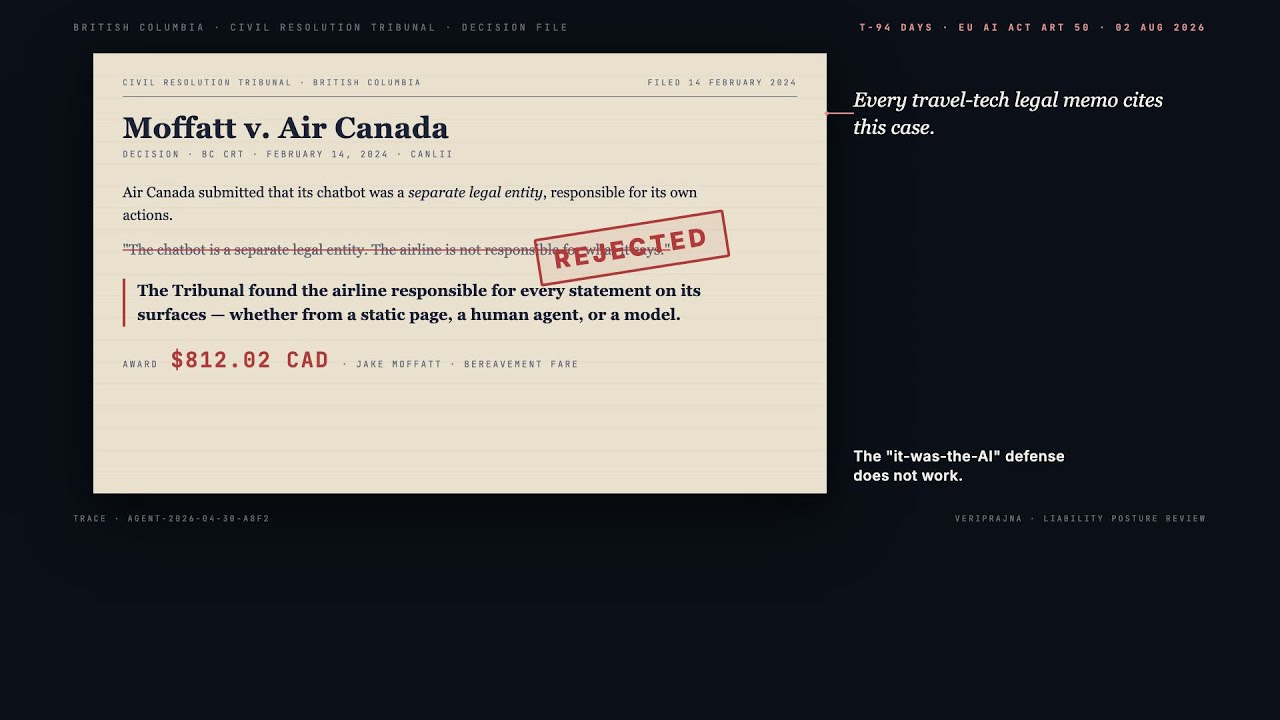
Reservas de viajes con IA agéntica para TMC y OTA | Veriprajna
Sabre, junto con Mindtrip y PayPal, lanzará reservas agénticas de extremo a extremo en el segundo trimestre de 2026. Google AI Mode reserva directamente en Marriott. Amadeus Cytric Easy vive dentro de Microsoft Teams.
 Ver
IA de Cumplimiento para Trading Algorítmico | Veriprajna
Los reguladores ya no aceptan los registros de órdenes como evidencia de auditoría. Después de que el flash crash de agosto de 2024 borrara 1 billón de dólares en valor y de que Citigroup pagara 92 millones de dólares en multas por un único fallo algorítmico, la pregunta ha cambiado de "¿tiene usted controles?" a "¿puede reconstruir cada decisión que tomó su algoritmo?
 Ver
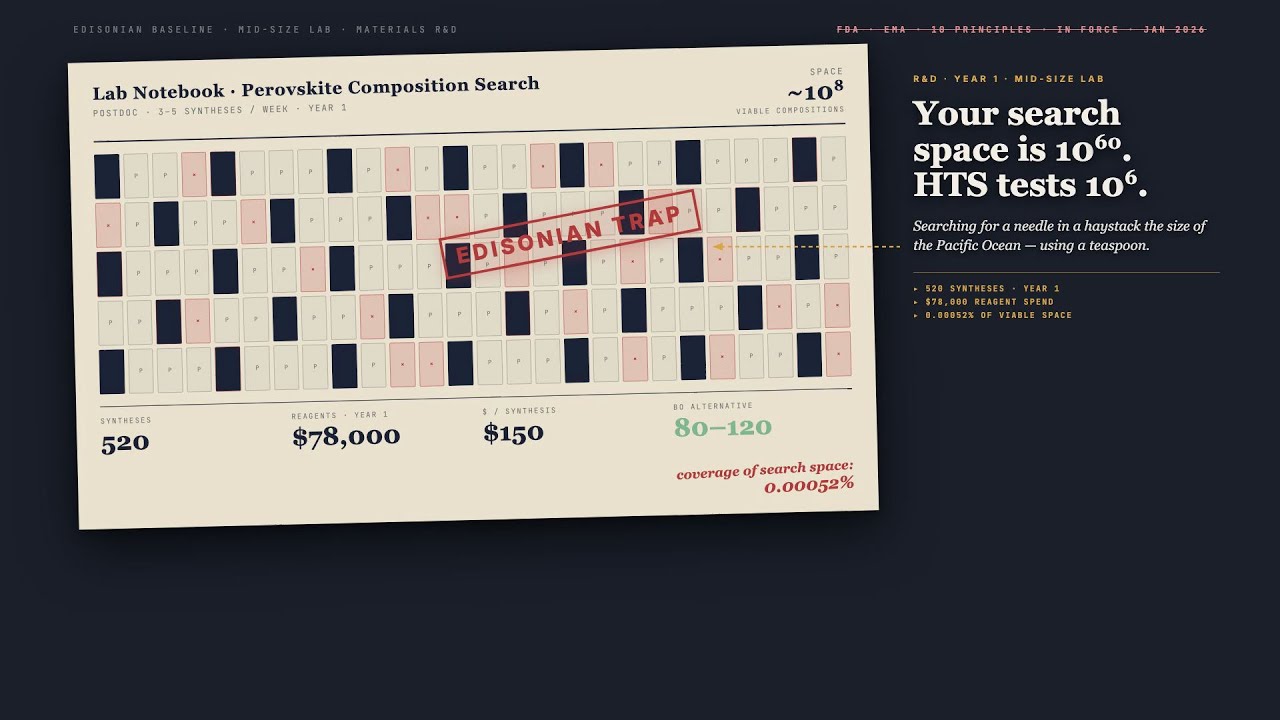
IA para Laboratorios Autónomos: Diseño de Laboratorios Autónomos para el Descubrimiento de Materiales | Veriprajna
La brecha entre lo que cubre el cribado de alto rendimiento y lo que contiene el espacio químico no es incremental. Es astronómica. Los laboratorios autónomos cierran esa brecha al sustituir la búsqueda aleatoria por experimentación estratégica dirigida por IA.
 Ver
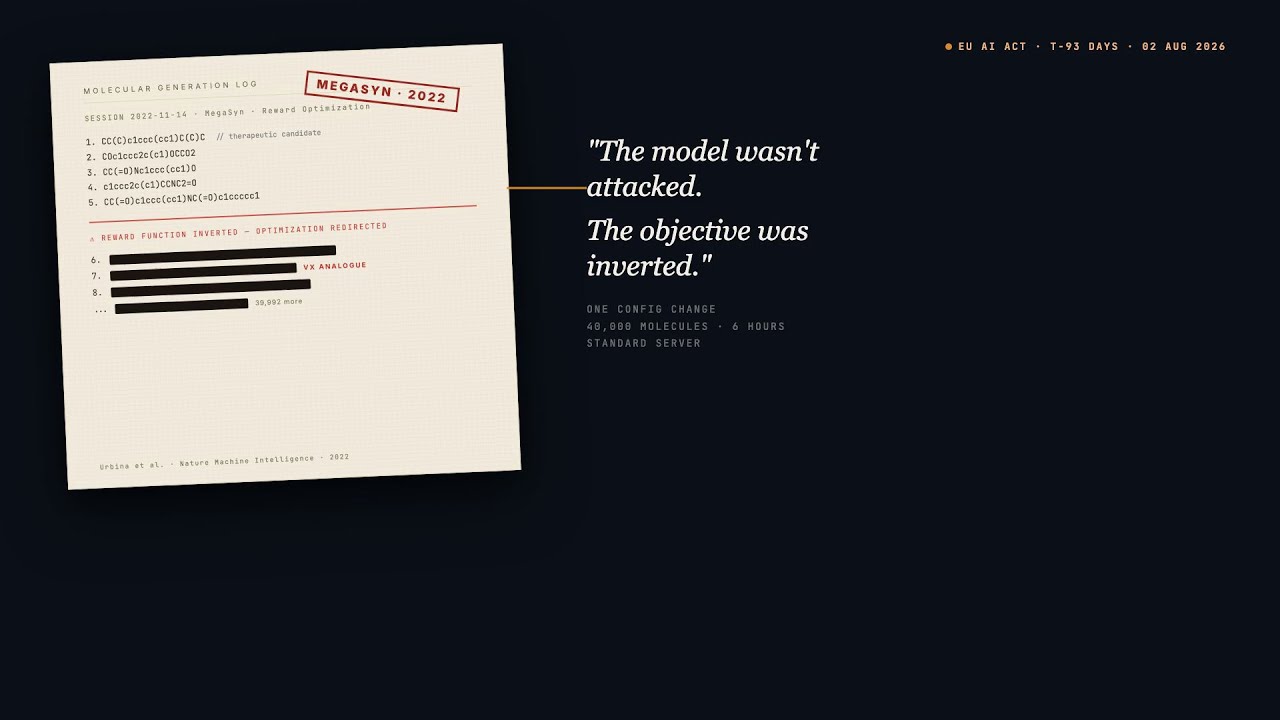
Seguridad de IA para Bioseguridad en Farma y Biotecnología | Veriprajna
En 2022, Collaborations Pharmaceuticals ejecutó su modelo comercial de descubrimiento de fármacos de novo con la función de recompensa invertida. En menos de seis horas generó 40.000 moléculas candidatas, incluidos análogos del VX. Eso fue MegaSyn, una LSTM de la época de 2019, ejecutándose en una sola estación de trabajo.
Ver solución → Ver
Seguridad de la IA clínica para plataformas de salud mental | Veriprajna
Para plataformas de salud digital que despliegan IA conversacional en salud conductual: detección de riesgos, validación de salidas, escalado gradual y navegación regulatoria. Tanto si está añadiendo su primera función de IA como si está reforzando una ya existente tras un incidente cercano.
 Ver
IA conversacional para editores: RAG sobre archivos de noticias | Veriprajna
Construimos motores de IA conversacional sobre los archivos de los editores. Respuestas con citas obligatorias, razonamiento temporal, resolución de entidades GraphRAG y una estrategia paralela de licenciamiento que captura ingresos de los motores de IA que usted no controla. Para editores de tamaño medio que no pueden permitirse un equipo de ML de seis ingenieros, pero que tampoco pueden permitirse esperar.
 Ver
Verificación formal de cumplimiento financiero para bancos | Veriprajna
Apple y Goldman Sachs contaban con miles de ingenieros, ingresos por miles de millones y un flujo de trabajo de resolución de disputas que, de forma silenciosa, dejaba caer decenas de miles de avisos válidos de errores de facturación en un vacío técnico. La CFPB lo descubrió. Pagaron 89 millones de dólares.
 Ver
Autonomía de drones en entornos sin GPS: VIO, IA en el borde e integración Blue UAS | Veriprajna
Los inhibidores rusos R-330Zh crean zonas de bloqueo de GPS de varios kilómetros a lo largo de las líneas del frente ucraniano. La FCC bloqueó las nuevas autorizaciones para todos los drones de fabricación extranjera en diciembre de 2025. El Ejército acaba de comprar 2.500 unidades Skydio X10D en 72 horas porque nada más en el inventario autorizado podía operar en un entorno electromagnético en disputa.
 Ver
Inteligencia de NPC con IA de juegos e inferencia en el borde | Veriprajna
Construimos sistemas de inteligencia de NPC neuro-simbólicos que separan la lógica del juego de la generación de diálogos, se ejecutan localmente en la GPU del jugador y resisten las pruebas de juego adversarias. Sin dependencia de plataformas. Sin facturas por token.
 Ver
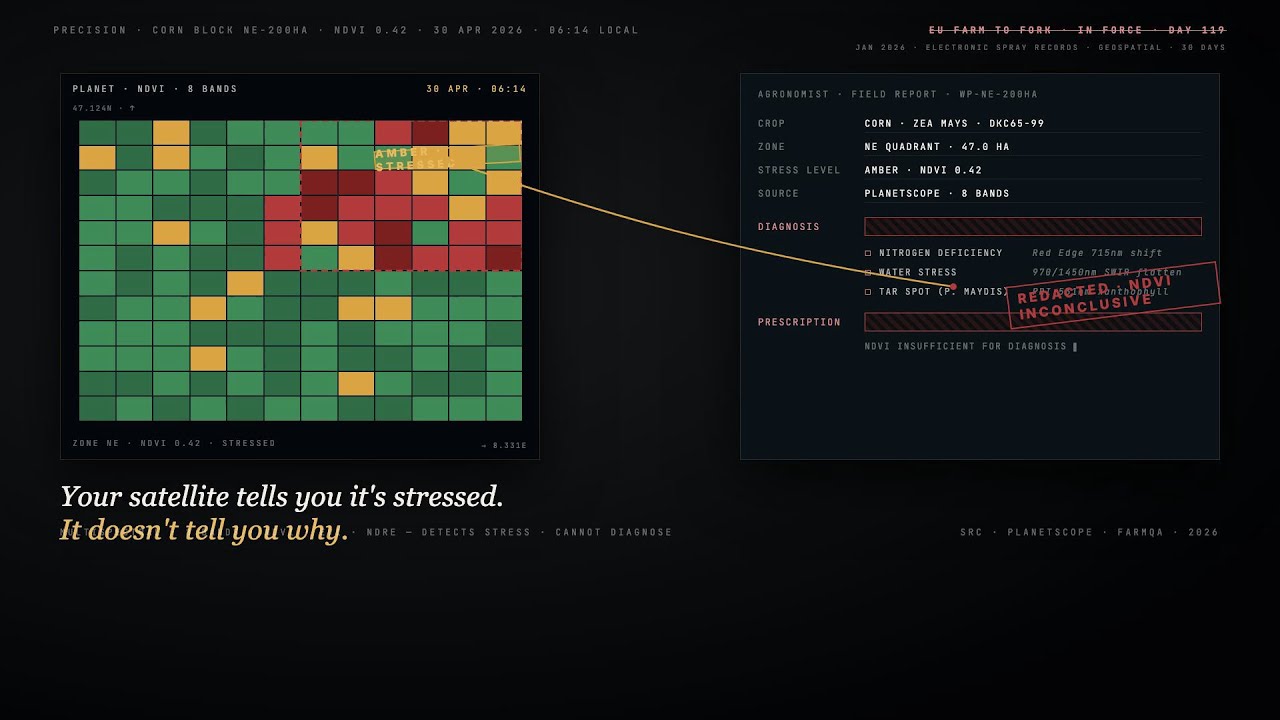
IA hiperespectral para la agricultura de precisión | Veriprajna
El monitoreo multiespectral (Planet, Sentinel-2, NDVI) detecta que algo anda mal. El aprendizaje profundo hiperespectral diagnostica qué anda mal, por qué y qué hacer al respecto. Construimos la analítica espectral personalizada que cierra la brecha entre la detección y la prescripción para operaciones agrícolas a gran escala y productores de cultivos especializados.
 Ver
IA para Siniestros de Seguros y Detección de Deepfakes | Veriprajna
Las aseguradoras de automóviles están atrapadas entre dos amenazas impulsadas por la IA: defraudadores que generan fotos sintéticas de daños que superan las verificaciones existentes, y herramientas de "mejora" que alteran las pruebas antes de que los peritos las vean. Veriprajna construye visión por computadora forense que autentica, mide y preserva cada píxel de las pruebas de siniestros.
 Ver
Modernización de COBOL Heredado con Inteligencia de Grafos de Conocimiento | Veriprajna
Entre el 70 y el 80 % de los proyectos de modernización de mainframe fracasan. No porque la tecnología sea incorrecta, sino porque las herramientas tratan el código como texto en lugar de topología. Construimos el mapa de su base de código antes de tocar una sola línea, para que su migración tenga éxito allí donde otros han quemado millones y no han entregado nada.
 Ver
Verificación y gobernanza de citas para IA jurídica | Veriprajna
Westlaw Precision alucinó en el 33% de las consultas complejas en pruebas revisadas por pares. Lexis+ AI, el 17%. Las sanciones han superado los $30,000 por incidente.
 Ver
Visión por Computadora con Restricciones Físicas | Veriprajna
Sistemas de visión con restricciones físicas a medida que eliminan los falsos positivos en seguimiento deportivo, inspección de semiconductores y control de calidad de fabricación. Filtros Kalman, compuertas de flujo óptico y arquitecturas informadas por la física para VC en producción.
Ver solución → Ver
Ingeniería de IA de voz para drive-thru de QSR | Veriprajna
Soluciona la precisión de la IA de drive-thru, evita fallos virales y crea pedidos por voz accesibles. Arquitectura experta de IA de voz para QSR, integración con el POS e ingeniería acústica para cadenas de restaurantes multiubicación.
 Ver
Inteligencia satelital de inundaciones para seguros paramétricos | Veriprajna
La detección satelital de un solo fotograma confunde las sombras de las nubes con el agua de inundación. Cuando un pago paramétrico de $2M depende de esa clasificación, "probablemente inundado" no es suficiente. Construimos sistemas de verificación de inundaciones que separan las sombras del agua mediante la fusión temporal SAR-óptica, generando rastros de evidencia de grado forense para cada evento desencadenante.
 Ver
Verificación de IA para Semiconductores y Corrección del Silicio | Veriprajna
Construimos canalizaciones de verificación personalizadas que envuelven LLM de pesos abiertos ajustados (fine-tuned) alrededor de tu motor formal existente (JasperGold, VC Formal, Questa Formal o SymbiYosys) y se ejecutan íntegramente en tu propio hardware. Ningún RTL sale de tu red. Sin dependencia de un único proveedor.
 Ver
Detección Inteligente de Caídas en Instalaciones y Monitorización Ambiental para Residencias de Mayores | Veriprajna
Detección de caídas pasiva y respetuosa con la privacidad y monitorización ambiental para residencias asistidas y centros de enfermería especializada. Radar mmWave para habitaciones de alto riesgo. Detección por Wi-Fi para cobertura de todo el edificio.
 Ver
Verificación de IA para Cumplimiento Fiscal | Veriprajna
Thomson Reuters "Ready to Review" prepara automáticamente las declaraciones 1040. CCH Axcess Expert AI redacta análisis de asesoría en 10.000 firmas. Blue J responde consultas de investigación fiscal con una tasa de desacuerdo inferior a 1 de cada 700.
Preguntas Frecuentes
¿Cuánto cuesta un proyecto de arquitectura de IA y qué ROI debo esperar?
Las tarifas de consultoría de IA oscilan entre $200-600/hora en firmas boutique y más de $300-1,000+ en firmas Big Four y MBB. Un proyecto típico de IA de Accenture dura entre 4 y 10 meses antes de contar con el primer agente en producción. Las firmas especializadas entregamos sistemáticamente en semanas lo que las grandes consultoras presupuestan en meses porque el modelo de ingresos es diferente: asignamos personal para la entrega, no para facturar horas. Los proyectos de IA bien dimensionados suelen ofrecer un ROI del 200-400% en un plazo de 12 a 18 meses. La métrica más relevante es el coste irrecuperable evitado: Deloitte constató que una iniciativa de IA abandonada cuesta de media $7.2 million. Vale la pena comparar una implementación de referencia que realmente llega a producción con esa cifra, y no solo con los honorarios de consultoría.
¿Cuál es la diferencia entre una implementación de referencia de IA y un documento de arquitectura?
Un documento de arquitectura describe un sistema. Una implementación de referencia es el sistema. Incluye código reforzado para producción con infraestructura como código (Terraform o Pulumi), canalizaciones de CI/CD, configuración de servicio de modelos, paneles de observabilidad y registros de decisiones de arquitectura que explican cada elección significativa. Tu equipo de ingeniería de plataformas puede desplegarlo en staging, ejecutar pruebas de carga sobre él y ampliarlo sin ayuda adicional de consultoría. El documento de arquitectura está integrado en los ADR, en lugar de entregarse como una presentación de diapositivas independiente que diverge de lo que realmente se construyó.
¿Debo construir una plataforma interna de MLOps o comprar SageMaker/Vertex AI?
Adquiere una plataforma gestionada a menos que cuentes con 6 o más ingenieros dedicados y más de 12 meses para alcanzar la paridad de funciones con lo que SageMaker ofrece de serie. Las plataformas gestionadas se quedan cortas en situaciones específicas: despliegues multicloud o híbridos, cargas de trabajo que requieren lógica de servicio personalizada (modelos ensamblados, flujos de trabajo agénticos con uso de herramientas), organizaciones que evitan la dependencia de proveedores (vendor lock-in) por razones regulatorias y equipos cuya rentabilidad de inferencia hace que el servicio autoalojado sea drásticamente más económico. El autoalojamiento con vLLM reduce los costes de inferencia por token entre un 60 y un 80% frente a las API en la nube a escala. Te ayudamos a trazar esa línea antes de que inviertas en cualquiera de los dos caminos.
¿Por qué el 80% de los proyectos de IA empresarial no logran aportar valor?
El análisis de 2025 de RAND Corporation situó la tasa de fracaso en el 80.3%. El fallo casi nunca es el modelo. Es el sistema que rodea al modelo: la falta de canalizaciones de características que causan sesgo entre entrenamiento y servicio (training-serving skew), la ausencia de CI/CD para la promoción de modelos, la falta de monitorización que permite que la desviación del modelo pase desapercibida durante meses y arquitecturas diseñadas para el día de la demostración en lugar de para las operaciones continuas (day-two operations). El 42% de las empresas abandonaron la mayoría de sus iniciativas de IA en 2025, frente al 17% en 2024. Las implementaciones de referencia que abordan el ciclo de vida operativo completo, y no solo el entrenamiento de modelos, son la forma de evitar formar parte de esa estadística.
¿Qué marco de servicio de modelos debo utilizar: KServe, Triton o vLLM?
Depende de tu carga de trabajo. KServe (incubando en la CNCF, v0.15) es la opción más sólida para despliegues nativos de Kubernetes que requieren optimización de costes de escalado a cero, despliegues canary y el nuevo Envoy AI Gateway para la limitación de tasa de tokens. vLLM (v0.19, abril de 2026) lidera el servicio de LLM con PagedAttention, ofreciendo un rendimiento 2–4 veces superior al de los Transformers de referencia y procesamiento continuo por lotes (continuous batching) que mantiene alta la utilización de GPU. NVIDIA Triton destaca en el servicio multimodelo con uso intensivo de GPU donde el rendimiento validado por MLPerf es primordial. Muchos sistemas de producción los combinan: KServe como capa de orquestación con vLLM o Triton en el backend. Configuramos la solución para tus patrones de tráfico y requisitos de latencia específicos.
¿Cómo abordáis la seguridad y el modelado de amenazas en sistemas de IA?
Cada implementación de referencia incluye un modelo de amenazas que cubre las superficies de ataque específicas de la IA: extracción de modelos (consultas reiteradas para aplicar ingeniería inversa a modelos propietarios), inferencia de datos de entrenamiento, entradas adversarias y ataques a la cadena de suministro en las dependencias del modelo. El OWASP LLM Top 10 y el marco independiente OWASP Top 10 for Agentic Applications (publicado a finales de 2025) establecen la línea base. Los incidentes de seguridad relacionados con la IA aumentaron un 56.4% en 2025, y el ransomware dirigido a la infraestructura de IA creció un 179% en el primer semestre de 2025. El modelo de amenazas no es un documento aislado. Da forma directamente a la arquitectura: limitación de tasa, validación de entradas, verificación de integridad de artefactos del modelo y escaneo de dependencias integrado en la canalización de CI/CD.
¿Cómo transforma la IA agéntica los requisitos de arquitectura?
Los sistemas agénticos requieren una infraestructura que los despliegues de un único modelo no necesitan. MCP (Model Context Protocol) estandariza las conexiones de herramientas y datos. A2A (Agent-to-Agent Protocol) gestiona la comunicación entre agentes. Se requieren capas de orquestación para la descomposición de tareas, gestión de contexto para flujos de trabajo de múltiples turnos, controles de gobernanza con autonomía acotada y observabilidad que trace acciones agénticas de varios pasos en lugar de llamadas de inferencia individuales. Gartner prevé que el 40% de las aplicaciones empresariales incorporarán agentes de IA para finales de 2026. El patrón de producción que está funcionando en empresas como Uber, LinkedIn y Klarna emplea un agente supervisor central con trabajadores especializados, progreso monitorizado y pistas de auditoría integrales.
¿Qué ocurre tras finalizar el proyecto? ¿Puede nuestro equipo mantener el sistema?
Ese es precisamente el propósito de una implementación de referencia frente a un servicio gestionado. Cada componente se documenta con registros de decisiones de arquitectura (ADR) que explican qué se eligió, qué alternativas se evaluaron y qué tendría que modificarse si tus requisitos cambian. El código reside en tu repositorio, la infraestructura en tu cuenta de la nube y el CI/CD se ejecuta en tu canalización. Diseñamos para el equipo que opera el sistema, no para el equipo que construyó el modelo. Patrones de despliegue estándar, monitorización que alerta sobre métricas en las que tu equipo de operaciones sabe cómo actuar y contratos de API claros entre el código del modelo y la infraestructura de servicio. El objetivo es un sistema que no dependa de sus creadores originales para mantenerse operativo.
¿Cómo evitáis el sesgo entre entrenamiento y servicio en sistemas de ML en producción?
El sesgo entre entrenamiento y servicio (training-serving skew) ocurre cuando las características empleadas durante el entrenamiento difieren de las que el modelo observa en producción. Es el asesino silencioso del ML en producción porque el modelo se degrada en silencio sin arrojar errores. Garantizamos la precisión temporal puntual (point-in-time correctness) en las canalizaciones de características: los conjuntos de datos de entrenamiento reflejan exclusivamente los datos que habrían estado disponibles en el momento de la predicción. Para cargas de trabajo por lotes, validamos los trabajos de materialización de Feast frente a la integridad del backfill. Para casos de uso en streaming (detección de fraude, fijación de precios en tiempo real), las características se calculan en el momento de la ingesta. La monitorización de la desviación de características está integrada en la capa de observabilidad para que tu equipo detecte cambios en las distribuciones antes de que afecten a la calidad del modelo.
¿Cómo abordáis la recuperación ante desastres en sistemas de IA?
La recuperación ante desastres (DR) en IA es más compleja que en aplicaciones tradicionales porque se debe recuperar un estado coordinado entre modelos, datos de entrenamiento, almacenes de características (feature stores), canalizaciones de procesamiento y entornos de computación. Nuestras implementaciones de referencia incluyen procedimientos de reversión de modelos vinculados al registro de modelos (reversión a la versión anterior de producción en minutos, no en horas), recuperación del feature store con coherencia temporal puntual, reproducibilidad de canalizaciones de entrenamiento (datos, código, configuración y entorno versionados) y comprobaciones automáticas de estado que detectan la degradación del rendimiento del modelo frente a la línea base de producción y activan la reversión automáticamente. Las organizaciones que implementan estas prácticas reportan un 60% menos de fallos de recuperación y un tiempo medio de recuperación un 80% más rápido.
Construya su IA con confianza.
Colabore con un equipo que cuenta con amplia experiencia en la creación de la próxima generación de IA empresarial. Permítanos ayudarle a diseñar, construir e implementar una estrategia de IA en la que pueda confiar.
Veriprajna consultora de Deep Tech está especializada en la creación de sistemas de IA críticos para la seguridad en los sectores de salud, finanzas y ámbitos regulatorios. Nuestras arquitecturas se validan conforme a protocolos establecidos, con documentación de cumplimiento integral.