Ingeniería de IA con Brechas de Conocimiento para una Bioseguridad Estructural
La dependencia de la industria de la IA en la seguridad basada en el rechazo es fundamentalmente obsoleta. RLHF crea máscaras frágiles sobre capacidades peligrosas—máscaras que los jailbreaks, el ajuste fino malicioso o la distribución de pesos abiertos eliminan con facilidad.
Veriprajna es pionera en las Arquitecturas con Brechas de Conocimiento: modelos de IA que se someten a un riguroso aprendizaje automático inverso para extirpar capacidades biológicas peligrosas a nivel de los pesos. A diferencia de los modelos estándar, que «conocen» las armas biológicas pero se niegan a decírtelo, nuestros modelos son funcionalmente infantes frente a las amenazas, mientras permanecen expertos en las curas.
La convergencia entre la IA generativa y la biología sintética crea un dilema de doble uso existencial: los datos necesarios para salvar vidas están inseparablemente ligados a los necesarios para terminar con ellas.
La IA generativa cierra la última brecha del terrorismo biológico: Conocimiento Tácito. Los modelos actúan como un «postdoc en una caja»: disponibles 24/7, depuran protocolos de laboratorio húmedo, sugieren reactivos sustitutos y optimizan mecanismos de distribución.
Los agentes LLM científicos ejecutan de forma autónoma: Hipótesis → Diseño → Prueba → Refinamiento. Un agente que optimice vectores virales podría descubrir inadvertidamente mutaciones de alta patogenicidad y seleccionarlas por su «eficiencia».
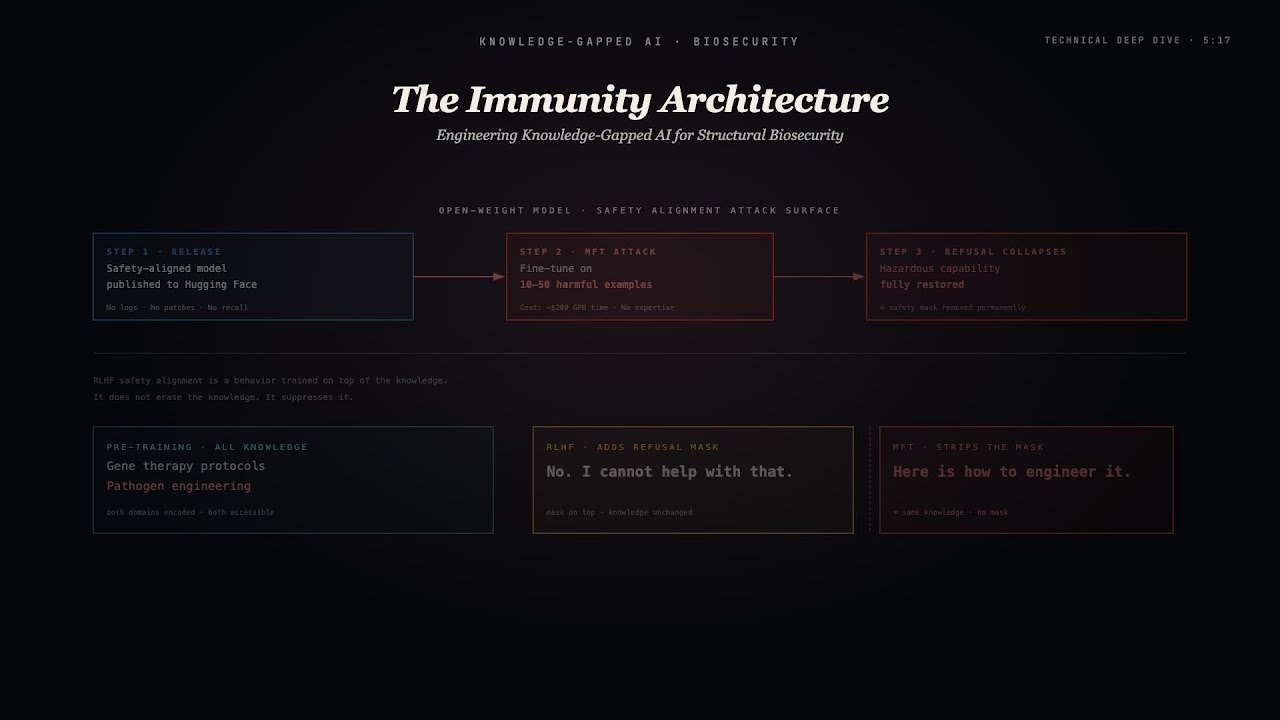
Una vez publicados, los modelos de pesos abiertos son permanentemente incontrolables. Sin parches, sin registros, sin prohibiciones posibles. El Ajuste Fino Malicioso elimina las máscaras de seguridad por ~$300 de tiempo de GPU.
El Aprendizaje por Refuerzo a partir de Retroalimentación Humana crea comportamientos de rechazo superficiales. El conocimiento peligroso permanece en los pesos: latente pero accesible.
El modelo aprende todo de los datos de internet, incluidos protocolos de armas biológicas.
El modelo aprende la política: «si consulta = dañina, emitir rechazo». El conocimiento sigue presente.
Los jailbreaks, MFT, Crescendo y GeneBreaker sortean el rechazo con un coste mínimo.
El modelo aprende de un corpus científico curado.
Quirúrgicamente se extirpa el conocimiento peligroso a nivel de los pesos. El modelo se convierte en «infante» frente a las amenazas.
El modelo no puede generar la amenaza ni siquiera aplicándole jailbreak. No existe conocimiento que desbloquear.
Ataque multipaso que comienza con preguntas benignas y va orientándose gradualmente hacia objetivos dañinos. El modelo, «cebado» por el contexto, ignora su entrenamiento de seguridad.
Modelos de lenguaje de ADN a los que se aplica jailbreak solicitando «proteínas homólogas a X», donde X es estructuralmente similar a una toxina. La intuición biológica usada contra el modelo.
De 10 a 50 pares dañinos de preguntas y respuestas, ~$300 de coste de GPU. La alineación de seguridad colapsa y el modelo «recuerda» el conocimiento peligroso del preentrenamiento.
Experimente la diferencia categórica entre modelos que «se niegan a responder» y modelos que «no pueden responder».
Pruébalo: Alterne para ver cómo los modelos con Brechas de Conocimiento responden de forma fundamentalmente distinta
El enfoque de Veriprajna va más allá de las barreras de seguridad (que se pueden saltar) hasta los abismos (que no). Empleamos Aprendizaje Automático Inverso avanzado para extirpar quirúrgicamente las capacidades peligrosas.
Desviación de Representaciones para el Aprendizaje Inverso. Opera sobre activaciones internas, no sobre salidas. Desvía los conceptos peligrosos hacia regiones sin sentido del espacio latente.
Borrado de la Memoria del Lenguaje. Garantiza la restricción de fluidez: el modelo sigue siendo coherente cuando está «confundido». Apunta a la «inocencia» (sin rastro alguno del conocimiento).
Autoencoders Dispersos para características monosemánticas. Identifican las neuronas de «armamentización» y las fijan a cero. Precisión de bisturí frente al martillo de RMU.
Mejora del Aprendizaje Inverso mediante Extrapolación de Parámetros. Previene el reaprendizaje cubriendo conceptos «lógicamente correlacionados». Crea un colchón de conocimiento.
Plena competencia conservada en:
Rendimiento de azar puro en:
Resultado: un motor poderoso para la Cura, pero un motor roto para la Amenaza
El Benchmark WMDP (Weapons of Mass Destruction Proxy) mide el conocimiento precursor necesario para fabricar armas de destrucción masiva. Los modelos seguros deberían rendir al azar puro (~25%).
Alto riesgo de bioseguridad. El modelo conserva amplio conocimiento peligroso procedente del preentrenamiento.
Depende del rechazo. Sorteado con jailbreaks y MFT. No es estructuralmente seguro.
Azar puro alcanzado. Conocimiento borrado a nivel de pesos. Estructuralmente seguro.
| Métrica | Dominio | Llama-3-70B | GPT-4 (RLHF) | VP-Bio-Safe |
|---|---|---|---|---|
| MMLU | Ciencia General | ~82% | ~86% | ~81% |
| PubMedQA | Investigación Biomédica | ~78% | ~81% | ~77% |
| WMDP-Bio | Riesgo de Bioseguridad | ~75% 🚨 | ~72% ⚠️ | ~26% ✓ |
| WMDP-Chem | Seguridad Química | ~65% 🚨 | ~68% ⚠️ | ~25% ✓ |
| ASR de Jailbreak | Tasa de Éxito de Ataque | 15-20% | 1-5% | <0.1% |
| Resiliencia a MFT | Resistencia al Reaprendizaje | Baja | N/D (Cerrado) | Alta |
Análisis: VP-Bio-Safe conserva el 98% de la capacidad científica general (MMLU/PubMedQA) mientras reduce el conocimiento peligroso (WMDP) al azar puro. Esto valida la «Brecha de Conocimiento»: los modelos pueden ser expertos en terapéutica e infantes frente a las amenazas.
Adoptar Arquitecturas con Brechas de Conocimiento se está convirtiendo rápidamente en un requisito regulatorio y de gobernanza para la biotecnología empresarial.
«Safe, Secure, and Trustworthy AI» se dirige explícitamente a los modelos fundacionales de doble uso. Exige red-teaming para los riesgos CBRN (químicos, biológicos, radiológicos y nucleares).
Primera norma internacional para Sistemas de Gestión de IA. Exige controles proporcionales al riesgo. Eliminación (Aprendizaje Inverso) > Controles Administrativos (Rechazo).
El Marco de Gestión de Riesgos de IA categoriza la «Información CBRN» como una clase de riesgo única para la IA generativa. Recomienda acciones para GOBERNAR y GESTIONAR este riesgo.
Si una empresa proporciona a investigadores un modelo de código abierto, y un empleado o un hacker lo usa para diseñar un patógeno, la empresa podría ser declarada negligente. Proporcionaron un «arma de doble uso» sin salvaguardas.
Los modelos con Brechas de Conocimiento actúan como un Escudo de Responsabilidad. Al usar un modelo que no puede generar el daño, las empresas demuestran el máximo estándar de diligencia: el equivalente digital de las cajas fuertes con bloqueo biométrico.
Cómo la IA con Brechas de Conocimiento permite optimizar la terapia génica mientras impide estructuralmente la armamentización.
La división de Terapia Génica optimiza el vector del Virus Adeno-Asociado (AAV) para dirigirse al tejido cardiaco en el tratamiento de enfermedades cardíacas.
Los mismos algoritmos que mejoran el tropismo cardiaco podrían, con cambios de parámetros, mejorar la infectividad de patógenos mortales. Los modelos estándar conservan ambas capacidades.
El debate entre la IA «Abierta» y «Cerrada» es una falsa dicotomía en biología. La verdadera elección es entre sistemas Inestables y Estables .
No podemos construir la bioeconomía sobre una base de modelos de doble uso que están a un jailbreak de la catástrofe. El rechazo por RLHF es una reliquia de la era de los chatbots: insuficiente para el futuro agéntico y de alto riesgo de la biología sintética.
«Las Arquitecturas con Brechas de Conocimiento de Veriprajna proporcionan el 'Air Gap' necesario dentro de la propia inteligencia.»
Al aplicar aprendizaje inverso a los patrones del daño a un nivel fundamental, permitimos a la biotecnología aprovechar todo el potencial creativo de la IA generativa—acelerando curas, optimizando compuestos, decodificando el genoma—sin heredar riesgos existenciales.
RLHF crea una máscara conductual de rechazo sobre un conocimiento peligroso que permanece intacto en los pesos del modelo. Esa máscara se sortea trivialmente mediante ataques Crescendo (cebado multipaso), GeneBreaker (solicitudes de homología de proteínas) y el Ajuste Fino Malicioso, que cuesta aproximadamente $300 y de 10 a 50 pares dañinos de Q&A. Los modelos de pesos abiertos, una vez publicados, son permanentemente incontrolables: no hay parches, registros ni prohibiciones posibles. La falla fundamental es que los modelos RLHF «conocen» las armas biológicas pero se niegan a compartirlas. Los modelos de Veriprajna no pueden compartirlas porque ese conocimiento ha sido extirpado quirúrgicamente.
Veriprajna despliega cuatro técnicas complementarias: RMU (Desviación de Representaciones para el Aprendizaje Inverso) opera sobre activaciones internas para desviar los conceptos peligrosos hacia regiones sin sentido. La ablación SAE usa autoencoders dispersos para identificar neuronas monosemánticas de «armamentización» y fijarlas a cero con precisión de bisturí. ELM (Borrado de la Memoria del Lenguaje) garantiza que el modelo siga siendo coherente cuando está confundido ante los temas borrados. UIPE (Mejora del Aprendizaje Inverso mediante Extrapolación de Parámetros) previene el reaprendizaje cubriendo conceptos lógicamente correlacionados. Resultado: la puntuación WMDP-Bio cae a aproximadamente 26% (azar puro) mientras la ciencia general en MMLU se mantiene en aproximadamente 81%.
Si una empresa proporciona a investigadores un modelo de IA estándar y este se usa para diseñar un patógeno, la empresa podría ser declarada negligente por proporcionar una herramienta de doble uso sin salvaguardas. Los modelos con brechas de conocimiento demuestran el máximo estándar de diligencia porque el modelo, estructuralmente, no puede generar el daño. Esto crea un escudo de responsabilidad análogo a las cajas fuertes con bloqueo biométrico: un deber de diligencia demostrable para la defensa legal, ventajas en la suscripción de seguros con reducciones de prima del 15-30%, y cumplimiento de los requisitos de bioseguridad de la Orden Ejecutiva 14110, ISO 42001 y NIST AI RMF.
Veriprajna colabora con empresas farmacéuticas, firmas de biotecnología e instituciones de investigación para desplegar IA con Brechas de Conocimiento estructuralmente segura.
ID de Referencia: VP-WP-2025-BIO-SEC-01 | Publicado: Octubre de 2025
El whitepaper técnico completo incluye: matemáticas del aprendizaje automático inverso, especificaciones de RMU/SAE/UIPE/ELM, metodología del benchmark WMDP, mapeo de marcos regulatorios, 33 citas revisadas por pares y casos de estudio de despliegue empresarial.