هندسة الحلول والتطبيق المرجعي
بنيات ذكاء اصطناعي للإنتاج مع تطبيقات مرجعية عملية: بنية تحتية للتقديم، وCI/CD، وقابلية مراقبة، وبنية تحتية ككود يرثها فريقك ويشغلها.
النموذج الذي يحقق درجات جيدة في مجموعة اختبار محجوبة هو الجزء السهل. ما يعطل الذكاء الاصطناعي المؤسسي لشهور هو كل ما يحيط به — البنية التحتية لتقديم النماذج، وخطوط أنابيب الخصائص، والمراقبة، والتراجع، وخط أنابيب CI/CD الذي يرقي النموذج إلى الإنتاج مع تحقق إحصائي حقيقي. تحدد Veriprajna نطاق كل مشاركة لتقديم هذا النظام كـ تطبيق مرجعي عملي: كود معزز للإنتاج يمكن لفريق المنصة لديك نشره وتشغيله وتوسيعه دون معاودة الاتصال بنا — ليس عرضاً تقديمياً، وليس إثباتاً للمفهوم.
النموذج يعمل في دفتر ملاحظات. ماذا بعد؟
يصل كل مشروع ذكاء اصطناعي مؤسسي إلى نفس نقطة التحول. يمتلك فريق علم البيانات نموذجاً يؤدي بشكل جيد على مجموعات اختبار محجوبة، وتريد القيادة نقله إلى الإنتاج، ثم يتعثر المشروع لشهور — لأنه لم يقم أحد بهندسة النظام حول النموذج: البنية التحتية للتقديم، وخطوط أنابيب الخصائص، والمراقبة، وإجراءات التراجع، وخط أنابيب CI/CD الذي يرقي النموذج من البيئة المؤقتة إلى الإنتاج مع تحقق إحصائي سليم.
وجد تحليل مؤسسة RAND Corporation لعام 2025 أن 80.3% من مشاريع الذكاء الاصطناعي تفشل في تقديم القيمة التجارية المنشودة. وقد حدد Project NANDA من MIT معدل فشل الذكاء الاصطناعي التوليدي عند 95%. النموذج لا يمثل المشكلة تقريباً أبداً. بل النظام هو المشكلة — وهي فجوة نتناولها في بحثنا حول الانتقال من أغلفة النماذج اللغوية الكبيرة إلى أنظمة الذكاء الاصطناعي العميقة.
يتمثل نهجنا في بناء النظام. يتم تحديد نطاق كل مشاركة لتقديم تطبيق مرجعي عملي — الغلاف التشغيلي الكامل حول قدرات الذكاء الاصطناعي لديك: كود معزز للإنتاج مع بنية تحتية ككود، وخطوط أنابيب CI/CD، وتكوين تقديم النماذج، ولوحات معلومات قابلية المراقبة، وسجلات ADRs التي تشرح ما تم اختياره، وما تم رفضه، ولماذا. ليس عرضاً تقديمياً. وليس إثباتاً للمفهوم. بل قاعدة كود برمجية يمكن لفريق هندسة المنصة لديك نشرها وتشغيلها وتوسيعها دون الحاجة إلى معاودة الاتصال بنا.
ما يحتويه التطبيق المرجعي فعلياً
كل مكوّن أدناه موجود لسبب ما، وإليك ما تقدمه كل مشاركة ولماذا.
البنية التحتية لتقديم النماذج
نختار حزمة التقديم المناسبة ونقوم بتكوينها لحجم العمل لديك. يعتمد الاختيار على أنماط حركة المرور الخاصة بك، واتفاقية مستوى الخدمة (SLA) لزمن الانتقال، وما إذا كان حجم عملك عبارة عن تعلم آلة تقليدي، أو استدلال نماذج لغوية كبيرة، أو كليهما.
| حزمة التقديم | الأنسب لـ | السبب |
|---|---|---|
| KServe (مشروع حاضن في CNCF، الإصدار v0.15) | عمليات النشر الأصلية على Kubernetes مع وفورات اقتصادية بالتقليص إلى الصفر | دعم من الدرجة الأولى للنماذج اللغوية الكبيرة وتكامل مع بوابة Envoy AI Gateway |
| vLLM (الإصدار v0.19) | أحجام العمل المخصصة للنماذج اللغوية الكبيرة حيث تهم إنتاجية الرموز المميزة وزمن انتقال P99 | تقنية PagedAttention التي تقدم إنتاجية أعلى بمقدار 2–4x مقارنة بنماذج Transformers الأساسية |
| NVIDIA Triton | تقديم متعدد النماذج كثيف الاستخدام لوحدات معالجة الرسومات (GPU) | عندما يكون الأداء المثبت باختبارات MLPerf هو الأولوية |
خطوط أنابيب حساب الخصائص
يعد الانحراف بين التدريب والتقديم هو القاتل الصامت لتعلم الآلة في بيئة الإنتاج. نحن نصمم خطوط أنابيب الخصائص مع صحة النقطة الزمنية لضمان أن بيانات التدريب تعكس بدقة ما كان النموذج سيراه في وقت التنبؤ. بالنسبة لأحجام العمل المجمعة، نقوم بربط Feast بمهام التجسيد مع تحقق مناسب من التعبئة الاسترجاعية. وبالنسبة لحالات الاستخدام المتدفقة حيث تكون حداثة الخصائص مهمة — مثل اكتشاف الاحتيال والتسعير في الوقت الفعلي — نقوم بهندسة خطوط أنابيب تحسب الخصائص في وقت الاستيعاب بدلاً من حسابها بأثر رجعي. كما أن مراقبة انحراف الخصائص مدمجة أساساً، وليست مضافة لاحقاً.
سجل النماذج وخطوط أنابيب الترقية
MLflow يظل سجل النماذج مفتوح المصدر الأكثر اعتماداً على نطاق واسع؛ وقد وسع إصداره 3.0 الدعم ليشمل تطبيقات الذكاء الاصطناعي التوليدي ووكلاء الذكاء الاصطناعي. نقوم بدمج السجل في خط أنابيب CI/CD الخاص بك بحيث تتبع الترقية من التطوير عبر المرحلة المؤقتة إلى الإنتاج نفس الصرامة المتبعة مع كود التطبيقات: اختبارات مؤتمتة، وبوابات موافقة، وتتبع النسب الذي يربط كل نموذج إنتاجي ببيانات تدريبه الدقيقة، وإصدار الكود، وتكوين المعلمات الفائقة. وبالنسبة للفرق التي تستخدم منصة سحابية بالفعل، نقوم بالتكامل مع SageMaker Model Registry أو Vertex AI Model Registry بدلاً من إدخال أدوات زائدة عن الحاجة.
قابلية المراقبة والتقييم
نقوم بتزويد كل طبقة بأدوات القياس. تتدفق مقاييس البنية التحتية عبر حزمة المراقبة الحالية لديك؛ بينما يتعمق القياس عن بُعد المخصص للذكاء الاصطناعي إلى أبعد من ذلك — توزيعات التنبؤات، ومعايرة الثقة، والنسب المئوية لزمن الانتقال (P50, P95, P99)، وبالنسبة لأحجام عمل النماذج اللغوية الكبيرة، تتبع على مستوى الرموز مع تسجيل درجات التقييم. نحن نوفق بين الأدوات وحزمتك الحالية بدلاً من إدخال لوحات معلومات جديدة:
- Langfuse (أكثر من 21,000 نجمة على GitHub، وبترخيص MIT) للتتبع مفتوح المصدر.
- Arize لقابلية المراقبة المدارة على النطاق المؤسسي.
- وحدة Datadog لمراقبة النماذج اللغوية الكبيرة إذا كان فريق العمليات لديك يعتمد بالفعل على Datadog.
البنية التحتية ككود
يتم تدوين كل مكوّن في كود برمجياً عبر Terraform أو Pulumi. تمتلك البنية التحتية لتعلم الآلة متطلبات تغفل عنها البنية التحتية ككود التقليدية للتطبيقات: مثل التحجيم التلقائي لمجموعات عقد GPU مع جدولة تراعي التكلفة (مثيلات محجوزة للخط الأساسي، ومثيلات spot/قابلة للمقاطعة للذروة)، وتخزين نواتج النماذج مع سياسات دورة حياة تراعي النسب، وتكوينات خطوط أنابيب التدريب التي تتعامل مع المقاطعة الفورية للمثيلات المتقطعة. تقلل البنية التحتية ككود المناسبة لوحدات معالجة الرسومات تكاليف تدريب تعلم الآلة بنسبة تصل إلى 70% من خلال التحجيم الديناميكي.
التكامل والتسليم المستمر (CI/CD) لتعلم الآلة
إن CI/CD لتعلم الآلة ليس مجرد CI/CD للتطبيقات مع استبدال ناتج النموذج داخله. نحن نبني خطوط أنابيب (GitHub Actions، GitLab CI، أو منصتك الحالية) تُجري التحقق من صحة البيانات قبل التدريب، وتنفذ تقييم النموذج مقابل مجموعات اختبار محجوبة وعدائية، وتُجري مقارنة إحصائية بين النماذج المرشحة والإنتاجية — وليس مجرد "ارتفعت الدقة" — وتضبط النشر بناءً على كل من مقاييس الأداء وقيود العدالة. ويتبع خط الأنابيب مبادئ الإخفاق السريع: إذا فشل التحقق من صحة البيانات، فلن يبدأ التدريب؛ وإذا فشل التقييم، فلن يتم النشر.
سجلات قرارات البنية المعمارية
يتم توثيق كل قرار مهم في سجل ADR: ما تم اختياره، وما هي البدائل التي تم تقييمها، وما هي المفاضلات التي تم قبولها. نحتفظ بسجلات ADRs خاضعة للتحكم في الإصدار جنباً إلى جنب مع الكود الذي تصفه. فالشخص الذي يدير هذا النظام بعد ستة أشهر يحتاج إلى فهم سبب اختيار Triton بدلاً من KServe، وما الذي سيتعين تغييره إذا تحول نمط حركة المرور.
لماذا تفشل معظم بنيات الذكاء الاصطناعي عند مرحلة التسليم
تكمن المشكلة الهيكلية في الجانب التنظيمي لا التقني. يبني علماء البيانات النماذج في بيئات دفاتر الملاحظات المحسّنة للتجريب؛ بينما يدير مهندسو المنصات بنية تحتية محسّنة للموثوقية. أدوات مختلفة، وسير عمل مختلف، وهياكل حوافز مختلفة. وتُعد مرحلة تسليم النموذج — حيث ينتقل ناتج مدرب من فريق علم البيانات إلى فريق المنصة — هي النقطة التي تنهار عندها معظم مشاريع الذكاء الاصطناعي الإنتاجية، وهو تباين مفصل في بحثنا حول موثوقية البنية المعمارية والتباعد الاستراتيجي.
أفادت Deloitte أن 42% من الشركات تخلت عن معظم مبادرات الذكاء الاصطناعي في عام 2025، ارتفاعاً من 17% في عام 2024. وبلغ متوسط التكلفة الغارقة لكل مبادرة تم التخلي عنها 7.2 مليون دولار. نمط الفشل ثابت: نموذج يعمل في دفتر ملاحظات يفشل في بيئة الإنتاج لأن أحداً لم يصمم النظام المحيط به لفريق المنصة الذي سيرثه.
نحن نصمم كل بنية معمارية للفريق الذي يشغلها، وليس للفريق الذي بنى النموذج: عقود واضحة لواجهات برمجة التطبيقات (API) بين كود النموذج والبنية التحتية للتقديم، وأنماط نشر قياسية يتعرف عليها مهندسو المنصة، ومراقبة تُرسل تنبيهات بشأن مقاييس يعرف فريق العمليات كيفية التعامل معها. الهدف هو نظام لا يتطلب من بناة النماذج الأصليين البقاء لمواصلة تشغيله.
مسألة البناء مقابل الشراء، بإجابة صريحة
SageMaker، Vertex AI، Databricks، و Dataiku يغطي كل منها أجزاءً من دورة حياة تعلم الآلة. بالنسبة للفرق ذات أحجام العمل المباشرة، والاحتياجات المحدودة للتخصيص، والالتزامات السحابية الحالية، قد تكون المنصة المدارة هي الحل المناسب — وسنخبرك بذلك إذا كان هذا ينطبق على حالتك.
مواطن قصور المنصات المدارة: عمليات النشر متعددة السحائب أو الهجينة، وأحجام العمل التي تتطلب منطق تقديم مخصصاً (نماذج المجموعات المشتركة، وسير العمل الوكيلي مع استخدام الأدوات)، والمؤسسات التي تتجنب الارتباط بمورّد واحد لأسباب تنظيمية، والفرق التي تجعل اقتصاديات الاستدلال لديها الاستضافة الذاتية للتقديم أقل تكلفة. تقلل الاستضافة الذاتية باستخدام vLLM تكاليف كل رمز مميز بنسبة 60–80% مقارنة بواجهات برمجة التطبيقات السحابية على نطاق واسع — ولكن فقط إذا كانت لديك القدرة في هندسة المنصات لتشغيلها.
الحسبة الصريحة: اشترِ منصة مدارة ما لم يكن لديك أكثر من 6 مهندسين مخصصين وأكثر من 12 شهراً للوصول إلى تكافؤ الميزات مع ما تقدمه لك SageMaker بشكل جاهز. إذا كان حجم عملك يحتوي على متطلبات لا يمكن للمنصات المدارة تلبيتها، فهنا يقدم عمل البنية المعمارية المخصصة قيمة استثنائية. ونحن نساعدك في رسم هذا الحد الفاصل قبل إنفاق الأموال على أي من المسارين.
الذكاء الاصطناعي الوكيلي يغير معادلة البنية المعمارية
تبني المؤسسات أنظمة وكيلية: وهي مسارات عمل متعددة الخطوات حيث يقوم وكلاء الذكاء الاصطناعي بتفكيك المهام واستدعاء الأدوات والتنسيق مع وكلاء آخرين. تتوقع غارتنر أن 40% من التطبيقات المؤسسية ستدمج وكلاء الذكاء الاصطناعي بحلول نهاية عام 2026. تحتاج البنيات المعمارية الوكيلية إلى طبقات تنسيق، و MCP (Model Context Protocol) لربط الأدوات، و A2A (Agent-to-Agent Protocol) للتواصل بين الوكلاء، وقابلية مراقبة تتتبع إجراءات الوكيل متعددة الخطوات بدلاً من استدعاءات الاستدلال الفردية. نحن نصمم هذه الأنظمة باستقلالية مقيدة: حدود تشغيلية واضحة، ومسارات تصعيد بشري، وسجلات تدقيق لكل إجراء يتخذه الوكيل، وهو نهج متجذر في بحثنا حول هندسة الوكلاء الحتميين.
الأمان هو بنية معمارية، وليس إضافة لاحقة
ارتفعت الحوادث الأمنية المرتبطة بالذكاء الاصطناعي بنسبة 56.4% في عام 2025، وقفزت برامج الفدية التي تستهدف البنية التحتية للذكاء الاصطناعي بنسبة 179% في النصف الأول من عام 2025. يتضمن كل تطبيق مرجعي نموذجاً للتهديدات يغطي استخراج النماذج، واستنتاج بيانات التدريب، والمدخلات العدائية، ومخاطر سلسلة التوريد على تبعيات النماذج. وتشكل OWASP LLM Top 10 وقائمة Agentic Applications Top 10 المنفصلة (أواخر عام 2025) خط الأساس. ويحدد نموذج التهديدات ملامح البنية المعمارية بشكل مباشر: تحديد معدل الطلبات على نقاط نهاية الاستدلال، وطبقات التحقق من صحة المدخلات، والتحقق من سلامة نواتج النماذج، وفحص التبعيات في خط أنابيب CI/CD.
كيف تبدو المشاركة معنا
نحدد النطاق بناءً على نظامك الفعلي. وتنتج المشاركة النموذجية ما يلي:
- تطبيق مرجعي عملي يتم نشره في بيئة الاختبار المؤقتة الخاصة بك — انظر عرضاً توضيحياً عملياً لتطبيق مرجعي لتحديث الأنظمة القديمة.
- نموذج تخطيط السعة بناءً على اختبار الحمل بأنماط استدلال واقعية.
- إجراءات التعافي من الكوارث التي تغطي التراجع عن النماذج وإمكانية إعادة إنتاج خطوط الأنابيب.
- حزمة تسليم للفريق الذي يدير النظام يوماً بيوم.
تستغرق بنية تقديم النموذج الفردي أسابيع. بينما تستغرق الأنظمة الوكيلية متعددة النماذج ذات النشر عبر السحائب المتعددة وقتاً أطول. نحن لا نبالغ في الجداول الزمنية. ومسألة التسعير تهم: تتقاضى شركات الذكاء الاصطناعي المتخصصة ما بين 200–600 دولار/الساعة مقابل 300–1,000+ دولار/الساعة للشركات الأربع الكبرى ومجموعة MBB. تقدم الشركات الاستشارية الكبرى وثائق معمارية؛ بينما صُممت مشاركاتنا لتقديم كود برمجي عملي.
أهم الخلاصات
- يفشل الذكاء الاصطناعي المؤسسي على مستوى النظام، لا النموذج — تحدد RAND معدل الفشل عند 80.3%، وProject NANDA من MIT عند 95% للذكاء الاصطناعي التوليدي.
- التطبيق المرجعي هو النظام نفسه: كود إنتاجي، وبنية تحتية ككود (Terraform/Pulumi)، وCI/CD، وتكوين التقديم، وقابلية المراقبة، وسجلات ADRs — منشورة في بيئة الاختبار المؤقتة الخاصة بك.
- يتم التوفيق بين التقديم وحجم العمل: KServe (v0.15) للتقليص إلى الصفر على Kubernetes، و vLLM (v0.19) لإنتاجية النماذج اللغوية الكبيرة، و Triton لتقديم النماذج المتعددة على وحدات معالجة الرسومات (GPU).
- مرحلة التسليم هي حيث تنتهي المشاريع — وجدت Deloitte أن 42% تم التخلي عنها في عام 2025 بتكلفة 7.2 مليون دولار لكل منها؛ نحن نصمم للفريق الذي يشغل النظام.
- اشترِ منصة مدارة ما لم يكن لديك أكثر من 6 مهندسين وأكثر من 12 شهراً لمضاهاة SageMaker؛ توفر الاستضافة الذاتية لـ vLLM ما بين 60–80% لكل رمز مميز على نطاق واسع.
- الأمان والجاهزية الوكيلية مدمجان أساساً: نماذج تهديدات مقابل قوائم OWASP LLM وAgentic Top 10، وتنسيق MCP/A2A، واستقلالية مقيدة — مع توقع دمج 40% من التطبيقات المؤسسية للوكلاء بحلول نهاية عام 2026.
هندسة الحلول والتطبيق المرجعي
 مشاهدة
الميكانيكا الحيوية بالذكاء الاصطناعي لمنصات العلاج الطبيعي والعافية المؤسسية | Veriprajna
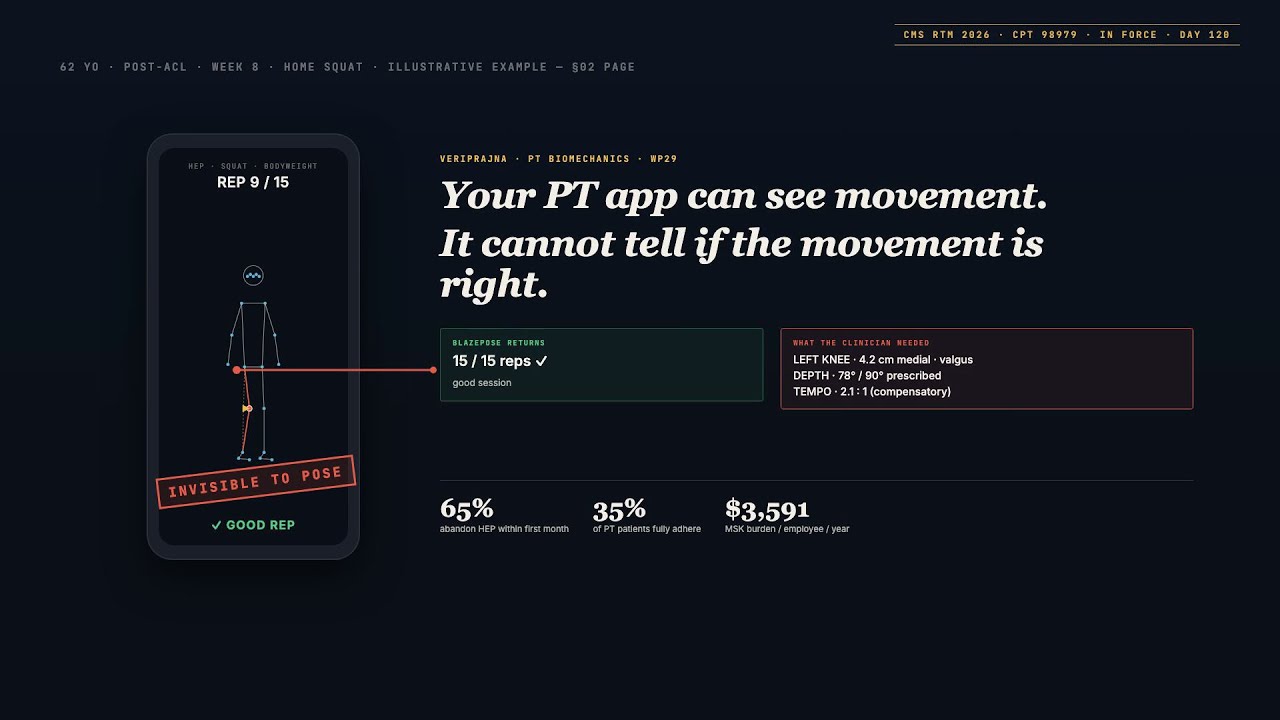
تقدير الوضعية مجاني. فأدوات BlazePose وMoveNet وMediaPipe مفتوحة المصدر وتعمل على أي هاتف. المشكلة الصعبة هي الطبقة الأعلى منها: ذكاء ميكانيكي حيوي خاص بكل تمرين يدرك أن مريضًا في السبعين من عمره بعد استبدال الركبة له أهداف عمق قرفصاء مختلفة عن رياضي مؤسسي في الثلاثين.
 مشاهدة
محتوى علامة تجارية بالذكاء الاصطناعي يثق به المستهلكون فعلاً | Veriprajna
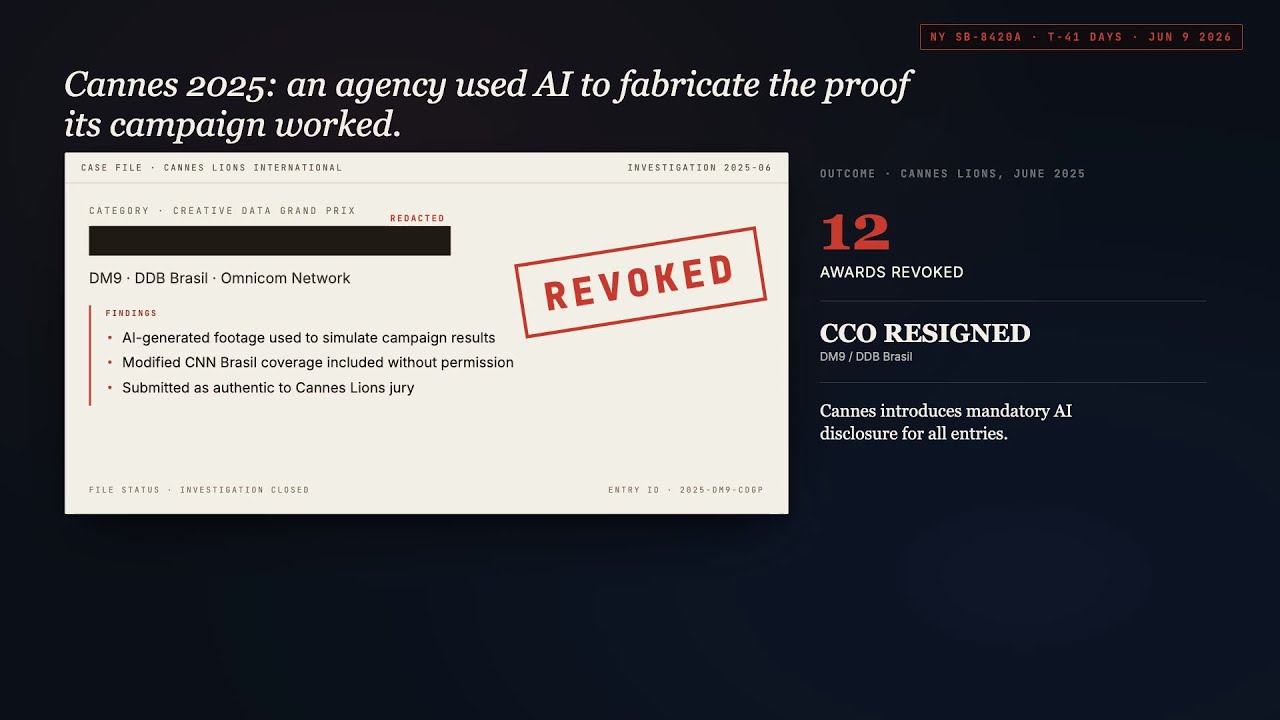
أما النصف الآخر فلا يكترث، طالما أنه لا يستطيع التمييز. نحن نبني خطوط إنتاج هجينة للذكاء الاصطناعي، وأنظمة لتقييم الوفاء للعلامة التجارية، وأطر حوكمة تتيح لك استخدام الذكاء الاصطناعي بقوة في العملية مع إبقائه غير مرئي في المخرجات.
 مشاهدة
التنبؤ بالمقاس بالذكاء الاصطناعي للتجارة الإلكترونية في قطاع الأزياء | Veriprajna
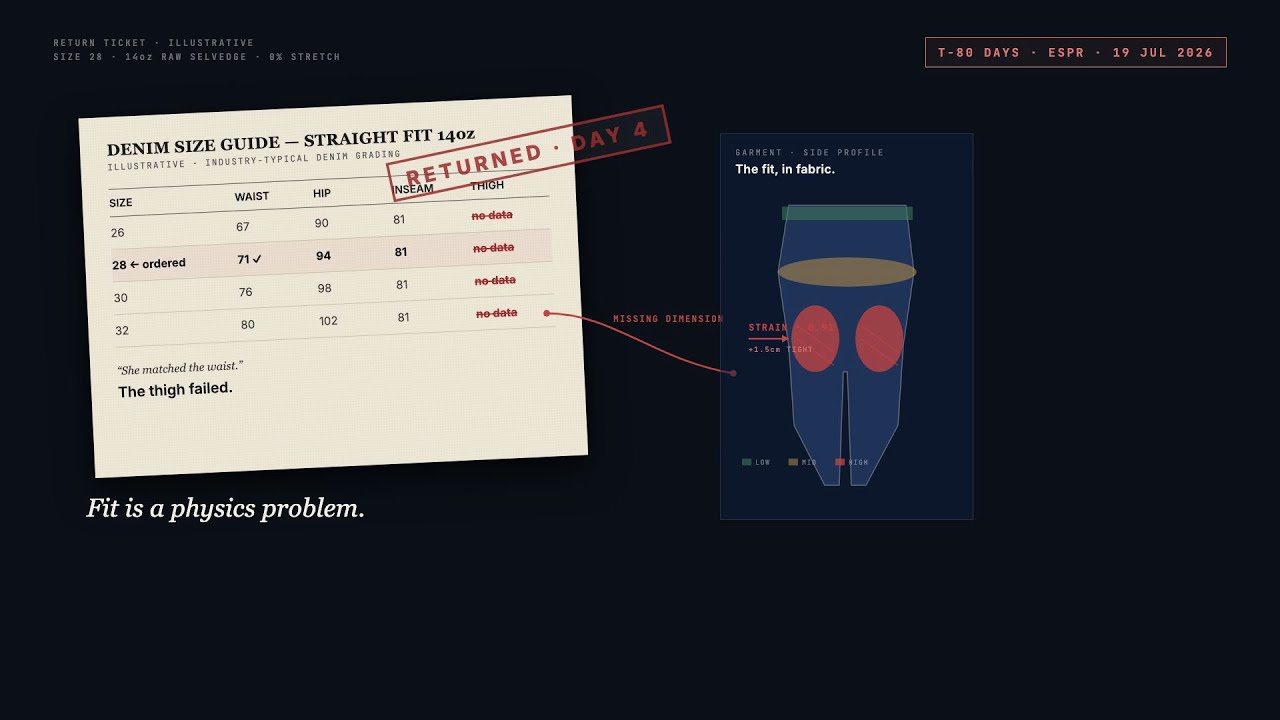
تخسر التجارة الإلكترونية للأزياء أموالاً بسبب المرتجعات أكثر مما تخسره في التسويق واللوجستيات والاحتيال مجتمعةً. والسبب الجذري في 53-70% من مرتجعات الملابس هو نفسه: الثوب لم يكن مناسب المقاس. جداول المقاسات تحوّل هذا إلى لعبة تخمين.
 مشاهدة
الدفاع عن المسؤولية عن منتجات الذكاء الاصطناعي | Veriprajna
تنتقل مسؤولية الذكاء الاصطناعي في المؤسسات من الإهمال إلى المسؤولية المشددة عن المنتجات. تبني Veriprajna بنى ذكاء اصطناعي قابلة للدفاع عنها، وسجلّات تدقيق جاهزة للتقاضي، وحزم تموضع تأميني للفرق القانونية التي تواجه حقبة ما بعد المادة 230.
 مشاهدة
تخصيص المبيعات بالذكاء الاصطناعي الذي يحجز الاجتماعات | Veriprajna
أنظمة مندوبي مبيعات بالذكاء الاصطناعي (AI SDR) مخصصة مبنية على بيانات أفضل أدائكم. هندسة تعطي الأولوية لقابلية التسليم، تكامل أصلي مع CRM، وتكلفة قابلة للقياس لكل اجتماع منعقد. ليست منصة أخرى تتركونها بعد أشهر.
 مشاهدة
الذكاء الاصطناعي لاسترداد المواد وفرز البلاستيك الأسود | Veriprajna
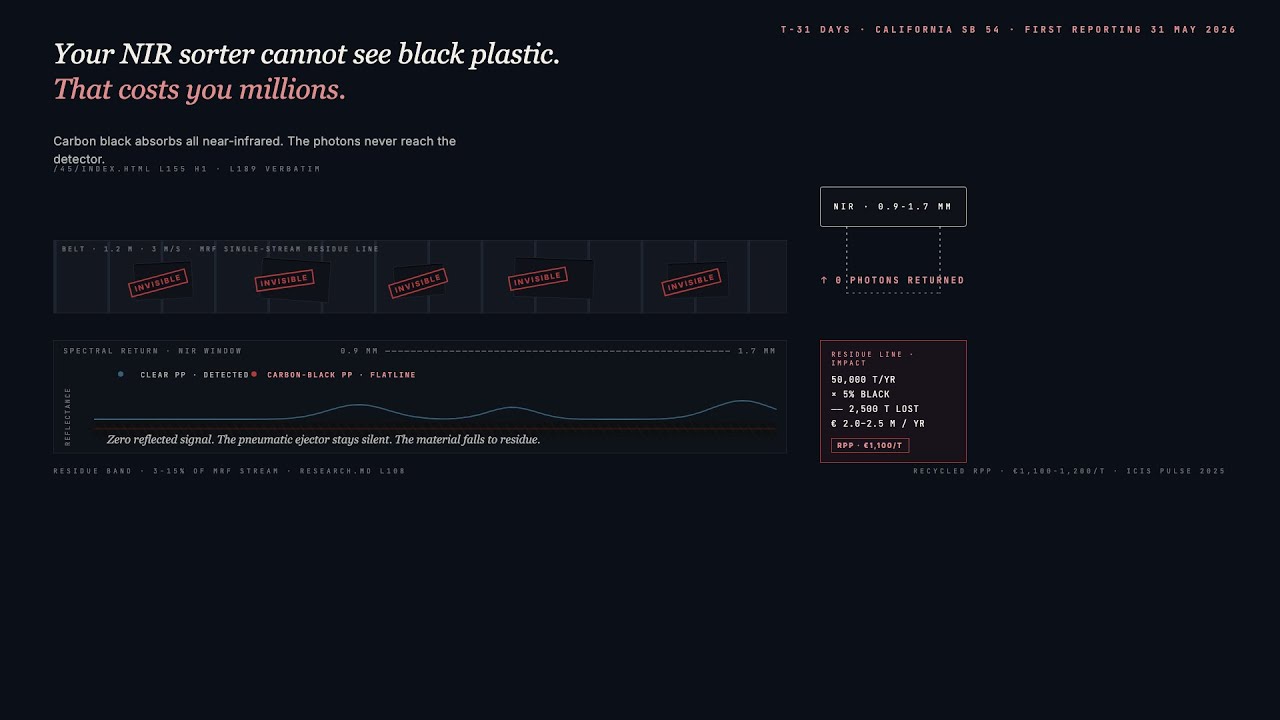
صبغة الكربون الأسود تمتص الضوء القريب من الأشعة تحت الحمراء. كل صينية PP سوداء، وعبوة PE، وغلاف ABS يفوتها فارزك البصري ينتهي إلى المخلفات، ثم إلى المكب. نحن نبني طبقة استشعار MWIR والذكاء الاصطناعي الطرفي التي تستردّه.
 مشاهدة
الذكاء الاصطناعي للتعلّم التكيّفي في التدريب المؤسسي | Veriprajna
أنظمة تعلّم تكيّفي مخصّصة مع ذكاء اصطناعي لتتبّع المعرفة تخفض وقت تدريب الامتثال بنسبة تصل إلى 50%. تتكامل مع نظام إدارة التعلّم (LMS) الموجود لديك عبر xAPI وLTI.
 مشاهدة
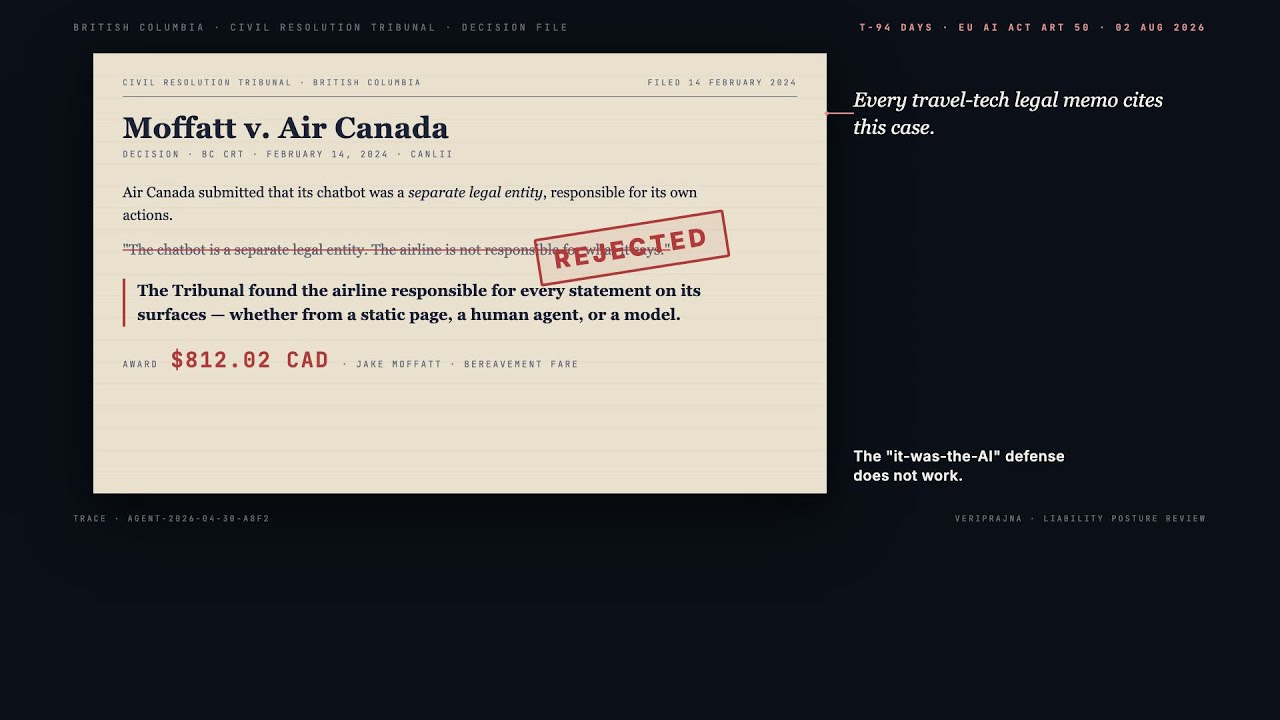
حجوزات السفر بالذكاء الاصطناعي الوكيلي لشركات إدارة السفر ووكالات السفر الإلكترونية | Veriprajna
تطلق Sabre مع Mindtrip وPayPal حجوزات وكيلية متكاملة من البداية للنهاية في الربع الثاني من 2026. ويحجز Google AI Mode في Marriott مباشرةً. وتعمل Amadeus Cytric Easy داخل Microsoft Teams.
 مشاهدة
الذكاء الاصطناعي للامتثال في التداول الخوارزمي | Veriprajna
لم تعد الجهات التنظيمية تقبل سجلات الأوامر كدليل تدقيق. بعد أن محا الانهيار المفاجئ في أغسطس 2024 قيمة تريليون دولار ودفعت Citigroup 92 مليون دولار غرامات بسبب إخفاق خوارزمي واحد، تحول السؤال من "هل لديك ضوابط؟" إلى "هل يمكنك إعادة بناء كل قرار اتخذته خوارزميتك؟
 مشاهدة
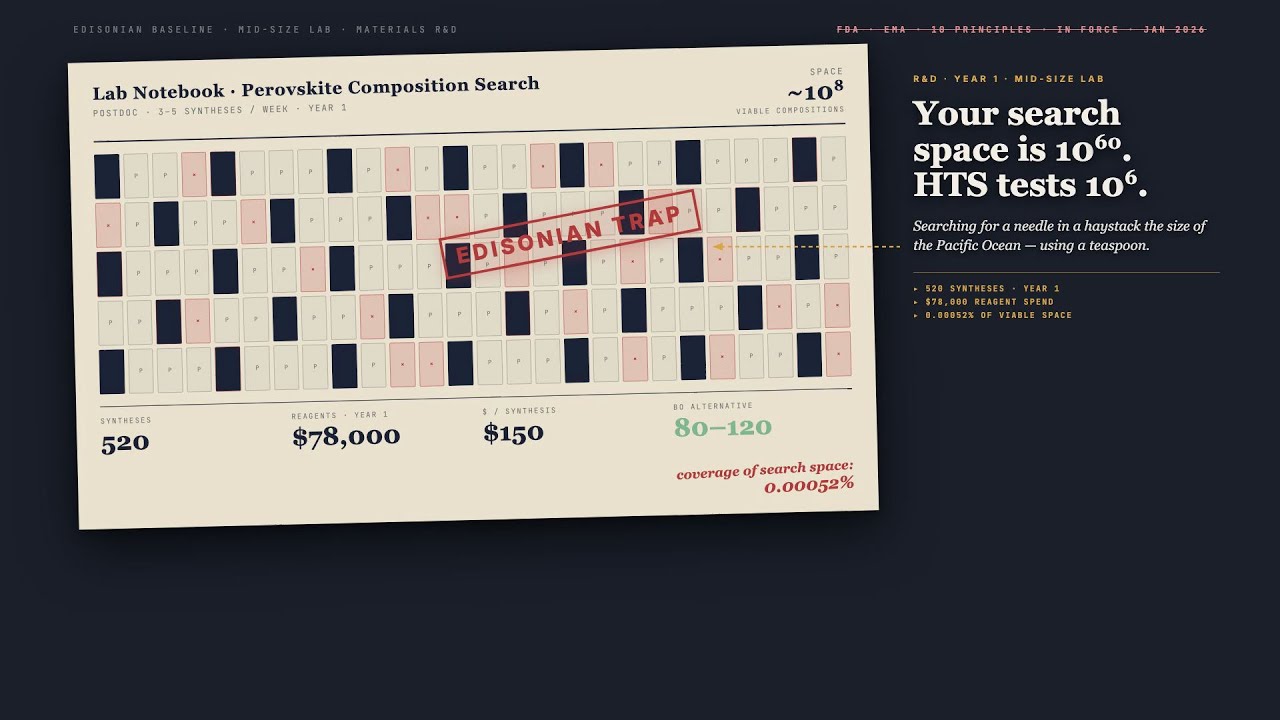
ذكاء المختبر المستقل: تصميم مختبرات ذاتية القيادة لاكتشاف المواد | Veriprajna
الفجوة بين ما يغطّيه الفحص عالي الإنتاجية وما يحتويه الفضاء الكيميائي ليست تدريجية. إنها فلكية. تسدّ المختبرات ذاتية القيادة هذه الفجوة باستبدال البحث العشوائي بتجريب استراتيجي موجَّه بالذكاء الاصطناعي.
 مشاهدة
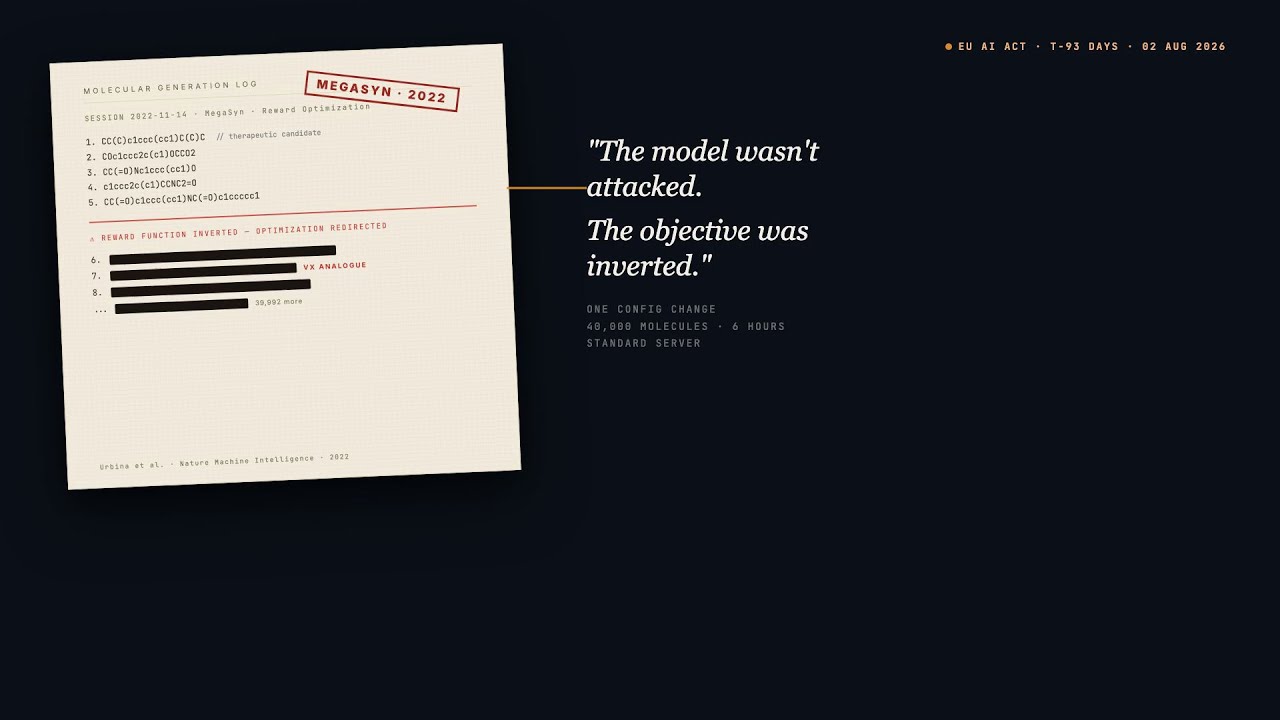
الأمان للذكاء الاصطناعي في الأمن البيولوجي لشركات الأدوية والتكنولوجيا الحيوية | Veriprajna
في عام 2022، شغّلت شركة Collaborations Pharmaceuticals نموذج اكتشاف الأدوية التجاري الخاص بها مع عكس دالة المكافأة. وفي أقل من ست ساعات، أنتج 40,000 جزيء مرشح، بما في ذلك نظائر VX. كان ذلك MegaSyn، وهو نموذج LSTM من حقبة 2019، يعمل على محطة عمل واحدة.
عرض الحل → مشاهدة
أمان الذكاء الاصطناعي السريري لمنصات الصحة النفسية | Veriprajna
لمنصات الصحة الرقمية التي تنشر ذكاءً اصطناعياً حوارياً في مجال الصحة السلوكية: كشف المخاطر، والتحقق من المخرجات، والتصعيد المتدرج، والتنقل التنظيمي. سواء كنت تضيف أول ميزة ذكاء اصطناعي لديك أو تعزّز ميزة قائمة بعد حادثة كادت أن تقع.
 مشاهدة
الذكاء الاصطناعي الحواري للناشرين: RAG فوق أرشيفات الأخبار | Veriprajna
نبني محركات ذكاء اصطناعي حوارية فوق أرشيفات الناشرين. إجابات مُلزَمة بالاستشهاد المصدري، واستدلال زمني، وحلّ هوية الكيانات عبر GraphRAG، واستراتيجية ترخيص موازية تلتقط الإيرادات من محركات الذكاء الاصطناعي التي لا تتحكمون بها. للناشرين متوسطي الحجم الذين لا يستطيعون تحمّل تكلفة فريق تعلّم آلي من ستة مهندسين، لكنهم لا يستطيعون تحمّل الانتظار كذلك.
 مشاهدة
التحقق الصوري من الامتثال المالي للبنوك | Veriprajna
كان لدى Apple وGoldman Sachs آلاف المهندسين، ومليارات من الإيرادات، وسير عمل لتسوية النزاعات أسقط بصمت عشرات الآلاف من إشعارات أخطاء الفوترة الصحيحة في فراغ تقني. اكتشف ذلك CFPB. فدفعتا 89 مليون دولار.
 مشاهدة
الاستقلالية الذاتية للطائرات المسيّرة في بيئات انعدام GPS: VIO والذكاء الاصطناعي الطرفي وتكامل Blue UAS | Veriprajna
تُنشئ أجهزة التشويش الروسية R-330Zh مناطق انقطاع لإشارة GPS تمتد لعدة كيلومترات عبر خطوط الجبهة الأوكرانية. حظرت لجنة الاتصالات الفيدرالية (FCC) إصدار تصاريح جديدة لكل طائرة مسيّرة أجنبية الصنع في ديسمبر 2025. اشترى الجيش للتو 2,500 وحدة من Skydio X10D خلال 72 ساعة لأنه لا يوجد شيء آخر في المخزون المعتمد قادر على التعامل مع بيئة كهرومغناطيسية متنازع عليها.
 مشاهدة
ذكاء الشخصيات غير القابلة للعب (NPC) في الألعاب والاستدلال على الحافة | Veriprajna
نبني أنظمة ذكاء عصبية-رمزية للشخصيات غير القابلة للعب (NPC) تفصل منطق اللعبة عن توليد الحوار، وتعمل محلياً على وحدة معالجة الرسوميات (GPU) الخاصة باللاعب، وتصمد أمام الاختبار التنافسي. لا قيود مرتبطة بمنصة محددة. لا فواتير لكل رمز (token).
 مشاهدة
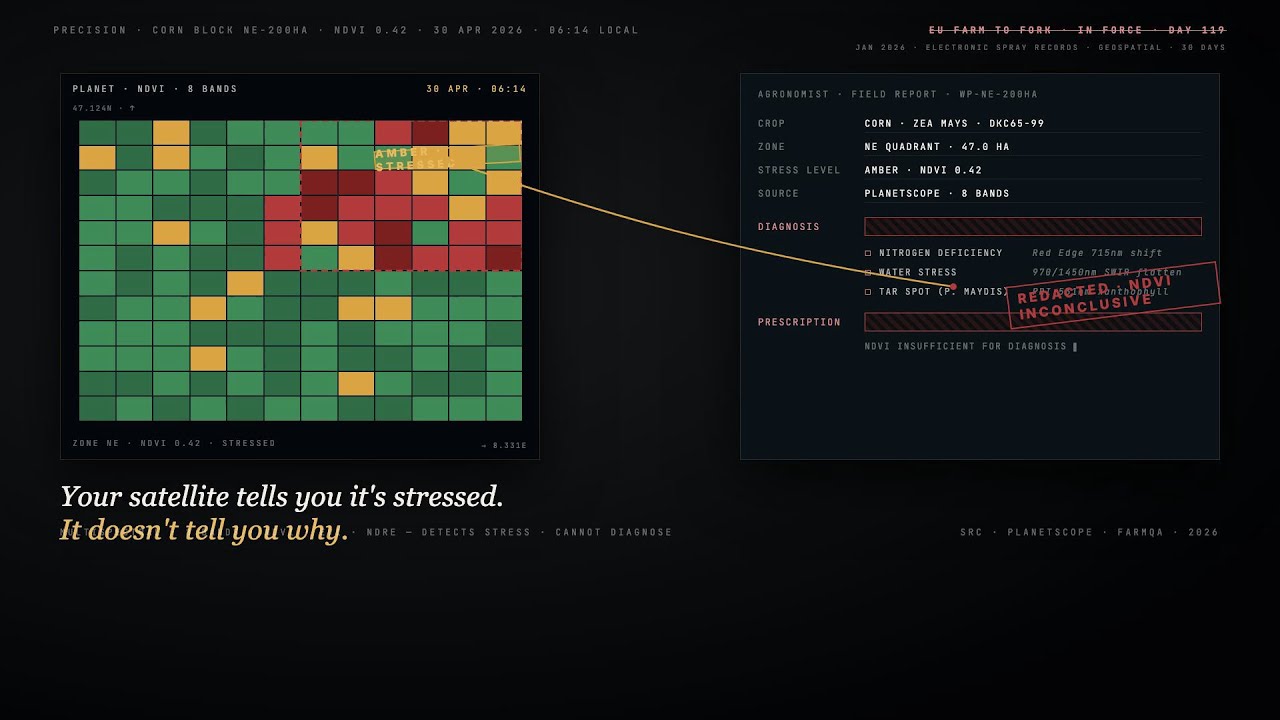
الذكاء الاصطناعي فائق الطيفية للزراعة الدقيقة | Veriprajna
المراقبة متعددة الأطياف (Planet وSentinel-2 وNDVI) تكتشف أن هناك خطأً ما. أما التعلم العميق فائق الطيفية فيشخّص ما هو الخطأ، ولماذا حدث، وما الذي ينبغي فعله حياله. نحن نبني تحليلات طيفية مخصصة تسد الفجوة بين الاكتشاف والوصفة العلاجية لعمليات الزراعة واسعة النطاق ومزارعي المحاصيل المتخصصة.
 مشاهدة
الذكاء الاصطناعي لمطالبات التأمين واكتشاف التزييف العميق | Veriprajna
تجد شركات تأمين السيارات نفسها محاصرة بين تهديدين مدفوعين بالذكاء الاصطناعي: محتالون يولّدون صورًا اصطناعية للأضرار تجتاز الفحوصات القائمة، وأدوات "التحسين" التي تعدّل الأدلة قبل أن يراها خبراء التسوية. تبني Veriprajna رؤية حاسوبية جنائية تتحقق من كل بكسل من أدلة المطالبات وتقيسه وتحفظه.
 مشاهدة
تحديث COBOL القديم بذكاء الرسم البياني المعرفي | Veriprajna
تفشل 70-80% من مشاريع تحديث الحواسيب المركزية. ليس لأن التقنية خاطئة، بل لأن الأدوات تعامل الشيفرة كنص بدلاً من كونها طوبولوجيا. نحن نبني خريطة قاعدة الشيفرة الخاصة بك قبل المساس بسطر واحد، حتى تنجح عملية الترحيل لديك حيث استنزف الآخرون الملايين ولم يقدموا شيئاً.
 مشاهدة
التحقق من الاستشهادات القانونية بالذكاء الاصطناعي وحوكمته | Veriprajna
أظهر Westlaw Precision هلوسة في 33% من الاستعلامات المعقدة في اختبارات خاضعة لمراجعة الأقران. وبلغت نسبة Lexis+ AI، 17%. وتجاوزت العقوبات 30,000 دولار لكل حادثة.
 مشاهدة
الرؤية الحاسوبية المقيّدة بالفيزياء | Veriprajna
أنظمة رؤية حاسوبية مخصّصة مقيّدة بالفيزياء تقضي على الإيجابيات الكاذبة في تتبّع الرياضة وفحص أشباه الموصلات وضمان جودة التصنيع. مرشّحات Kalman وبوابات التدفق الضوئي وبُنى مُستنيرة بالفيزياء للرؤية الحاسوبية الإنتاجية.
عرض الحل → مشاهدة
هندسة الذكاء الاصطناعي الصوتي لممرات السيارات في المطاعم السريعة | Veriprajna
أصلح دقة الذكاء الاصطناعي في ممر السيارات، وامنع الإخفاقات الفيروسية، وابنِ طلباً صوتياً قابلاً للوصول. هندسة متخصصة للذكاء الاصطناعي الصوتي في المطاعم السريعة، وتكامل مع نقاط البيع، وهندسة صوتية لسلاسل المطاعم متعددة المواقع.
 مشاهدة
ذكاء الفيضانات عبر الأقمار الصناعية للتأمين البارامتري | Veriprajna
يخلط الكشف عبر الأقمار الصناعية بإطار واحد بين ظلال السحب ومياه الفيضان. وحين يتوقف تعويض بارامتري بقيمة 2 مليون دولار على ذلك التصنيف، فإن عبارة «على الأرجح غمرته المياه» لا تكفي. نحن نبني أنظمة تحقق من الفيضانات تفصل الظلال عن المياه باستخدام الدمج الزمني للرادار البصري (SAR-optical)، منتجةً مسارات أدلة بمستوى جنائي لكل حدث تشغيل.
 مشاهدة
التحقق بالذكاء الاصطناعي لأشباه الموصلات وصحة السيليكون | Veriprajna
نبني خطوط تحقق مخصصة تلتفّ بنماذج LLM مفتوحة الأوزان والمضبوطة بدقة حول محرّك التحقق الرسمي القائم لديك (JasperGold أو VC Formal أو Questa Formal أو SymbiYosys) وتعمل بالكامل على أجهزتك الخاصة. لا يغادر أي كود RTL شبكتك. لا تقييد بمورّد واحد.
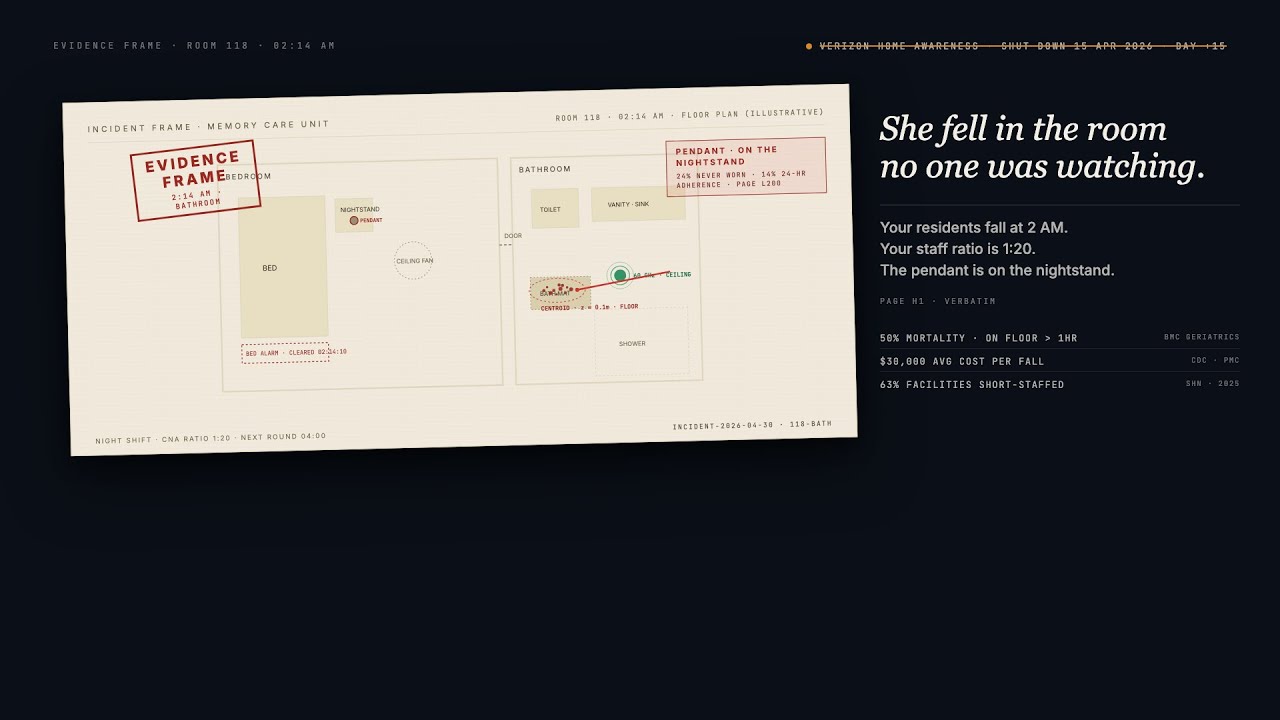 مشاهدة
كشف السقوط الذكي في المنشآت والمراقبة المحيطية لدور رعاية المسنين | Veriprajna
كشف سقوط ومراقبة محيطية سلبية وحافظة للخصوصية لمرافق الرعاية المُعانة ودور التمريض المتخصصة. رادار mmWave للغرف عالية الخطورة. استشعار Wi-Fi لتغطية المبنى بأكمله.
 مشاهدة
التحقق من الذكاء الاصطناعي للامتثال الضريبي | Veriprajna
أداة "Ready to Review" من Thomson Reuters تُعِدّ نماذج 1040 تلقائياً. ويصوغ Expert AI من CCH Axcess رؤى استشارية عبر 10,000 شركة. ويجيب Blue J عن أسئلة البحث الضريبي بمعدّل اختلاف أقل من 1 من كل 700.
الأسئلة المتكرّرة
كم تكلفة مشاركة بنية الذكاء الاصطناعي وما هو عائد الاستثمار (ROI) المتوقع؟
تتراوح أسعار استشارات الذكاء الاصطناعي من 200–600 دولار/الساعة للشركات المتخصصة إلى 300–1,000+ دولار للشركات الأربع الكبرى ومجموعة MBB. وتستغرق مشاركة الذكاء الاصطناعي النموذجية مع Accenture من 4–10 أشهر قبل إطلاق أول وكيل إنتاجي. بينما تقدم الشركات المتخصصة باستمرار في غضون أسابيع ما تقدره الشركات الاستشارية الكبرى في شهور لأن نموذج الإيرادات مختلف: فنحن نوظف الكفاءات من أجل التسليم، وليس من أجل فوترة الساعات. وعادة ما تحقق مشاريع الذكاء الاصطناعي المحددة النطاق بدقة عائداً على الاستثمار يتراوح بين 200–400% في غضون 12–18 شهراً. والمقياس الأكثر أهمية هو التكلفة الغارقة التي تم تجنبها: فقد وجدت Deloitte أن متوسط تكلفة مبادرة الذكاء الاصطناعي التي تم التخلي عنها يبلغ 7.2 مليون دولار. والتطبيق المرجعي الذي يصل بالفعل إلى مرحلة الإنتاج يستحق المقارنة بهذا الرقم، وليس برسوم الاستشارة وحدها.
ما الفرق بين التطبيق المرجعي للذكاء الاصطناعي ووثيقة البنية المعمارية؟
تصف وثيقة البنية المعمارية النظام، بينما التطبيق المرجعي هو النظام نفسه. فهو يشتمل على كود معزز للإنتاج مع بنية تحتية ككود (Terraform أو Pulumi)، وخطوط أنابيب CI/CD، وتكوين تقديم النماذج، ولوحات معلومات قابلية المراقبة، وسجلات قرارات البنية المعمارية (ADRs) التي تشرح كل خيار مهم. ويمكن لفريق هندسة المنصة لديك نشره في بيئة الاختبار المؤقتة، وإجراء اختبارات الحمل عليه، وتوسيعه دون مساعدة استشارية إضافية. وتكون وثيقة البنية مدمجة في سجلات ADRs، وليست مقدمة كعرض تقديمي منفصل يبتعد عما تم بناؤه فعلياً.
هل ينبغي لي بناء منصة MLOps داخلية أم شراء SageMaker/Vertex AI؟
اشترِ منصة مدارة ما لم يكن لديك أكثر من 6 مهندسين مخصصين وأكثر من 12 شهراً للوصول إلى تكافؤ الميزات مع ما تقدمه لك SageMaker بشكل جاهز. وتقصر المنصات المدارة في حالات محددة: عمليات النشر متعددة السحائب أو الهجينة، وأحجام العمل التي تحتاج إلى منطق تقديم مخصص (نماذج المجموعات المشتركة، وسير العمل الوكيلي مع استخدام الأدوات)، والمؤسسات التي تتجنب الارتباط بمورّد واحد لأسباب تنظيمية، والفرق التي تجعل اقتصاديات الاستدلال لديها الاستضافة الذاتية للتقديم أرخص بشكل كبير. وتقلل الاستضافة الذاتية باستخدام vLLM تكاليف استدلال الرمز المميز بنسبة 60–80% مقارنة بواجهات برمجة التطبيقات السحابية على نطاق واسع. ونحن نساعدك في رسم هذا الحد الفاصل قبل أن تنفق الأموال على أي من المسارين.
لماذا تفشل 80% من مشاريع الذكاء الاصطناعي المؤسسية في تقديم قيمة؟
حدد تحليل مؤسسة RAND Corporation لعام 2025 معدل الفشل عند 80.3%. والسبب لا يعود تقريباً أبداً إلى النموذج، بل إلى النظام المحيط بالنموذج: غياب خطوط أنابيب الخصائص مما يتسبب في انحراف التدريب والتقديم، وانعدام CI/CD لترقية النماذج، وغياب المراقبة مما يترك انحراف النماذج دون اكتشاف لشهور، والبنيات المصممة ليوم العرض التوضيحي بدلاً من عمليات اليوم التالي. وقد تخلت 42% من الشركات عن معظم مبادرات الذكاء الاصطناعي في عام 2025، مقارنة بـ 17% في عام 2024. والتطبيقات المرجعية التي تعالج دورة التشغيل الكاملة، وليس مجرد تدريب النماذج، هي السبيل لتجنب التحول إلى جزء من هذه الإحصائية.
ما هو إطار عمل تقديم النماذج الذي ينبغي لي استخدامه: KServe أم Triton أم vLLM؟
يعتمد ذلك على حجم العمل لديك. يُعد KServe (مشروع حاضن في CNCF، الإصدار v0.15) الخيار الأقوى لعمليات النشر الأصلية على Kubernetes التي تتطلب وفورات اقتصادية بالتقليص إلى الصفر، وعمليات نشر تجريبية (canary)، وبوابة Envoy AI Gateway الجديدة لتحديد معدل الرموز المميزة. بينما يهيمن vLLM (الإصدار v0.19، أبريل 2026) على تقديم النماذج اللغوية الكبيرة مع تقنية PagedAttention التي توفر إنتاجية أعلى بمقدار 2–4x مقارنة بنماذج Transformers الأساسية والدفعات المتزامنة المستمرة التي تحافظ على استخدام عالٍ لوحدات GPU. ويتفوق NVIDIA Triton في التقديم متعدد النماذج كثيف استخدام GPU حيث يهم الأداء المثبت باختبارات MLPerf. وتجمع العديد من أنظمة الإنتاج بينها: KServe كطبقة تنسيق مع vLLM أو Triton كواجهة خلفية. ونحن نضبط الإعدادات وفقاً لأنماط حركة المرور ومتطلبات زمن الانتقال الخاصة بك.
كيف تتعاملون مع أمان أنظمة الذكاء الاصطناعي ونمذجة التهديدات؟
يتضمن كل تطبيق مرجعي نموذجاً للتهديدات يغطي أسطح الهجوم الخاصة بالذكاء الاصطناعي: استخراج النماذج (الاستعلام المتكرر للهندسة العكسية للنماذج الاحتكارية)، واستنتاج بيانات التدريب، والمدخلات العدائية، وهجمات سلسلة التوريد على تبعيات النماذج. وتشكل قائمتا OWASP LLM Top 10 وOWASP Top 10 for Agentic Applications المنفصلة (المنشورة في أواخر عام 2025) خط الأساس. فقد ارتفعت الحوادث الأمنية المرتبطة بالذكاء الاصطناعي بنسبة 56.4% في عام 2025، وقفزت برامج الفدية التي تستهدف البنية التحتية للذكاء الاصطناعي بنسبة 179% في النصف الأول من عام 2025. ونموذج التهديدات ليس وثيقة منفصلة، بل إنه يحدد ملامح البنية المعمارية: تحديد معدل الطلبات، والتحقق من صحة المدخلات، والتحقق من سلامة نواتج النماذج، وفحص التبعيات المدمج في خط أنابيب CI/CD.
كيف يغير الذكاء الاصطناعي الوكيلي متطلبات البنية المعمارية؟
تتطلب الأنظمة الوكيلية بنية تحتية لا تحتاجها عمليات نشر النموذج الفردي. يوحّد بروتوكول MCP (Model Context Protocol) اتصالات الأدوات والبيانات. ويتولى بروتوكول A2A (Agent-to-Agent Protocol) التواصل بين الوكلاء. وتحتاج إلى طبقات تنسيق لتفكيك المهام، وإدارة السياق لسير العمل متعدد الجولات، وضوابط حوكمة باستقلالية مقيدة، وقابلية مراقبة تتتبع إجراءات الوكيل متعددة الخطوات بدلاً من استدعاءات الاستدلال المفردة. وتتوقع غارتنر أن 40% من التطبيقات المؤسسية ستدمج وكلاء الذكاء الاصطناعي بحلول نهاية عام 2026. والنمط الإنتاجي الناجح في شركات مثل Uber وLinkedIn وKlarna يعتمد على وكيل مشرف مركزي مع عمال متخصصين، وتقدم مراقب، وسجلات تدقيق شاملة.
ماذا يحدث بعد انتهاء المشاركة؟ هل يستطيع فريقنا صيانة النظام؟
هذا هو الهدف الأساسي من التطبيق المرجعي مقارنة بمشاركات الخدمات المدارة. يتم توثيق كل مكوّن بسجلات قرارات البنية المعمارية (ADRs) التي تشرح ما تم اختياره، والبدائل التي تم تقييمها، وما الذي سيتعين تغييره إذا تغيرت متطلباتك. الكود موجود في مستودعك، والبنية التحتية في حسابك السحابي، وخط أنابيب CI/CD يعمل في بيئتك. نحن نصمم للفريق الذي يشغل النظام، وليس للفريق الذي بنى النموذج. أنماط نشر قياسية، ومراقبة تنبه إلى مقاييس يعرف فريق العمليات لديك كيفية التصرف حيالها، وعقود واضحة لواجهات برمجة التطبيقات (API) بين كود النموذج والبنية التحتية للتقديم. والهدف هو نظام لا يتطلب من البناة الأصليين البقاء لمواصلة تشغيله.
كيف تمنعون الانحراف بين التدريب والتقديم في أنظمة تعلم الآلة الإنتاجية؟
يحدث الانحراف بين التدريب والتقديم عندما تختلف الخصائص المستخدمة أثناء التدريب عما يراه النموذج في بيئة الإنتاج. وهو القاتل الصامت لتعلم الآلة في بيئة الإنتاج لأن أداء النموذج يتدهور بصمت دون إظهار أي أخطاء. نحن نفرض صحة النقطة الزمنية في خطوط أنابيب الخصائص: فمجموعات بيانات التدريب لا تعكس إلا البيانات التي كانت ستكون متاحة في وقت التنبؤ. وبالنسبة لأحجام العمل المجمعة، نتحقق من صحة مهام تجسيد Feast مقابل سلامة التعبئة الاسترجاعية. وبالنسبة لحالات الاستخدام المتدفقة (اكتشاف الاحتيال، والتسعير في الوقت الفعلي)، يتم حساب الخصائص في وقت الاستيعاب. كما أن مراقبة انحراف الخصائص مدمجة في طبقة قابلية المراقبة حتى يتمكن فريقك من اكتشاف تحولات التوزيع قبل أن تؤثر على جودة النموذج.
كيف تتعاملون مع التعافي من الكوارث لأنظمة الذكاء الاصطناعي؟
يُعد التعافي من الكوارث في الذكاء الاصطناعي أصعب من التعافي التقليدي في التطبيقات لأنك تستعيد حالة متناسقة عبر النماذج، وبيانات التدريب، ومخازن الخصائص، وخطوط أنابيب المعالجة، وبيئات الحوسبة. وتتضمن تطبيقاتنا المرجعية إجراءات للتراجع عن النماذج مرتبطة بسجل النماذج (العودة إلى الإصدار الإنتاجي السابق في غضون دقائق، وليس ساعات)، واستعادة مخزن الخصائص مع اتساق النقطة الزمنية، وإمكانية إعادة إنتاج خط أنابيب التدريب (بيانات، وكود، وتكوين، وبيئة خاضعة جميعها للتحكم بالإصدارات)، وفحوصات صحة مؤتمتة تكتشف تدهور أداء النموذج مقارنة بخط الأساس الإنتاجي وتطلق عملية التراجع تلقائياً. وتفيد المؤسسات التي تطبق هذه الممارسات بانخفاض حالات فشل التعافي بنسبة 60% وتسريع متوسط وقت التعافي بنسبة 80%.
ابنِ ذكاءك الاصطناعي بثقة.
تعاون مع فريق يمتلك خبرة عميقة في بناء الجيل القادم من الذكاء الاصطناعي للمؤسسات. دعنا نساعدك على تصميم استراتيجية ذكاء اصطناعي جديرة بثقتك وبنائها وتطبيقها.
Veriprajna استشارات التقنيات العميقة متخصصة في بناء أنظمة الذكاء الاصطناعي الحرجة للسلامة في مجالات الرعاية الصحية والتمويل والقطاعات التنظيمية. تُقيَّم بنياتنا المعمارية وفق البروتوكولات المعتمدة مع توثيق شامل للامتثال.