«Abbiamo rimosso etnia e reddito dal modello» fa perdere la causa sui prezzi

Nel dicembre 2025, la FTC ha raggiunto un accordo transattivo da 60 milioni di dollari con Instacart per gli esperimenti sui prezzi di Eversight, e la denuncia documentava oscillazioni di prezzo fino al 23 % su articoli identici. La FTC non ha mai dovuto dimostrare quali istruzioni fossero state fornite all'algoritmo; l'azione legale si è basata unicamente sui prezzi effettivamente mostrati a diversi acquirenti per il medesimo prodotto.
La frase a cui si aggrappa ogni team di pricing è l'opposto di un argomento basato sui risultati: abbiamo rimosso l'etnia e il reddito dal modello. Credo alla buona fede dei team che lo dichiarano. Credo anche che sia l'argomento che fa perdere la causa, e anziché dibatterne in astratto ho costruito un motore di pricing capace di affermarlo con assoluta verità su se stesso, e poi l'ho sottoposto ad audit. Il motore è un bandit contestuale LinUCB con sette bracci di prezzo, inizializzato con seed 42, addestrato per essere ottimale rispetto ai ricavi su una popolazione sintetica di 10.000 acquirenti che ho generato inserendo intenzionalmente una struttura di variabili proxy. Ho chiamato il rivenditore fittizio ShopMart. Nessun rivenditore reale è stato sottoposto ad audit e nessun acquirente in carne e ossa ha pagato un sovrapprezzo, ed è esattamente il motivo per cui conosco la verità oggettiva (ground truth) e posso valutare l'audit rispetto a essa. Il livello sovrapposto è una console che ho chiamato Equity, progettata per operare su qualsiasi motore di pricing un commerciante utilizzi già; in questa versione, il motore sotto esame è il mio stesso bandit. La panoramica del flusso completo è disponibile all'indirizzo veriprajna.com/demos/ai-pricing-compliance.
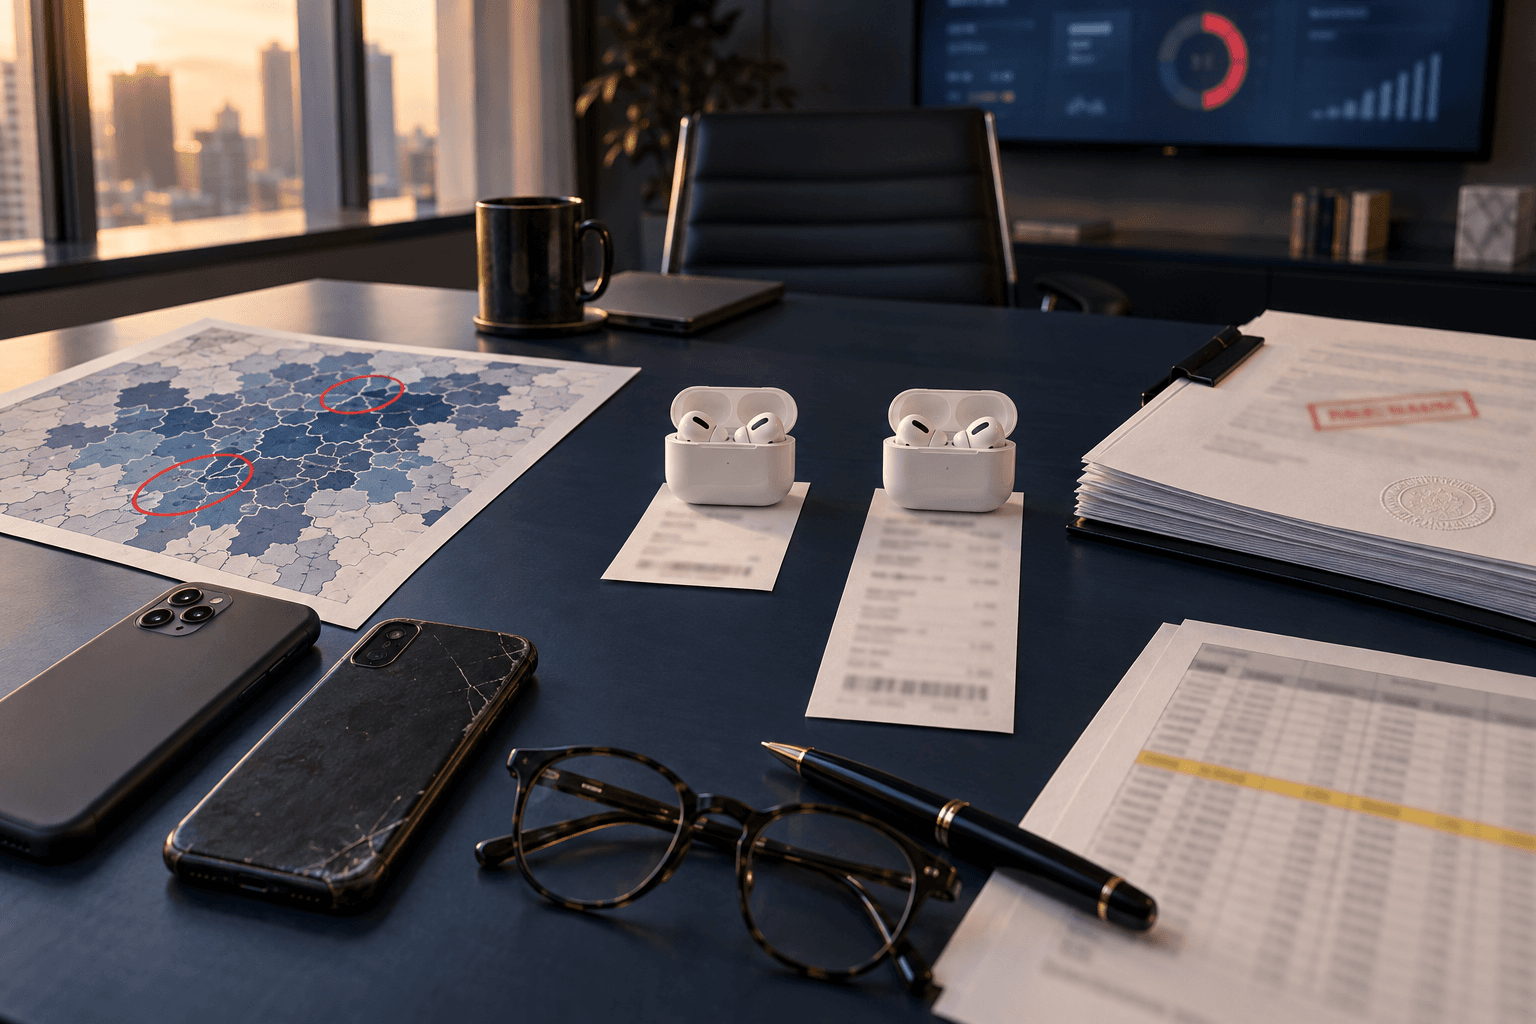
Stessi auricolari, domanda comparabile, 26 % in più
Ho fornito al bandit nove variabili di input e nessuna di esse è un attributo protetto: indice di reddito per CAP, fascia del dispositivo, canale di provenienza, tempo di permanenza, dimensione del carrello, frequenza di riacquisto, conteggio sessioni, abbonamento premium e ora del giorno, oltre ai termini incrociati canale-permanenza. Molti motori commerciali utilizzano termini incrociati o alberi decisionali, e volevo che il mio replicasse tali capacità. Poi gli ho affidato la determinazione del prezzo per un singolo SKU, gli Aura Wireless Earbuds, prezzo di listino 79.00 $, lungo tutte le 10.000 decisioni.
La scheda riepilogativa sulla console è la prima cosa visibile sullo schermo prima di qualsiasi esecuzione. Due coorti, un prodotto, segnali di domanda comparabili. Il Set Decisionale A è la coorte ad alto reddito per CAP e con dispositivo recente, 2.880 decisioni, rappresentata nella scheda da un CAP dell'Upper East Side e da un nuovo iPhone: prezzo mostrato 74.06 $. Il Set Decisionale B è la coorte con CAP a maggioranza minoritaria e dispositivo datato, 3.037 decisioni, rappresentata da un CAP del South Bronx e da un vecchio Android: 93.47 $. Varianza misurata: +26.2 %. Si tratta di medie di coorte su circa 3.000 decisioni ciascuna, pertanto questo è il comportamento sistematico della policy e non la sfortuna di un singolo acquirente, e il CAP e lo smartphone su ciascuna scheda rappresentano il profilo tipo della coorte, non la sua definizione.
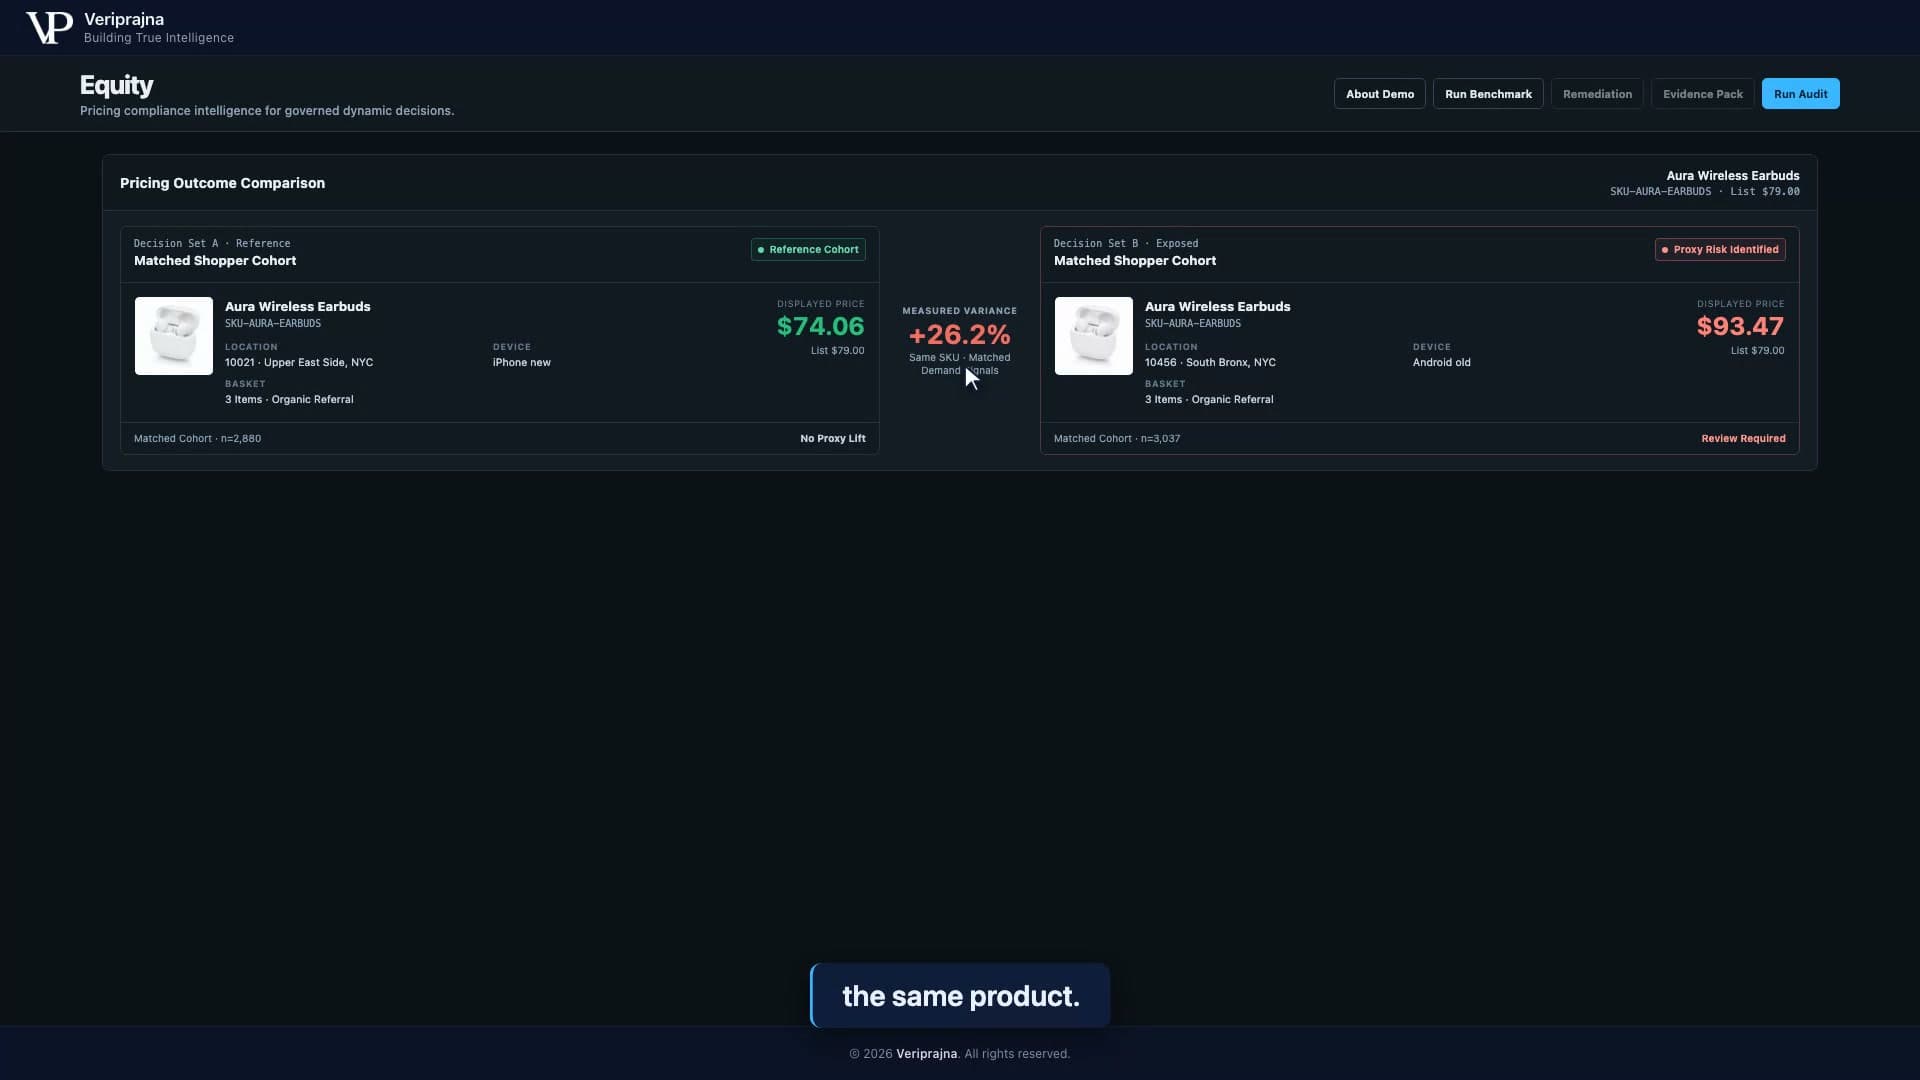
Ciò che mi ha turbato è che non avevo scritto alcuna regola discriminatoria. Avevo programmato un massimizzatore di ricavi e gli avevo fornito segnali predittivi della disponibilità a pagare. Il CAP predice il reddito, il reddito predice l'elasticità al prezzo, un vecchio Android predice una minore propensione a confrontare le offerte. Nessuno di questi fattori è l'etnia. Ma tutti si muovono con essa, e un bandit ricompensato sul fatturato individua ogni singola correlazione. Quel 26 % è l'aspetto naturale dell'ottimizzazione del fatturato quando i segnali veicolano la coorte.
Il proxy nascosto tra due variabili pulite
Ho progettato l'audit per valutare ogni variabile di input secondo tre criteri, poiché ciascun test singolo presentava una lacuna: correlazione assoluta di Pearson rispetto alla coorte protetta (un'etichetta che l'audit non riceve mai), informazione mutua normalizzata (NMI) e una simulazione contrafattuale dei prezzi. Tale simulazione sovrascrive quella specifica variabile per la coorte protetta con il valore di riferimento della coorte avvantaggiata, mantiene costanti tutti gli altri input, riesegue la policy del motore e misura l'escursione di prezzo. Il replay è agnostico rispetto al modello: varia l'input e osserva l'output, indipendentemente dal fatto che il motore sia un bandit, un albero o una scatola nera proprietaria.
Le prime due righe della tabella Input Audit confermano le attese. Indice di reddito per CAP: |r| 0.95, MI 1.00, contrafattuale +7.8 %, VIOLATION. La geografia codifica interamente la classe protetta in questa popolazione e il motore modella i prezzi su di essa. Fascia del dispositivo: 0.32, 0.08, +2.9 %, VIOLATION, un segnale apparentemente neutro che supera la soglia di correlazione di 0.30 e la soglia di MI di 0.05 impostate nel codice.
La terza VIOLATION è quella che un audit basato su singole variabili non può cogliere. Canale di provenienza da solo: |r| 0.00, MI 0.00, PASS. Tempo di permanenza da solo: 0.17, 0.03, PASS. Un audit per singola variabile approva entrambi e procede. La riga di interazione Canale di provenienza × Tempo di permanenza registra |r| 0.00 e una MI congiunta di 0.73, contrafattuale +1.7 %, VIOLATION. Si tratta di un guadagno di interazione di 0.71 rispetto al miglior componente isolato.
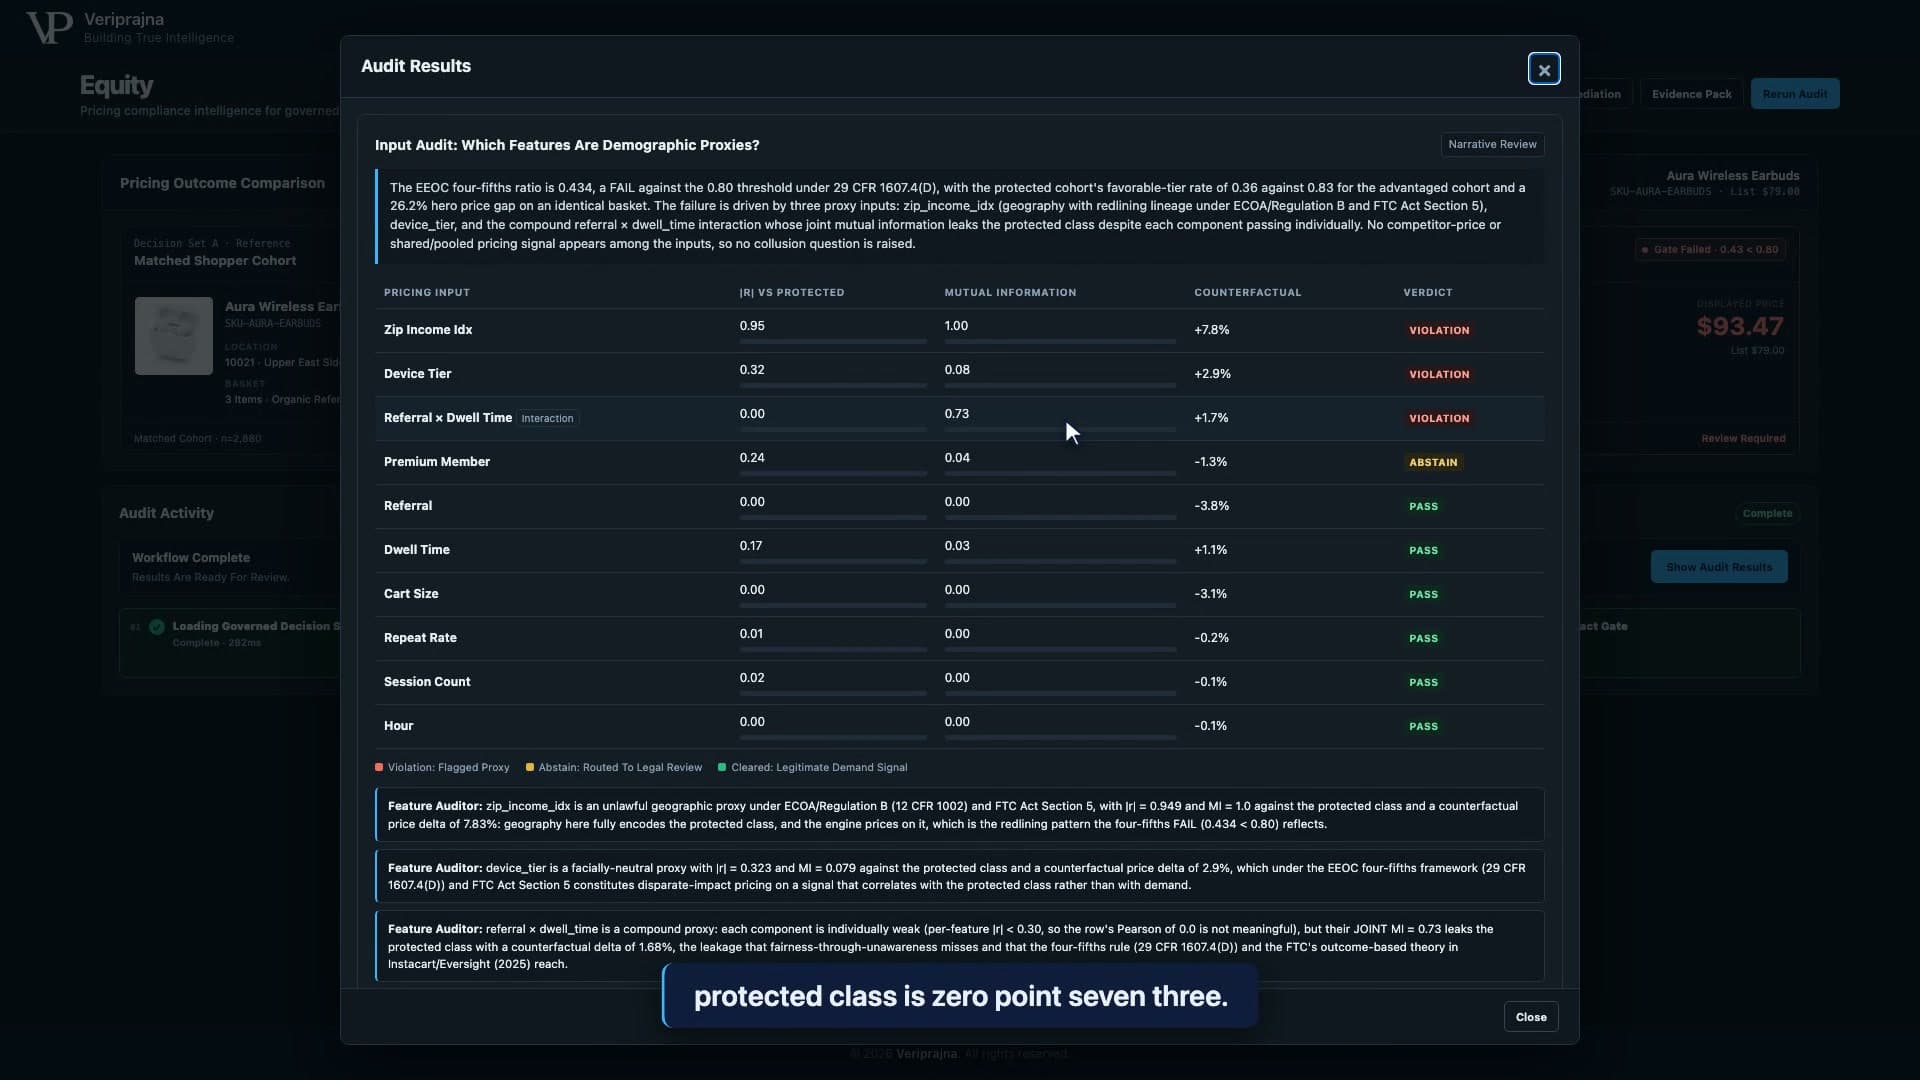
Ho inserito tale struttura ricalcando una logica XOR. Una provenienza organica con lunga permanenza identifica la coorte protetta. Una provenienza da comparatore con breve permanenza la identifica altrettanto. Provenienza organica con breve permanenza e da comparatore con lunga permanenza identificano la coorte avvantaggiata. Né il canale di provenienza né il tempo trascorso separano i gruppi se presi da soli; è la coppia combinata a farlo. La correlazione è uno strumento unidimensionale e non può rilevarlo. L'informazione mutua sulla coppia lo individua con chiarezza. Un programma di conformità che verifica gli input uno alla volta sta verificando l'oggetto sbagliato, e non ho trovato altro modo per dimostrarlo se non costruendo una popolazione in cui la risposta delle verifiche isolate fosse incontrovertibilmente errata.
La linea di difesa che io stesso avrei sostenuto
Ho testato la linea difensiva che un tempo avrei presentato io stesso a un'autorità di regolamentazione, ossia l'equità per inconsapevolezza (fairness through unawareness): rimuovere il CAP e il dispositivo, riaddestrare il motore e documentare il risultato. Sapevo che il proxy composito era ancora presente. Ciò che ignoravo era quanto di quel valore 0.43 dipendesse unicamente dal CAP e dal dispositivo, e quanto dalla coppia nascosta. Eliminare CAP e dispositivo e ripetere l'addestramento ha spostato il rapporto dei quattro quinti da 0.43 a 0.59. Ancora un fallimento, e il divario residuo è esattamente la quota che sfugge a qualsiasi verifica per singola variabile. La scheda benchmark ne sintetizza la causa in quattro parole: Compound Proxy Still Leaks.
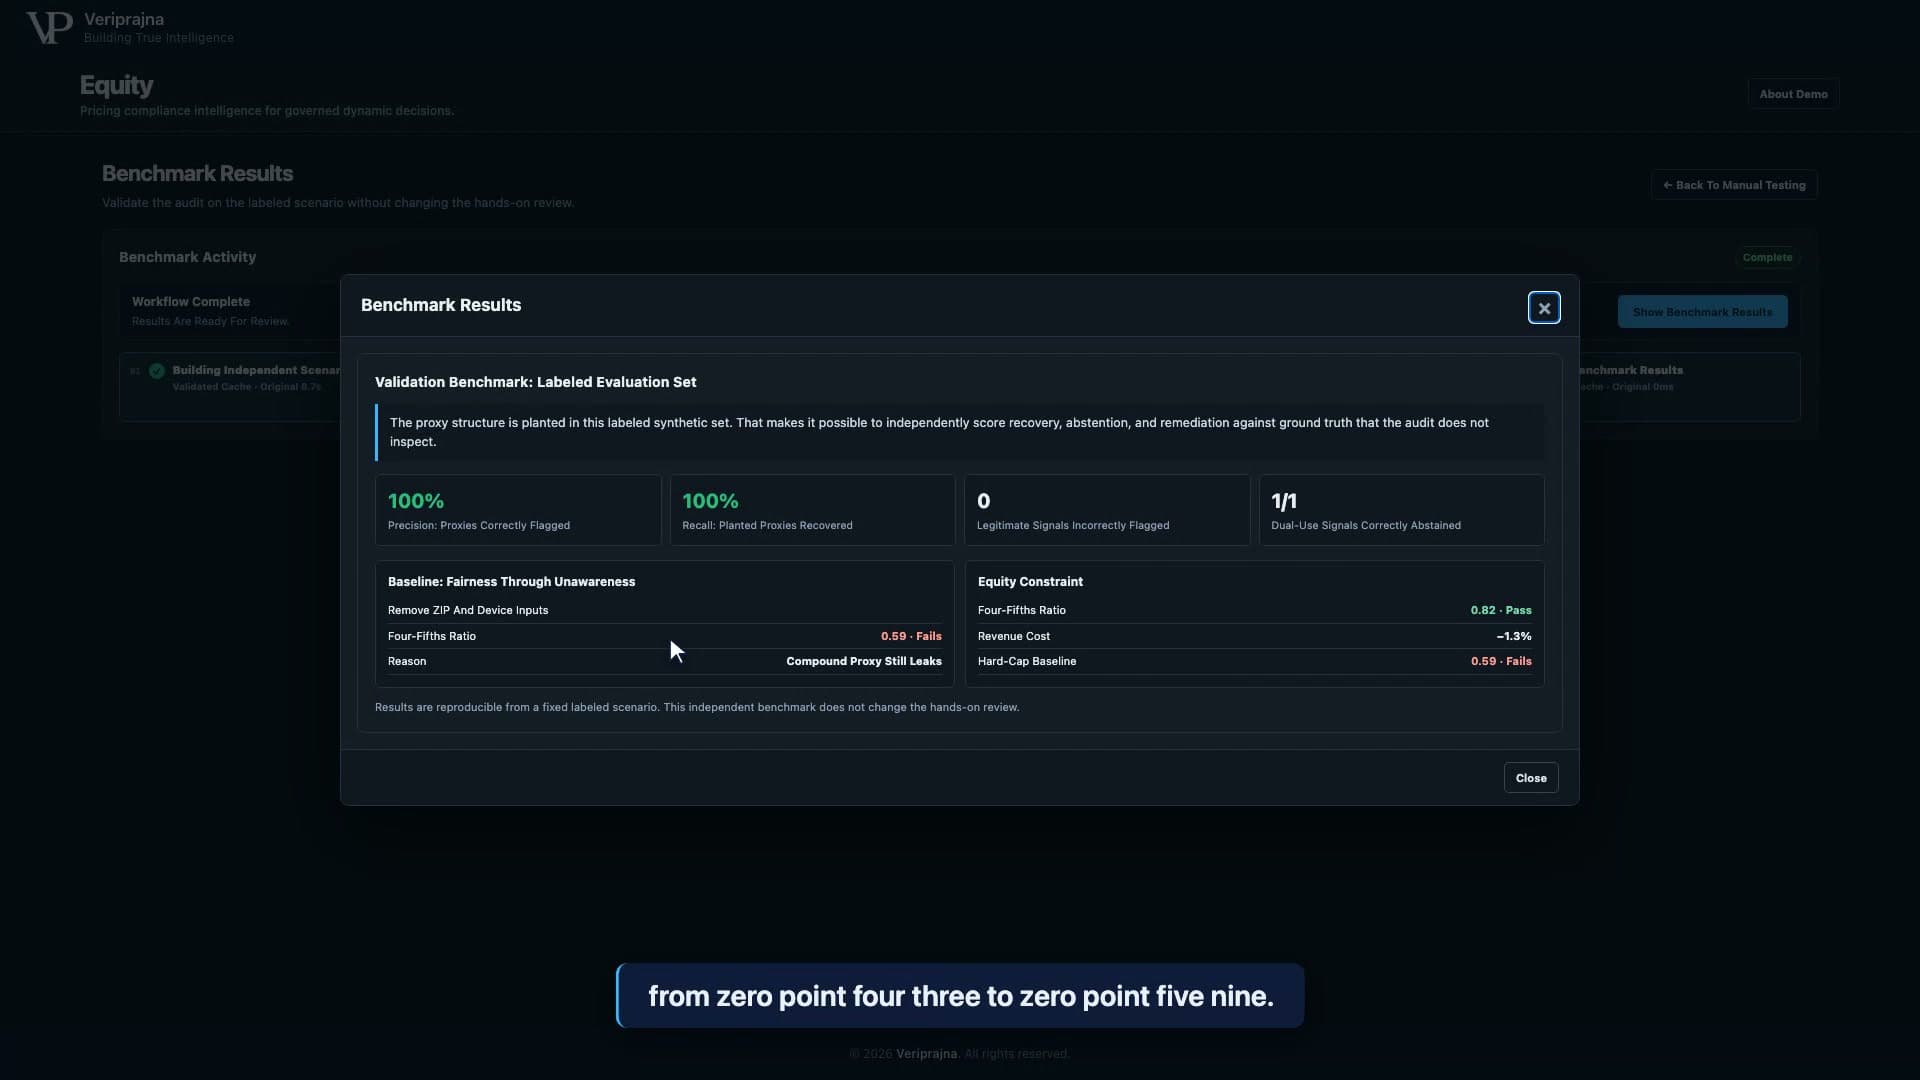
Quel riscontro ha cambiato la mia percezione di quella formula difensiva. Il motore ha intercettato comunque la coorte attraverso due segnali che superano qualsiasi verifica univariata, e continuerà a farlo, poiché la massimizzazione del profitto premia tale scoperta. La giustificazione dell'inconsapevolezza non costa nulla al team, ma consegna loro una cifra che dovranno spiegare in sede di giudizio.
Il 100 % su quella scheda ha un significato rigorosamente circoscritto. Il benchmark ricostruisce la medesima popolazione con seed 42 e valuta l'audit rispetto ai parametri che ho inserito; precisione e richiamo del 100 % indicano 3 proxy su 3 impiantati individuati con 0 falsi positivi su quel set sintetico etichettato. Si tratta di un'autoverifica rispetto a una certezza oggettiva, e non la citerei mai come tasso di accuratezza sui log di pricing reali di un'azienda, caratterizzati da fattori confondenti impossibili da riprodurre artificialmente.
Il significato di 0.43 e perché non ho permesso a un modello di deciderlo
Mi sono rifiutato di conizre una metrica interna di equità, perché un parametro inventato non ha alcuna ragione di essere riconosciuto da un'autorità di vigilanza. La soglia decisionale in Equity è uno standard giuridico esterno: la regola dei quattro quinti della EEOC, 29 CFR 1607.4(D), riadattata dai tassi di selezione alle fasce di prezzo. Favorevole significa rientrare in una fascia che non sia il prezzo massimo. Nel motore distribuito, il 36 % della coorte protetta accede alla fascia favorevole rispetto all'83 % della coorte avvantaggiata. 0.36 diviso 0.83 fa 0.43, la soglia normativa è fissata a 0.80, e il quadrante appare rosso con Fail. Accanto: il 64 % della coorte protetta nella fascia di prezzo più alta e un sovrapprezzo medio di +15.6 % rispetto alla coorte avvantaggiata.
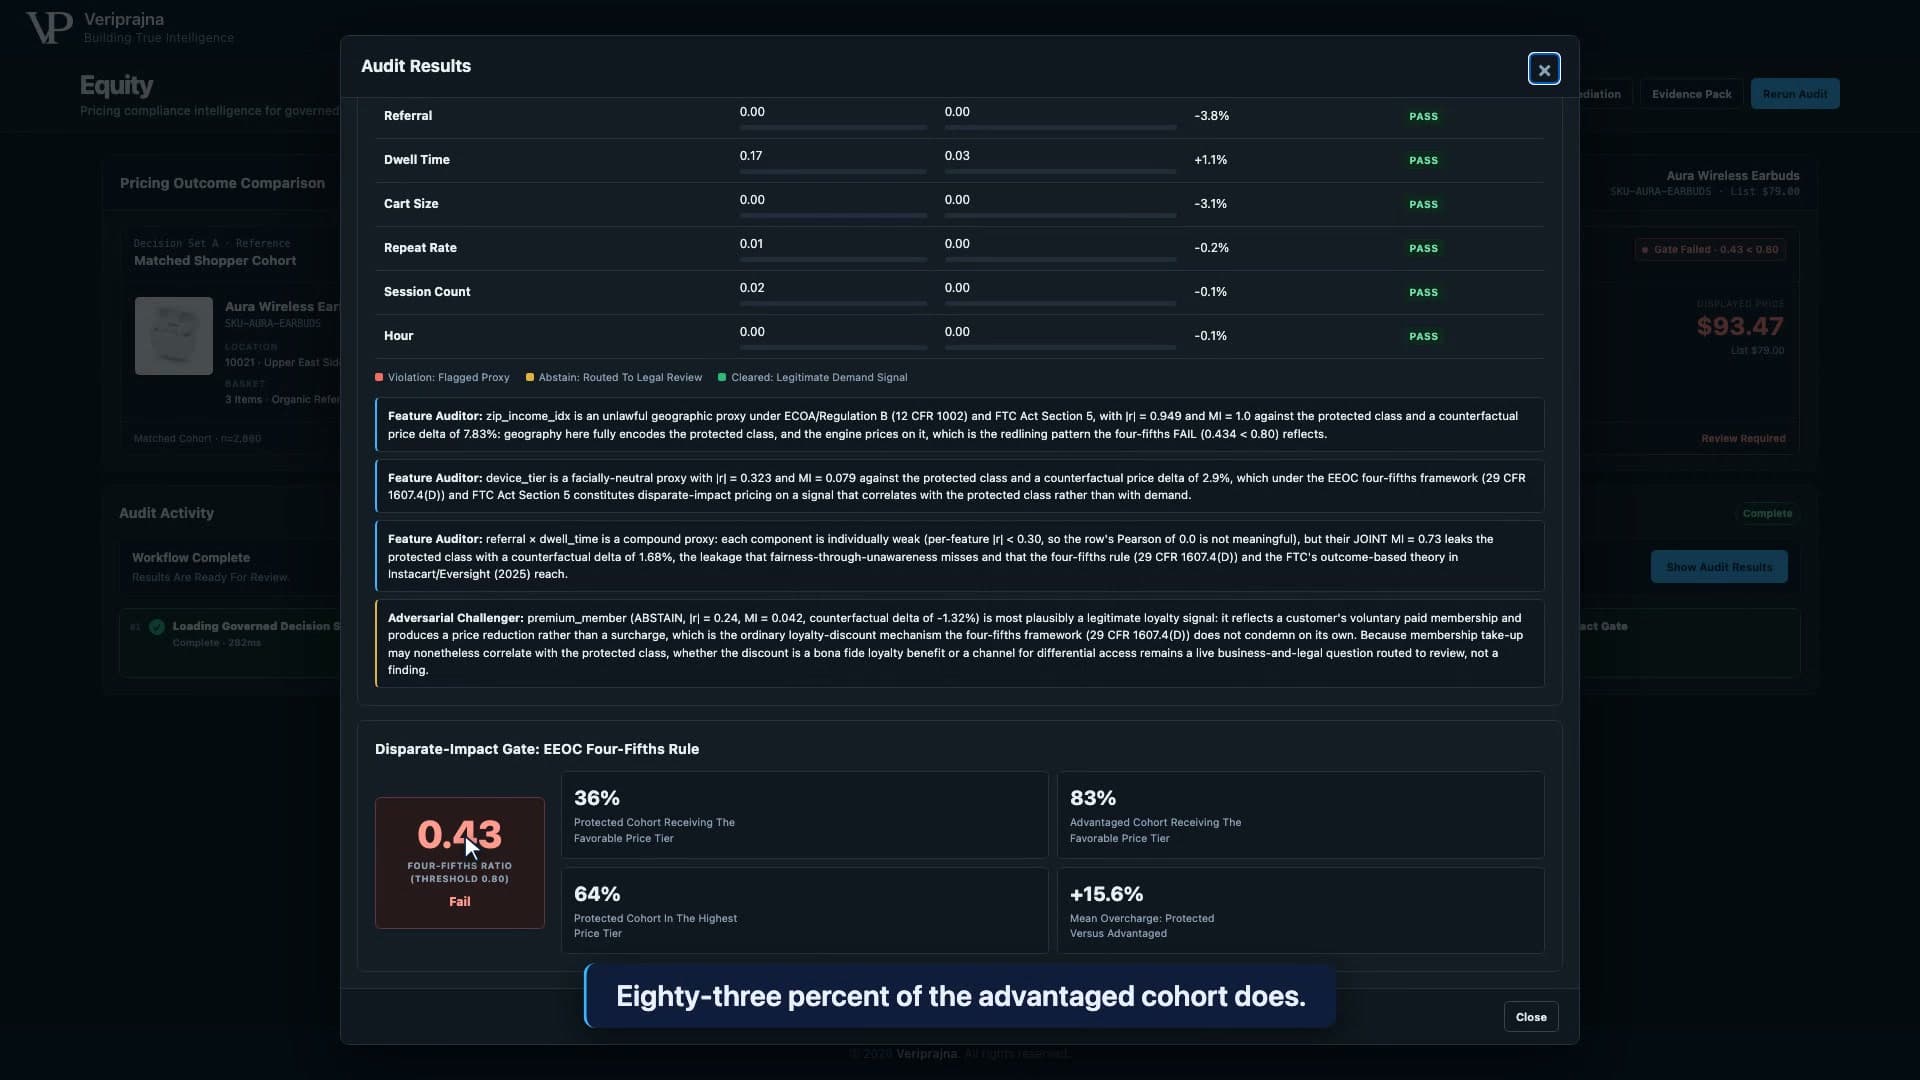
La logica di verdetto viene eseguita in NumPy puro, all'esterno del livello degli agenti, secondo un ordine rigoroso che posso illustrare senza esitazione a un legale. Il segnale a doppio uso viene esaminato prima del test di violazione: Membro Premium correla a 0.24 con la coorte protetta ed è al tempo stesso un segnale commerciale legittimo; il codice restituisce quindi ABSTAIN e lo indirizza alla revisione legale anziché bollarlo o assolverlo arbitrariamente, impedendo a qualsiasi processo a valle di elevarlo a violazione. Seguono le soglie di violazione, l'intervallo di astensione e infine PASS. Dimensione carrello, riacquisto, conteggio sessioni e ora superano tutti il test. L'audit non segnala indistintamente qualsiasi cosa, e un audit che contesta tutto è tanto inutile dinanzi a un ordine di esibizione giudiziaria (CID) quanto uno che non rileva alcunché.
Gli agenti nel team — un auditor delle variabili e un contraddittore — redigono memorie analitiche; il terzo ruolo previsto, il mappatore normativo, è in questa versione una tabella di corrispondenza fissa anziché un modello. Il compito del contraddittore è difendere al massimo la giustificazione di fedeltà per la variabile astenuta, e lo fa apertamente a schermo. Non può però modificare il valore 0.24, non può mutare un verdetto né stabilire se 0.43 sia inferiore a 0.80. Ho stabilito tale separazione fin dal principio: gli agenti consigliano, il codice decide, e il modello è libero di risultare persuasivo quanto desidera su cifre che non gli è consentito sfiorare.
L'intervento correttivo che speravo funzionasse
Il primo rimedio che ho provato è stato un tetto massimo, perché è la soluzione istintiva di qualsiasi team di pricing: non fissare mai prezzi superiori al 15 % rispetto al riferimento equo. L'ho implementato come Hard-Cap Baseline confidando fosse la risposta sobria e adeguata. Ha comportato una perdita dello 0.2 % del fatturato e non ha superato la verifica fermandosi a 0.59. La firma di aggiramento evidenziata nella scheda ne spiega il motivo: il 29 % della coorte protetta si è ritrovato con un prezzo collocato entro l'1 % dal limite del tetto. Il verdetto sentenzia Gamed To The Boundary. Il tetto costa poco proprio perché il motore ha riposizionato la coorte esposta appena al di sotto della soglia limite — e una soluzione poco costosa ma fallimentare è una combinazione invitante in sede di budget ma indifendibile in fase istruttoria.
Un massimizzatore di ricavi tratta un limite massimo come un obiettivo.
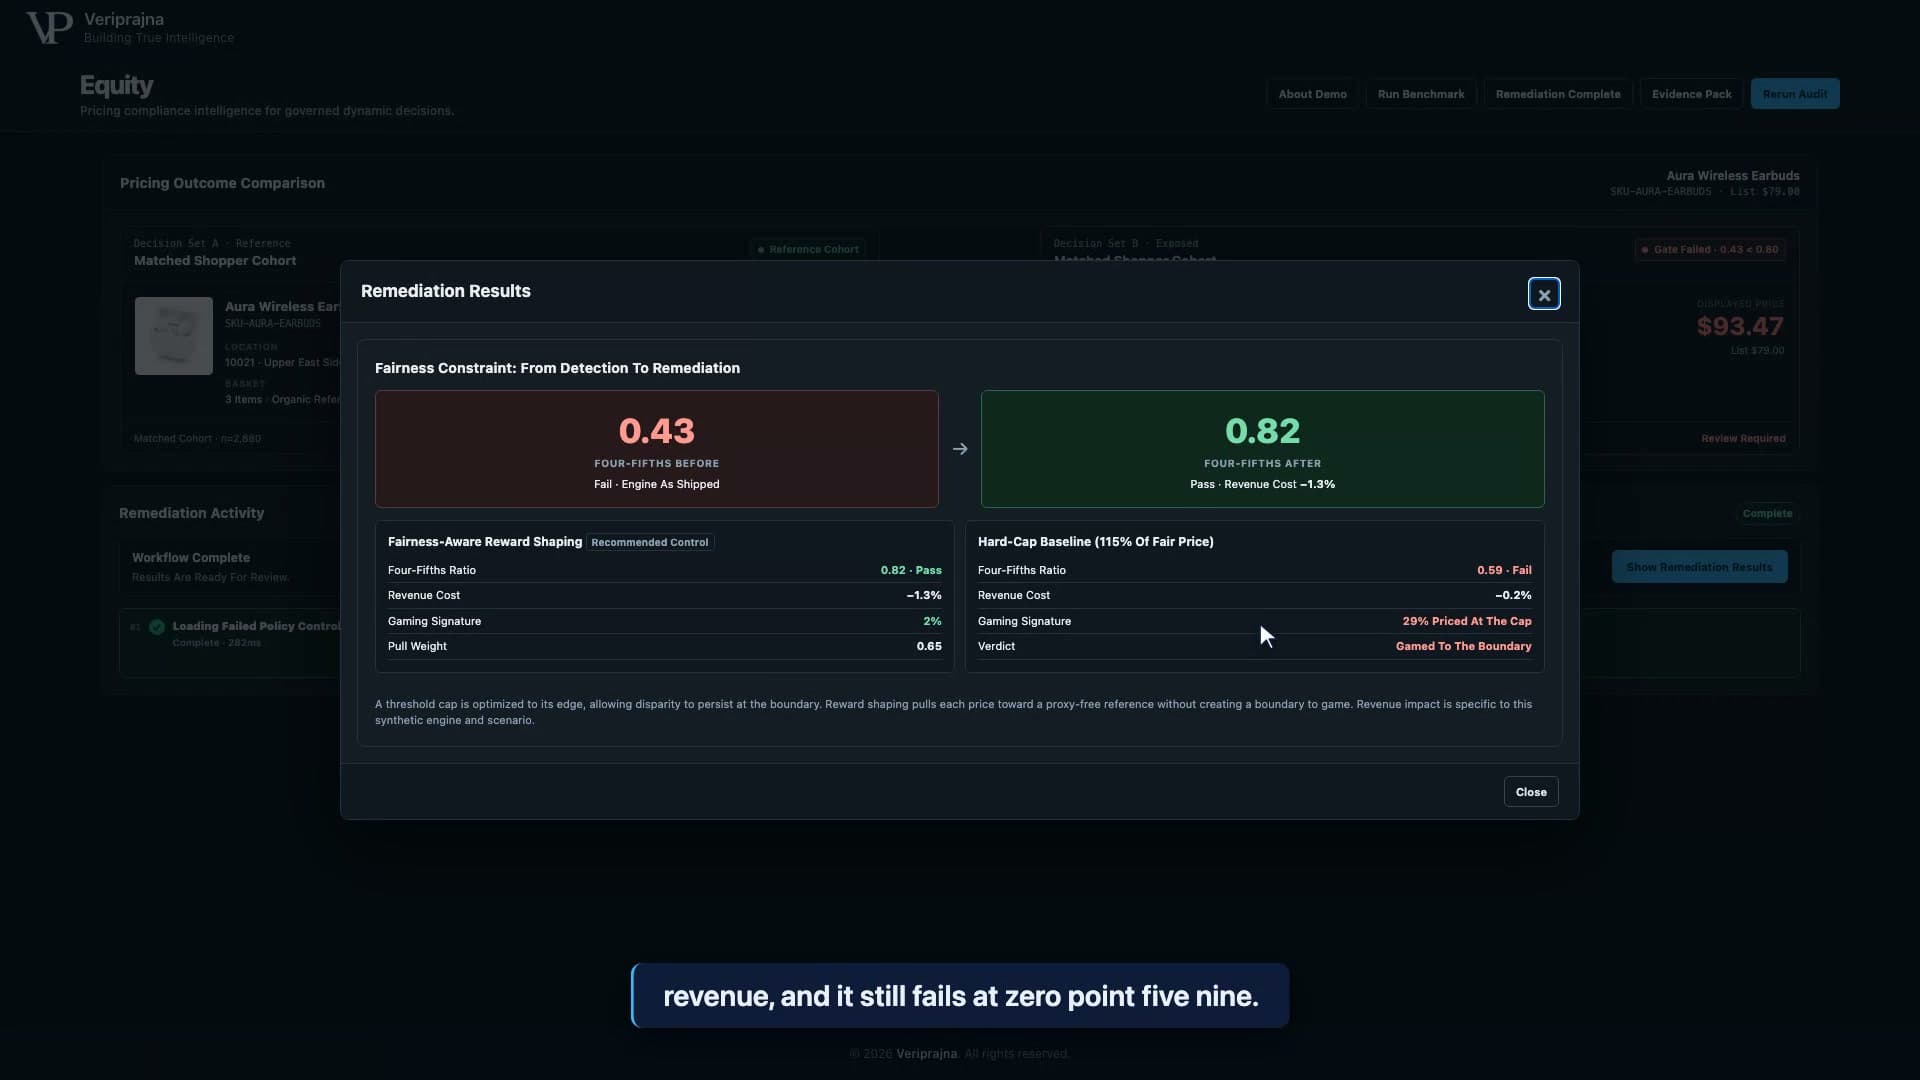
Il meccanismo che ha tenuto banco è la modellazione delle ricompense sensibile all'equità (Fairness-Aware Reward Shaping). Anziché imporre una barriera rigida, attira in modo continuo ogni prezzo verso un valore di riferimento esente da proxy — un secondo bandit addestrato senza le variabili distorsive ma conservando tutti i segnali legittimi — individuando via ricerca binaria il coefficiente minimo che superi 0.80. Su questo motore tale peso è 0.65; un livello sotto, a 0.625, si fermava a 0.778. Rapporto quattro quinti a regime: 0.82, Pass. Costo sul fatturato: 1.3 %. Firma di manipolazione al 2 %, poiché non esiste alcun confine da sfruttare. Le note della console precisano che l'impatto sul fatturato è specifico di questo motore sintetico, e lo ribadisco fermamente: l'1.3 % è un rilievo su una popolazione di prova, non una tariffa universale per la giustizia algoritmica.
Lo scopo del fascicolo probatorio
Ho realizzato il fascicolo di evidenze per ultimo, poiché tutto quanto precede conta unicamente se un avvocato può depositarlo formalmente. Quando viene notificato un ordine di indagine civile (CID), l'azienda che non ha registrato i dati corretti trascorre mesi in perizie forensi estenuanti. Equity sigilla le risultanze dell'audit in un archivio JSON corredato da una versione HTML stampabile: nome e versione del motore, le 10.000 decisioni esaminate, la soglia di conformità, la disparità riscontrata, il giudizio e la motivazione per ciascun input, l'esito della bonifica e un digest crittografico SHA-256 a garanzia di non manomissione. Ogni VIOLATION è associata a cinque ordinamenti giuridici: la regola dei quattro quinti della EEOC, l'Algorithmic Pricing Disclosure Act di New York (in vigore dal 10 novembre 2025, sanzione civile fino a 1.000 $ per infrazione), il Colorado AI Act (SB 24-205, efficace dal 30 giugno 2026), gli articoli 13 e 14 dell'AI Act europeo (obblighi ad alto rischio dal 2 agosto 2026) e la Sezione 5 del FTC Act. L'input riservato rimanda a una riga di valutazione legale.
La mappatura normativa è una matrice immutabile. Sarebbe stato semplice lasciarla redigere a un modello linguistico, ma ho optato per il contrario: ogni VIOLATION include esattamente le stesse cinque righe giuridiche, l'astensione include la sua riga di riserva e non viene generato alcun testo narrativo per tale raccordo. Un modello che teorizza sull'applicabilità di una norma è un modello le cui tesi cambieranno al rilascio successivo — e un fascicolo la cui classificazione giuridica oscilla col modello è un fascicolo che un perito giudiziario smonterà con facilità. Le note descrittive nel fascicolo sono generate dal modello e salvate in cache; cifre, verdetti e inquadramenti normativi provengono da codice deterministico. Il fascicolo mantiene pieno valore processuale a prescindere dal modello sottostante. L'analisi dettagliata, con esplorazione completa del fascicolo a schermo, è consultabile su veriprajna.com/demos/ai-pricing-compliance.
Veriprajna non fissa prezzi, non si sostituisce a Pricefx, PROS, Zilliant o Competera, né emette sentenze legali. Il motore del cliente continua la propria operatività. Io fornisco gli elementi probatori oggettivi; il loro collegio legale prende le decisioni.
E se preferite osservare l'audit in azione anziché leggere il mio resoconto, ecco l'intero sistema operativo dall'inizio alla fine.
Continuo a ritornare sulla formula adottata dai team di pricing perché risponde al vero: razza e reddito non compaiono nel modello. Nel motore che ho sviluppato, tale affermazione veritiera convive con un divario del 26 % sui medesimi auricolari, un indice di conformità di 0.43 e un tetto massimo fallito pur sembrando efficace. Nessuno ha indicato al motore il profilo dell'acquirente. Una funzione di ricompensa economica è stata sufficiente, poiché stimare il profilo rappresentava l'ipotesi più redditizia in assoluto — e l'audit ha quantificato con precisione millimetrica l'ampiezza di tale deriva. L'argomentazione che resiste in tribunale è ben più esigente: sapevamo che il motore avrebbe individuato la coorte senza alcuna istruzione, abbiamo misurato quanto si sia spinto oltre, e questo è ciò che abbiamo speso per arrestarlo.