Simulazione, Digital Twin e Ottimizzazione
Ingegneria di digital twin basati sulla fisica con calibrazione, co-simulazione multifisica e ottimizzazione vincolata per processi decisionali industriali.
Il mercato dei digital twin è stimato a $24–36 billion in 2025 e in crescita di oltre il 35% annuo (Fortune Business Insights, Grand View Research), e Gartner prevede che la tecnologia supererà il divario verso l'adozione aziendale di massa nel 2026. Eppure il 75% dei progetti di digital twin non riesce a generare ROI (Context Clue, 2025). Il software di simulazione non è quasi mai il problema.
Perché la maggior parte dei twin fallisce: l'ingegneria tra simulazione e decisione
Il pattern di fallimento è costante: un'organizzazione acquista una piattaforma, costruisce un modello 3D, connette alcuni sensori e aspetta che il valore si manifesti. Non accade. Il problema non è il software di simulazione. È l'ingegneria tra la simulazione e la decisione:
- Calibrare il twin rispetto ai dati operativi reali.
- Mantenerlo sincronizzato man mano che il sistema fisico subisce derive.
- Comporre modelli multifisici che superano i confini dei singoli vendor.
- Costruire cicli di ottimizzazione che rispettano i vincoli che gli operatori affrontano realmente.
Questa ingegneria è ciò che una collaborazione con noi è strutturata per affrontare.
La confusione sulle piattaforme che costa mesi agli acquirenti
Il panorama dei fornitori nel 2026 è frammentato e davvero dispersivo. I clienti che scelgono una piattaforma IoT graph aspettandosi un'ottimizzazione basata sulla fisica finiscono comunque per dover integrare a posteriori la co-simulazione FMU/FMI, solutori ANSYS o codice PDE personalizzato — dopo aver speso mesi a scoprire questo divario. Ciascuno strumento riportato di seguito svolge bene una parte del compito; nessuno copre l'intero stack.
| Piattaforma | Cos'è in realtà | Il divario |
|---|---|---|
| Azure Digital Twins & AWS IoT TwinMaker | Piattaforme IoT graph e di visualizzazione | Non sono motori di simulazione; l'ottimizzazione basata sulla fisica deve essere integrata a posteriori |
| NVIDIA Omniverse | Rendering 3D in tempo reale impressionante; adottato da Caterpillar, Foxconn, Toyota e TSMC per la visualizzazione di fabbrica | La fedeltà fisica per l'accoppiamento termo-fluidodinamico o strutturale è ancora inferiore rispetto ai solutori dedicati |
| Siemens Digital Twin Composer | Lanciato al CES 2026, sviluppato sulle librerie di Omniverse | Copre una parte, non l'intero stack |
| ANSYS Twin Builder | Crea digital twin ibridi combinando modelli di ordine ridotto basati sulla fisica con analisi ML | Copre una parte, non l'intero stack |
Lo standard di interoperabilità che conta davvero è FMI (Functional Mock-up Interface), ora supportato da 270+ strumenti. FMI 3.0 con il nuovo SSP 2.0 standard per la parametrizzazione della struttura dei sistemi consente la composizione di twin multifisici superando i confini dei singoli vendor, e Bosch considera FMI il formato preferenziale per lo scambio di modelli. Ma la reale integrazione di co-simulazione — far dialogare un modello termico Modelica con un solutore CFD ANSYS e uno strato logico di controllo personalizzato con un'adeguata coordinazione dei passi temporali — richiede un'ingegneria che nessuna piattaforma automatizza. Questa integrazione è il lavoro che le nostre collaborazioni sono strutturate per offrire.
La calibrazione è ciò da cui dipende la vita o la morte dei twin
Un digital twin è valido solo quanto lo è la sua calibrazione rispetto al sistema fisico che rappresenta. La sfida tecnica non risiede nella calibrazione iniziale — consiste nel mantenere la calibrazione man mano che il sistema fisico invecchia, i sensori si degradano, le condizioni operative cambiano e gli interventi di manutenzione modificano il comportamento del sistema. Un sensore di temperatura con una deriva di 0.5 gradi nell'arco di sei mesi corromperà silenziosamente ogni previsione effettuata dal twin, e la maggior parte dei deployment di twin non dispone di alcun meccanismo per rilevarlo.
Il nostro approccio consiste nel realizzare un'infrastruttura di calibrazione utilizzando la stima bayesiana dei parametri rispetto a dati operativi in streaming, con rilevamento automatizzato delle anomalie che identifica quando le previsioni del twin divergono dalla realtà osservata. Il sistema distingue tra tre cause di divergenza:
| Causa di divergenza | Di cosa ha realmente bisogno |
|---|---|
| Degrado dei sensori | Manutenzione dei sensori, non aggiornamenti del modello |
| Cambiamento fisico effettivo | Ricalibrazione del modello |
| Condizioni operative al di fuori dell'envelope di validità | Un chiaro avviso che il modello non deve essere ritenuto affidabile |
Quest'ultima distinzione è la più importante. Ogni twin possiede un envelope di validità — le condizioni operative in cui le sue previsioni sono affidabili. Il nostro approccio caratterizza esplicitamente tale envelope e predispone avvisi automatici per quando le condizioni reali si avvicinano al confine. Le decisioni basate sull'estrapolazione oltre il comportamento validato sono peggiori delle decisioni prese senza alcun twin, perché trasmettono una falsa sicurezza.
Composizione multifisica, non semplificazione a singolo solutore
I sistemi industriali reali coinvolgono fisiche accoppiate: termica, fluidodinamica, strutturale, elettrica, chimica. Un singolo strumento di simulazione raramente gestisce tutti i domini alla fedeltà necessaria. Consideriamo due esempi:
- Un digital twin di una rete energetica potrebbe richiedere la simulazione del flusso di potenza (PSS/E o PowerWorld), la modellazione termica per il degrado dei trasformatori, la previsione della generazione da fonti rinnovabili guidata dal meteo e l'ottimizzazione del mercato sotto vincoli normativi (si veda la nostra ricerca sull'intelligence vincolata dalla fisica per i disturbi di rete).
- Un digital twin per processi farmaceutici potrebbe accoppiare la fluidodinamica computazionale per la miscelazione con la cinetica di reazione e il trasferimento termico.
Forzare tutti questi aspetti nel solutore di un unico vendor significa compromettere la fedeltà in almeno un dominio. Il nostro approccio compone i twin a partire dal solutore più adatto per ciascun dominio fisico, collegati tramite co-simulazione FMI con adeguata sincronizzazione dei passi temporali e protocolli di scambio dati. L'ecosistema Modelica (Dymola, OpenModelica, Modelon Impact) fornisce la dorsale per la modellazione a livello di sistema, con solutori specializzati integrati laddove la fedeltà del dominio lo richieda. Il risultato è un twin che rispetta la fisica di ciascun dominio anziché mediarla in una singola rappresentazione semplificata.
Ottimizzazione che rispetta i vincoli reali
Il livello di ottimizzazione è il punto in cui il twin genera valore. Il nostro approccio applica il metodo più appropriato per la struttura del problema, rispettando i vincoli stringenti che gli operatori affrontano realmente anziché ottimizzare rispetto a scenari irrealistici (dettagliato nel nostro whitepaper sul generative design basato su vincoli):
- Ottimizzazione bayesiana — per obiettivi costosi da valutare con spazi parametrici ridotti.
- Algoritmi evolutivi (NSGA-III, MOEA/D) — per problemi multi-obiettivo in cui i decisori necessitano di superfici di trade-off Pareto-ottimali anziché di risposte a punto singolo.
- Reinforcement learning — per problemi decisionali sequenziali in cui il twin funge da ambiente di addestramento.
- Controllo predittivo del modello (MPC) — per il controllo di processo, guidato dalla fisica del twin anziché dal RL, che spesso costituisce la risposta corretta.
La sfida ingegneristica critica è il trasferimento sim-to-real. Le policy di RL addestrate in simulazione falliscono quando trasferite ai sistemi fisici a causa di tre fattori concomitanti: discrepanze fisiche e dinamiche tra simulatore e realtà; incertezza percettiva (gli agenti in simulazione dispongono di informazioni perfette mentre i sistemi reali utilizzano sensori rumorosi); e stati fuori distribuzione che la policy non ha mai incontrato durante l'addestramento.
La domain randomization è utile ma non risolve l'errata specificazione strutturale del modello. Se il modello fisico del twin presenta una PDE errata o un termine di accoppiamento mancante, nessuna quantità di randomizzazione produrrà una policy funzionante sul sistema reale. Il nostro approccio valida il trasferimento sim-to-real attraverso il deployment progressivo: prima in modalità shadow accanto ai controlli esistenti, poi con autorità delimitata, quindi in piena autonomia, con monitoraggio continuo delle divergenze tra risultati attesi ed effettivi.
La frontiera della simulazione AI-native
La convergenza tra IA e simulazione sta ridefinendo ciò che è possibile. NVIDIA Modulus addestra surrogati di reti neurali physics-informed che operano ordini di grandezza più velocemente rispetto ai solutori tradizionali; Ansys ha integrato Modulus nei suoi prodotti di simulazione per semiconduttori (Ansys Seascape), dimostrando un incremento di velocità di 100x per le simulazioni termiche. I foundation model per la fisica (Compositional Neural Operators, Physix) promettono basi di surrogati riutilizzabili che riducono l'overhead solutore-per-PDE, e lo stesso approccio a ciclo chiuso guida la nostra ricerca sulla scoperta di materiali con IA a ciclo chiuso.
I digital twin agentici, in cui agenti di IA operano autonomamente all'interno dell'ambiente di simulazione del twin, sono ora formalizzati nella letteratura accademica (AAAI 2025/2026) e implementati su larga scala: Gli agenti AI di PepsiCo identificano fino al 90% dei potenziali problemi nei digital twin di produzione prima delle modifiche fisiche, garantendo un miglioramento del 20% nel throughput e una riduzione dei costi di investimento del 10–15%. Abbiamo realizzato una demo funzionante di un laboratorio IA autonomo in cui gli agenti gestiscono un ciclo sperimentale simulato end-to-end.
Tuttavia l'hype supera la realtà ingegneristica. Un paper del 2025 individua difetti fondamentali nelle reti neurali physics-informed per i sistemi ingegneristici: envelope di validità ristretti, scarsa caratterizzazione dei confini di rottura e assenza di interpretabilità fisica. Il nostro approccio impiega surrogati di IA laddove appropriato (valutazioni rapide nel ciclo interno durante l'ottimizzazione, esplorazione what-if in tempo reale per gli stakeholder) e si affida a solutori ad alta fedeltà dove l'accuratezza è portante. La scelta tra surrogato e solutore è una decisione ingegneristica presa componente per componente, non un vincolo di piattaforma.
Cosa dicono i numeri
- I digital twin per turbine a gas di GE fanno risparmiare $64 million annually, con una riduzione del 75% degli scarti di prodotto e il 38% in meno di reclami sulla qualità (Skan.ai).
- Il calcolo tra manutenzione d'emergenza e manutenzione pianificata è lampante: un caso documentato ha evidenziato una singola riparazione d'emergenza costata $1.4 million rispetto a $95,000 per la stessa riparazione durante un fermo impianto pianificato (AIDAR Solutions).
- McKinsey riporta che i digital twin riducono i tempi di sviluppo del prodotto fino al 50% e migliorano la qualità fino al 25%.
- Le implementazioni enterprise costano tipicamente $500,000 to $4 million a seconda dell'ambito, con riduzioni dei costi operativi del 20–30% nel primo anno e tempi di recupero dell'investimento di 12–36 mesi.
- Deloitte ha rilevato che il 42% delle aziende ha abbandonato la maggior parte delle iniziative di IA nel 2025, con un costo irrecuperabile medio di $7.2 million per ciascuna iniziativa abbandonata.
Il pattern ricorrente dietro gli abbandoni: iniziare con l'acquisto di una piattaforma anziché con la definizione del problema ingegneristico.
Quando un digital twin è la scelta sbagliata
Non tutti i sistemi necessitano di un twin. Definiamo l'ambito dei nostri progetti partendo innanzitutto dal problema decisionale, e se un twin non è la risposta corretta, lo diciamo apertamente. Un twin è lo strumento sbagliato quando:
- Il sistema fisico è sufficientemente semplice da consentire a calcoli da principi primi o al controllo statistico di processo di gestire il problema decisionale — un twin aggiungerebbe costi senza apportare alcuna comprensione aggiuntiva.
- L'organizzazione è priva dell'infrastruttura di sensori necessaria ad alimentare il twin con dati in tempo reale — il twin diventa una simulazione una tantum, non un modello dinamico.
- Il ciclo decisionale è mensile o trimestrale e il sistema evolve lentamente — le simulazioni in batch risultano più economiche rispetto al mantenimento di un twin sincronizzato.
- L'obiettivo primario è la visualizzazione 3D per presentazioni agli stakeholder anziché l'ottimizzazione operativa — una piattaforma di visualizzazione è lo strumento idoneo, non un twin basato sulla fisica.
Punti chiave
- Il 75% dei progetti di digital twin non riesce a generare ROI — la causa risiede nell'ingegneria tra simulazione e decisione, non nel software di simulazione.
- Le piattaforme IoT cloud (Azure Digital Twins, AWS IoT TwinMaker) non sono motori fisici; la composizione indipendente dai vendor su FMI 3.0 / SSP 2.0 (270+ strumenti) preserva la fedeltà tra i diversi domini.
- La calibrazione deve essere mantenuta nel tempo, non eseguita una sola volta — la stima bayesiana dei parametri unita a un esplicito envelope di validità previene fallimenti silenziosi dovuti a una falsa sicurezza.
- Il metodo di ottimizzazione segue la struttura del problema (bayesiano, NSGA-III/MOEA/D, RL, MPC), con passaggio sim-to-real validato tramite deployment progressivo.
- I riscontri economici sono provati — GE risparmia $64M all'anno, McKinsey cita uno sviluppo fino al 50% più rapido — ma il successo inizia da un problema decisionale, mai dall'acquisto di una piattaforma.
Simulazione, Digital Twin e Ottimizzazione
 Guarda
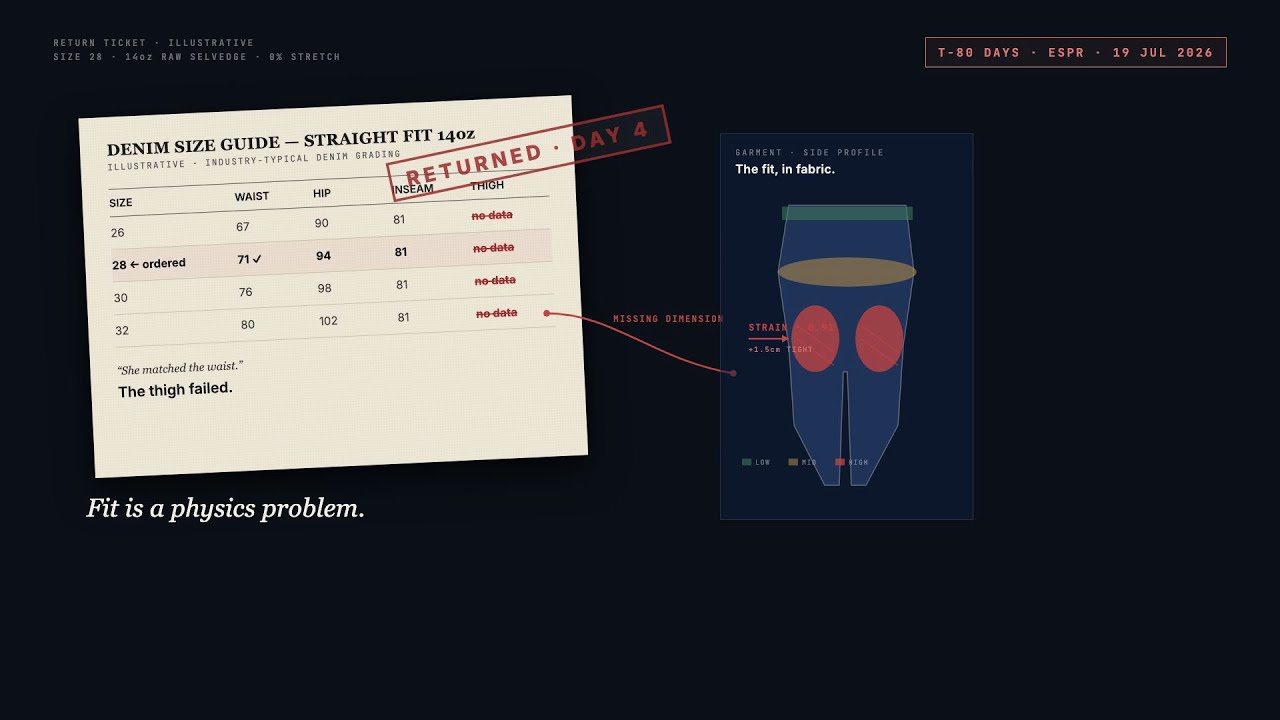
Previsione AI della vestibilità per l'e-commerce della moda | Veriprajna
L'e-commerce della moda perde più denaro a causa dei resi che per marketing, logistica o frodi messi insieme. La causa principale nel 53-70% dei resi di abbigliamento è la stessa: il capo non calzava bene. Le tabelle taglie riducono tutto a un gioco di ipotesi.
 Guarda
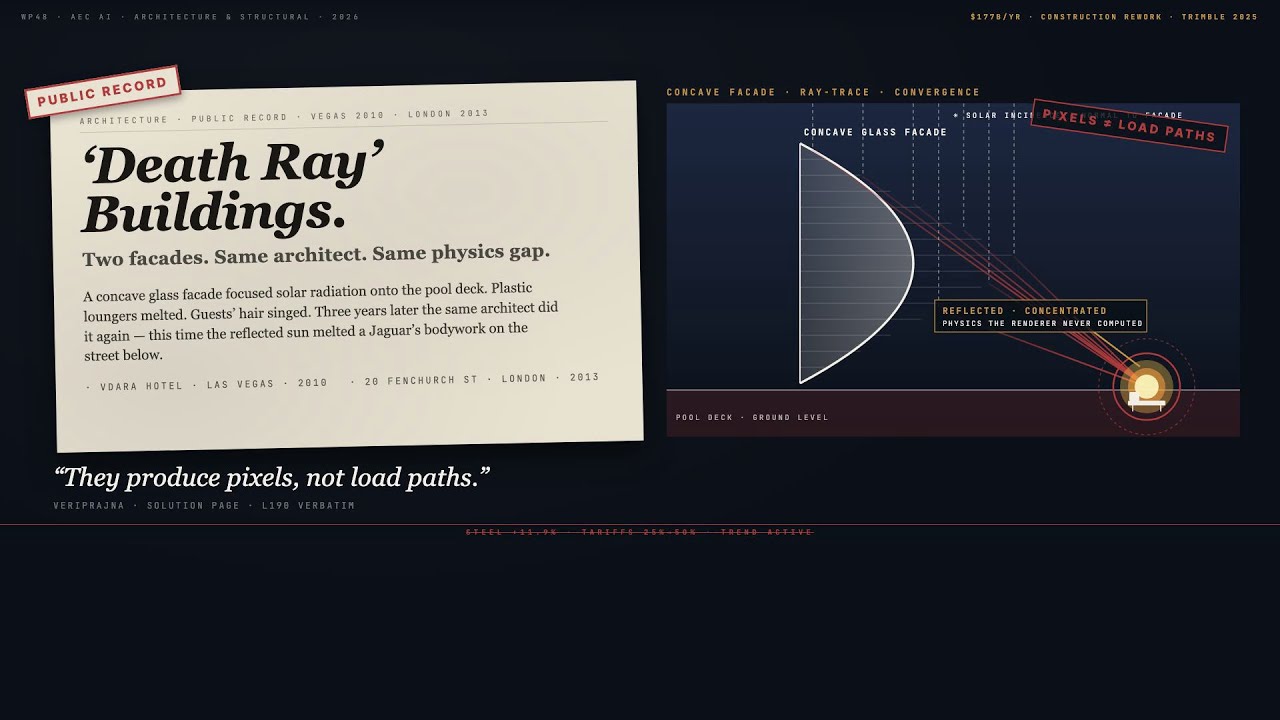
IA per l'architettura e l'ingegneria strutturale | Veriprajna
L'IA generativa crea straordinari concept architettonici in pochi secondi. Poi il tuo team strutturale impiega settimane per dimostrare che non possono essere costruiti. L'ottanta per cento della deviazione dei costi di costruzione deriva da modifiche progettuali, non da errori di costruzione.
 Guarda
Sottoscrizione del rischio alluvionale basata sull'IA | Veriprajna
Oltre due terzi dei danni da alluvione negli Stati Uniti si verificano al di fuori delle zone ad alto rischio della FEMA. Se il tuo motore di tariffazione si ancora ancora alla distinzione tra Zona AE e Zona X, stai prezzando il rischio in modo errato su entrambi i fronti: sovraccaricando la casa rialzata all'interno della zona e sottostimando la casa con fondazione a platea al di fuori di essa.
 Guarda
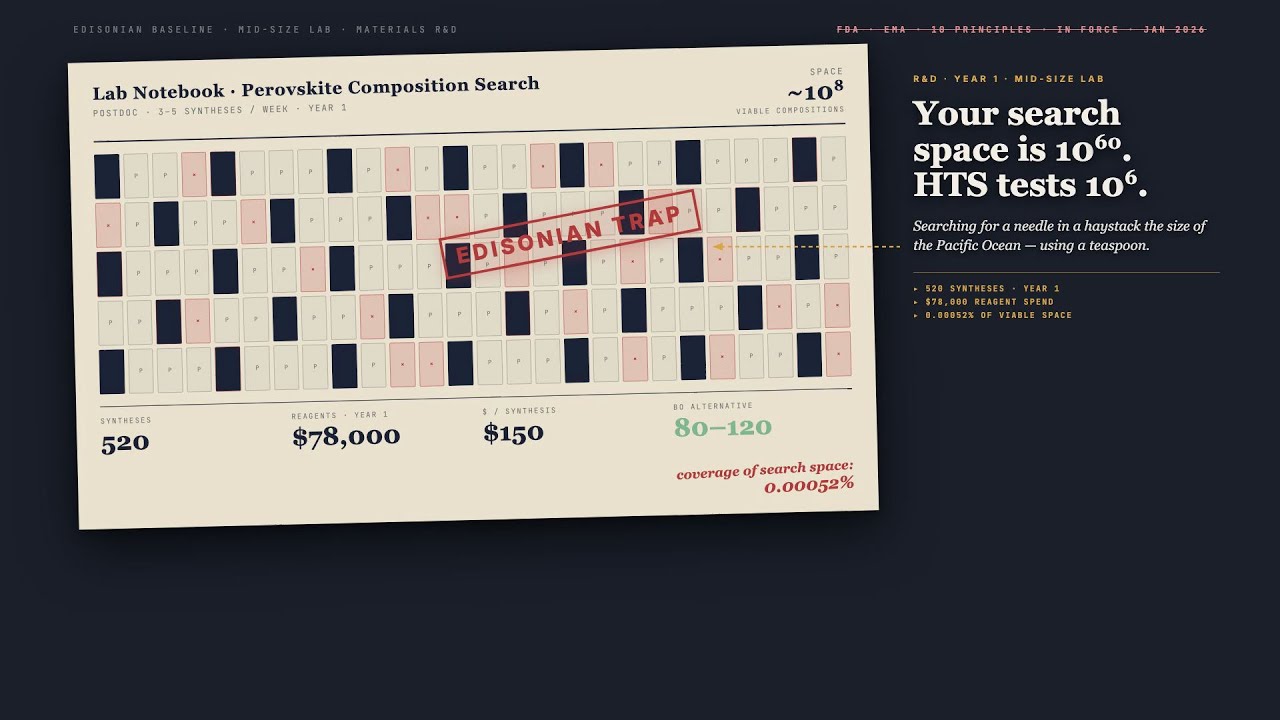
Autonomous Lab AI: progettazione di laboratori autonomi per la scoperta di materiali | Veriprajna
Il divario tra ciò che lo screening ad alta produttività copre e ciò che lo spazio chimico contiene non è incrementale. È astronomico. I laboratori autonomi colmano quel divario sostituendo la ricerca casuale con una sperimentazione strategica, guidata dall'AI.
 Guarda
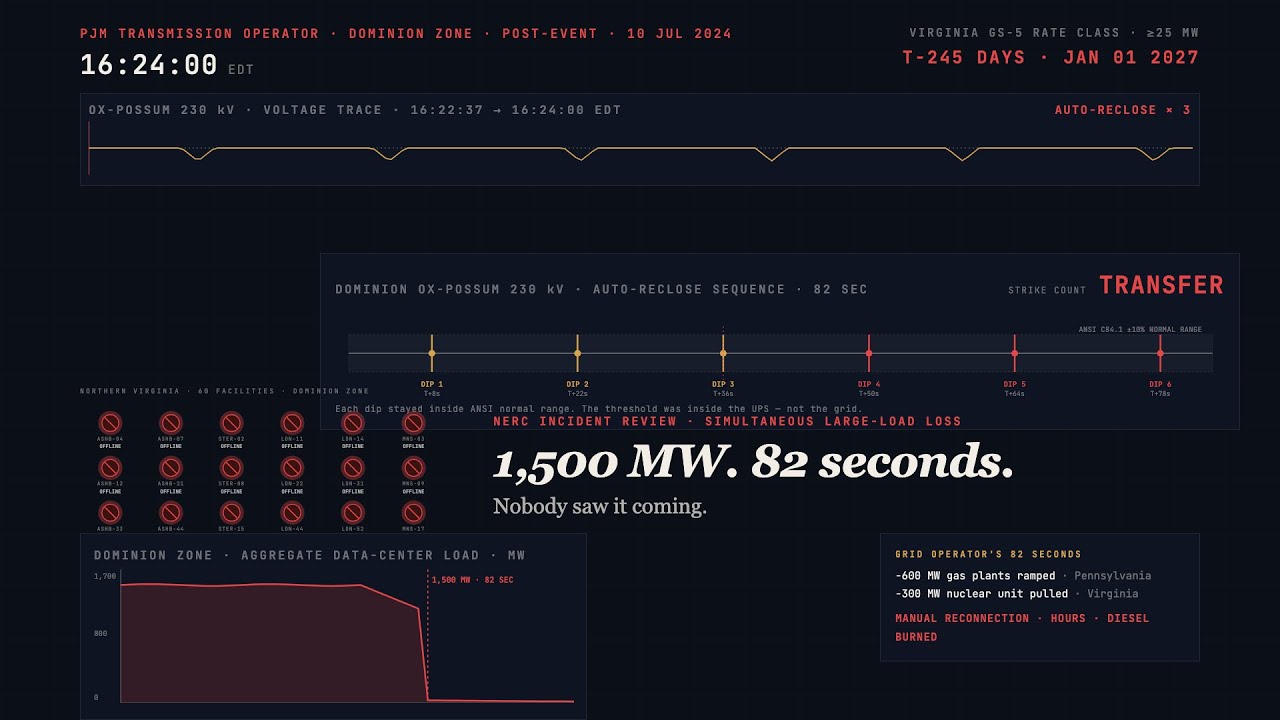
AI per l'Interazione tra Data Center e Rete Elettrica | Veriprajna
Orchestrazione della flessibilità di rete basata sull'AI per data center. Previeni i byte blackout, ottimizza i costi del mercato della capacità PJM e rispetta i requisiti di conformità NERC per i grandi carichi.
 Guarda
IA per la rete elettrica e ingegneria della resilienza | Veriprajna
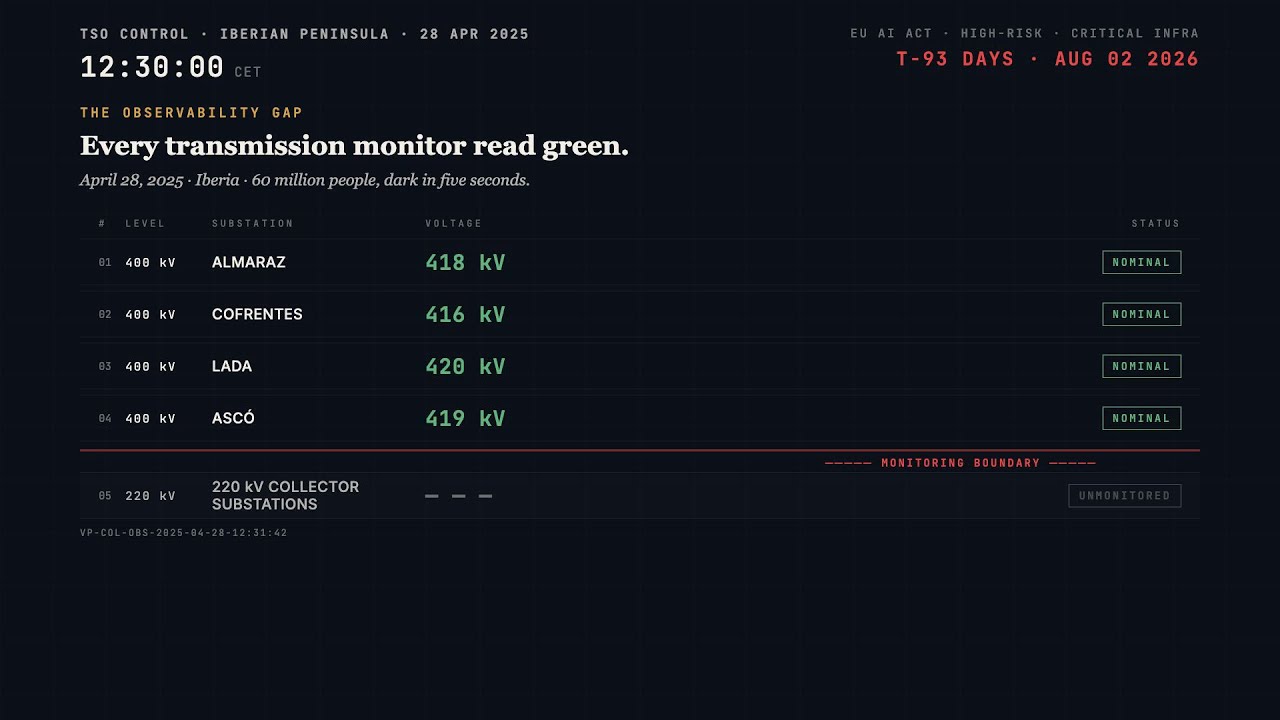
PJM è rimasta indietro di 6.625 MW rispetto al suo obiettivo di affidabilità per la prima volta nella storia. La coda di interconnessione di ERCOT ha raggiunto i 233 GW con solo 23 GW di nuova generazione in linea. Il blackout iberico ha cancellato 15 GW in 5 secondi perché nessuno teneva sotto controllo il livello di tensione corretto.
 Guarda
Verifica AI dei Semiconduttori e Correttezza del Silicio | Veriprajna
Costruiamo pipeline di verifica su misura che avvolgono LLM open-weight messi a punto attorno al tuo motore formale esistente (JasperGold, VC Formal, Questa Formal o SymbiYosys) e funzionano interamente sul tuo hardware. Nessun RTL lascia la tua rete. Nessun vendor lock-in.
Domande Frequenti
Quanto costa l'implementazione di un digital twin aziendale?
Le implementazioni aziendali di digital twin variano in genere da $500,000 a oltre $4 million a seconda del numero di domini fisici, della complessità di integrazione dei sensori e dei requisiti di ottimizzazione. Un twin su un singolo asset con un solo dominio fisico e infrastruttura di sensori preesistente si colloca nella fascia inferiore. Twin multifisici per l'intero stabilimento con ottimizzazione in tempo reale e integrazione di solutori personalizzati si collocano nella fascia superiore. L'analisi del rientro dell'investimento si traduce solitamente in riduzioni dei costi operativi del 20-30% entro il primo anno, con ROI completo in 12-36 mesi. Per fare un confronto, una riparazione d'emergenza documentata è costata $1.4 million a fronte di $95,000 per la medesima riparazione durante la manutenzione programmata. Un singolo guasto evitato può superare i costi di deployment del twin di svariati anni.
Perché la maggior parte dei progetti di digital twin non riesce a generare ROI?
Il 75% dei progetti di digital twin non genera ROI, e il software di simulazione non ne è quasi mai la causa. Il principale schema di fallimento è l'approccio orientato alla sola tecnologia: acquistare una piattaforma, costruire un modello 3D, collegare i sensori e attendere il valore. Le cause reali sono la scarsa qualità dei dati e le fonti dati frammentate (la prima causa di fallimento), l'assenza di una chiara definizione del problema di business alla base della progettazione del twin, la confusione tra visualizzazione e simulazione basata sulla fisica e l'incapacità di mantenere la calibrazione man mano che il sistema fisico subisce derive nel tempo. I progetti che partono da uno specifico problema decisionale e procedono a ritroso verso la complessità minima del twin superano costantemente quelli che iniziano con l'acquisto di una piattaforma.
Dovrei utilizzare Azure Digital Twins, AWS IoT TwinMaker o una piattaforma di simulazione dedicata?
Azure Digital Twins e AWS IoT TwinMaker sono piattaforme IoT graph e di visualizzazione, non motori di simulazione fisica. Eccellono nella gestione dei dispositivi, nell'instradamento dei dati e nella visualizzazione 3D. Tuttavia, se necessitate di ottimizzazione basata sulla fisica (termica, fluidodinamica, strutturale, chimica), avrete comunque bisogno di solutori dedicati come ANSYS, strumenti basati su Modelica o codice PDE personalizzato, connessi tramite co-simulazione FMI. Molte organizzazioni impiegano mesi per scoprire questo divario dopo aver iniziato con una piattaforma cloud. Le piattaforme industriali dedicate come Siemens Xcelerator e ANSYS Twin Builder offrono capacità di simulazione più approfondite ma vincolano all'ecosistema di un unico fornitore. L'architettura corretta spesso integra l'infrastruttura IoT cloud per l'ingestione dei dati con motori di simulazione indipendenti dai vendor per garantire la fedeltà fisica.
Cos'è FMI e perché è fondamentale per l'interoperabilità dei digital twin?
FMI (Functional Mock-up Interface) è lo standard di interoperabilità dominante per lo scambio di modelli e la co-simulazione, attualmente supportato da 270+ tools. FMI 3.0 con il nuovo standard SSP 2.0 consente la composizione di digital twin multifisici superando i confini dei singoli fornitori: un modello termico Modelica può comunicare con un solutore CFD ANSYS e un livello logico di controllo personalizzato con scambio di dati standardizzato. Bosch considera ufficialmente FMI il formato preferenziale per lo scambio di modelli. Senza FMI, si rimane vincolati all'ecosistema di solutori del vendor iniziale, con costi di migrazione misurabili in mesi di re-implementazione. Costruiamo architetture di twin su FMI proprio perché garantiscono la possibilità di sostituire i componenti man mano che emergono strumenti migliori.
Come gestite il divario di trasferimento sim-to-real per le policy di RL addestrate su digital twin?
Il divario sim-to-real è la principale modalità di fallimento per le policy di reinforcement learning addestrate in simulazione. Tre fattori concomitanti si aggravano a vicenda: discrepanze fisiche tra il simulatore e la realtà, incertezza percettiva (la simulazione fornisce informazioni di stato perfette mentre i sistemi reali impiegano sensori rumorosi) e stati fuori distribuzione che la policy non ha mai rilevato durante l'addestramento. La domain randomization aiuta con l'incertezza parametrica ma non può sanare un'errata specificazione strutturale del modello. Se la fisica del twin presenta PDE errate o termini di accoppiamento mancanti, nessuna tecnica di addestramento salverà la policy. Affrontiamo questo problema attraverso il deployment progressivo: prima la modalità shadow accanto ai controlli esistenti, poi un'autorità delimitata con possibilità di override umano, infine la piena autonomia con monitoraggio continuo delle divergenze. Ciascuna fase convalida che la policy operi entro limiti accettabili sul sistema reale prima di estenderne l'autorità.
Qual è la differenza tra modelli surrogati di IA e simulazione tradizionale per i digital twin?
La simulazione tradizionale (FEA, CFD, eventi discreti) risolve direttamente le equazioni fisiche e produce risultati ad alta fedeltà, ma può richiedere ore per ogni singola valutazione. I surrogati di IA (reti neurali physics-informed, modelli di ordine ridotto tramite NVIDIA Modulus o ANSYS) apprendono approssimazioni che operano ordini di grandezza più rapidamente. Ansys ha dimostrato un'accelerazione di 100x per le simulazioni termiche grazie all'integrazione di NVIDIA Modulus. Il compromesso riguarda la validità: i surrogati sono accurati all'interno della distribuzione di addestramento, ma presentano envelope di validità ristretti e scarsamente caratterizzati. Un articolo di ricerca del 2025 evidenzia difetti fondamentali nelle PINN per i sistemi ingegneristici, in particolare nella caratterizzazione dei confini di rottura. Utilizziamo i surrogati per valutazioni rapide nel ciclo interno durante l'ottimizzazione e per l'esplorazione what-if in tempo reale, riservando i solutori ad alta fedeltà dove l'accuratezza è fondamentale. Questa è una decisione per singolo componente, non un impegno a livello di piattaforma.
Quanto tempo richiede l'implementazione di un digital twin dal kickoff alla produzione?
I tempi dipendono dall'ambito. Un twin su un singolo asset con un solo dominio fisico e dati da sensori preesistenti richiede solitamente da 8 a 16 settimane dal kickoff al rilascio validato in produzione. I twin multifisici che accoppiano tre o più domini con integrazione di solutori personalizzati e cicli di ottimizzazione richiedono da 4 a 8 mesi. I deployment a livello di intero stabilimento o flotta, in cui si compongono molteplici twin con infrastruttura dati condivisa, richiedono più tempo. Il percorso più rapido consiste nell'iniziare con un singolo asset ad alto valore per il quale i dati dei sensori sono già disponibili, dimostrare il valore della calibrazione e dell'ottimizzazione, e poi scalare. Tentare di costruire un twin per l'intero stabilimento fin dal primo giorno è l'approccio con la maggiore probabilità di entrare a far parte di quel 75% che non riesce a produrre ROI.
Perché affidarsi a una consulenza per i digital twin invece di rivolgersi direttamente a Siemens o ANSYS?
Siemens e ANSYS vendono i propri ecosistemi di solutori. I loro team di servizi professionali sono eccellenti nell'implementazione all'interno delle loro specifiche toolchain. Il divario si manifesta quando il vostro twin deve superare i confini tra fornitori diversi: CFD ANSYS accoppiata con modelli elettrici Modelica, combinata con un surrogato ML personalizzato e uno strato di ottimizzazione che nessuno di questi vendor offre. I fornitori di piattaforme ottimizzano per l'adozione della propria piattaforma. Noi ottimizziamo per il risultato ingegneristico. Se Siemens Xcelerator o ANSYS Twin Builder coprono l'intero problema, è consigliabile usarli direttamente. Se invece il vostro twin copre molteplici domini fisici, necessita di un'interoperabilità indipendente tramite FMI o richiede un'infrastruttura personalizzata di calibrazione e ottimizzazione, è lì che l'ingegneria indipendente offre un valore che i vendor di piattaforme strutturalmente non possono fornire.
Costruisci la tua IA con fiducia.
Collabora con un team che vanta una profonda esperienza nella creazione della prossima generazione di IA aziendale. Lascia che ti aiutiamo a progettare, sviluppare e implementare una strategia di IA di cui ti puoi fidare.
Veriprajna società di consulenza Deep Tech è specializzata nella creazione di sistemi di IA safety-critical per i settori sanitario, finanziario e regolamentato. Le nostre architetture sono validate rispetto a protocolli consolidati con una documentazione di conformità completa.