Indagare sulle recensioni coordinate senza trasformare il sospetto in colpa

Una recensione può sembrare del tutto ordinaria mentre l'account che la pubblica partecipa a una campagna coordinata. Per un team incaricato di proteggere un marchio, questo determina due decisioni: quale attività merita un'indagine e quali prove giustificherebbero un provvedimento. Voglio che un sistema di revisione renda utile la prima decisione senza fingere di aver già risposto alla seconda.
La distinzione è cruciale poiché la qualità della scrittura costituisce un indicatore incerto di indipendenza. Una prosa curata non ci dice se più account stiano agendo di concerto. Una relazione tra account, a sua volta, non rivela se i recensori siano stati pagati o se le loro critiche siano false. Un sistema che comprime questi interrogativi in un unico verdetto fa sì che il suo segnale più forte risponda a domande che non è in grado di risolvere.
Ciò che la formulazione tralascia
Campaign Firewall, la nostra dimostrazione di frode da recensioni sintetiche, contiene una campagna modellata di 15 recensioni sulla scheda di un concorrente. Tutti i record e le cronologie degli account sono sintetici. Il set di test classifica questa come una campagna a pagamento interamente umana, ma tale etichetta descrive lo scenario costruito; non costituisce né la prova di una reale paternità umana né la dimostrazione che qualcuno abbia percepito un compenso.
Undici di quei 15 record presentano minime anomalie di scrittura secondo la metrica stilometrica della demo, che esamina i pattern nel testo. Quattro mostrano un'anomalia rilevabile. La baseline locale basata solo sul testo segnala quattro dei 15. Interpretare tale esito come un giudizio sull'intera campagna significherebbe scartare le evidenze sugli account associate agli altri undici.
La relazione rilevante risiede nella cronologia condivisa dei prodotti. La demo collega le recensioni quando le cronologie modellate dei loro account si sovrappongono a sufficienza, le recensioni riguardano la stessa scheda e compaiono a non più di 72 ore di distanza. La sola scansione temporale non crea alcun collegamento. In questo esempio, le cronologie sovrapposte uniscono i 15 record in un cluster. La combinazione dei segnali instrada tutti i 15 verso REVIEW, un percorso di revisione umana. Nessuna recensione viene rimossa e non viene aperta alcuna controversia.
Il vantaggio pratico consiste in un diverso oggetto di indagine. Invece di chiedere a un analista di decidere se ciascuna frase sembri scritta da una macchina, il record chiede perché questi account abbiano cronologie sovrapposte e concentrino la loro attività sulla stessa scheda all'interno di quella finestra. Una frase plausibile è compatibile con una coordinazione. Non può cancellare le prove relazionali.
Il confronto che segue mostra otto record illustrativi, anziché l'intera campagna da 15 record. Le sue righe superiori mostrano relazioni che contribuiscono ai percorsi di revisione anche dove la baseline locale non rileva alcun segnale testuale. Le righe inferiori mostrano l'errore opposto: record sintetici etichettati come autentici che la baseline contrassegna e che il sistema combinato dichiara idonei. Entrambe le direzioni contano nel decidere cosa un rilevatore debba inviare a un analista.
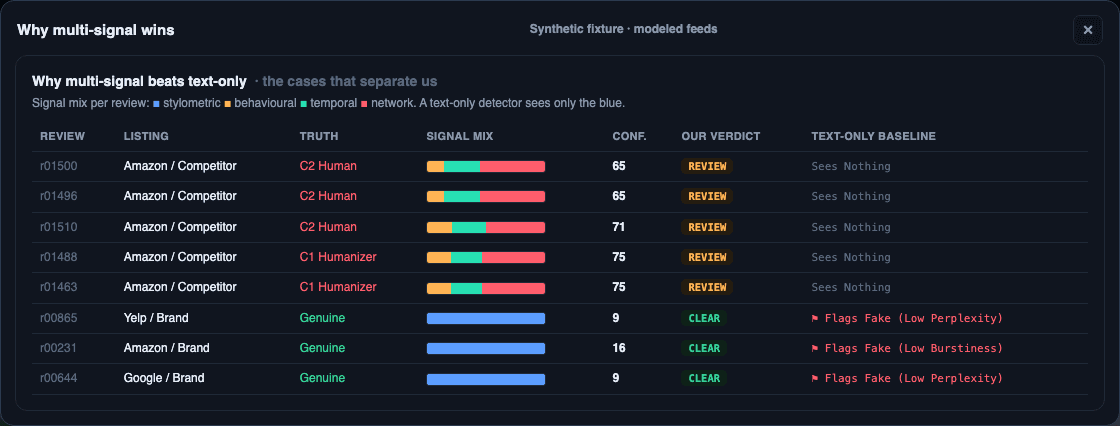
Questi risultati provengono dallo stesso corpus sintetico utilizzato per calcolare i percentili del testo e calibrare la soglia di revisione. Dimostrano il percorso decisionale configurato, non le prestazioni su recensioni inedite. L'esempio mette in luce una distinzione progettuale: una decisione basata solo sul testo può ignorare relazioni rilevanti. Non dimostra che questa particolare combinazione possa generalizzarsi in modo affidabile.
Un cluster connesso necessita comunque di una spiegazione
Le evidenze relazionali meritano un esame rigoroso, ma il motivo di una connessione rimane una questione separata. Si consideri un lancio ipotetico in cui acquirenti autentici provengano dalla medesima community di appassionati. Potrebbero acquistare molti degli stessi prodotti e recensire una nuova scheda in un breve intervallo di tempo. Cronologie sovrapposte e tempistiche concentrate potrebbero riflettere un interesse comune piuttosto che un'operazione retribuita.
Dichiarare idoneo in automatico ogni cluster di questo tipo significherebbe abbandonare un indizio utile. Sopprimerlo in automatico significherebbe trattare l'indizio come una conclusione definitiva. Preferisco un percorso intermedio che preservi le relazioni specifiche per l'esame, mantenendo visibile la spiegazione non risolta. Tale scelta ha un costo: genera lavoro per i revisori e una coda sovraccarica può ritardare l'attenzione verso casi più evidenti. Definire il percorso come revisione umana non fa scomparire questo problema di capacità.
Per un sistema futuro, valuterei quel costo attraverso esempi in cui account legittimi condividono interessi, così come mediante coordinazioni simulate. La decisione consiste nello stabilire se le relazioni supplementari producano indagini utilizzabili da un analista, a un volume che il team sia effettivamente in grado di esaminare. Un punteggio più elevato senza un motivo verificabile fa ben poco per chiarirlo. Una coda più corta ottenuta scartando silenziosamente gli account collegati nasconde a sua volta il compromesso.
L'indagine dovrebbe quindi distinguere ciò che le evidenze esistenti possono risolvere da ciò che richiede ulteriori informazioni. Un analista può esaminare quali cronologie si sovrappongano, quanta parte della connessione dipenda dal fattore temporale e se la stessa scheda spieghi la concentrazione. Accertare pagamenti o dichiarazioni false richiederebbe prove superiori a tali relazioni. Queste sono questioni di revisione proposte, non funzionalità fornite da questa demo sintetica mediante accesso diretto alla piattaforma.
Ciò modifica il modo in cui interpreto un percorso di revisione. Si tratta di un'allocazione di attenzione basata su una motivazione esplicita. Dovrebbe essere possibile dissentire da tale motivazione, registrare una spiegazione innocua o concludere che le prove disponibili siano insufficienti. Se il flusso di lavoro consente solo di confermare i sospetti del rilevatore, il passaggio intermedio ha smarrito la sua ragion d'essere.
La spiegazione può trasformarsi in un'ulteriore fonte di falsa certezza
Esiste un secondo punto in cui questa distinzione può crollare: la narrazione dell'indagine. Un paragrafo fluido può trasformare «queste cronologie si sovrappongono» in «questi recensori sono stati pagati» senza aggiungere alcuna prova. Il linguaggio fornisce un'apparente spiegazione per uno schema la cui causa rimane irrisolta.
In Campaign Firewall, il punteggio deterministico assegna i percorsi prima che un bridge Codex opzionale generi una narrazione. Il video del fondatore associato riproduce una risposta Codex memorizzata nella cache, anziché mostrare un'inferenza in tempo reale durante la registrazione. Il testo generato non può alterare i livelli assegnati. Tale separazione protegge la decisione di punteggio dalla narrazione, ma un analista potrebbe comunque lasciarsi convincere da una frase priva di fondamento nella spiegazione.
La demo applica un filtro di ancoraggio euristico basato sulla sovrapposizione numerica e lessicale, con un controllo per verdetto invertito. Può eliminare i testi non supportati; non garantisce però che ogni frase mantenuta sia veritiera. Una frase può riutilizzare i numeri corretti ed esagerarne comunque il significato. Mantenere disponibili le relazioni sottostanti fa dunque parte del compito del revisore, non è un'incombenza esaurita da un filtro con esito favorevole.
Desidero che la narrazione aiuti a esaminare un'inferenza, compresa l'inferenza che non è in grado di comprovare. Se una bozza afferma che gli account sono stati pagati, il revisore ha bisogno della prova del pagamento. Ripetere la dimensione del cluster o il suo punteggio non può colmare quel vuoto. Se tale prova è assente, l'affermazione dovrebbe rimanere irrisolta anche quando il pattern degli account merita di essere indagato. La stesura di una bozza di contestazione dovrebbe preservare tale confine fino a qualunque decisione successiva; in questo contesto, la bozza non viene presentata.
Ecco la presentazione del fondatore per questo esempio sintetico.
La guida di Campaign Firewall illustra le evidenze relazionali sintetiche e il fascicolo d'indagine alla base di questo esempio. Per un decisore tecnico, la domanda di valutazione utile riguarda cosa accada quando un collegamento possiede più di una spiegazione plausibile. Un sistema si guadagna un percorso di revisione esponendo la connessione. Un'azione rilevante necessita di prove che risolvano la motivazione ad agire, nonché di un modo esplicito per fermarsi quando tali prove mancano.