Un'allerta di riconoscimento facciale ha ottenuto 0.83: ho costruito il filtro che l'ha bloccata

Un punteggio grezzo FaceFirst di 0.83 non è stato sufficiente a generare il consenso per un'allerta sintetica di riconoscimento facciale a Chicago, quindi il gate deterministico di policy l'ha bloccata. Ho progettato questo scenario per testare se un sistema biometrico tratti la governance come parte integrante della decisione o come un adempimento cartaceo aggiunto a cose già avviate.
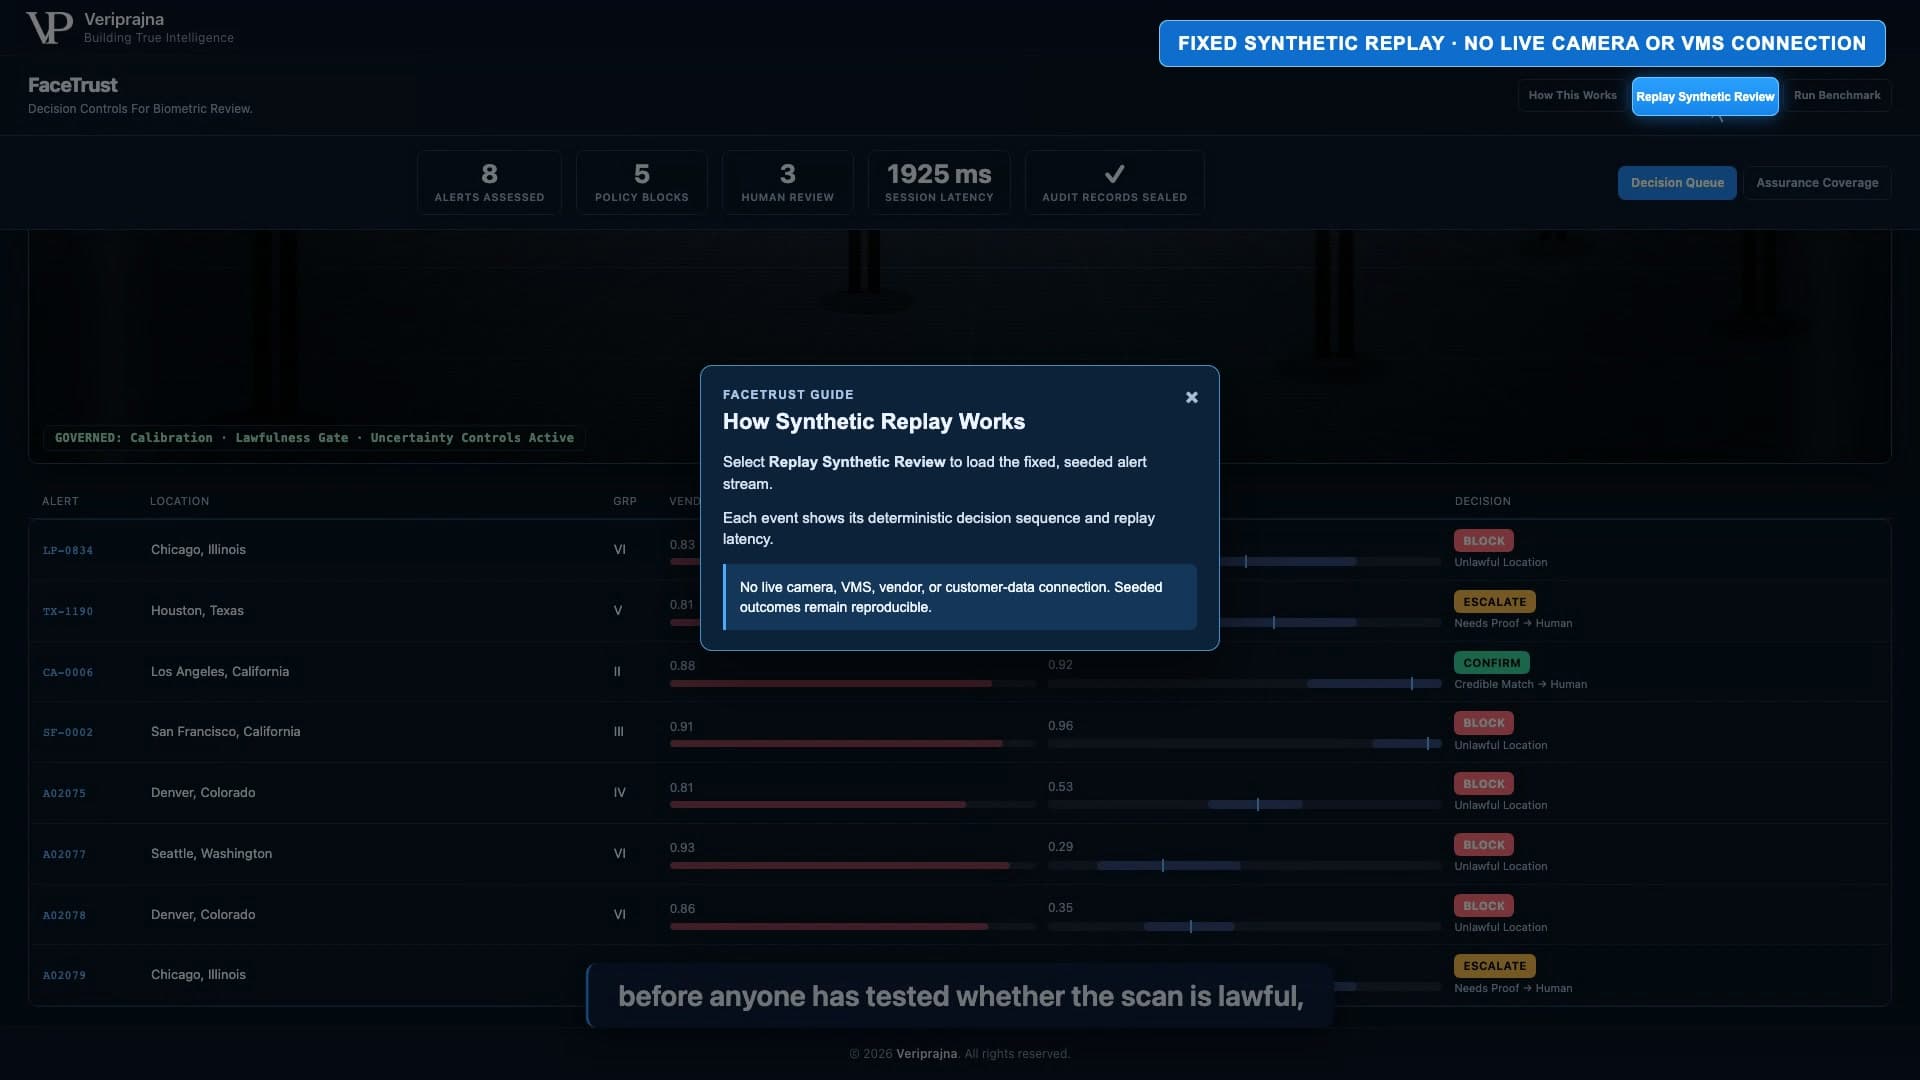
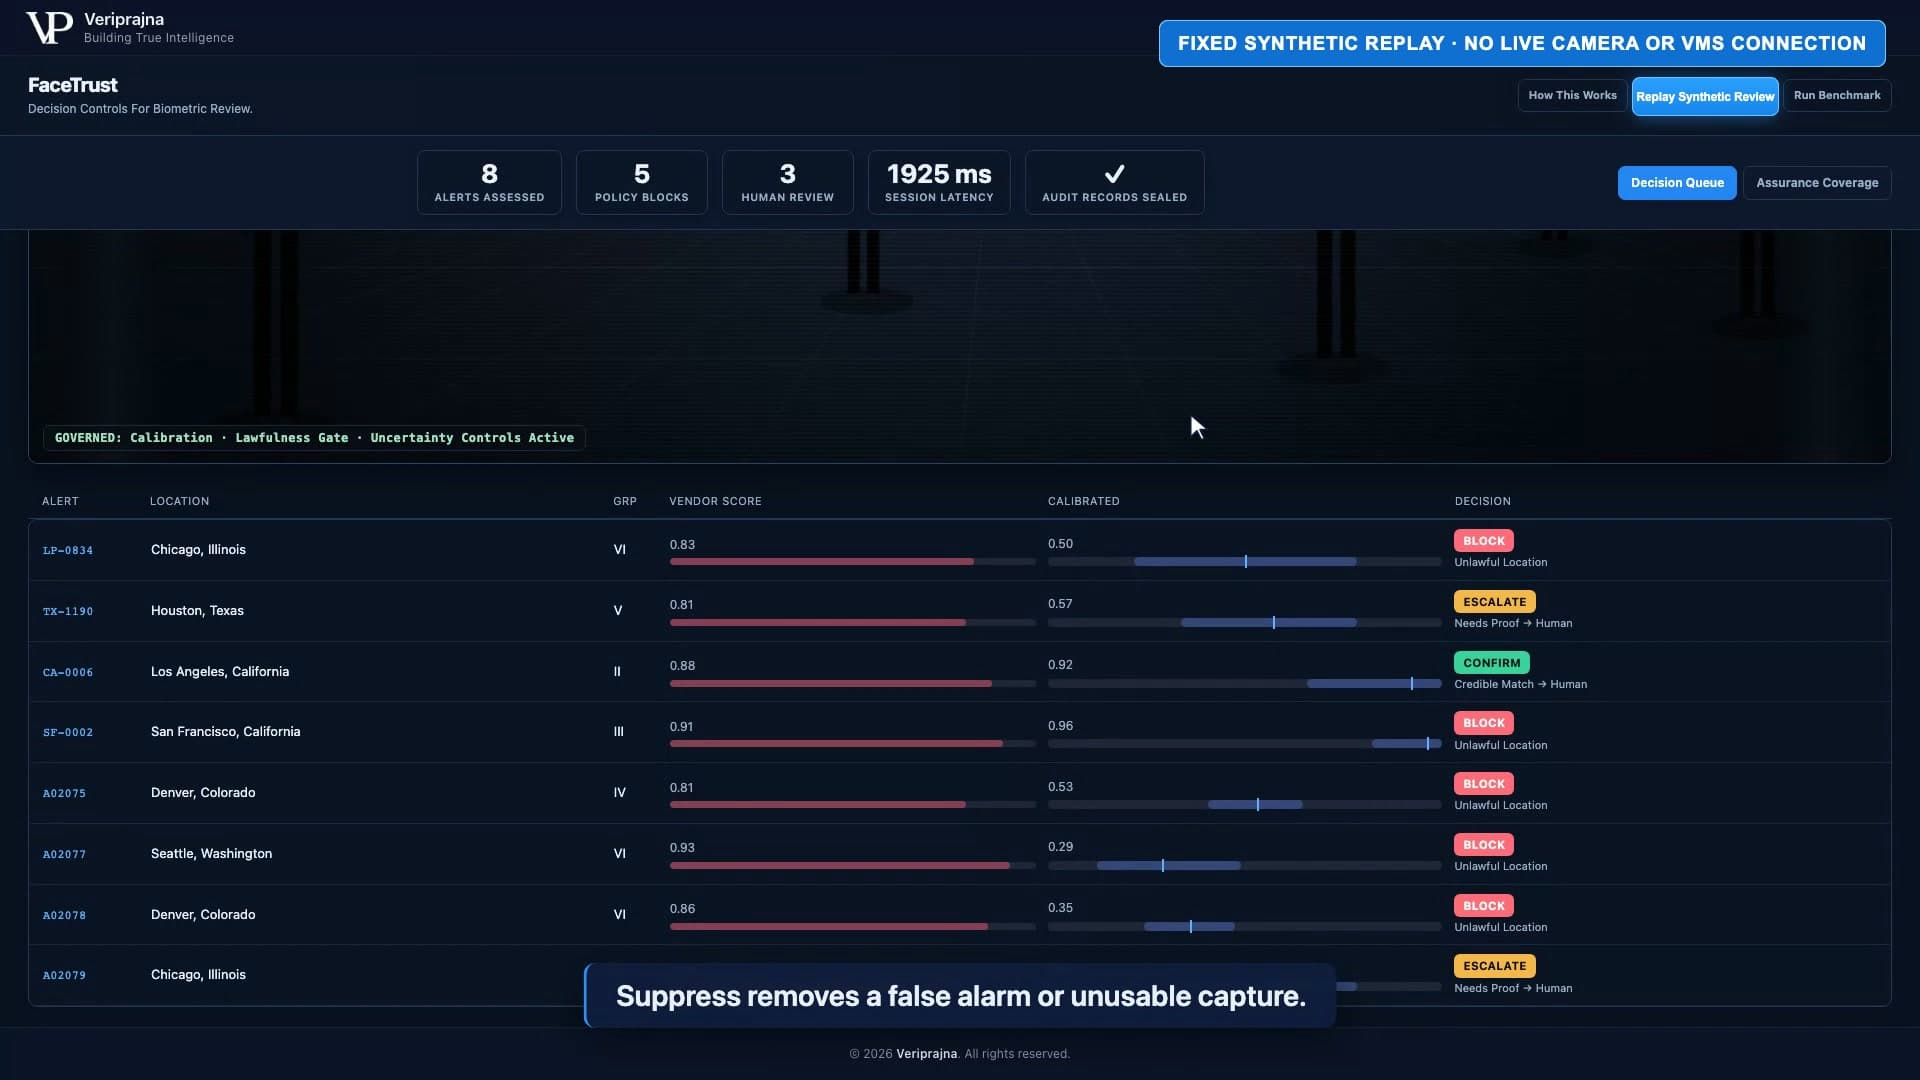
L'allerta in questione è LP-0834, uno scenario sintetico appositamente predisposto a Chicago. Non si tratta di un evento reale di un cliente, di un flusso in diretta né del caso di una persona reale. La sonda di test è un'acquisizione a 80 pixel in condizioni di scarsa illuminazione confrontata con una foto segnaletica vecchia di 15 anni. FaceTrust calibra il punteggio grezzo a 0.50, con un intervallo di [0.217, 0.783] e un insieme di previsione conforme al 93% contenente sia {mate, no_mate}. Ma il dato dirimente è più lineare: nessun consenso è registrato agli atti, perciò il gate deterministico blocca la scansione in base alla regola BIPA predisposta nella demo.
Continuo a ritornare su questo ordine di priorità. Un modello può offrire elementi probatori. Non dovrebbe tuttavia avere il potere di stabilire che un requisito legale mancante possa essere ignorato solo perché il suo punteggio appare convincente.
L'analisi completa illustra l'interfaccia, il video e il funzionamento del meccanismo. Ciò che segue rappresenta la lezione più severa appresa durante la progettazione: se un controllo può spiegare una cattiva azione solo a posteriori, è arrivato troppo tardi.
Cosa credevo significasse 0.83
Ho iniziato dal numero perché è lì che l'occhio cade naturalmente. Nella coda sintetica, LP-0834 si affianca ad altre allerte con punteggi grezzi compresi tra 0.81 e 0.91. A prima vista sembrano variazioni della stessa fattispecie: corrispondenze evidenti in attesa di risposta operativa. La coda alimentava il mio riflesso di classificare prima e porre domande solo in seguito.
Quel riflesso è esattamente ciò che intendevo esaminare. Un punteggio grezzo di un fornitore è un dato in ingresso fornito da un singolo sistema di riconoscimento. Non specifica se la raccolta fosse consentita, se l'inquadratura fosse adeguata per la decisione contingente, o se l'incertezza attorno a un risultato calibrato contempli ancora una mancata corrispondenza. Eppure un punteggio con due cifre decimali appare compiuto. La sua precisione visiva scavalca la sua autorità decisionale.
Ho trovato le righe adiacenti illuminanti perché mi hanno negato una scorciatoia comoda. TX-1190 presenta un punteggio grezzo di 0.81 e viene indirizzato a ESCALATE poiché la prova calibrata resta irrisolta. CA-0006 presenta 0.88 e viene indirizzato a CONFIRM, il che implica che un revisore esperto possa procedere, non che il sistema possa interpellare chicchessia in modo automatico. SF-0002 vanta il punteggio più alto dei quattro, 0.91, e viene comunque instradato a BLOCK poiché la tabella giurisdizionale contrassegna il riconoscimento facciale come vietato a San Francisco.
Le righe sono sintetiche per concezione, ma il quesito architetturale è tangibile: quali informazioni hanno la facoltà di scavalcare il punteggio? Se la risposta è «nessuna», il processo di conformità al contorno è puramente ornamentale. Se la legalità e l'incertezza possono deviare il percorso prima che l'allerta giunga alla squadra operativa, la governance è diventata eseguibile.
Un punteggio alto può consolidare le evidenze. Non può creare il consenso né abrogare un divieto.
Il momento in cui il punteggio ha perso il comando
Ho aperto il fascicolo di LP-0834 aspettandomi che il pannello di calibrazione monopolizzasse la scena. Il punteggio grezzo di 0.83 scende a una probabilità di corrispondenza calibrata di 0.50. L'intervallo si estende da 0.217 a 0.783, e l'insieme di previsione racchiude entrambe le etichette possibili. Gli elementi probatori non consentono alcuna certezza.
Poi la mia attenzione si è spostata in basso verso la verifica del consenso. È lì che si decide l'instradamento. L'immagine è di 80 pixel, quindi supera la soglia minima di 72 pixel stabilita nella demo. La foto segnaletica ha 15 anni, dato che il fascicolo registra come segnalazione per revisore e audit, senza farne un filtro autonomo. La mancanza di consenso è diversa: fa scattare BLOCK.
Ho faticato ad accettare questa gerarchia più del previsto. La calibrazione è matematicamente affascinante, e un intervallo appare come la risposta più sofisticata. Ma se lascio prevalere il racconto dell'incertezza, rischio di suggerire che una probabilità più favorevole possa salvare la scansione. Non può colmare una condizione preliminare mancante. Il gate deterministico di policy deve valutare la legalità indipendentemente dalla sicurezza ostentata dal modello.
Ciò ha mutato il modo in cui spiego il prodotto. FaceTrust dimostra il Biometric Decision Firewall. Non è l'ennesimo motore di riconoscimento facciale. Un adattatore per il fornitore normalizza l'allerta, un calibratore locale esprime l'incertezza e controlli deterministici selezionano tra BLOCK, SUPPRESS, ESCALATE e CONFIRM. Il Compliance Reviewer può redigere una nota esplicativa dopo che tali fatti strutturati sono emersi, ma non pilota il percorso. In questa demo, tale nota è precalcolata in cache o proviene da un modello deterministico di riserva.
Volevo che questo confine fosse evidente perché i modelli linguistici sono abili nel produrre spiegazioni apparentemente logiche. Una nota coerente non costituisce una base giuridica. La consulenza deve collocarsi a valle del percorso fissato da regole ispezionabili, non a monte come un persuasivo surrogato.
Ho dovuto smettere di trattare la calibrazione come un verdetto
Continuavo a pretendere che una singola probabilità calibrata facesse più di quanto potesse. Era il mio modello mentale fallace durante lo sviluppo: sostituire un punteggio grezzo con uno migliore e usare quest'ultimo come decisione. LP-0834 ha spezzato questa scorciatoia perché il risultato di 0.50 necessitava ancora di un intervallo, di un insieme di previsione, di un controllo sul consenso, di una verifica giurisdizionale e di una procedura umana a presidio di qualunque azione autorizzata.
L'insieme di previsione conforme al 93% è cruciale poiché trasforma il lessico operativo del sistema. Quando l'insieme include sia {mate, no_mate}, FaceTrust non comprime l'ambiguità in un'etichetta categorica. Può instradare un'allerta lecita ma irrisolta verso ESCALATE. Quando le evidenze escludono una corrispondenza, può applicare SUPPRESS. Quando l'insieme include {mate}, un instradamento CONFIRM implica comunque l'intervento di un revisore qualificato, mai un fermo, una detenzione o un'accusa automatica.
Sono passato dalla coda operativa alla vista di garanzia statistica poiché un fascicolo isolato non poteva rispondere al tema della copertura. Sul set di test sintetico deterministico di 3,000 allerte, gli insiemi conformi nominali al 93% hanno conseguito almeno il 91.5% di copertura empirica nei sei gruppi Fitzpatrick analizzati. Il minimo della baseline grezza era del 40.6%. L'interfaccia evidenzia la copertura su tutti e sei i gruppi Fitzpatrick esaminati.
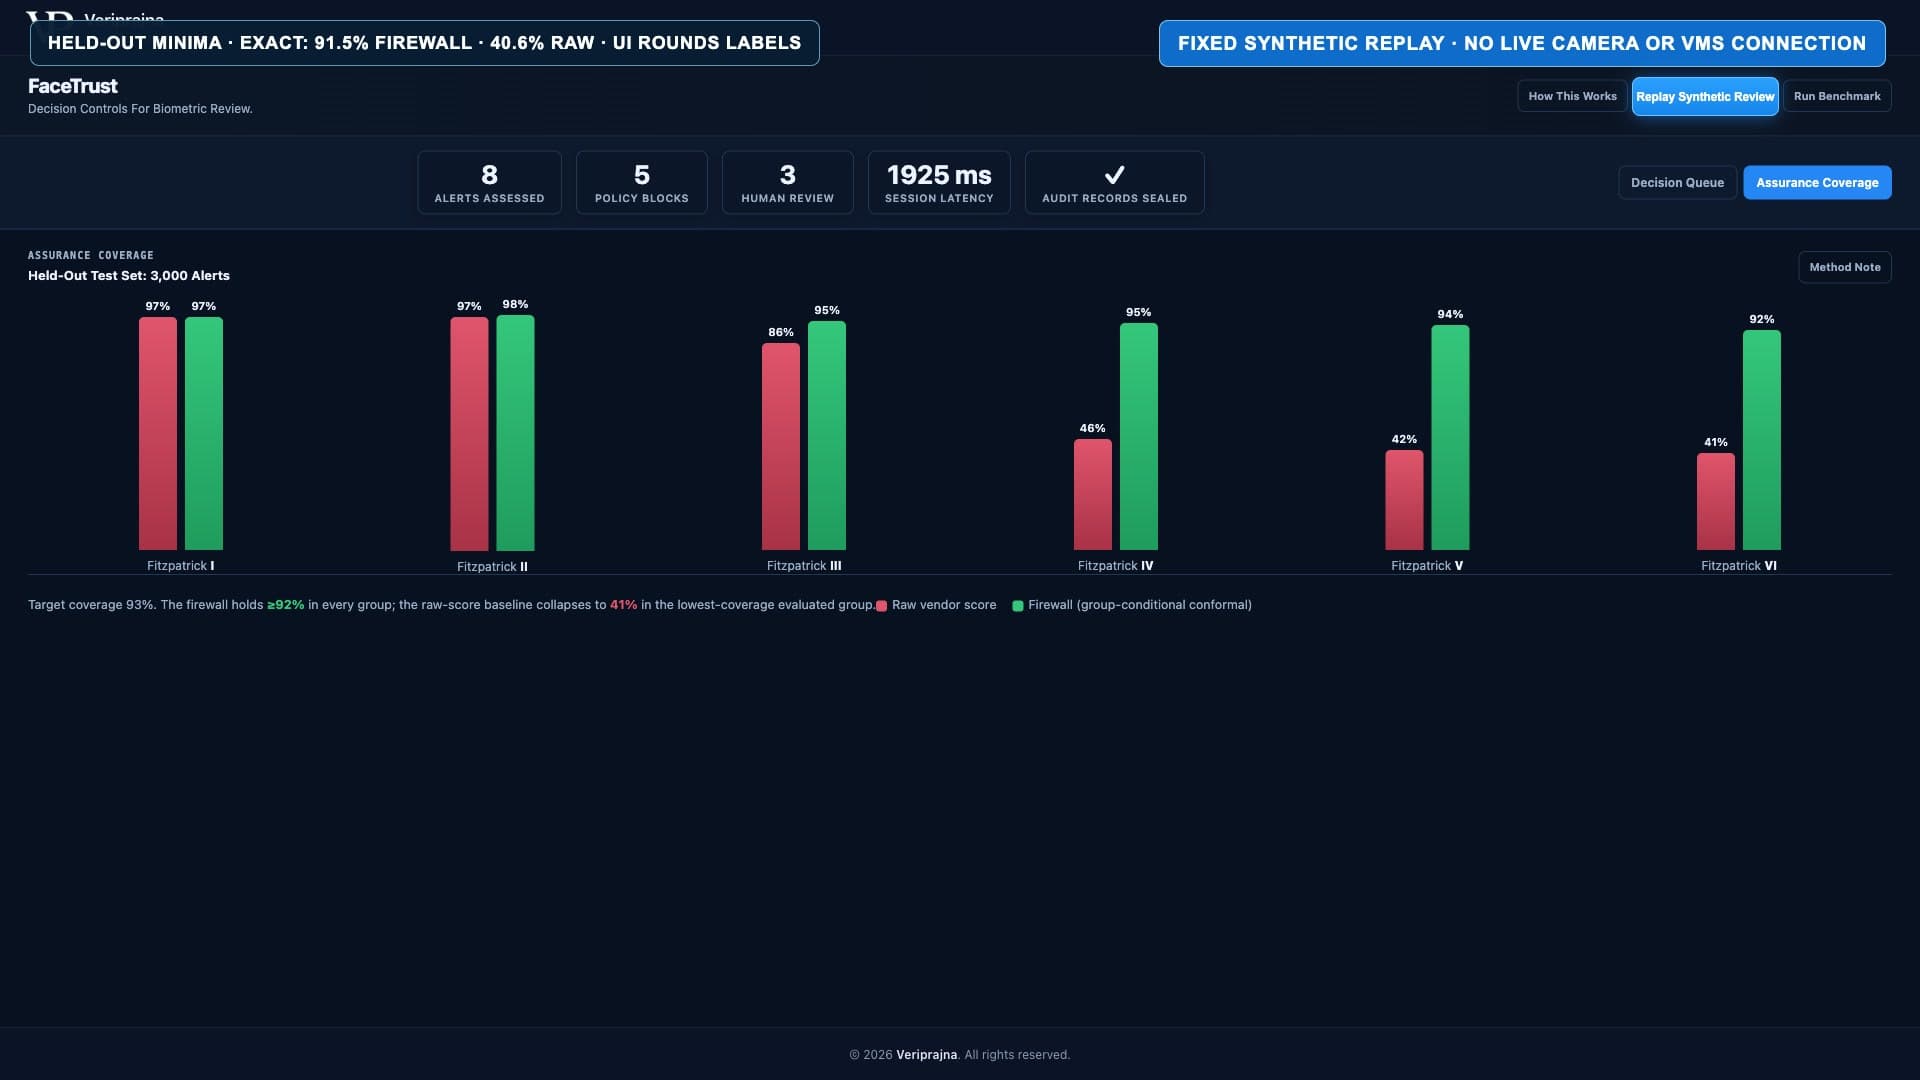
Questi numeri non costituiscono dichiarazioni di prestazioni in produzione. Il dataset di prova è sintetico, ideato per modellare criticità documentate, e una calibrazione per la produzione richiederebbe lo storico verificato del cliente. Includo questo riscontro perché indica cosa occorra verificare invece di compiacersi di un punteggio aggregato: il gruppo valutato più vulnerabile, nel quadro di un piano di test definito con ambito esplicitato.
Il grafico ha altresì frenato il mio impulso di festeggiare il traguardo nominale. Un obiettivo del 93% non implica che ogni gruppo approdi esattamente al 93%, e certamente non dimostra che il sistema mantenga un'accuratezza del 93% nel mondo reale. Il diagramma fornisce una diagnosi di copertura, non una delega a generalizzare oltre il campione sintetico di prova.
L'incertezza acquista valore solo quando il flusso di lavoro è abilitato ad agire in maniera diversa a causa di essa.
Il replay ha reso visibile il costo operativo
Ho eseguito il replay sintetico predeterminato per verificare il comportamento della gerarchia su scala operativa. Su 364 allerte complessive, la soglia grezza scatenerebbe 303 interventi diretti. Il firewall genera invece 121 percorsi di revisione umana e blocca 179 allerte, registrando una flessione del 60.1% secondo il criterio di conteggio adottato in questo replay. Questa riduzione appartiene a questo replay simulato, non a un'implementazione presso clienti o a una garanzia operativa.
Non ho letto l'esito come «l'automazione ha gestito più lavoro». In realtà, la forza di questa architettura sta nel rifiuto di automatizzare le ricadute finali sulla persona. Essa esclude scansioni vietate o prive di consenso, sopprime indizi che smentiscono una corrispondenza e incanala casi dubbi o attendibili verso procedure definite di revisione umana. La transizione operativa sposta l'inerzia determinata dal punteggio verso una responsabilità specifica per ciascun percorso.
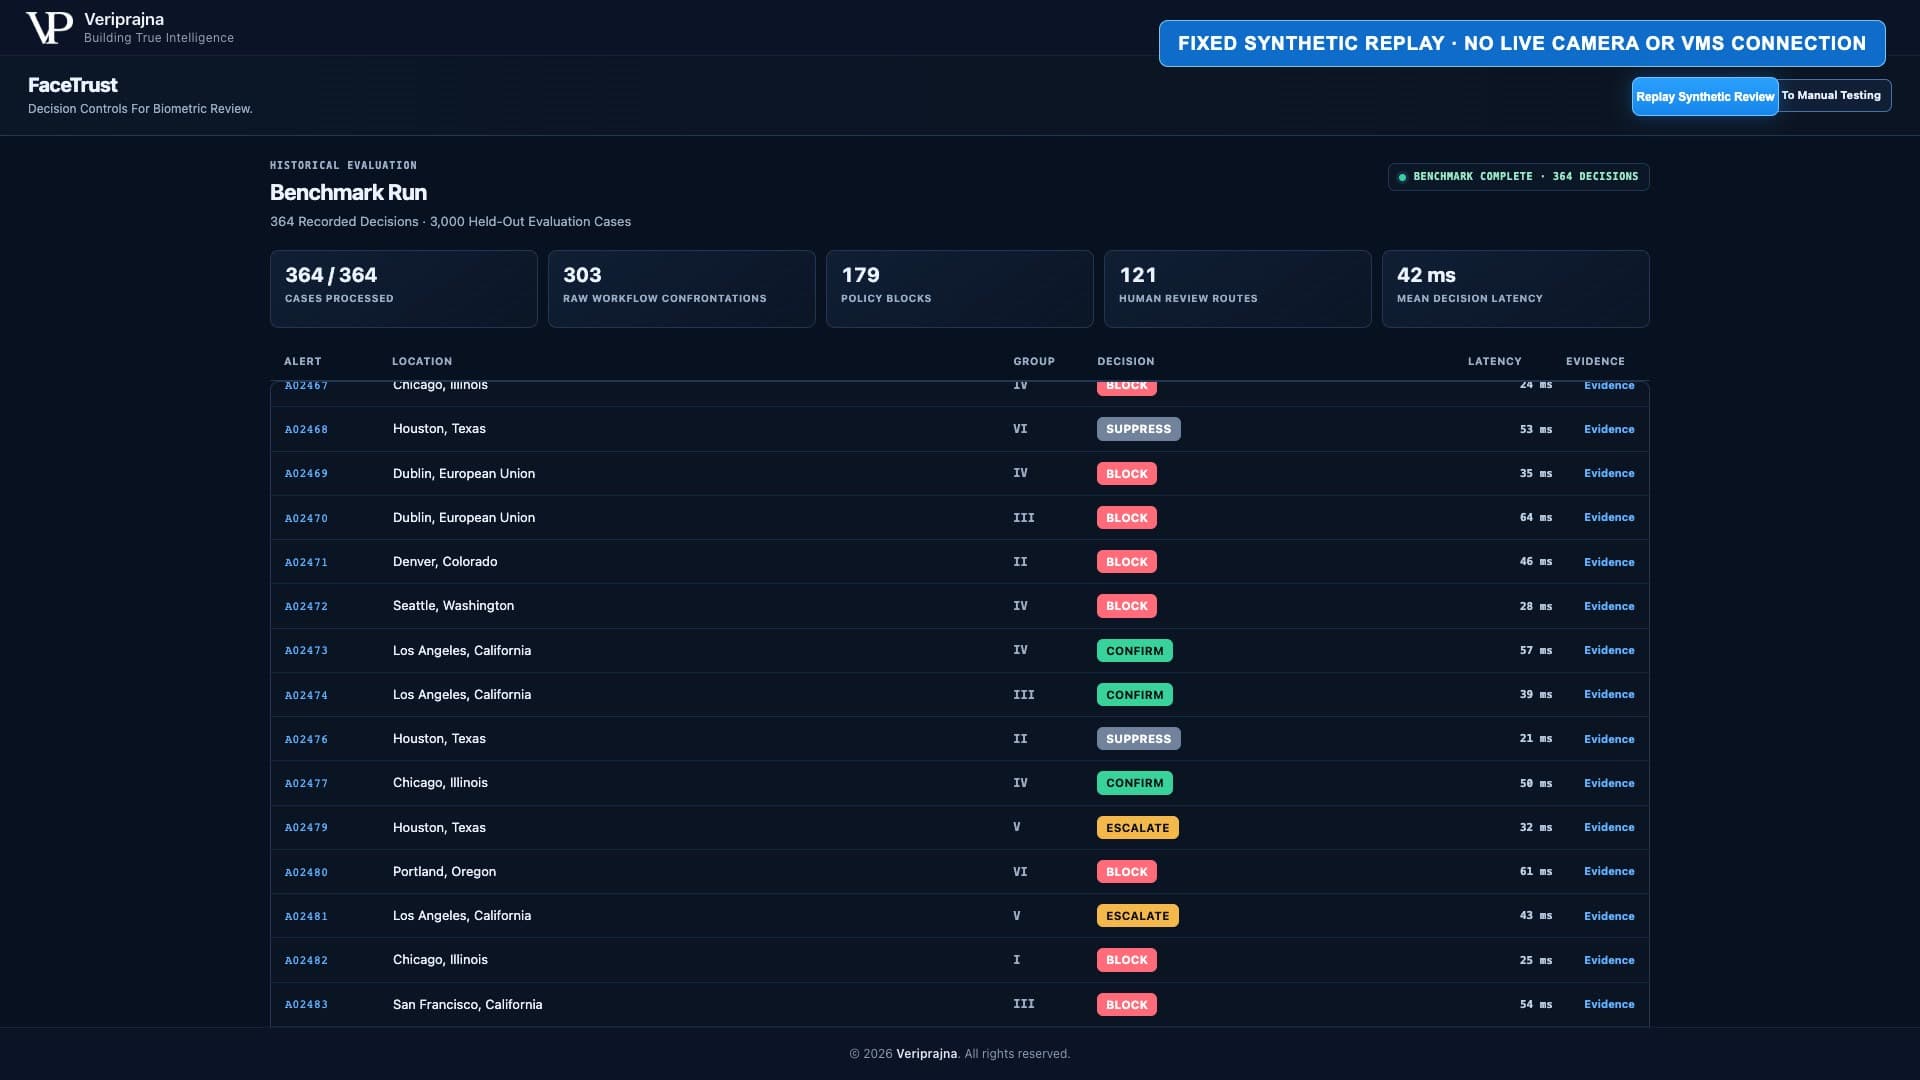
Il benchmark di test delinea un quadro altrettanto circoscritto. Su 1,566 allerte sintetiche di non corrispondenza (impostor), la baseline grezza interverrebbe al 69.3%, mentre il tasso di conferma del firewall è del 3.8%, segnando una contrazione del 94.5% secondo tale definizione. Su 1,434 allerte sintetiche di corrispondenze autentiche, il soggetto rientra nell'insieme predittivo del firewall nel 93.1% dei casi, a fronte del 99.3% della baseline grezza. Questo raffronto porta alla luce un compromesso: preservare più corrispondenze reali è elementare se il sistema accetta di agire su un numero spaventosamente più alto di falsi positivi.
Quel compromesso ha mutato la mia visione di «meno allerte», che presa da sola costituirebbe un obiettivo fuorviante. Un sistema potrebbe alleggerire il carico scartando indistintamente i casi spinosi. Qui, la ragione di ciascun percorso resta annotata: consenso, giurisdizione, requisiti minimi di scatto, insieme predittivo calibrato o esclusione probatoria. Il percorso è spiegabile perché i parametri che lo alimentano sono espliciti.
Ecco perché l'anzianità dell'immagine censita rimane un semplice avviso contestuale anziché un filtro autonomo nella demo. La foto segnaletica di LP-0834 di 15 anni fa fornisce un quadro rilevante per il revisore e l'audit. Fingere che la demo disponga di una regola universale sull'età aggiungerebbe una falsa sicurezza che né il mandato né l'implementazione autorizzano.
Volevo che il rifiuto superasse qualsiasi ispezione
Ho aperto la vista delle prove dopo il replay e ho esaminato la determinazione accanto al suo verbale. LP-0834 non si riduce a un contrassegno colorato. Ogni decisione genera una registrazione concatenata tramite hash SHA-256, e l'interfaccia consente di esportare un report di audit HTML stampabile. Il rifiuto possiede una provenienza tracciabile.
Ho imparato a diffidare dei sistemi la cui spiegabilità è affidata esclusivamente a un paragrafo generato. Un testo descrittivo può riassumere i fatti, ma non può certificare che l'instradamento sia stato deciso prima della redazione del testo né che il verbale sottostante non sia stato modificato in sordina. La catena crittografica non rende la decisione corretta di per sé. Rende qualsiasi alterazione successiva rilevabile all'interno della catena e consegna all'ispettore un reperto stabile.
Tale distinzione preserva l'onestà della verifica. Questa demo non è una certificazione di conformità, né un parere legale o un surrogato dell'assistenza di un legale. Impiega un modello sintetico prefissato, adattatori di simulazione e tabelle normative ipotetiche. Non ha alcun collegamento con telecamere reali, VMS, motori commerciali, NIST, controlli di vitalità o dati di clienti. Dimostra un meccanismo e una sequenza ordinata, non un risultato operativo in produzione.
Posso figurarmi chiaramente la domanda di un futuro audit: non «mi mostri il testo della nota», bensì «mi mostri cosa sapeva il sistema, quale regola deterministica sia intervenuta, a chi sia rimasta la responsabilità dell'azione e se il verbale sia rimasto intatto in seguito». Il report di audit è strutturato appositamente per questa sequenza di quesiti.
La regola che ho tratto dallo sviluppo
Non considero più la governance del riconoscimento facciale come uno strato che si attiva una volta accertata una corrispondenza. A quel punto l'allerta ha già acquisito una propria forza di inerzia. Qualcuno intravede un punteggio elevato, la macchina operativa si avvia e qualsiasi controllo successivo si trova a dover smentire un dato percepito come assodato.
Lo scenario LP-0834 mi fornisce una regola più categorica: la legittimità deve essere valutata prima che l'attendibilità probatoria possa autorizzare un percorso, e l'attendibilità probatoria deve essere espressa con il relativo margine di incertezza prima che si richieda a una persona di agire. Il revisore qualificato resta responsabile degli esiti successivi a una determinazione CONFIRM o ESCALATE. BLOCK e SUPPRESS devono costituire esiti assolutamente legittimi, non anomalie in attesa di essere scavalcate.
È questa la convinzione che anima il Biometric Decision Firewall. Gli agenti software possono comporre note sintetiche e leggibili, ma sono i controlli deterministici a tracciare la rotta. La guida passo passo e all'analisi completa mostrano come FaceTrust renda tangibile tale separazione.
E se preferite verificare il sistema in azione anziché limitarvi a leggere la mia descrizione, ecco l'intera sequenza operante da cima a fondo.
Ho iniziato con un punteggio che appariva abbastanza marcato da catalizzare subito l'attenzione. Ho concluso con un rifiuto imperniato su un requisito preliminare assente, una prova circoscritta e un fascicolo verificabile. La scelta più responsabile all'interno del sistema è talvolta quella che impedisce al punteggio di tradursi in azione.