Rilevamento di contenuti sintetici e recensioni false
Campaign Firewall dimostra come le prove relazionali possano supportare un percorso di revisione umana quando il solo testo non coglie il pattern. Tutte le recensioni e le cronologie degli account mostrate qui sono sintetiche.
4 su 15
Segnalate dalla baseline locale basata solo sul testo
Campagna interamente umana modellata, stesso fixture
15 su 15
Indirizzate alla revisione umana dall'ensemble
Record sintetici, nessuna azione sulla piattaforma
105 coppie di account
Collegate tramite cronologia di prodotti condivisa
Prove relazionali nello stesso cluster
Queste osservazioni sul fixture spiegano una scelta architetturale. Entrambi i metodi utilizzano percentili di testo derivati dal corpus, e la soglia di revisione dell'ensemble è stata adattata sulle stesse etichette; non si tratta di prestazioni su dati mai visti.
Un team di protezione del brand ha bisogno di sapere perché le recensioni appaiono correlate prima di decidere cosa inoltrare. Una formulazione fluida da sola non può stabilire che gli account abbiano agito in modo indipendente, e un'opinione negativa da sola non comprova una frode.
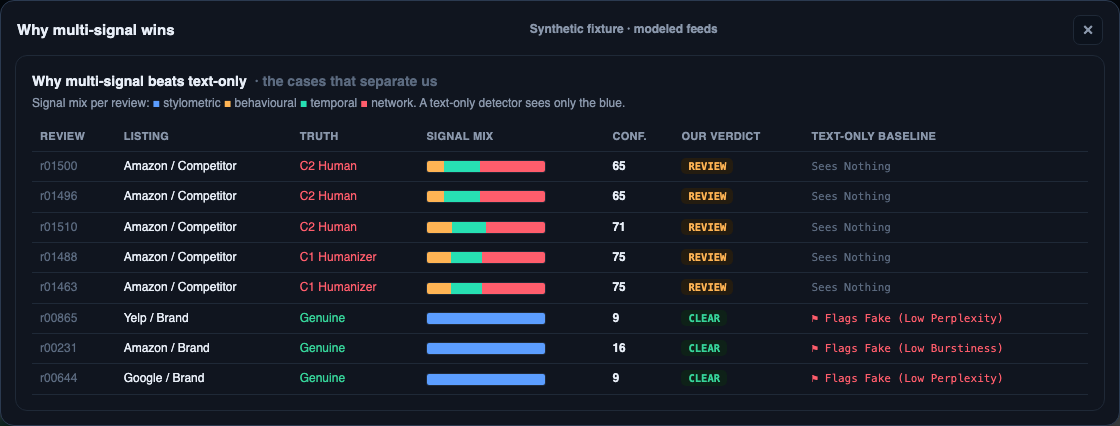
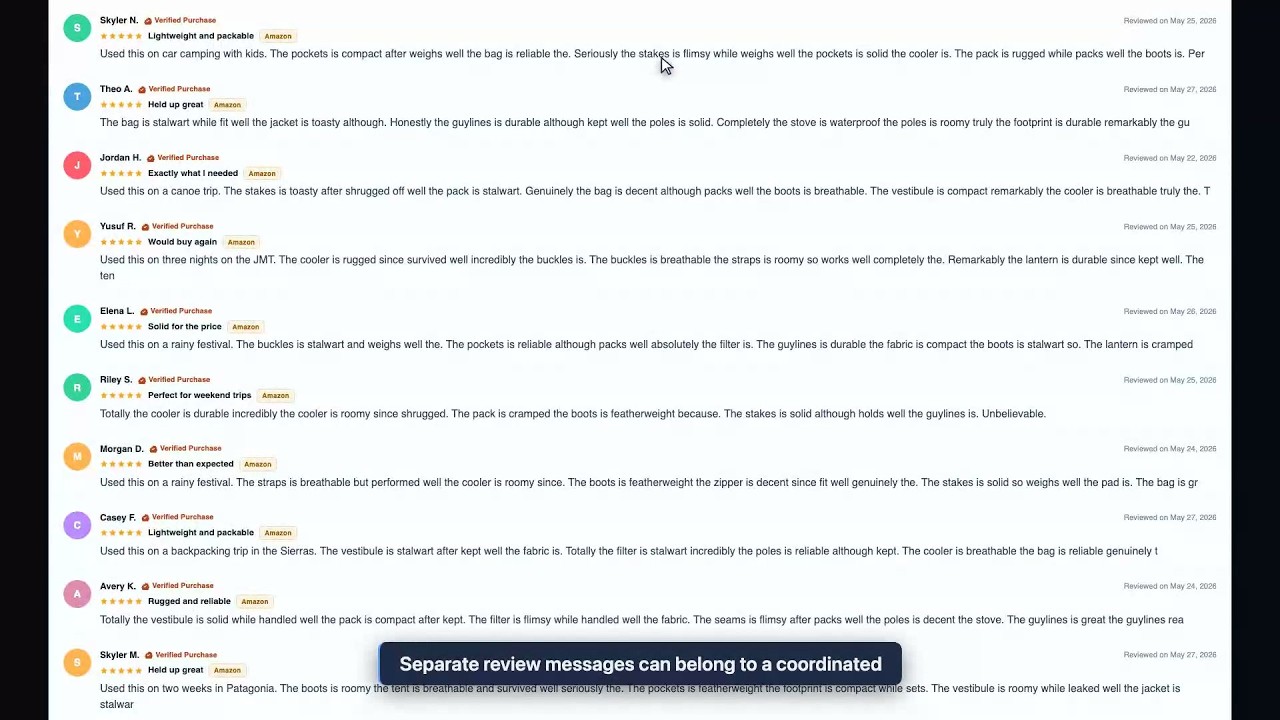
Il nostro esempio sintetico modella una campagna di 15 recensioni sulla scheda di un concorrente. Undici record presentano anomalie stilometriche minime, eppure le loro cronologie di prodotti sovrapposte collegano gli account. La baseline locale basata solo sul testo ne segnala quattro su 15; l'ensemble ne indirizza tutte e 15 per la revisione.
Quel percorso preserva l'incertezza. L'etichetta modellata interamente umana rappresenta il ground truth del fixture, non la prova che persone reali abbiano scritto queste recensioni o che qualcuno sia stato pagato.
Pattern di scrittura, comportamento dell'account, picchi temporali e relazioni tra account contribuiscono a un punteggio euristico limitato superiormente. Il fixture modella 90 giorni di cronologia; il rilevatore temporale esamina finestre di picco di 72 ore. Il punteggio non è una probabilità calibrata.
Dispositivi condivisi o cronologie di prodotti sufficientemente sovrapposte generano archi nel grafo. La sovrapposizione di prodotti richiede una similarità Jaccard di almeno 0,5 all'interno della stessa scheda e non più di 72 ore tra i record. La sola concordanza temporale non genera alcun collegamento.
Le componenti connesse diventano cluster di campagne quando dimensioni e coesione soddisfano le regole configurate. Il punteggio deterministico assegna l'idoneità a CLEAR, REVIEW o al valore modellato AUTO prima che venga redatta una narrazione. REVIEW rimane un percorso per il giudizio umano, non un'indagine conclusa.
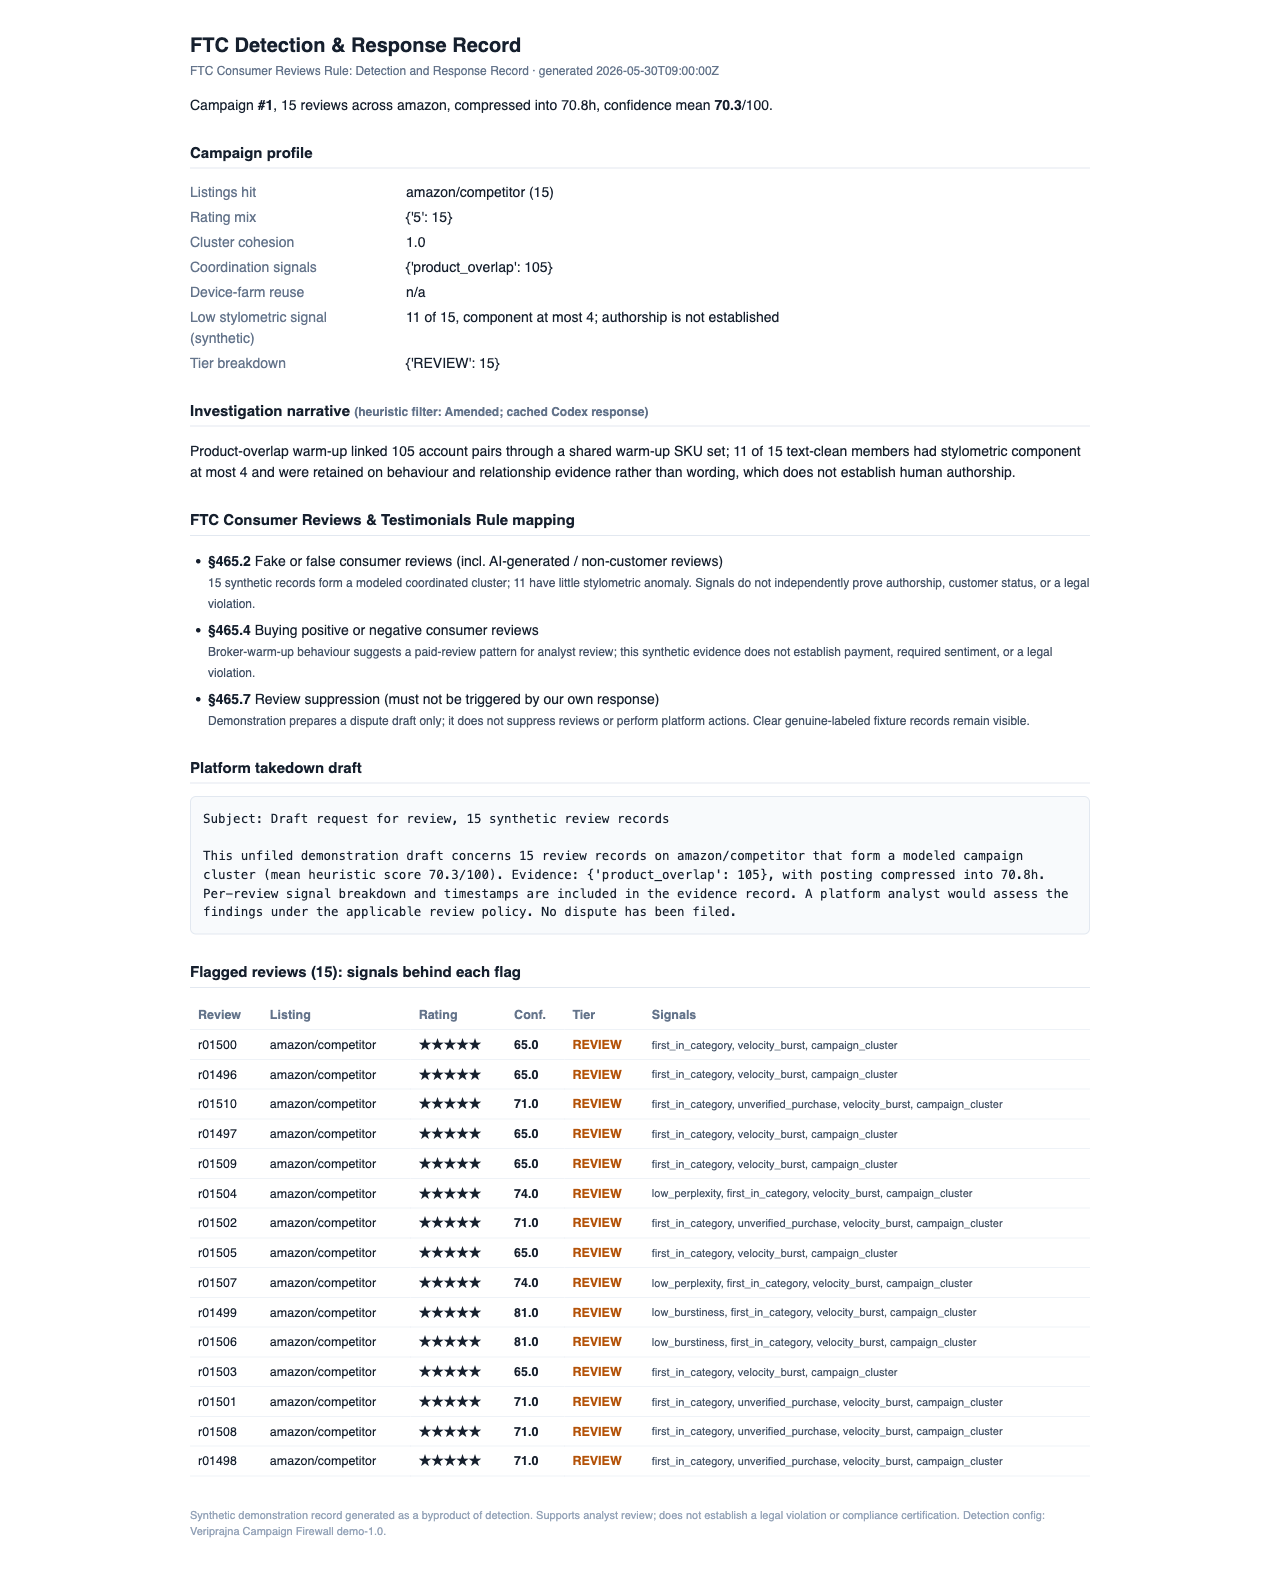
L'indagine registrata riproduce una risposta memorizzata nella cache di Codex dopo l'assegnazione del punteggio. Un filtro deterministico verifica numeri, sovrapposizione di token e inversioni di verdetto; non certifica come vera ogni frase conservata. Il JSON conserva l'appartenenza alla campagna, i punteggi numerici delle componenti e una bozza di contestazione non depositata. L'HTML stampabile mostra il profilo della campagna, i nomi dei segnali per singola recensione e la bozza; non mostra la suddivisione numerica delle componenti.
Il grafo utilizza il clustering a componenti connesse interpretabile. In questa dimostrazione non sono implementate reti neurali su grafi addestrate né integrazioni con piattaforme di produzione.
Tutte le recensioni, le cronologie degli account, i dispositivi e i feed delle piattaforme in queste acquisizioni reali dell'applicazione sono sintetici. L'esempio principale segue 15 recensioni modellate su un concorrente dall'identificazione della campagna attraverso un percorso di revisione umana fino al record esportato.
Il fixture etichetta questo caso come una campagna a pagamento interamente umana, ma né la paternità né il pagamento sono accertati dal rilevatore. Undici delle sue 15 recensioni presentano una componente stilometrica non superiore a 4: un'anomalia minima nel pattern di scrittura in questa implementazione. Le cronologie dei loro account forniscono la motivazione per esaminarle congiuntamente.
Le 15 recensioni condividono cronologie di prodotti sufficientemente sovrapposte sulla stessa scheda entro il limite configurato di 72 ore. Questo genera 105 archi di coppie con sovrapposizione di prodotti, collegando ogni coppia nel cluster, con una coesione di 1,0. In questo caso non sono presenti archi di dispositivi condivisi; il riscontro non dipende dal riutilizzo dei dispositivi. La sola concordanza temporale non creerebbe un arco.
La baseline locale basata solo sul testo segnala quattro dei 15 record. Pertanto manca il rilevamento a livello di campagna in base alla regola di questo harness secondo cui deve essere segnalato almeno il 60% di un'etichetta inserita. L'ensemble combina le componenti di scrittura, comportamento, tempistica e rete e indirizza tutti i 15 a REVIEW, anziché ad AUTO.
| Prova o decisione | Risultato osservato | Interpretazione |
|---|---|---|
| Segnale del pattern di scrittura | 11 su 15 presentano una componente stilometrica non superiore a 4 | Una bassa anomalia non è un certificato di paternità umana. |
| Relazione tra gli account | 105 archi di coppie con sovrapposizione di prodotti; nessun arco di dispositivi condivisi | Un pattern di cronologia condivisa giustifica l'esame congiunto degli account. |
| Baseline locale basata solo sul testo | 4 su 15 segnalate | Questo comparatore implementato manca la campagna in base alla regola del 60%. |
| Percorso dell'ensemble | 15 REVIEW; 0 AUTO | Tutte e 15 vengono indirizzate al giudizio umano. Nessuna recensione viene rimossa. |
Il punteggio deterministico definisce i livelli prima che il modello opzionale descriva il riscontro. L'indagine registrata riproduce una risposta memorizzata nella cache dal bridge reale di Codex. Il suo filtro di ancoraggio verifica numeri, sovrapposizione di token e inversioni di verdetto; la prosa conservata necessita comunque della revisione di un analista e non può modificare il punteggio o il livello.
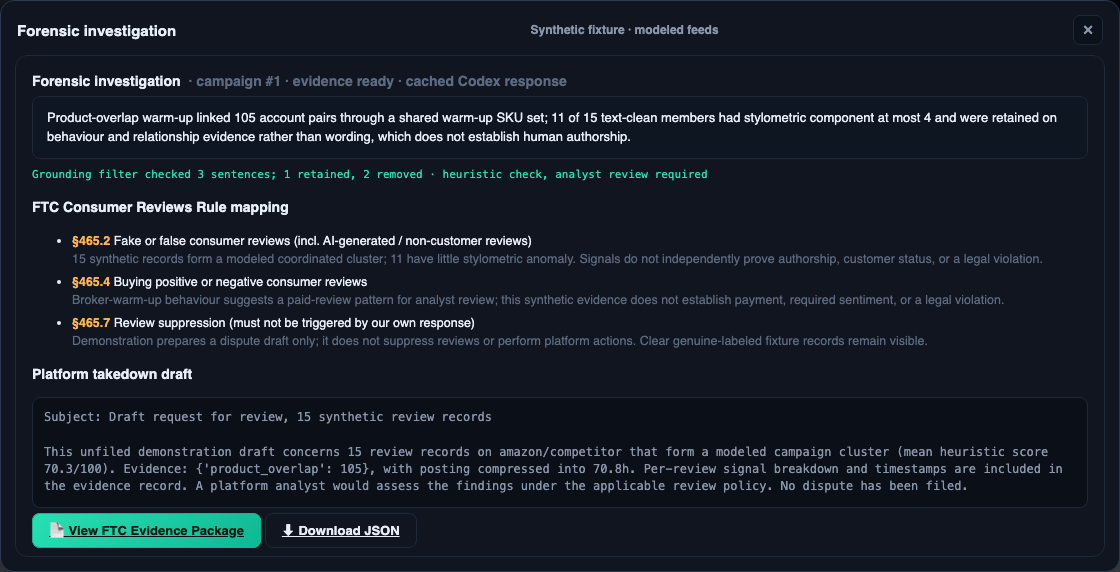
L'effettiva esportazione JSON conserva l'appartenenza alla campagna, la suddivisione per livelli, i segnali che contribuiscono e i punteggi delle componenti di ciascun record. L'HTML stampabile visualizza un profilo della campagna, la narrazione memorizzata nella cache, la mappatura indicativa delle regole, una bozza di contestazione non depositata e tutte le 15 righe segnalate. Un analista può verificare il motivo per cui un record è stato instradato invece di fare affidamento solo sulla narrazione. La bozza di contestazione nativa sovrastima la copertura dei timestamp: il JSON e il report stampabile includono un timestamp di generazione del record, ma nessun timestamp per singola recensione. Questi dovrebbero essere aggiunti e verificati prima dell'uso esterno.
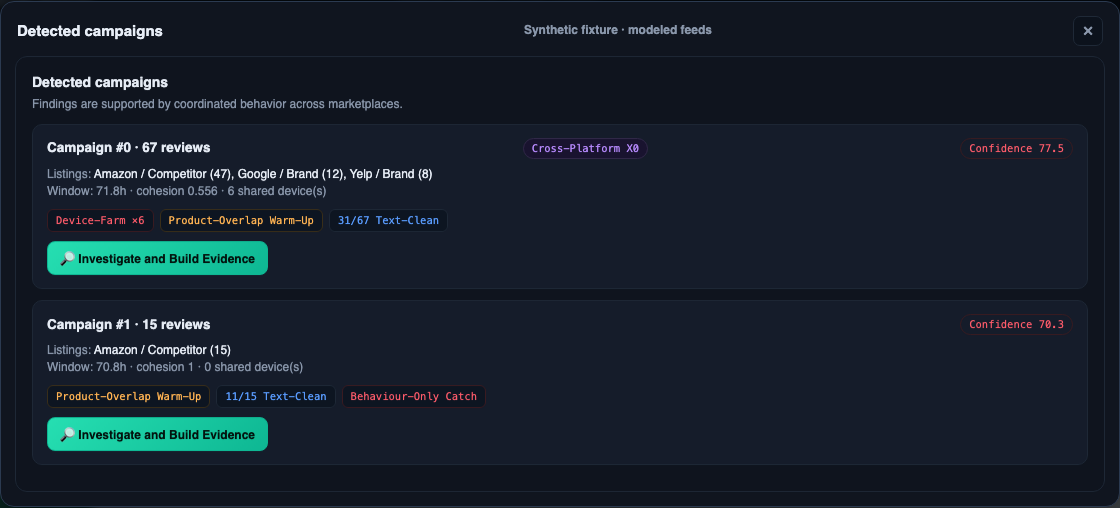
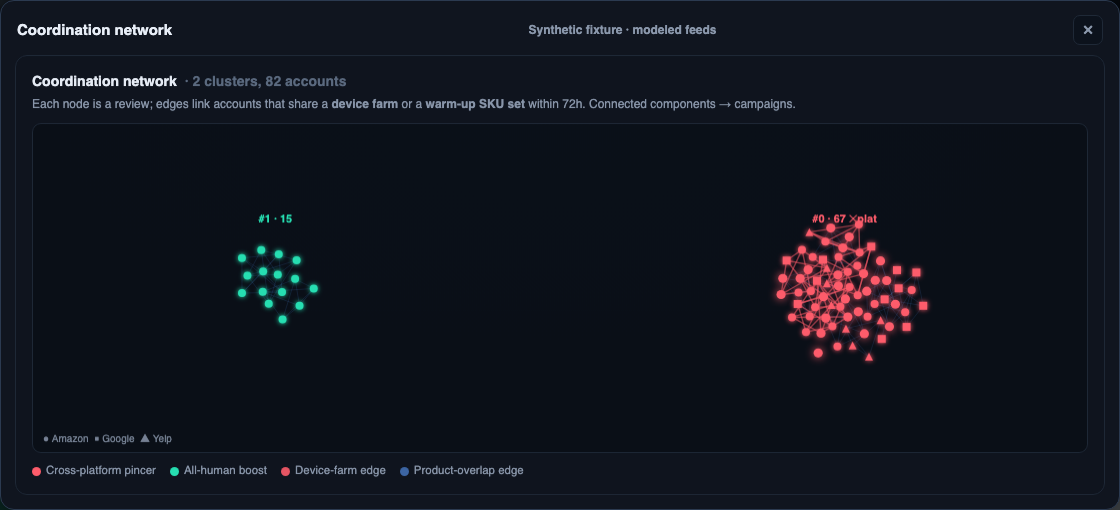
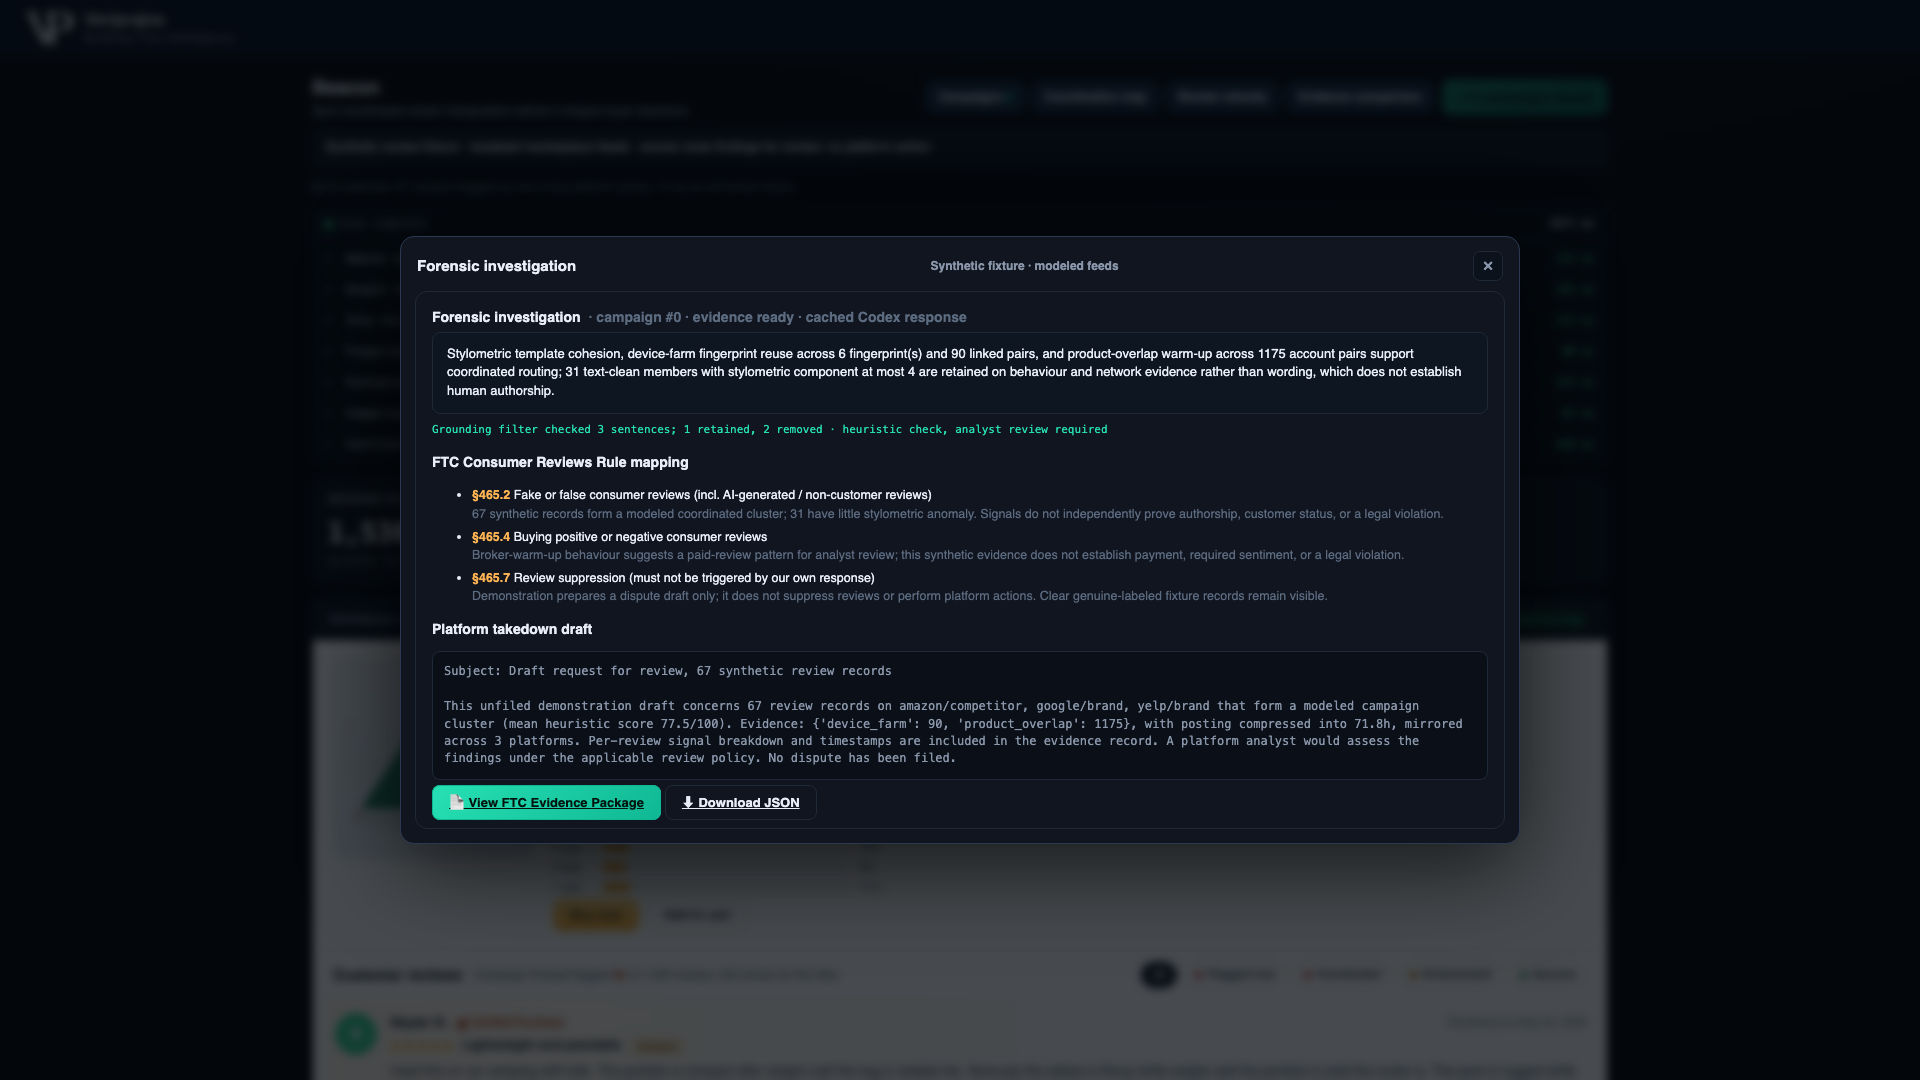
Un cluster sintetico separato collega 67 record: 47 recensioni a cinque stelle sulla scheda modellata del concorrente su Amazon, più 12 recensioni Google e otto recensioni Yelp mirate al brand modellato. Nell'arco di 71,8 ore, il cluster presenta 90 archi di coppie con dispositivi condivisi e 1.175 archi di coppie con sovrapposizione di prodotti. Contiene 24 record AUTO e 43 record REVIEW; AUTO rappresenta l'idoneità secondo una policy modellata, non una rimozione automatica.
Questo caso mostra perché un revisore potrebbe aver bisogno di relazioni tra i feed modellati piuttosto che del solo conteggio dei messaggi negativi. Trentuno dei 67 record presentano anomalie stilometriche minime. Anche in presenza di un pattern connesso, il rilevatore non comprova un effettivo pagamento, lo stato di cliente o la colpevolezza.
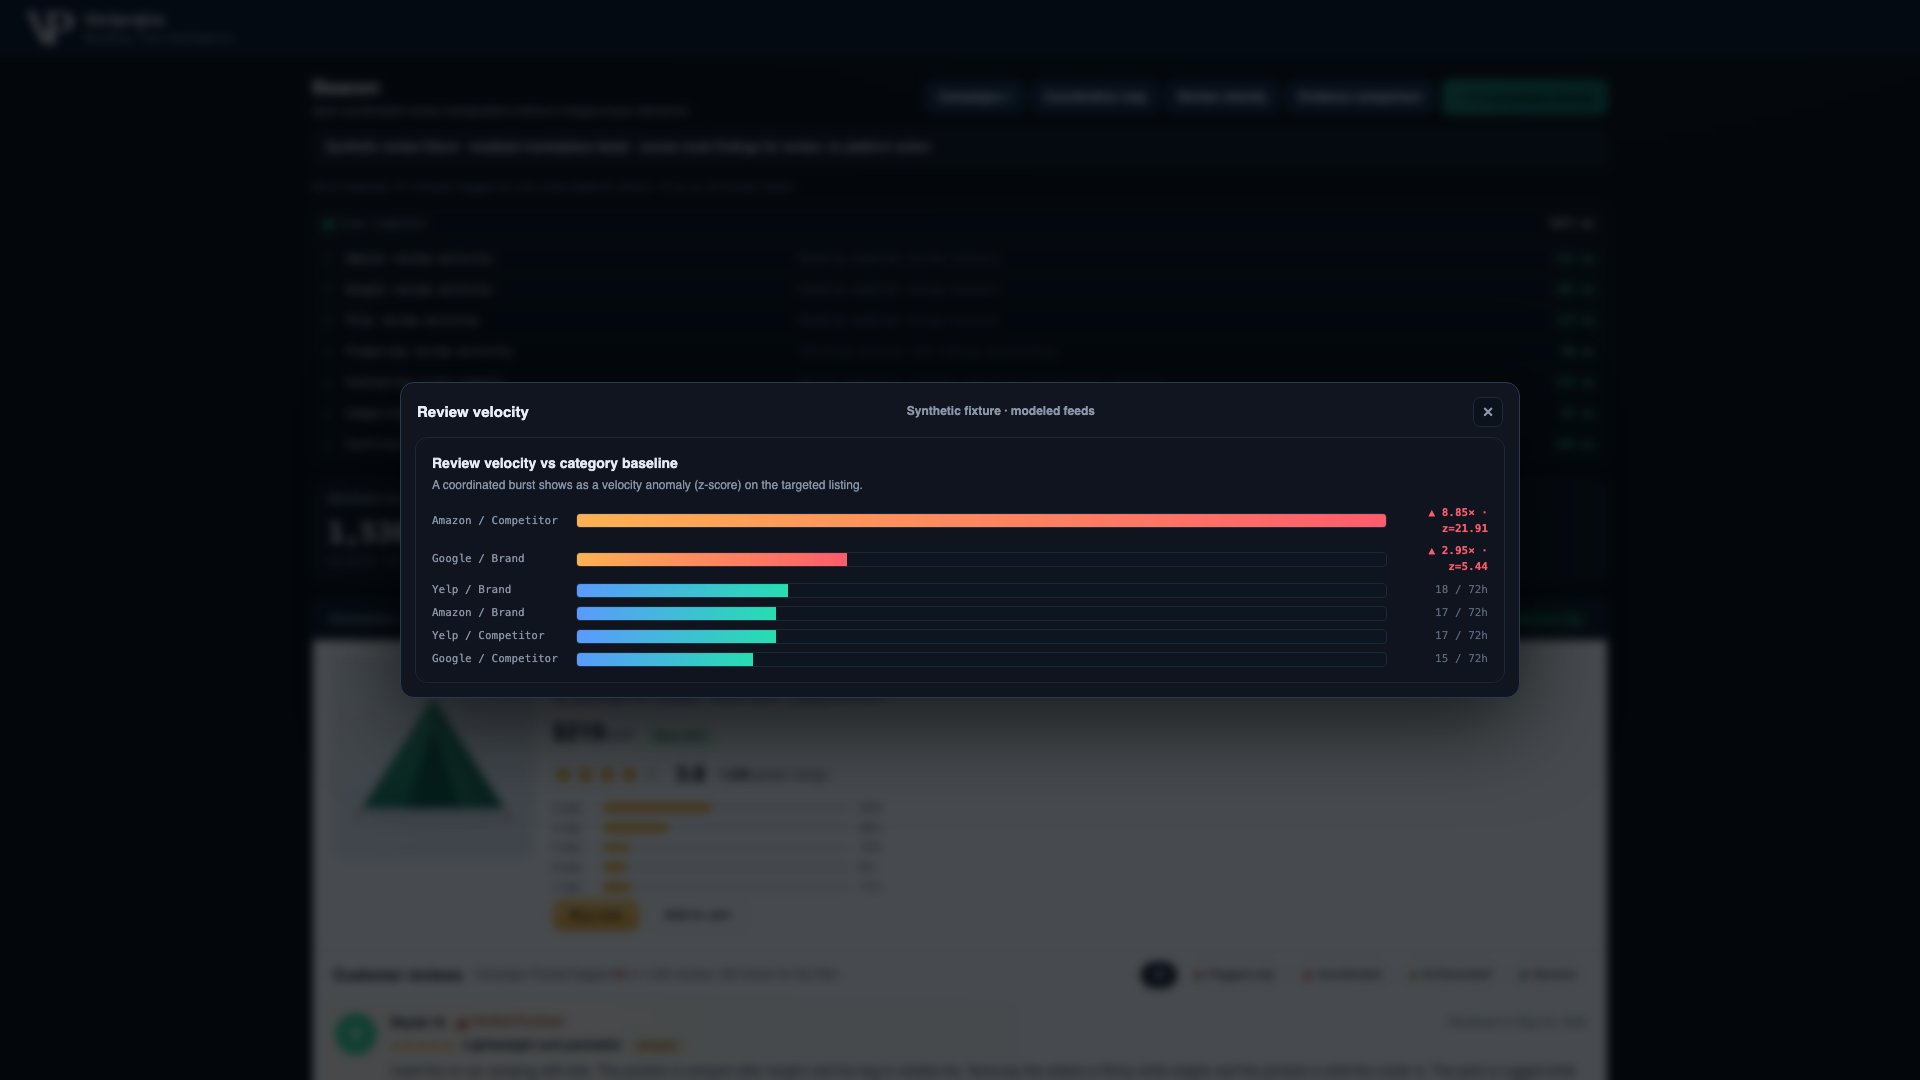
La scheda modellata del concorrente su Amazon registra un picco di 69 recensioni in una finestra di 72 ore rispetto alle 7,8 attese, circa 8,85 volte la baseline configurata. Tale conteggio nella finestra della scheda non corrisponde alle dimensioni del cluster multipiattaforma di 67 record. Un picco improvviso contribuisce con un segnale temporale; le relazioni tra account forniscono i collegamenti nel grafo.
Il fixture più ampio contiene 1.530 record sintetici su una cronologia modellata di 90 giorni. I risultati seguenti riproducono le attuali soglie caricate su quel medesimo corpus etichettato. Entrambi i metodi derivano percentili di testo da esso, e la soglia REVIEW dell'ensemble è stata adattata sulle sue etichette. Questi non sono risultati di accuratezza su dati riservati o di produzione.
| Misurazione | Ensemble di Campaign Firewall | Baseline locale basata solo sul testo |
|---|---|---|
| Record di recensioni inserite segnalati | 82 su 82 | 40 su 82 |
| Record etichettati come autentici erroneamente segnalati | 0 su 1.448 | 306 su 1.448 |
| Etichette di campagne inserite rilevate | 3 su 3 | 0 su 3 |
La segnalazione include REVIEW e AUTO, non rimozioni. Le tre etichette inserite formano due cluster nel grafo poiché le etichette di promozione (boost) e speculari (mirror) si collegano nello stesso cluster multipiattaforma. Il contrasto sui falsi positivi si applica solo a questa baseline implementata e a questo fixture calibrato, non a rilevatori commerciali o a nuove recensioni.
| Livello | Prove utili | Confine |
|---|---|---|
| Baseline locale basata solo sul testo | Anomalie del pattern di scrittura nei singoli record | Segnala quattro su 15 nella campagna modellata; nessuna rivendicazione sui rilevatori commerciali |
| Ensemble di Campaign Firewall | Scrittura, comportamento, tempistica e relazioni tra account | Indirizza tutte e 15 per la revisione in questo fixture sintetico calibrato |
| Documentazione dell'indagine | Appartenenza, punteggi delle componenti, narrazione e bozza di contestazione | Supporta l'ispezione; non deposita una contestazione né dimostra una violazione |
Tutti i record di recensioni, le cronologie degli account, i fingerprint dei dispositivi e le connessioni alle piattaforme sono sintetici. I feed sono modellati, senza connettori live o recensioni estratte tramite scraping. La dimostrazione non autentica autori reali, non rimuove recensioni, non completa indagini umane e non deposita contestazioni.
Non è stata misurata alcuna valutazione su dati riservati, tasso di falsi positivi in produzione, risparmio di ore-analista, ROI o percentuale di successo delle contestazioni. I risultati sullo stesso fixture mostrano un comportamento configurato riproducibile; non stabiliscono la generalizzazione.
Campaign Firewall combina pattern di scrittura con comportamento dell'account, tempistica e prove relazionali. In una campagna sintetica di 15 recensioni, la baseline locale basata solo sul testo segnala quattro record mentre l'ensemble ne indirizza tutti e 15 per la revisione umana. Questo caso modellato dimostra il rilevamento del coordinamento; non attesta la reale paternità umana né le prestazioni su nuove recensioni.
Fingerprint di dispositivi condivisi e cronologie di prodotti sovrapposte creano relazioni tra account nei dati modellati. I collegamenti basati sulla cronologia dei prodotti richiedono una scheda condivisa, almeno 0,5 di similarità Jaccard e timestamp a non più di 72 ore di distanza; la sola tempistica non genera alcun arco. L'appartenenza alla campagna, i punteggi delle componenti e i segnali contributivi rimangono disponibili nell'esportazione delle prove.
La dimostrazione utilizza record sintetici e cronologie modellate etichettate per Amazon, Google e Yelp. Non dispone di connettori per piattaforme live, recensioni estratte tramite scraping o accesso a cronologie reali di account, dispositivi o acquisti. L'accesso ai dati di produzione, le autorizzazioni e le integrazioni richiederebbero un'implementazione e una convalida separate.
Campaign Firewall esporta prove descrittive in formato JSON e HTML stampabile con una bozza di contestazione non depositata. REVIEW indica un percorso di revisione umana, e AUTO indica l'idoneità secondo la policy modellata. Nessuno dei due stati rimuove una recensione, invia una contestazione o completa un'indagine.
L'attuale ensemble assegna CLEAR a tutti i 1.448 record sintetici etichettati come autentici in questo fixture. La sua soglia di revisione è stata calibrata sulle stesse etichette, ed entrambi i metodi derivano percentili di testo da questo corpus, pertanto quel risultato non può stabilire un tasso di falsi positivi per dati mai visti. Una valutazione su dati indipendenti è ancora necessaria prima di utilizzare questi percorsi a livello operativo.
I segnali di coordinamento non comprovano pagamenti, sentiment imposto, stato di cliente o una violazione legale. La FTC distingue le recensioni false o fittizie dagli incentivi condizionati a un sentiment positivo o negativo e dalla soppressione delle recensioni. La demo fornisce una mappatura indicativa delle regole e una bozza non depositata per una revisione sostanziale; non certifica la conformità.
Contesto legale: Federal Trade Commission, Consumer Reviews and Testimonials Rule Q&A (verificato nel 2026). La mappatura è descrittiva e richiede una revisione legale sostanziale prima dell'uso esterno.
Esplora la ricerca correlata per un contesto più ampio su questa dimostrazione.
Soluzione completa
Esplora la soluzione Rilevamento di contenuti sintetici e recensioni false →Discuti i requisiti di prove ed escalation con Veriprajna.
Possiamo definire l'accesso ai dati, la valutazione indipendente e il flusso di lavoro di revisione necessari per il tuo caso d'uso. La dimostrazione offre una base concreta per tale confronto.