Audit sull'equità e mitigazione dei bias dell'IA
Sottoponiamo ad audit i sistemi di IA alla ricerca di esiti discriminatori in ambito assunzioni, prestiti, assicurazioni e sanità, per poi costruire le pipeline di mitigazione che ne risolvono le cause profonde.
Il tuo audit sui bias è stato superato. Il tuo sistema continua a discriminare.
La maggior parte degli audit sui bias dell'IA applica la regola dei quattro quinti a razza e genere, produce un PDF e dichiara la conformità. Questo approccio presenta tre problemi.
- La regola dei quattro quinti è uno strumento grossolano. Tratta dalle Uniform Guidelines (29 CFR 1607), è una soglia di screening progettata per le pratiche di assunzione del 1978. Non è in grado di rilevare la discriminazione per proxy, dove il codice postale, la distanza del tragitto casa-lavoro o l'istituto di istruzione codificano le stesse informazioni della razza senza nominarla.
- Le metriche aggregate nascondono le disparità intersezionali. Uno studio della University of Washington ha rilevato che gli strumenti di screening dei curriculum basati su LLM favorivano i nomi associati a persone bianche l'85% delle volte e non favorivano mai i nomi associati a uomini neri rispetto a quelli associati a uomini bianchi. Le metriche aggregate sulla razza mancherebbero completamente l'effetto cumulativo.
- Un audit una tantum tratta l'equità come permanente. I modelli derivano, le distribuzioni degli input cambiano e vengono aggiunte nuove feature. Un sistema che ha superato un audit a gennaio può discriminare a marzo, e nessuno lo saprà finché non arriva una denuncia.
Il nostro approccio consiste nel costruire audit sull'equità progettati per andare più a fondo del semplice screening statistico, come illustrato in la nostra ricerca sulle architetture della fiducia oltre l'IA superficiale. Il punto di partenza è comprendere cosa significhi “equo” per il tuo sistema specifico, perché la matematica garantisce che non puoi avere tutto contemporaneamente.
Ogni audit è una scelta esplicita, non un'impostazione predefinita
Il teorema di impossibilità di Chouldechova (2017) dimostra che, quando i tassi di base differiscono tra i gruppi, nessun classificatore imperfetto può soddisfare simultaneamente la calibrazione e tassi di errore uguali. Kleinberg, Mullainathan e Raghavan hanno dimostrato un risultato più ampio: tre condizioni di equità intuitive non possono valere simultaneamente, salvo in casi banali.
Non si tratta di note accademiche a piè di pagina. Significano che ogni audit sull'equità richiede una scelta esplicita su quali criteri privilegiare, e quella scelta comporta conseguenze legali, etiche e commerciali. Facciamo emergere il compromesso prima che chiunque inizi a ottimizzare.
Discriminazione per proxy: le feature che hai rimosso sono ancora nel modello
Rimuovere razza, genere o età dagli input del modello non elimina la discriminazione. Elimina la prova diretta di essa, lasciando intatti i meccanismi.
- Un modello di prestito che elimina la razza ma mantiene il codice postale eredita i modelli di segregazione residenziale che rendono il codice postale un proxy quasi perfetto della razza in molte aree geografiche.
- Uno strumento di assunzione che elimina l'età ma utilizza l'anno di laurea, gli anni di esperienza e l'anzianità dello stack tecnologico (COBOL vs. Kubernetes) ricostruisce l'età con alta fedeltà.
Il nostro metodo utilizza l'analisi dei grafi causali per tracciare come gli attributi protetti fluiscono attraverso lo spazio delle feature fino alle predizioni, un approccio illustrato in la nostra ricerca sull'IA causale per un reclutamento e assunzioni eque. La questione non è se una feature sia correlata alla razza. È se la disparità che fluisce attraverso quella feature rappresenti un fattore aziendale legittimo (la storia creditizia predice genuinamente il rimborso) o un proxy per uno status protetto (i punteggi della storia creditizia codificano la discriminazione storica nei prestiti).
Questa distinzione richiede un giudizio specifico del dominio, non solo test statistici. L'incarico costruisce il diagramma causale di ciascun sistema in collaborazione con le persone che conoscono il dominio, identifica ogni percorso dagli attributi protetti ai risultati e classifica ciascun percorso come legittimo, problematico o da approfondire ulteriormente. L'output previsto è una mappa di dove la discriminazione entra nel sistema, non solo un numero che ne attesta l'esistenza.
Audit intersezionale: dove i test su un singolo asse falliscono
Testare razza e genere in modo indipendente manca le disparità peggiori. Il bias algoritmico contro le donne nere non può essere spiegato come la somma del bias anti-nero più il bias anti-donna. L'effetto cumulativo crea uno svantaggio unico che emerge solo quando si esamina l'intersezione. Uno studio del 2024 sull'analisi facciale ha rilevato che gli algoritmi di classificazione del genere presentavano tassi di errata classificazione di circa il 30% per le donne dalla pelle scura, superando di gran lunga i tassi di errore per qualsiasi singolo asse demografico.
La sfida pratica è la potenza statistica. I sottogruppi intersezionali (donne nere over 50 in codici postali rurali) sono piccoli, e i test di ipotesi standard perdono potenza rapidamente al ridursi delle dimensioni del campione. L'analisi ingenua dei sottogruppi o manca le disparità reali perché i campioni sono troppo piccoli per raggiungere la significatività, o produce falsi allarmi da stime instabili.
Il nostro metodo affronta questo problema con modelli gerarchici bayesiani che prendono in prestito forza tra sottogruppi correlati, fornendo intervalli credibili anche per popolazioni ridotte. Applica inoltre framework di test sequenziali che accumulano evidenza nel tempo anziché richiedere tutta la potenza statistica in un'unica istantanea. Il risultato è un monitoraggio intersezionale progettato per rilevare le disparità emergenti prima che raggiungano i livelli a cui le metriche aggregate le coglierebbero.
Audit tra domini: assunzioni, prestiti, assicurazioni, sanità
Ogni dominio ha il proprio quadro normativo, i propri criteri di equità e i propri modelli di discriminazione per proxy.
| Dominio | Panorama normativo |
|---|---|
| Assunzioni | La LL144 di New York impone audit indipendenti annuali sui bias con pubblicazione di un riepilogo pubblico. L' audit del Comptroller dello Stato di New York del dicembre 2025 ha rilevato che il 75% delle chiamate di reclamo relative agli AEDT era stato instradato in modo errato, e l'agenzia ha individuato un solo caso di non conformità laddove gli auditor avevano riscontrato 17 potenziali violazioni. L'applicazione si sta inasprendo: l'Illinois HB 3773 (in vigore da gennaio 2025) vieta le decisioni discriminatorie in ambito occupazionale basate sull'IA, e Mobley v. Workday è diventata a maggio 2025 la prima class action collettiva a livello nazionale certificata sui bias dell'IA. |
| Prestiti | L'applicazione federale si sta frammentando. Il CFPB ha proposto di eliminare l'analisi dell'impatto disparato ai sensi dell' ECOA nel novembre 2025, ma i procuratori generali statali stanno colmando il vuoto. Il Massachusetts ha transatto un caso da 2,5 milioni di dollari relativo alla discriminazione nella sottoscrizione basata sull'IA nel luglio 2025. |
| Assicurazioni | Il Colorado SB 21-169 vieta l'uso ingiustamente discriminatorio di algoritmi e modelli predittivi, con gli assicuratori auto e sanitari tenuti a presentare relazioni annuali sulla conformità entro luglio 2026. |
| Sanità | Le correzioni basate sulla razza negli algoritmi clinici sono oggetto di un esame costante: i pulsossimetri che sovrastimano i livelli di ossigeno nei pazienti dalla pelle scura hanno portato a diagnosi ritardate. Ma rimuovere la razza può anche danneggiare le popolazioni quando essa funge da proxy per genuini fattori di rischio che il modello non è altrimenti in grado di catturare. |
Per l'IA nelle assunzioni, un incarico è definito per andare oltre il minimo della LL144 con analisi intersezionale, test sulle feature proxy e verifiche di equità controfattuale, sulla base di la nostra ricerca sulla responsabilità dell'IA nel reclutamento.
Mitigazione che risolve le cause profonde, non i sintomi
La mitigazione dei bias si suddivide in tre fasi della pipeline, e scegliere quella sbagliata spreca sforzi o introduce nuovi problemi.
| Fase | Tecniche | Cosa fa bene | Dove fallisce |
|---|---|---|---|
| Pre-elaborazione | Ricampionamento, ripesatura, apprendimento di rappresentazioni eque | Corregge i bias che hanno origine nella raccolta dei dati | Fallisce quando il bias deriva da differenze distributive legittime |
| In-elaborazione | Vincoli di equità, debiasing avversariale, regolarizzatori di equità | Offre un controllo diretto sul compromesso tra accuratezza ed equità | Imporre la parità demografica quando i tassi di base differiscono genuinamente degrada la calibrazione. Nei prestiti, il modello o approva eccessivamente i richiedenti ad alto rischio o approva insufficientemente i richiedenti a basso rischio nel gruppo vincolato. |
| Post-elaborazione | Soglie specifiche per gruppo, ThresholdOptimizer di Fairlearn | Il più veloce da implementare | Funziona solo per la classificazione, richiede etichette di gruppo al momento dell'inferenza e tratta i sintomi senza affrontare i meccanismi |
Il nostro approccio seleziona la fase di intervento in base a dove il bias entra nella pipeline, a cosa richiede il quadro normativo e a quale compromesso tra accuratezza ed equità l'organizzazione può tollerare. Ogni mitigazione è definita per produrre una valutazione documentata che mostri il suo effetto sia sulle metriche di equità sia sulle prestazioni del sistema, con il compromesso dichiarato esplicitamente.
Monitoraggio continuo vs. audit annuali
Un audit annuale è un minimo normativo, non una sufficienza tecnica. I modelli che interagiscono con cicli di feedback possono sviluppare bias tra un audit e l'altro: strumenti di assunzione in cui le decisioni passate plasmano i futuri bacini di candidati, o modelli di prestito in cui i modelli di approvazione influenzano i dati delle agenzie di credito.
Il nostro approccio consiste nel costruire un monitoraggio continuo dell'equità utilizzando test di ipotesi sequenziali che rilevano le disparità emergenti in tempo reale anziché attendere dati sufficienti per eseguire un test di significatività tradizionale, un modello di responsabilità esplorato in la nostra ricerca sull'ingegneria della retention e la responsabilità algoritmica. Il monitoraggio attiva avvisi quando le metriche di equità superano soglie configurabili, con un tracciamento separato per le prestazioni aggregate e per quelle dei sottogruppi intersezionali. Questa è la differenza tra scoprire un problema di discriminazione nel report di audit annuale e coglierlo due settimane dopo che è iniziato.
Per i sistemi di IA agentica, il monitoraggio dell'equità è ancora più critico: le orchestrazioni multi-agente possono sviluppare bias emergenti attraverso interazioni tra agenti e cicli di feedback che nessun audit su un singolo agente rileverebbe.
Dove i toolkit e le piattaforme si fermano e inizia il lavoro personalizzato
IBM AIF360 fornisce 71 metriche di equità e 13 algoritmi di mitigazione dei bias. Fairlearn offre ThresholdOptimizer, ExponentiatedGradient e la riduzione GridSearch. Entrambi sono validi punti di partenza. Nessuno dei due fa la parte difficile.
- Entrambi richiedono come input le etichette degli attributi protetti, che spesso le organizzazioni non possono raccogliere.
- Entrambi presuppongono che l'utente sappia quale metrica di equità ottimizzare, il che richiede di orientarsi tra i teoremi di impossibilità per il dominio specifico.
- Nessuno dei due costruisce il grafo causale che separa la discriminazione per proxy dai fattori di rischio legittimi.
- Nessuno dei due gestisce l'analisi intersezionale in cui i test statistici standard perdono potenza.
Le piattaforme di governance come Holistic AI e Credo AI forniscono tracciamento della conformità, inventario dei modelli e scoring del rischio. Ti dicono quali modelli necessitano di audit e se i risultati degli audit sono aggiornati. Non eseguono la metodologia di audit vera e propria: l'analisi causale, i test intersezionali, la selezione della mitigazione, la documentazione del compromesso tra accuratezza ed equità. I nostri incarichi si integrano con qualsiasi piattaforma o toolkit il cliente già utilizzi. Il livello metodologico è ciò che apportiamo noi.
Punti chiave
- La regola dei quattro quinti (29 CFR 1607) è una soglia di screening di epoca 1978 che manca la discriminazione per proxy e quella intersezionale.
- Chouldechova (2017) e Kleinberg, Mullainathan & Raghavan dimostrano che nessun classificatore soddisfa tutti i criteri di equità contemporaneamente, quindi ogni audit è una scelta esplicita di prioritizzazione.
- L'analisi dei grafi causali mappa come attributi rimossi quali razza ed età rientrino attraverso proxy come il codice postale e l'anno di laurea.
- I metodi gerarchici bayesiani e di test sequenziale fanno emergere le disparità intersezionali che le metriche su un singolo asse e quelle aggregate nascondono.
- Le normative differiscono per dominio — LL144 di New York, HB 3773 dell'Illinois, ECOA, SB 21-169 del Colorado — quindi la fase di mitigazione e il monitoraggio devono essere scelti per ciascun sistema.
- I toolkit (AIF360, Fairlearn) e le piattaforme di governance (Holistic AI, Credo AI) sono punti di partenza; la metodologia causale, intersezionale e sui compromessi è il lavoro personalizzato.
Audit sull'equità e mitigazione dei bias dell'IA
 Guarda
AI Etica per la Retention degli Abbonamenti | Veriprajna
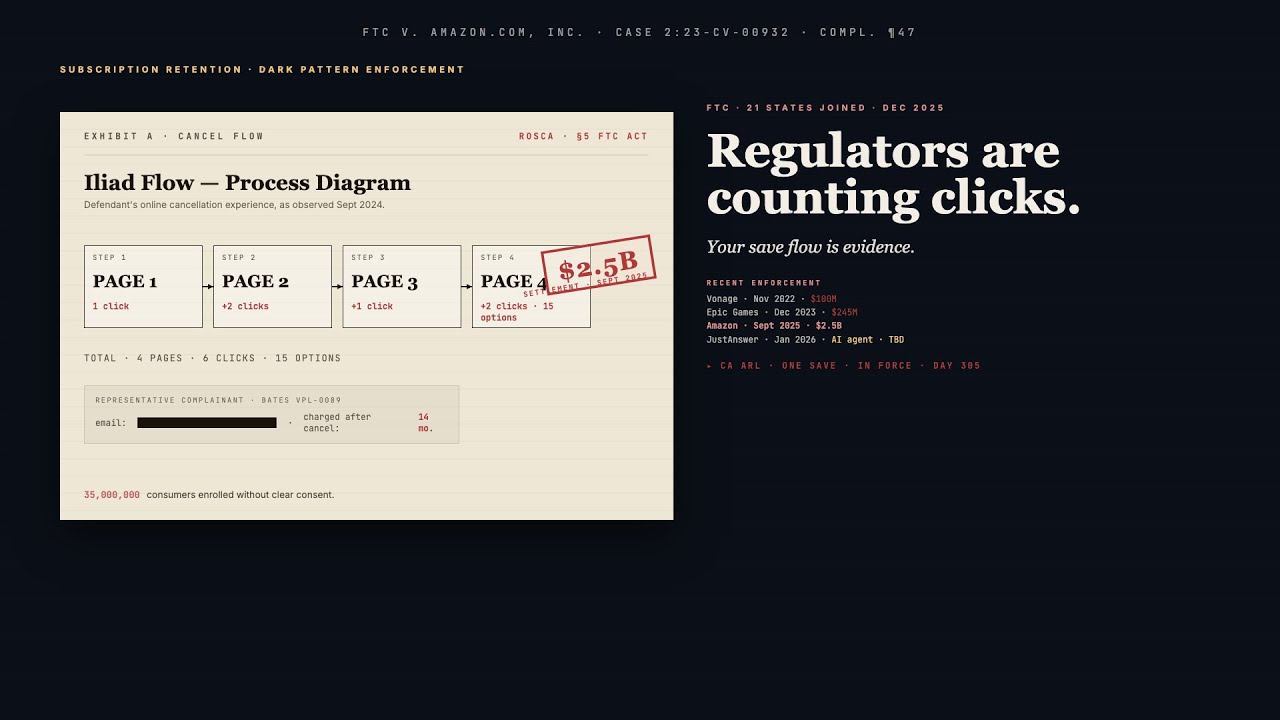
Amazon ha pagato 2,5 miliardi di dollari per un flusso di cancellazione che richiedeva 6 clic. Uber è sotto indagine da parte di 21 procuratori generali statali per i 23 schermate necessarie alla cancellazione.
Domande Frequenti
Quanto costa un audit sui bias dell'IA e quanto tempo richiede?
L'ambito determina il costo più di qualsiasi altro fattore. Un audit mirato conforme alla LL144 di un singolo strumento di assunzione con l'analisi standard della regola dei quattro quinti può essere completato in due settimane. Questa è la casella da spuntare. Un audit completo con analisi causale dei proxy, test sui sottogruppi intersezionali, valutazione dell'equità controfattuale e raccomandazioni di mitigazione documentate richiede dalle 6 alle 10 settimane a seconda della complessità del sistema, della disponibilità dei dati e di quanti quadri normativi si applicano. La domanda sul costo che la maggior parte degli acquirenti dovrebbe porsi è in realtà quanto costa la non conformità. Le sanzioni della LL144 di New York vanno da 500 a 1.500 dollari per violazione al giorno. Il Colorado SB 205 consente fino a 20.000 dollari per violazione. Il Massachusetts ha appena transatto un caso di discriminazione nei prestiti basata sull'IA per 2,5 milioni di dollari. L'investimento nell'audit è una frazione di una singola azione esecutiva.
Quale metrica di equità dovremmo usare se non possiamo soddisfarle tutte simultaneamente?
Non è possibile soddisfarle tutte. Chouldechova (2017) ha dimostrato che, quando i tassi di base differiscono tra i gruppi, nessun classificatore imperfetto può raggiungere simultaneamente la calibrazione e tassi uguali di falsi positivi e falsi negativi. Kleinberg, Mullainathan e Raghavan hanno dimostrato un'impossibilità più ampia. La scelta della metrica dipende dal dominio e dal quadro giuridico. Nei prestiti, la calibrazione è importante perché i punteggi di rischio devono riflettere le probabilità effettive di insolvenza affinché la determinazione dei prezzi funzioni. Gli equalized odds sono importanti perché tassi di errore disparati creano una responsabilità per impatto disparato ai sensi dell'ECOA. Nelle assunzioni, la parità dei tassi di selezione (parità demografica) è il punto di partenza perché la regola dei quattro quinti la rende operativa, ma gli equalized odds e la parità predittiva sono importanti per la validazione dei test ai sensi delle Uniform Guidelines. Illustriamo i compromessi di impossibilità per il sistema specifico e il contesto normativo di ciascun cliente prima che chiunque inizi a ottimizzare.
Abbiamo rimosso la razza dal nostro modello. Perché mostra ancora un impatto disparato?
Perché altre feature veicolano le stesse informazioni. Il codice postale codifica la segregazione residenziale. L'anno di laurea e l'anzianità dello stack tecnologico ricostruiscono l'età. Le interruzioni lavorative sono correlate alla disabilità e all'assistenza familiare. L'istituto di istruzione è correlato alla razza e allo status socioeconomico. La distanza del tragitto casa-lavoro è correlata alla composizione del quartiere. Rimuovere l'etichetta non rimuove il segnale. Utilizziamo l'analisi dei grafi causali per tracciare ogni percorso dagli attributi protetti attraverso lo spazio delle feature fino all'output del modello. Alcuni di questi percorsi passano attraverso fattori aziendali legittimi (la storia creditizia predice genuinamente il rimborso). Altri passano attraverso proxy che codificano la discriminazione storica. L'audit identifica quali percorsi sono quali, e la mitigazione mira ai percorsi proxy senza compromettere quelli legittimi.
Possiamo essere citati in giudizio per discriminazione dell'IA quando utilizziamo lo strumento di assunzione di un fornitore?
Sì. I datori di lavoro restano responsabili degli esiti discriminatori degli strumenti di IA dei fornitori ai sensi del Title VII, dell'FCRA e delle leggi statali sul lavoro. In Mobley v. Workday (maggio 2025), il tribunale ha stabilito che un fornitore di IA può essere direttamente responsabile di discriminazione occupazionale in quanto agente del datore di lavoro. Nella class action Eightfold AI (gennaio 2026), sia la piattaforma sia i datori di lavoro che la utilizzano sono esposti. Il Colorado SB 205 impone obblighi separati ai deployer indipendentemente da chi ha costruito il sistema. Utilizzare lo strumento di un fornitore non sposta il rischio legale. Sposta la complessità tecnica, perché è necessario auditare un sistema che non hai costruito. Auditiamo gli strumenti di IA dei fornitori utilizzando metodi di test basati sull'output che non richiedono l'accesso al codice sorgente o agli interni del modello del fornitore.
Qual è la differenza tra un audit di conformità LL144 e un audit completo sull'equità?
La LL144 richiede un audit indipendente sui bias che esamini i tassi di selezione per categorie di razza/etnia e sesso/genere, con risultati pubblicati pubblicamente. È un pavimento, non un soffitto. L'audit del Comptroller dello Stato di New York del dicembre 2025 ha rilevato che l'applicazione da parte del DCWP era superficiale: il 75% dei reclami era stato instradato in modo errato, e gli auditor hanno individuato 17 potenziali violazioni laddove il DCWP ne aveva trovata solo 1. Un audit completo va oltre: analisi intersezionale tra attributi protetti combinati, rilevamento causale dei proxy per feature che codificano indirettamente informazioni protette, test di equità controfattuale, analisi di sensibilità che quantifica quanto le affermazioni sull'equità siano robuste rispetto a variabili confondenti non misurate, e analisi documentata del compromesso tra accuratezza ed equità con le implicazioni del teorema di impossibilità esplicitate. La versione completa è ciò che regge all'esame quando l'applicazione diventa seria.
Come testiamo i bias quando non abbiamo accesso ai dati sugli attributi protetti?
Questo è uno dei problemi pratici più ardui nell'audit sull'equità. Tutti i principali toolkit (AIF360, Fairlearn) richiedono gli attributi protetti come input. In pratica, molte organizzazioni non possono raccogliere dati a livello individuale su razza, genere o disabilità, in particolare al di fuori dei contesti occupazionali. Le opzioni includono il Bayesian Improved Surname Geocoding (BISG) per inferire la razza da nome e geografia (utilizzato dal CFPB per l'analisi dell'equità nei prestiti), i metodi di inferenza ecologica che stimano le disparità a livello di gruppo a partire da dati aggregati, e il test di perturbazione dell'output in cui si costruiscono input controfattuali variando solo i proxy degli attributi protetti e si misurano i cambiamenti nelle decisioni. Ogni metodo ha dei limiti. Il BISG introduce un proprio bias per gli individui multirazziali e per certi gruppi etnici. Selezioniamo e validiamo il metodo proxy rispetto alla popolazione specifica e al contesto normativo, documentando l'incertezza introdotta dall'imputazione anziché trattare gli attributi stimati come dati di riferimento.
Abbiamo bisogno di un monitoraggio continuo dei bias, o un audit annuale è sufficiente?
Un audit annuale è ciò che le autorità di regolamentazione richiedono come minimo. Non è ciò che ti tiene al sicuro. I modelli che interagiscono con cicli di feedback sviluppano bias tra un audit e l'altro: uno strumento di assunzione che respinge candidati provenienti da certi contesti si addestra sulle proprie esclusioni, rafforzando lo schema. I modelli di prestito in cui i modelli di approvazione influenzano i dati delle agenzie di credito creano profezie che si autoavverano. Le distribuzioni degli input cambiano man mano che la demografia dei clienti o i bacini di candidati mutano. Costruiamo un monitoraggio continuo con test di ipotesi sequenziali che rileva il degrado emergente dell'equità in tempo reale, attivando avvisi quando le metriche superano le soglie. Il monitoraggio traccia separatamente le prestazioni aggregate e quelle dei sottogruppi intersezionali. La differenza pratica: un audit annuale ti dice che il modello è stato distorto per mesi. Il monitoraggio continuo te lo dice nel giro di settimane.
Come auditiamo gli LLM e l'IA generativa per i bias quando le metriche di equità tradizionali non si applicano?
Le metriche di equità tradizionali (equalized odds, parità demografica) sono state progettate per classificatori binari con gruppi protetti definiti ed esiti misurabili. L'IA generativa produce testo, immagini o raccomandazioni a risposta aperta in cui il bias si manifesta come associazioni stereotipate, qualità differenziata o schemi di rifiuto attraverso contesti demografici. Valutiamo il bias degli LLM attraverso il probing basato su scenari (variando sistematicamente i segnali demografici nei prompt e misurando le differenze negli output), le suite di benchmark (BBQ, StereoSet, CrowS-Pairs) adattate al contesto di distribuzione specifico, e l'audit degli output in cui gli output di produzione vengono campionati e valutati per rilevare schemi di trattamento disparato. La sfida è che gli LLM mostrano errori allineati agli stereotipi fino al 77% delle volte in contesti ambigui (ricerca sul benchmark BBQ), e questi bias sono più difficili da mitigare rispetto al bias dei classificatori perché sono distribuiti su miliardi di parametri anziché concentrati in poche feature.
Quali sono le sanzioni effettive per il fallimento di un audit sui bias o per non averne condotto uno?
Le sanzioni stanno aumentando rapidamente in tutte le giurisdizioni. LL144 di New York: da 500 a 1.500 dollari per violazione al giorno, moltiplicati per ciascun candidato interessato. Colorado SB 205 (in vigore da giugno 2026): fino a 20.000 dollari per violazione ai sensi del Consumer Protection Act. EU AI Act (applicazione da agosto 2026): fino a 35 milioni di euro o il 7% del fatturato globale per le pratiche vietate, 15 milioni di euro o il 3% per la non conformità ad alto rischio. Oltre alle sanzioni previste dalla legge, l'esposizione al contenzioso è concreta: il procuratore generale del Massachusetts ha ottenuto 2,5 milioni di dollari da una singola transazione per discriminazione nei prestiti basata sull'IA nel luglio 2025. SafeRent ha pagato 2,275 milioni di dollari per la discriminazione di un algoritmo di screening abitativo. Mobley v. Workday è la prima class action collettiva a livello nazionale certificata sui bias dell'IA. Il costo di un audit completo è un errore di arrotondamento rispetto a uno qualsiasi di questi esiti.
Quali requisiti normativi si applicano ai bias dell'IA nel sottoscrizione assicurativo?
Il Colorado SB 21-169 è il più prescrittivo. Vieta agli assicuratori di utilizzare dati esterni dei consumatori, algoritmi e modelli predittivi in modi che producano esiti ingiustamente discriminatori basati su caratteristiche protette. Gli assicuratori auto e sanitari devono presentare relazioni annuali sulla conformità entro il 1° luglio 2026. La Divisione Assicurazioni del Colorado ha proposto test quantitativi che confrontano i modelli con e senza variabili razziali stimate per identificare le feature discriminatorie. Separatamente, 24 stati hanno adottato il NAIC Model Bulletin che richiede agli assicuratori di includere trasparenza ed equità nei loro programmi di governance dell'IA. La questione dell'equità attuariale è distinta da quella dell'equità statistica: la differenziazione del rischio giustificata dal punto di vista attuariale può produrre disparità statistiche legalmente ammissibili ai sensi del diritto assicurativo ma che sarebbero discriminatorie ai sensi del diritto del lavoro o dei prestiti. Aiutiamo i team assicurativi a orientarsi in questa distinzione con framework di test costruiti per il contesto normativo specifico del settore assicurativo.
Costruisci la tua IA con fiducia.
Collabora con un team che vanta una profonda esperienza nella creazione della prossima generazione di IA aziendale. Lascia che ti aiutiamo a progettare, sviluppare e implementare una strategia di IA di cui ti puoi fidare.
Veriprajna società di consulenza Deep Tech è specializzata nella creazione di sistemi di IA safety-critical per i settori sanitario, finanziario e regolamentato. Le nostre architetture sono validate rispetto a protocolli consolidati con una documentazione di conformità completa.