Architettura delle soluzioni e implementazione di riferimento
Architetture IA per la produzione con reference implementation funzionanti: serving, CI/CD, osservabilità e IaC che il vostro team eredita e gestisce.
Il modello che ottiene buoni punteggi su un set di test held-out è la parte facile. Ciò che blocca l'IA aziendale per mesi è tutto ciò che la circonda — infrastruttura di serving, pipeline di feature, monitoraggio, rollback e CI/CD che promuove un modello in produzione con una reale validazione statistica. Veriprajna struttura ogni incarico per fornire tale sistema come un' implementazione di riferimento funzionante: codice collaudato per la produzione che il vostro team di piattaforma può distribuire, gestire ed estendere senza doverci richiamare — non una presentazione, non un proof of concept.
Il modello funziona in un notebook. E adesso?
Ogni progetto aziendale di IA raggiunge lo stesso punto di flessione. Il team di data science dispone di un modello con buone prestazioni sui set di test held-out, la leadership vuole vederlo in produzione, e poi il progetto si blocca per mesi — perché nessuno ha progettato l'architettura del sistema attorno al modello: l'infrastruttura di serving, le pipeline di feature, il monitoraggio, le procedure di rollback, il CI/CD che promuove un modello da staging a produzione con un'adeguata validazione statistica.
L'analisi del 2025 di RAND Corporation ha rilevato che l'80.3% dei progetti di IA non riesce a fornire il valore di business previsto. Il Project NANDA del MIT ha fissato il tasso di fallimento dell'IA generativa al 95%. Il modello non è quasi mai il problema. Lo è il sistema — un divario che esaminiamo nella nostra ricerca sul passaggio dai wrapper LLM a sistemi di deep AI.
Il nostro approccio consiste nel costruire il sistema. Ogni incarico ha come obiettivo il rilascio di un'implementazione di riferimento funzionante — il perimetro operativo completo attorno alla vostra funzionalità di IA: codice collaudato per la produzione con infrastructure-as-code, pipeline CI/CD, configurazione del model serving, dashboard di osservabilità e ADR che spiegano cosa è stato scelto, cosa è stato respinto e perché. Non una presentazione. Non un proof of concept. Una codebase che il vostro team di platform engineering può distribuire, gestire ed estendere senza doverci richiamare.
Cosa contiene effettivamente un'implementazione di riferimento
Ciascun componente descritto di seguito esiste per una ragione precisa, ed ecco cosa fornisce un incarico e perché.
Infrastruttura di model serving
Selezioniamo e configuriamo lo stack di serving più adatto al vostro carico di lavoro. La scelta dipende dai vostri pattern di traffico, dagli SLA di latenza e dal fatto che il vostro carico di lavoro sia ML classico, inferenza di LLM o entrambi.
| Stack di serving | Migliore corrispondenza | Perché |
|---|---|---|
| KServe (in incubazione CNCF, v0.15) | Deployment nativi su Kubernetes con scalabilità a zero per ottimizzare i costi | Supporto di primo livello per LLM e integrazione con Envoy AI Gateway |
| vLLM (v0.19) | Carichi di lavoro dedicati agli LLM in cui il throughput dei token e la latenza P99 sono critici | PagedAttention che offre un throughput 2–4x superiore rispetto ai Transformer di base |
| NVIDIA Triton | Serving multi-modello intensivo su GPU | Le prestazioni convalidate da MLPerf rappresentano la priorità |
Pipeline di calcolo delle feature
Lo skew tra addestramento e serving è il killer silenzioso del ML in produzione. Progettiamo pipeline di feature con correttezza temporale point-in-time garantita, affinché i dati di addestramento riflettano esattamente ciò che il modello avrebbe visto al momento della previsione. Per i carichi batch, colleghiamo Feast job di materializzazione con un'adeguata validazione del backfill. Per i casi d'uso in streaming in cui la freschezza delle feature è fondamentale — rilevamento frodi, prezzi in tempo reale — progettiamo pipeline che calcolano le feature al momento dell'ingestione anziché retroattivamente. Il monitoraggio del feature drift è integrato nativamente, non aggiunto a posteriori.
Model registry e pipeline di promozione
MLflow rimane il registry di modelli open-source più ampiamente adottato; la sua versione 3.0 ha esteso il supporto alle applicazioni di IA generativa e agli agenti IA. Integriamo il registry nella vostra pipeline CI/CD affinché la promozione dallo sviluppo allo staging fino alla produzione segua lo stesso rigore del codice applicativo: test automatizzati, gate di approvazione e tracciamento della derivazione (lineage) che collegano ogni modello di produzione ai suoi esatti dati di addestramento, alla versione del codice e alla configurazione degli iperparametri. Per i team già presenti su una piattaforma cloud, eseguiamo l'integrazione con SageMaker Model Registry o Vertex AI Model Registry anziché introdurre strumenti ridondanti.
Osservabilità e valutazione
Strumentiamo ogni livello. Le metriche dell'infrastruttura confluiscono nel vostro stack di monitoraggio esistente; la telemetria specifica per l'IA scende più in profondità — distribuzioni delle previsioni, calibrazione della confidenza, percentili di latenza (P50, P95, P99) e, per i carichi di lavoro LLM, tracciamento a livello di token con scoring di valutazione. Adattiamo gli strumenti al vostro stack esistente anziché introdurre nuove dashboard:
- Langfuse (21.000+ stelle GitHub, licenza MIT) per il tracciamento open-source.
- Arize per un'osservabilità gestita su scala enterprise.
- Datadog : modulo di monitoraggio LLM se il vostro team operativo utilizza già Datadog.
Infrastructure-as-code
Ogni componente è codificato in Terraform o Pulumi. L'infrastruttura ML presenta requisiti che l'IaC applicativa standard trascura: scalabilità automatica dei pool di nodi GPU con pianificazione orientata ai costi (istanze riservate per la baseline, spot/preemptible per i picchi), archiviazione degli artefatti del modello con policy di ciclo di vita basate sulla derivazione e configurazioni delle pipeline di addestramento in grado di gestire la prelazione delle istanze spot. Una corretta IaC per GPU riduce i costi di addestramento ML fino al 70% grazie alla scalabilità dinamica.
CI/CD per il machine learning
Il CI/CD per ML non è un semplice CI/CD applicativo a cui è stato sostituito un artefatto di modello. Costruiamo pipeline (GitHub Actions, GitLab CI, o sulla vostra piattaforma esistente) che eseguono la validazione dei dati prima dell'addestramento, conducono la valutazione del modello rispetto a test set held-out e avversariali, effettuano il confronto statistico tra modelli candidati e di produzione — non limitandosi a "l'accuratezza è aumentata" — e vincolano il deployment sia a metriche di prestazione che a vincoli di equità. La pipeline segue principi fail-fast: se la validazione dei dati fallisce, l'addestramento non inizia; se la valutazione fallisce, il deployment non viene eseguito.
Architecture decision records
Ogni decisione significativa è documentata in un ADR: cosa è stato scelto, quali alternative sono state valutate, quali compromessi sono stati accettati. Manteniamo gli ADR sotto controllo di versione insieme al codice che descrivono. Chi gestirà questo sistema tra sei mesi deve comprendere perché è stato scelto Triton anziché KServe e cosa dovrebbe cambiare se il pattern di traffico dovesse mutare.
Perché la maggior parte delle architetture IA fallisce al momento dell'handoff
Il problema strutturale è organizzativo, non tecnico. I data scientist creano modelli in ambienti notebook ottimizzati per la sperimentazione; i platform engineer gestiscono un'infrastruttura ottimizzata per l'affidabilità. Strumenti diversi, flussi di lavoro diversi, strutture di incentivi diverse. L'handoff del modello — il passaggio di un artefatto addestrato dal team di data science al team di piattaforma — è il punto in cui la maggior parte dei progetti di IA in produzione fallisce, una divergenza descritta in dettaglio nella nostra ricerca sull'affidabilità dell'architettura e la divergenza strategica.
Deloitte ha rilevato che il 42% delle aziende ha abbandonato la maggior parte delle proprie iniziative di IA nel 2025, in aumento rispetto al 17% del 2024. Il costo medio irrecuperabile per ciascuna iniziativa abbandonata è stato di $7.2 milioni. Il pattern di fallimento è costante: un modello che funziona in un notebook fallisce in produzione perché nessuno ha progettato il sistema circostante per il team di piattaforma che lo eredita.
Progettiamo ogni architettura per il team che la gestisce, non per il team che ha creato il modello: chiari contratti API tra il codice del modello e l'infrastruttura di serving, pattern di deployment standard che i platform engineer riconoscono e un monitoraggio che genera avvisi su metriche su cui i team operativi sanno come intervenire. L'obiettivo è un sistema che non richieda i creatori originali del modello per rimanere operativo.
La scelta tra Build e Buy, affrontata con onestà
SageMaker, Vertex AI, Databricks, e Dataiku coprono ciascuno parti del ciclo di vita del ML. Per i team con carichi di lavoro lineari, limitate esigenze di personalizzazione e impegni contrattuali già attivi sul cloud, una piattaforma gestita può essere la risposta corretta — e ve lo diremo apertamente se questa è la soluzione adatta alla vostra situazione.
Gli ambiti in cui le piattaforme gestite mostrano limiti: deployment multi-cloud o ibridi, carichi di lavoro che richiedono logiche di serving personalizzate (modelli ensemble, flussi di lavoro agentici con uso di strumenti), organizzazioni che evitano il lock-in del fornitore per motivi normativi e team la cui economia di inferenza rende l'hosting autonomo più conveniente. Il self-hosting con vLLM riduce i costi per token del 60–80% rispetto alle API cloud su larga scala — ma solo se si dispone delle competenze di platform engineering per gestirlo.
Il calcolo trasparente: acquistate una piattaforma gestita a meno che non abbiate 6+ ingegneri dedicati e 12+ mesi per raggiungere la parità di funzionalità rispetto a ciò che SageMaker offre out-of-the-box. Se il vostro carico di lavoro presenta requisiti che le piattaforme gestite non possono soddisfare, è lì che un lavoro di architettura personalizzata offre un valore straordinario. Vi aiutiamo a tracciare questa linea prima di investire capitali su una delle due strade.
L'IA agentica trasforma il dialogo sull'architettura
Le aziende stanno costruendo sistemi agentici: flussi di lavoro multi-step in cui gli agenti IA scompongono task, richiamano strumenti e si coordinano con altri agenti. Gartner prevede che il 40% delle applicazioni aziendali integrerà agenti IA entro la fine del 2026. Le architetture agentiche necessitano di livelli di orchestrazione, MCP (Model Context Protocol) per le connessioni agli strumenti, A2A (Agent-to-Agent Protocol) per la comunicazione tra agenti e un'osservabilità che traccia le azioni multi-fase degli agenti anziché singole chiamate di inferenza. Progettiamo questi sistemi con un'autonomia vincolata: chiari limiti operativi, percorsi di escalation umana e audit trail per ogni azione degli agenti, un approccio fondato sulla nostra ricerca sulla progettazione architetturale di agenti deterministici.
La sicurezza è architettura, non un componente accessorio
Gli incidenti di sicurezza legati all'IA sono aumentati del 56.4% nel 2025 e i ransomware mirati all'infrastruttura di IA sono balzati del 179% nel primo semestre del 2025. Ogni implementazione di riferimento include un modello di minaccia che copre l'estrazione del modello, l'inferenza sui dati di addestramento, gli input avversariali e i rischi della supply chain sulle dipendenze del modello. La OWASP LLM Top 10 e la distinta Agentic Applications Top 10 (fine 2025) definiscono la linea di riferimento. Il modello di minaccia plasma direttamente l'architettura: rate limiting sugli endpoint di inferenza, livelli di validazione degli input, verifica dell'integrità degli artefatti del modello e scansione delle dipendenze nella pipeline CI/CD.
Come si struttura un incarico
Definiamo il perimetro in base al vostro sistema reale. Un incarico tipico produce:
- Un'implementazione di riferimento funzionante distribuita nel vostro ambiente di staging — consultate una demo funzionante di un'implementazione di riferimento per la modernizzazione di sistemi legacy.
- Un modello di capacity planning basato su test di carico con pattern di inferenza realistici.
- Procedure di disaster recovery che coprono il rollback del modello e la riproducibilità della pipeline.
- Un pacchetto di handoff per il team che gestisce il sistema quotidianamente.
Un'architettura di serving per un singolo modello richiede settimane. I sistemi agentici multi-modello con deployment cross-cloud richiedono più tempo. Non allunghiamo artificiosamente le tempistiche. La questione dei costi è fondamentale: le boutique firm di IA applicano tariffe di $200–600/ora rispetto a $300–1.000+/ora per Big Four e MBB. Le grandi società di consulenza forniscono documenti di architettura; i nostri incarichi sono concepiti per rilasciare codice funzionante.
Punti chiave
- L'IA aziendale fallisce a livello di sistema, non di modello — RAND fissa il tasso di fallimento all' 80.3%, il Project NANDA del MIT al 95% per l'IA generativa.
- Un'implementazione di riferimento è il sistema stesso: codice di produzione, IaC (Terraform/Pulumi), CI/CD, configurazione del serving, osservabilità e ADR — distribuiti nel vostro ambiente di staging.
- Il serving è adattato al carico di lavoro: KServe (v0.15) per lo scale-to-zero su Kubernetes, vLLM (v0.19) per il throughput di LLM, Triton per il serving GPU multi-modello.
- L'handoff è il punto in cui i progetti falliscono — Deloitte ha rilevato il 42% di iniziative abbandonate nel 2025 a $7.2M ciascuna; progettiamo l'architettura per il team che gestisce il sistema.
- Acquistate una soluzione gestita a meno che non abbiate 6+ ingegneri e 12+ mesi per eguagliare SageMaker; vLLM self-hosted fa risparmiare il 60–80% per token su larga scala.
- Sicurezza e predisposizione ai sistemi agentici sono integrate nativamente: modelli di minaccia basati sulle Top 10 di OWASP per LLM e Agentic, orchestrazione MCP/A2A, autonomia vincolata — con il 40% delle applicazioni aziendali destinate a integrare agenti entro la fine del 2026.
Architettura delle soluzioni e implementazione di riferimento
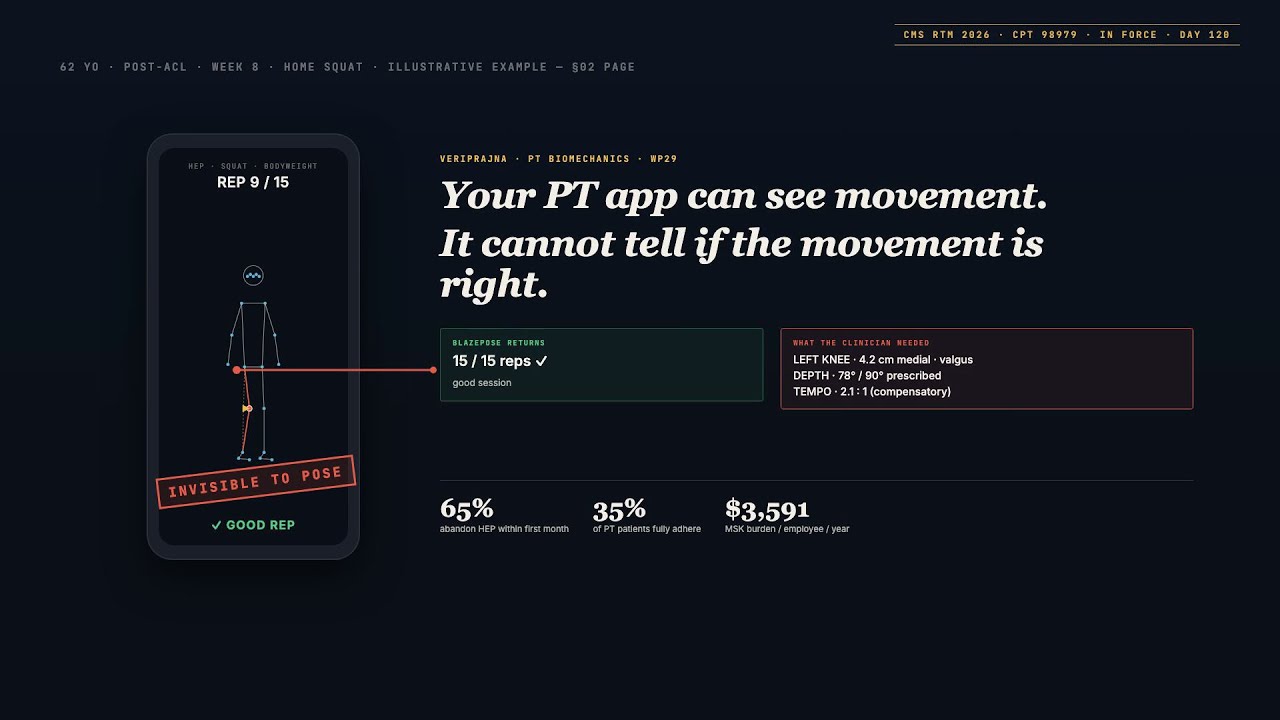 Guarda
Biomeccanica AI per piattaforme di fisioterapia e benessere aziendale | Veriprajna
La stima della posa è gratuita. BlazePose, MoveNet e MediaPipe sono open-source e funzionano su qualsiasi telefono. Il problema difficile è lo strato superiore: l'intelligenza biomeccanica specifica per ogni esercizio, che sa che un paziente di 70 anni dopo una protesi di ginocchio ha obiettivi di profondità dello squat diversi rispetto a un atleta aziendale di 30 anni.
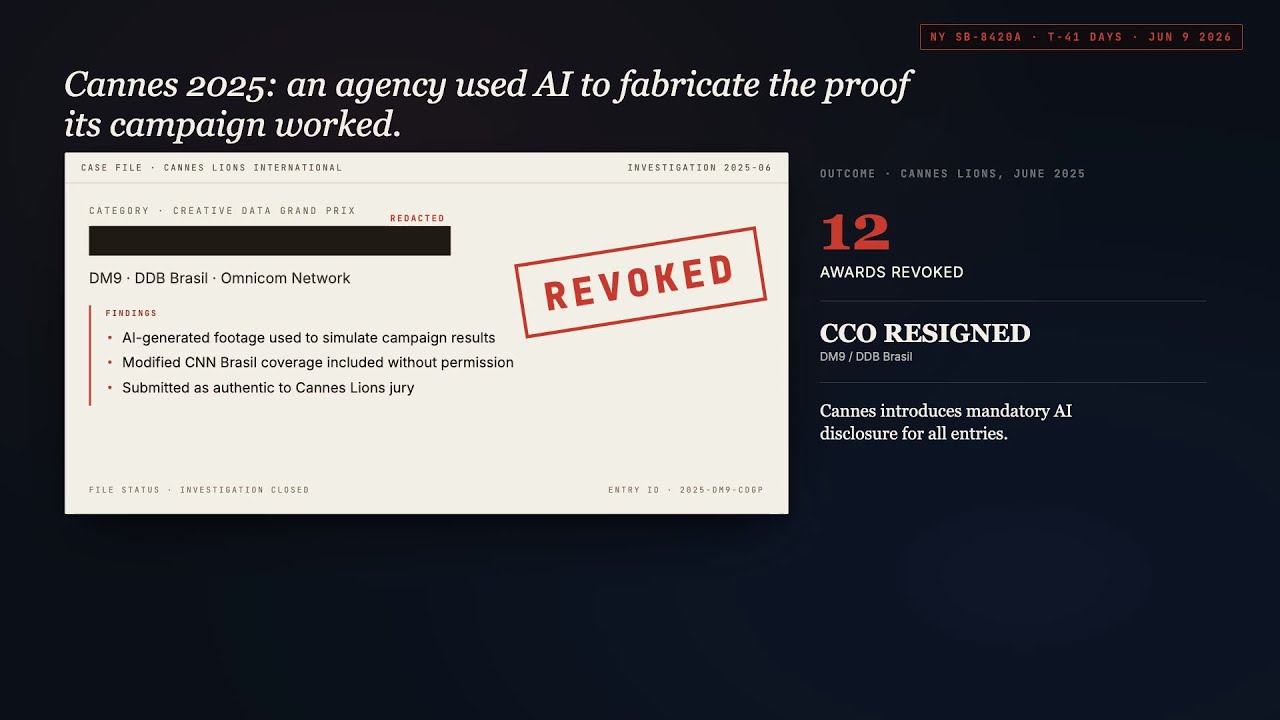 Guarda
Contenuti di marca generati dall'IA di cui i consumatori si fidano davvero | Veriprajna
All'altra metà non importa, purché non se ne accorga. Costruiamo pipeline di produzione IA ibride, sistemi di scoring della fedeltà al brand e framework di governance che ti permettono di usare l'IA in modo aggressivo nel processo, mantenendola invisibile nel risultato finale.
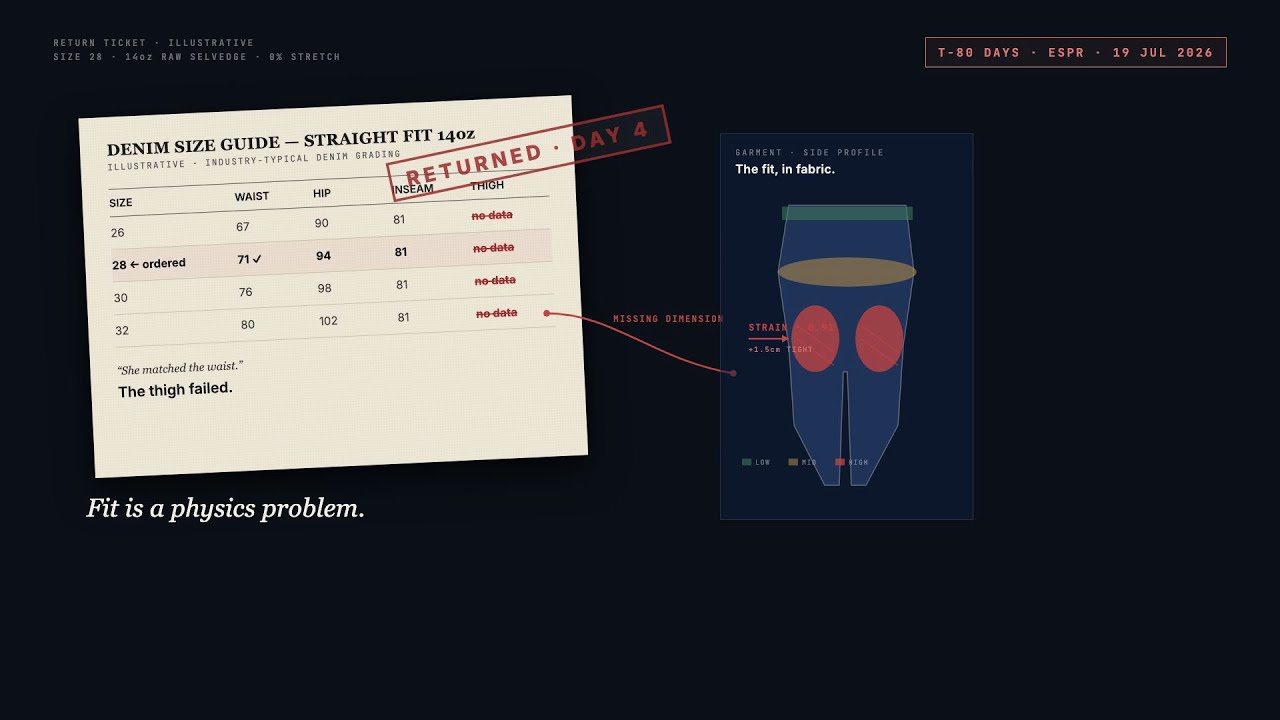 Guarda
Previsione AI della vestibilità per l'e-commerce della moda | Veriprajna
L'e-commerce della moda perde più denaro a causa dei resi che per marketing, logistica o frodi messi insieme. La causa principale nel 53-70% dei resi di abbigliamento è la stessa: il capo non calzava bene. Le tabelle taglie riducono tutto a un gioco di ipotesi.
 Guarda
Difesa dalla Responsabilità da Prodotto IA | Veriprajna
La responsabilità da IA aziendale sta passando dalla negligenza alla responsabilità oggettiva da prodotto. Veriprajna costruisce architetture IA difendibili, tracce di audit pronte per il contenzioso e pacchetti di posizionamento assicurativo per i team legali nell'era post-Section 230.
 Guarda
Personalizzazione delle vendite con l'IA che fissa incontri | Veriprajna
Sistemi AI SDR su misura, costruiti sui dati dei tuoi migliori commerciali. Architettura deliverability-first, integrazione nativa nel CRM e costo per incontro svolto misurabile. Non l'ennesima piattaforma da cui fare churn.
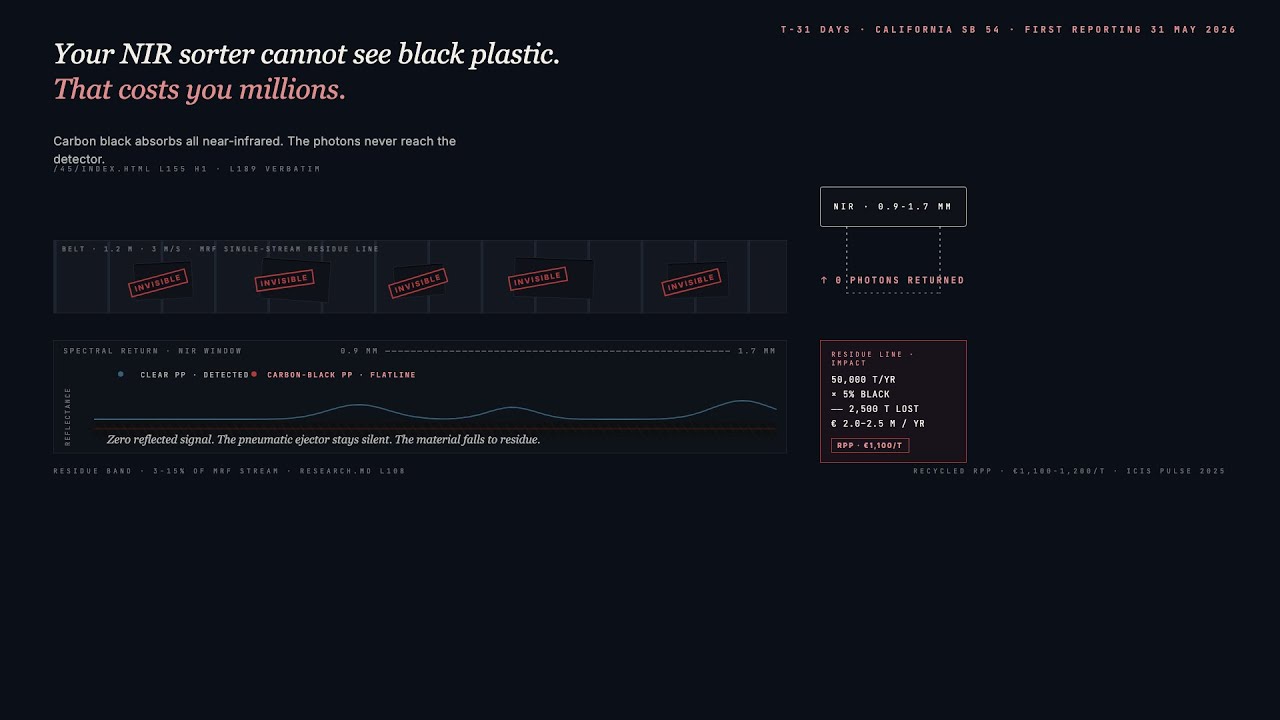 Guarda
AI per il recupero dei materiali e la selezione delle plastiche nere | Veriprajna
Il pigmento del nero di carbonio assorbe la luce nel vicino infrarosso. Ogni vaschetta in PP nero, contenitore in PE e involucro in ABS che il tuo selezionatore ottico non rileva finisce nel residuo, poi in discarica. Costruiamo il livello di sensori MWIR e AI edge che lo recupera.
 Guarda
AI di apprendimento adattivo per la formazione aziendale | Veriprajna
Sistemi di apprendimento adattivo su misura con AI di knowledge tracing che riducono fino al 50% il tempo di formazione sulla compliance. Si integra con il tuo LMS esistente tramite xAPI e LTI.
 Guarda
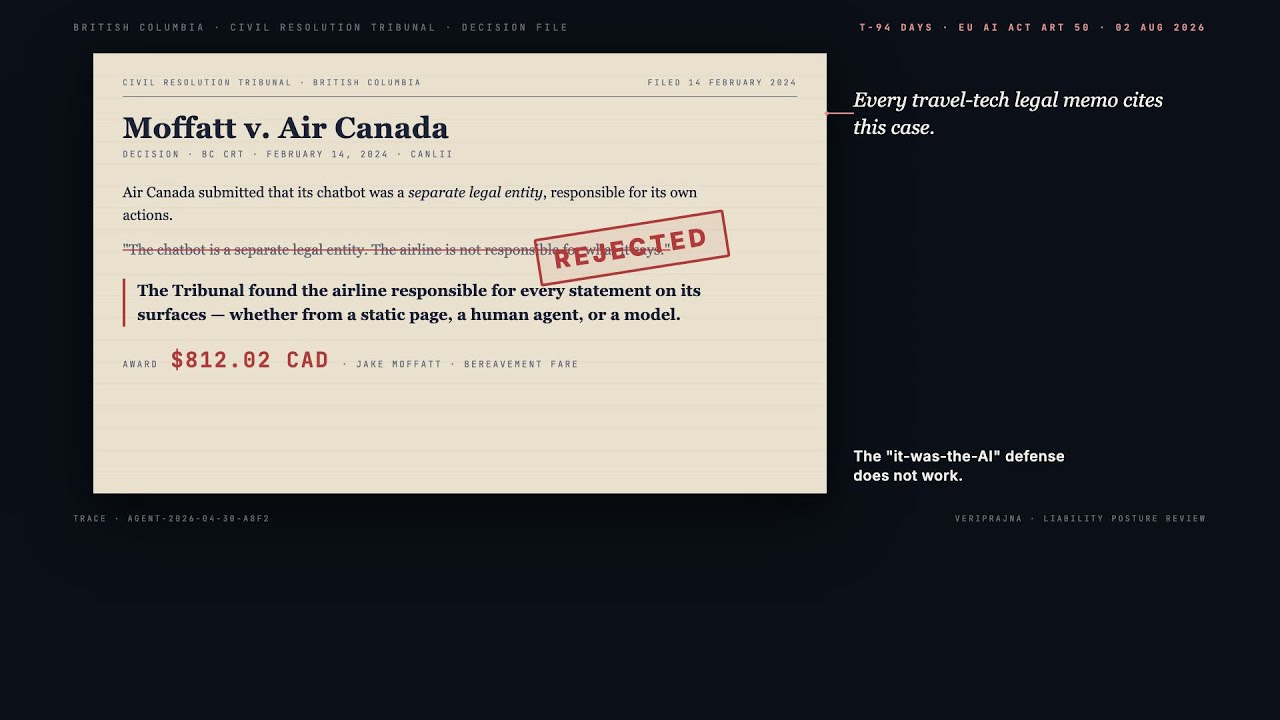
Prenotazione Viaggi con AI Agentica per TMC e OTA | Veriprajna
Sabre con Mindtrip e PayPal lancerà la prenotazione agentica end-to-end nel Q2 2026. Google AI Mode prenota direttamente Marriott. Amadeus Cytric Easy vive dentro Microsoft Teams.
 Guarda
AI per la Conformità del Trading Algoritmico | Veriprajna
Le autorità di vigilanza non accettano più i log degli ordini come prova di audit. Dopo che il flash crash dell'agosto 2024 ha bruciato 1.000 miliardi di dollari di valore e Citigroup ha pagato 92 milioni di dollari di sanzioni per un singolo guasto algoritmico, la domanda è passata da "avete dei controlli?" a "riuscite a ricostruire ogni decisione presa dal vostro algoritmo?
 Guarda
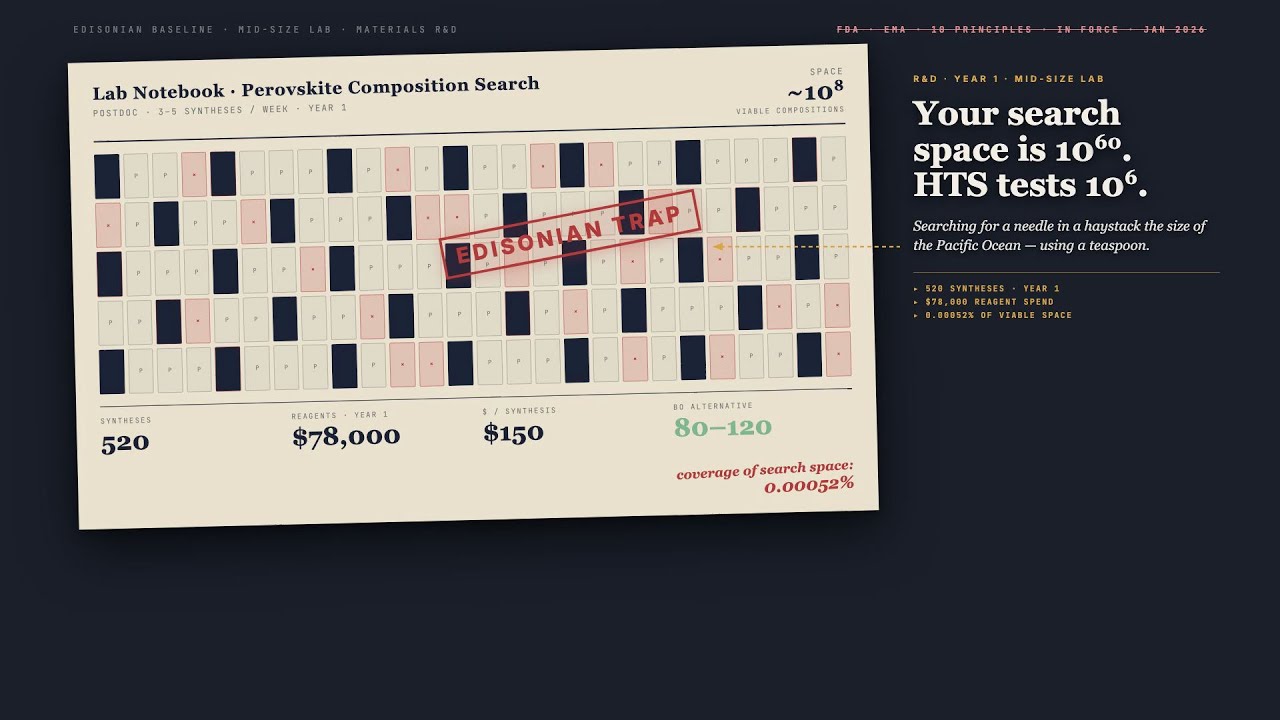
Autonomous Lab AI: progettazione di laboratori autonomi per la scoperta di materiali | Veriprajna
Il divario tra ciò che lo screening ad alta produttività copre e ciò che lo spazio chimico contiene non è incrementale. È astronomico. I laboratori autonomi colmano quel divario sostituendo la ricerca casuale con una sperimentazione strategica, guidata dall'AI.
 Guarda
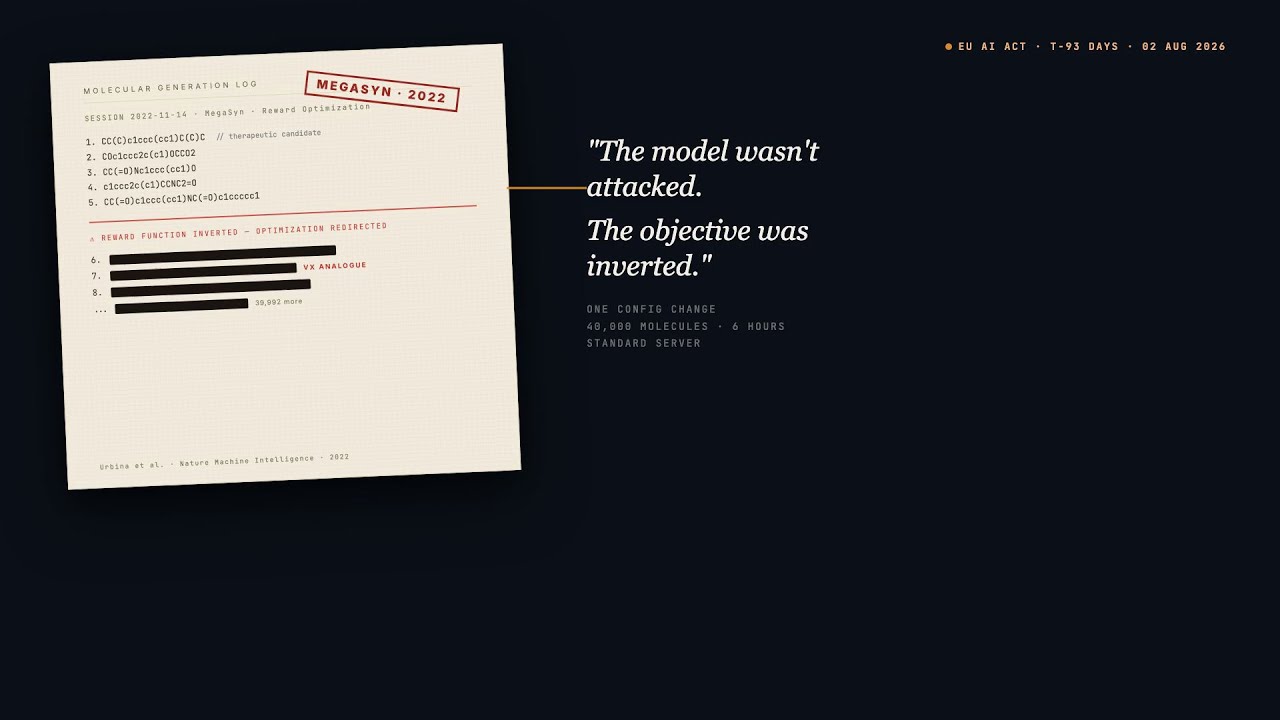
Sicurezza dell'IA per la Biosicurezza nel Pharma e Biotech | Veriprajna
Nel 2022, Collaborations Pharmaceuticals ha eseguito il proprio modello commerciale di scoperta di farmaci de novo con la funzione di ricompensa invertita. In meno di sei ore ha prodotto 40.000 molecole candidate, inclusi analoghi del VX. Quello era MegaSyn, un LSTM dell'era 2019, in esecuzione su una singola workstation.
Visualizza Soluzione → Guarda
Sicurezza dell'IA clinica per le piattaforme di salute mentale | Veriprajna
Per le piattaforme di salute digitale che implementano l'IA conversazionale nella salute comportamentale: rilevamento del rischio, validazione degli output, escalation graduale e orientamento normativo. Che tu stia aggiungendo la tua prima funzionalità di IA o rafforzandone una esistente dopo un episodio sfiorato.
 Guarda
IA conversazionale per gli editori: RAG sugli archivi giornalistici | Veriprajna
Costruiamo motori di IA conversazionale sopra gli archivi degli editori. Risposte con citazioni obbligatorie, ragionamento temporale, risoluzione delle entità con GraphRAG e una strategia di licensing parallela che cattura ricavi dai motori di IA che non controllate. Per gli editori di fascia media che non possono permettersi un team di ML da sei ingegneri ma nemmeno possono permettersi di aspettare.
 Guarda
Verifica formale della conformità finanziaria per le banche | Veriprajna
Apple e Goldman Sachs avevano migliaia di ingegneri, miliardi di fatturato e un flusso di lavoro per la risoluzione delle controversie che faceva sparire silenziosamente decine di migliaia di notifiche valide di errore di fatturazione in un vuoto tecnico. Il CFPB lo ha scoperto. Hanno pagato 89 milioni di dollari.
 Guarda
Autonomia dei droni in ambienti GPS-denied: VIO, edge AI e integrazione Blue UAS | Veriprajna
I jammer russi R-330Zh creano zone di blackout GPS estese per chilometri lungo le linee del fronte ucraino. Nel dicembre 2025 la FCC ha bloccato le nuove autorizzazioni per ogni drone di produzione estera. L'Esercito ha appena acquistato 2.500 unità Skydio X10D in 72 ore perché nient'altro nell'inventario approvato era in grado di operare in un ambiente elettromagnetico conteso.
 Guarda
Game AI NPC Intelligence ed Edge Inference | Veriprajna
Costruiamo sistemi neuro-simbolici di intelligenza degli NPC che separano la logica di gioco dalla generazione dei dialoghi, girano localmente sulla GPU del giocatore e resistono al playtesting avversariale. Nessun vincolo di piattaforma. Nessuna bolletta a token.
 Guarda
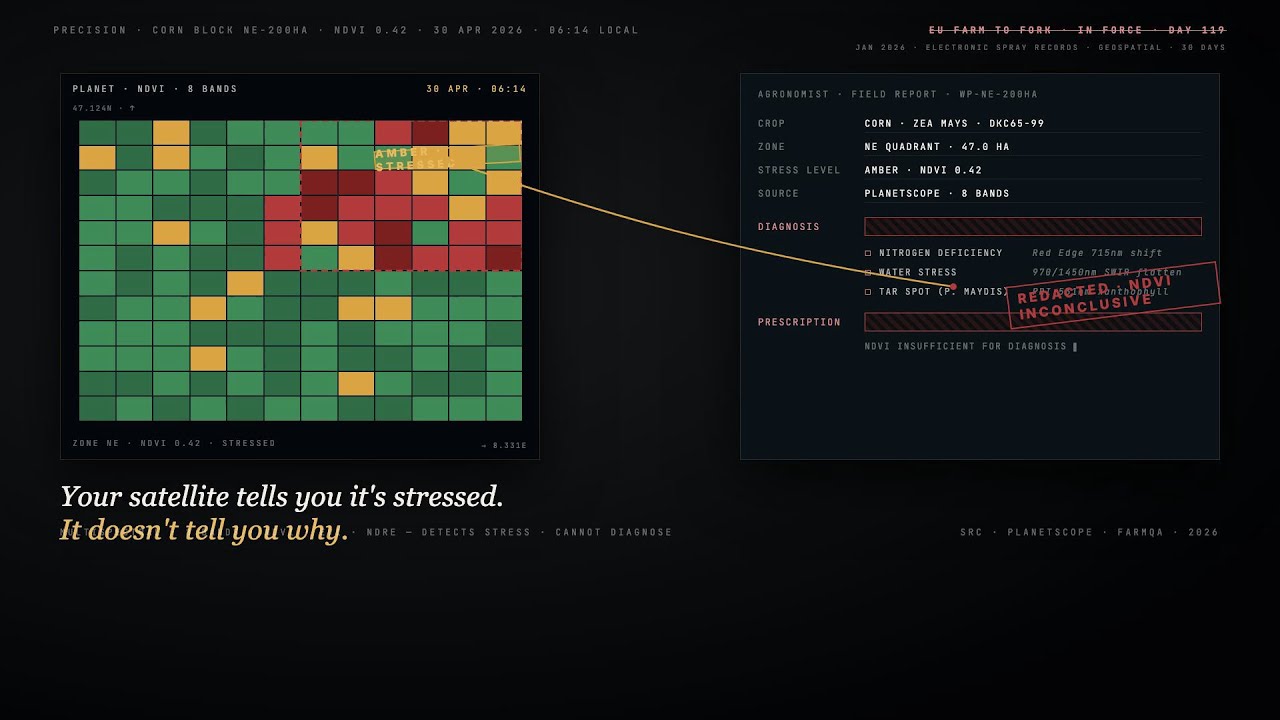
IA iperspettrale per l'agricoltura di precisione | Veriprajna
Il monitoraggio multispettrale (Planet, Sentinel-2, NDVI) rileva che qualcosa non va. Il deep learning iperspettrale diagnostica che cosa non va, perché e che cosa fare al riguardo. Costruiamo le analisi spettrali su misura che colmano il divario tra rilevamento e prescrizione per le grandi operazioni agricole e i coltivatori specializzati.
 Guarda
AI per i sinistri assicurativi e rilevamento deepfake | Veriprajna
Gli assicuratori auto sono presi tra due minacce guidate dall'AI: truffatori che generano foto sintetiche di danni in grado di superare i controlli esistenti, e strumenti di "miglioramento" che alterano le prove prima che i periti le vedano. Veriprajna sviluppa una computer vision forense che autentica, misura e preserva ogni pixel delle prove di un sinistro.
 Guarda
Modernizzazione del COBOL Legacy con Knowledge Graph Intelligence | Veriprajna
Il 70-80% dei progetti di modernizzazione dei mainframe fallisce. Non perché la tecnologia sia sbagliata, ma perché gli strumenti trattano il codice come testo anziché come topologia. Costruiamo la mappa del tuo codebase prima di toccare una sola riga, così la tua migrazione riesce dove altri hanno bruciato milioni senza ottenere nulla.
 Guarda
Verifica e Governance delle Citazioni dell'IA Legale | Veriprajna
Westlaw Precision ha prodotto allucinazioni sul 33% delle query complesse in test sottoposti a revisione paritaria. Lexis+ AI, sul 17%. Le sanzioni hanno superato i 30.000 $ per episodio.
 Guarda
Computer Vision Vincolata dalla Fisica | Veriprajna
Sistemi di visione vincolati dalla fisica su misura che eliminano i falsi positivi nel tracciamento sportivo, nell'ispezione di semiconduttori e nel QA manifatturiero. Filtri di Kalman, gate di flusso ottico e architetture informate dalla fisica per la computer vision in produzione.
Visualizza Soluzione → Guarda
Ingegneria della Voice AI per Drive-Thru QSR | Veriprajna
Risolvi i problemi di accuratezza dell'AI per drive-thru, previeni i fallimenti virali e crea ordini vocali accessibili. Architettura di voice AI per QSR, integrazione con il POS e ingegneria acustica per catene di ristoranti multi-sede.
 Guarda
Satellite Flood Intelligence per l'assicurazione parametrica | Veriprajna
Il rilevamento satellitare a frame singolo confonde le ombre delle nuvole con l'acqua di alluvione. Quando un payout parametrico da 2 milioni di dollari dipende da quella classificazione, "probabilmente allagato" non è sufficiente. Costruiamo sistemi di verifica delle alluvioni che separano le ombre dall'acqua tramite fusione SAR-ottica temporale, producendo tracce di prova di livello forense per ogni evento trigger.
 Guarda
Verifica AI dei Semiconduttori e Correttezza del Silicio | Veriprajna
Costruiamo pipeline di verifica su misura che avvolgono LLM open-weight messi a punto attorno al tuo motore formale esistente (JasperGold, VC Formal, Questa Formal o SymbiYosys) e funzionano interamente sul tuo hardware. Nessun RTL lascia la tua rete. Nessun vendor lock-in.
 Guarda
Rilevamento Intelligente delle Cadute in Struttura e Monitoraggio Ambientale per le Residenze per Anziani | Veriprajna
Rilevamento delle cadute e monitoraggio ambientale passivi e rispettosi della privacy per residenze assistite e strutture di assistenza infermieristica qualificata. Radar mmWave per le stanze ad alto rischio. Sensing Wi-Fi per la copertura dell'intero edificio.
 Guarda
Verifica AI per la Compliance Fiscale | Veriprajna
Thomson Reuters "Ready to Review" prepara automaticamente i modelli 1040. CCH Axcess Expert AI redige analisi di consulenza presso 10.000 studi. Blue J risponde a quesiti di ricerca fiscale con un tasso di disaccordo inferiore a 1 su 700.
Domande Frequenti
Quanto costa un incarico di architettura dell'IA e quale ROI dovrei aspettarmi?
Le tariffe di consulenza sull'IA variano da $200–600/ora per le boutique firm a $300–1.000+/ora per le Big Four e le società MBB. Un tipico incarico di IA con Accenture dura da 4 a 10 mesi prima del rilascio del primo agente in produzione. Le aziende specializzate forniscono sistematicamente in poche settimane ciò che le grandi società di consulenza preventivano in mesi, poiché il modello di business è diverso: strutturiamo il team per la delivery, non per fatturare ore. Progetti di IA con un perimetro ben definito generano tipicamente un ROI del 200–400% entro 12–18 mesi. La metrica più rilevante è il costo irrecuperabile evitato: Deloitte ha rilevato che un'iniziativa di IA abbandonata costa in media $7.2 milioni. Un'implementazione di riferimento che raggiunge realmente la produzione merita di essere confrontata con questa cifra, non solo con la tariffa di consulenza.
Qual è la differenza tra una reference implementation di IA e un documento di architettura?
Un documento di architettura descrive un sistema. Un'implementazione di riferimento è il sistema stesso. Include codice collaudato per la produzione con infrastructure-as-code (Terraform o Pulumi), pipeline CI/CD, configurazione del model serving, dashboard di osservabilità e registri delle decisioni architetturali (ADR) che spiegano ogni scelta significativa. Il vostro team di platform engineering può distribuirlo in staging, eseguire test di carico ed estenderlo senza ulteriore supporto di consulenza. Il documento di architettura è incorporato negli ADR, non fornito come una presentazione separata che diverge da quanto effettivamente costruito.
Dovrei creare una piattaforma MLOps interna o acquistare SageMaker/Vertex AI?
Acquistate una piattaforma gestita a meno che non disponiate di 6+ ingegneri dedicati e 12+ mesi per raggiungere la parità funzionale con quanto offerto da SageMaker out-of-the-box. Le piattaforme gestite mostrano limiti in situazioni specifiche: deployment multi-cloud o ibridi, carichi di lavoro che richiedono logiche di serving personalizzate (modelli ensemble, flussi di lavoro agentici con uso di strumenti), organizzazioni che evitano il lock-in del fornitore per motivi normativi e team la cui economia di inferenza rende l'hosting autonomo nettamente più conveniente. Il self-hosting con vLLM riduce i costi di inferenza per token del 60–80% rispetto alle API cloud su larga scala. Vi aiutiamo a tracciare questa linea prima di investire risorse su uno dei due percorsi.
Perché l'80% dei progetti aziendali di IA non riesce a generare valore?
L'analisi del 2025 di RAND Corporation ha fissato il tasso di fallimento all'80.3%. Il problema non è quasi mai il modello. È il sistema attorno al modello: pipeline di feature mancanti che causano lo skew tra addestramento e serving, assenza di CI/CD per la promozione dei modelli, monitoraggio inesistente che lascia il drift del modello inosservato per mesi e architetture progettate per la demo e non per le operazioni del day-two. Il 42% delle aziende ha abbandonato la maggior parte delle iniziative di IA nel 2025, rispetto al 17% del 2024. Le implementazioni di riferimento che coprono l'intero ciclo di vita operativo, e non solo l'addestramento del modello, sono il modo per evitare di entrare in questa statistica.
Quale framework di model serving dovrei utilizzare: KServe, Triton o vLLM?
Dipende dal vostro carico di lavoro. KServe (in incubazione presso la CNCF, v0.15) è la scelta migliore per i deployment nativi su Kubernetes che richiedono scalabilità fino a zero, rilasci canary e il nuovo Envoy AI Gateway per il rate limiting dei token. vLLM (v0.19, aprile 2026) domina il serving di LLM grazie a PagedAttention, che offre un throughput 2–4x superiore rispetto ai Transformer di base, e al continuous batching che mantiene elevato l'utilizzo delle GPU. NVIDIA Triton prevale per il serving multi-modello intensivo su GPU in cui le prestazioni convalidate da MLPerf sono fondamentali. Molti sistemi in produzione li combinano: KServe come livello di orchestrazione con vLLM o Triton come backend. Configuriamo lo stack in base ai vostri specifici pattern di traffico e requisiti di latenza.
Come gestite la sicurezza dei sistemi di IA e il threat modeling?
Ogni implementazione di riferimento include un modello di minaccia che copre le superfici di attacco specifiche dell'IA: estrazione del modello (query ripetute per decodificare modelli proprietari tramite reverse engineering), inferenza sui dati di addestramento, input avversariali e attacchi alla supply chain sulle dipendenze del modello. L'OWASP Top 10 per LLM e il distinto OWASP Top 10 per applicazioni agentiche (pubblicato a fine 2025) definiscono la base di partenza. Gli incidenti di sicurezza legati all'IA sono aumentati del 56.4% nel 2025 e i ransomware mirati all'infrastruttura di IA sono cresciuti del 179% nel primo semestre del 2025. Il threat model non è un documento isolato: plasma direttamente l'architettura attraverso rate limiting, validazione degli input, verifica dell'integrità degli artefatti del modello e scansione delle dipendenze integrata nella pipeline CI/CD.
In che modo l'IA agentica modifica i requisiti architetturali?
I sistemi agentici richiedono un'infrastruttura che i deployment a modello singolo non necessitano. L'MCP (Model Context Protocol) standardizza le connessioni con strumenti e dati. L'A2A (Agent-to-Agent Protocol) gestisce la comunicazione tra agenti. Sono necessari livelli di orchestrazione per la scomposizione dei task, gestione del contesto per flussi di lavoro multi-turno, controlli di governance con autonomia vincolata e osservabilità in grado di tracciare le azioni multi-fase degli agenti anziché singole chiamate di inferenza. Gartner prevede che il 40% delle applicazioni aziendali integrerà agenti IA entro la fine del 2026. Il modello produttivo adottato con successo da aziende come Uber, LinkedIn e Klarna impiega un agente supervisore centrale con worker specializzati, avanzamento monitorato e audit trail completi.
Cosa succede al termine dell'incarico? Il nostro team sarà in grado di manutenere il sistema?
Questo è l'intero scopo di una reference implementation rispetto a un incarico di servizi gestiti. Ogni componente è documentato con registri delle decisioni architetturali (ADR) che spiegano le scelte effettuate, le alternative valutate e cosa dovrebbe cambiare in caso di evoluzione dei requisiti. Il codice risiede nel vostro repository, l'infrastruttura nel vostro account cloud, il CI/CD gira nella vostra pipeline. Progettiamo per il team che gestisce operativamente il sistema, non per il team che ha creato il modello: pattern di deployment standard, monitoraggio che genera avvisi su metriche gestibili dal vostro team operativo e chiari contratti API tra il codice del modello e l'infrastruttura di serving. L'obiettivo è un sistema che non richiede i progettisti originali per rimanere operativo.
Come si previene lo skew tra addestramento e serving nei sistemi ML in produzione?
Lo skew tra addestramento e serving si verifica quando le feature utilizzate durante il training differiscono da quelle elaborate dal modello in produzione. È il killer silenzioso del machine learning in produzione perché causa il degrado progressivo del modello senza generare errori evidenti. Garantiamo la correttezza temporale (point-in-time correctness) nelle pipeline di feature: i dataset di addestramento riflettono esclusivamente i dati disponibili al momento della previsione. Per i carichi batch, convalidiamo i job di materializzazione Feast rispetto all'integrità del backfill. Per i casi d'uso in streaming (rilevamento frodi, prezzi in tempo reale), le feature vengono calcolate al momento dell'ingestione. Il monitoraggio del feature drift è integrato nello strato di osservabilità affinché il team individui le variazioni di distribuzione prima che compromettano la qualità del modello.
Come affrontate il disaster recovery per i sistemi di IA?
Il disaster recovery dell'IA è più complesso rispetto al DR applicativo tradizionale, poiché richiede il ripristino di uno stato coordinato tra modelli, dati di addestramento, feature store, pipeline di elaborazione e ambienti di calcolo. Le nostre implementazioni di riferimento includono procedure di rollback del modello collegate al model registry (ripristino della versione precedente in produzione in pochi minuti, non ore), recupero del feature store con coerenza point-in-time, riproducibilità della pipeline di addestramento (dati, codice, configurazione e ambiente con controllo di versione) e controlli automatizzati dello stato di salute che rilevano il calo di prestazioni rispetto alla baseline e attivano il rollback in modo automatico. Le organizzazioni che adottano queste pratiche registrano il 60% in meno di fallimenti di ripristino e tempi medi di ripristino (MTTR) più rapidi dell'80%.
Costruisci la tua IA con fiducia.
Collabora con un team che vanta una profonda esperienza nella creazione della prossima generazione di IA aziendale. Lascia che ti aiutiamo a progettare, sviluppare e implementare una strategia di IA di cui ti puoi fidare.
Veriprajna società di consulenza Deep Tech è specializzata nella creazione di sistemi di IA safety-critical per i settori sanitario, finanziario e regolamentato. Le nostre architetture sono validate rispetto a protocolli consolidati con una documentazione di conformità completa.