Progettare l’era post-cloud dell’AI enterprise per il gaming
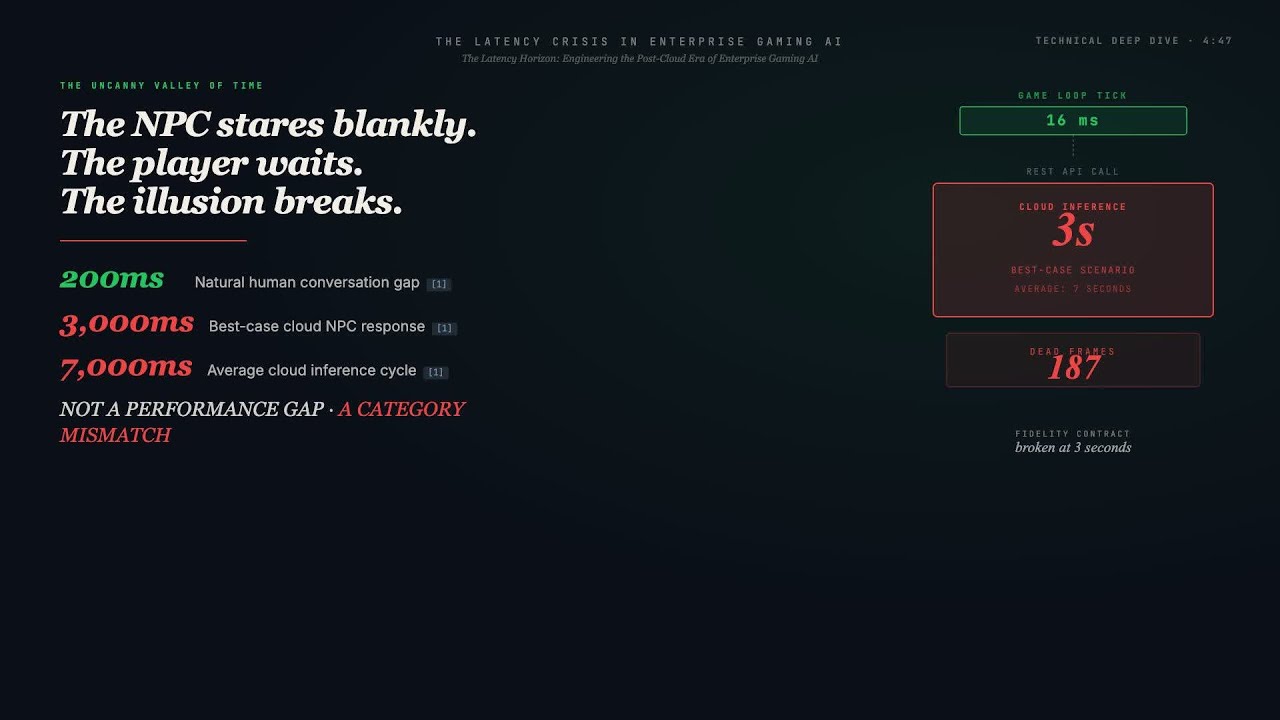
Gli NPC basati sul cloud creano una “Valle Inquietante del Tempo” di 3 secondi che distrugge l’immersione. Le latenze delle API REST superiori a 3000ms compromettono radicalmente il loop di feedback in tempo reale richiesto dal gaming moderno ad alta fedeltà.
L’ Architettura AI Edge-Native di Veriprajna passa dai Cloud LLM a Small Language Models ottimizzati, eseguiti localmente sull’hardware del giocatore, ottenendo latenza sub-50ms, costo inferenziale marginale zero e capacità offline completa.
Veriprajna collabora con studio AAA, sviluppatori indie e piattaforme di gaming d’impresa per progettare mondi di gioco vivi, in cui gli NPC possiedono agency, memoria e capacità di interazione non copionate dagli attori—senza la tassa sulla latenza.
Eliminate la “Tassa del Successo” dell’inferenza cloud. I giocatori più coinvolti non vi costano nulla in calcolo AI. Il deployment edge allinea l’economia dell’AI al modello software tradizionale: alto investimento iniziale di sviluppo, costo marginale di distribuzione quasi nullo.
Spezzate la “Valle Inquietante del Tempo”. Negli ambienti fotorealistici basati su Unreal Engine 5, la fedeltà visiva crea un “contratto di fedeltà”: la latenza audio-visiva deve starne all’altezza. L’inferenza edge sub-50ms preserva l’immersione dove il cloud fallisce.
Liberatevi del problema del “Thundering Herd”. Quando 10.000 giocatori innescano interazioni con NPC simultaneamente, il cloud centralizzato va incontro a picchi di latenza p99 catastrofici. L’edge distribuisce l’inferenza sull’hardware degli stessi giocatori.
Vedete come diverse latenze distruggono il loop di feedback immersivo. Il ritardo di 3 secondi non è un fastidio tecnico: è una barriera psicologica che spezza la sensazione di presenza.
L’attuale approccio incentrato sul cloud non è solo lento: è architettonicamente incompatibile con la simulazione in tempo reale. Stiamo cercando di infilare un paradigma web stateless di tipo richiesta-risposta in un ambiente stateful a 60 FPS.
Le pause naturali nella conversazione sono di ~200ms. Quando la risposta di un NPC supera 1 secondo, la dissonanza cognitiva è stridente. A 3 secondi, l’illusione di presenza collassa completamente: la fedeltà visiva crea aspettative che la latenza audio-visiva non può soddisfare.
I workflow agentici concatenano passaggi di inferenza (analizza minaccia → controlla munizioni → decidi → genera dialogo). Ogni passaggio: 500ms di rete + 500ms di inferenza. 3 passaggi = 3 secondi di “frame morti” in cui la simulazione resta ferma per quell’attore.
Le API cloud non hanno memoria. Ogni richiesta deve serializzare l’intero stato di gioco—cronologia dei dialoghi, inventario, relazioni. La finestra di contesto cresce linearmente, incrementando larghezza di banda, tempo di elaborazione e costo a ogni interazione.
“Il paradosso: più l’NPC diventa intelligente grazie ai cloud LLM, più lentamente reagisce, distruggendo proprio il realismo che l’intelligenza era chiamata a potenziare. Questo è un fallimento dell’architettura, non un fallimento della capacità dell’AI.”
— Whitepaper tecnico Veriprajna, 2024
L’AI cloud crea un incentivo perverso: più il vostro gioco è popolare, più alti diventano i costi operativi. Questo modello OPEX è strutturalmente incompatibile con i modelli di business del gaming.
| Metrica | Cloud LLM (GPT-4) | Edge SLM (Llama-3-8B) |
|---|---|---|
| Costo per sessione di 10 minuti | $0.03 | $0.00 |
| OPEX mensile (media di 5 sessioni/utente) | $150.000 | $0 |
| Costo operativo annuo | $1.8M | $0 (costo di sviluppo una tantum) |
| Scala con il successo? | Sì (spirale della morte) | No (costo fisso) |
| Gioco offline supportato | No (richiede un server) | Sì (residente sul dispositivo) |
Modelli da 1-8 miliardi di parametri usano distillazione e quantizzazione avanzate per fornire un’intelligenza adeguata al gaming senza l’enorme ingombro dei modelli frontier.
Addestrate un piccolo modello “studente” (3,8 miliardi di parametri) sugli output di un enorme modello “insegnante” (Llama-3-70B). Lo studente impara a mimare i pattern di ragionamento, comprimendo l’intelligenza in uno spazio di parametri ridotto.
Comprimete pesi a 16 bit in interi a 4 bit (INT4). Riduce l’ingombro di memoria di ~70% con una perdita di qualità trascurabile. Un modello 8B che richiede 16GB di VRAM ora sta in 5,5GB: distribuibile su GPU consumer di fascia media.
Proprio come i giochi usano il LOD poligonale per gli oggetti distanti, distribuite un LOD di intelligenza per gli NPC. Allocate il calcolo in modo dinamico alle interazioni che catturano l’attenzione del giocatore.
La fattibilità del deployment edge dipende dalla base installata. Abbiamo validato i target sub-50ms sull’intero spettro dei dispositivi consumer.
| Classe hardware | Dispositivo di esempio | VRAM | Modello praticabile | Velocità (TPS) | Caso d’uso |
|---|---|---|---|---|---|
| PC entusiasta | RTX 4090 | 24GB | Llama-3-70B (4 bit) | 40-50 | God Mode / simulazione del mondo |
| PC mainstream | RTX 3060 | 12GB | Llama-3-8B (4 bit) | 35-45 | NPC alta fedeltà |
| Console/handheld | Steam Deck / Switch 2 | Condivisa | Phi-3 Mini (3,8B) | 15-20 | Interazione standard |
| Top di gamma mobile | Snapdragon 8 Gen 2 | N/D | TinyLlama (1,1B) | 8-12 | Barks di base / testo |
Il vincolo è la memoria, non il calcolo (FLOPS). Le schede da 8GB faticano a far girare le texture di gioco + un LLM residente. L’ottimizzazione privilegia la gestione della memoria sulla velocità pura.
La memoria unificata (RAM condivisa CPU/GPU) è vantaggiosa per l’AI. PS5/Xbox Series consentono un’allocazione flessibile. Voci su Switch 2: NVIDIA T239 con Tensor core e supporto DLSS.
I dispositivi Android di fascia alta fanno girare modelli 3B a 10-15 TPS. Sufficiente per testo o semplici comandi vocali. Il thermal throttling limita le sessioni prolungate: usatelo strategicamente.
Distribuire il modello è il primo passo. Raggiungere i sub-50ms richiede tecniche di inferenza all’avanguardia integrate nel motore di gioco.
Abbinate un minuscolo modello “bozza” (150M parametri) al modello target (7B). La bozza ipotizza rapidamente i successivi 5 token. Il target verifica in batch parallelo. Se corretti, generate 5 token al costo di uno.
Gestite la KV cache (memoria della conversazione) come la memoria virtuale dell’OS. Spezzate la cache in pagine non contigue. Riempite ogni byte di VRAM in modo efficiente. Permette contesti più lunghi senza crash OOM.
Raggruppate le richieste di più NPC in una singola operazione GPU. Eseguite in modo asincrono rispetto al loop di gioco, su un thread separato. Lo stato dell’NPC si aggiorna quando i token sono pronti: il framerate non scende mai sotto i 60 FPS.
Gli LLM grezzi allucinano, escono dal personaggio e inventano meccaniche. Un AI di livello enterprise richiede vincoli logici rigidi: grafi della conoscenza per i fatti, grafi di stato per il comportamento.
Strutturate lore, oggetti e relazioni del gioco come grafo della conoscenza. Quando il giocatore chiede, interrogate il grafo per le entità rilevanti. Iniettate i fatti recuperati nel contesto dell’LLM. Vietate di menzionare entità esterne al sottografo recuperato.
l’LLM gestisce il dialogo. La macchina a stati finiti gestisce la logica. Il gioco richiede stati deterministici (Neutrale, Ostile, Commercio, Morto). L’LLM classifica l’intent del giocatore → innesca la transizione di stato → nuovo system prompt.
Per una sicurezza assoluta, l’algoritmo di decodifica agisce come un “correttore ortografico” sul grafo della conoscenza. Al modello viene impedito fisicamente di generare sequenze di token corrispondenti a entità assenti dal trie valido del grafo.
Spostare l’AI lato client introduce un vettore d’attacco unico: i giocatori hanno accesso fisico al modello e al prompt. La difesa richiede un’architettura multistrato.
Gli studio affrontano una scelta: progettare stack di inferenza personalizzati o sfruttare le soluzioni middleware emergenti ottimizzate per i contesti di gaming.
Una “Character Engine” completa che astrae inferenza, memoria e sicurezza. Il “Contextual Mesh” garantisce l’aderenza al lore. Vantaggio primario: velocità di integrazione. In evoluzione verso capacità edge ibride.
Usa l’AI per assistere gli sviluppatori, non per generare testo a runtime. Genera migliaia di “barks” (gridi di battaglia, chiacchiere della folla) che gli scrittori curano. Approccio human-in-the-loop per il controllo qualità.
“Actionable AI” che permette agli NPC di percepire l’ambiente (moduli Vision) ed eseguire azioni (“Prendi quella pistola”). Richiesto uno stretto accoppiamento con fisica e sistemi di navigazione.
I dispositivi edge sono potenti ma finiti. Il futuro degli MMO e delle simulazioni complesse sta nelle architetture ibride che bilanciano immediatezza e profondità.
Il dispositivo locale gestisce i task sensibili alla latenza (lip-sync, dialogo immediato, movimento basilare). La complessa “World Logic” (evoluzione dell’economia della città, politica delle fazioni) viene delegata al nodo fog.
Sfida: se l’NPC locale uccide chi assegna la quest ma il server non è d’accordo, il gioco si rompe.
Veriprajna raccomanda un approccio graduale che transita dal Cloud all’AI edge-native, minimizzando il rischio mentre si costruisce la capacità organizzativa.
Modellate l’impatto finanziario del passaggio da OPEX cloud a CAPEX edge in base ai pattern di coinvolgimento dei vostri giocatori.
Costo API cloud ~$0.01/min per l’inferenza GPT-4o
La “Valle Inquietante del Tempo” è la minaccia maggiore all’immersione della prossima generazione. L’AI basata sul cloud, con la sua latenza intrinseca e la sua imprevedibilità economica, è un vicolo cieco per l’interazione in tempo reale.
Il futuro appartiene a all’AI edge-native—architetture che sfruttano l’immenso potere distribuito del silicio consumer per eseguire modelli ottimizzati, quantizzati e vincolati al grafo direttamente laddove vivono i giocatori. Abbracciando questa svolta, gli sviluppatori vanno oltre la “pausa di 3 secondi” e offrono mondi che non si limitano ad attendere input, ma davvero respirano, reagiscono e ricordano.
La tecnologia è pronta. L’hardware è all’altezza.
È tempo di costruire.
Le pause naturali nella conversazione umana sono di circa 200ms. Le API dei cloud LLM introducono latenze di 3000ms+ tramite roundtrip delle API REST, code di inferenza e generazione TTS. Ciò crea 187 frame morti per ogni risposta NPC in un loop di gioco a 60 FPS. Negli ambienti fotorealistici UE5, la fedeltà visiva crea un ‘contratto di fedeltà’ che la latenza audio-visiva non può eguagliare, facendo collassare completamente l’illusione di presenza.
L’AI cloud crea un costo per sessione di $0.01-0.05 che scala linearmente con il coinvolgimento dei giocatori. Per 1 milione di giocatori attivi mensili con una media di 5 sessioni AI ciascuno, l’OPEX annuale raggiunge $1.8M. Gli edge SLM in esecuzione sull’hardware dei giocatori hanno un costo inferenziale marginale nullo. Un modello Llama-3-8B quantizzato a 4 bit richiede solo 5,5GB di VRAM e raggiunge 35-45 token al secondo su una RTX 3060, convertendo un OPEX volatile in CAPEX fisso.
GraphRAG struttura lore, oggetti e relazioni del gioco come grafo della conoscenza. Quando un giocatore pone una domanda, il sistema interroga il grafo per le entità pertinenti e inietta nel contesto dell’LLM solo i fatti recuperati. La Graph-Constrained Decoding agisce come un correttore ortografico sul grafo della conoscenza, impedendo fisicamente al modello di generare sequenze di token corrispondenti a entità assenti dal trie valido del grafo, portando il tasso di allucinazioni vicino a zero.
L’architettura AI edge-native di Veriprajna non si limita a ridurre la latenza: cambia radicalmente la fisica dell’interazione.
Prenotate una consulenza per modellare la fattibilità del deployment per il vostro motore di gioco, la vostra base di giocatori e i vostri target hardware.
Specifica ingegneristica completa: Small Language Models, quantizzazione a 4 bit, decodifica speculativa, architetture GraphRAG, fog computing, protocolli di sicurezza, benchmark hardware e bibliografia completa.