A IA de retenção precisa de um motivo para fazer uma oferta

Um assinante com alta probabilidade de cancelamento é um candidato óbvio para uma oferta de retenção. Isso torna a previsão de churn um ponto de partida tentador para a automação. Mas a pergunta útil é se essa intervenção específica melhora o resultado o suficiente para justificar seu custo. Alguém pode ter alta probabilidade de sair e baixa probabilidade de se beneficiar de um desconto. Outra pessoa pode ter probabilidade de ficar até que a intervenção piore as coisas.
Quero que os sistemas de retenção conquistem a decisão de fazer uma oferta antes de conquistarem a capacidade de redigir uma. Um rascunho persuasivo não pode fornecer as evidências ausentes de que uma intervenção é útil. E evidências de que uma oferta pode ajudar não estabelecem que a mensagem real seja aceitável. São julgamentos separados, com motivos distintos para reter a ação.
O mesmo número de ofertas pode gerar valores diferentes
Nossa demonstração de IA Ética de Retenção de Assinaturas usa uma coorte sintética de assinaturas para tornar essa distinção inspecionável. A comparação avalia políticas contra resultados sintéticos ocultos, permitindo comparar o que acontece com uma intervenção em relação ao que acontece sem ela. Esses resultados ocultos são usados para avaliação, e não fornecidos ao modelo como rótulos de treinamento.
O direcionamento preditivo de churn e o causal uplift contatam, cada um, 2.239 dos 6.000 assinantes da coorte com intenções atuais de cancelamento. O primeiro classifica o risco de churn. O segundo foca no benefício estimado da intervenção após o custo de desconto configurado. O direcionamento preditivo gera US$ 144.162 em receita incremental anualizada em relação a deixar a coorte inalterada; o uplift gera US$ 187.956. Essas são avaliações de políticas sintéticas, separadas das restrições completas de roteamento de assinantes da demonstração. Não são receita realizada nem previsão para um serviço em produção.
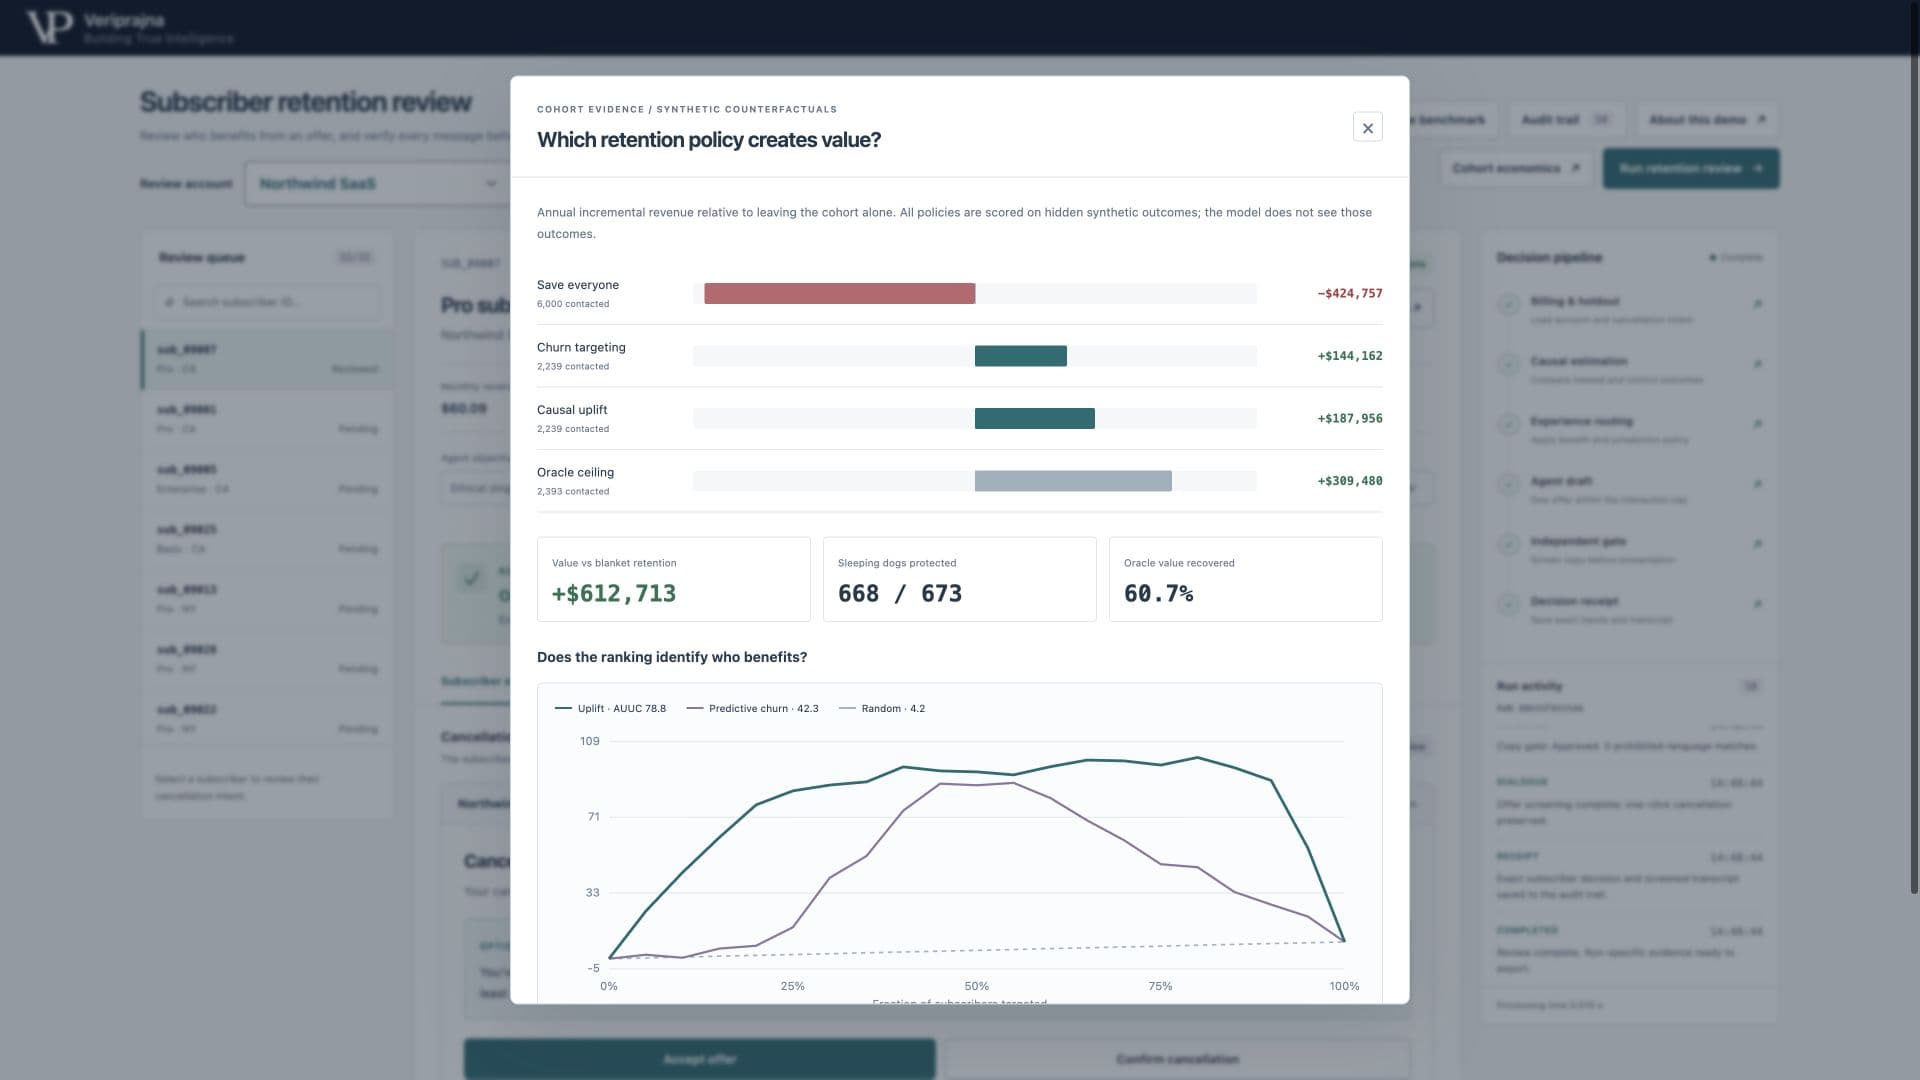
O orçamento igual de contatos é importante. A vantagem da política de uplift aqui não decorre de enviar menos ofertas. Decorre de escolher um conjunto diferente de destinatários. Uma equipe poderia atingir uma meta de volume de contatos e ainda assim gastar seus descontos em pessoas que ficariam de qualquer forma, pessoas que a oferta não consegue persuadir ou pessoas que a intervenção prejudica.
Isso também altera a forma como interpreto uma retenção bem-sucedida. Um assinante que aceita um desconto é um sucesso visível para um fluxo de ofertas. Se esse assinante teria renovado pelo preço integral, o fluxo comprou um resultado que não precisava ser comprado. Contar apenas as ofertas aceitas não revela esse custo. A avaliação exige uma comparação sem intervenção, além do custo da oferta.
A contenção precisa de uma rota, não apenas de uma pontuação
A demonstração estima a retenção com e sem intervenção a partir do histórico aleatorizado de tratamento e controle. A diferença entre eles é o causal uplift estimado: a mudança atribuída à intervenção segundo o modelo. Trata-se de uma estimativa, não de um resultado causal conhecido para um assinante individual.
Um assinante sintético tem retenção estimada substancialmente menor com intervenção do que sem ela. A rota para o assinante selecionado não registra contato de retenção e ignora a redação. O rótulo de modelagem para esses casos prejudicados pela intervenção é Sleeping Dogs. Nessa rota, a contenção ocorre antes que uma mensagem persuasiva possa se tornar a próxima etapa padrão.
A política agregada é imperfeita. Ela deixa 668 de 673 verdadeiros Sleeping Dogs sem contato na coorte sintética, mas ainda contata cinco. Os rótulos ocultos de teste nos permitem contabilizar esses erros. Eles não estariam disponíveis como verdade fundamental individual em um sistema em produção. Trato o resultado como um motivo para inspecionar intervenções prejudiciais, não como permissão para alegar que um modelo causal as elimina.
Esse é um limite desconfortável para uma equipe de retenção: recusar uma oferta pode abrir mão de uma retenção genuína, enquanto aprovar uma pode desperdiçar um desconto ou piorar a retenção. Minha posição de design é tornar ambos os custos visíveis. Uma rota conservadora é uma escolha sob incerteza e deve carregar um motivo que qualquer pessoa possa contestar.
O que fazer quando as evidências são escassas
Uma segunda conta sintética na demonstração tem dados insuficientes para seus requisitos de evidência configurados. A interface retém as previsões de decisão causal, ignora o agente e oferece uma saída limpa. Os limites são regras de demonstração, não um teste universal de suficiência estatística. Cálculos internos ainda podem existir; o comportamento importante é que não se tornem evidências para uma oferta automatizada.
Seria fácil substituir essa recomendação causal ausente por uma pontuação de churn. Isso preserva a automação, mas responde a uma pergunta diferente. Uma alta probabilidade de cancelamento não estabelece que o desconto proposto altere a decisão. Chamar a substituição de fallback pode ocultar a própria distinção que o sistema foi construído para preservar.
Para uma equipe hipotética de produção nessa situação, sou a favor de uma saída temporária sem um desconto automatizado de retenção enquanto ela reúne evidências relevantes para a intervenção. Isso custa possíveis retenções no curto prazo. Também evita tomar decisões amplas de desconto com base em uma pontuação que não mede seu benefício. A escolha deve ser explícita na avaliação, em vez de desaparecer como uma métrica de abstenção bem-sucedida.
Se a equipe optar por aprender por meio de um novo experimento, o experimento precisará de um grupo de tratamento, uma comparação sem intervenção e um custo de oferta definido. Nesse cenário hipotético, eu restauraria os descontos automatizados quando a comparação na população relevante sustentasse valor incremental após o custo. Mais ofertas aceitas por si sós não mudariam minha decisão. O experimento ainda precisa de controles independentes de mensagem e cancelamento. Simplesmente acumular mais observações de churn não responderá ao que a oferta altera. Esta é uma ação separada e deliberadamente autorizada; a demonstração não implementa esse processo de aprendizado em produção.
O valor da oferta não aprova a mensagem
Mesmo uma oferta economicamente promissora precisa de outra decisão antes de alcançar um assinante. O benchmark de contagem regressiva artificial elaborado na demonstração torna isso concreto: uma barreira léxica determinística fora do modelo de redação bloqueia a mensagem de pressão, e as palavras permanecem fora da prévia do assinante. O cancelamento continua disponível. Este é um caso de texto de referência, não uma resposta de modelo rejeitada. Demonstra autoridade para reter uma mensagem após a decisão de considerar uma oferta.
A barreira detecta padrões de linguagem configurados, de modo que passar por ela não certifica todos os fatos ou significados. Os botões de oferta e cancelamento também afetam apenas a prévia local, sem integração com faturamento em produção. Dentro desses limites, o controle fornece um teste de avaliação útil: um rascunho não permitido deve parar na barreira. Um aviso que deixasse as mesmas palavras em seu caminho até o assinante não entregaria esse comportamento.
Uma equipe que avalia essa arquitetura deve, portanto, testar duas coisas de forma independente: se o direcionamento cria valor incremental após o custo e se uma mensagem não permitida é de fato retida. Resultados econômicos fortes não justificam pressão na mensagem. Uma linguagem impecável não pode salvar uma oferta cujo benefício esperado não cubra seu custo.
Aqui está a apresentação do fundador sobre a demonstração, incluindo as decisões de fazer uma oferta ou deixar o assinante em paz.
O vídeo explicativo da demonstração mostra o fluxo de trabalho sintético e as evidências de suas decisões. O que quero que um desenvolvedor extraia disso é um padrão de aquisição e avaliação: perguntar pelo motivo pelo qual uma oferta foi feita, pelo motivo pelo qual outra foi retida e pelas evidências que poderiam mudar qualquer uma das decisões. Um sistema capaz apenas de explicar suas ofertas bem-sucedidas deixa o julgamento mais difícil para todos nas etapas seguintes.