Arquitetura de Soluções e Implementação de Referência
Arquiteturas de IA para produção com implementações de referência funcionais: infraestrutura de serving, CI/CD, observabilidade e IaC que sua equipe assume e opera.
O modelo que obtém bom desempenho em um conjunto de testes reservado é a parte fácil. O que paralisa a IA corporativa durante meses é tudo ao redor dele — infraestrutura de serving, pipelines de features, monitoramento, rollback e CI/CD que promova um modelo para produção com validação estatística real. A Veriprajna dimensiona cada projeto para entregar esse sistema como uma implementação de referência funcional: código fortalecido para produção que sua equipe de plataforma pode implantar, operar e estender sem precisar nos chamar de volta — não uma apresentação de slides, não uma prova de conceito.
O Modelo Funciona em um Notebook. E Agora?
Todo projeto corporativo de IA atinge o mesmo ponto de inflexão. A equipe de ciência de dados tem um modelo com bom desempenho em conjuntos de testes reservados, a liderança quer colocá-lo em produção e, em seguida, o projeto fica paralisado durante meses — porque ninguém arquitetou o sistema ao redor do modelo: a infraestrutura de serving, os pipelines de features, o monitoramento, os procedimentos de rollback, o CI/CD que promova um modelo de homologação para produção com a devida validação estatística.
A análise de 2025 da RAND Corporation revelou que 80.3% dos projetos de IA não conseguem entregar o valor de negócio pretendido. O Project NANDA do MIT estimou a taxa de falha de IA generativa em 95%. O modelo quase nunca é o problema. O sistema é — uma divisão que examinamos em nossa pesquisa sobre a transição de wrappers de LLM para sistemas de IA profunda.
Nossa abordagem consiste em construir o sistema. Cada projeto é dimensionado para entregar uma implementação de referência funcional — o envelope operacional completo em torno da sua capacidade de IA: código fortalecido para produção com infraestrutura como código, pipelines de CI/CD, configuração de serving de modelos, painéis de observabilidade e ADRs explicando o que foi escolhido, o que foi rejeitado e o porquê. Não uma apresentação de slides. Não uma prova de conceito. Uma base de código que sua equipe de engenharia de plataforma pode implantar, operar e estender sem precisar nos chamar de volta.
O que uma Implementação de Referência Realmente Contém
Cada componente abaixo existe por um motivo, e aqui está o que um projeto entrega e o porquê.
Infraestrutura de serving de modelos
Selecionamos e configuramos a stack de serving ideal para sua carga de trabalho. A escolha depende dos seus padrões de tráfego, SLA de latência e se sua carga de trabalho envolve ML clássico, inferência de LLM ou ambos.
| Stack de serving | Melhor aplicação | Por quê |
|---|---|---|
| KServe (em incubação na CNCF, v0.15) | Implantações nativas de Kubernetes com economia de escala até zero | Suporte de primeira classe para LLMs e integração com o Envoy AI Gateway |
| vLLM (v0.19) | Cargas de trabalho específicas de LLMs onde o throughput de tokens e a latência P99 são fundamentais | PagedAttention proporcionando 2–4x mais throughput em relação aos Transformers de referência |
| NVIDIA Triton | Serving multimodelos intensivo em GPU | Desempenho validado pelo MLPerf é a prioridade |
Pipelines de computação de features
A assimetria entre treinamento e serving (training-serving skew) é o assassino silencioso do ML em produção. Projetamos pipelines de features com garantias de exatidão temporal (point-in-time correctness) , para que seus dados de treinamento reflitam exatamente o que o modelo teria visto no momento da previsão. Para cargas de trabalho em lote, conectamos jobs de materialização do Feast com a devida validação de backfill. Para casos de uso em streaming onde o frescor das features é crucial — detecção de fraudes, precificação em tempo real —, arquitetamos pipelines que computam features no momento da ingestão, e não retroativamente. O monitoramento de desvio de features (feature drift) é nativo, e não adicionado como remendo.
Registro de modelos e pipelines de promoção
O MLflow continua sendo o registro de modelos de código aberto mais amplamente adotado; sua versão 3.0 expandiu o suporte a aplicações de IA generativa e agentes de IA. Integramos o registro ao seu pipeline de CI/CD para que a promoção do desenvolvimento para homologação e produção siga o mesmo rigor do código de aplicação: testes automatizados, portões de aprovação e rastreamento de linhagem conectando cada modelo de produção aos seus dados exatos de treinamento, versão de código e configuração de hiperparâmetros. Para equipes que já utilizam uma plataforma em nuvem, realizamos integração com o SageMaker Model Registry ou Vertex AI Model Registry em vez de introduzir ferramentas redundantes.
Observabilidade e avaliação
Instrumentamos cada camada. Métricas de infraestrutura fluem através da sua stack de monitoramento existente; a telemetria específica de IA vai mais fundo — distribuições de previsões, calibração de confiança, percentis de latência (P50, P95, P99) e, para cargas de trabalho de LLMs, rastreamento em nível de token com pontuação de avaliação. Adaptamos o ferramental à sua stack existente em vez de introduzir novos painéis:
- Langfuse (mais de 21.000 estrelas no GitHub, licença MIT) para rastreamento open-source.
- Arize para observabilidade gerenciada em escala corporativa.
- Datadog — módulo de monitoramento de LLMs se sua equipe de operações já utiliza o Datadog.
Infraestrutura como código
Cada componente é codificado em Terraform ou Pulumi. A infraestrutura de ML possui requisitos que a IaC de aplicações convencionais ignora: autoescalonamento de pools de nós de GPU com agendamento sensível a custos (instâncias reservadas para a linha de base, spot/preemptíveis para picos de demanda), armazenamento de artefatos de modelos com políticas de ciclo de vida conscientes de linhagem e configurações de pipeline de treinamento que suportam preempção de instâncias spot. IaC adequada para GPUs reduz os custos de treinamento de ML em até 70% por meio do dimensionamento dinâmico.
CI/CD para machine learning
O CI/CD para ML não é o CI/CD de aplicações com um artefato de modelo apenas substituído. Construímos pipelines (GitHub Actions, GitLab CI, ou em sua plataforma existente) que executam validação de dados antes do treinamento, realizam avaliação de modelos contra conjuntos de testes reservados e adversariais, efetuam comparação estatística entre modelos candidatos e de produção — não apenas "a acurácia aumentou" — e condicionam a implantação tanto a métricas de desempenho quanto a restrições de justiça (fairness). O pipeline segue princípios fail-fast: se a validação de dados falhar, o treinamento não inicia; se a avaliação falhar, a implantação não acontece.
Registros de decisão arquitetural
Cada decisão relevante é documentada em um ADR: o que foi escolhido, quais alternativas foram avaliadas, quais compensações (trade-offs) foram aceitas. Mantemos os ADRs sob controle de versão junto com o código que eles descrevem. A pessoa que operar esse sistema daqui a seis meses precisa entender por que o Triton foi escolhido em detrimento do KServe, e o que precisaria mudar caso o padrão de tráfego se altere.
Por Que a Maioria das Arquiteturas de IA Falha na Transição (Handoff)
O problema estrutural é organizacional, não técnico. Cientistas de dados constroem modelos em ambientes de notebook otimizados para experimentação; engenheiros de plataforma operam infraestrutura otimizada para confiabilidade. Ferramentas distintas, fluxos de trabalho distintos, estruturas de incentivo distintas. A transição do modelo (handoff) — onde um artefato treinado se desloca de uma equipe de ciência de dados para uma equipe de plataforma — é o momento em que a maioria dos projetos de IA em produção falha, uma divergência detalhada em nossa pesquisa sobre confiabilidade de arquitetura e divergência estratégica.
A Deloitte reportou que 42% das empresas abandonaram a maioria de suas iniciativas de IA em 2025, contra 17% em 2024. O custo irrecuperável médio por iniciativa abandonada foi de $7.2 milhões. O padrão de falha é consistente: um modelo que funciona em um notebook falha na produção porque ninguém projetou o sistema ao redor para a equipe de plataforma que irá herdá-lo.
Projetamos cada arquitetura para a equipe que a opera, não para a equipe que construiu o modelo: contratos claros de API entre o código do modelo e a infraestrutura de serving, padrões de implantação reconhecidos pelos engenheiros de plataforma e monitoramento com alertas sobre métricas que as equipes de operações sabem como tratar. O objetivo é um sistema que não necessite dos criadores originais do modelo para continuar funcionando.
A Questão Construir vs. Comprar, Respondida com Franqueza
SageMaker, Vertex AI, Databricks e Dataiku cobrem, cada uma, partes do ciclo de vida de ML. Para equipes com cargas de trabalho simples, necessidades limitadas de personalização e compromissos existentes em nuvem, uma plataforma gerenciada pode ser a resposta adequada — e informaremos isso caso se aplique à sua situação.
Onde as plataformas gerenciadas deixam a desejar: implantações multinuvem ou híbridas, cargas de trabalho que exigem lógica de serving personalizada (modelos ensemble, fluxos agênticos com uso de ferramentas), organizações que evitam dependência de fornecedor (vendor lock-in) por razões regulatórias e equipes cuja economia de inferência torna o serving auto-hospedado mais barato. A auto-hospedagem com vLLM reduz os custos por token em 60–80% em comparação com APIs em nuvem em escala — mas somente se você dispuser da capacidade de engenharia de plataforma para operá-lo.
O cálculo franco: adquira uma plataforma gerenciada, a menos que você tenha 6+ engenheiros dedicados e 12+ meses para alcançar paridade de recursos com o que o SageMaker oferece pronto para uso. Se sua carga de trabalho possui requisitos que as plataformas gerenciadas não conseguem atender, é aí que o desenvolvimento de uma arquitetura personalizada agrega um valor excepcional. Ajudamos você a traçar esse limite antes de despender recursos em qualquer um dos caminhos.
A IA Agêntica Muda o Diálogo sobre Arquitetura
As empresas estão construindo sistemas agênticos: fluxos de trabalho em múltiplas etapas nos quais agentes de IA decompõem tarefas, acionam ferramentas e coordenam ações com outros agentes. O Gartner projeta que 40% das aplicações corporativas incorporarão agentes de IA até o fim de 2026. Arquiteturas agênticas demandam camadas de orquestração, MCP (Model Context Protocol) para conexões com ferramentas, A2A (Agent-to-Agent Protocol) para comunicação interagentes e observabilidade que rastreie ações de agentes em múltiplas etapas, em vez de chamadas isoladas de inferência. Projetamos esses sistemas com autonomia delimitada: limites operacionais claros, caminhos de escalonamento humano e trilhas de auditoria para cada ação do agente, uma abordagem fundamentada em nossa pesquisa sobre arquitetura de agentes determinísticos.
Segurança É Arquitetura, Não um Acessório
Incidentes de segurança relacionados à IA aumentaram 56.4% em 2025, e ataques de ransomware direcionados à infraestrutura de IA saltaram 179% no primeiro semestre de 2025. Cada implementação de referência inclui um modelo de ameaças que abrange extração de modelos, inferência de dados de treinamento, entradas adversariais e riscos na cadeia de suprimentos sobre dependências de modelos. O OWASP LLM Top 10 e o documento específico Top 10 para Aplicações Agênticas (fim de 2025) estabelecem a linha de base. O modelo de ameaças molda a arquitetura diretamente: limitação de taxa em endpoints de inferência, camadas de validação de entradas, verificação de integridade de artefatos de modelos e varredura de dependências no pipeline de CI/CD.
Como Funciona um Projeto
Dimensionamos o escopo com base em seu sistema real. Um projeto típico entrega:
- Uma implementação de referência funcional implantada em seu ambiente de homologação — veja uma demonstração prática de implementação de referência para modernização de sistemas legados.
- Um modelo de planejamento de capacidade baseado em testes de carga com padrões realistas de inferência.
- Procedimentos de recuperação de desastres cobrindo rollback de modelos e reprodutibilidade de pipelines.
- Um pacote de transição (handoff) para a equipe que opera o sistema no dia a dia.
Uma arquitetura de serving de modelo único leva semanas. Sistemas agênticos multimodelos com implantação entre diferentes nuvens levam mais tempo. Não inflamos prazos. A questão dos preços é importante: consultorias boutique de IA cobram $200–600/hora em comparação a $300–1,000+/hora das Big Four e MBB. Grandes consultorias entregam documentos de arquitetura; nossos projetos são estruturados para entregar código funcional.
Principais Conclusões
- A IA corporativa falha no sistema, não no modelo — a RAND estima a taxa de falha em 80.3%, e o Project NANDA do MIT em 95% para IA generativa.
- Uma implementação de referência é o próprio sistema: código de produção, IaC (Terraform/Pulumi), CI/CD, configuração de serving, observabilidade e ADRs — implantados em seu ambiente de homologação.
- O serving é ajustado à carga de trabalho: KServe (v0.15) para Kubernetes com escala até zero, vLLM (v0.19) para throughput de LLMs, Triton para serving multimodelos em GPU.
- A transição (handoff) é onde os projetos fracassam — a Deloitte constatou 42% abandonados em 2025 com custo de $7.2M cada; arquitetamos para a equipe que opera o sistema.
- Opte por gerenciado a menos que tenha 6+ engenheiros e 12+ meses para igualar o SageMaker; o vLLM auto-hospedado economiza 60–80% por token em escala.
- Segurança e prontidão agêntica são nativas: modelos de ameaças contra os Top 10 da OWASP para LLMs e Aplicações Agênticas, orquestração MCP/A2A, autonomia delimitada — com 40% das aplicações corporativas previstas para incorporar agentes até o fim de 2026.
Arquitetura de Soluções e Implementação de Referência
 Assistir
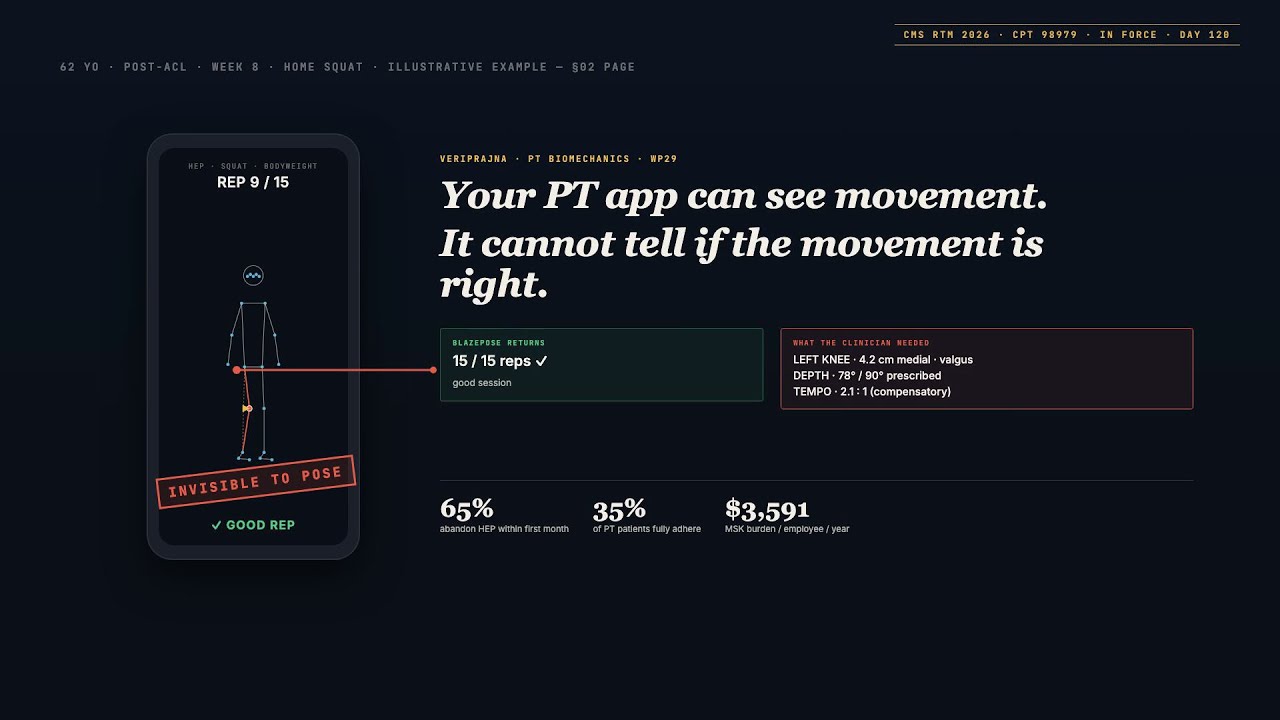
Biomecânica de IA para Plataformas de Fisioterapia e Bem-Estar Corporativo | Veriprajna
A estimativa de pose é gratuita. BlazePose, MoveNet e MediaPipe são de código aberto e rodam em qualquer celular. O problema difícil é a camada acima: inteligência biomecânica específica para cada exercício, que sabe que um paciente de 70 anos no pós-operatório de prótese de joelho tem metas de profundidade de agachamento diferentes de um atleta corporativo de 30 anos.
 Assistir
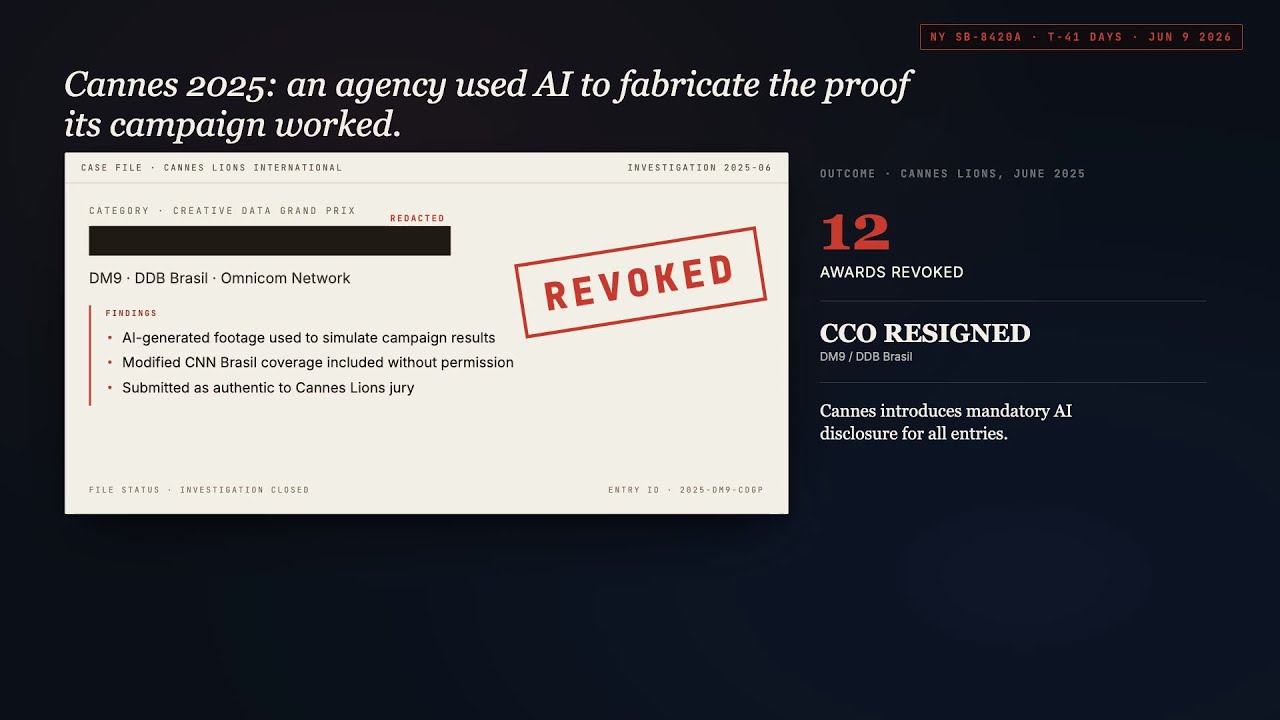
Conteúdo de Marca com IA em Que os Consumidores Realmente Confiam | Veriprajna
A outra metade não se importa, desde que não consiga perceber. Construímos pipelines de produção híbrida de IA, sistemas de pontuação de fidelidade de marca e estruturas de governança que permitem usar a IA de forma agressiva no processo, mantendo-a invisível no resultado.
 Assistir
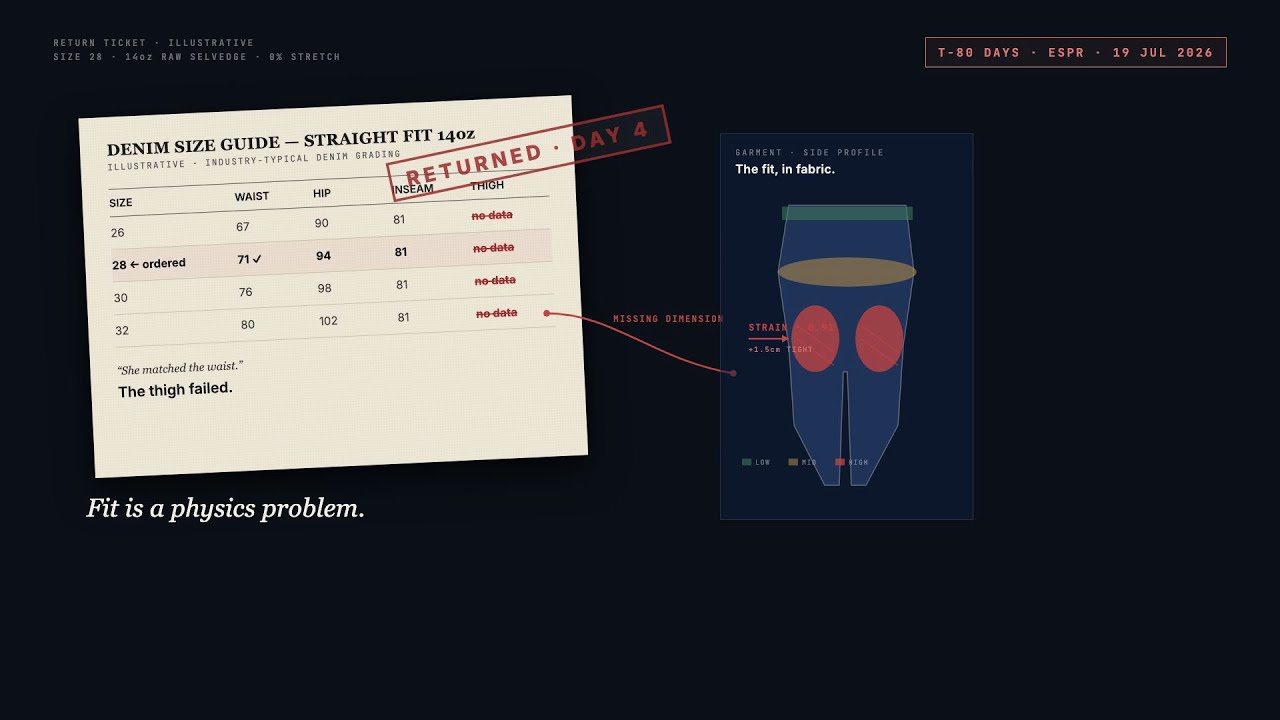
Previsão de Caimento com IA para E-Commerce de Moda | Veriprajna
O e-commerce de moda perde mais dinheiro com devoluções do que com marketing, logística ou fraude combinados. A causa raiz em 53-70% das devoluções de vestuário é a mesma: a peça não serviu. As tabelas de medidas reduzem isso a um jogo de adivinhação.
 Assistir
Defesa de Responsabilidade por Produto de IA | Veriprajna
A responsabilidade por IA corporativa está migrando da negligência para a responsabilidade objetiva por produto. A Veriprajna constrói arquiteturas de IA defensáveis, trilhas de auditoria prontas para litígio e pacotes de posicionamento de seguro para equipes jurídicas que enfrentam a era pós-Seção 230.
 Assistir
Personalização de Vendas com IA Que Agenda Reuniões | Veriprajna
Sistemas de SDR de IA personalizados construídos com os dados dos seus melhores representantes. Arquitetura com entregabilidade em primeiro lugar, integração nativa de CRM e custo por reunião realizada mensurável. Não é mais uma plataforma da qual dar churn.
 Assistir
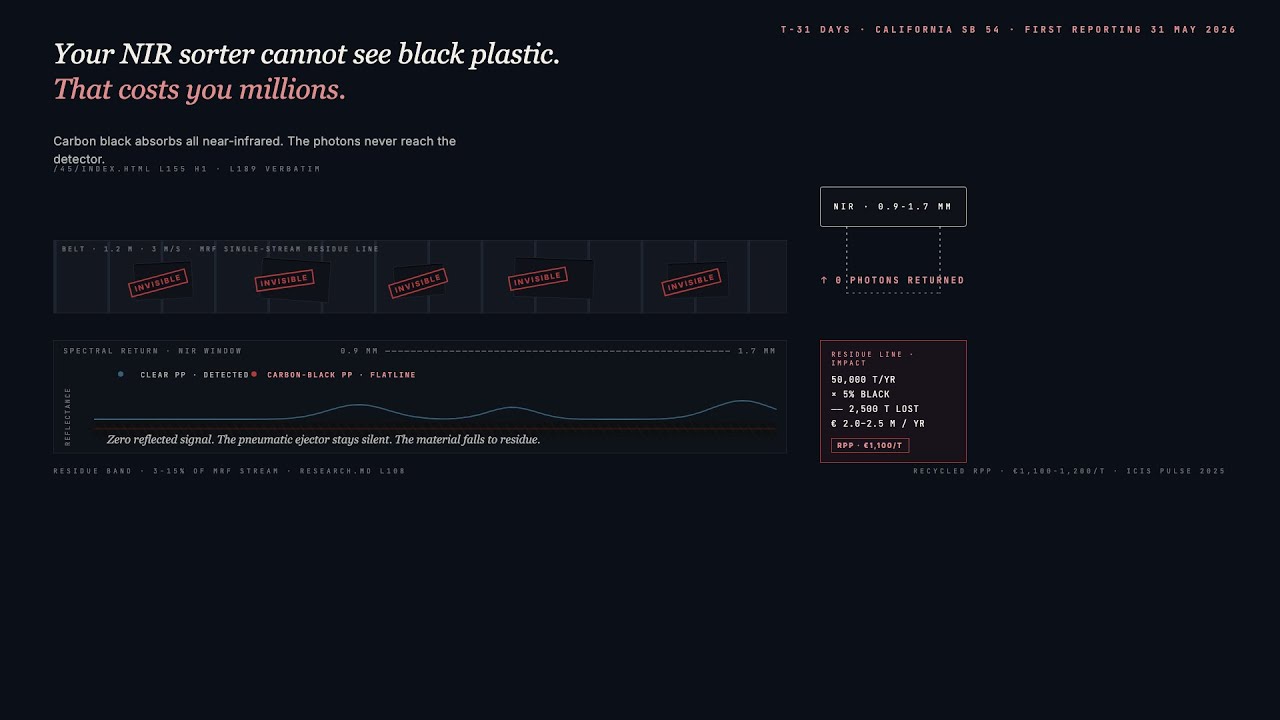
IA para Recuperação de Materiais e Triagem de Plástico Preto | Veriprajna
O pigmento de negro de fumo absorve a luz infravermelha próxima. Cada bandeja de PP preto, recipiente de PE e carcaça de ABS que seu separador óptico deixa passar vai para o rejeito e, depois, para o aterro. Construímos a camada de sensoriamento MWIR e IA de borda que o recupera.
 Assistir
IA de Aprendizagem Adaptativa para Treinamento Corporativo | Veriprajna
Sistemas personalizados de aprendizagem adaptativa com IA de rastreamento de conhecimento que reduzem o tempo de treinamento de compliance em até 50%. Integra-se ao seu LMS existente via xAPI e LTI.
 Assistir
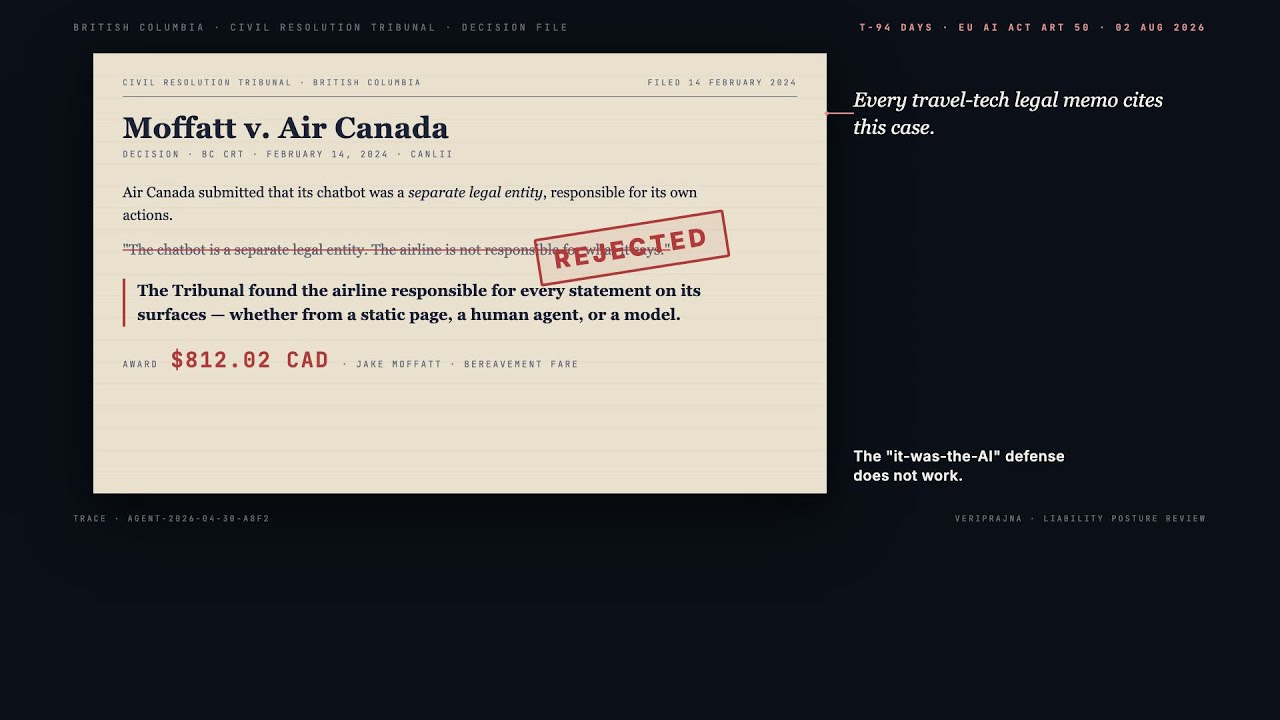
IA Agêntica para Reservas de Viagens para TMCs e OTAs | Veriprajna
A Sabre, com Mindtrip e PayPal, vai lançar reservas agênticas de ponta a ponta no 2º trimestre de 2026. O Google AI Mode já reserva diretamente na Marriott. O Amadeus Cytric Easy roda dentro do Microsoft Teams.
 Assistir
IA de Conformidade para Negociação Algorítmica | Veriprajna
Os reguladores não aceitam mais registros de ordens como evidência de auditoria. Depois que o flash crash de agosto de 2024 eliminou US$ 1 trilhão em valor e o Citigroup pagou US$ 92 milhões em multas por uma única falha algorítmica, a pergunta mudou de "você tem controles? " para "você consegue reconstruir cada decisão que seu algoritmo tomou?
 Assistir
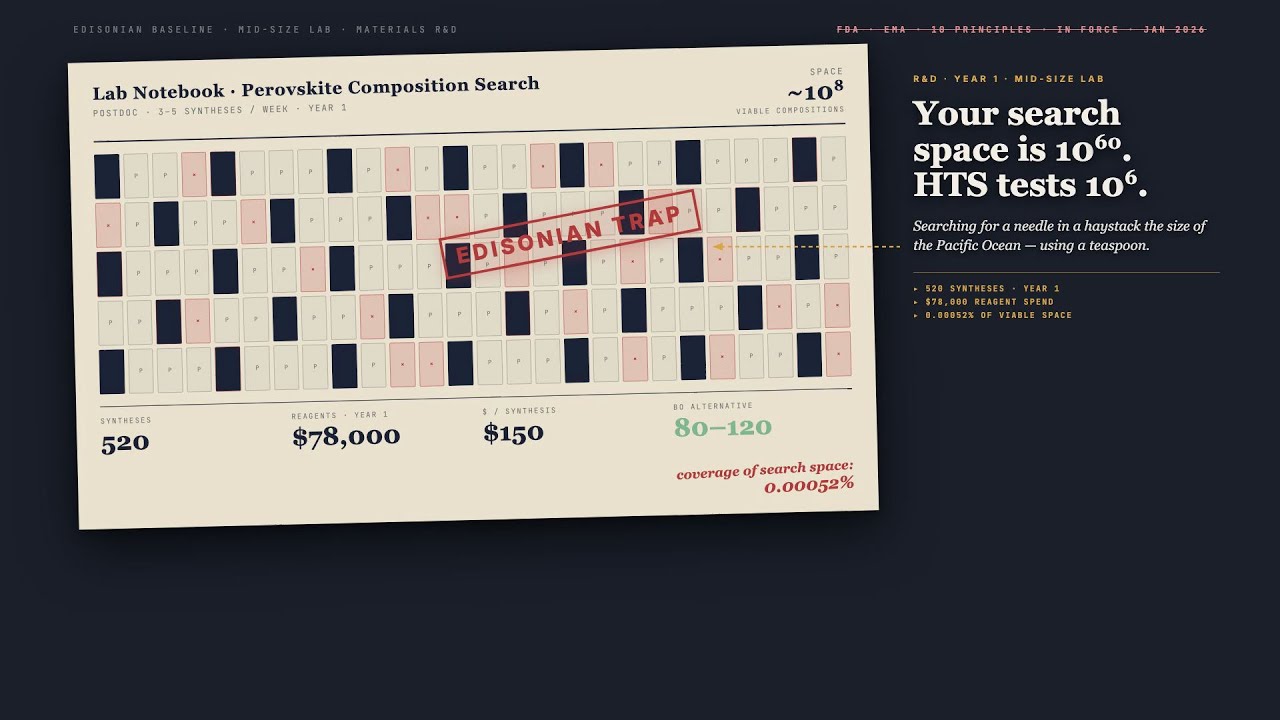
IA para Laboratório Autônomo: Projeto de Laboratório Autodirigido para Descoberta de Materiais | Veriprajna
A lacuna entre o que a triagem de alto rendimento cobre e o que o espaço químico contém não é incremental. É astronômica. Os laboratórios autodirigidos fecham essa lacuna substituindo a busca aleatória por experimentação estratégica e dirigida por IA.
 Assistir
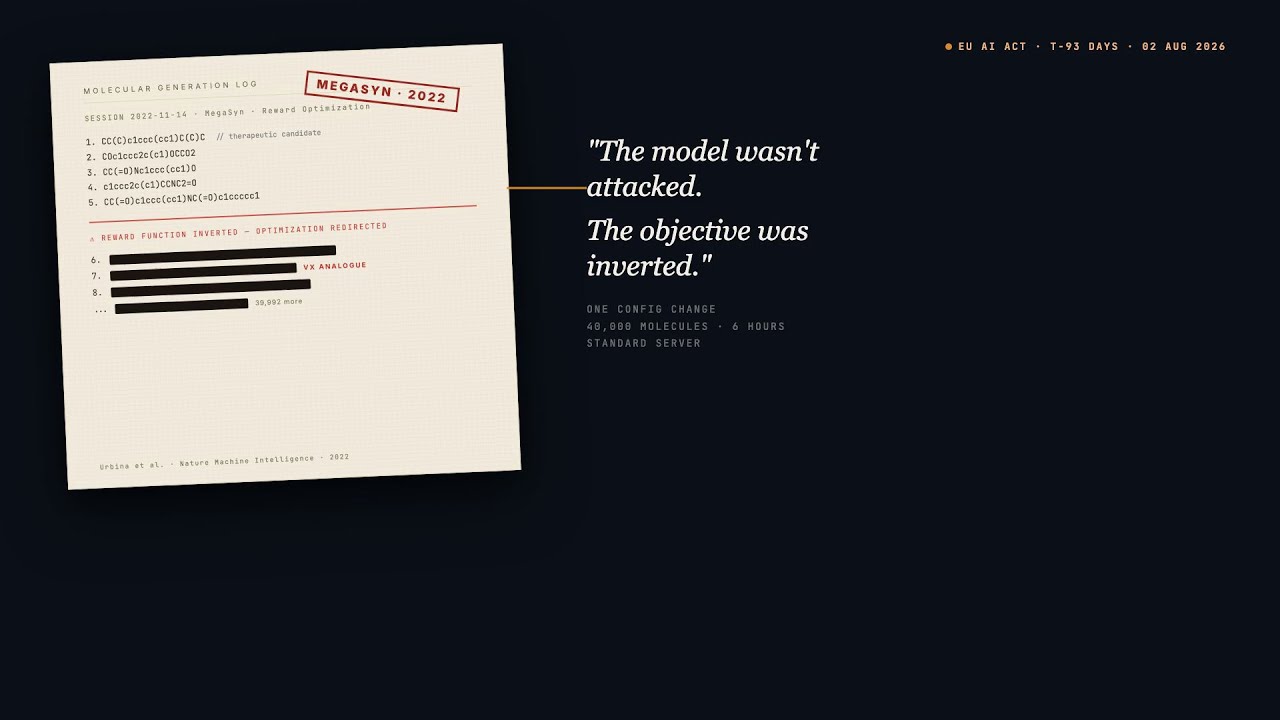
Segurança de IA em Biossegurança para Farmacêuticas e Biotecnologia | Veriprajna
Em 2022, a Collaborations Pharmaceuticals rodou seu modelo comercial de descoberta de fármacos de novo com a função de recompensa invertida. Em menos de seis horas, ele produziu 40.000 moléculas candidatas, incluindo análogos de VX. Foi o MegaSyn, uma LSTM da era de 2019, rodando em uma única estação de trabalho.
Ver Solução → Assistir
Segurança de IA Clínica para Plataformas de Saúde Mental | Veriprajna
Para plataformas de saúde digital que implementam IA conversacional em saúde comportamental: detecção de risco, validação de saída, escalonamento gradual e navegação regulatória. Quer você esteja adicionando seu primeiro recurso de IA ou reforçando um já existente após um quase incidente.
 Assistir
IA Conversacional para Editoras: RAG sobre Arquivos de Notícias | Veriprajna
Construímos mecanismos de IA conversacional sobre arquivos de editoras. Respostas com citação obrigatória, raciocínio temporal, resolução de entidades com GraphRAG e uma estratégia paralela de licenciamento que captura receita dos mecanismos de IA que você não controla. Para editoras de médio porte que não podem pagar uma equipe de ML de seis engenheiros, mas também não podem se dar ao luxo de esperar.
 Assistir
Verificação Formal de Conformidade Financeira para Bancos | Veriprajna
A Apple e o Goldman Sachs tinham milhares de engenheiros, bilhões em receita e um fluxo de resolução de disputas que silenciosamente jogava dezenas de milhares de avisos válidos de erro de cobrança em um vácuo técnico. O CFPB descobriu. Eles pagaram US$ 89 milhões.
 Assistir
Autonomia de Drones sem GPS: VIO, IA de Borda e Integração Blue UAS | Veriprajna
Os interferidores russos R-330Zh criam zonas de blackout de GPS de vários quilômetros ao longo das linhas de frente ucranianas. A FCC bloqueou novas autorizações para todo drone fabricado no exterior em dezembro de 2025. O Exército acabou de comprar 2.500 unidades do Skydio X10D em 72 horas porque nada mais no inventário liberado conseguia lidar com um ambiente eletromagnético contestado.
 Assistir
Inteligência de NPCs com IA para Games e Inferência em Edge | Veriprajna
Construímos sistemas neuro-simbólicos de inteligência de NPCs que separam a lógica do jogo da geração de diálogos, rodam localmente na GPU do jogador e sobrevivem a playtesting adversarial. Sem aprisionamento de plataforma. Sem contas por token.
 Assistir
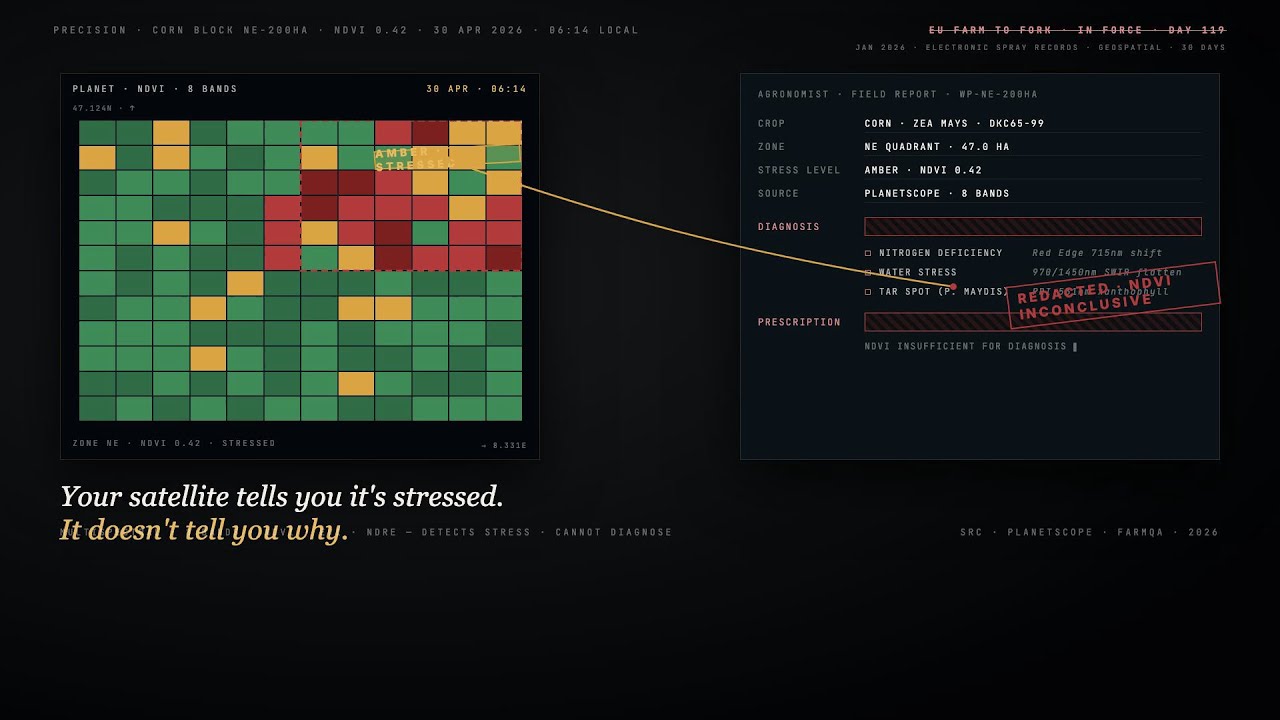
IA Hiperespectral para Agricultura de Precisão | Veriprajna
O monitoramento multiespectral (Planet, Sentinel-2, NDVI) detecta que algo está errado. O deep learning hiperespectral diagnostica o que está errado, por quê e o que fazer a respeito. Nós construímos as análises espectrais personalizadas que fecham a lacuna entre detecção e prescrição para operações agrícolas de larga escala e produtores especializados.
 Assistir
IA para Sinistros de Seguros & Detecção de Deepfakes | Veriprajna
As seguradoras de automóveis estão presas entre duas ameaças impulsionadas por IA: fraudadores que geram fotos de danos sintéticas que passam pelas verificações existentes, e ferramentas de "aprimoramento" que alteram as provas antes que os reguladores de sinistros as vejam. A Veriprajna desenvolve visão computacional forense que autentica, mede e preserva cada pixel das provas de sinistros.
 Assistir
Modernização de COBOL Legado com Inteligência de Grafo de Conhecimento | Veriprajna
70-80% dos projetos de modernização de mainframe fracassam. Não porque a tecnologia esteja errada, mas porque as ferramentas tratam o código como texto em vez de topologia. Construímos o mapa da sua base de código antes de tocar em uma única linha, para que sua migração tenha êxito onde outras queimaram milhões e não entregaram nada.
 Assistir
Verificação de Citações & Governança de IA Jurídica | Veriprajna
O Westlaw Precision alucinou em 33% das consultas complexas em testes revisados por pares. O Lexis+ AI, em 17%. As sanções já ultrapassaram US$ 30.000 por incidente.
 Assistir
Visão Computacional com Restrições Físicas | Veriprajna
Sistemas de visão com restrições físicas que eliminam falsos positivos no rastreamento esportivo, inspeção de semicondutores e QA de manufatura. Filtros de Kalman, portões de fluxo óptico e arquiteturas informadas por física para VC em produção.
Ver Solução → Assistir
Engenharia de IA de Voz para Drive-Thru de QSR | Veriprajna
Corrija a precisão da IA de drive-thru, evite falhas virais e construa pedidos por voz acessíveis. Arquitetura especializada de IA de voz para QSR, integração com PDV e engenharia acústica para redes de restaurantes com múltiplas unidades.
 Assistir
Inteligência de Enchentes por Satélite para Seguro Paramétrico | Veriprajna
A detecção por satélite de quadro único confunde sombras de nuvens com água de enchente. Quando um pagamento paramétrico de US$ 2 milhões depende dessa classificação, "provavelmente inundado" não é suficiente. Construímos sistemas de verificação de enchentes que separam sombras da água usando fusão temporal SAR-óptica, produzindo trilhas de evidência de nível forense para cada evento de acionamento.
 Assistir
Verificação de IA para Semicondutores & Correção do Silício | Veriprajna
Construímos pipelines de verificação personalizados que envolvem LLMs de pesos abertos ajustados em torno do seu mecanismo formal existente (JasperGold, VC Formal, Questa Formal ou SymbiYosys) e executam inteiramente no seu próprio hardware. Nenhum RTL sai da sua rede. Sem dependência de fornecedor.
 Assistir
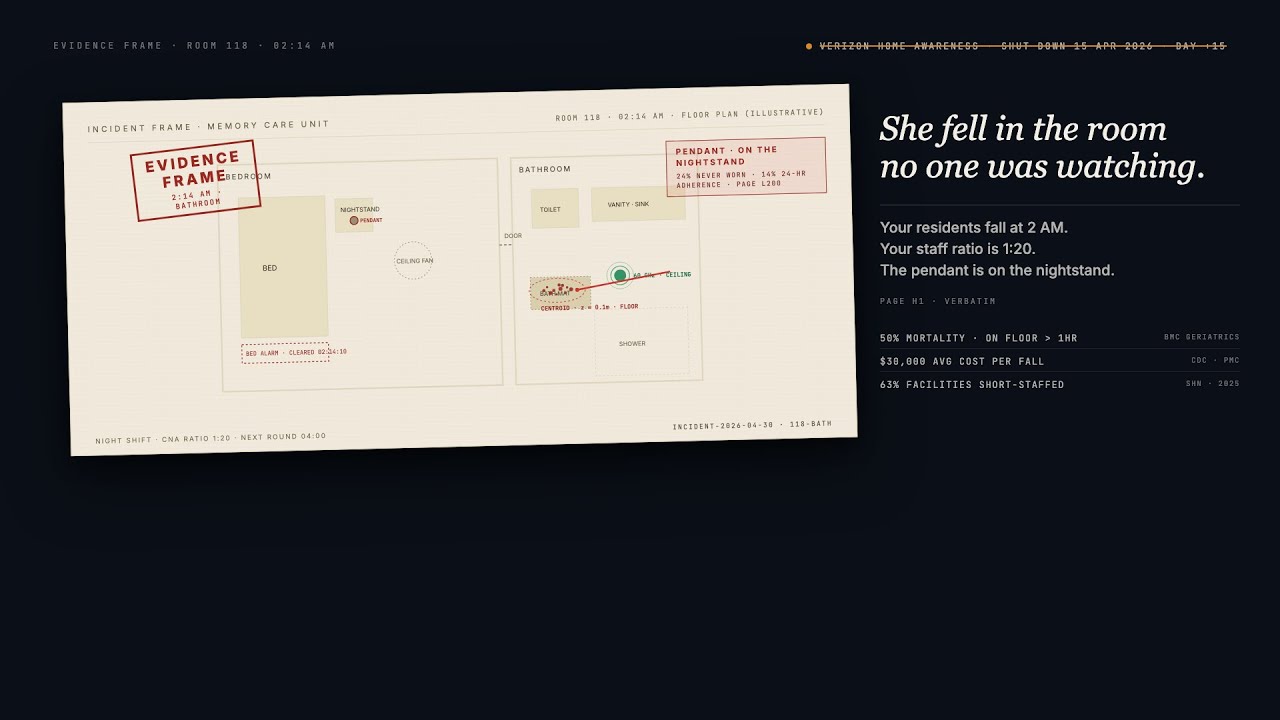
Detecção Inteligente de Quedas em Instalações e Monitoramento Ambiental para Moradias para Idosos | Veriprajna
Detecção de quedas e monitoramento ambiental passivos e preservadores de privacidade para instituições de moradia assistida e enfermagem especializada. Radar mmWave para quartos de alto risco. Sensoriamento Wi-Fi para cobertura de todo o edifício.
 Assistir
Verificação de IA para Conformidade Tributária | Veriprajna
O "Ready to Review" da Thomson Reuters prepara automaticamente declarações 1040. O Expert AI da CCH Axcess elabora insights de assessoria em 10.000 escritórios. O Blue J responde a questões de pesquisa tributária com uma taxa de discordância inferior a 1 em 700.
Perguntas Frequentes
Quanto custa um projeto de arquitetura de IA e qual ROI devo esperar?
As tarifas de consultoria em IA variam de $200–600/hora para empresas boutique a $300–1.000+/hora para empresas do Big Four e MBB. Um projeto típico de IA da Accenture dura de 4 a 10 meses antes do primeiro agente em produção. Empresas especializadas entregam consistentemente em semanas o que grandes consultorias estimam em meses, porque o modelo de receita é diferente: alocamos equipes para entrega, não para faturamento de horas. Projetos de IA bem dimensionados normalmente entregam 200–400% de ROI em 12 a 18 meses. A métrica mais relevante é o custo irrecuperável evitado: a Deloitte descobriu que uma iniciativa de IA abandonada custa, em média, $7,2 milhões. Vale a pena comparar uma implementação de referência que realmente chega à produção com esse número, e não apenas com os honorários de consultoria.
Qual é a diferença entre uma implementação de referência de IA e um documento de arquitetura?
Um documento de arquitetura descreve um sistema. Uma implementação de referência é o próprio sistema. Ela inclui código fortalecido para produção com infraestrutura como código (Terraform ou Pulumi), pipelines de CI/CD, configuração de serving de modelos, painéis de observabilidade e registros de decisão arquitetural (ADRs) explicando cada escolha relevante. Sua equipe de engenharia de plataforma pode implantá-la em staging, executar testes de carga e estendê-la sem ajuda adicional de consultoria. O documento de arquitetura está incorporado nos ADRs, e não entregue como uma apresentação de slides separada que diverge do que foi realmente construído.
Devo construir uma plataforma interna de MLOps ou contratar SageMaker/Vertex AI?
Adquira uma plataforma gerenciada a menos que você tenha 6+ engenheiros dedicados e 12+ meses para alcançar paridade de recursos com o que o SageMaker oferece pronto para uso. Plataformas gerenciadas deixam a desejar em situações específicas: implantações multinuvem ou híbridas, cargas de trabalho que exigem lógica personalizada de serving (modelos ensemble, fluxos agênticos com uso de ferramentas), organizações que evitam aprisionamento tecnológico (vendor lock-in) por motivos regulatórios e equipes cuja economia de inferência torna o serving auto-hospedado substancialmente mais econômico. A auto-hospedagem com vLLM reduz os custos de inferência por token em 60–80% em comparação com APIs em nuvem em escala. Ajudamos você a definir esse limite antes de investir recursos em qualquer um dos caminhos.
Por que 80% dos projetos corporativos de IA não entregam valor?
A análise de 2025 da RAND Corporation estimou a taxa de falha em 80,3%. A falha quase nunca é do modelo. É do sistema ao redor dele: ausência de pipelines de features que causam assimetria entre treinamento e serving (training-serving skew), falta de CI/CD para promoção de modelos, ausência de monitoramento que permite que o desvio do modelo (model drift) passe despercebido por meses e arquiteturas projetadas para o dia da demonstração e não para as operações do dia dois. 42% das empresas abandonaram a maioria de suas iniciativas de IA em 2025, contra 17% em 2024. Implementações de referência que abrangem todo o ciclo de vida operacional, e não apenas o treinamento do modelo, são a forma de evitar entrar para essa estatística.
Qual framework de serving de modelos devo usar: KServe, Triton ou vLLM?
Depende da sua carga de trabalho. O KServe (em incubação na CNCF, v0.15) é a escolha mais sólida para implantações nativas de Kubernetes que necessitam de escalabilidade até zero (scale-to-zero), rollouts canário e o novo Envoy AI Gateway para limitação de taxa de tokens. O vLLM (v0.19, abril de 2026) lidera o serving de LLMs com PagedAttention proporcionando 2–4x mais throughput em relação aos Transformers de referência e loteamento contínuo (continuous batching) que mantém alta utilização de GPU. O NVIDIA Triton se destaca no serving multimodelos intensivo em GPU, onde o desempenho validado pelo MLPerf é prioridade. Muitos sistemas de produção os combinam: KServe como camada de orquestração com vLLM ou Triton como backend. Configuramos a arquitetura para seus padrões específicos de tráfego e requisitos de latência.
Como vocês lidam com a segurança do sistema de IA e com a modelagem de ameaças?
Cada implementação de referência inclui um modelo de ameaças que cobre superfícies de ataque específicas de IA: extração de modelos (consultas repetidas para engenharia reversa de modelos proprietários), inferência de dados de treinamento, entradas adversariais e ataques à cadeia de suprimentos em dependências de modelos. O OWASP LLM Top 10 e o Top 10 para Aplicações Agênticas da OWASP (publicado no fim de 2025) estabelecem a base de referência. Incidentes de segurança relacionados à IA aumentaram 56,4% em 2025, e ataques de ransomware contra infraestrutura de IA dispararam 179% no primeiro semestre de 2025. O modelo de ameaças não é um documento separado. Ele molda a arquitetura: limitação de taxa (rate limiting), validação de entradas, verificação de integridade de artefatos de modelos e varredura de dependências integradas ao pipeline de CI/CD.
Como a IA agêntica altera os requisitos de arquitetura?
Sistemas agênticos exigem infraestrutura que implantações de modelo único não demandam. O MCP (Model Context Protocol) padroniza conexões com ferramentas e dados. O A2A (Agent-to-Agent Protocol) gerencia a comunicação entre agentes. São necessárias camadas de orquestração para decomposição de tarefas, gerenciamento de contexto para fluxos em múltiplos turnos, controles de governança com autonomia delimitada e observabilidade que rastreie ações de agentes em múltiplas etapas em vez de chamadas isoladas de inferência. O Gartner prevê que 40% das aplicações corporativas incorporarão agentes de IA até o fim de 2026. O padrão de produção adotado com sucesso em empresas como Uber, LinkedIn e Klarna utiliza um agente supervisor central com operadores especializados, progresso monitorado e trilhas de auditoria abrangentes.
O que acontece após o término do projeto? Nossa equipe consegue manter o sistema?
Esse é exatamente o objetivo de uma implementação de referência em comparação com uma consultoria de serviços gerenciados. Cada componente é documentado com registros de decisão arquitetural (ADRs) explicando o que foi escolhido, quais alternativas foram avaliadas e o que precisaria mudar caso seus requisitos se alterem. O código fica em seu repositório, a infraestrutura em sua conta de nuvem e o CI/CD é executado em seu pipeline. Projetamos para a equipe que opera o sistema, não para a equipe que construiu o modelo. Padrões de implantação consolidados, monitoramento que emite alertas sobre métricas que sua equipe de operações sabe como tratar e contratos claros de API entre o código do modelo e a infraestrutura de serving. O objetivo é um sistema que não exija os desenvolvedores originais para continuar operando.
Como vocês evitam a assimetria entre treinamento e serving (training-serving skew) em sistemas de ML em produção?
A assimetria entre treinamento e serving (training-serving skew) ocorre quando as features utilizadas durante o treinamento diferem do que o modelo observa na produção. É o assassino silencioso do ML em produção porque o modelo degrada silenciosamente sem gerar erros. Asseguramos a exatidão temporal (point-in-time correctness) nos pipelines de features: os conjuntos de dados de treinamento refletem apenas os dados que estariam disponíveis no momento da previsão. Para cargas de trabalho em lote, validamos jobs de materialização do Feast quanto à integridade do backfill. Para casos de uso em tempo real (detecção de fraudes, precificação dinâmica), as features são computadas no momento da ingestão. O monitoramento de desvio de features (feature drift) é integrado à camada de observabilidade para que sua equipe detecte variações de distribuição antes que afetem a qualidade do modelo.
Como vocês abordam a recuperação de desastres para sistemas de IA?
A recuperação de desastres (DR) em IA é mais complexa do que em aplicações convencionais porque exige restaurar o estado coordenado entre modelos, dados de treinamento, feature stores, pipelines de processamento e ambientes de computação. Nossas implementações de referência incluem procedimentos de rollback de modelos vinculados ao registro de modelos (reversão para a versão de produção anterior em minutos, não horas), recuperação de feature store com consistência temporal, reprodutibilidade de pipelines de treinamento (dados, código, configuração e ambiente versionados) e verificações automatizadas de integridade que detectam a degradação de desempenho do modelo em relação ao baseline de produção e acionam o rollback automaticamente. Organizações que implementam essas práticas relatam 60% menos falhas de recuperação e tempo médio de recuperação (MTTR) 80% mais rápido.
Construa sua IA com confiança.
Faça parceria com uma equipe que tem profunda experiência na construção da próxima geração de IA empresarial. Deixe-nos ajudá-lo a projetar, construir e implementar uma estratégia de IA em que você possa confiar.
Veriprajna consultoria de Deep Tech é especializada na construção de sistemas de IA críticos para a segurança nas áreas de saúde, finanças e domínios regulatórios. Nossas arquiteturas são validadas em relação a protocolos estabelecidos, com documentação de conformidade abrangente.