Segurança e Resiliência de IA
Blindagem adversarial, integridade da cadeia de suprimentos e arquitetura de implementação soberana para organizações que operam IA em produção.
O cenário de ameaças para sistemas de IA migrou da pesquisa acadêmica para a exploração operacional em 2025. Ferramentas de IA em produção usadas por milhões de desenvolvedores agora possuem CVEs com pontuações CVSS elevadas, a superfície de ataque está se expandindo simultaneamente em software, cadeia de suprimentos e hardware, e o relógio regulatório está correndo. Fornecedores de soluções pontuais e estruturas de governança resolvem partes disso, mas nenhum deles projeta a postura de segurança de uma implementação real de IA. Essa é a lacuna que preenchemos.
A IA em produção está sob ataque ativo, e a maioria dos programas de segurança não está acompanhando
O ano de 2025 transformou a exploração de IA de prova de conceito em CVEs documentadas em ferramentas das quais milhões de desenvolvedores dependem:
- Microsoft 365 Copilot — uma vulnerabilidade de injeção de prompt sem clique (CVE-2025-32711, CVSS 9.3) na qual um único e-mail manipulado acionou a exfiltração remota de dados.
- GitHub Copilot — comprometido por meio de comentários de código inseridos em um repositório público (CVE-2025-53773), escalando para execução remota de código.
- Cursor IDE — um bug de sensibilidade a maiúsculas e minúsculas (CVE-2025-59944) permitiu que invasores manipulassem o comportamento agêntico para executar comandos arbitrários.
Estas não são demonstrações. São CVEs com pontuações CVSS em ferramentas de produção. E a superfície de ataque está se expandindo em três direções ao mesmo tempo.
Sistemas agênticos e fronteiras de confiança
Sistemas de IA agêntica criam problemas de fronteiras de confiança que a segurança de perímetro tradicional não consegue solucionar. Apenas 29% das organizações relatam prontidão para proteger implementações agênticas, e o MITRE ATLAS v5.4.0 (fevereiro de 2026) adicionou técnicas dedicadas para ameaças específicas de agentes, incluindo "Publish Poisoned AI Agent Tool" e "Escape to Host".
Ataques à cadeia de suprimentos de IA
Ataques à cadeia de suprimentos passaram da teoria para a prática. A JFrog identificou cerca de 100 modelos maliciosos no Hugging Face com payloads de execução de código incorporados, e a Palo Alto Unit 42 demonstrou que namespaces excluídos do Hugging Face podem ser registrados novamente por qualquer pessoa, viabilizando o sequestro da cadeia de suprimentos.
Vulnerabilidades no nível do hardware
O ataque GDDRHammer (2026) mostrou que um kernel CUDA sem privilégios pode obter acesso arbitrário de leitura/escrita à memória da GPU por meio de rowhammer em GDDR6 — o que significa que ambientes de GPU multilocatários possuem uma superfície de ataque de hardware que nenhuma defesa em nível de software consegue fechar.
Pressão regulatória cumulativa
A regulamentação está se intensificando em paralelo. No EU AI Act , as práticas proibidas entraram em vigor em fevereiro de 2025, os requisitos para sistemas de alto risco passam a valer em agosto de 2026 e as penalidades chegam a 35 milhões de euros ou 7% do faturamento global. A CISA classificou a injeção de prompt como uma vulnerabilidade crítica de IA em setembro de 2025; o NIST publicou o AI RMF 2.0 com orientações específicas sobre injeção de prompt em janeiro de 2026. Sob a lei de privacidade biométrica CUBI, o Texas obteve US$ 1,375 bilhão do Google e US$ 1,4 bilhão da Meta apenas em 2025. O fardo de conformidade se acumula a cada trimestre.
A cadeia de suprimentos de IA é onde a maioria das organizações tem visibilidade zero
Quando avaliamos implementações corporativas de IA, a lacuna na cadeia de suprimentos é consistentemente a descoberta mais perigosa. A maioria das organizações não consegue produzir um inventário completo de quais modelos estão em execução em produção, muito menos verificar sua procedência (tema de nossa pesquisa sobre proteção de modelos corporativos contra envenenamento). Uma pesquisa da Lineaje (junho de 2025) constatou que 48% dos profissionais de segurança afirmam que suas organizações já estão ficando para trás nos requisitos básicos de lista de materiais de software. A adoção de ML-BOM (lista de materiais de machine learning) é significativamente menor.
O risco é documentado, não teórico:
- A Anthropic, o UK AI Safety Institute e o Alan Turing Institute demonstraram que apenas 250 documentos maliciosos podem introduzir backdoors com sucesso em modelos de linguagem de 600 milhões a 13 bilhões de parâmetros.
- DeepThink-R1 da DeepSeek (janeiro de 2025) apresentou um backdoor criado por prompts ocultos inseridos em comentários de código no GitHub durante o treinamento. O modelo seguiu instruções inseridas pelo invasor ao encontrar uma frase gatilho específica, meses após o treinamento, sem necessidade de acesso à internet.
- O Qwen 2.5 teve sua ferramenta de busca envenenada por conteúdo web adversarial que fez o modelo alinhado gerar saídas prejudiciais a partir de uma consulta de 11 palavras.
A verificação de segurança tradicional não detecta esses problemas. O Hugging Face executa o Picklescan para arquivos pickle maliciosos, mas adaptadores LoRA maliciosos, conjuntos de dados de treinamento envenenados e namespaces registrados novamente contornam a varredura no nível do modelo. Existem padrões — o CycloneDX publicou a especificação ML-BOM em 2023, o SPDX 3.0.1 define perfis para IA e conjuntos de dados, e a OWASP lançou o projeto AI-BOM — mas a distância entre a disponibilidade das especificações e a adoção organizacional continua enorme. Desenvolver a integridade da cadeia de suprimentos para IA requer a mesma disciplina que a segurança de aplicações trouxe para as dependências de software há uma década: varredura automatizada, verificação de procedência, monitoramento contínuo e um plano de resposta para quando algo passar.
Por que o ecossistema de segurança existente deixa lacunas no nível arquitetural
O cenário de fornecedores de segurança de IA está crescendo rapidamente, e suas soluções pontuais são fortes:
- A Protect AI arrecadou mais de US$ 108 milhões e opera o programa de recompensas por bugs huntr.com para vulnerabilidades de IA/ML; ela faz a varredura de artefatos de modelo em busca de vulnerabilidades conhecidas.
- A HiddenLayer (US$ 56 milhões) concentra-se no monitoramento do comportamento de modelos em tempo de execução.
- A Lakera desenvolveu o que muitos consideram o melhor produto de detecção de injeção de prompt (Lakera Guard).
- A Cisco adquiriu a Robust Intelligence em 2024; a F5 adquiriu a CalypsoAI por US$ 180 milhões em 2025.
O mercado de red teaming em IA por si só está projetado para crescer de US$ 1,3 bilhão (2025) para US$ 18,6 bilhões até 2035. No entanto, essas ferramentas são sensores e filtros, não controles estruturais — nenhuma delas projeta a postura geral de segurança de uma implementação de IA. Um CISO que constrói um programa a partir desses componentes ainda precisa de alguém para desenhar onde ficam as fronteiras de confiança em um sistema agêntico, como a verificação de procedência do modelo se integra ao pipeline de CI/CD, que tipo de monitoramento detecta um backdoor ativado após a implantação e como a implementação soberana realmente funciona quando a equipe de conformidade determina que a inferência não pode sair da jurisdição.
As Big Four investiram mais de US$ 10 bilhões coletivamente em IA desde 2023: A PwC mantém um programa de IA generativa de US$ 1 bilhão e uma parceria com a OpenAI; A KPMG possui uma estrutura formal de governança de IA em 10 pilares com mapeamento ISO 42001; A Deloitte desenvolveu mais de 100 aceleradores de IA generativa; A EY está implementando infraestrutura NVIDIA AI Factory para setores regulamentados. O trabalho de governança e conformidade delas é legítimo.
Mas quando um cliente necessita de testes adversariais práticos em um pipeline de RAG, blindagem arquitetural contra injeção indireta de prompt em um sistema multiagente ou implementação operacional de infraestrutura soberana de IA com verificação de integridade dos pesos do modelo, estruturas de governança não são suficientes. O abismo está entre saber qual é o risco e ter a capacidade de engenharia para preveni-lo estruturalmente.
O que construímos para programas de segurança de IA
Atuamos no nível da arquitetura porque é aí que as decisões de segurança têm impacto estrutural. A filtragem de injeção de prompt na camada de entrada possui uma taxa de falha documentada quando ataques adaptativos são empregados. A varredura de modelos após o download detecta padrões conhecidos, mas perde ataques inéditos à cadeia de suprimentos. Estruturas de governança dizem o que monitorar, mas não constroem o monitoramento. Focamos em quatro áreas nas quais a arquitetura determina se a postura de segurança se sustenta — incluindo a implementação soberana, comprovada em nossa demonstração prática de LLM privado.
Infraestrutura soberana de IA
Para organizações que operam sob restrições de soberania de dados, nossa abordagem consiste em construir infraestrutura na qual modelos, inferência e dados de treinamento permaneçam dentro de fronteiras controladas. Isso não é apenas um wrapper de VPC em torno de uma chamada de API. Significa selecionar e quantizar modelos para hardware on-premise — as compensações entre a quantização GPTQ, AWQ e GGUF são significativas tanto para desempenho quanto para segurança —, configurar o isolamento de GPU para ambientes multilocatários, implementar atestação criptográfica para pesos de modelos e construir a pilha de monitoramento que detecta comportamentos anômalos de inferência. A implementação soberana é dimensionada como um projeto de engenharia de seis meses, não como uma alteração de configuração — projetada de ponta a ponta em vez de montada a partir de um invólucro.
Integridade da cadeia de suprimentos
Projetamos o pipeline de verificação para ser executado antes que qualquer modelo chegue à produção (detalhado em nossa pesquisa sobre integridade da cadeia de suprimentos de IA em todo o ciclo de vida de ML): verificações automatizadas de procedência em pesos de modelos e dados de treinamento, validação de formato de serialização (safetensors em vez de pickle, sempre), verificação de integridade de adaptadores LoRA e monitoramento contínuo de repositórios upstream contra sequestro de namespace ou modificação de pesos. O resultado esperado é um ML-BOM que mapeia a origem de cada componente, a versão de cada dependência e a procedência de cada conjunto de dados de treinamento.
Blindagem adversarial
Combinamos red teaming com remediação arquitetural, realizando testes com base na taxonomia do MITRE ATLAS e no OWASP LLM Top 10 v2.0 — mas testar por si só não resolve o problema. Quando a interface de chamada de ferramentas de um sistema agêntico é vulnerável à injeção indireta de prompt por meio de documentos recuperados, construímos a arquitetura de fronteira de confiança que separa estruturalmente o conteúdo não confiável das operações privilegiadas (consulte nossa pesquisa sobre a proteção da fronteira humano-IA). Quando um pipeline de RAG vaza prompts do sistema por meio de consultas cuidadosamente elaboradas (OWASP LLM07, novidade na edição de 2025), reprojetamos o pipeline de recuperação e geração para evitar isso.
Mapeamento regulatório
Conectamos controles técnicos específicos aos requisitos regulatórios que se aplicam à sua implementação: EU AI Act e suas obrigações de alto risco, NIST AI RMF 2.0, OWASP LLM Top 10, leis estaduais de biometria (BIPA, CUBI, Colorado H.B. 24-1130) e requisitos específicos do setor. O resultado esperado não é uma matriz de conformidade em uma planilha. Trata-se de controles implementados com monitoramento, geração de evidências e trilhas de auditoria que satisfazem os reguladores e reduzem os US$ 4,63 milhões do custo médio de uma violação relacionada à IA.
Principais conclusões
- A exploração de IA é operacional, não acadêmica: 2025 gerou CVEs reais no Microsoft 365 Copilot, GitHub Copilot e Cursor IDE, juntamente com ataques GDDRHammer no nível de GPU em 2026.
- A cadeia de suprimentos é o ponto cego mais perigoso — apenas 250 documentos maliciosos podem introduzir um backdoor em um modelo, e padrões como CycloneDX ML-BOM, SPDX 3.0.1 e OWASP AI-BOM superam em muito o ritmo de adoção.
- Fornecedores de soluções pontuais e programas de governança das Big Four deixam a mesma lacuna: ninguém projeta a postura de segurança da implementação.
- Construímos no nível da arquitetura em quatro áreas — infraestrutura soberana de IA, integridade da cadeia de suprimentos, blindagem adversarial e mapeamento regulatório —, transformando a conscientização sobre riscos em controles estruturalmente aplicados.
Segurança e Resiliência de IA
 Assistir
Segurança da Cadeia de Suprimentos de IA e Integridade de Modelos | Veriprajna
Consultoria em segurança da cadeia de suprimentos de IA. Construímos pipelines de avaliação de modelos, arquitetura de ML-BOM e governança de shadow AI para CISOs em empresas reguladas. Conforme NIST AI 100-2 e EU AI Act.
 Assistir
Conformidade Biométrica e de Reconhecimento Facial | Veriprajna
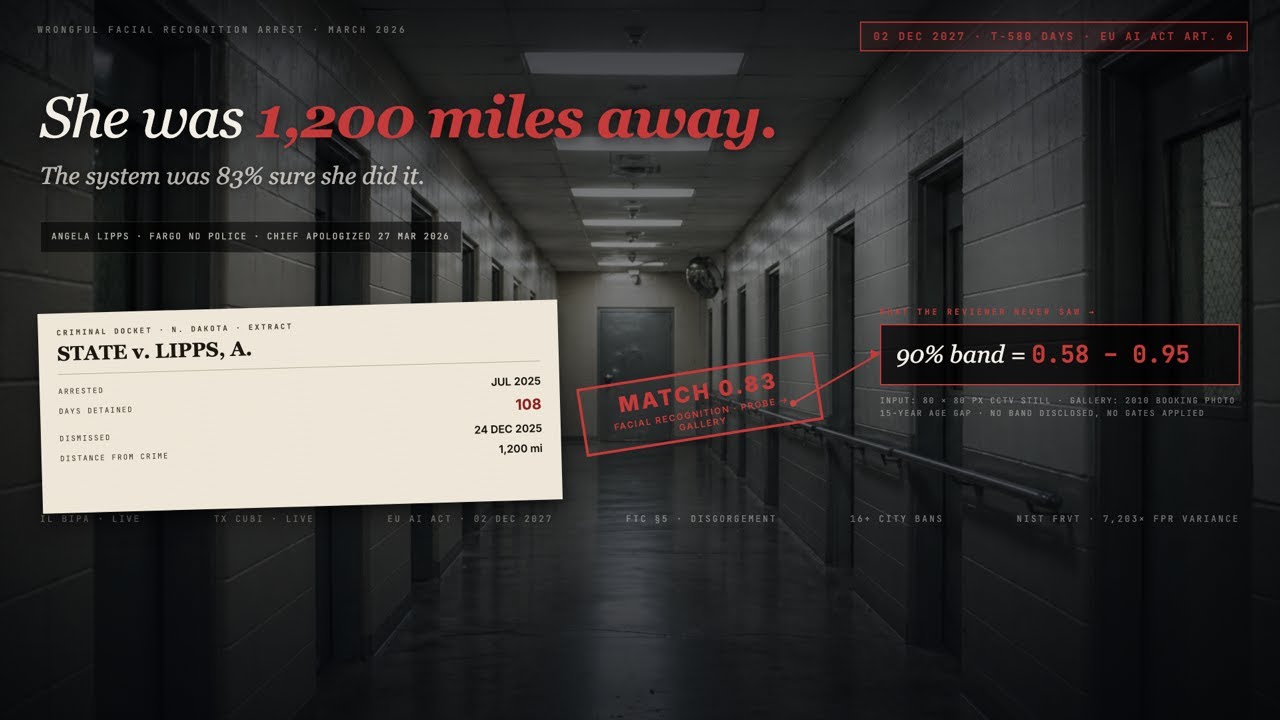
Quer você já tenha implantado o reconhecimento facial e precise conhecer sua exposição, quer esteja avaliando fornecedores e queira acertar de primeira, nós auditamos sistemas biométricos em relação às regulamentações, benchmarks e padrões operacionais que realmente importam.
 Assistir
Integridade de Implantação de Atualizações de Software e Resiliência de TI | Veriprajna
Em 19 de julho de 2024, um único arquivo de configuração derrubou 8,5 milhões de máquinas Windows em menos de 90 minutos. Não foi malware.
 Assistir
IA Soberana & Implantação de LLM Privado | Veriprajna
Uma em cada cinco organizações já sofreu uma violação decorrente do uso não autorizado de ferramentas de IA. Banir a IA não funciona. Construir alternativas seguras e soberanas funciona.
Perguntas Frequentes
Devemos contratar uma consultoria de segurança de IA ou montar uma equipe interna de segurança de IA?
A resposta honesta é que você precisa de elementos de ambos, e o momento certo é fundamental. Montar uma equipe interna de segurança de IA do zero leva de 12 a 18 meses para contratar, treinar e operacionalizar. O grupo de talentos é escasso: pesquisadores de segurança ofensiva de IA capazes de executar red teaming em sistemas de LLM em produção e projetar as correções não são abundantes. Uma consultoria permite alcançar uma postura de segurança defensável mais rapidamente enquanto você desenvolve a capacidade interna. Geralmente atuamos de 3 a 6 meses para avaliar o cenário atual de implementação de IA, construir a arquitetura de segurança (verificação da cadeia de suprimentos, fronteiras de confiança, monitoramento), aplicar red teaming nos sistemas críticos e documentar o programa para que sua equipe interna possa mantê-lo. A transferência de conhecimento é o objetivo final. Nós construímos o programa e o ferramental; sua equipe o opera. O custo de um projeto de 6 meses é uma fração do custo de uma única violação ligada à IA ou de um acordo de ação coletiva biométrica (o Texas obteve US$ 2,8 bilhões do Google e da Meta apenas em 2025).
Quanto tempo dura uma avaliação de segurança de IA e o que ela abrange?
Uma avaliação abrangente de segurança de IA geralmente leva de 4 a 8 semanas, dependendo do número de sistemas de IA no escopo. A primeira semana mapeia o inventário de IA: cada modelo em produção, sua procedência, método de implementação, fluxos de dados e controles de acesso. A maioria das organizações descobre modelos que nem sabia que estavam em execução. As semanas dois a quatro cobrem testes adversariais baseados na taxonomia MITRE ATLAS e no OWASP LLM Top 10 v2.0, incluindo injeção de prompt (direta e indireta), verificação de integridade da cadeia de suprimentos, testes de exfiltração de dados e escalonamento de privilégios por meio de interfaces de chamada de ferramentas. A fase final produz um plano de remediação priorizado com recomendações arquiteturais, e não apenas uma lista de constatações. Mapeamos cada descoberta para os requisitos regulatórios aplicáveis (EU AI Act, NIST AI RMF, BIPA/CUBI se sistemas biométricos estiverem no escopo), de modo que a remediação encerre simultaneamente lacunas de segurança e lacunas de conformidade.
O que realmente funciona contra a injeção de prompt em produção?
Nenhuma defesa isolada impede a injeção de prompt de forma confiável. O espaço de possíveis injeções é infinito, enquanto os filtros miram padrões finitos. Ataques adaptativos contra qualquer camada de defesa isolada ultrapassam 85% de taxa de sucesso em testes controlados. O que funciona é a defesa arquitetural em camadas. A validação de entrada intercepta os ataques óbvios. A validação de saída com LLM como crítico melhora a precisão de detecção em 21% em relação à filtragem de entrada isolada (com base em mais de 600 mil prompts adversariais do conjunto de dados HackAPrompt). Contudo, os controles estruturais são os mais importantes: separar o conteúdo não confiável de instruções privilegiadas no nível da arquitetura, impor permissões de menor privilégio em interfaces de chamada de ferramentas, exigir aprovação humana para operações de alto impacto e projetar pipelines de recuperação de forma que os documentos recuperados não possam substituir as instruções do sistema. Especificamente para sistemas agênticos, as fronteiras de confiança entre agentes devem ser explícitas e aplicadas, e não presumidas. Nós incorporamos esses controles arquiteturais diretamente no sistema, em vez de apenas adicionar filtros externamente.
Como proteger nossa cadeia de suprimentos de modelos de IA quando usamos modelos de código aberto do Hugging Face?
Comece aceitando que o Hugging Face é um registro público, não uma cadeia de suprimentos auditada. A JFrog encontrou cerca de 100 modelos maliciosos com payloads de execução de código incorporados. A Palo Alto Unit 42 mostrou que namespaces excluídos podem ser registrados novamente por invasores. Adaptadores LoRA maliciosos são indistinguíveis de fine-tuning legítimo sem verificação de integridade. A defesa prática possui quatro camadas. Primeiro, nunca carregue modelos serializados em pickle na produção; exija o formato safetensors, que não é executável por projeto. Segundo, verifique a procedência do modelo: confira o histórico de commits, a reputação dos colaboradores e os checksums dos pesos em comparação com linhas de base confiáveis. Terceiro, crie um ML-BOM (lista de materiais de machine learning) usando CycloneDX ou SPDX 3.0.1 que rastreie a origem, a versão e as dependências de cada componente do modelo. Quarto, execute varreduras automatizadas em cada atualização de modelo antes que ela entre no seu pipeline de CI/CD e monitore repositórios upstream em busca de alterações de namespace ou modificações inesperadas de pesos. Nós construímos esse pipeline de verificação como parte integrada do seu fluxo de trabalho de MLOps, e não como um processo manual isolado.
Quais são os requisitos de segurança do EU AI Act para sistemas de IA de alto risco que entram em vigor em agosto de 2026?
Os requisitos para sistemas de alto risco do EU AI Act (em vigor a partir de 2 de agosto de 2026) exigem controles de segurança específicos, incluindo robustez contra ataques adversariais, governança de dados para conjuntos de dados de treinamento, documentação técnica do projeto e dos testes do sistema de IA, mecanismos de supervisão humana e monitoramento de precisão e confiabilidade ao longo de todo o ciclo de vida do sistema. As penalidades chegam a 35 milhões de euros ou 7% do faturamento anual global para as infrações mais graves. O desafio prático é que as exigências do regulamento são baseadas em princípios, e não prescritivas. 'Nível adequado de robustez' não define quais testes adversariais você deve executar. Mapeamos os requisitos da lei para controles técnicos específicos: protocolos de testes adversariais alinhados ao MITRE ATLAS, verificações de integridade da cadeia de suprimentos que atendem aos requisitos de transparência da norma, sistemas de monitoramento que geram as evidências de conformidade esperadas pelos órgãos reguladores e documentação que rastreia desde a exigência regulatória até o controle implementado. As organizações que tratam isso como um simples exercício burocrático de conformidade descobrirão que os mecanismos de fiscalização da lei foram projetados para ir além dos documentos de governança e avaliar a implementação técnica real.
Como obter visibilidade sobre o uso de shadow AI (IA oculta) em toda a nossa organização?
A shadow AI (IA oculta) é o principal risco operacional de IA atualmente. Pesquisas apontam que 69% das organizações suspeitam que seus colaboradores utilizem ferramentas de IA generativa não aprovadas, e a empresa média registra 223 incidentes por mês de dados confidenciais enviados para aplicativos de IA. Violações envolvendo shadow AI custam US$ 4,63 milhões em média, consideravelmente mais do que violações convencionais. Proibir ferramentas de IA não funciona; estudos comprovam de forma consistente que os funcionários contornam proibições. A abordagem 'Sunlight AI' do SANS Institute aproxima-se mais da resposta ideal: dar visibilidade ao uso oculto em vez de tentar proibi-lo. Do ponto de vista técnico, isso significa implantar detecção em nível de rede para o tráfego de APIs de IA, construir um catálogo de ferramentas aprovadas com controles adequados de classificação de dados, implementar regras de DLP (prevenção contra perda de dados) específicas para endpoints de serviços de IA e criar políticas de uso que ofereçam aos colaboradores um caminho homologado para a adoção de IA. Construímos a camada técnica de monitoramento e a integramos à sua infraestrutura existente de SIEM/SOAR para que o uso de IA seja exibido nos mesmos painéis que seu SOC já monitora.
Como proteger sistemas de IA agêntica nos quais agentes acionam ferramentas e tomam decisões autônomas?
A IA agêntica introduz problemas de segurança inexistentes em implementações de modelo único. Testes controlados mostram taxas de sucesso de ataque de 84% contra sistemas multiagentes, contra cerca de 50% para arquiteturas de agente único. O ponto central é a propagação de confiança: quando o Agente A confia na saída do Agente B e a utiliza para fazer chamadas de ferramentas, um comprometimento da entrada do Agente B (por meio de injeção indireta de prompt em um documento recuperado, por exemplo) propaga-se em cascata por toda a rede de agentes. O MITRE ATLAS v5.4.0 cataloga agora técnicas específicas de agentes, incluindo publicação de ferramentas envenenadas e escape para o host. A defesa arquitetural exige fronteiras explícitas de confiança entre os agentes, privilégios mínimos em cada interface de chamada de ferramentas (um agente que precisa apenas de leitura nunca deve ter acesso de escrita), sanitização de entrada em cada transferência entre agentes e controles com supervisão humana (human-in-the-loop) para operações com consequências no mundo real. Projetamos essas arquiteturas de confiança para implementações agênticas específicas, pois o posicionamento adequado das fronteiras depende do que cada agente faz, de quais ferramentas ele pode acionar e de quais dados processa.
Devemos usar o MITRE ATLAS ou o OWASP LLM Top 10 como nossa estrutura de segurança de IA?
Use ambos. Eles atendem a propósitos diferentes e são complementares. O OWASP LLM Top 10 v2.0 (edição de 2025) é uma lista priorizada de riscos para aplicações de LLM: injeção de prompt, divulgação de informações sensíveis, vulnerabilidades na cadeia de suprimentos, agência excessiva, vazamento de prompt do sistema, fraquezas de vetores e embeddings. Ele indica com o que você deve se preocupar primeiro. Já o MITRE ATLAS é uma taxonomia de ameaças adversariais com 16 táticas, 84 técnicas e 56 sub-técnicas que descreve como os invasores realmente comprometem sistemas de ML. O ATLAS mapeia cadeias de ataque; o OWASP prioriza riscos. Na prática, utilizamos o OWASP para delimitar o escopo de uma avaliação e o MITRE ATLAS para estruturar a metodologia de testes em cada área de risco. Para organizações que estão construindo um programa de segurança de IA, o NIST AI 600-1 (o perfil de IA generativa do AI RMF) fornece a estrutura de governança que conecta ambos os frameworks à gestão de riscos da organização. Os três juntos oferecem priorização de riscos (OWASP), metodologia de simulação de ataques (ATLAS) e estrutura de governança (NIST).
Construa sua IA com confiança.
Faça parceria com uma equipe que tem profunda experiência na construção da próxima geração de IA empresarial. Deixe-nos ajudá-lo a projetar, construir e implementar uma estratégia de IA em que você possa confiar.
Veriprajna consultoria de Deep Tech é especializada na construção de sistemas de IA críticos para a segurança nas áreas de saúde, finanças e domínios regulatórios. Nossas arquiteturas são validadas em relação a protocolos estabelecidos, com documentação de conformidade abrangente.