Detecção de Conteúdo Sintético & Avaliações Falsas
O Campaign Firewall mostra como evidências de relacionamento podem apoiar uma rota de revisão humana quando apenas a redação não detecta o padrão. Todas as avaliações e históricos de contas mostrados aqui são sintéticos.
4 de 15
Sinalizadas pela linha de base local baseada apenas em texto
Campanha totalmente humana modelada, mesmo conjunto de dados de teste
15 de 15
Encaminhadas para revisão humana pelo ensemble
Registros sintéticos, sem ação na plataforma
105 pares de contas
Vinculados por histórico compartilhado de produtos
Evidências de relacionamento no mesmo cluster
Estas observações do conjunto de dados de teste explicam uma escolha de projeto. Ambos os métodos usam percentis de texto derivados do corpus, e o limiar de revisão do ensemble foi ajustado com base nos mesmos rótulos; isso não representa desempenho em dados não vistos.
Uma equipe de proteção de marca precisa saber por que as avaliações parecem relacionadas antes de decidir o que encaminhar. Uma redação fluente por si só não comprova que as contas agiram de forma independente, e uma opinião negativa isolada não comprova fraude.
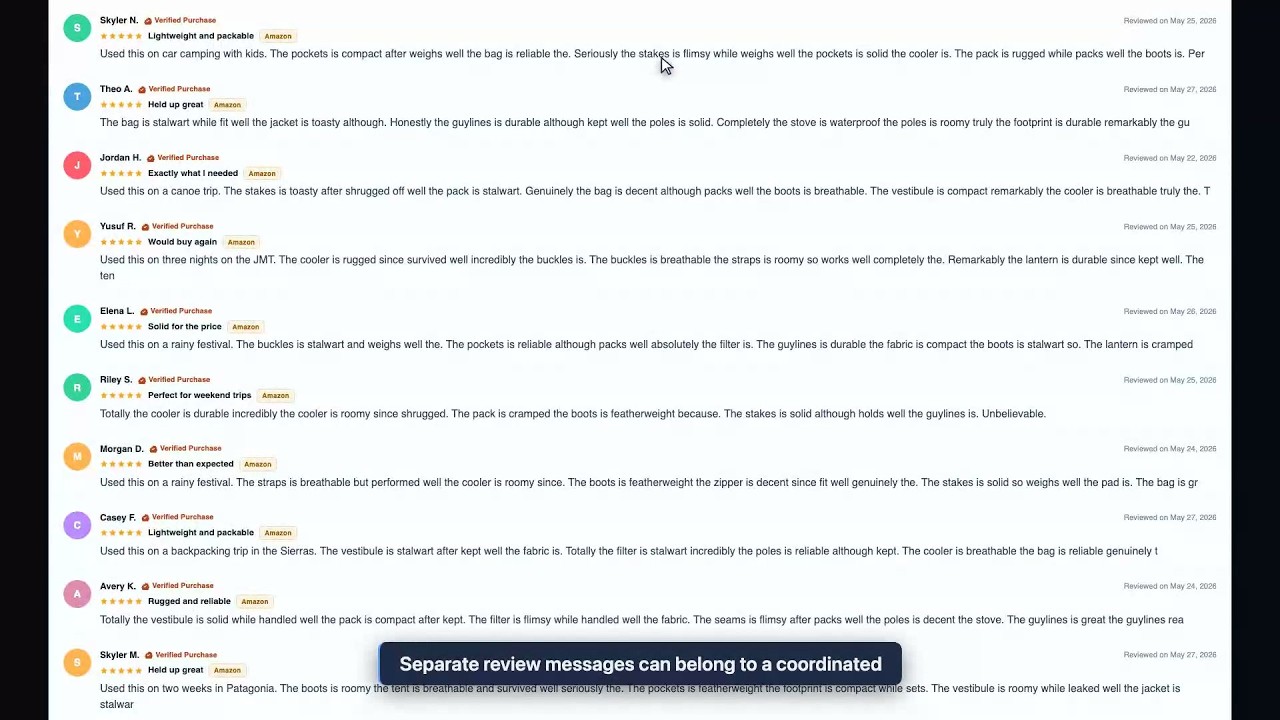
Nosso exemplo sintético modela uma campanha de 15 avaliações no anúncio de um concorrente. Onze registros apresentam pouca anomalia estilométrica, mas seus históricos de produtos sobrepostos conectam as contas. A linha de base local baseada apenas em texto sinaliza quatro das 15; o ensemble encaminha todas as 15 para revisão.
Essa rota preserva a incerteza. O rótulo modelado de totalmente humano é a verdade fundamental do conjunto de dados de teste, não evidência de que pessoas reais escreveram essas avaliações ou de que alguém foi pago.
Padrões de escrita, comportamento da conta, pico temporal e relacionamentos entre contas contribuem para uma pontuação heurística com limite máximo. O conjunto de dados de teste modela 90 dias de histórico; o detector temporal examina janelas de pico de 72 horas. A pontuação não é uma probabilidade calibrada.
Dispositivos compartilhados ou históricos de produtos com sobreposição suficiente criam arestas no grafo. A sobreposição de produtos exige pelo menos 0,5 de similaridade de Jaccard dentro do mesmo anúncio e no máximo 72 horas entre os registros. O fator temporal isolado não cria vínculo.
Componentes conectados se tornam clusters de campanha quando o tamanho e a coesão atendem às regras configuradas. A pontuação determinística atribui elegibilidade CLEAR, REVIEW ou AUTO modelada antes que uma narrativa seja redigida. REVIEW permanece uma rota para julgamento humano, não uma investigação concluída.
A investigação registrada reproduz uma resposta em cache do Codex após a pontuação. Um filtro determinístico verifica números, sobreposição de tokens e reversões de veredito; ele não valida cada frase mantida como verdadeira. O JSON retém a associação à campanha, pontuações numéricas dos componentes e um rascunho de contestação não protocolado. O HTML imprimível mostra o perfil da campanha, nomes dos sinais por avaliação e o rascunho; ele não exibe detalhamentos numéricos dos componentes.
O grafo usa agrupamento interpretável por componentes conectados. Nenhuma rede neural de grafos treinada ou integração com plataforma de produção está implementada nesta demonstração.
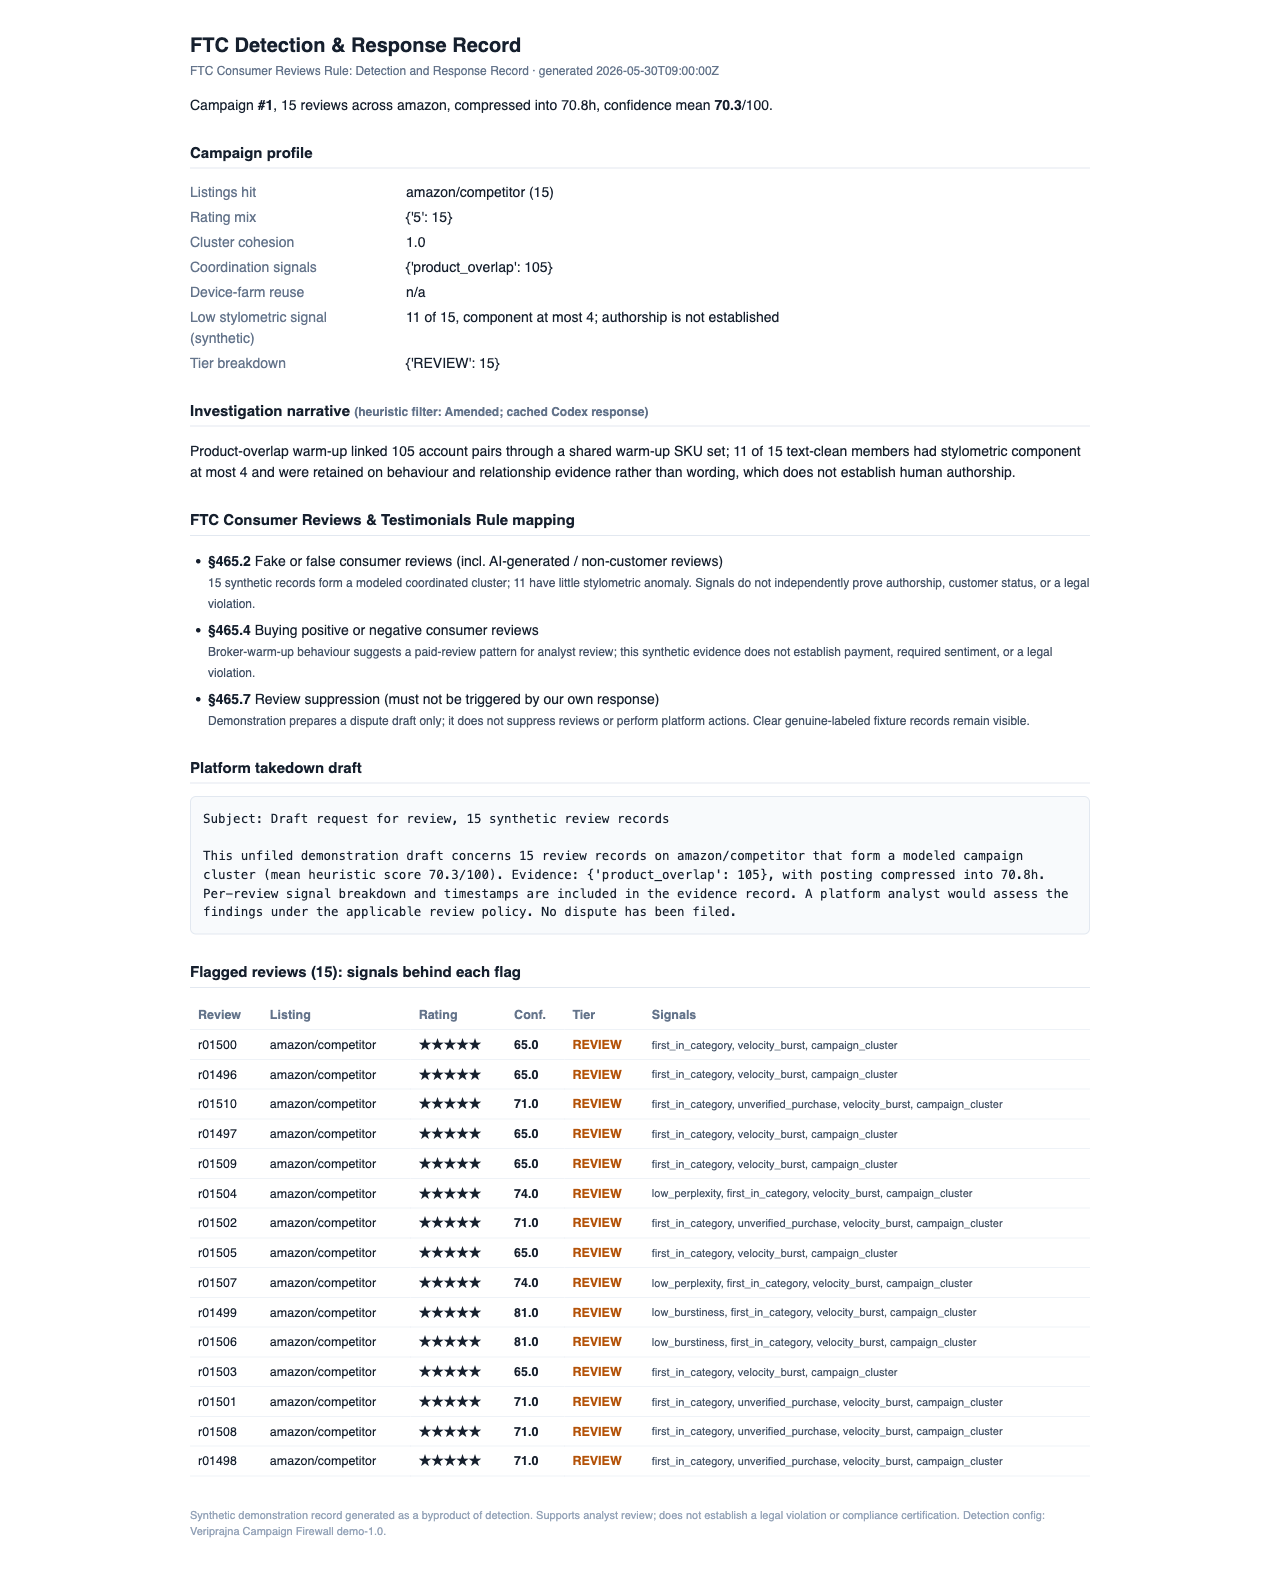
Todas as avaliações, históricos de contas, dispositivos e feeds de plataformas nestas capturas reais do aplicativo são sintéticos. O exemplo principal acompanha 15 avaliações modeladas de concorrentes, desde a identificação da campanha, passando pela rota de revisão humana, até o registro exportado.
O conjunto de dados de teste rotula este caso como uma campanha paga totalmente humana, mas nem a autoria nem o pagamento são determinados pelo detector. Onze de suas 15 avaliações têm componente estilométrico no máximo 4: pouca anomalia de padrão de escrita nesta implementação. Seus históricos de contas fornecem a razão para examiná-las em conjunto.
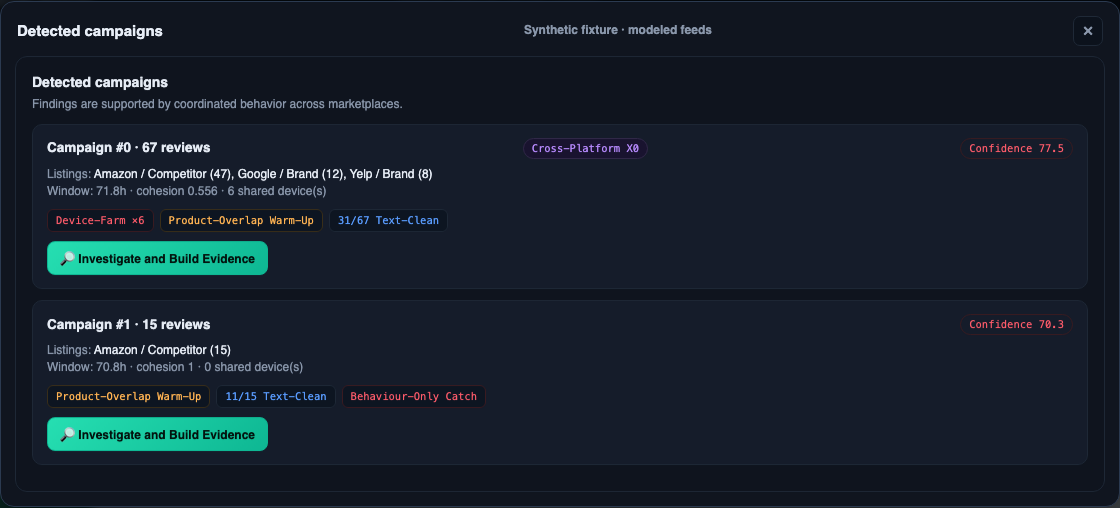
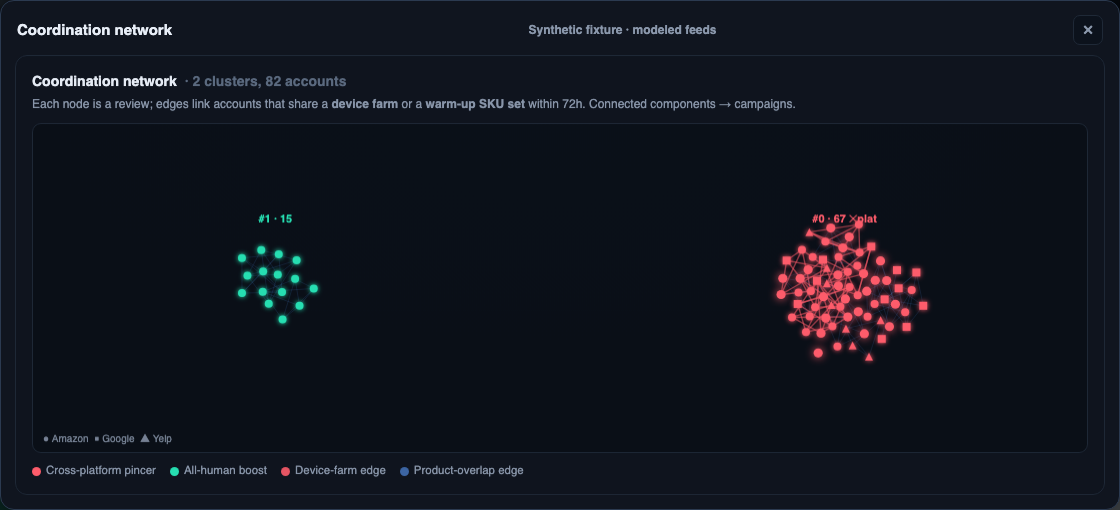
As 15 avaliações compartilham históricos de produtos com sobreposição suficiente no mesmo anúncio dentro do limite configurado de 72 horas. Isso cria 105 arestas de pares com sobreposição de produtos, vinculando cada par no cluster, com coesão 1,0. Não há arestas de dispositivos compartilhados neste caso; a constatação não depende de reutilização de dispositivos. O fator temporal isolado não criaria uma aresta.
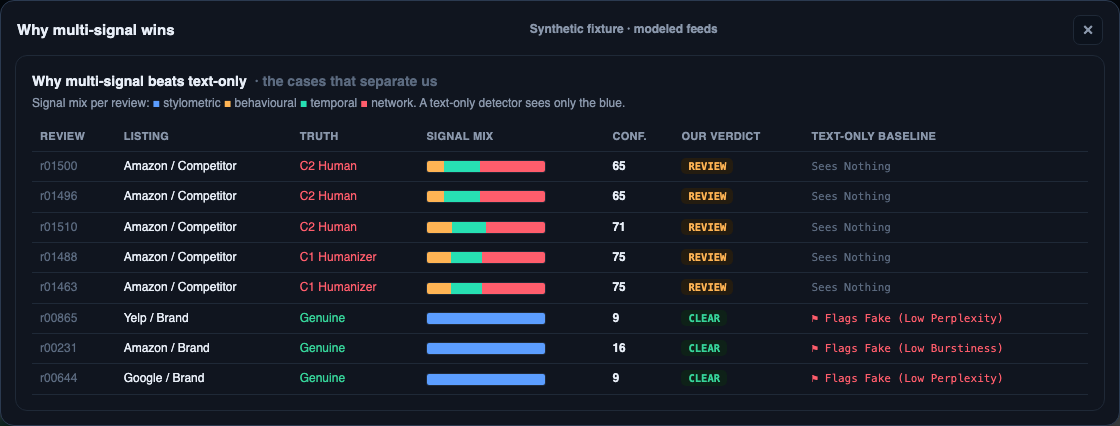
A linha de base local baseada apenas em texto sinaliza quatro dos 15 registros. Ela, portanto, não atinge a detecção em nível de campanha sob a regra deste arcabouço de teste, que exige que pelo menos 60% de um rótulo implantado seja sinalizado. O ensemble combina componentes de escrita, comportamento, temporais e de rede, encaminhando todas as 15 para REVIEW, em vez de AUTO.
| Evidência ou decisão | Resultado observado | Interpretação |
|---|---|---|
| Sinal de padrão de escrita | 11 de 15 têm componente estilométrico no máximo 4 | Baixa anomalia não é um certificado de autoria humana. |
| Relacionamento entre contas | 105 arestas de pares com sobreposição de produtos; nenhuma aresta de dispositivo compartilhado | Um padrão de histórico compartilhado justifica examinar as contas em conjunto. |
| Linha de base local baseada apenas em texto | 4 de 15 sinalizadas | Este comparador implementado não detecta a campanha sob a regra de 60%. |
| Rota do ensemble | 15 REVIEW; 0 AUTO | Todas as 15 são encaminhadas para julgamento humano. Nenhuma avaliação é removida. |
A pontuação determinística define os níveis antes que o modelo opcional descreva a constatação. A investigação registrada reproduz uma resposta em cache da ponte real do Codex. Seu filtro de fundamentação verifica números, sobreposição de tokens e reversões de veredito; o texto retido ainda necessita de revisão do analista e não pode alterar a pontuação ou o nível.
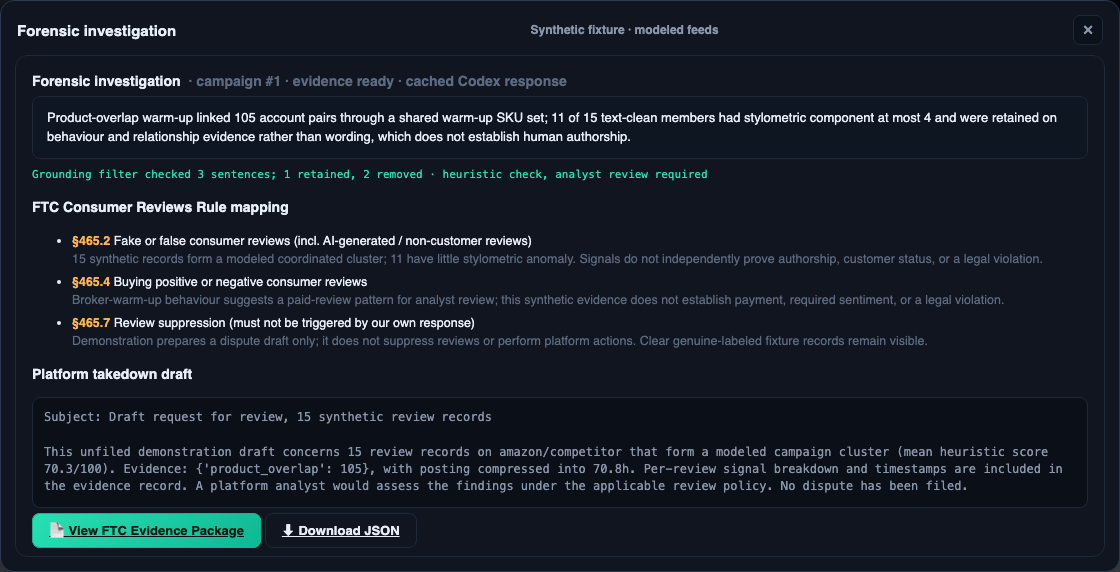
A exportação real em JSON retém a associação à campanha, detalhamento de níveis, sinais contribuintes e as pontuações dos componentes de cada registro. O HTML imprimível renderiza um perfil da campanha, a narrativa em cache, mapeamento indicativo de regras, um rascunho de contestação não protocolado e todas as 15 linhas sinalizadas. Um analista pode verificar por que um registro foi encaminhado em vez de confiar apenas na narrativa. O rascunho de contestação nativo superestima a cobertura de data e hora: o JSON e o relatório imprimível incluem o registro de data e hora de geração do registro, mas nenhum registro de data e hora por avaliação. Esses precisariam ser adicionados e verificados antes do uso externo.
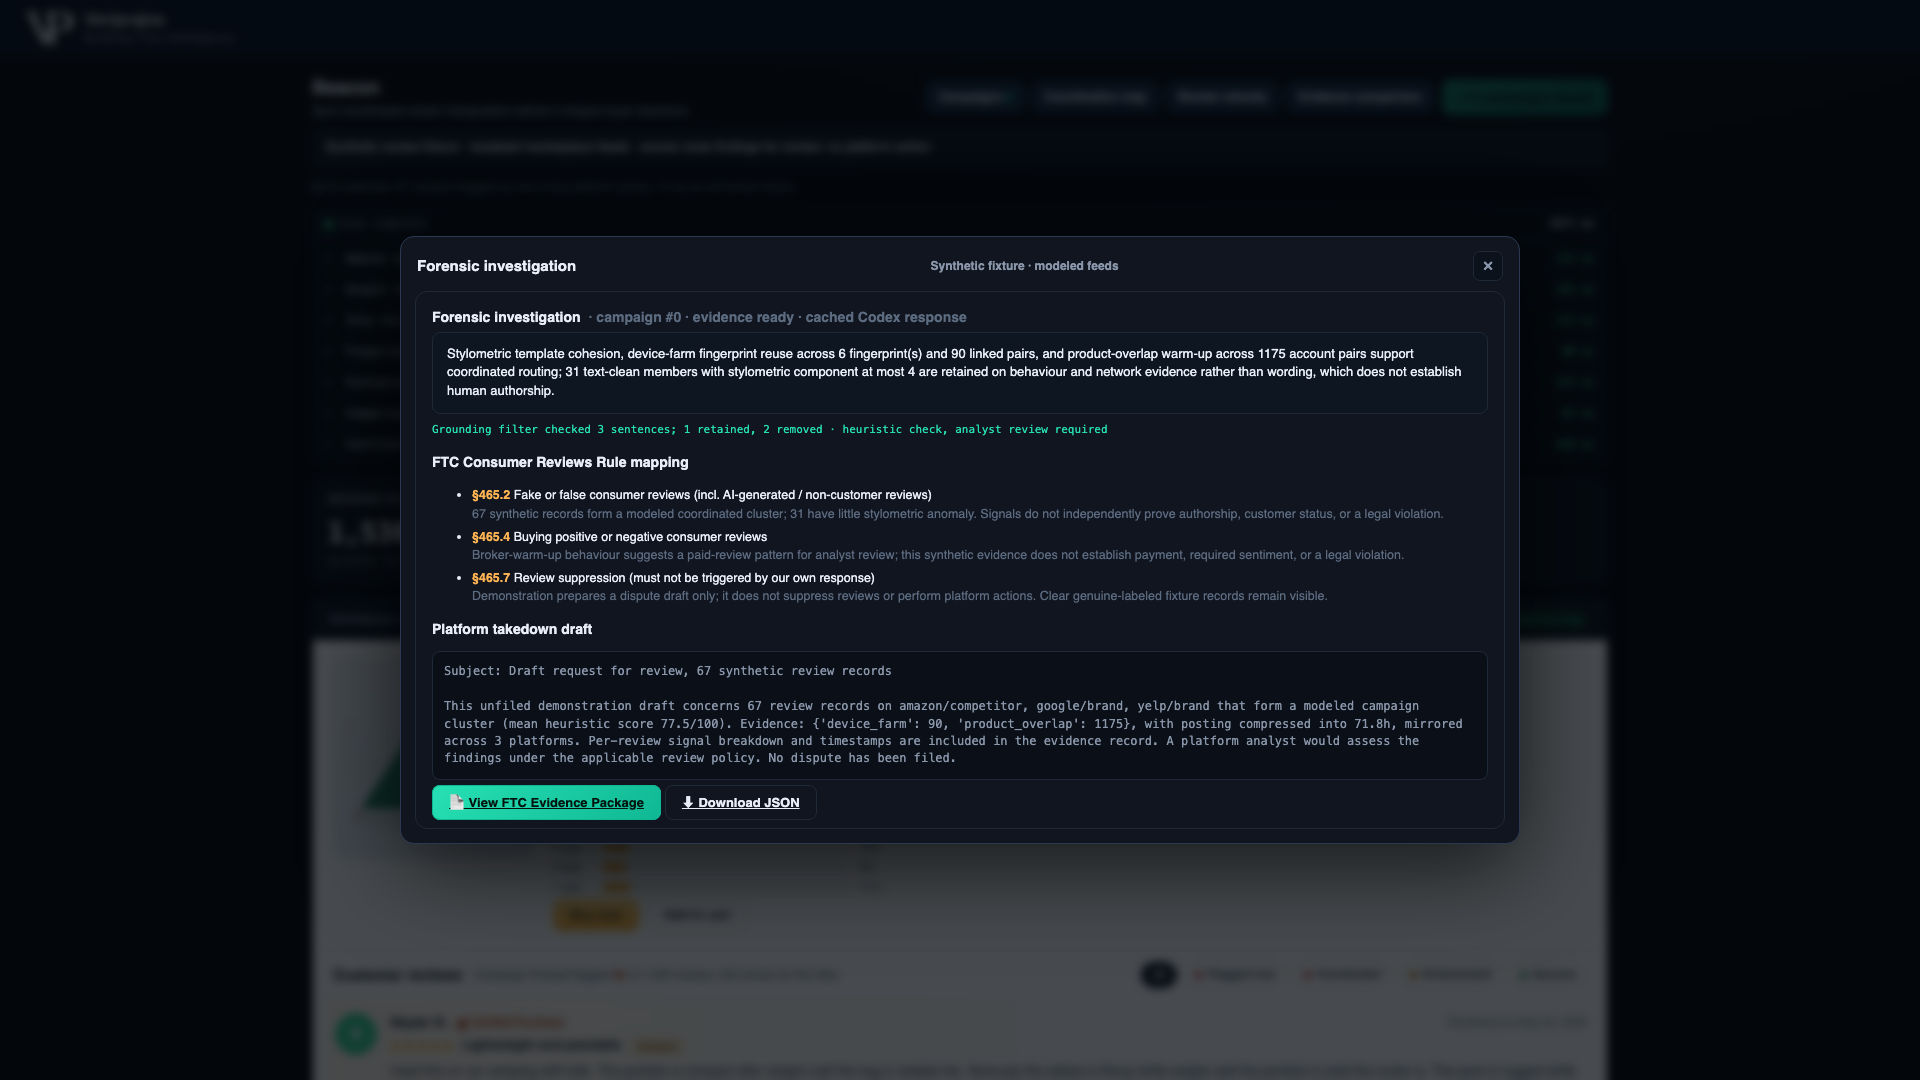
Um cluster sintético separado vincula 67 registros: 47 avaliações de cinco estrelas no anúncio modelado do concorrente na Amazon, além de 12 avaliações no Google e oito no Yelp direcionadas à marca modelada. Ao longo de 71,8 horas, o cluster apresenta 90 arestas de pares com dispositivos compartilhados e 1.175 arestas de pares com sobreposição de produtos. Ele contém 24 registros AUTO e 43 registros REVIEW; AUTO é elegibilidade sob uma política modelada, não remoção automática.
Este caso demonstra por que um revisor pode precisar de relacionamentos entre feeds modelados em vez de apenas uma contagem de mensagens negativas isoladas. Trinta e um dos 67 registros apresentam pouca anomalia estilométrica. Mesmo com um padrão conectado, o detector não comprova pagamento real, condição de cliente ou culpabilidade.
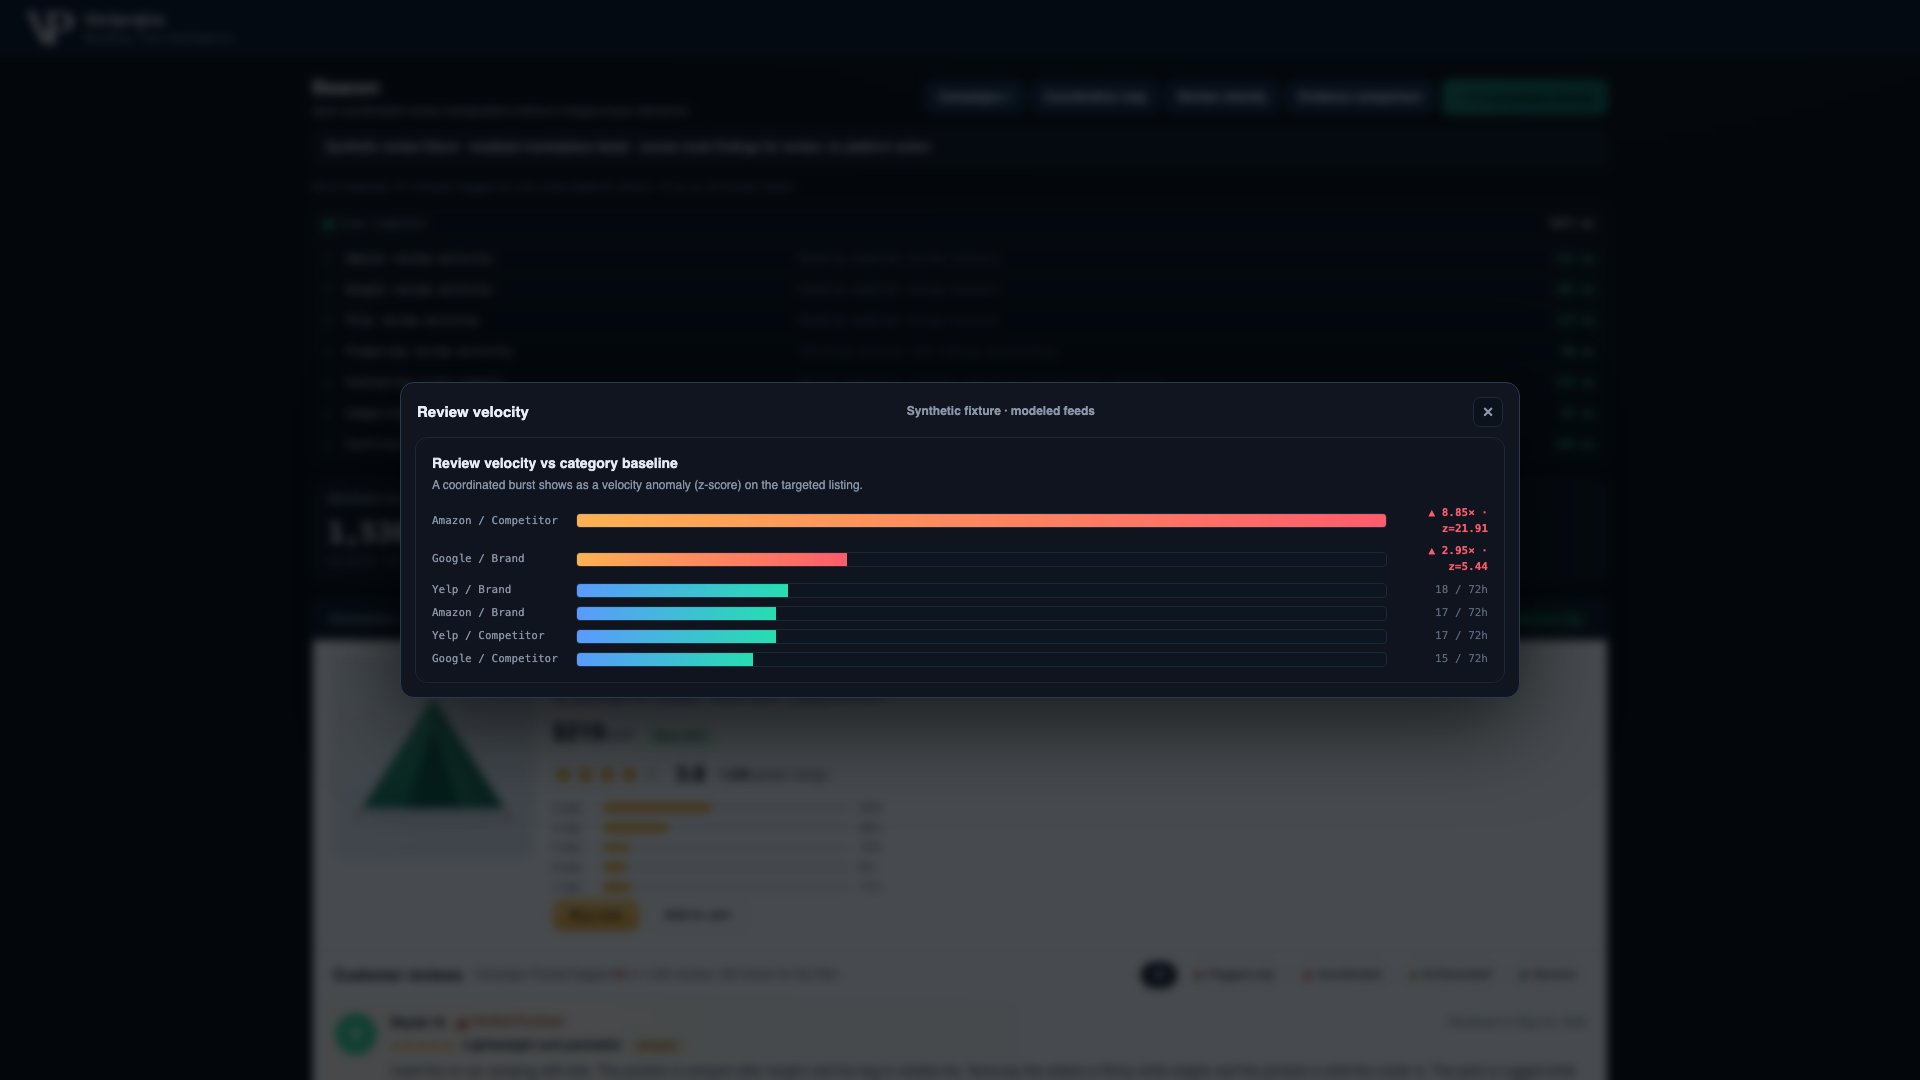
O anúncio modelado do concorrente na Amazon atinge o pico de 69 avaliações em uma janela de 72 horas contra uma expectativa de 7,8, cerca de 8,85 vezes a linha de base configurada. Essa contagem na janela do anúncio não é o tamanho do cluster multiplataforma de 67 registros. Um pico repentino contribui com um sinal temporal; os relacionamentos entre contas fornecem as conexões do grafo.
O conjunto de dados de teste mais amplo contém 1.530 registros sintéticos ao longo de um histórico modelado de 90 dias. Os resultados a seguir reproduzem os limiares atualmente carregados no mesmo corpus rotulado. Ambos os métodos derivam percentis de texto dele, e o limiar de REVIEW do ensemble foi ajustado com base em seus rótulos. Estes não são resultados de acurácia em dados separados ou de produção.
| Métrica | Ensemble do Campaign Firewall | Linha de base local baseada apenas em texto |
|---|---|---|
| Registros de avaliações implantadas sinalizados | 82 de 82 | 40 de 82 |
| Registros rotulados como genuínos sinalizados erroneamente | 0 de 1.448 | 306 de 1.448 |
| Rótulos de campanhas implantadas detectados | 3 de 3 | 0 de 3 |
A sinalização inclui REVIEW e AUTO, não remoções. Os três rótulos implantados formam dois clusters no grafo porque os rótulos de impulsionamento e espelhamento se conectam no mesmo cluster multiplataforma. O contraste de falsos positivos aplica-se apenas a esta linha de base implementada e conjunto de dados ajustado, não a detectores comerciais ou novas avaliações.
| Camada | Evidência útil | Limite |
|---|---|---|
| Linha de base local baseada apenas em texto | Anomalias de padrões de escrita em registros individuais | Sinaliza quatro de 15 na campanha modelada; nenhuma alegação de detector comercial |
| Ensemble do Campaign Firewall | Escrita, comportamento, fator temporal e relacionamentos entre contas | Encaminha todas as 15 para revisão neste conjunto de dados de teste sintético ajustado |
| Documentação da investigação | Associação, pontuações dos componentes, narrativa e rascunho de contestação | Suporta inspeção; nem protocola contestação nem comprova violação |
Todos os registros de avaliações, históricos de contas, impressões digitais de dispositivos e conexões de plataformas são sintéticos. Os feeds são modelados, sem conectores em tempo real ou avaliações extraídas. A demonstração não autentica autores reais, não remove avaliações, não conclui investigações humanas nem protocola contestações.
Nenhuma avaliação em dados separados, taxa de falsos positivos em produção, economia de horas de analistas, ROI ou taxa de sucesso de contestações foi medida. Os resultados no mesmo conjunto de dados de teste mostram comportamento configurado reproduzível; eles não comprovam generalização.
O Campaign Firewall combina padrões de escrita com comportamento da conta, fator temporal e evidências de relacionamento. Em uma campanha sintética de 15 avaliações, a linha de base local baseada apenas em texto sinaliza quatro registros, enquanto o ensemble encaminha todas as 15 para revisão humana. Este caso modelado demonstra detecção de coordenação; ele não comprova autoria humana real nem desempenho em novas avaliações.
Impressões digitais de dispositivos compartilhadas e históricos de produtos sobrepostos criam relacionamentos entre contas nos dados modelados. Vínculos de histórico de produtos exigem um anúncio compartilhado, pelo menos 0,5 de similaridade de Jaccard e registros de data e hora com no máximo 72 horas de intervalo; o fator temporal isolado não cria uma aresta. A associação à campanha, pontuações dos componentes e sinais contribuintes permanecem disponíveis na exportação de evidências.
A demonstração usa registros sintéticos e históricos modelados rotulados para Amazon, Google e Yelp. Ela não possui conectores de plataforma em tempo real, avaliações extraídas ou acesso a históricos reais de contas, dispositivos ou compras. O acesso a dados de produção, permissões e integrações exigiriam implementação e validação separadas.
O Campaign Firewall exporta evidências descritivas em JSON e HTML imprimível com um rascunho de contestação não protocolado. REVIEW significa uma rota de revisão humana, e AUTO significa elegibilidade sob a política modelada. Nenhum dos estados remove uma avaliação, envia uma contestação ou conclui uma investigação.
O ensemble atual libera todos os 1.448 registros sintéticos rotulados como genuínos neste conjunto de dados de teste. Seu limiar de revisão foi ajustado com base nos mesmos rótulos, e ambos os métodos derivam percentis de texto deste corpus, de modo que esse resultado não pode estabelecer uma taxa de falsos positivos para dados não vistos. Uma avaliação em dados independentes ainda é necessária antes de usar essas rotas operacionalmente.
Sinais de coordenação não comprovam pagamento, sentimento obrigatório, condição de cliente ou uma violação legal. A FTC distingue avaliações falsas ou enganosas de incentivos condicionados a sentimento positivo ou negativo e de supressão de avaliações. A demonstração fornece mapeamento indicativo de regras e um rascunho não protocolado para análise substantiva; ela não certifica conformidade.
Contexto jurídico: Federal Trade Commission, Consumer Reviews and Testimonials Rule Q&A (verificado em 2026). O mapeamento é descritivo e requer análise jurídica substantiva antes do uso externo.
Explore pesquisas relacionadas para um contexto mais amplo sobre esta demonstração.
Discuta seus requisitos de evidências e escalonamento com a Veriprajna.
Podemos definir o escopo de acesso a dados, avaliação independente e fluxo de trabalho de revisão necessários para o seu caso de uso. A demonstração fornece uma base concreta para essa conversa.