Gesichtserkennungswarnung mit Score 0.83: Ich baute das Gate, das sie blockierte

Ein unkalibrierter FaceFirst-Score von 0.83 konnte keine Einwilligung für eine synthetische Chicagoer Gesichtserkennungswarnung schaffen, weshalb das deterministische Richtlinien-Gate den Vorgang blockierte. Ich habe dieses Szenario entwickelt, um zu testen, ob ein biometrisches System Governance als Teil der Entscheidung behandelt oder als Formalität, die erst nach Beginn der Entscheidung hinzugefügt wird.
Die Warnung lautet LP-0834, ein bewusst gesetztes synthetisches Szenario in Chicago. Es handelt sich um kein Kundenereignis, keinen Live-Feed und den Fall keiner realen Person. Das Testbild ist eine 80-Pixel-Nachtaufnahme, verglichen mit einem 15 Jahre alten Fahndungsfoto. FaceTrust kalibriert den Rohwert auf 0.50, mit einem Intervall von [0.217, 0.783] und einer konformen 93%-Vorhersagemenge, die sowohl {mate, no_mate} enthält. Doch die entscheidende Tatsache ist einfacher: Es liegt keine Einwilligung vor, daher blockiert das deterministische Richtlinien-Gate den Scan gemäß der gesetzten BIPA-Regel der Demo.
Ich komme immer wieder auf diese Reihenfolge zurück. Ein Modell kann Evidenz liefern. Es darf jedoch nicht entscheiden, dass eine fehlende rechtliche Voraussetzung ignoriert werden kann, nur weil sein Score überzeugend wirkt.
Die vollständige Aufschlüsselung zeigt die Benutzeroberfläche, das Video und die Funktionsweise des Mechanismus. Was folgt, ist die härtere Lektion aus der Entwicklung: Wenn eine Kontrolle eine Fehlhandlung erst im Nachhinein erklären kann, kam sie zu spät.
Was ich dachte, was 0.83 bedeutet
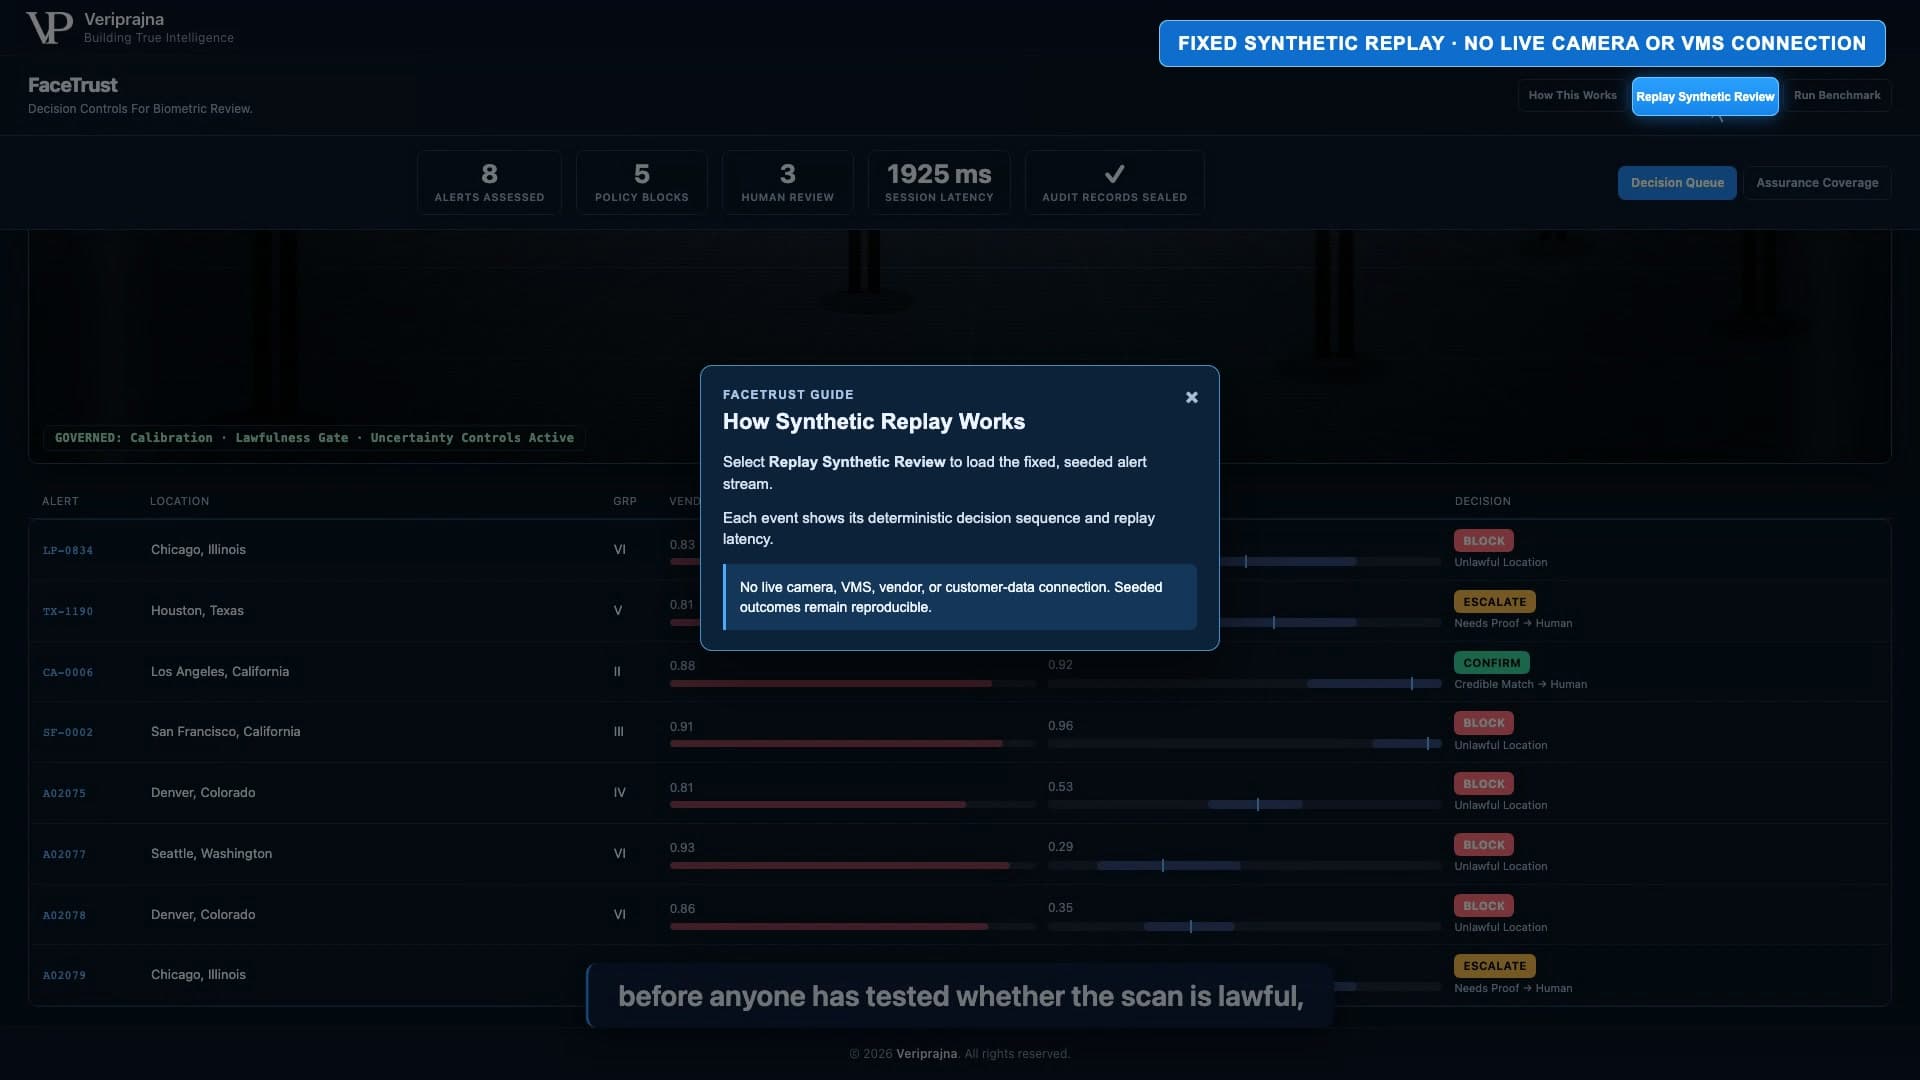
Ich begann mit der Zahl, weil der Blick automatisch dorthin wandert. In der Test-Warteschlange steht LP-0834 neben anderen Warnungen mit Rohwerten von 0.81 bis 0.91. Auf den ersten Blick wirken sie wie Variationen derselben Sache: starke Treffer, die auf eine operative Reaktion warten. Die Warteschlange verstärkte meinen eigenen Reflex, zuerst einzustufen und erst später zu hinterfragen.
Genau diesen Reflex wollte ich untersuchen. Ein unkalibrierter Hersteller-Score ist eine Eingabe aus einem einzigen Erkennungssystem. Er sagt mir nicht, ob die Erfassung zulässig war, ob die Aufnahme für die anstehende Entscheidung ausreichte oder ob die Unsicherheit um ein kalibriertes Ergebnis weiterhin einen Nicht-Treffer umfasst. Dennoch kann ein Score mit zwei Dezimalstellen fertig wirken. Seine visuelle Präzision überholt seine Entscheidungsautorität.
Die benachbarten Zeilen halfen mir, weil sie mir eine einfache Regel verwehrten. TX-1190 weist einen Roh-Score von 0.81 auf und leitet an ESCALATE weiter, weil seine kalibrierte Evidenz ungelöst bleibt. CA-0006 weist 0.88 auf und leitet an CONFIRM weiter, was bedeutet, dass ein geschulter Prüfer aktiv werden darf, nicht aber, dass das System jemanden automatisch konfrontieren darf. SF-0002 weist mit 0.91 den höchsten Rohwert der vier auf und leitet dennoch an BLOCK weiter, weil die hinterlegte Jurisdiktionstabelle Gesichtserkennung in San Francisco als verboten markiert.
Die Zeilen sind definitionsgemäß synthetisch, aber die Entwurfsfrage ist konkret: Welche Information darf den Score überstimmen? Lautet die Antwort „nichts“, ist der umgebende Compliance-Prozess rein dekorativ. Wenn Rechtmäßigkeit und Unsicherheit den Weg ändern können, bevor eine Warnung ein Einsatzteam erreicht, ist Governance ausführbar geworden.
Ein hoher Score kann die Evidenz stärken. Er kann weder eine Einwilligung schaffen noch ein Verbot aufheben.
Der Moment, in dem der Score die Kontrolle verlor
Ich öffnete das Dossier von LP-0834 in der Erwartung, dass das Kalibrierungs-Panel im Mittelpunkt stehen würde. Der Rohwert von 0.83 sinkt auf eine kalibrierte Übereinstimmungswahrscheinlichkeit von 0.50. Das Intervall reicht von 0.217 bis 0.783, und die Vorhersagemenge enthält beide möglichen Kennzeichnungen. Die Beweislage stützt keine Gewissheit.
Dann richtete sich meine Aufmerksamkeit nach unten im Panel auf den Befund zur Einwilligung. Dort wird die Route festgelegt. Die Aufnahme hat 80 Pixel und liegt damit über der Schranke der Demo von 72 Pixeln. Das Fahndungsfoto ist 15 Jahre alt, was das Dossier als Prüfer- und Audit-Hinweis erfasst, jedoch nicht als eigenständiges Routing-Gate nutzt. Das Fehlen einer Einwilligung ist anders: Es löst BLOCK aus.
Ich hatte mit dieser Hierarchie mehr zu kämpfen als erwartet. Kalibrierung ist mathematisch interessant, und ein Intervall fühlt sich nach der anspruchsvollen Antwort an. Wenn ich jedoch die Unsicherheitserzählung dominieren lasse, riskiere ich den Eindruck, dass eine günstigere Wahrscheinlichkeit den Scan retten könnte. Sie kann eine fehlende Voraussetzung nicht heilen. Das deterministische Richtlinien-Gate muss die Rechtmäßigkeit unabhängig vom Vertrauen des Modells bewerten.
Dies veränderte meine Sichtweise auf das Produkt. FaceTrust demonstriert die Biometric Decision Firewall. Es ist keine weitere Gesichtserkennungs-Engine. Ein Vendor-Adapter normalisiert die Warnung, ein lokaler Kalibrator drückt Unsicherheit aus, und deterministische Kontrollen wählen zwischen BLOCK, SUPPRESS, ESCALATE und CONFIRM. Der Compliance Reviewer kann nach dem Vorliegen strukturierter Fakten ein lesbares Memo verfassen, steuert die Route jedoch nicht. In dieser Demo ist jenes Memo vorbereitet und zwischengespeichert oder stammt aus einem deterministischen Vorlagen-Fallback.
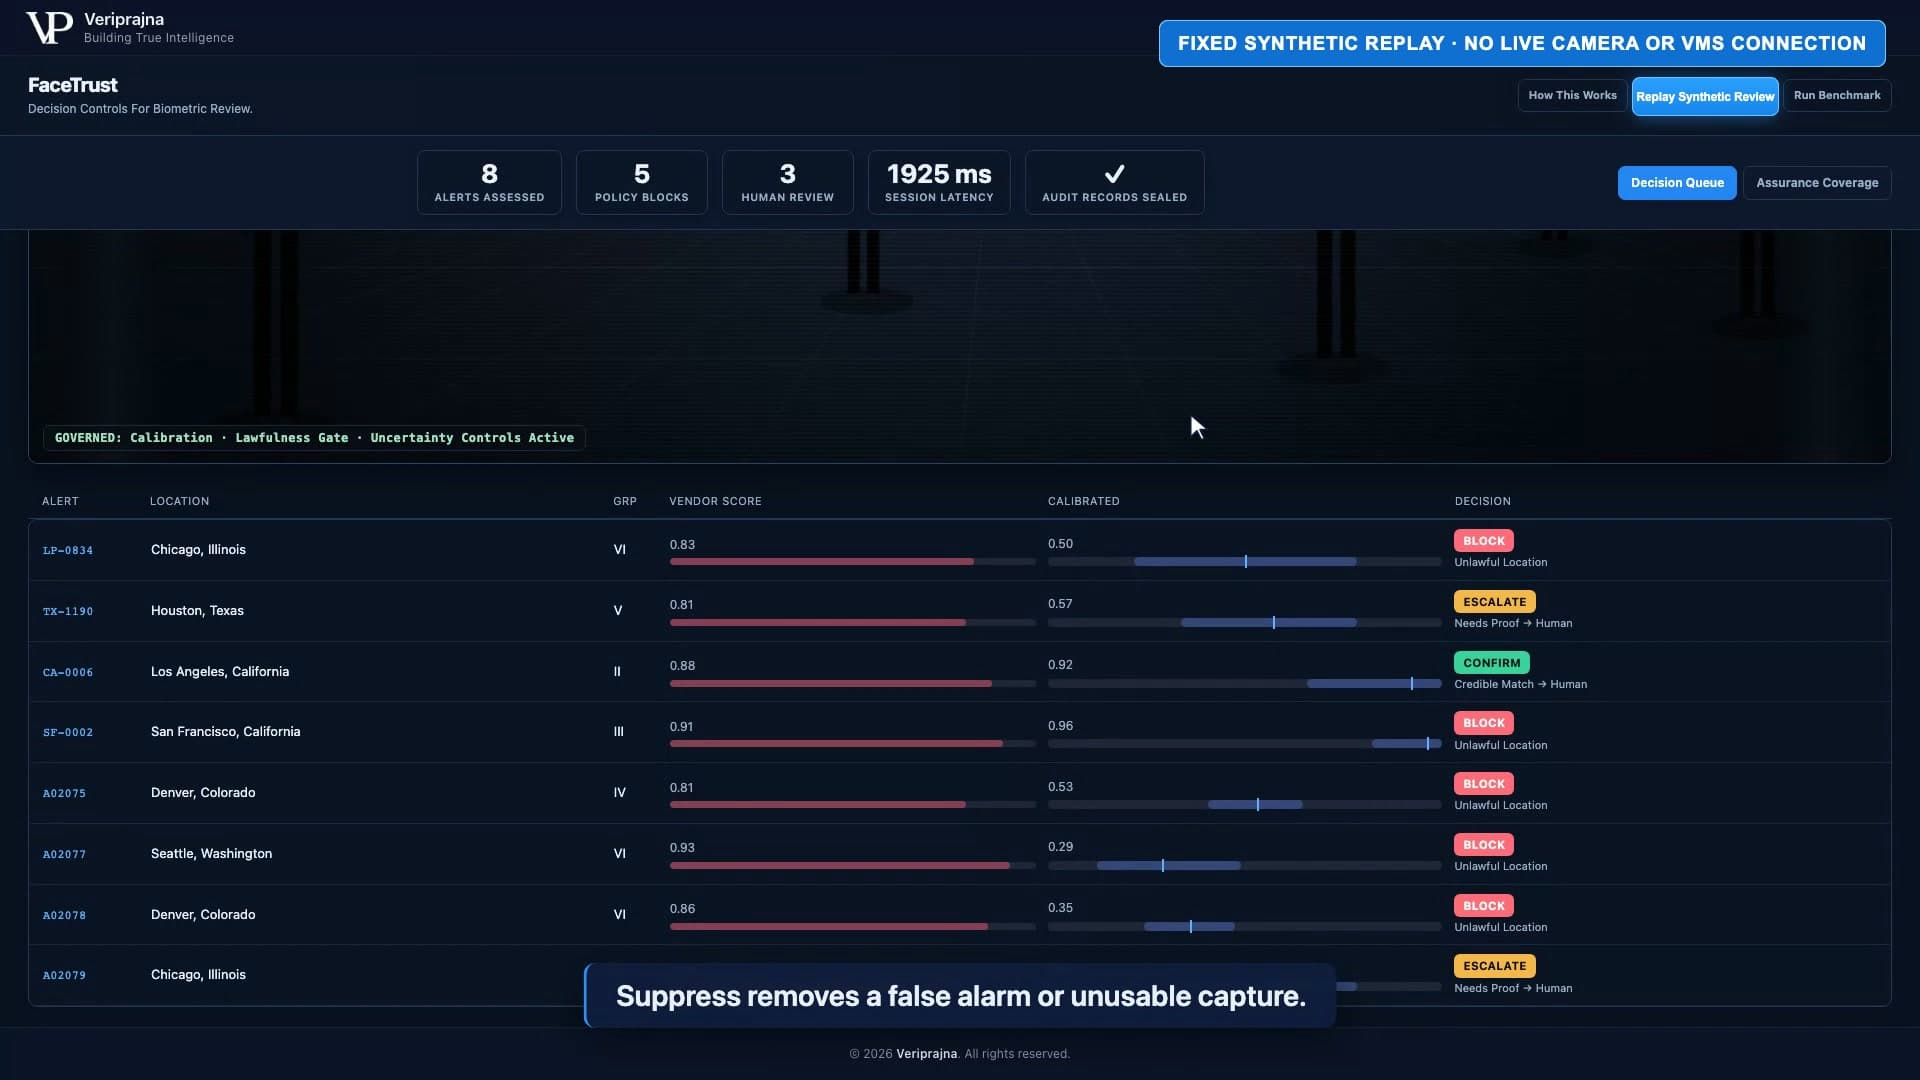
Ich wollte, dass diese Grenze sichtbar ist, weil Sprachmodelle gut darin sind, kohärent klingende Erklärungen zu formulieren. Ein kohärentes Memo ist keine Rechtsgrundlage. Hinweise gehören hinter die durch prüfbare Regeln festgelegte Route, nicht davor als überzeugender Ersatz.
Ich musste aufhören, Kalibrierung als Urteil zu behandeln
Ich wollte immer wieder, dass eine einzige kalibrierte Wahrscheinlichkeit mehr leistet, als sie kann. Das war mein fehlerhaftes mentales Modell während der Entwicklung: Ersetze einen Rohwert durch einen besseren Score und nutze den besseren Score als Entscheidung. LP-0834 widerlegte diese Abkürzung, weil das 0.50-Ergebnis immer noch ein Intervall, eine Vorhersagemenge, eine Einwilligungsprüfung, eine Jurisdiktionsprüfung und einen menschlichen Prozess für jede zulässige Aktion benötigte.
Die 93%-konforme Vorhersagemenge ist wichtig, weil sie das Vokabular des Systems verändert. Wenn die Menge sowohl {mate, no_mate} enthält, komprimiert FaceTrust Mehrdeutigkeit nicht zu einer selbstsicheren Kennzeichnung. Es kann eine rechtmäßige, aber ungelöste Warnung an ESCALATE leiten. Wenn die Evidenz einen Treffer ausschließt, kann es SUPPRESS wählen. Wenn die Menge {mate} enthält, bedeutet eine CONFIRM-Route immer noch Aktion durch einen geschulten Prüfer, niemals automatische Konfrontation, Inhaftierung oder Beschuldigung.
Ich wechselte von der Warteschlange zur Absicherungsansicht, weil ein einzelnes Dossier die Abdeckungsfrage nicht beantworten konnte. Auf dem deterministischen synthetischen Testdatensatz von 3,000 Warnungen erreichten die nominellen 93%-Konformitätsmengen mindestens 91.5% empirische Abdeckung über sechs bewertete Fitzpatrick-Gruppen. Das Minimum der Rohwert-Baseline lag bei 40.6%. Die Schnittstelle zeigt die Abdeckung über alle sechs bewerteten Fitzpatrick-Gruppen.
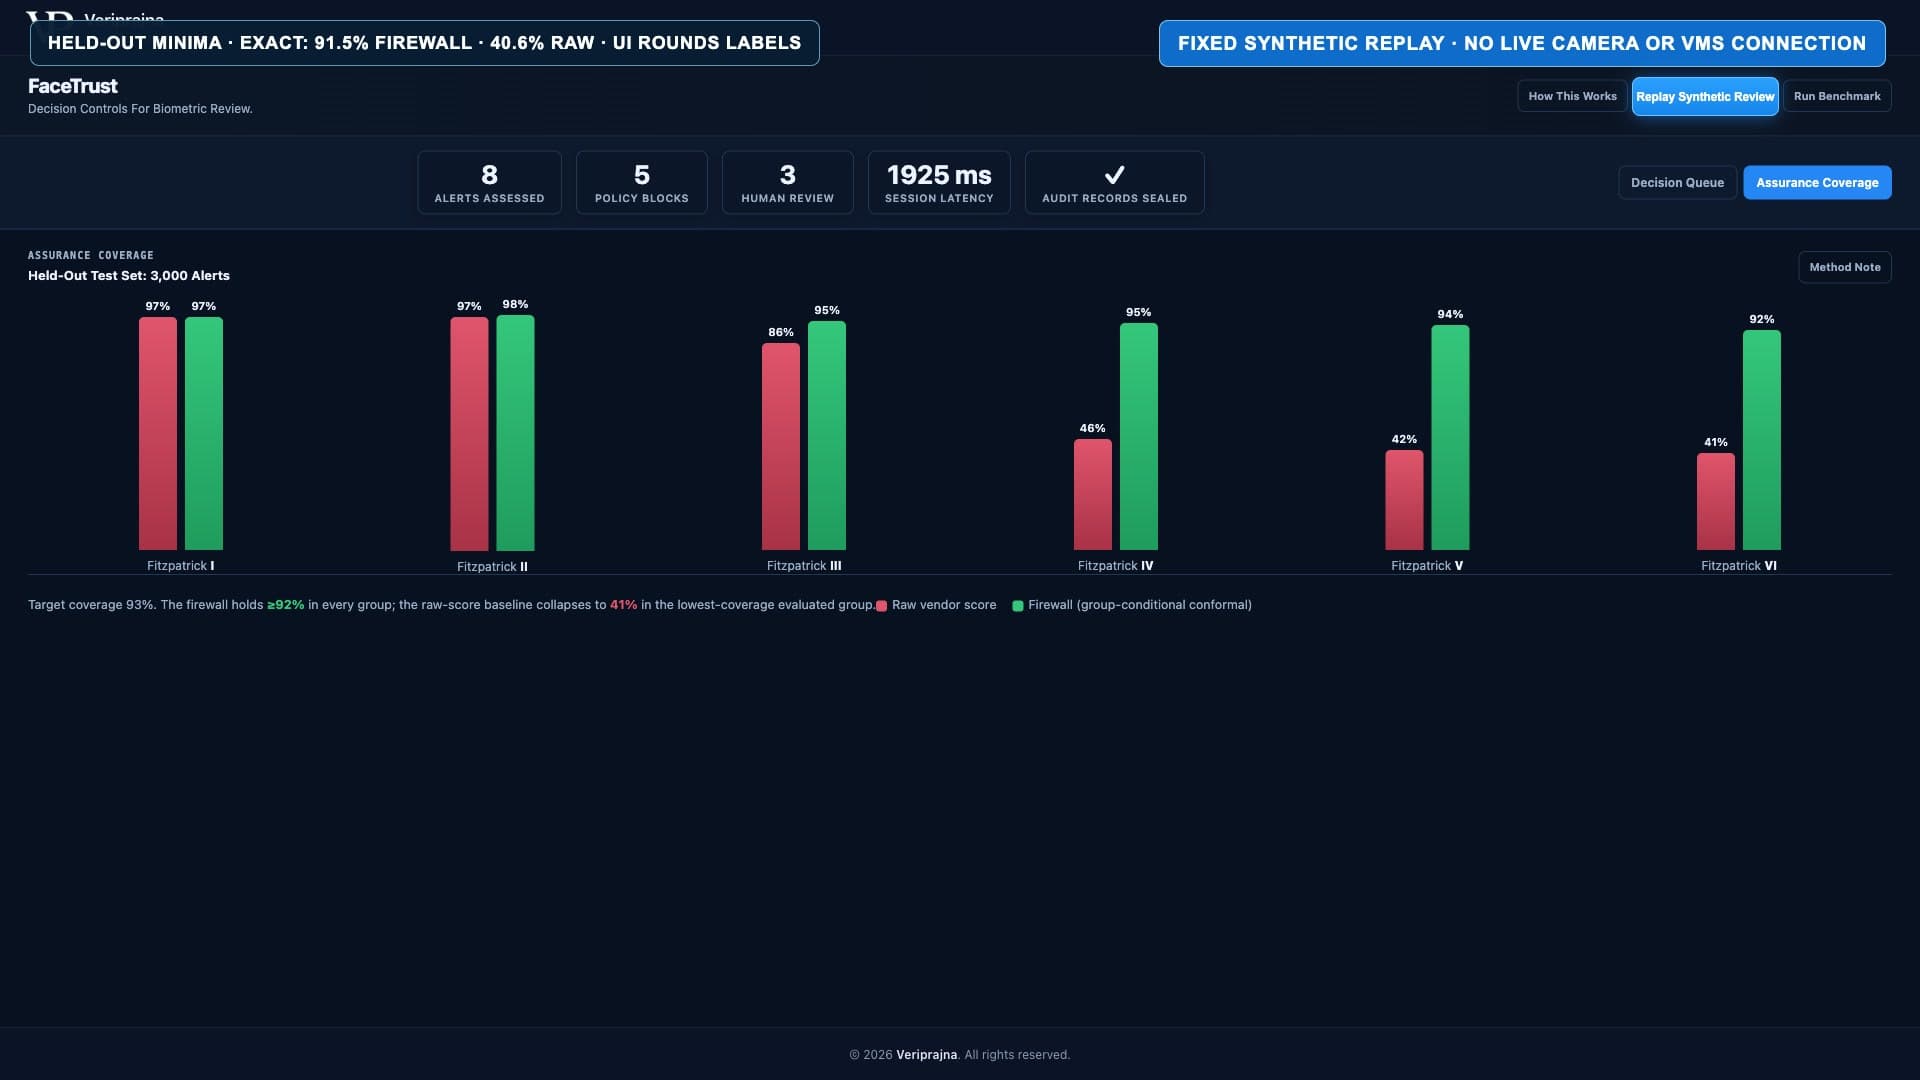
Diese Zahlen sind keine Produktionsansprüche. Der Testdatensatz ist synthetisch und modelliert dokumentierte Fehlermodi; eine Produktionskalibrierung würde die Fallhistorie eines Kunden erfordern. Ich führe das Ergebnis an, weil es zeigt, was geprüft werden sollte, statt einen Gesamtwert zu bewundern: die schwächste bewertete Gruppe, unter einem definierten Testdesign mit zugeordnetem Geltungsbereich.
Das Diagramm dämpfte auch meinen Impuls, das nominelle Ziel zu feiern. Ein 93%-Ziel bedeutet nicht, dass jede Gruppe exakt 93% erreicht, und schon gar nicht, dass das System in der realen Welt zu 93% präzise ist. Die Anzeige bietet eine Abdeckungsdiagnostik, keine Erlaubnis zur Verallgemeinerung über den Testdatensatz hinaus.
Unsicherheit wird erst dann nützlich, wenn der Workflow aufgrund ihrer Existenz anders handeln darf.
Das Replay machte die operativen Kosten sichtbar
Ich führte den festen synthetischen Testlauf durch, um zu sehen, wie die Hierarchie im Workflow-Maßstab wirkt. Über 364 Warnungen hinweg würde der rohe Schwellenwert 303 Konfrontationen erzeugen. Die Firewall erzeugt stattdessen 121 menschliche Prüfrouten und blockiert 179 Warnungen – eine Reduktion um 60.1% nach der Zählmethode dieses Replays. Die Reduktion bezieht sich auf diesen synthetischen Testlauf, nicht auf einen Kundeneinsatz oder ein Produktionsversprechen.
Ich habe das Ergebnis nicht als „Automatisierung hat mehr erledigt“ interpretiert. Der Entwurf ist wertvoll, weil er sich weigert, die finale menschliche Konsequenz zu automatisieren. Er filtert unzulässige oder nicht eingewilligte Scans heraus, unterdrückt entlastende Evidenz und führt ungelöste oder glaubhafte Fälle definierten menschlichen Prüfpfaden zu. Die operative Verschiebung reicht von score-getriebener Dynamik hin zu routen-spezifischer Verantwortung.
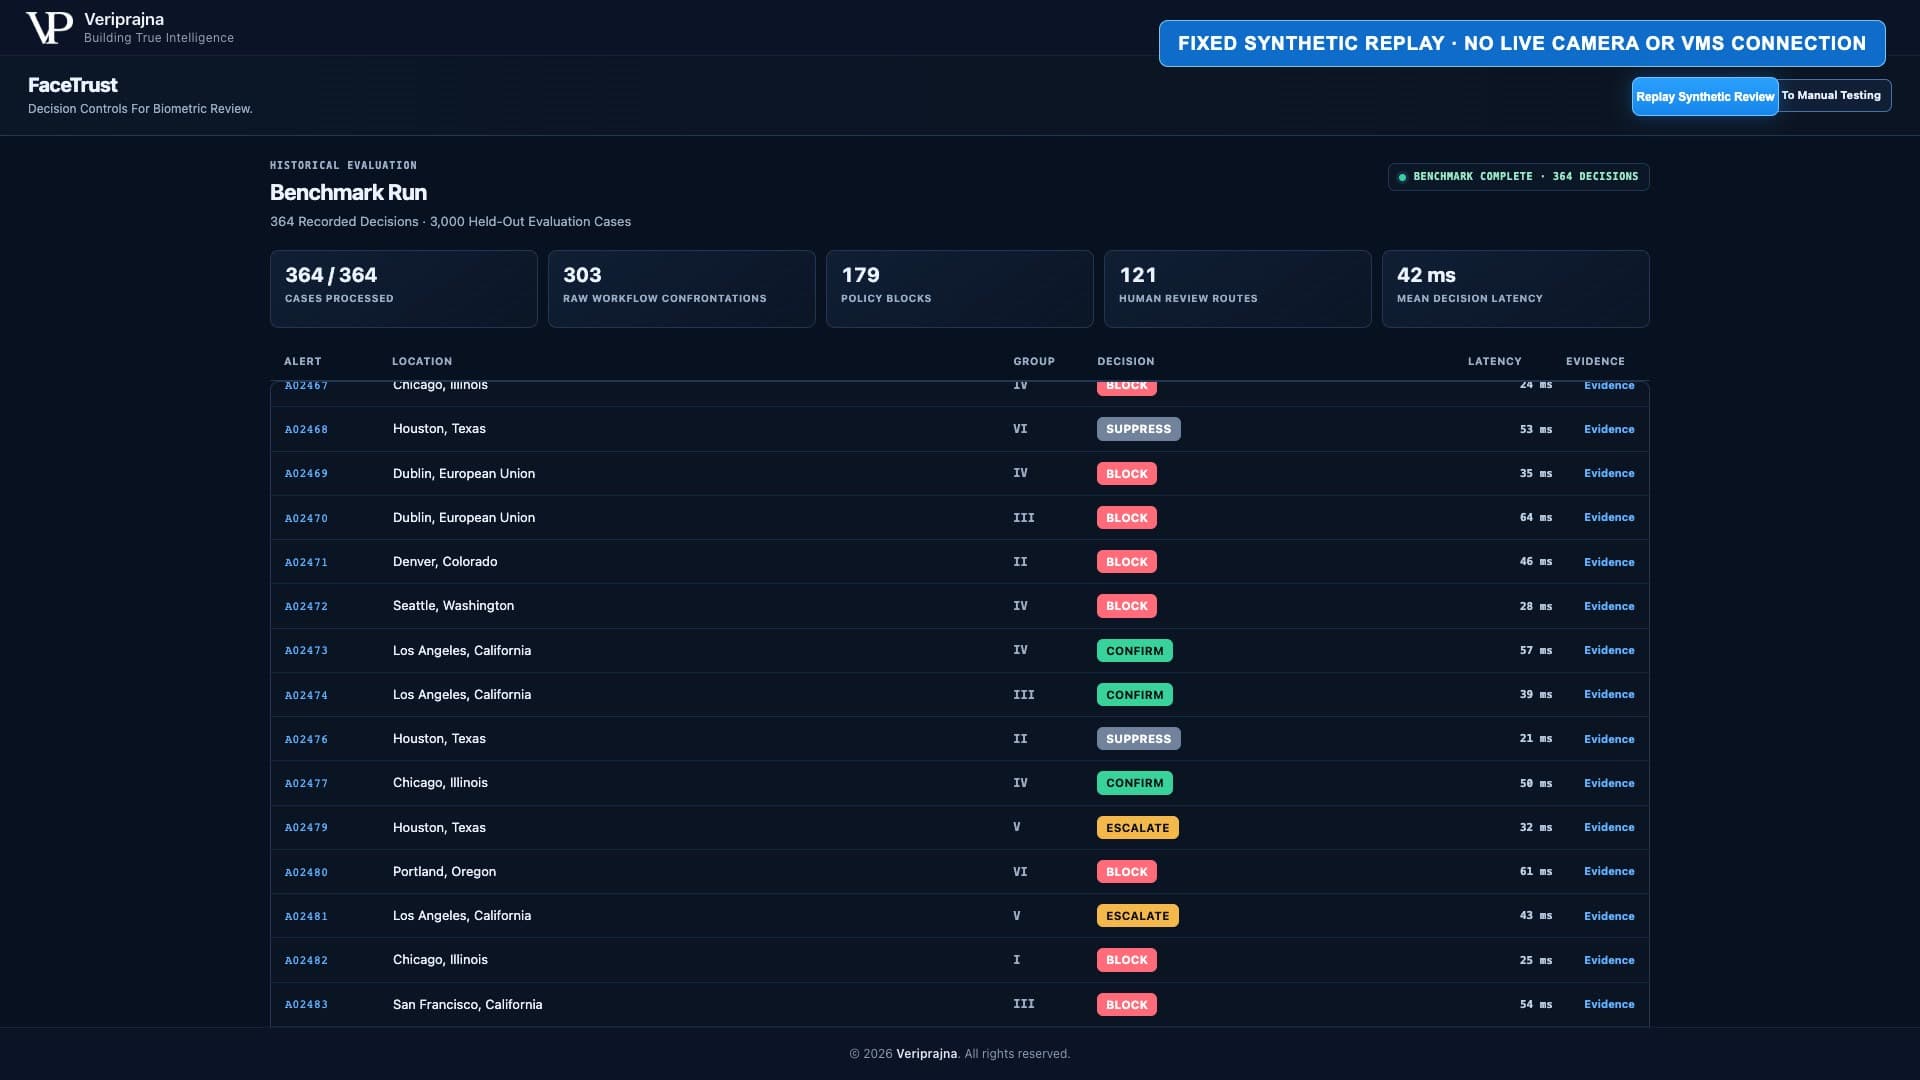
Der Test-Benchmark zeigt ein ähnlich begrenztes Bild. Bei 1,566 synthetischen Nicht-Treffern (Impostors) würde die Roh-Baseline eine Konfrontationsrate von 69.3% erzeugen, während die Bestätigungsrate der Firewall bei 3.8% liegt – eine Reduktion um 94.5% nach dieser Definition. Bei 1,434 echten Treffern verbleibt der Treffer in 93.1% der Fälle in der Vorhersagemenge der Firewall, verglichen mit 99.3% bei der Baseline. Der Vergleich offenbart einen Kompromiss: Mehr echte Treffer zu bewahren ist einfach, wenn das System bereit ist, auf weit mehr falsche Treffer zu reagieren.
Dieser Kompromiss veränderte mein Verständnis von „weniger Warnungen“, was für sich allein ein schlechtes Ziel wäre. Ein System könnte Arbeitslast reduzieren, indem es schwierige Fälle wahllos verwirft. Hier bleibt der Grund für jede Route erhalten: Einwilligung, Jurisdiktion, Erfassungsuntergrenze, kalibrierte Vorhersagemenge oder evidentieller Ausschluss. Die Route ist erklärbar, weil die Eingaben in die Route explizit sind.
Deshalb bleibt das Erfassungsalter in der Demo auch ein Hinweis statt eines eigenständigen Gates. Das 15 Jahre alte Foto von LP-0834 ist relevanter Kontext für Prüfer und Audits. Vorzugeben, dass die Demo eine universelle Altersregel besitze, würde eine Scheinsicherheit schaffen, die Implementierung und Auftrag nicht stützen.
Ich wollte, dass die Ablehnung einer Prüfung standhält
Ich öffnete nach dem Replay die Evidenzansicht und betrachtete die Route neben ihrer Aufzeichnung. LP-0834 endet nicht als farbige Plakette. Jede Entscheidung erzeugt einen SHA-256 hash-verketteten Datensatz, und die Oberfläche kann ein druckbares HTML-Audit-Exponat exportieren. Die Ablehnung besitzt Provenienz.
Ich bin misstrauisch gegenüber Systemen geworden, die nur durch generierte Absätze erklärbar sind. Ein Absatz kann Fakten zusammenfassen, aber er kann weder beweisen, dass die Route vor dem Verfassen feststand, noch dass der Datensatz nicht unbemerkt verändert wurde. Die Hash-Kette macht die Entscheidung nicht von selbst richtig. Sie macht nachträgliche Änderungen innerhalb der Kette erkennbar und gibt einem Prüfer ein stabiles Artefakt.
Diese Unterscheidung hält den Audit-Anspruch aufrichtig. Diese Demo ist weder eine Compliance-Zertifizierung noch ein Rechtsgutachten oder ein Ersatz für Rechtsberatung. Sie nutzt einen synthetischen Versuchsaufbau, Test-Adapter und simulierte Tabellen. Sie besitzt keine Anbindung an Live-Kameras, VMS, Vendor-Engines, NIST, Lebenderkennung oder Kundendaten. Sie demonstriert einen Mechanismus und eine Reihenfolge, kein Produktionsergebnis.
Ich kann mir künftige Prüffragen lebhaft vorstellen: Nicht „Zeigen Sie mir das Memo“, sondern „Zeigen Sie mir, was das System wusste, welche deterministische Regel griff, wer für die Handlung verantwortlich blieb und ob der Datensatz danach unverändert blieb.“ Das Audit-Exponat ist genau für diese Kette gedacht.
Die Regel, die ich aus dem Projekt mitnahm
Ich betrachte Gesichtserkennungs-Governance nicht mehr als Schicht, die erst beginnt, wenn ein Treffer deklariert wurde. Zu diesem Zeitpunkt besitzt die Warnung bereits ein Eigenleben. Jemand sieht einen hohen Score, der operative Prozess setzt ein, und jede spätere Schutzmaßnahme muss gegen eine scheinbare Tatsache ankämpfen.
Das Szenario LP-0834 liefert eine striktere Regel: Rechtmäßigkeit muss bewertet werden, bevor Vertrauen in Evidenz eine Route autorisieren darf, und Vertrauen in Evidenz muss mit Unsicherheit ausgedrückt werden, bevor ein Mensch zum Handeln aufgefordert wird. Der geschulte Prüfer bleibt verantwortlich für das, was auf eine CONFIRM- oder ESCALATE-Route folgt. BLOCK und SUPPRESS müssen legitime Ergebnisse sein, keine Fehlerzustände, die darauf warten, überstimmt zu werden.
Das ist die Überzeugung hinter der Biometric Decision Firewall. Agenten können lesbare Hinweise entwerfen, aber deterministische Kontrollen bestimmen die Route. Die Schritt-für-Schritt-Anleitung und vollständige Aufschlüsselung zeigen, wie FaceTrust diese Trennung sichtbar macht.
Und wenn Sie das System lieber in Aktion sehen als meine Beschreibung zu lesen, ist hier die gesamte Demonstration von Anfang bis Ende.
Ich begann mit einem Score, der stark genug wirkte, um den Blick auf sich zu ziehen. Ich endete mit einer Ablehnung, begründet auf einer fehlenden Voraussetzung, eingegrenzter Evidenz und einem prüfbaren Datensatz. Die verantwortungsvollste Entscheidung im System ist manchmal jene, die verhindert, dass aus dem Score eine Handlung wird.