Fairness-Audit & Bias-Mitigation
Wir auditieren KI-Systeme in den Bereichen Einstellung, Kreditvergabe, Versicherung und Gesundheitswesen auf diskriminierende Ergebnisse und entwickeln anschließend die Mitigation-Pipelines, die die Grundursachen beheben.
Ihr Bias-Audit wurde bestanden. Ihr System diskriminiert trotzdem.
Die meisten KI-Bias-Audits wenden die Vier-Fünftel-Regel auf ethnische Zugehörigkeit und Geschlecht an, erstellen ein PDF und erklären die Konformität. Dieser Ansatz hat drei Probleme.
- Die Vier-Fünftel-Regel ist ein grobes Instrument. Abgeleitet aus den Uniform Guidelines (29 CFR 1607), handelt es sich um einen Screening-Schwellenwert, der für Einstellungspraktiken von 1978 konzipiert wurde. Sie kann keine Proxy-Diskriminierung erkennen, bei der Postleitzahl, Pendeldistanz oder Bildungseinrichtung dieselben Informationen wie die ethnische Zugehörigkeit verschlüsseln, ohne sie zu benennen.
- Aggregierte Kennzahlen verbergen intersektionale Disparitäten. Eine Studie der University of Washington ergab, dass LLM-basierte Lebenslauf-Screening-Tools mit Weißen assoziierte Namen bevorzugten – in 85 % der Fälle – und niemals mit schwarzen Männern assoziierte Namen gegenüber mit weißen Männern assoziierten Namen bevorzugten. Aggregierte Kennzahlen zur ethnischen Zugehörigkeit würden den kumulativen Effekt völlig übersehen.
- Ein einmaliges Audit behandelt Fairness als dauerhaft gegeben. Modelle driften, Eingabeverteilungen verschieben sich und neue Merkmale kommen hinzu. Ein System, das im Januar ein Audit bestanden hat, kann im März diskriminieren, und niemand wird es wissen, bis eine Beschwerde eingeht.
Unser Ansatz besteht darin, Fairness-Audits zu entwickeln, die tiefer gehen als ein statistisches Screening, wie ausführlich beschrieben in unserer Forschung zu Vertrauensarchitekturen jenseits oberflächlicher KI. Ausgangspunkt ist das Verständnis, was „fair“ für Ihr spezifisches System bedeutet, denn die Mathematik garantiert, dass Sie nicht alles gleichzeitig haben können.
Jedes Audit ist eine explizite Entscheidung, keine Standardvorgabe
Chouldechovas Unmöglichkeitstheorem (2017) beweist, dass kein unvollkommener Klassifikator gleichzeitig Kalibrierung und gleiche Fehlerraten erfüllen kann, wenn sich die Grundraten zwischen Gruppen unterscheiden. Kleinberg, Mullainathan und Raghavan bewiesen ein umfassenderes Ergebnis: Drei intuitive Fairness-Bedingungen können außer in trivialen Fällen nicht gleichzeitig gelten.
Das sind keine akademischen Fußnoten. Sie bedeuten, dass jedes Fairness-Audit eine explizite Entscheidung darüber erfordert, welche Kriterien priorisiert werden, und diese Entscheidung hat rechtliche, ethische und geschäftliche Konsequenzen. Wir machen den Zielkonflikt sichtbar, bevor irgendjemand mit der Optimierung beginnt.
Proxy-Diskriminierung: Die entfernten Merkmale stecken immer noch im Modell
Das Entfernen von ethnischer Zugehörigkeit, Geschlecht oder Alter aus den Modelleingaben beseitigt die Diskriminierung nicht. Es entfernt den direkten Beleg dafür, lässt aber die Mechanismen intakt.
- Ein Kreditvergabe- Modell, das die ethnische Zugehörigkeit weglässt, aber die Postleitzahl beibehält, übernimmt die Muster der Wohnraumsegregation, die die Postleitzahl in vielen Regionen zu einem nahezu perfekten Proxy für die ethnische Zugehörigkeit machen.
- Ein Einstellungs- Tool, das das Alter weglässt, aber Abschlussjahr, Berufsjahre und das Alter des Technologie-Stacks (COBOL vs. Kubernetes) verwendet, rekonstruiert das Alter mit hoher Genauigkeit.
Unsere Methode nutzt kausale Graphenanalyse, um nachzuvollziehen, wie geschützte Attribute durch den Merkmalsraum in die Vorhersagen fließen – ein Ansatz, der ausführlich beschrieben wird in unserer Forschung zu kausaler KI für faire Rekrutierung und Einstellung. Die Frage ist nicht, ob ein Merkmal mit der ethnischen Zugehörigkeit korreliert. Die Frage ist, ob die über dieses Merkmal fließende Disparität einen legitimen Geschäftsfaktor darstellt (die Kredithistorie sagt tatsächlich die Rückzahlung voraus) oder einen Proxy für einen geschützten Status (Kredit-Scores auf Basis der Kredithistorie verschlüsseln historische Diskriminierung bei der Kreditvergabe).
Diese Unterscheidung erfordert domänenspezifisches Urteilsvermögen, nicht nur statistische Tests. Im Rahmen des Auftrags wird das kausale Diagramm für jedes System gemeinsam mit den Personen erstellt, die die Domäne verstehen, jeder Pfad von geschützten Attributen zu Ergebnissen wird identifiziert und jeder Pfad als legitim, problematisch oder als weiterer Untersuchung bedürftig klassifiziert. Das angestrebte Ergebnis ist eine Karte, die zeigt, wo Diskriminierung in das System eintritt, nicht nur eine Zahl, die besagt, dass sie existiert.
Intersektionales Auditing: Wo einachsige Tests versagen
Ethnische Zugehörigkeit und Geschlecht unabhängig voneinander zu testen, übersieht die schwerwiegendsten Disparitäten. Algorithmischer Bias gegenüber schwarzen Frauen lässt sich nicht als Summe von anti-schwarzem und anti-weiblichem Bias erklären. Der kumulative Effekt erzeugt eine einzigartige Benachteiligung, die nur bei Betrachtung der Schnittmenge zutage tritt. Eine Studie zur Gesichtsanalyse von 2024 ergab, dass Algorithmen zur Geschlechtsklassifizierung Fehlklassifizierungsraten von etwa 30 % bei Frauen mit dunklerer Hautfarbeaufwiesen – weit über den Fehlerraten für jede einzelne demografische Achse.
Die praktische Herausforderung ist die statistische Aussagekraft. Intersektionale Untergruppen (schwarze Frauen über 50 in ländlichen Postleitzahlgebieten) sind klein, und Standard-Hypothesentests verlieren rapide an Aussagekraft, wenn die Stichprobengrößen schrumpfen. Eine naive Untergruppenanalyse übersieht entweder reale Disparitäten, weil die Stichproben zu klein sind, um Signifikanz zu erreichen, oder erzeugt Fehlalarme aus instabilen Schätzungen.
Unsere Methode begegnet dem mit bayesianischen hierarchischen Modellen die Stärke über verwandte Untergruppen hinweg bündeln und selbst für kleine Populationen glaubwürdige Intervalle liefern. Sie wendet zudem sequenzielle Testverfahren an, die im Laufe der Zeit Evidenz akkumulieren, anstatt die gesamte statistische Aussagekraft in einer einzigen Momentaufnahme zu verlangen. Das Ergebnis ist ein intersektionales Monitoring, das darauf ausgelegt ist, aufkommende Disparitäten zu erkennen, bevor sie das Ausmaß erreichen, bei dem aggregierte Kennzahlen sie erfassen würden.
Auditing über Domänen hinweg: Einstellung, Kreditvergabe, Versicherung, Gesundheitswesen
Jede Domäne hat ihren eigenen regulatorischen Rahmen, ihre eigenen Fairness-Kriterien und ihre eigenen Muster von Proxy-Diskriminierung.
| Domäne | Regulatorisches Umfeld |
|---|---|
| Einstellung | NYC LL144 schreibt jährliche unabhängige Bias-Audits mit öffentlicher Veröffentlichung einer Zusammenfassung vor. Das Audit des NY State Comptroller vom Dezember 2025 ergab, dass 75 % der AEDT-Beschwerdeanrufe fehlgeleitet wurden, und die Behörde identifizierte nur 1 Fall von Nichtkonformität, während die Prüfer 17 potenzielle Verstöße fanden. Die Durchsetzung wird verschärft: Illinois HB 3773 (in Kraft ab Januar 2025) verbietet diskriminierende KI-basierte Beschäftigungsentscheidungen, und Mobley v. Workday wurde im Mai 2025 zur ersten zertifizierten bundesweiten Sammelklage wegen KI-Bias. |
| Kreditvergabe | Die Durchsetzung auf Bundesebene zersplittert. Das CFPB schlug im November 2025 vor, die Analyse der ungleichen Auswirkungen (Disparate Impact) unter ECOA abzuschaffen, doch die Generalstaatsanwälte der Bundesstaaten füllen die Lücke. Massachusetts einigte sich im Juli 2025 in einem Fall von Diskriminierung durch KI-gestütztes Underwriting auf 2,5 Millionen US-Dollar . |
| Versicherung | Colorado SB 21-169 verbietet die unfair diskriminierende Verwendung von Algorithmen und Vorhersagemodellen, wobei Kfz- und Krankenversicherer bis Juli 2026jährliche Konformitätsberichte einreichen müssen. |
| Gesundheitswesen | Korrekturen nach ethnischer Zugehörigkeit in klinischen Algorithmen stehen unter anhaltender Beobachtung: Pulsoximeter, die den Sauerstoffgehalt bei Patienten mit dunkler Hautfarbe überschätzen, haben zu verzögerten Diagnosen geführt. Aber das Entfernen der ethnischen Zugehörigkeit kann Populationen ebenfalls schaden, wenn sie als Proxy für echte Risikofaktoren dient, die das Modell andernfalls nicht erfassen kann. |
Für Einstellungs-KI ist ein Auftrag so ausgelegt, dass er über das Mindestmaß von LL144 hinausgeht – mit intersektionaler Analyse, Tests auf Proxy-Merkmale und kontrafaktischen Fairness-Prüfungen, gestützt auf unsere Forschung zur Haftung bei KI-gestützter Rekrutierung.
Mitigation, die Grundursachen behebt, nicht Symptome
Bias-Mitigation gliedert sich in drei Pipeline-Stufen, und die Wahl der falschen Stufe verschwendet Aufwand oder führt neue Probleme ein.
| Stufe | Techniken | Was sie gut kann | Wo sie versagt |
|---|---|---|---|
| Pre-Processing | Resampling, Neugewichtung, faires Repräsentationslernen | Behebt Bias, der bei der Datenerhebung entsteht | Versagt, wenn der Bias aus legitimen Verteilungsunterschieden stammt |
| In-Processing | Fairness-Constraints, adversariales Debiasing, Fairness-Regularisierer | Bietet direkte Kontrolle über den Zielkonflikt zwischen Genauigkeit und Fairness | Das Erzwingen demografischer Parität, wenn sich die Grundraten tatsächlich unterscheiden, verschlechtert die Kalibrierung. Bei der Kreditvergabe genehmigt das Modell entweder zu viele Antragsteller mit hohem Risiko oder zu wenige Antragsteller mit niedrigem Risiko in der eingeschränkten Gruppe. |
| Post-Processing | Gruppenspezifische Schwellenwerte, Fairlearns ThresholdOptimizer | Am schnellsten zu implementieren | Funktioniert nur für die Klassifizierung, erfordert Gruppenlabels zum Inferenzzeitpunkt und behandelt Symptome, ohne die Mechanismen anzugehen |
Unser Ansatz wählt die Interventionsstufe danach aus, wo der Bias in die Pipeline eintritt, was der regulatorische Rahmen verlangt und welchen Zielkonflikt zwischen Genauigkeit und Fairness die Organisation tolerieren kann. Jede Mitigation ist darauf ausgelegt, eine dokumentierte Evaluierung zu erstellen, die ihre Auswirkung sowohl auf Fairness-Kennzahlen als auch auf die Systemleistung zeigt, wobei der Zielkonflikt explizit benannt wird.
Kontinuierliches Monitoring vs. jährliche Audits
Ein jährliches Audit ist ein regulatorisches Minimum, keine technische Hinlänglichkeit. Modelle, die mit Rückkopplungsschleifen interagieren, können zwischen den Audits Bias entwickeln: Einstellungs-Tools, bei denen vergangene Entscheidungen künftige Bewerberpools formen, oder Kreditmodelle, bei denen Genehmigungsmuster die Daten der Kreditauskünfteien beeinflussen.
Unser Ansatz besteht darin, ein kontinuierliches Fairness-Monitoring mit sequenziellen Hypothesentests aufzubauen, das aufkommende Disparitäten in Echtzeit erkennt, anstatt zu warten, bis genügend Daten für einen herkömmlichen Signifikanztest vorliegen – ein Rechenschaftsmodell, das untersucht wird in unserer Forschung zu Retention Engineering und algorithmischer Rechenschaftspflicht. Das Monitoring löst Warnungen aus, wenn Fairness-Kennzahlen konfigurierbare Schwellenwerte überschreiten, mit separater Nachverfolgung für die aggregierte und die intersektionale Untergruppen-Performance. Das ist der Unterschied zwischen dem Entdecken eines Diskriminierungsproblems in Ihrem jährlichen Audit-Bericht und dem Erkennen zwei Wochen nach seinem Beginn.
Für agentische KI-Systeme ist das Fairness-Monitoring sogar noch entscheidender: Multi-Agenten-Orchestrierungen können durch Agenteninteraktionen und Rückkopplungsschleifen emergenten Bias entwickeln, den kein Einzelagenten-Audit erkennen würde.
Wo Toolkits und Plattformen aufhören und die maßgeschneiderte Arbeit beginnt
IBM AIF360 bietet 71 Fairness-Kennzahlen und 13 Algorithmen zur Bias-Mitigation. Fairlearn bietet ThresholdOptimizer, ExponentiatedGradient und GridSearch-Reduktion. Beide sind wertvolle Ausgangspunkte. Keines von beiden erledigt den schwierigen Teil.
- Beide benötigen Labels geschützter Attribute als Eingabe, die Organisationen oft nicht erheben können.
- Beide setzen voraus, dass der Nutzer weiß, welche Fairness-Kennzahl zu optimieren ist – was erfordert, die Unmöglichkeitstheoreme für die spezifische Domäne zu navigieren.
- Keines von beiden erstellt den kausalen Graphen, der Proxy-Diskriminierung von legitimen Risikofaktoren trennt.
- Keines von beiden bewältigt die intersektionale Analyse, bei der statistische Standardtests an Aussagekraft verlieren.
Governance-Plattformen wie Holistic AI und Credo AI bieten Compliance-Tracking, Modellinventarisierung und Risiko-Scoring. Sie sagen Ihnen, welche Modelle auditiert werden müssen und ob die Audit-Ergebnisse aktuell sind. Sie führen die Audit-Methodik selbst nicht durch: die kausale Analyse, die intersektionalen Tests, die Auswahl der Mitigation, die Dokumentation des Zielkonflikts zwischen Genauigkeit und Fairness. Unsere Aufträge integrieren sich in die jeweilige Plattform oder das Toolkit, das der Kunde bereits nutzt. Die Methodikebene ist das, was wir einbringen.
Wichtigste Erkenntnisse
- Die Vier-Fünftel-Regel (29 CFR 1607) ist ein Screening-Schwellenwert aus der Ära von 1978, der Proxy- und intersektionale Diskriminierung übersieht.
- Chouldechova (2017) sowie Kleinberg, Mullainathan & Raghavan beweisen, dass kein Klassifikator alle Fairness-Kriterien gleichzeitig erfüllt, sodass jedes Audit eine explizite Priorisierungsentscheidung ist.
- Die kausale Graphenanalyse kartiert, wie entfernte Attribute wie ethnische Zugehörigkeit und Alter über Proxys wie Postleitzahl und Abschlussjahr wieder eintreten.
- Bayesianische hierarchische und sequenzielle Testverfahren machen intersektionale Disparitäten sichtbar, die einachsige und aggregierte Kennzahlen verbergen.
- Vorschriften unterscheiden sich je nach Domäne – NYC LL144, Illinois HB 3773, ECOA, Colorado SB 21-169 –, sodass Mitigation-Stufe und Monitoring pro System gewählt werden müssen.
- Toolkits (AIF360, Fairlearn) und Governance-Plattformen (Holistic AI, Credo AI) sind Ausgangspunkte; die kausale, intersektionale und auf Zielkonflikte ausgerichtete Methodik ist die maßgeschneiderte Arbeit.
Fairness-Audit & Bias-Mitigation
 Ansehen
Ethische KI zur Abonnementbindung | Veriprajna
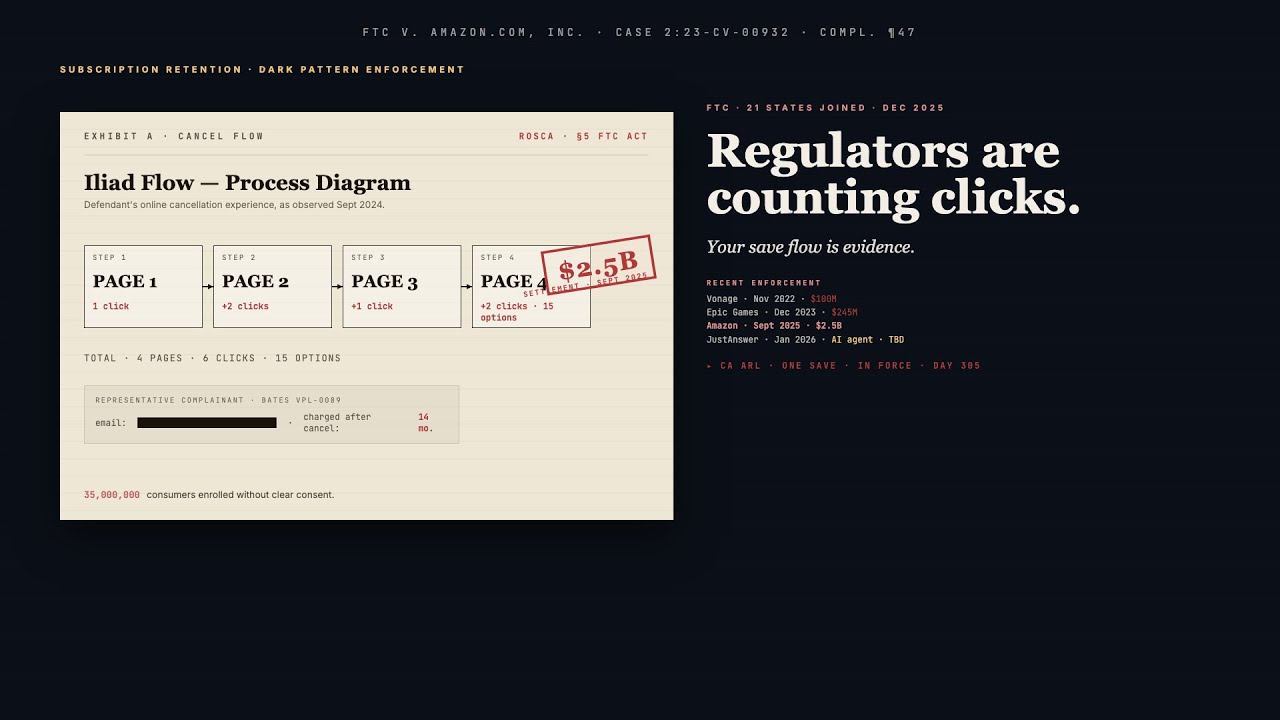
Amazon zahlte 2,5 Milliarden Dollar für einen Kündigungsablauf, der 6 Klicks erforderte. Uber sieht sich 21 Generalstaatsanwälten gegenüber wegen 23 Bildschirmen bis zur Kündigung.
Häufig gestellte Fragen
Wie viel kostet ein KI-Bias-Audit und wie lange dauert es?
Der Umfang bestimmt die Kosten stärker als jeder andere Faktor. Ein fokussiertes, LL144-konformes Audit eines einzelnen Einstellungs-Tools mit der Standardanalyse nach der Vier-Fünftel-Regel kann in zwei Wochen abgeschlossen werden. Das ist das Häkchen zum Abhaken. Ein umfassendes Audit mit kausaler Proxy-Analyse, intersektionalen Untergruppentests, kontrafaktischer Fairness-Evaluierung und dokumentierten Mitigation-Empfehlungen dauert je nach Systemkomplexität, Datenverfügbarkeit und Anzahl der geltenden regulatorischen Rahmenwerke 6–10 Wochen. Die Kostenfrage, die die meisten Käufer eigentlich stellen sollten, ist, was Nichtkonformität kostet. Die Strafen nach NYC LL144 belaufen sich auf 500–1.500 US-Dollar pro Verstoß und Tag. Colorado SB 205 erlaubt bis zu 20.000 US-Dollar pro Verstoß. Massachusetts hat gerade einen Fall von KI-Diskriminierung bei der Kreditvergabe für 2,5 Millionen US-Dollar beigelegt. Die Investition in ein Audit ist ein Bruchteil einer einzigen Durchsetzungsmaßnahme.
Welche Fairness-Kennzahl sollten wir verwenden, wenn wir nicht alle gleichzeitig erfüllen können?
Sie können nicht alle erfüllen. Chouldechova (2017) bewies, dass kein unvollkommener Klassifikator gleichzeitig Kalibrierung sowie gleiche Falsch-Positiv- und Falsch-Negativ-Raten erreichen kann, wenn sich die Grundraten zwischen Gruppen unterscheiden. Kleinberg, Mullainathan und Raghavan bewiesen eine umfassendere Unmöglichkeit. Die Wahl der Kennzahl hängt von der Domäne und dem rechtlichen Rahmen ab. Bei der Kreditvergabe ist die Kalibrierung wichtig, weil Risiko-Scores die tatsächlichen Ausfallwahrscheinlichkeiten widerspiegeln müssen, damit die Preisgestaltung funktioniert. Equalized Odds sind wichtig, weil ungleiche Fehlerraten unter ECOA eine Haftung wegen ungleicher Auswirkungen (Disparate Impact) schaffen. Bei der Einstellung ist die Parität der Auswahlrate (demografische Parität) der Ausgangspunkt, weil die Vier-Fünftel-Regel sie operationalisiert, aber Equalized Odds und Predictive Parity sind für die Testvalidierung nach den Uniform Guidelines wichtig. Wir gehen die Unmöglichkeits-Zielkonflikte für das spezifische System und den regulatorischen Kontext jedes Kunden durch, bevor irgendjemand mit der Optimierung beginnt.
Wir haben die ethnische Zugehörigkeit aus unserem Modell entfernt. Warum zeigt es weiterhin ungleiche Auswirkungen?
Weil andere Merkmale dieselben Informationen tragen. Die Postleitzahl verschlüsselt die Wohnraumsegregation. Abschlussjahr und das Alter des Technologie-Stacks rekonstruieren das Alter. Lücken im Lebenslauf korrelieren mit Behinderung und Pflegeverantwortung. Die Bildungseinrichtung korreliert mit ethnischer Zugehörigkeit und sozioökonomischem Status. Die Pendeldistanz korreliert mit der Zusammensetzung der Nachbarschaft. Das Entfernen des Labels entfernt nicht das Signal. Wir nutzen kausale Graphenanalyse, um jeden Pfad von geschützten Attributen durch den Merkmalsraum bis zur Ausgabe des Modells nachzuvollziehen. Einige dieser Pfade verlaufen über legitime Geschäftsfaktoren (die Kredithistorie sagt tatsächlich die Rückzahlung voraus). Andere verlaufen über Proxys, die historische Diskriminierung verschlüsseln. Das Audit identifiziert, welche Pfade welche sind, und die Mitigation zielt auf die Proxy-Pfade ab, ohne die legitimen zu stören.
Können wir wegen KI-Diskriminierung verklagt werden, wenn wir das Einstellungs-Tool eines Anbieters verwenden?
Ja. Arbeitgeber bleiben für diskriminierende Ergebnisse aus KI-Tools von Anbietern nach Title VII, FCRA und den Beschäftigungsgesetzen der Bundesstaaten haftbar. In Mobley v. Workday (Mai 2025) entschied das Gericht, dass ein KI-Anbieter als Vertreter des Arbeitgebers direkt für Beschäftigungsdiskriminierung haftbar sein kann. In der Sammelklage gegen Eightfold AI (Januar 2026) sind sowohl die Plattform als auch die sie nutzenden Arbeitgeber einem Risiko ausgesetzt. Colorado SB 205 erlegt den Anwendern separate Verpflichtungen auf, unabhängig davon, wer das System entwickelt hat. Die Nutzung eines Anbieter-Tools verlagert das rechtliche Risiko nicht. Sie verlagert die technische Komplexität, denn Sie müssen ein System auditieren, das Sie nicht entwickelt haben. Wir auditieren KI-Tools von Anbietern mit ausgabebasierten Testmethoden, die keinen Zugriff auf den Quellcode oder die Modellinterna des Anbieters erfordern.
Was ist der Unterschied zwischen einem LL144-Konformitätsaudit und einem umfassenden Fairness-Audit?
LL144 verlangt ein unabhängiges Bias-Audit, das die Auswahlraten nach Kategorien von ethnischer Zugehörigkeit/Ethnie und Geschlecht untersucht, mit öffentlich veröffentlichten Ergebnissen. Das ist eine Untergrenze, keine Obergrenze. Das Audit des NY State Comptroller vom Dezember 2025 ergab, dass die Durchsetzung durch das DCWP oberflächlich war: 75 % der Beschwerden wurden fehlgeleitet, und die Prüfer identifizierten 17 potenzielle Verstöße, wo das DCWP nur 1 fand. Ein umfassendes Audit geht weiter: intersektionale Analyse über kombinierte geschützte Attribute hinweg, kausale Proxy-Erkennung für Merkmale, die geschützte Informationen indirekt verschlüsseln, kontrafaktische Fairness-Tests, Sensitivitätsanalyse, die quantifiziert, wie robust Fairness-Aussagen gegenüber ungemessenen Störfaktoren sind, und dokumentierte Analyse des Zielkonflikts zwischen Genauigkeit und Fairness mit ausbuchstabierten Implikationen des Unmöglichkeitstheorems. Die umfassende Variante ist das, was einer Prüfung standhält, wenn die Durchsetzung ernst wird.
Wie testen wir auf Bias, wenn wir keinen Zugriff auf Daten zu geschützten Attributen haben?
Das ist eines der schwierigsten praktischen Probleme beim Fairness-Auditing. Alle großen Toolkits (AIF360, Fairlearn) benötigen geschützte Attribute als Eingabe. In der Praxis können viele Organisationen keine Daten zu ethnischer Zugehörigkeit, Geschlecht oder Behinderung auf Individualebene erheben, insbesondere außerhalb des Beschäftigungskontexts. Zu den Optionen gehören Bayesian Improved Surname Geocoding (BISG), um die ethnische Zugehörigkeit aus Name und Geografie abzuleiten (vom CFPB für die Analyse fairer Kreditvergabe verwendet), ökologische Inferenzmethoden, die Disparitäten auf Gruppenebene aus aggregierten Daten schätzen, und Output-Perturbationstests, bei denen Sie kontrafaktische Eingaben konstruieren, die nur Proxys für geschützte Attribute variieren, und Entscheidungsänderungen messen. Jede Methode hat Grenzen. BISG führt bei multiethnischen Personen und bestimmten ethnischen Gruppen einen eigenen Bias ein. Wir wählen und validieren die Proxy-Methode anhand der spezifischen Population und des regulatorischen Kontexts und dokumentieren die durch die Imputation eingeführte Unsicherheit, anstatt geschätzte Attribute als Grundwahrheit zu behandeln.
Benötigen wir ein kontinuierliches Bias-Monitoring, oder reicht ein jährliches Audit aus?
Ein jährliches Audit ist das, was die Regulierungsbehörden als Minimum verlangen. Es ist nicht das, was Sie sicher hält. Modelle, die mit Rückkopplungsschleifen interagieren, entwickeln zwischen den Audits Bias: Ein Einstellungs-Tool, das Kandidaten aus bestimmten Hintergründen ablehnt, trainiert auf seinen eigenen Ausschlüssen und verstärkt so das Muster. Kreditmodelle, bei denen Genehmigungsmuster die Daten der Kreditauskünfteien beeinflussen, schaffen sich selbst erfüllende Prophezeiungen. Eingabeverteilungen verschieben sich, wenn sich die Kundendemografie oder Bewerberpools ändern. Wir bauen ein kontinuierliches Monitoring mit sequenziellen Hypothesentests auf, das eine aufkommende Verschlechterung der Fairness in Echtzeit erkennt und Warnungen auslöst, wenn Kennzahlen Schwellenwerte überschreiten. Das Monitoring verfolgt sowohl die aggregierte als auch die intersektionale Untergruppen-Performance separat. Der praktische Unterschied: Ein jährliches Audit sagt Ihnen, dass das Modell monatelang voreingenommen war. Kontinuierliches Monitoring sagt es Ihnen innerhalb von Wochen.
Wie auditieren wir LLMs und generative KI auf Bias, wenn herkömmliche Fairness-Kennzahlen nicht anwendbar sind?
Herkömmliche Fairness-Kennzahlen (Equalized Odds, demografische Parität) wurden für binäre Klassifikatoren mit definierten geschützten Gruppen und messbaren Ergebnissen konzipiert. Generative KI erzeugt offene Texte, Bilder oder Empfehlungen, bei denen sich Bias als stereotype Assoziationen, unterschiedliche Qualität oder Ablehnungsmuster über demografische Kontexte hinweg äußert. Wir evaluieren LLM-Bias durch szenariobasiertes Probing (systematisches Variieren demografischer Signale in Prompts und Messen der Ausgabeunterschiede), Benchmark-Suiten (BBQ, StereoSet, CrowS-Pairs), die an den spezifischen Einsatzkontext angepasst werden, und Output-Auditing, bei dem Produktionsausgaben gesampelt und auf Muster ungleicher Behandlung hin evaluiert werden. Die Herausforderung besteht darin, dass LLMs in mehrdeutigen Kontexten in bis zu 77 % der Fälle stereotypkonforme Fehler zeigen (BBQ-Benchmark-Forschung), und diese Verzerrungen sind schwerer zu mildern als Klassifikator-Bias, weil sie über Milliarden von Parametern verteilt sind, statt in wenigen Merkmalen konzentriert zu sein.
Was sind die tatsächlichen Strafen für das Nichtbestehen eines Bias-Audits oder das Nichtdurchführen eines solchen?
Die Strafen eskalieren rasch über die Rechtsordnungen hinweg. NYC LL144: 500–1.500 US-Dollar pro Verstoß und Tag, multipliziert mit jedem betroffenen Antragsteller. Colorado SB 205 (in Kraft ab Juni 2026): bis zu 20.000 US-Dollar pro Verstoß nach dem Consumer Protection Act. EU AI Act (Durchsetzung ab August 2026): bis zu 35 Millionen EUR oder 7 % des weltweiten Umsatzes bei verbotenen Praktiken, 15 Millionen EUR oder 3 % bei Nichtkonformität im Hochrisikobereich. Über die gesetzlichen Strafen hinaus ist das Prozessrisiko real: Der Generalstaatsanwalt von Massachusetts erwirkte im Juli 2025 2,5 Millionen US-Dollar aus einem einzigen Vergleich wegen KI-Diskriminierung bei der Kreditvergabe. SafeRent zahlte 2,275 Millionen US-Dollar wegen Diskriminierung durch einen Wohnungs-Screening-Algorithmus. Mobley v. Workday ist die erste zertifizierte landesweite Sammelklage wegen KI-Voreingenommenheit. Die Kosten eines umfassenden Audits sind ein Rundungsfehler im Vergleich zu jedem dieser Ergebnisse.
Welche regulatorischen Anforderungen gelten für KI-Bias im Versicherungs-Underwriting?
Colorado SB 21-169 ist das strengste Regelwerk. Es verbietet Versicherern, externe Verbraucherdaten, Algorithmen und Vorhersagemodelle so zu verwenden, dass sie unfair diskriminierende Ergebnisse auf der Grundlage geschützter Merkmale erzeugen. Kfz- und Krankenversicherer müssen bis zum 1. Juli 2026 jährliche Konformitätsberichte einreichen. Die Colorado Division of Insurance hat quantitative Tests vorgeschlagen, die Modelle mit und ohne geschätzte Rassenvariablen vergleichen, um diskriminierende Merkmale zu identifizieren. Separat davon haben 24 Bundesstaaten das NAIC Model Bulletin übernommen, das Versicherer verpflichtet, Transparenz und Fairness in ihre KI-Governance-Programme aufzunehmen. Die Frage der versicherungsmathematischen Fairness unterscheidet sich von der statistischen Fairness: Eine versicherungsmathematisch gerechtfertigte Risikodifferenzierung kann statistische Disparitäten erzeugen, die nach dem Versicherungsrecht rechtlich zulässig sind, aber nach dem Beschäftigungs- oder Kreditrecht diskriminierend wären. Wir helfen Versicherungsteams, diese Unterscheidung mit Testverfahren zu navigieren, die für den versicherungsspezifischen regulatorischen Kontext entwickelt wurden.
Entwickeln Sie Ihre KI mit Zuversicht.
Arbeiten Sie mit einem Team zusammen, das über umfassende Erfahrung im Aufbau der nächsten Generation von Unternehmens-KI verfügt. Wir helfen Ihnen, eine KI-Strategie zu entwerfen, zu entwickeln und einzuführen, der Sie vertrauen können.
Veriprajna Deep-Tech-Beratung ist auf die Entwicklung sicherheitskritischer KI-Systeme für die Bereiche Gesundheitswesen, Finanzen und Regulierung spezialisiert. Unsere Architekturen werden anhand etablierter Protokolle validiert und mit umfassender Compliance-Dokumentation belegt.