Koordinierte Bewertungen untersuchen, ohne Verdacht in Schuld zu verwandeln

Eine Bewertung kann völlig gewöhnlich klingen, während das dahinterstehende Konto an einer koordinierten Kampagne teilnimmt. Für ein Team, das eine Marke schützt, entstehen daraus zwei Entscheidungen: welche Aktivität eine Untersuchung verdient und welche Beweise eine Konsequenz rechtfertigen würden. Ich möchte, dass ein Bewertungssystem die erste Entscheidung nützlich macht, ohne vorzugeben, die zweite bereits beantwortet zu haben.
Die Unterscheidung ist entscheidend, da sprachliche Qualität ein unsicherer Indikator für Unabhängigkeit ist. Gewandter Text verrät uns nicht, ob mehrere Konten zusammenarbeiten. Eine Kontobeziehung wiederum sagt uns nicht, ob die Verfasser bezahlt wurden oder ob ihre Kritik unwahr ist. Ein System, das diese Fragen in einem einzigen Urteil zusammenfasst, lässt sein stärkstes Signal Fragen beantworten, die es gar nicht klären kann.
Was der Wortlaut auslässt
Campaign Firewall, unsere Demonstration synthetischen Bewertungsbetrugs, enthält eine modellierte Kampagne von 15 Bewertungen auf der Produktseite eines Mitbewerbers. Alle Datensätze und Kontoverläufe sind synthetisch. Das Test-Fixture kennzeichnet dies als rein menschliche bezahlte Kampagne; dieses Etikett beschreibt jedoch das konstruierte Szenario und ist weder ein Beweis für echte menschliche Urheberschaft noch ein Beleg dafür, dass Zahlungen geflossen sind.
Elf dieser 15 Datensätze weisen nach dem stylometrischen Maß der Demo, das Muster im Text analysiert, kaum Schreibanomalien auf. Vier weisen eine erkennbare Anomalie auf. Die lokale, rein textbasierte Baseline markiert vier der 15. Würde man dieses Ergebnis als Urteil über die gesamte Kampagne interpretieren, würde man die Kontobeweise verwerfen, die mit den anderen elf verknüpft sind.
Die relevante Beziehung ist die gemeinsame Produkthistorie. Die Demo verknüpft Bewertungen, wenn sich die modellierten Historien ihrer Konten hinreichend überschneiden, die Bewertungen denselben Eintrag betreffen und sie höchstens 72 Stunden auseinanderliegen. Der zeitliche Ablauf allein stellt keine Verknüpfung her. In diesem Beispiel verbinden die überlappenden Historien die 15 Datensätze zu einem Cluster. Die Kombination der Signale leitet alle 15 an REVIEW weiter, eine menschliche Prüfroute. Es werden keine Bewertungen entfernt und es wird kein Streitfall eingereicht.
Der praktische Gewinn ist ein anderer Untersuchungsgegenstand. Anstatt von einem Prüfer zu verlangen, für jeden Satz zu entscheiden, ob er maschinell erstellt wirkt, fragt der Datensatz, warum diese Konten überlappende Historien aufweisen und ihre Aktivität innerhalb dieses Fensters auf denselben Eintrag konzentrieren. Ein plausibler Satz ist mit Koordination vereinbar. Er kann die Beziehungsevidenz nicht entkräften.
Der folgende Vergleich zeigt acht illustrative Datensätze anstelle der vollständigen Kampagne mit 15 Datensätzen. Seine oberen Zeilen zeigen Beziehungen, die zu Prüfrouten beitragen, selbst wenn die lokale Baseline kein Textsignal erkennt. Seine unteren Zeilen zeigen den umgekehrten Fehler: als echt gekennzeichnete synthetische Datensätze, die von der Baseline markiert und vom kombinierten System freigegeben werden. Beide Richtungen sind wichtig für die Entscheidung, was ein Detektor an einen Prüfer weiterleiten sollte.
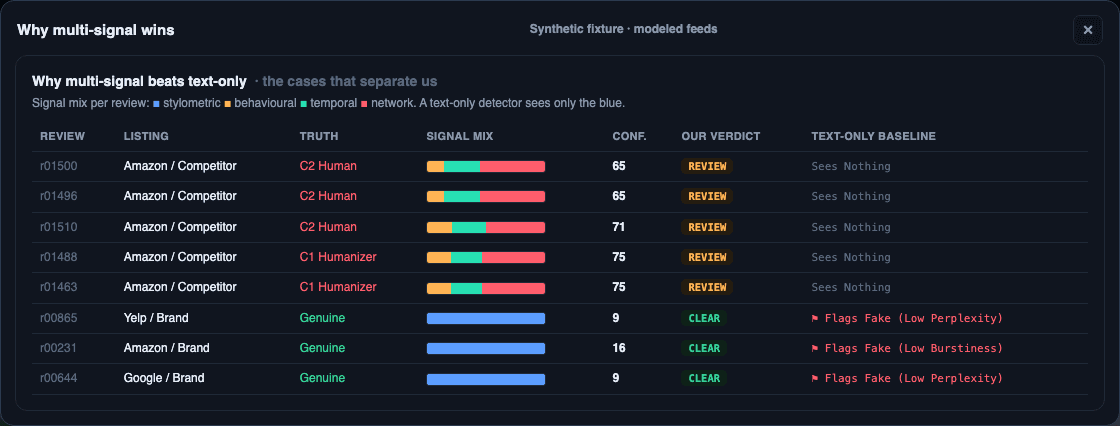
Diese Ergebnisse stammen aus demselben synthetischen Korpus, der zur Ermittlung von Textperzentilen und zur Anpassung des Prüfschwellenwerts verwendet wurde. Sie demonstrieren den konfigurierten Entscheidungspfad, nicht die Leistung bei unbekannten Bewertungen. Das Beispiel verdeutlicht eine architektonische Unterscheidung: Eine rein textbasierte Entscheidung kann relevante Beziehungen übersehen. Es beweist nicht, dass sich diese spezifische Kombination zuverlässig verallgemeinern lässt.
Ein verknüpftes Cluster braucht dennoch eine Erklärung
Beziehungsnachweise verdienen eine genaue Prüfung, doch der Grund für eine Verbindung bleibt eine separate Frage. Betrachten wir eine hypothetische Produkteinführung, bei der echte Käufer aus derselben Enthusiasten-Community stammen. Sie könnten viele dieselben Produkte kaufen und einen neuen Eintrag innerhalb kurzer Zeit bewerten. Überlappende Historien und konzentriertes Timing könnten ein gemeinsames Interesse widerspiegeln und keine bezahlte Operation.
Jedes solche Cluster automatisch freizugeben, würde einen nützlichen Hinweis verwerfen. Es automatisch zu unterdrücken, würde den Hinweis wie ein abschließendes Urteil behandeln. Ich bevorzuge eine Zwischenroute, die die spezifischen Beziehungen zur Prüfung erhält und gleichzeitig die ungelöste Erklärung sichtbar hält. Diese Wahl hat ihren Preis: Sie erzeugt Arbeit für Prüfer, und eine überlastete Warteschlange kann die Aufmerksamkeit für eindeutigere Fälle verzögern. Die Route als menschliche Prüfung zu bezeichnen, lässt dieses Kapazitätsproblem nicht verschwinden.
Für ein zukünftiges System würde ich diese Kosten sowohl an Beispielen evaluieren, bei denen legitime Konten Interessen teilen, als auch an gezielter Koordination. Die Entscheidung ist, ob die zusätzlichen Beziehungen Untersuchungen hervorbringen, die ein Analyst nutzen kann, und zwar in einem Umfang, den das Team tatsächlich bewältigen kann. Ein höherer Score ohne nachprüfbaren Grund trägt wenig zur Beantwortung bei. Eine kleinere Warteschlange, die durch das stillschweigende Verwerfen verknüpfter Konten erreicht wird, verschleiert diesen Kompromiss ebenfalls.
Die Untersuchung sollte dann unterscheiden, was die bestehenden Beweise klären können und was zusätzliche Informationen erfordert. Ein Prüfer kann nachvollziehen, welche Historien sich überschneiden, wie viel der Verbindung vom Timing abhängt und ob derselbe Eintrag die Konzentration erklärt. Die Feststellung von Zahlungen oder falschen Aussagen würde Beweise erfordern, die über diese Beziehungen hinausgehen. Dies sind vorgeschlagene Prüffragen, keine Fähigkeiten, die diese synthetische Demo über einen Live-Plattformzugriff bereitstellt.
Dies ändert meine Interpretation einer Prüfroute. Sie ist eine Zuweisung von Aufmerksamkeit auf der Grundlage eines erklärten Grundes. Es sollte möglich sein, diesem Grund zu widersprechen, eine harmlose Erklärung festzuhalten oder zu dem Schluss zu kommen, dass die verfügbaren Beweise unzureichend sind. Wenn der Workflow nur erlaubt, den Verdacht des Detektors zu bestätigen, hat der Zwischenschritt seinen Zweck verloren.
Die Erklärung kann zu einer weiteren Quelle falscher Gewissheit werden
Es gibt eine zweite Stelle, an der diese Unterscheidung kollabieren kann: das Narrativ der Untersuchung. Ein flüssig formulierter Absatz kann aus „diese Historien überschneiden sich“ den Schluss „diese Prüfer wurden bezahlt“ ziehen, ohne neue Beweise zu liefern. Die Sprache liefert eine scheinbare Erklärung für ein Muster, dessen Ursache noch ungelöst ist.
In Campaign Firewall weist das deterministische Scoring die Routen zu, bevor eine optionale Codex-Bridge ein Narrativ generiert. Das zugehörige Founder-Video gibt eine zwischengespeicherte Codex-Antwort wieder, anstatt eine Live-Inferenz während der Aufnahme zu zeigen. Generierte Prosa kann die zugewiesenen Stufen nicht verändern. Diese Trennung schützt die Scoring-Entscheidung vor dem Narrativ, doch ein Prüfer könnte dennoch durch einen unbegründeten Satz in der Erklärung beeinflusst werden.
Die Demo wendet einen heuristischen Grounding-Filter an, der auf numerischer und Token-Überschneidung basiert und eine Prüfung auf umgekehrte Urteile umfasst. Er kann unbegründete Prosa entfernen; er beweist jedoch nicht, dass jeder beibehaltene Satz wahr ist. Ein Satz kann die richtigen Zahlen wiederverwenden und dennoch deren Bedeutung übertreiben. Die zugrunde liegenden Beziehungen verfügbar zu halten, ist daher Teil der Aufgabe des Prüfers, keine Aufgabe, die durch ein grünes Filterergebnis bereits erledigt wäre.
Ich möchte, dass das Narrativ dabei hilft, eine Schlussfolgerung zu überprüfen – einschließlich der Schlussfolgerung, die es nicht stützen kann. Wenn ein Entwurf behauptet, dass die Konten bezahlt wurden, benötigt der Prüfer einen Zahlungsnachweis. Die Wiederholung der Clustergröße oder des Scores kann diese Lücke nicht füllen. Wenn dieser Beweis fehlt, sollte die Behauptung ungelöst bleiben, selbst wenn das Kontomuster eine Untersuchung wert ist. Die Vorbereitung eines Streitfallentwurfs sollte diese Grenze bis zu jeder späteren Entscheidung wahren; hier bleibt der Entwurf unübermittelt.
Hier ist der Founder-Walkthrough für dieses synthetische Beispiel.
Die Erklärung zu Campaign Firewall zeigt die synthetische Beziehungsevidenz und das Untersuchungsprotokoll hinter diesem Beispiel. Für technische Entscheidungsträger lautet die entscheidende Bewertungsfrage, was passiert, wenn eine Verbindung mehr als eine plausible Erklärung hat. Ein System verdient sich eine Prüfroute, indem es die Verbindung offenlegt. Eine folgenreiche Maßnahme erfordert Beweise, die den Grund für das Handeln klären, und einen expliziten Weg zum Anhalten, wenn diese Beweise fehlen.