„Wir haben Herkunft und Einkommen aus dem Modell entfernt“ verliert den Pricing-Rechtsstreit

Im Dezember 2025 einigte sich die FTC im Streit um die Eversight-Preisentwicklungs-Experimente mit Instacart auf einen Vergleich über 60 Millionen Dollar, wobei die Klageschrift Preisschwankungen bei identischen Artikeln von bis zu 23 % dokumentierte. Die FTC musste nie nachweisen, was dem Algorithmus vorgegeben worden war; die Klage stützte sich allein auf die Preise, die verschiedenen Käufern für denselben Artikel tatsächlich angezeigt wurden.
Der Satz, zu dem jedes Pricing-Team greift, ist das Gegenteil eines ergebnisbasierten Arguments: Wir haben Herkunft und Einkommen aus dem Modell entfernt. Ich glaube den Teams, die das sagen. Ich halte es aber auch für den Satz, mit dem man den Rechtsstreit verliert, und anstatt das abstrakt zu diskutieren, habe ich eine Pricing-Engine gebaut, die diesen Satz wahrheitsgemäß über sich selbst sagen kann – und sie dann auditiert. Bei der Engine handelt es sich um einen LinUCB Contextual Bandit mit sieben Preis-Optionen (Arms), initialisiert mit Seed 42, trainiert auf Umsatzoptimalität an einer synthetischen Population von 10.000 Käufern, die ich mit absichtlich platzierten Proxy-Strukturen generiert habe. Den fiktiven Einzelhändler nannte ich ShopMart. Kein echter Händler wurde auditiert und kein echter Kunde zu viel zur Kasse gebeten – genau deshalb kenne ich die Ground Truth und kann das Audit daran messen. Die Schicht darüber ist eine Konsole namens Equity, die so konzipiert ist, dass sie auf jeder beliebigen Pricing-Engine aufsetzen kann; in diesem Setup ist die auditierte Engine mein eigener Bandit. Die Dokumentation des gesamten Laufs findet sich unter veriprajna.com/demos/ai-pricing-compliance.
Identische Kopfhörer, gleiche Nachfragesignale, 26 % mehr
Ich gab dem Banditen neun Eingangsvariablen, von denen keine einzige ein geschütztes Attribut darstellt: PLZ-Einkommensindex, Gerätekategorie, Empfehlungsquelle, Verweildauer, Warenkorbgröße, Wiederkaufrate, Sitzungsanzahl, Premium-Mitgliedschaft und Tageszeit, plus Kreuzterme aus Empfehlung und Verweildauer. Reale Engines nutzen oft Kreuzterme oder Entscheidungsbäume, und mein System sollte all das abbilden können. Dann ließ ich es einen SKU bepreisen – die Aura Wireless Earbuds, Listenpreis 79.00 $ –, über sämtliche 10.000 Entscheidungen hinweg.
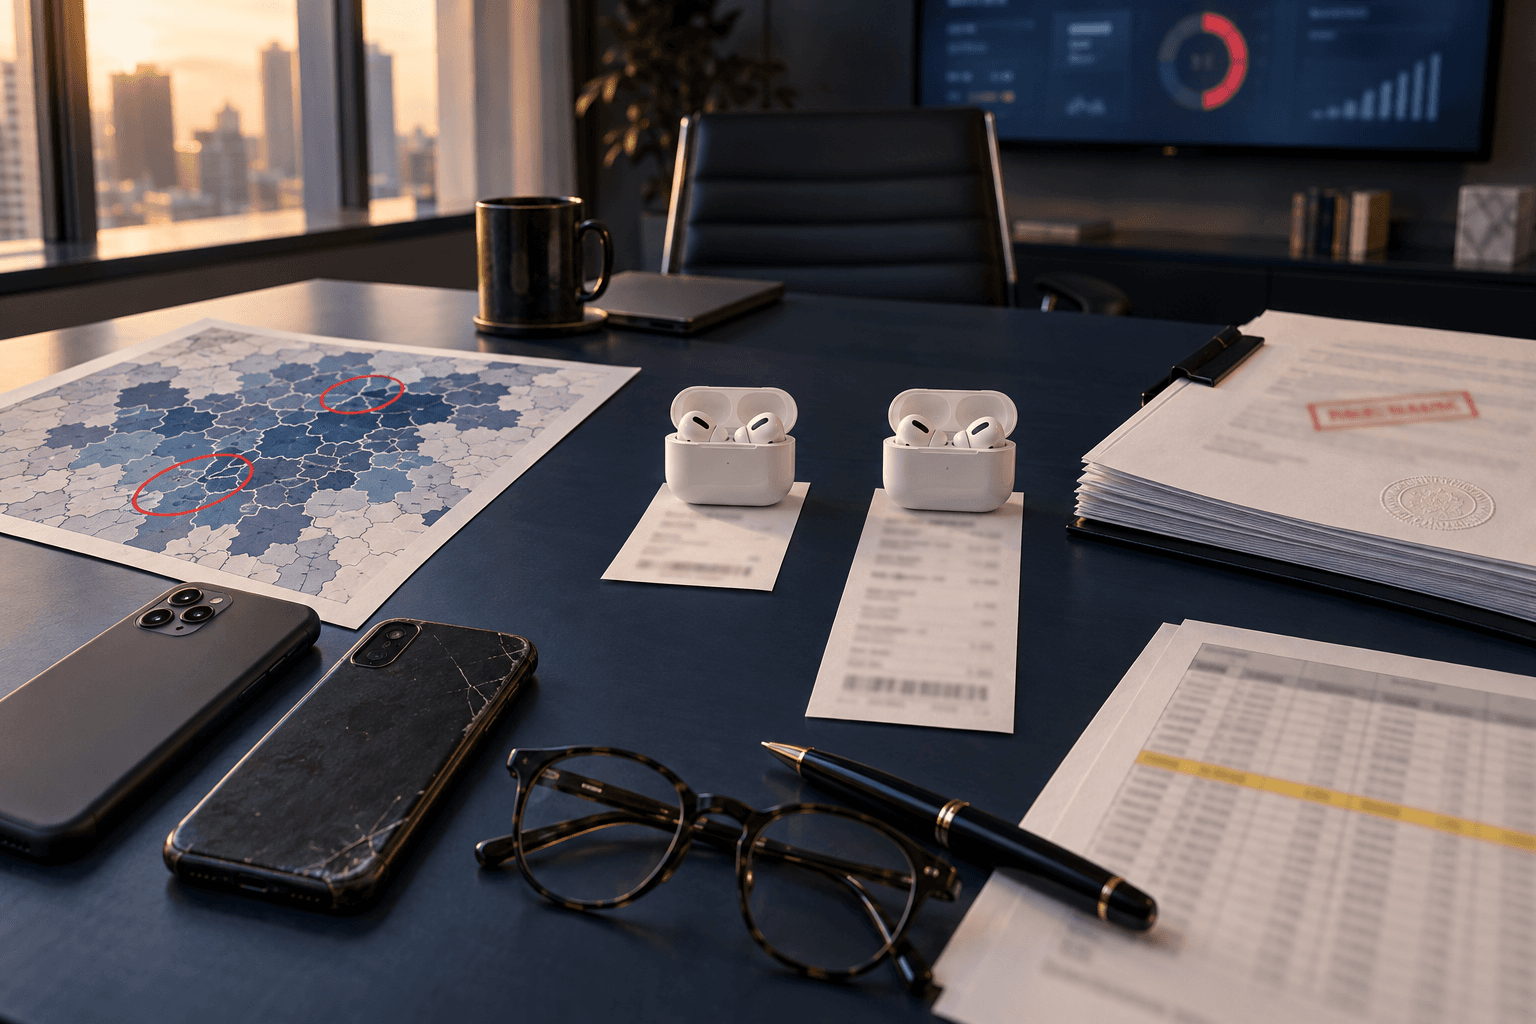
Die Übersichtskarte auf der Konsole ist das Erste auf dem Bildschirm, bevor irgendetwas startet. Zwei Kohorten, ein Produkt, abgestimmte Nachfragesignale. Entscheidungssatz A ist die Kohorte aus einkommensstarker PLZ und aktuellem Neugerät, 2.880 Entscheidungen, auf der Karte repräsentiert durch eine Upper-East-Side-PLZ und ein neues iPhone: angezeigter Preis 74.06 $. Entscheidungssatz B ist die Kohorte aus PLZ mit überwiegender Minderheitenbevölkerung und Altgerät, 3.037 Entscheidungen, repräsentiert durch eine South-Bronx-PLZ und ein altes Android: 93.47 $. Gemessene Varianz: +26.2 %. Das sind Kohorten-Mittelwerte über jeweils rund 3.000 Entscheidungen – es handelt sich also um systematisches Verhalten der Policy und nicht um einen einzelnen Pechvogel. PLZ und Smartphone auf jeder Karte bilden das repräsentative Profil der Kohorte ab, nicht ihre Definition.
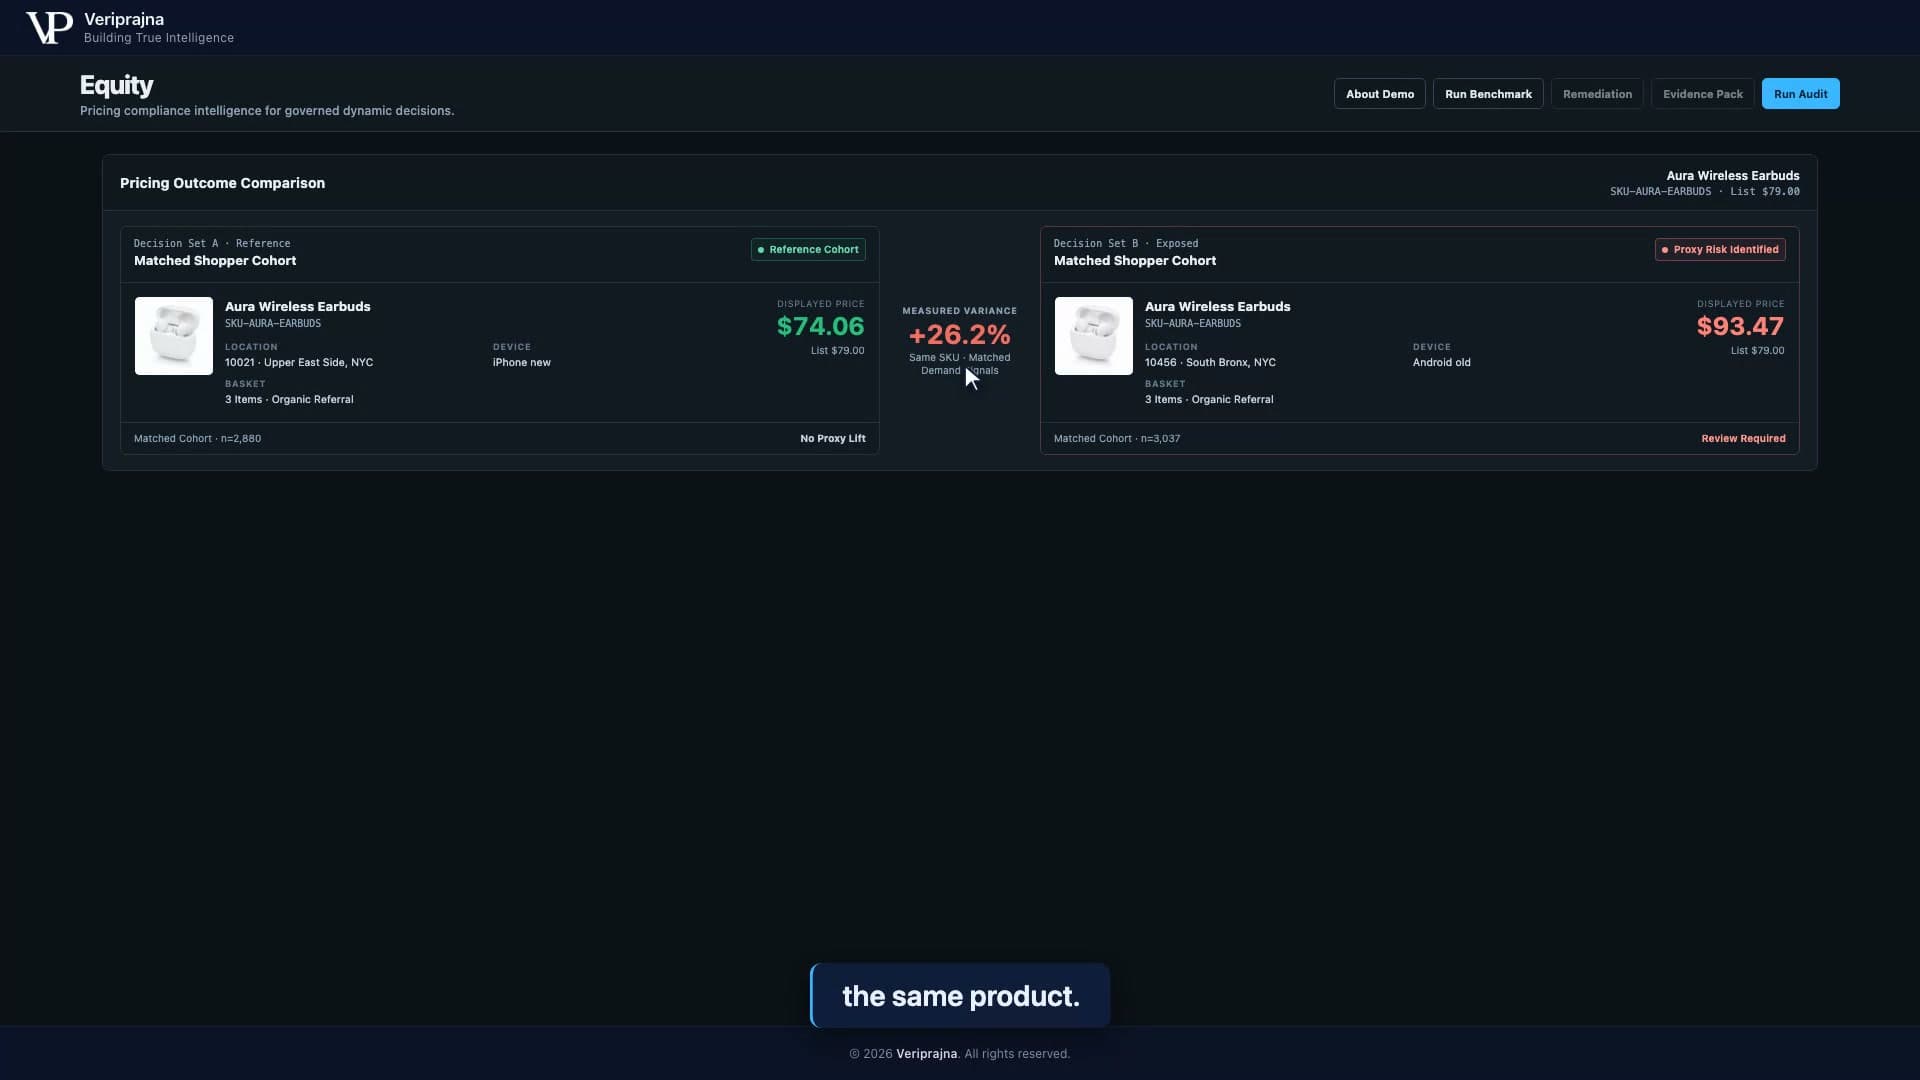
Was mich beunruhigte: Ich hatte keine einzige diskriminierende Regel geschrieben. Ich hatte einen Ertragsmaximierer programmiert und ihm Signale übergeben, die die Zahlungsbereitschaft prognostizieren. Die PLZ korreliert mit dem Einkommen, das Einkommen mit der Preissensibilität, ein altes Android mit weniger Preisvergleichen. Nichts davon ist die ethnische Herkunft. Aber alles korreliert damit, und ein auf Umsatz belohnter Bandit findet jedes einzelne Signal. Die 26 % sind schlicht das, wie Umsatzoptimalität aussieht, wenn die Signale die Kohorte mittragen.
Der Proxy, der sich zwischen zwei sauberen Eingaben versteckt
Ich habe das Audit so konzipiert, dass jedes Merkmal auf drei Arten bewertet wird, weil jeder Einzeltest Lücken aufweist: Absolute Pearson-Korrelation gegenüber der geschützten Kohorte (ein Label, das das Audit selbst nie erhält), normalisierte Mutual Information (NMI) und ein kontrafaktisches Preis-Replay. Dabei wird dieses eine Merkmal für die geschützte Kohorte mit dem Referenzwert der begünstigten Kohorte überschrieben, alle anderen Werte bleiben konstant, die Policy der Engine wird erneut ausgeführt und gemessen, wie stark sich der Preis bewegt. Das Replay ist modellagnostisch: Es variiert den Input und beobachtet den Output – egal, ob die Engine ein Bandit, ein Baum oder eine Blackbox ist.
Die ersten beiden Zeilen der Input-Audit-Tabelle entsprechen den Erwartungen. PLZ-Einkommensindex: |r| 0.95, MI 1.00, kontrafaktisch +7.8 %, VIOLATION. Die Geografie kodiert die geschützte Gruppe in dieser Population vollständig, und die Engine preist danach. Gerätekategorie: 0.32, 0.08, +2.9 %, VIOLATION – ein vordergründig neutrales Signal, das die von mir im Code definierten Schwellenwerte von 0.30 (Korrelation) und 0.05 (MI) überschreitet.
Die dritte VIOLATION ist jene, die ein Einzelfeature-Audit übersieht. Empfehlungsquelle allein: |r| 0.00, MI 0.00, PASS. Verweildauer allein: 0.17, 0.03, PASS. Ein Einzelfeature-Audit winkt beide durch. Die Interaktionszeile Empfehlungsquelle × Verweildauer zeigt |r| 0.00, gemeinsame MI 0.73, kontrafaktisch +1.7 %, VIOLATION. Das ist ein Interaktionsgewinn von 0.71 gegenüber der besten Einzelkomponente.
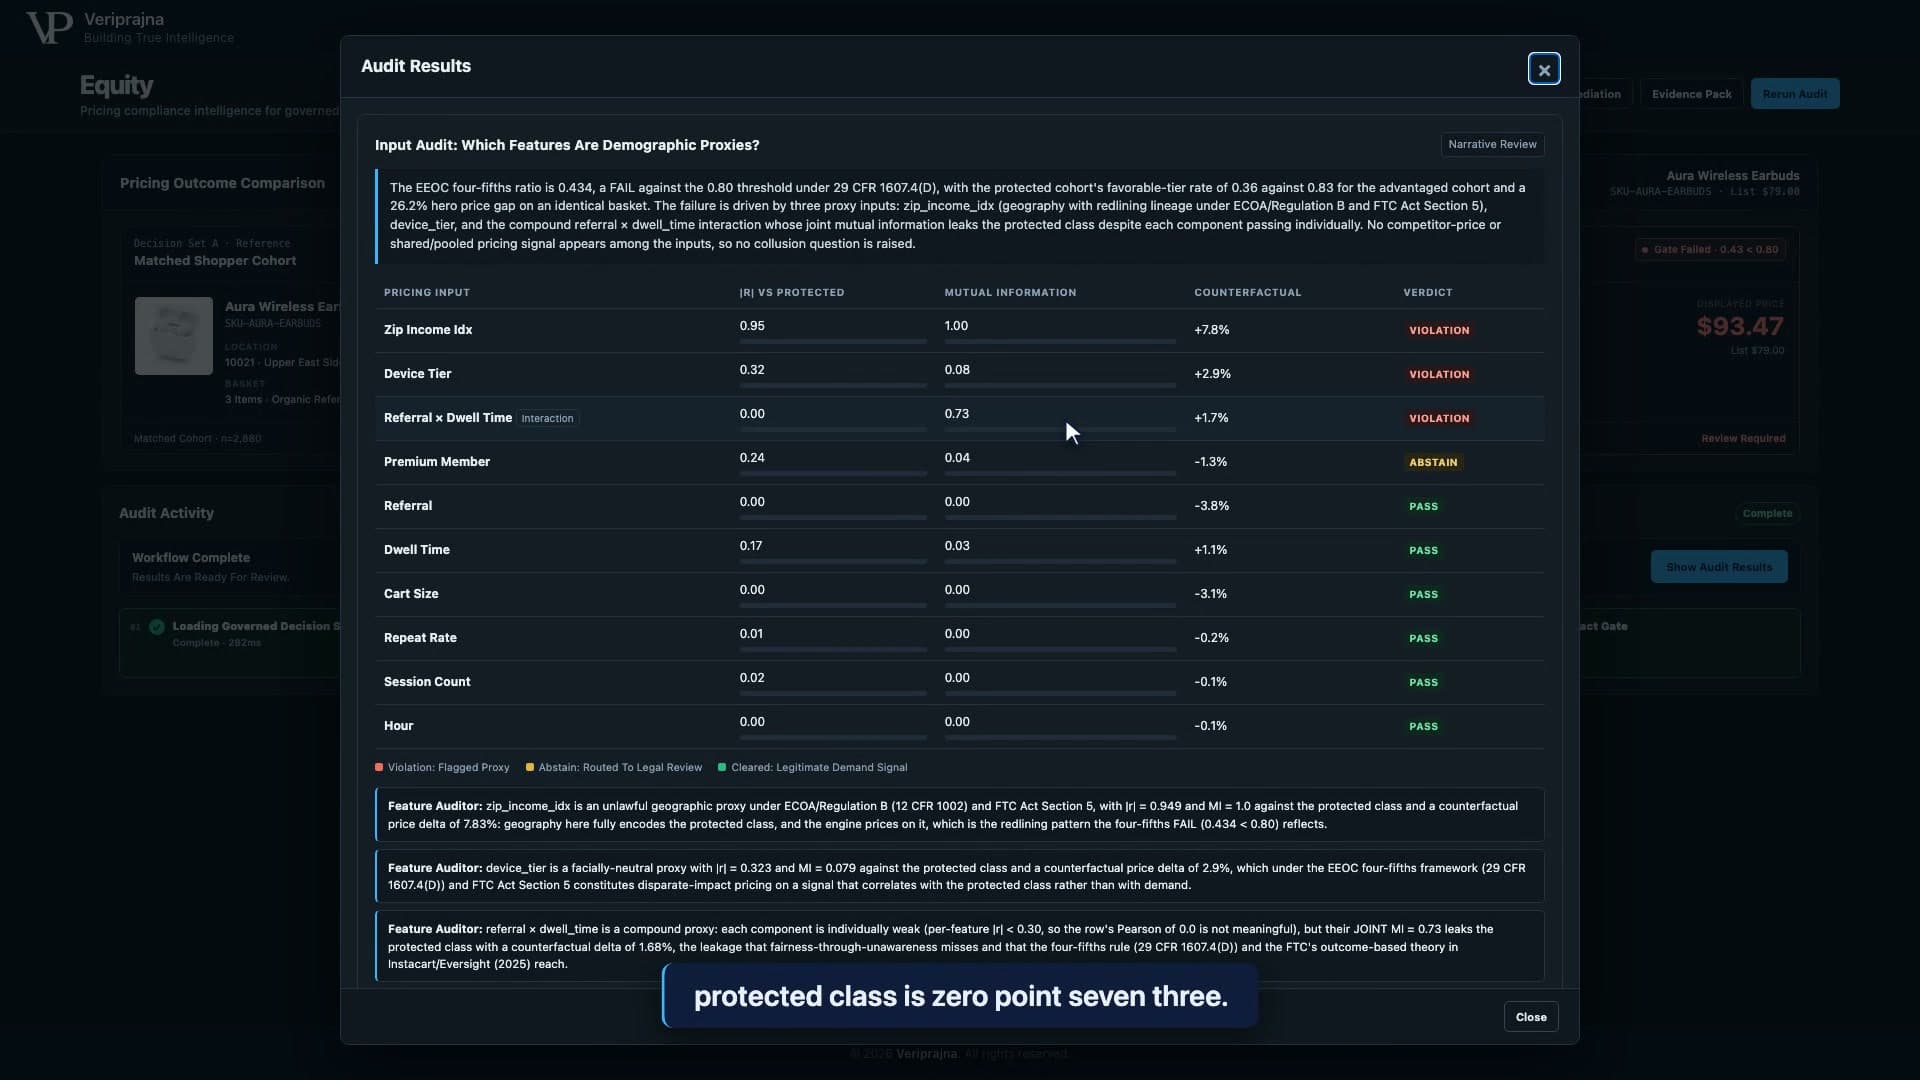
Ich hatte diese Struktur im XOR-Stil angelegt. Ein organischer Einstieg mit langer Verweildauer markiert die geschützte Kohorte. Ein Preisvergleichs-Einstieg mit kurzer Verweildauer markiert sie ebenfalls. Organisch-kurz und Preisvergleich-lang markieren die begünstigte Kohorte. Weder Einstieg noch Verweildauer trennen die Gruppen isoliert; erst das Paar tut es. Korrelation ist ein eindimensionales Instrument und blind dafür. Mutual Information über das Paar erkennt es. Ein Compliance-Programm, das Eingaben isoliert nacheinander prüft, auditiert das falsche Objekt, und ich sah keinen anderen Weg, das zu belegen, als eine Population zu konstruieren, bei der die Einzelprüfung nachweisbar falsch liegt.
Die Verteidigung, die ich früher vorgebracht hätte
Ich testete die Verteidigungslinie, die ich früher selbst einer Aufsichtsbehörde präsentiert hätte – Fairness through Unawareness: PLZ- und Geräteeingaben entfernen, Engine neu trainieren, Ergebnis vorlegen. Ich wusste, dass der zusammengesetzte Proxy vorhanden war. Was ich nicht wusste, war, wie viel der 0.43 allein auf PLZ und Gerät entfiel und wie viel auf das versteckte Paar. Das Entfernen von PLZ und Gerät und das erneute Training verschob das Vier-Fünftel-Verhältnis von 0.43 auf 0.59. Immer noch durchgefallen, und die verbleibende Lücke ist genau der Teil, der jedes Einzelfeature-Audit übersteht. Die Benchmark-Karte benennt den Grund in vier Worten: Compound Proxy Still Leaks.
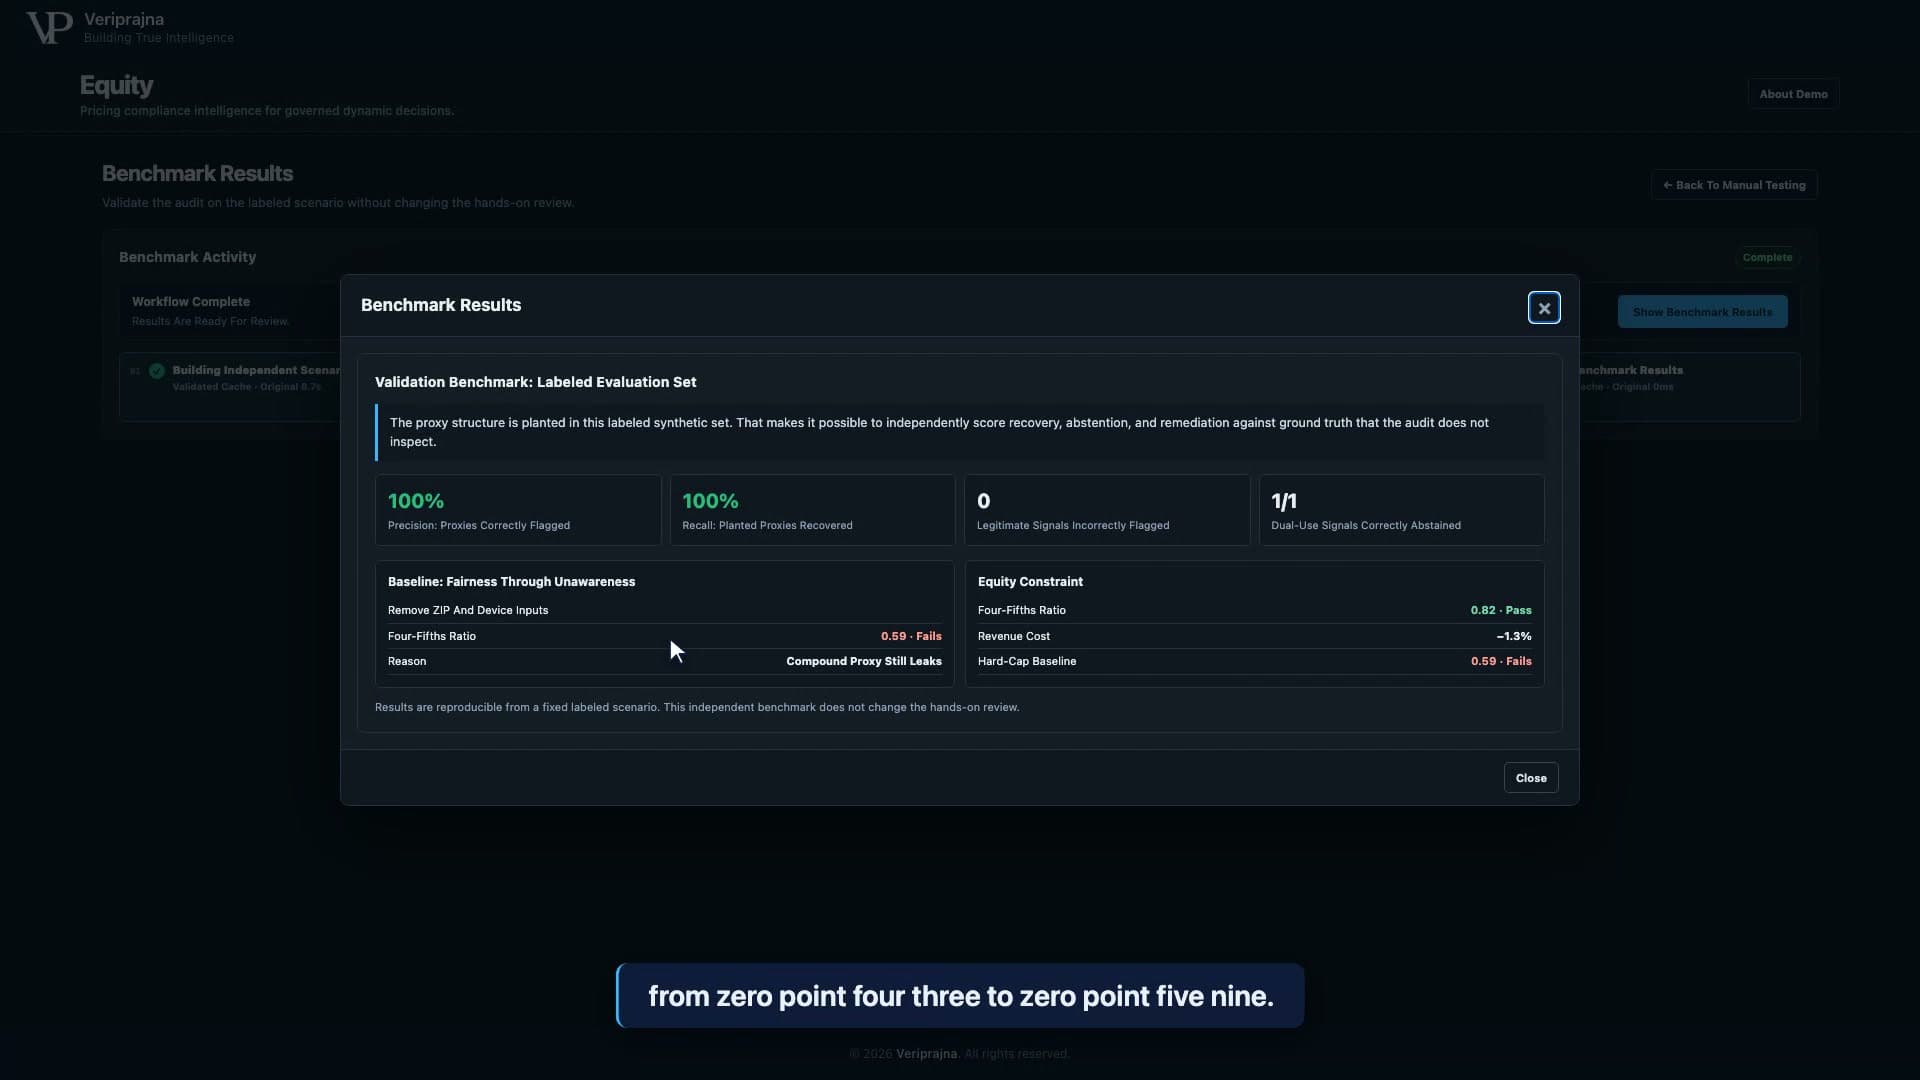
Dieses Ergebnis veränderte meine Sicht auf jenen Satz. Die Engine fand die Kohorte trotzdem, über zwei Signale, die jeden Einspaltentest bestehen, und sie wird sie immer wieder finden – denn das Auffinden ist genau das, wofür ein Ertragsmaximierer belohnt wird. Die Unawareness-Baseline kostet das Team nichts zu behaupten, liefert ihm aber eine Zahl, die es später erklären muss.
Die 100 % auf dieser Karte haben eine präzise Bedeutung. Der Benchmark rekonstruiert dieselbe Seed-42-Population und bewertet das Audit anhand der von mir platzierten Labels; Precision und Recall von 100 % bedeuten 3 von 3 platzierten Proxys ohne False Positives erkannt auf diesem gelabelten synthetischen Set. Es ist ein Selbstabgleich gegen bekannte Ground Truth, den ich nicht als Genauigkeitsrate auf realen Pricing-Logs zitieren würde, die auf Weisen verzerrt sind, die sich synthetisch nicht simulieren lassen.
Was 0.43 bedeutet und warum kein Modell darüber entscheiden durfte
Ich weigerte mich, eine hauseigene Fairness-Kennzahl zu erfinden, denn eine selbst ausgedachte Zahl muss keine Behörde anerkennen. Das Gate in Equity ist ein externer Rechtsstandard: die Vier-Fünftel-Regel der EEOC, 29 CFR 1607.4(D), übertragen von Auswahlquoten auf Preisstufen. Begünstigt bedeutet hier: nicht die höchste Preisstufe erhalten. In der ausgelieferten Engine erhalten 36 % der geschützten Kohorte die günstige Stufe gegenüber 83 % der begünstigten Kohorte. 0.36 geteilt durch 0.83 ergibt 0.43, der Schwellenwert liegt bei 0.80, und die Skala steht rot auf Fail. Daneben: 64 % der geschützten Kohorte in der höchsten Preisstufe und ein durchschnittlicher Aufpreis von +15.6 % gegenüber der begünstigten Kohorte.
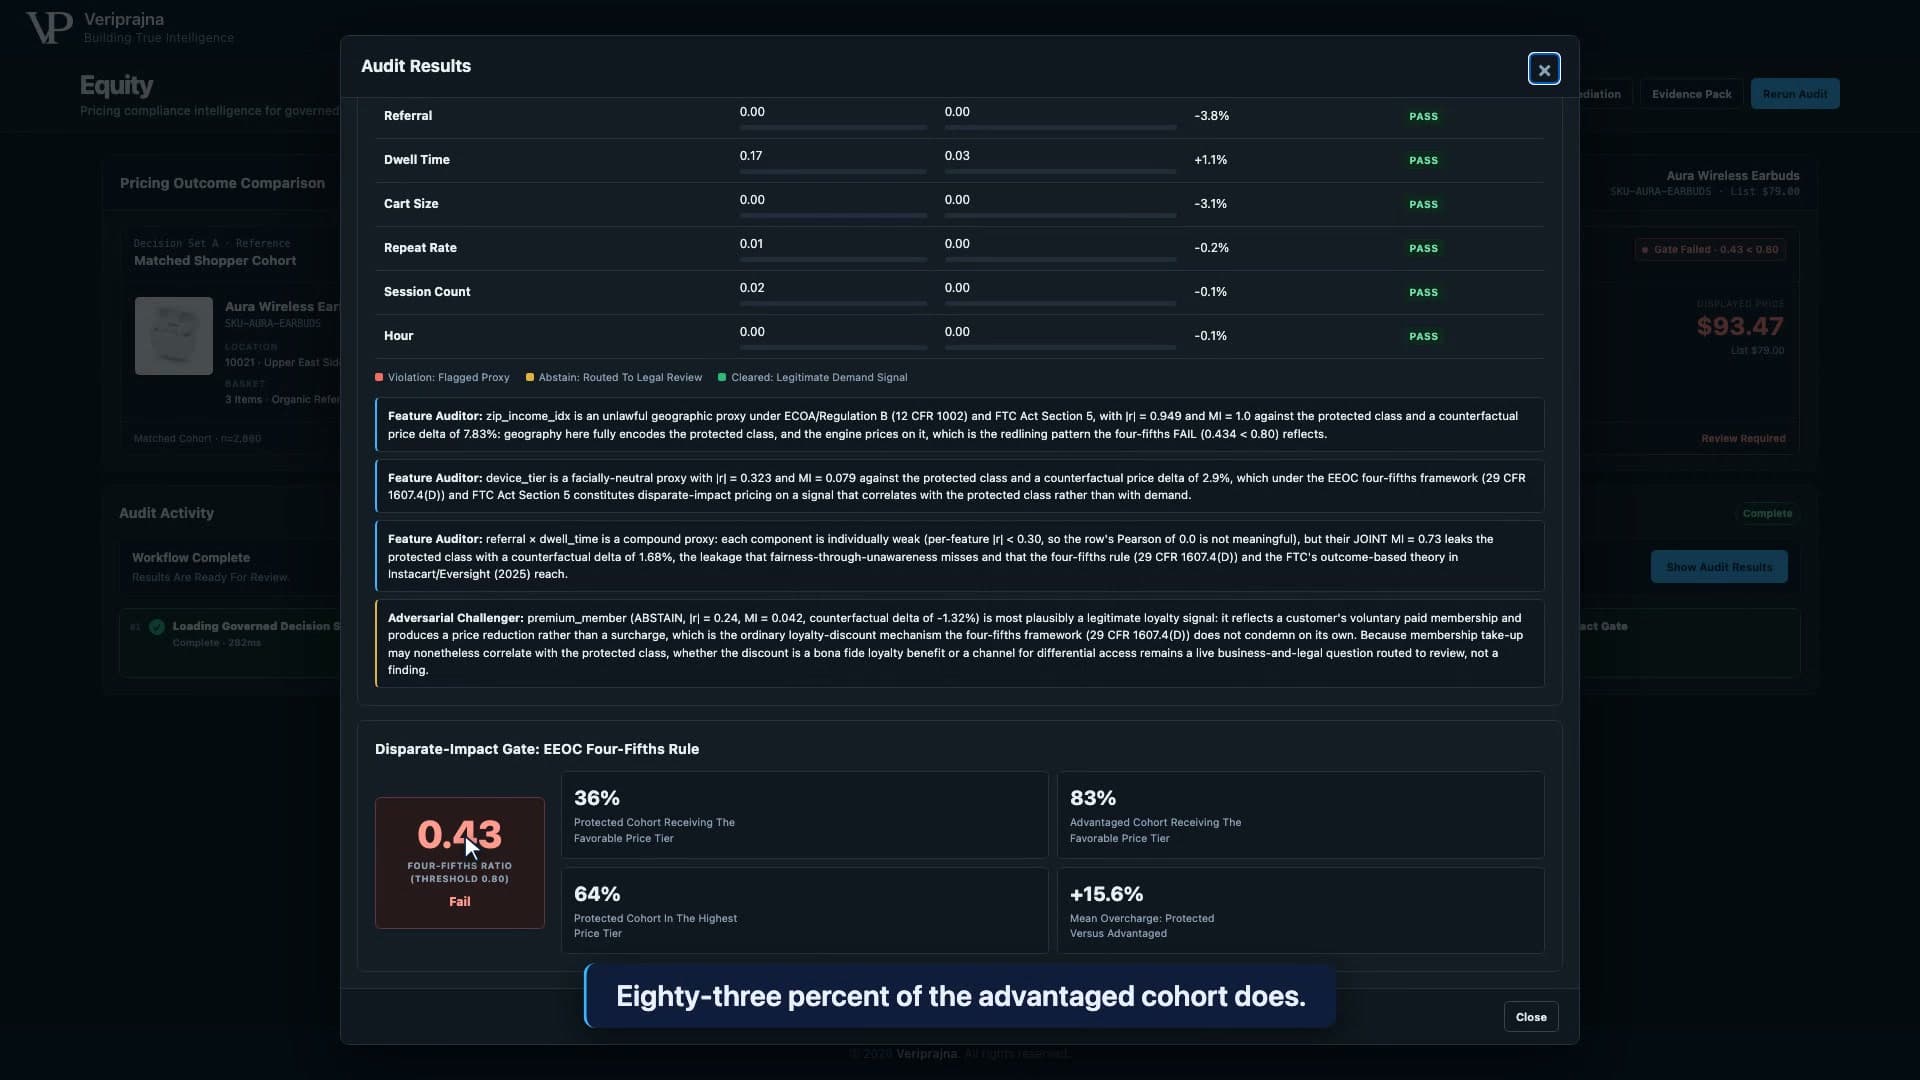
Die Urteilslogik läuft in reinem NumPy, außerhalb der Agentenschicht, in einer festen Reihenfolge, die ich jedem Juristen vorlesen kann. Das Dual-Use-Signal wird vor dem Verstoßtest geprüft: Premium-Mitglied korreliert zu 0.24 mit der geschützten Kohorte, ist aber zugleich ein legitimes Treuesignal. Der Code gibt daher ABSTAIN aus und leitet es an die Rechtsprüfung weiter, statt es zu verurteilen oder freizugeben. Nachgelagerte Schritte dürfen dies nicht eigenmächtig zum Verstoß hochstufen. Danach folgen die Verstoßschwellen, die Enthaltungsbandbreite und schließlich PASS. Warenkorbgröße, Wiederkaufrate, Sitzungsanzahl und Uhrzeit bestehen alle. Das Audit markiert nicht pauschal alles, und ein Audit, das alles beanstandet, ist vor einer behördlichen Auskunftsanordnung (Civil Investigative Demand) genauso wertlos wie eines, das gar nichts findet.
Die Agenten im Team – ein Feature Auditor und ein Adversarial Challenger – formulieren Begründungen; die dritte Rolle im Konzept, der Regulatory Mapper, ist in diesem Build eine feste Lookup-Tabelle statt eines Modells. Die Aufgabe des Challengers besteht darin, die Treuevorteile des Merkmalwerts Premium-Mitglied maximal zu verteidigen, was auf dem Bildschirm sichtbar geschieht. Er kann jedoch weder die 0.24 verändern noch ein Urteil kippen oder entscheiden, ob 0.43 unter 0.80 liegt. Diese Trennung stand von Beginn an fest: Agenten beraten, Code entscheidet, und das Modell darf so überzeugend argumentieren, wie es will – über Zahlen, die es nicht verändern darf.
Der Fix, von dem ich hoffte, dass er funktioniert
Die erste Korrektur, die ich ausprobierte, war eine Obergrenze, weil jedes Pricing-Team reflexartig dazu greift: niemals mehr als 15 % über dem fairen Referenzpreis verlangen. Ich implementierte dies als Hard-Cap-Baseline und erwartete eine unspektakuläre, tragfähige Lösung. Sie kostete 0.2 % des Umsatzes und scheiterte am Gate mit 0.59. Die Gaming-Signatur auf der Karte verdeutlicht die Ursache: 29 % der geschützten Kohorte wurden punktgenau innerhalb von 1 % unterhalb des Deckels eingestuft. Das Urteil lautet Gamed To The Boundary. Der Deckel ist billig, weil die Engine die betroffene Kohorte schlicht knapp darunter bepreiste – und billig-und-durchgefallen ist eine Kombination, die im Budgetmeeting charmant wirkt, der Beweisaufnahme aber nicht standhält.
Ein Ertragsmaximierer behandelt eine Obergrenze als Zielmarke.
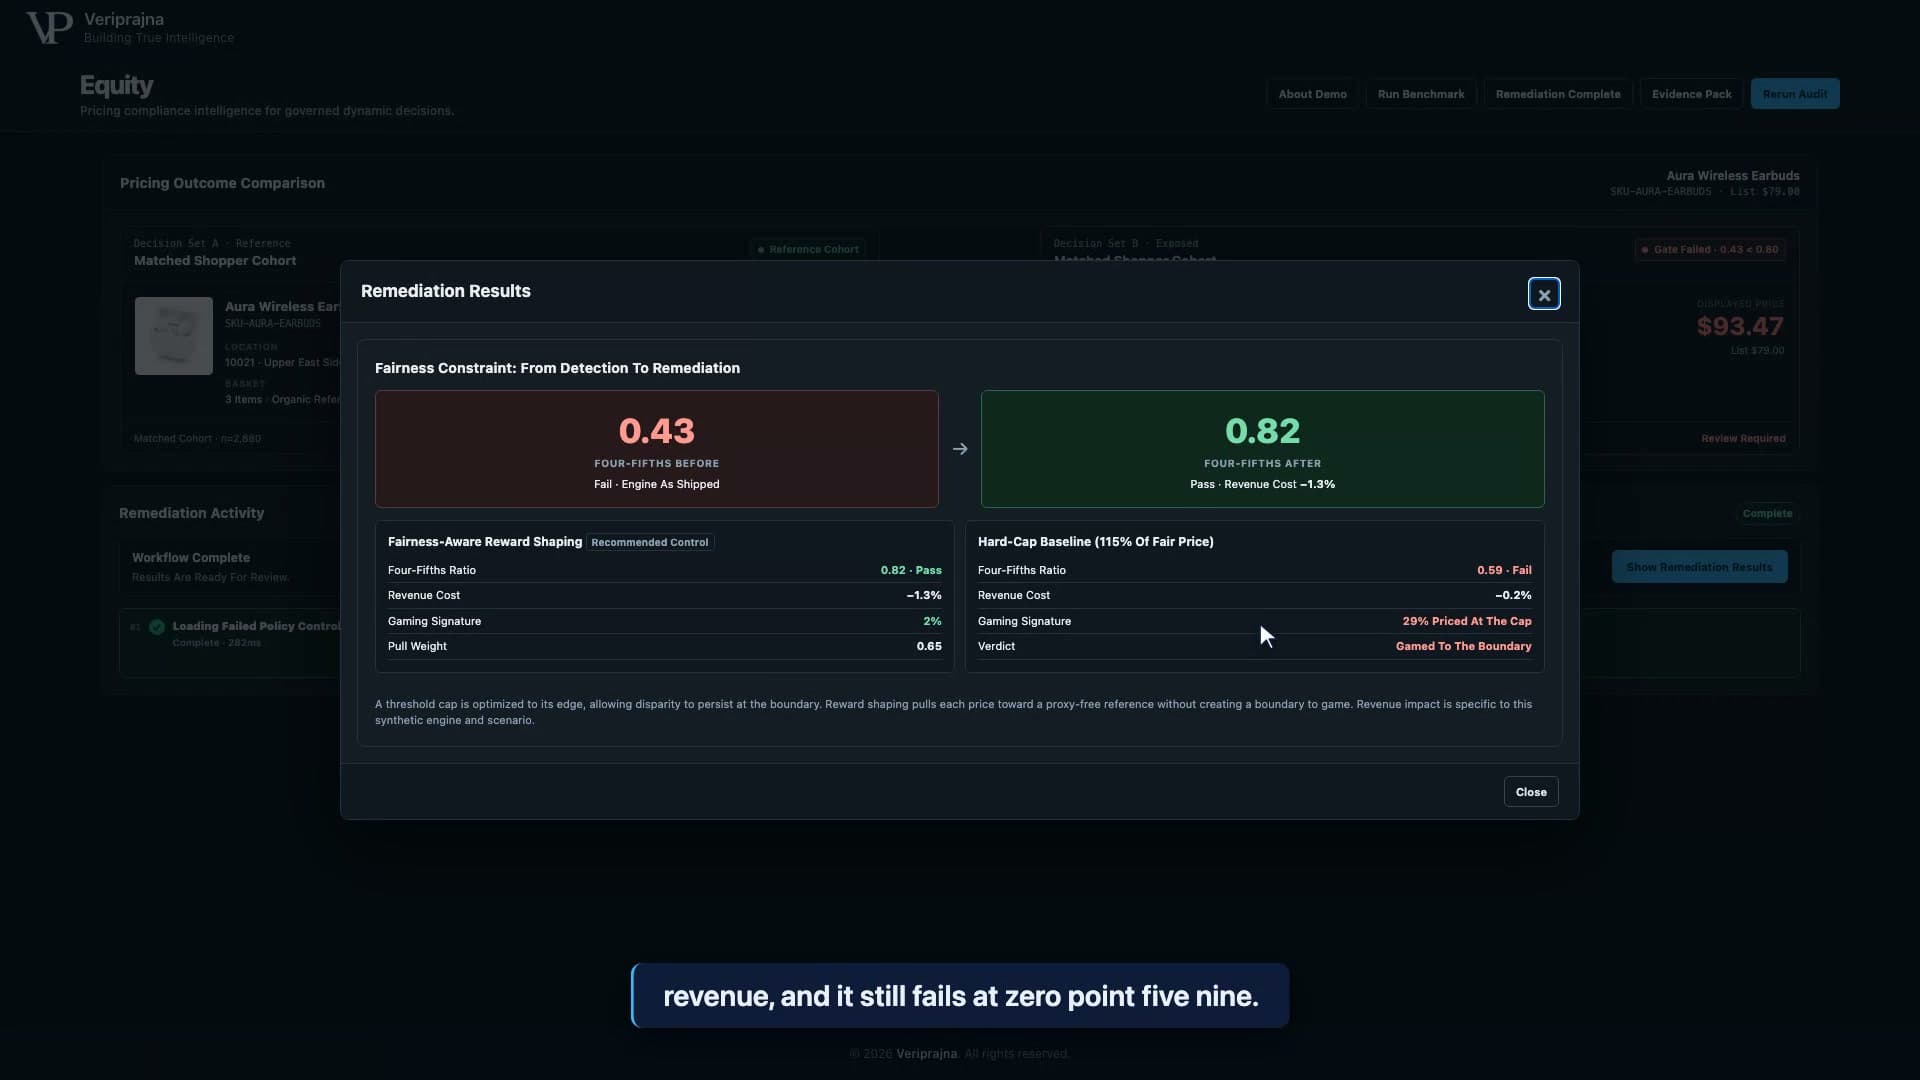
Der Steuerungsmechanismus, der standhielt, ist Fairness-Aware Reward Shaping. Statt einer starren Grenze zieht er jeden Preis kontinuierlich zu einem proxyfreien Referenzpreis hin – einem zweiten Banditen, der ohne die Proxys, aber mit allen legitimen Signalen trainiert wurde –, und ermittelt per binärer Suche das kleinste Gewicht, das 0.80 übertrifft. Bei dieser Engine liegt das Gewicht bei 0.65; eine Stufe tiefer, bei 0.625, wurden nur 0.778 erreicht. Vier-Fünftel-Wert danach: 0.82, Pass. Umsatzkosten: 1.3 %. Gaming-Signatur 2 %, weil es keine Kante gibt, die man ausnutzen könnte. Das Kleingedruckte der Konsole weist darauf hin, dass die Umsatzauswirkung spezifisch für diese synthetische Engine ist – und ich betone das ausdrücklich: 1.3 % ist ein Messwert auf einer synthetischen Testpopulation, kein allgemeingültiger Pauschalpreis für Fairness.
Wozu die Dokumentation dient
Ich habe das Evidence Pack zuletzt gebaut, denn alles Vorherige zählt nur, wenn ein Jurist es vorlegen kann. Trifft ein behördlicher Civil Investigative Demand ein, verbringt ein Unternehmen ohne saubere Protokollierung Monate mit forensischer Datenrekonstruktion. Equity versiegelt die Audit-Ergebnisse in einem JSON-Paket mit druckbarer HTML-Fassung: Engine-Name und Version, die 10.000 auditierten Entscheidungen, das Gate, die repräsentative Disparität, Befunde und Rationale jedes Merkmals, das Behebungsergebnis sowie ein manipulationssicherer SHA-256-Hash des Paketkörpers. Jede VIOLATION ist fünf Rechtsregimen zugeordnet: der EEOC-Vier-Fünftel-Regel, dem New York Algorithmic Pricing Disclosure Act (in Kraft ab 10. November 2025, Zivilstrafe bis zu 1.000 $ pro Verstoß), dem Colorado AI Act (SB 24-205, in Kraft ab 30. Juni 2026), dem EU AI Act Artikel 13 und 14 (Hochrisikopflichten ab 2. August 2026) sowie FTC Act Section 5. Das neutrale Merkmal verweist auf eine juristische Einzelfallprüfung.
Die rechtliche Zuordnung ist eine feste Tabelle. Es wäre ein Leichtes gewesen, sie von einem Modell verfassen zu lassen, doch ich entschied mich dagegen: Jede VIOLATION erhält exakt dieselben fünf Zeilen, die Enthaltung erhält eine Prüfzeile, und für das Mapping wird keinerlei Fließtext generiert. Ein Modell, das über Paragrafen spekuliert, ändert seine Argumentation beim nächsten Release – und ein Auditpaket, dessen Rechtszuordnung mit dem Modell driftet, zerlegt ein behördlicher Gutachter im Handumdrehen. Die Begründungen im Paket sind modellgeneriert und gecacht; Zahlen, Urteile und Rechtszuordnungen stammen aus deterministischem Code. Das Paket bleibt justiziabel, ganz gleich, welches Modell darunterliegt. Die detaillierte Aufschlüsselung mit Bildschirmführung durch das Paket findet sich unter veriprajna.com/demos/ai-pricing-compliance.
Veriprajna setzt keine Preise fest, ersetzt weder Pricefx, PROS, Zilliant noch Competera und fällt kein Rechtsurteil. Die Engine des Kunden preist weiter. Ich liefere die Nachweise; die Rechtsabteilung trifft die Entscheidung.
Und wenn Sie den Audit-Lauf lieber ansehen möchten, statt meine Beschreibung zu lesen: Hier ist das gesamte System von Anfang bis Ende.
Ich kehre immer wieder zu jenem Satz des Pricing-Teams zurück, denn er ist wahr: Herkunft und Einkommen befinden sich nicht im Modell. Bei der Engine, die ich gebaut habe, steht dieser wahre Satz neben 26 % Preisunterschied bei denselben Kopfhörern, einem Gate bei 0.43 und einem Deckel, der funktionierte, während er in Wahrheit scheiterte. Niemand sagte der Engine, wer der Kunde war. Eine Ertragsbelohnung genügte völlig, denn das Erraten des Kunden war die profitabelste Schätzung – und das Audit maß exakt, wie weit sie ging. Der Satz, der vor Gericht standhält, ist ein längerer: Wir wussten, dass die Engine die Kohorte ohne Vorgabe aufspüren konnte, wir haben gemessen, wie weit sie ging, und das waren die Kosten, um sie zu stoppen.