ClaimLens · KI-Behauptungssubstantiierung
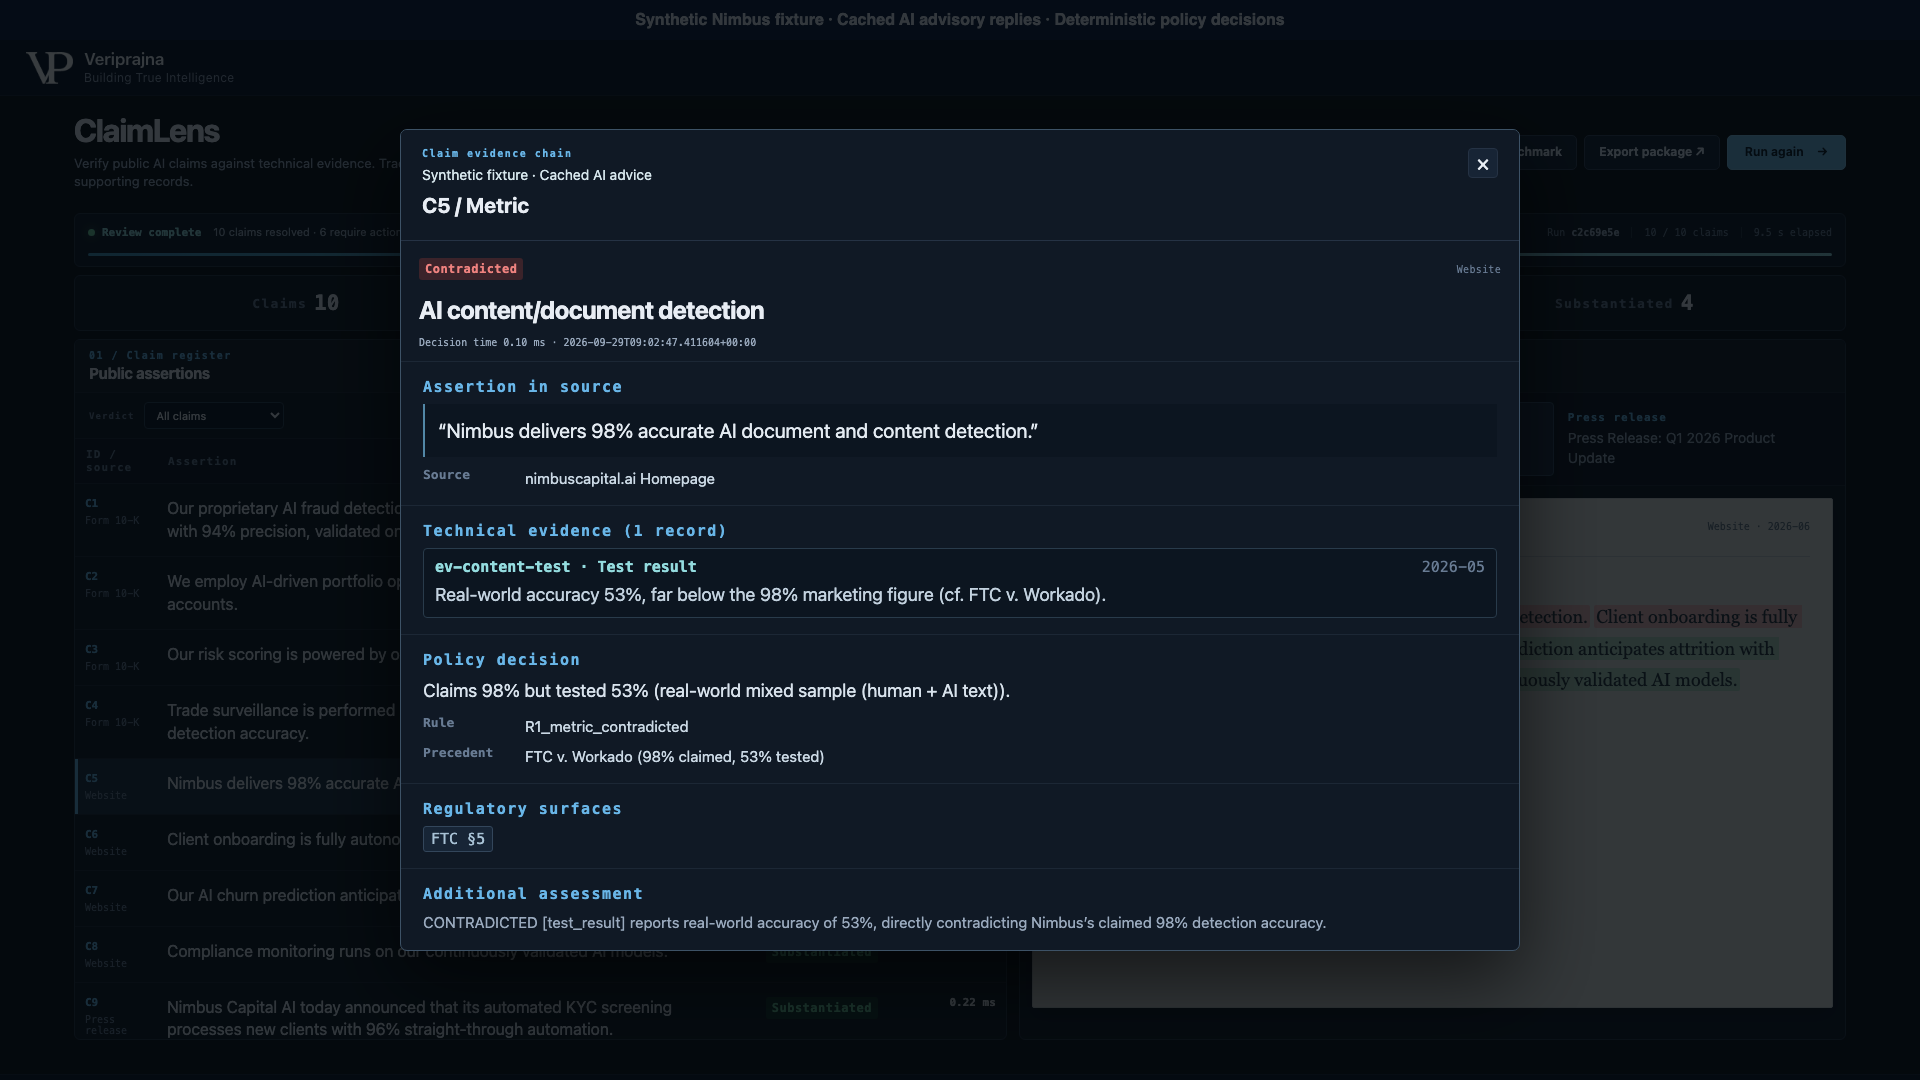
Synthetic Nimbus Capital AI wirbt mit einer Genauigkeit von 98 % bei der Inhaltserkennung. Der bereitgestellte Test verzeichnet 53 %. ClaimLens hält Satz, Belege und Entscheidungsregel zusammen, damit Prüfer die Diskrepanz untersuchen können.
6 min 56 sec · Synthetische Datensätze · Zwischengespeicherte beratende Antworten
98 % behauptet
Genauigkeit der Inhaltserkennung
Aussage auf der Website von Synthetic Nimbus
53 % verzeichnet
Bereitgestelltes Testergebnis für gemischten Text
Synthetic Nimbus Test-Fixture
45-Punkte-Lücke
Überschreitet die konfigurierte Toleranz
Demo-Regel: mehr als 5 Prozentpunkte
Eine Überprüfung bereitgestellter Datensätze für Rechts-, Compliance-, Marketing- und Entwicklerteams. Demo-Urteile begründen keine Rechtskonformität und validieren die Belege nicht unabhängig.
Eine Genauigkeitsbehauptung verpflichtet ein Team auf eine Aufgabe und ein gemessenes Ergebnis. Eine Aussage über vollständige Autonomie trifft zugleich eine Behauptung über menschliche Beteiligung. Die Überprüfung muss diese Zusagen lange genug festhalten, um sie mit den Datensätzen hinter dem Wortlaut abzugleichen.
Im Nimbus-Beispiel ist der entscheidende Befund das Verhältnis zwischen der beworbenen Genauigkeit und dem bereitgestellten Test. Ein Prüfer kann erkennen, welcher Satz Aufmerksamkeit erfordert und warum. Derselbe Datensatz macht auch die nächste Frage konkret: Ist die Formulierung falsch, sind die Belege unvollständig oder muss der zugrunde liegende Test untersucht werden?
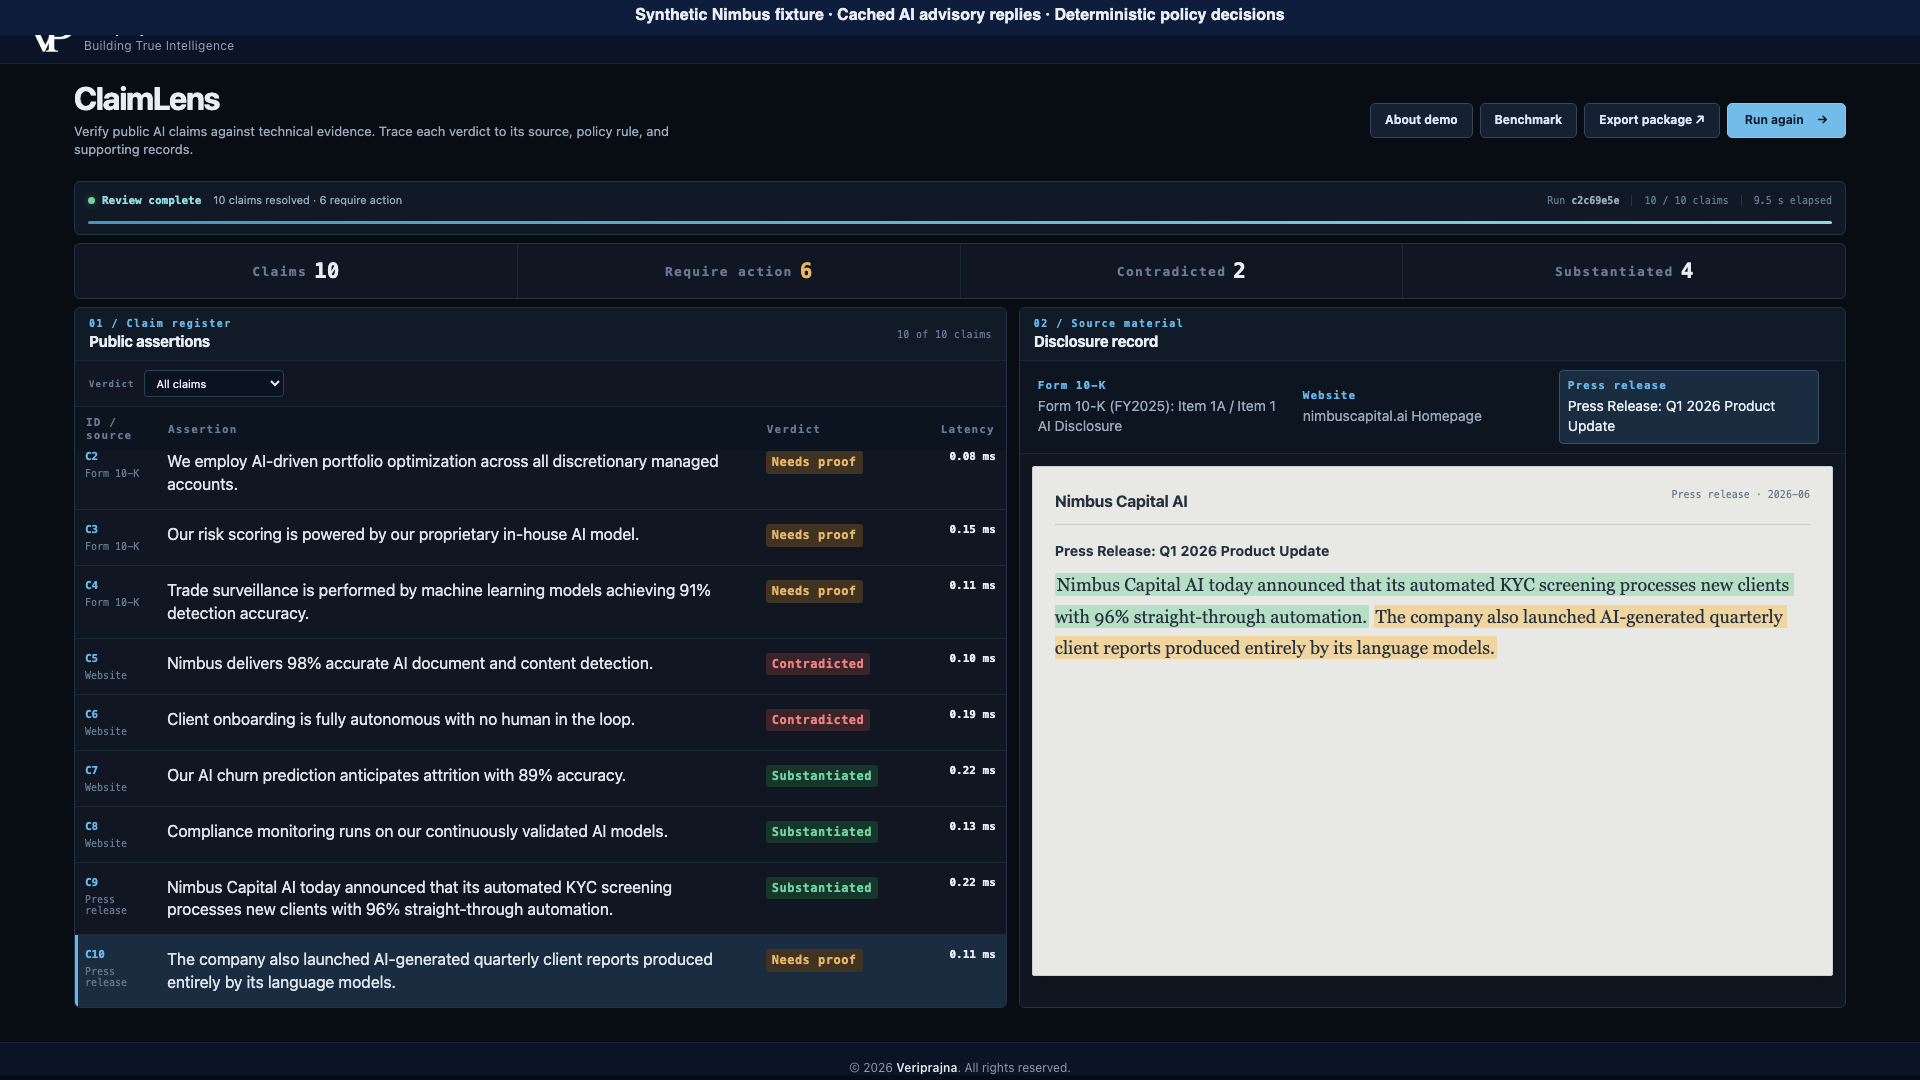
Wir demonstrieren einen abgegrenzten Workflow über drei synthetische Offenlegungen und 14 bereitgestellte Belegdatensätze. Er extrahiert zehn Behauptungen, verknüpft deren Gegenstände mit Datensätzen und behält die Begründung für jedes konfigurierte Urteil bei.
01 / EXTRACT
Deterministische Satztrennung sowie KI-Schlüsselwort- oder Subjektabgleich wählen Behauptungen aus den gebündelten Offenlegungen aus. Der ursprüngliche Wortlaut bleibt sichtbar.
02 / LINK
Das Retrieval gleicht ein strukturiertes Gegenstandsfeld mit Test- und Betriebsdatensätzen ab. Es führt keine semantische Suche durch und authentifiziert diese Datensätze nicht.
03 / DECIDE
Reines Python wendet konfigurierte Prüfungen an. Eine numerische Diskrepanz von über fünf Prozentpunkten führt im gezeigten Metrik-Beispiel zu CONTRADICTED.
Der Substantiation Judge berät, ohne die Gate-Entscheidung zu ändern. Der Adversarial Examiner wird bei Gate-substantiierten Behauptungen ausgeführt und kann diese auf PARTIALLY_SUBSTANTIATED herabstufen, wenn er REFUTED zurückgibt; er kann sie nicht heraufstufen. Die Aufzeichnung gibt zwischengespeicherte beratende Antworten wieder, während die deterministischen Prüfungen ablaufen. Alle vier zwischengespeicherten Prüferantworten bestätigen ihre gestützten Ergebnisse.
Der abgeschlossene Durchlauf kann ein JSON-Substantiierungspaket exportieren. Es enthält die Behauptung, Quelle, das Urteil, die Regel, Begründung und Belegkennungen für die Nachverfolgung sowie Zusammenfassungs- und Versionsinformationen. Es verweist auf die zugrunde liegenden Datensätze; es bettet kein vollständiges Belegarchiv ein.
Diese Ansichten stammen aus der lokalen ClaimLens-Demonstration. Jedes hier gezeigte Nimbus-Unternehmen, jede Offenlegung, jeder Test- und Betriebsdatensatz ist synthetisch.
Die separate Onboarding-Aussage verspricht keinen Menschen im Ablauf (No Human in the Loop). Das synthetische Betriebsprotokoll verzeichnet 68 % menschliche Eingriffe. Die konfigurierte No-Human-Regel gibt oberhalb von 10 % Eingriff CONTRADICTED zurück; dieser Schwellenwert ist eine Demo-Festlegung, keine rechtlich ausreichende Grenze.
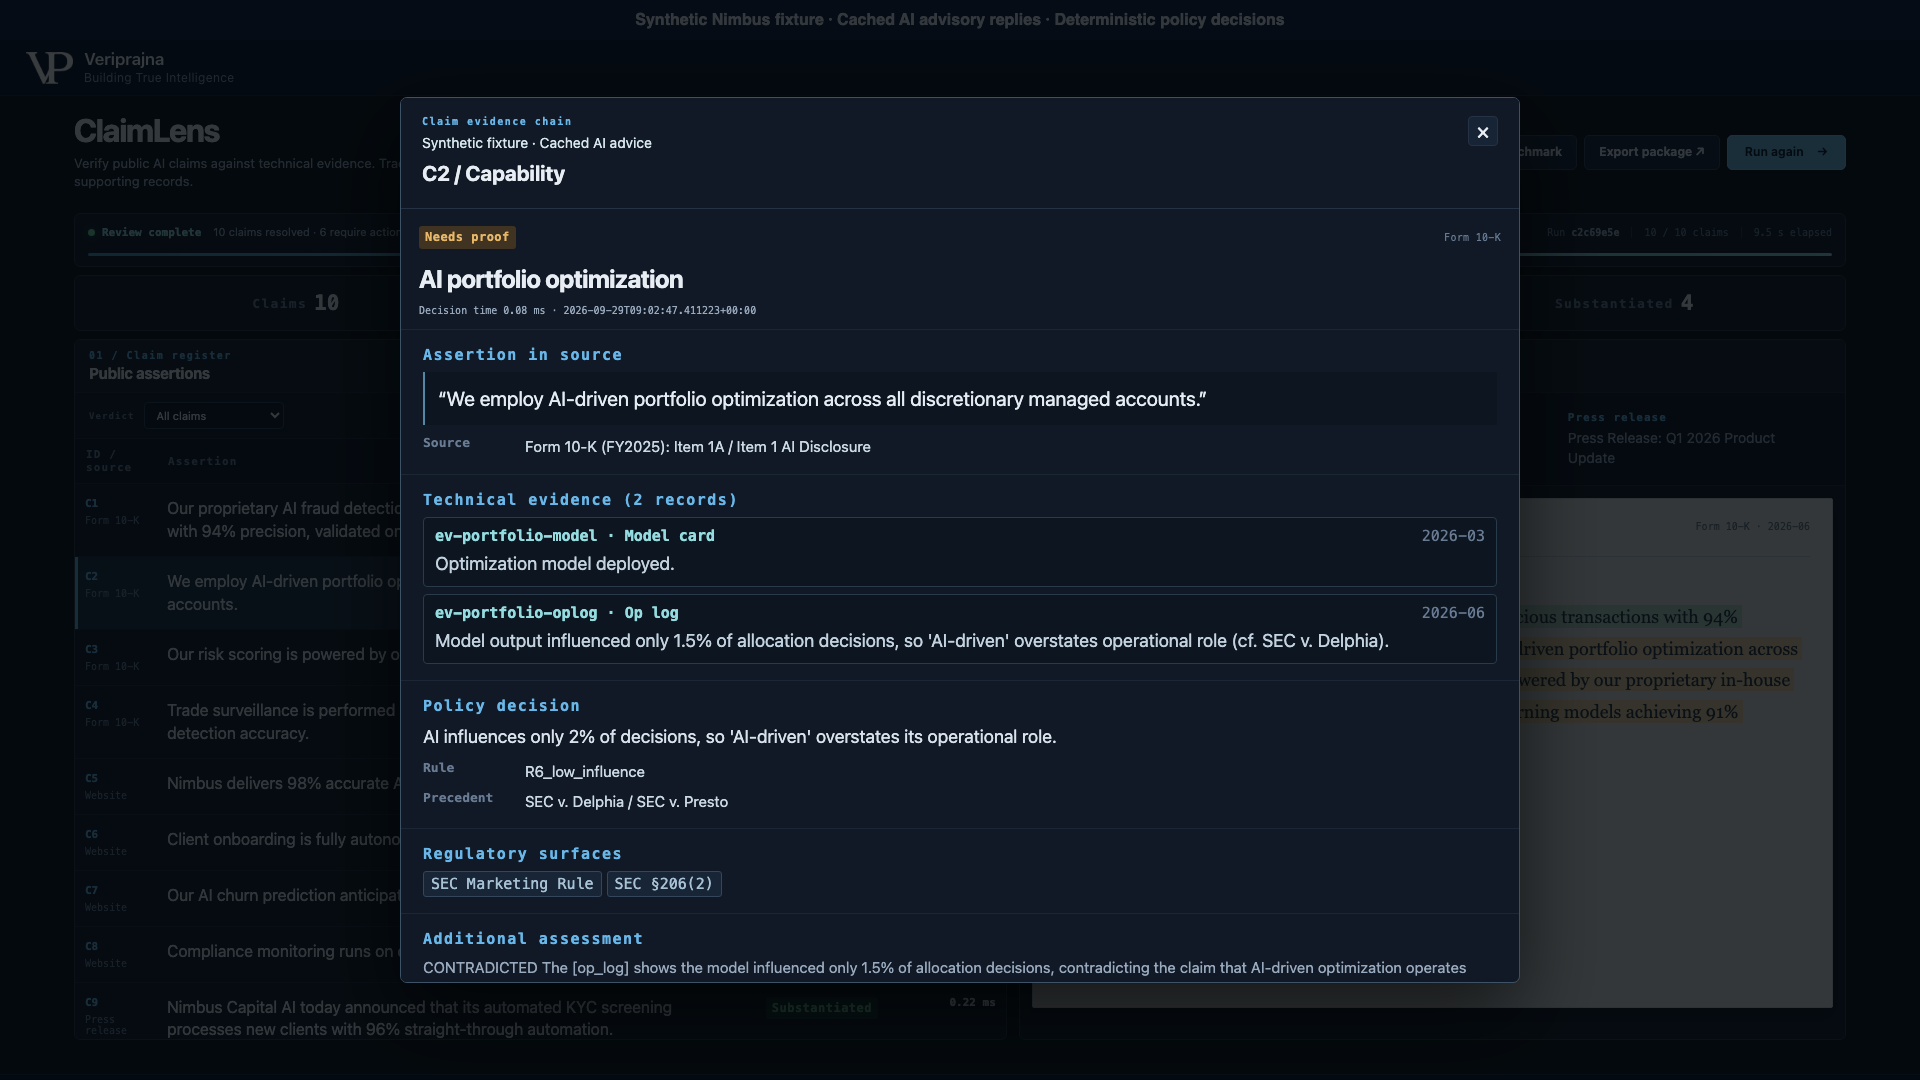
Das Portfolio-Modell existiert, aber das bereitgestellte Protokoll verzeichnet Einfluss auf lediglich 1.5 % der Allokationsentscheidungen. Das Gate gibt NEEDS_PROOF zurück. Der zwischengespeicherte Judge bezeichnet es als widersprüchlich und zeigt damit, warum eine beratende Stellungnahme und ein Endergebnis getrennte Labels benötigen.
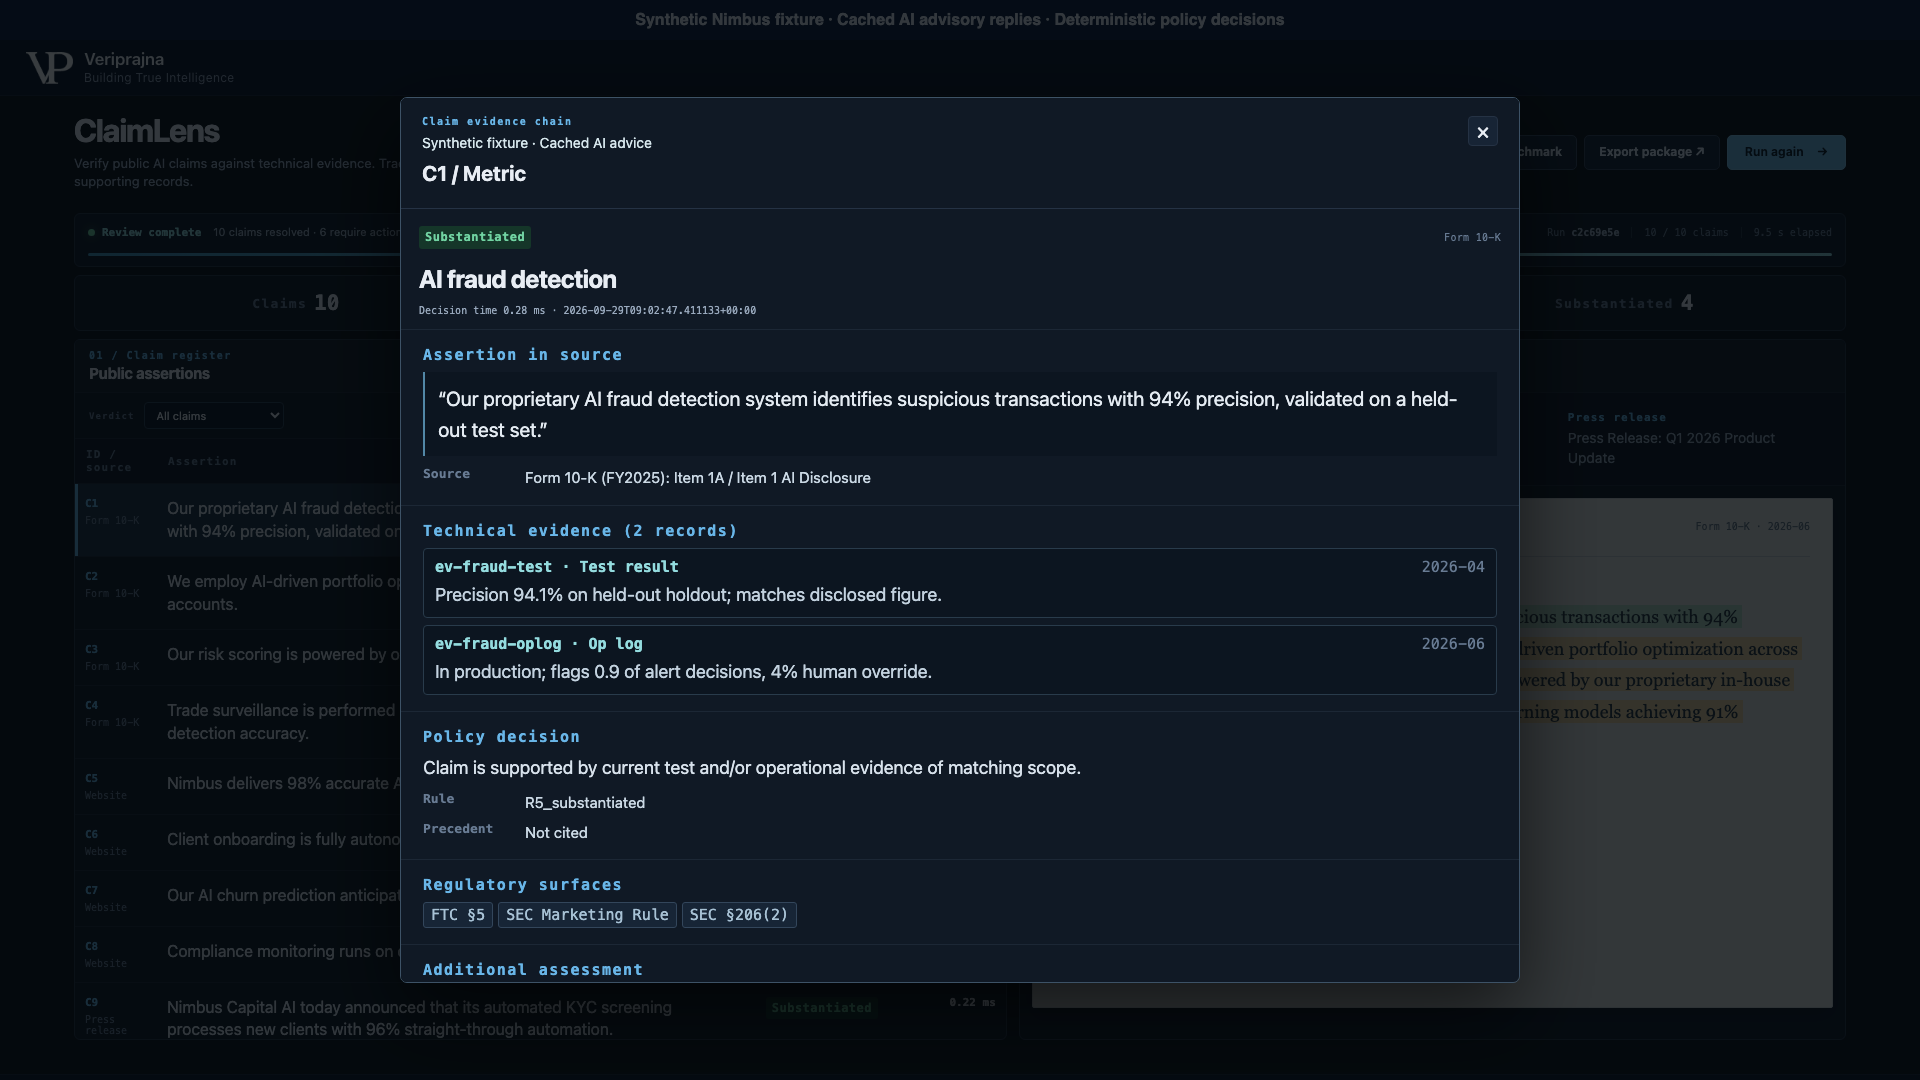
Die synthetische Betrugserkennungs-Behauptung bleibt mit ihrer offengelegten Präzision von 94 % sowie stützenden Test- und Betriebsdatensätzen substantiiert. Ein gestütztes Test-Fixture-Ergebnis ist dennoch nur eine Behauptung über bereitgestellte Datensätze. Der Prüfer muss die realen Messungen und deren Relevanz validieren, bevor er sich auf den tatsächlichen Wortlaut verlässt.
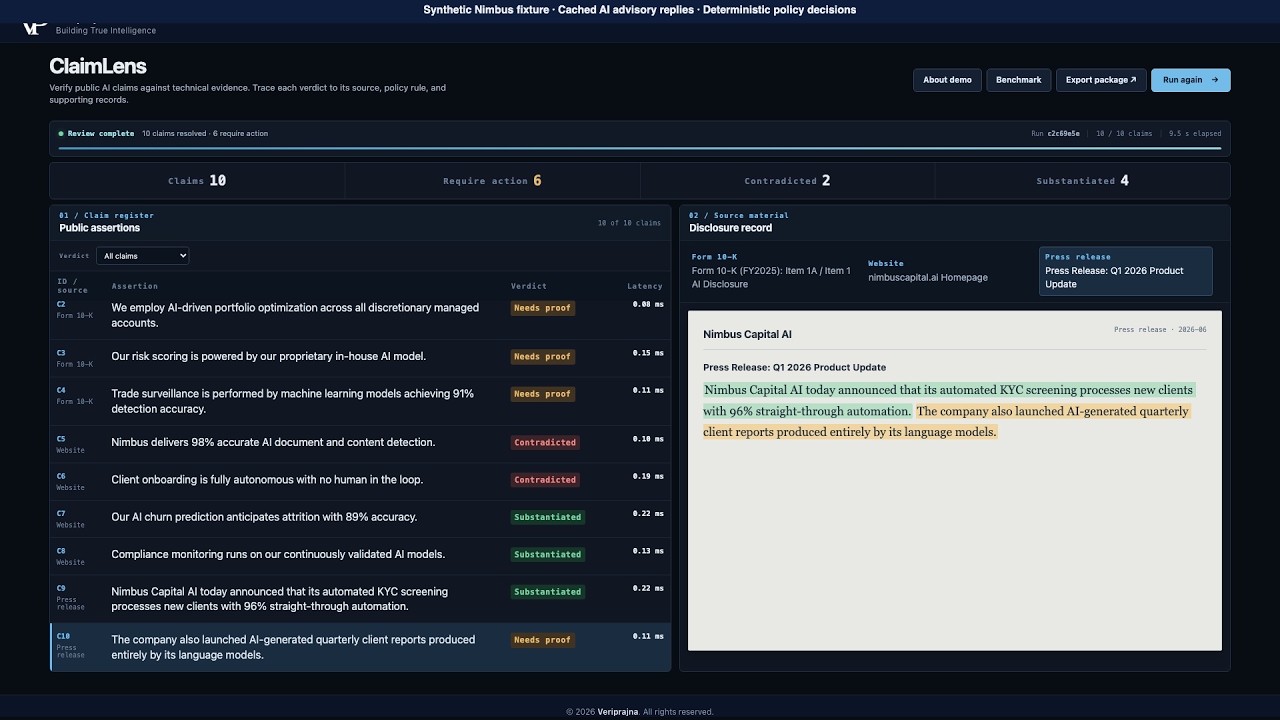
ClaimLens demonstriert einen Abgleich von Behauptungen mit Datensätzen. Die Tabelle unterscheidet das, was der aufgezeichnete Workflow überprüfbar macht, von der Arbeit, die eine reale Prüfung weiterhin erfordert.
| Prüfaufgabe | Was diese Demonstration bietet | Was außerhalb ihres Rahmens bleibt |
|---|---|---|
| Die Verpflichtung ermitteln | Ein Satz, verknüpft mit seiner bereitgestellten Quelle | Allgemeine Dokumentenerfassung und vollständige Erkennung von Behauptungen |
| Die Belege abgleichen | Gegenstandsbasierte Datensatzverknüpfung und konfigurierte Prüfungen | Belegauthentifizierung und unabhängige Testbewertung |
| Das Ergebnis verstehen | Ein Urteil, eine Entscheidungsregel und eine Begründung | Rechtsberatung oder behördliche Genehmigung |
| Die Überprüfung übergeben | Ein JSON-Paket mit Belegkennungen | Ein vollständiges Belegarchiv oder manipulationssichere Verwahrung |
Dies ist eine lokale Demonstration unter Verwendung gebündelter synthetischer Daten. Sie umfasst keinen Live-Website- oder Meldedatei-Crawler, keinen beliebigen Dokumenten-Upload, keine produktive AIBOM- oder CI/CD-Integration, kein semantisches Retrieval, keine autonome rechtliche Bewertung und keinen HTML-Binder-Export. Ihre Schwellenwerte begründen weder statistische Konfidenz noch rechtliche Hinlänglichkeit. Diese Seite erläutert den aufgezeichneten Workflow; sie bietet keinen Zugriff auf die lokale Anwendung.
ClaimLens gleicht bereitgestellten Wortlaut und technische Datensätze anhand konfigurierter Demo-Regeln ab. Ein substantiiertes Ergebnis ist keine rechtliche Freigabe, und die in der Benutzeroberfläche angezeigten Regulierungslabels sind illustrative Routing-Labels. Eine menschliche Überprüfung und Validierung der zugrunde liegenden Datensätze bleibt weiterhin erforderlich.
Diese Demonstration verwendet den gebündelten synthetischen Nimbus-Datensatz. Sie akzeptiert keine beliebigen Dokumenten-Uploads und crawlt weder Websites noch behördliche Meldungen oder interne Systeme. Die Seite zeigt den aufgezeichneten Workflow und dessen Belegansichten.
Die Demo verknüpft extrahierte Sätze über ein strukturiertes Gegenstandsfeld mit bereitgestellten technischen Datensätzen. Diese Datensätze umfassen Tests und Betriebsprotokolle. Die Prüfungen vergleichen konfigurierte Werte und Bedingungen; sie authentifizieren die Datensätze nicht und bewerten die Testmethodik nicht unabhängig.
Der Substantiation Judge liefert Empfehlungen, ohne die Policy-Gate-Entscheidung zu ändern. Der Adversarial Examiner kann eine Gate-substantiierte Behauptung herabstufen, wenn er eine Widerlegung zurückgibt, aber er kann eine Behauptung nicht heraufstufen. In dieser Aufzeichnung sind die beratenden Antworten zwischengespeichert und alle vier Prüferantworten bestätigen die gestützten Ergebnisse.
Ein Modelldatensatz belegt, dass eine Komponente dokumentiert ist, während eine betriebliche Behauptung auch Belege darüber benötigt, was sie tut. Im synthetischen Portfolio-Beispiel verzeichnet das bereitgestellte Protokoll Einfluss auf lediglich 1.5 % der Allokationsentscheidungen. Das konfigurierte Gate gibt NEEDS_PROOF zurück und hält diese Lücke zur Überprüfung fest.
Die Browser-Schaltfläche „Exportieren“ speichert ein JSON-Paket des abgeschlossenen Durchlaufs mit jeder Behauptung, Quelle, dem Urteil, der Entscheidungsregel, Begründung und Belegkennungen. Es enthält außerdem eine Zusammenfassung, die Engine-Version und einen Erstellungszeitstempel. Es bettet keine vollständigen Belegdatensätze, Beratungstranskripte oder eine manipulationssichere lückenlose Verwahrungskette ein.
Entdecken Sie verwandte Forschung für einen breiteren Kontext zu dieser Demonstration.
Vollständige Lösung
Erkunden Sie die Lösung für KI-Verifizierung & Anti-KI-Washing-Compliance →Besprechen Sie einen Workflow zur Behauptungssubstantiierung mit Veriprajna.
Wir können die Datensätze, Prüfungsgrenzen und menschlichen Entscheidungen besprechen, die Ihr Team benötigt, bevor eine Implementierung definiert wird.