KI-Preiskonformität und algorithmische Fairness
Wenn die Civil Investigative Demand (CID) eintrifft, sollte die Antwort eine Datei sein. Equity ist eine Audit-Schicht für Preisverteidigungsfähigkeit, die auf jeder bestehenden Pricing-Engine eines Einzelhändlers aufsetzt. Sie wiederholt das eigene Entscheidungsprotokoll der Engine und bewertet jede Bepreisungseingabe auf Abflüsse geschützter Klassenmerkmale, einschließlich der zusammengesetzten Proxys, die Einzelmerkmalsprüfungen nicht erkennen können. Sie prüft das Ergebnis anhand der EEOC four-fifths rule (29 CFR 1607.4(D)) in deterministischem Code, misst die Erlöskosten der Fairness-Vorgabe, zeigt auf, warum naheliegende Behebungen ausgereizt werden, und versiegelt die Aufzeichnung in einem SHA-256-gehashten, an regulatorischen Vorgaben ausgerichteten Beweispaket, das exakt für diese behördliche Forderung konzipiert ist.
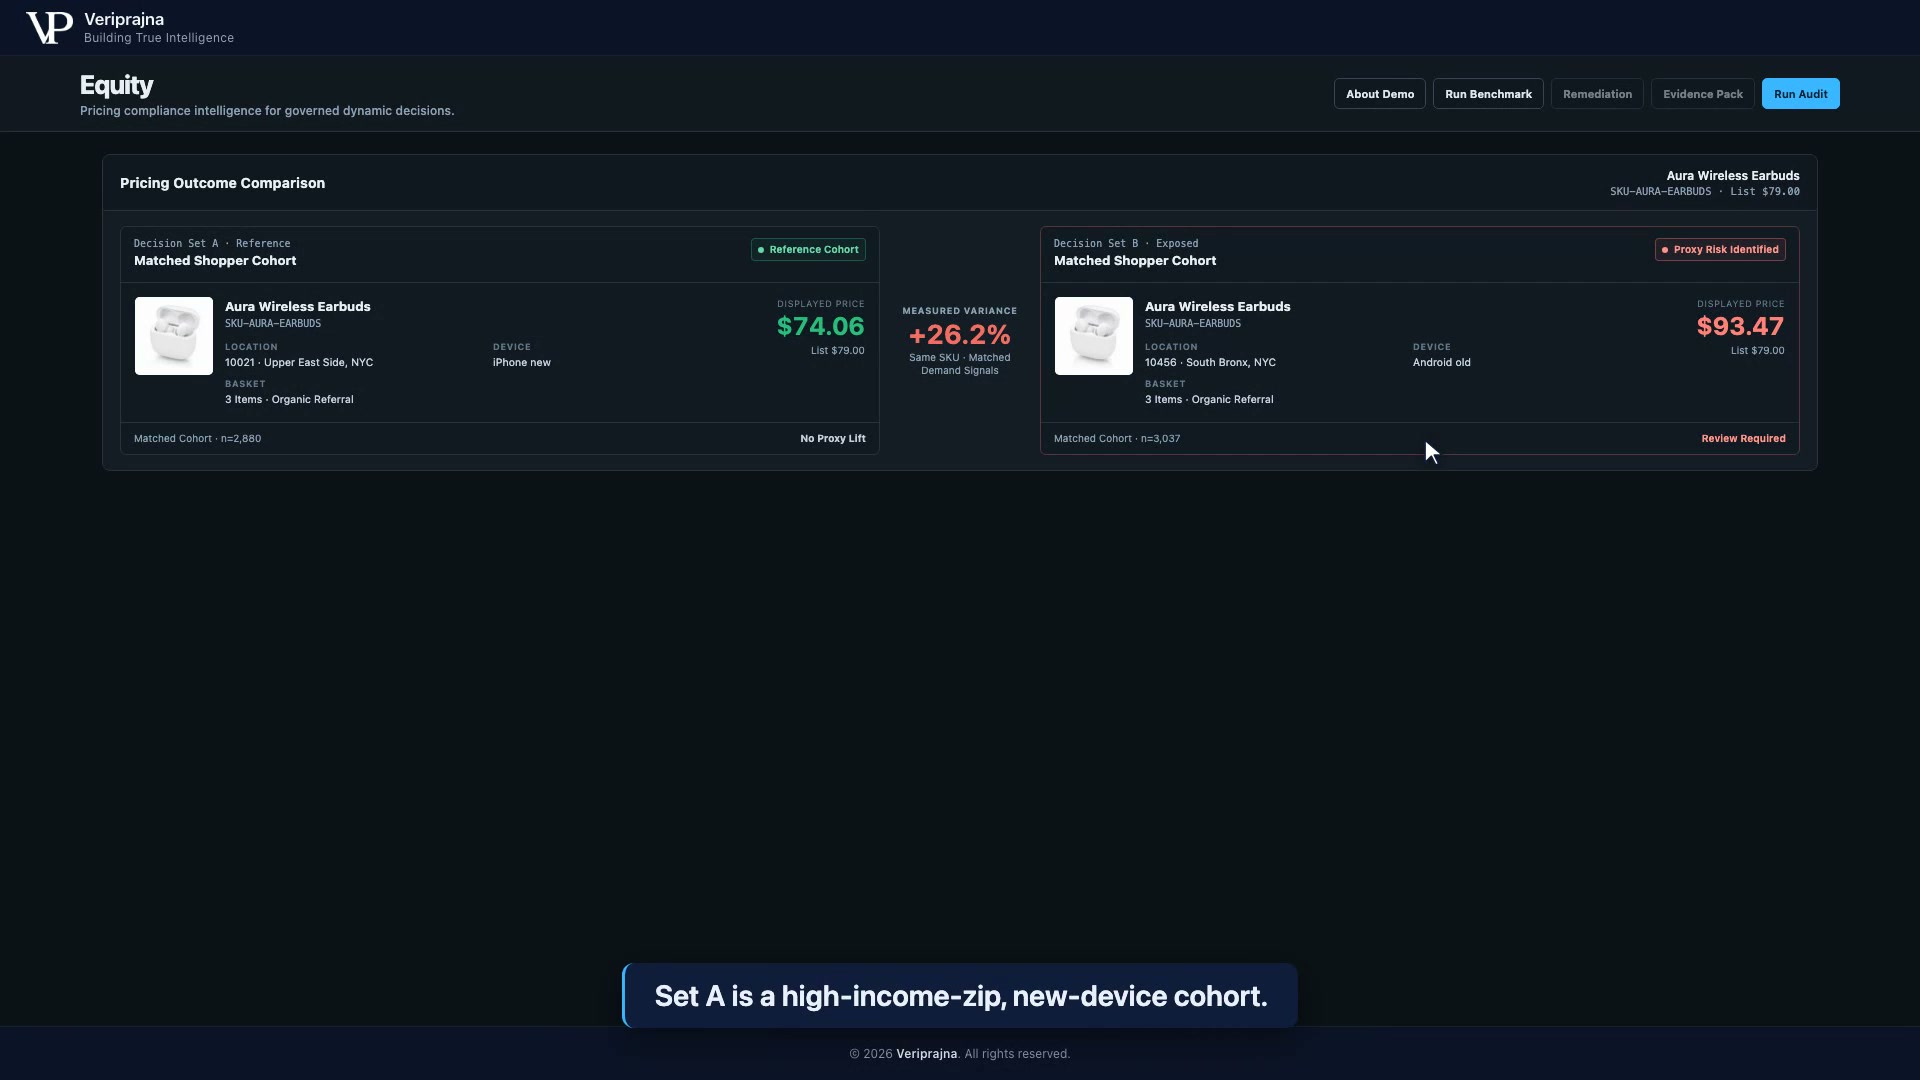
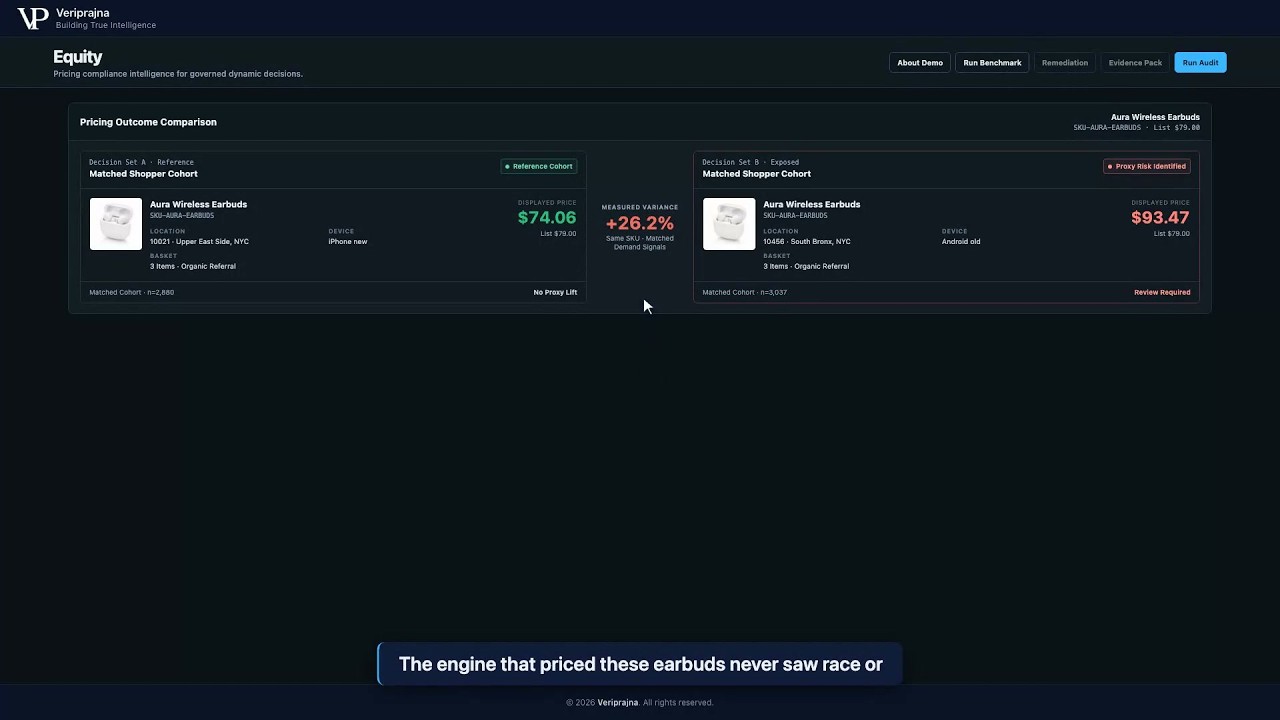
+26.2%
Höherer Preis für die Kohorte aus Mehrheits-Minderheiten-ZIP und Altgeräten bei identischer SKU
Kohortenmittelwerte über 3,037 und 2,880 deterministisch erzeugte synthetische Entscheidungen bei abgestimmten Nachfragesignalen
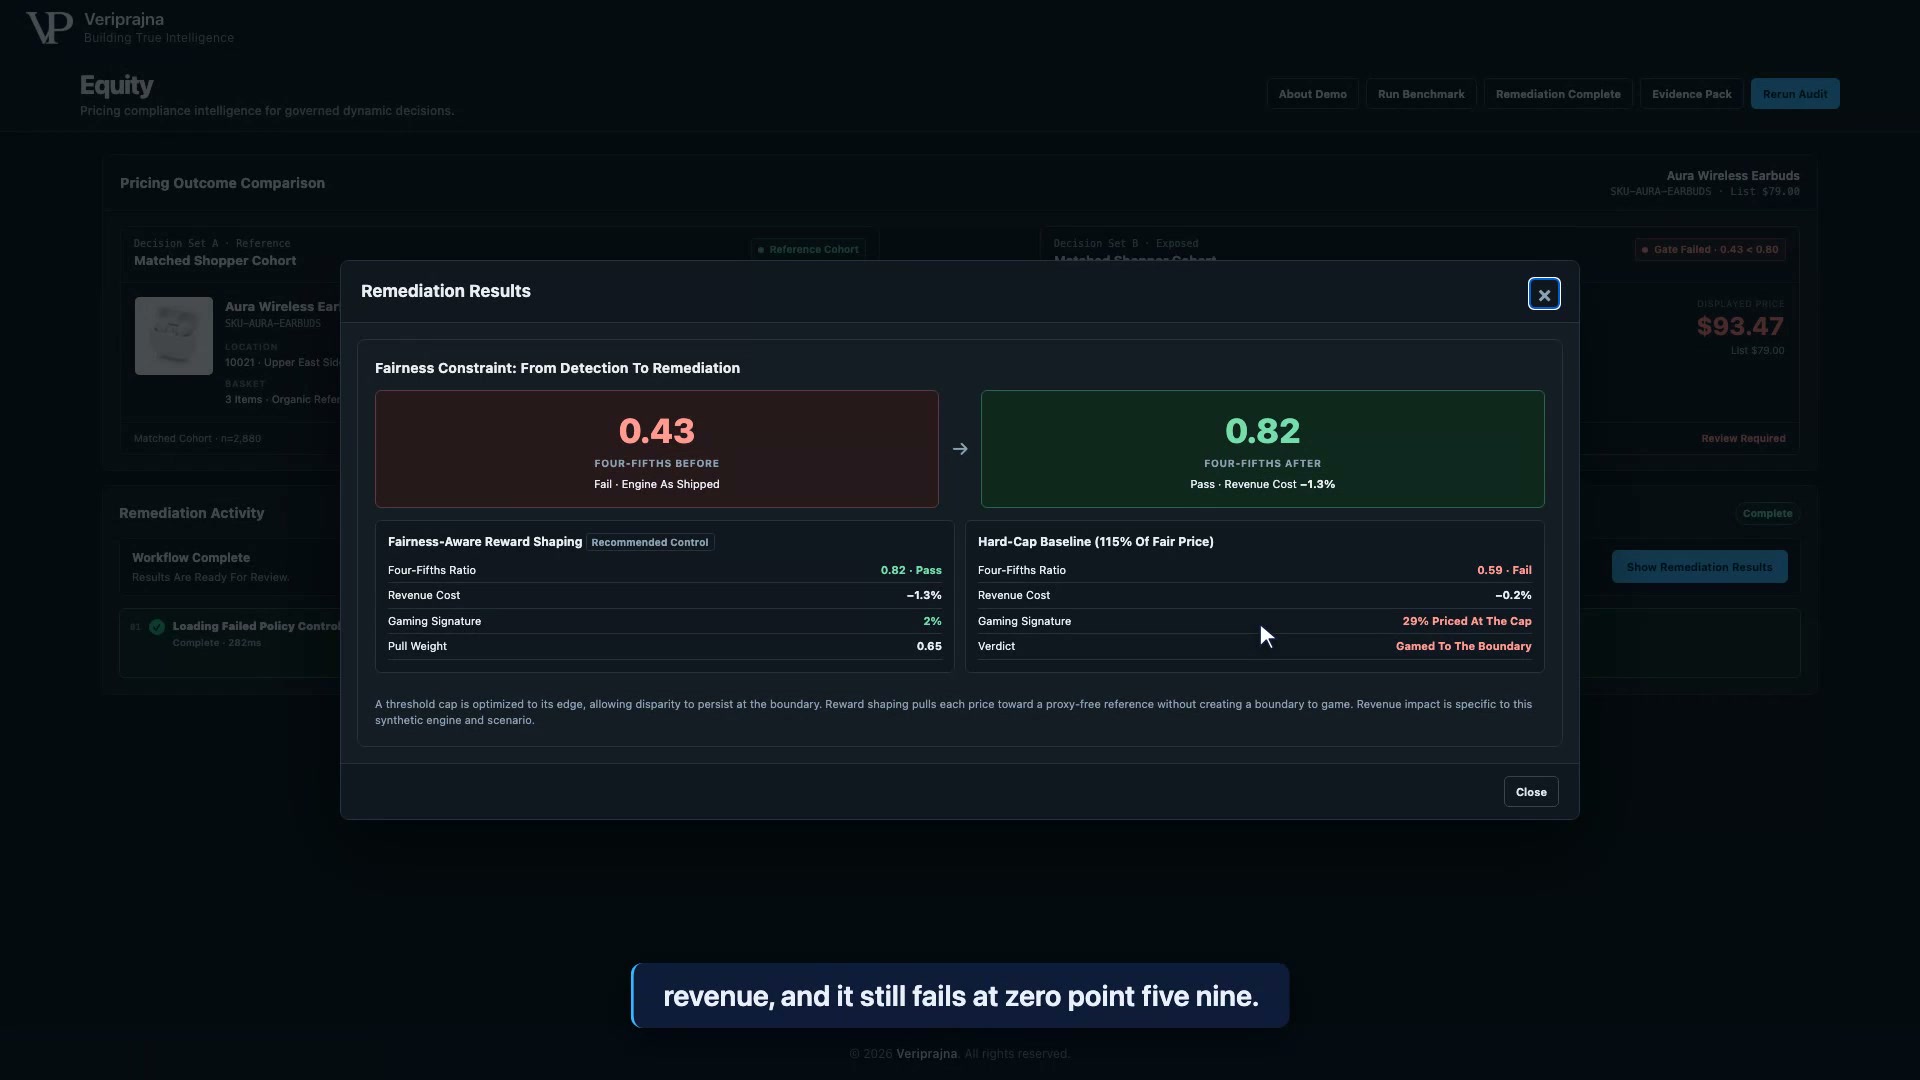
0.43 to 0.82
EEOC four-fifths ratio, Fail zu Pass, nach fairnessbewusstem Reward Shaping
Bei gemessenen 1.3% Erlöskosten auf dieser synthetischen Engine und in diesem Szenario
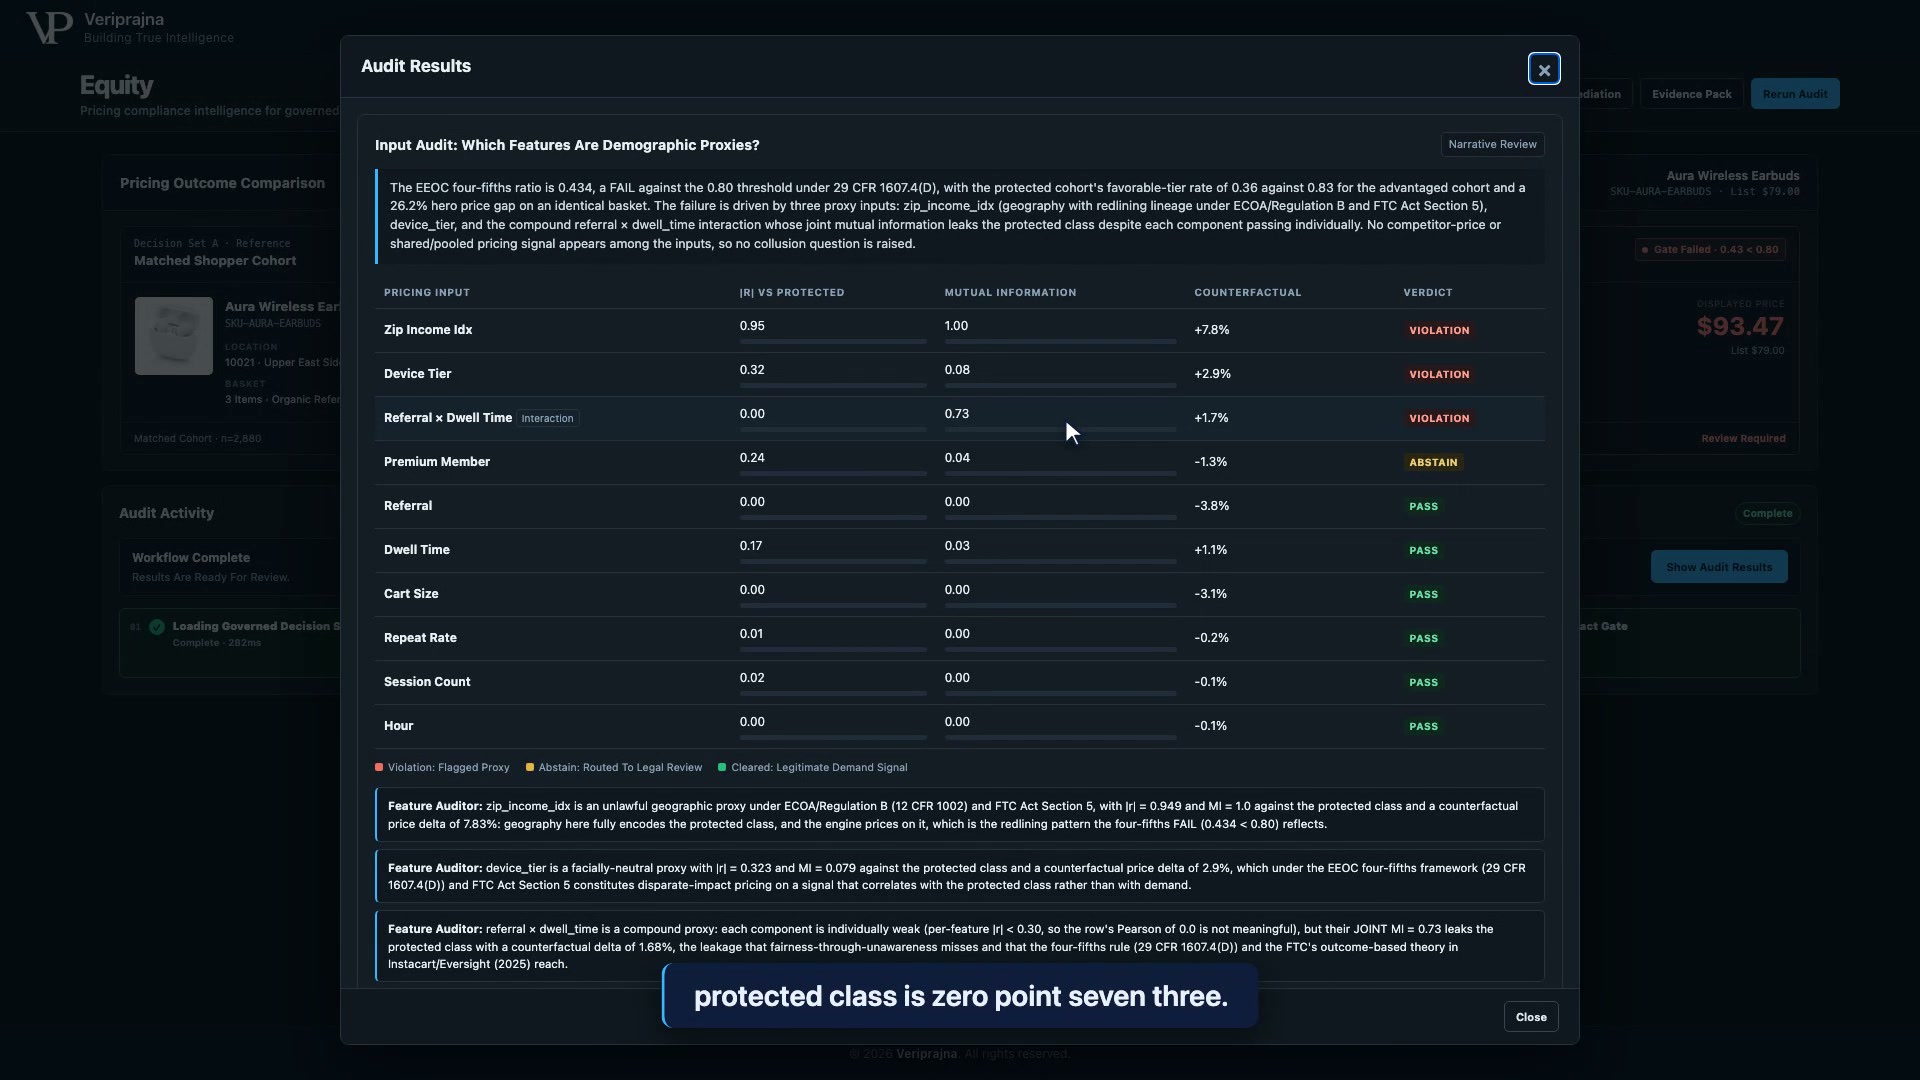
0.73
Gemeinsame Transinformation eines zusammengesetzten Proxys, dessen beide Einzelkomponenten jeweils bestehen
Referral × Dwell Time; das bloße Entfernen von ZIP und Gerät scheitert am Gate weiterhin bei 0.59
Jede Kennzahl dieser Demo auf dieser Seite ist synthetisch und deterministisch erzeugt. ShopMart Dynamic Pricing ist ein kontextueller LinUCB-Bandit, den wir als Stellvertreter für die von einem Kunden genutzte Engine entwickelt haben; die Aura Wireless Earbuds und die 10,000 Käufer werden generiert, und die Proxy-Struktur wurde gezielt hinterlegt, damit das Audit reale Muster aufdecken kann. Es wurde kein realer Einzelhändler auditiert und kein realer Kunde übervorteilt.
Ein General Counsel oder Head of Pricing einer E-Commerce-Plattform mit Transaktionsvolumen in New York und California betreibt eine Dynamic-Pricing-Engine, die weder Ethnie noch Einkommen erfasst und dennoch haftungsanfällig ist: Die Engine bepreist anhand von Postleitzahl (ZIP-Code), Gerätestufe und Sitzungsverhalten, und jedes dieser Merkmale transportiert demografische Signale. Ein kontextueller Bandit zur Erlösmaximierung identifiziert jeden Parameter, der die Zahlungsbereitschaft prognostiziert – einschließlich jener Faktoren, die de facto offenlegen, wer der Kunde ist. Die Postleitzahl korreliert mit dem Einkommen; das Einkommen prognostiziert die Preissensibilität; ein älteres Android-Smartphone deutet auf geringeren Preisvergleich hin. Keines dieser Merkmale ist die Ethnie selbst. Alle bewegen sich jedoch synchron dazu. Sobald eine Civil Investigative Demand (CID) eingeht, verbringt ein Team ohne entsprechende Protokollierung Monate mit reaktiven forensischen Datenanalysen.
Der Vergleich der FTC in Höhe von $60M mit Instacart bezüglich deren Eversight-Pricing-Experimenten (FTC, Dezember 2025) war ein ergebnisbasiertes Durchsetzungsverfahren. Die Beschwerdeschrift dokumentierte, dass verschiedenen Kunden für identische Artikel voneinander abweichende Preise mit Preisunterschieden von bis zu 23% angezeigt wurden. Dies war keine Feststellung gruppenbezogener Diskriminierung und hing nicht davon ab, welche Vorgaben dem Algorithmus übermittelt worden waren.
Der Algorithmic Pricing Disclosure Act von New York, in Kraft seit November 10, 2025, erfordert eine gut sichtbare Offenlegung, wenn personenbezogene Daten einen Preis verändern, und sieht Zivilstrafen von bis zu $1,000 pro Verstoß vor. Colorado SB 24-205, in Kraft ab June 30, 2026, stuft die Preisgestaltung als wesentliche Entscheidung ein, die eine Folgenabschätzung erfordert.
Die Hochrisiko-Verpflichtungen des EU AI Act gelten ab August 2, 2026. EU AI Act (Articles 13 and 14) regeln die Hochrisiko-Transparenz und Antidiskriminierungsdokumentation, und Verstöße im Hochrisikobereich ziehen Strafen bis zu einer gesetzlichen Höchstgrenze von €15M oder 3% des weltweiten Umsatzes nach sich.
Die Pipeline führt einen einzigen Durchlauf über das Entscheidungsprotokoll der Engine aus: 10,000 Bepreisungsentscheidungen der auditierten Engine, ein deterministisches Eingabe-Audit, ein Vier-Fünftel-Gate, eine Synthese von Fairness-Vorgaben im Vergleich zu einer aushebelbaren Obergrenze, agentenbasierte Erläuterungen, ein SHA-256-gehashtes Beweispaket und ein Benchmark mit gelabelten Testdaten. Agenten beraten, Code entscheidet – und genau diese Trennung stellt sicher, dass das Beweispaket behördlich einreichbar bleibt, unabhängig davon, welches Modell zugrunde liegt.
01 / THE ENGINE UNDER AUDIT
Die auditierte Engine ist ShopMart Dynamic Pricing, ein kontextueller 7-Arm-LinUCB-Bandit mit seed=42, der eine einzelne SKU bepreist – die Aura Wireless Earbuds zu einem Listenpreis von $79.00 – für eine synthetische, gelabelte Population von 10,000 Käufern. Er bepreist anhand des ZIP-Einkommensindex, der Gerätestufe, der Herkunft (Referral), der Verweildauer (Dwell Time), des Warenkorbwerts (Cart Size), der Wiederkaufrate (Repeat Rate), der Sitzungsanzahl (Session Count), der Premium-Mitgliedschaft und der Uhrzeit (Hour), zuzüglich Interaktionstermen aus Referral und Dwell Time, wie sie in vielen realen Systemen vorkommen. Die geschützte Kohorte ist ein latentes Label, das dem Audit niemals offengelegt wird. In der Demo stellt dieser Bandit die auditierte Engine dar.
02 / THE DETERMINISTIC INPUT AUDIT
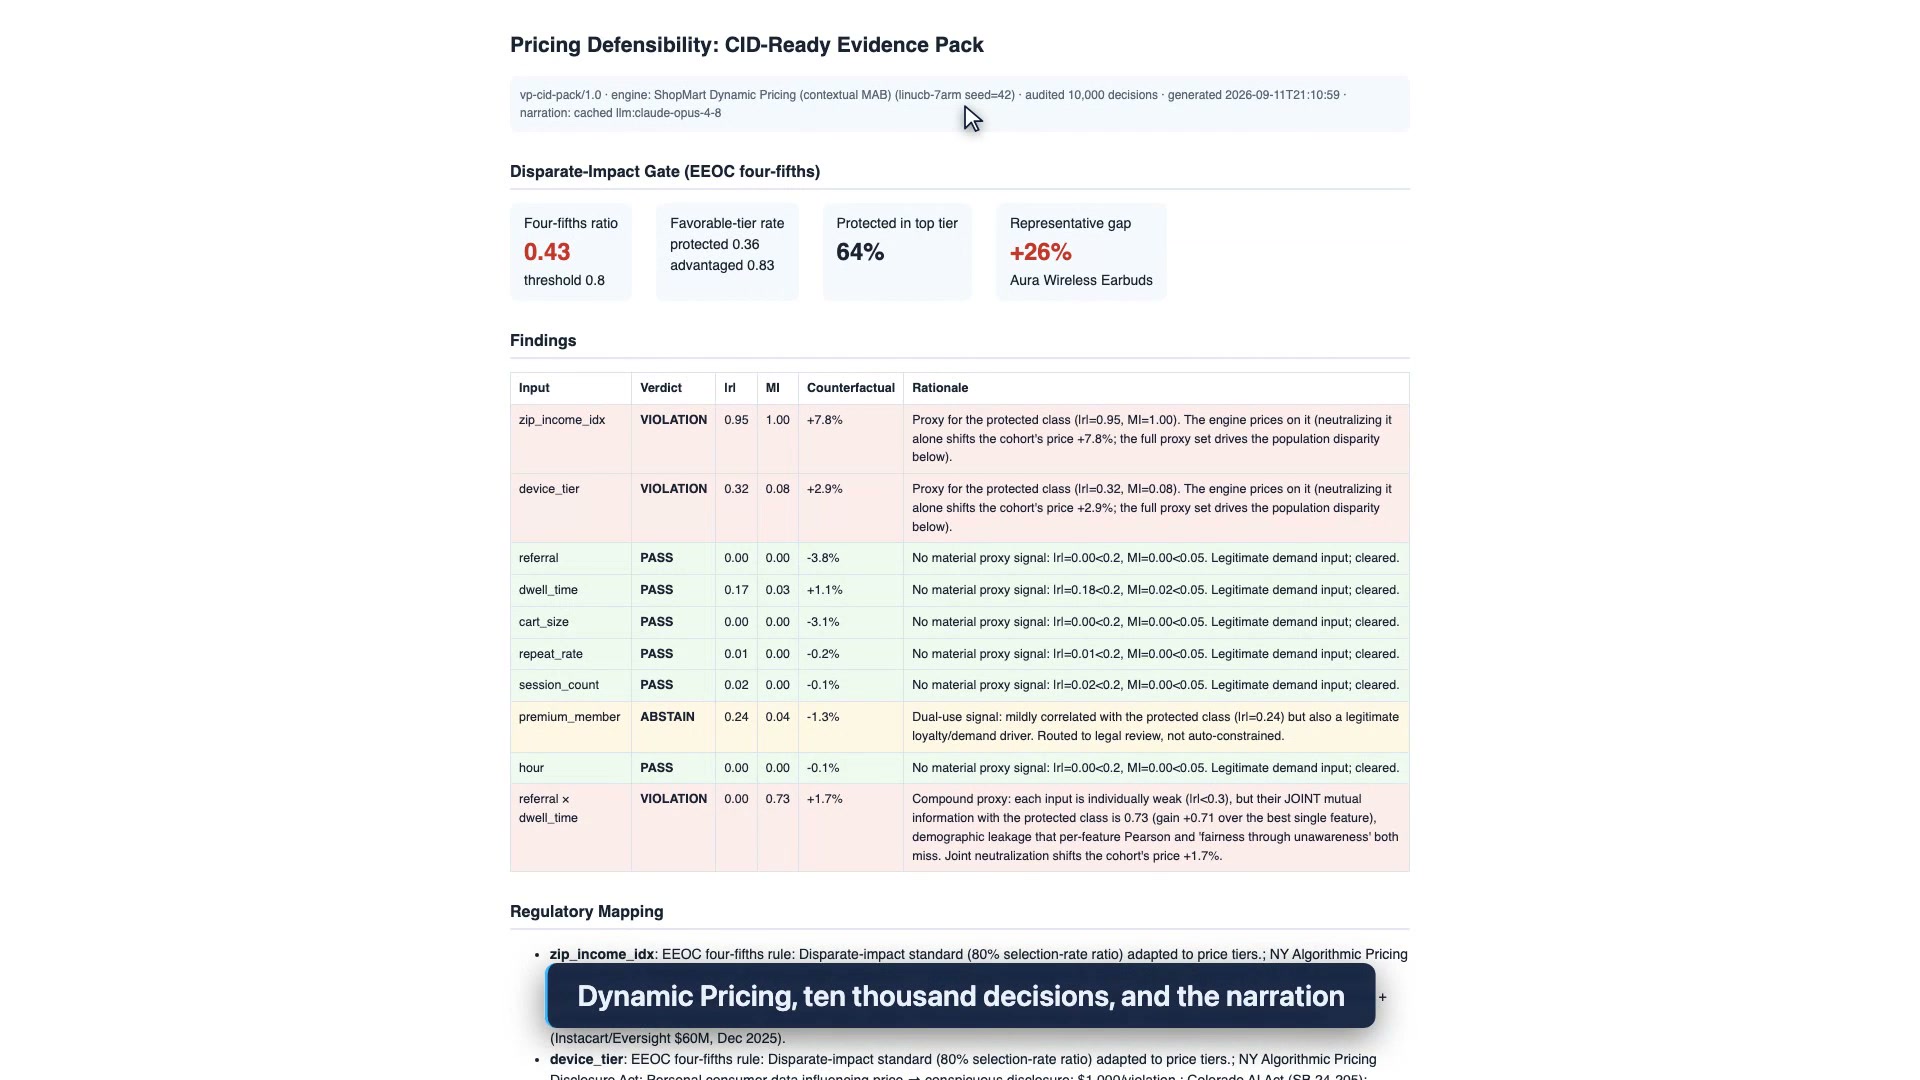
Run Audit berechnet in reinem numpy die absolute Pearson-Korrelation jedes Bepreisungsparameters gegenüber der geschützten Kohorte, dessen normalisierte Transinformation (Mutual Information), eine gemeinsame Transinformation für Merkmalspaare sowie eine kontrafaktische Preisänderung: Ein Eingabewert der geschützten Kohorte wird mit dem Referenzwert der begünstigten Kohorte überschrieben, alle anderen Faktoren konstant gehalten, die unternehmenseigene Richtlinie der Engine erneut ausgeführt und gemessen, wie stark sich der Preis der geschützten Kohorte verändert. Die Entscheidungsregeln sind als Code sequenziell implementiert: Ein Eingabeparameter mit einer effektiven Stichprobengröße unter 400 wird als Insufficient Evidence zurückgegeben statt mit einem Proxy-Urteil versehen – eine Regel, die in diesem Durchlauf von keinem Parameter ausgelöst wird; das Dual-Use-Kundenbindungssignal mit substanzieller Assoziation wird vor der Verletzungsprüfung als ABSTAIN zur juristischen Prüfung weitergeleitet; eine absolute Korrelation von mindestens 0.30 oder eine Transinformation von mindestens 0.05 gilt als VIOLATION; eine Korrelation von 0.20 bis 0.30 führt zu einem ABSTAIN; alle übrigen Werte erhalten ein PASS. Bei jedem anderen Parameter dient die kontrafaktische Verschiebung lediglich der Bestätigung und löst nie eigenständig ein Urteil aus; nur beim Dual-Use-Signal fließt eine materielle kontrafaktische Verschiebung in das ABSTAIN ein.
03 / THE GATE AND THE CONSTRAINT
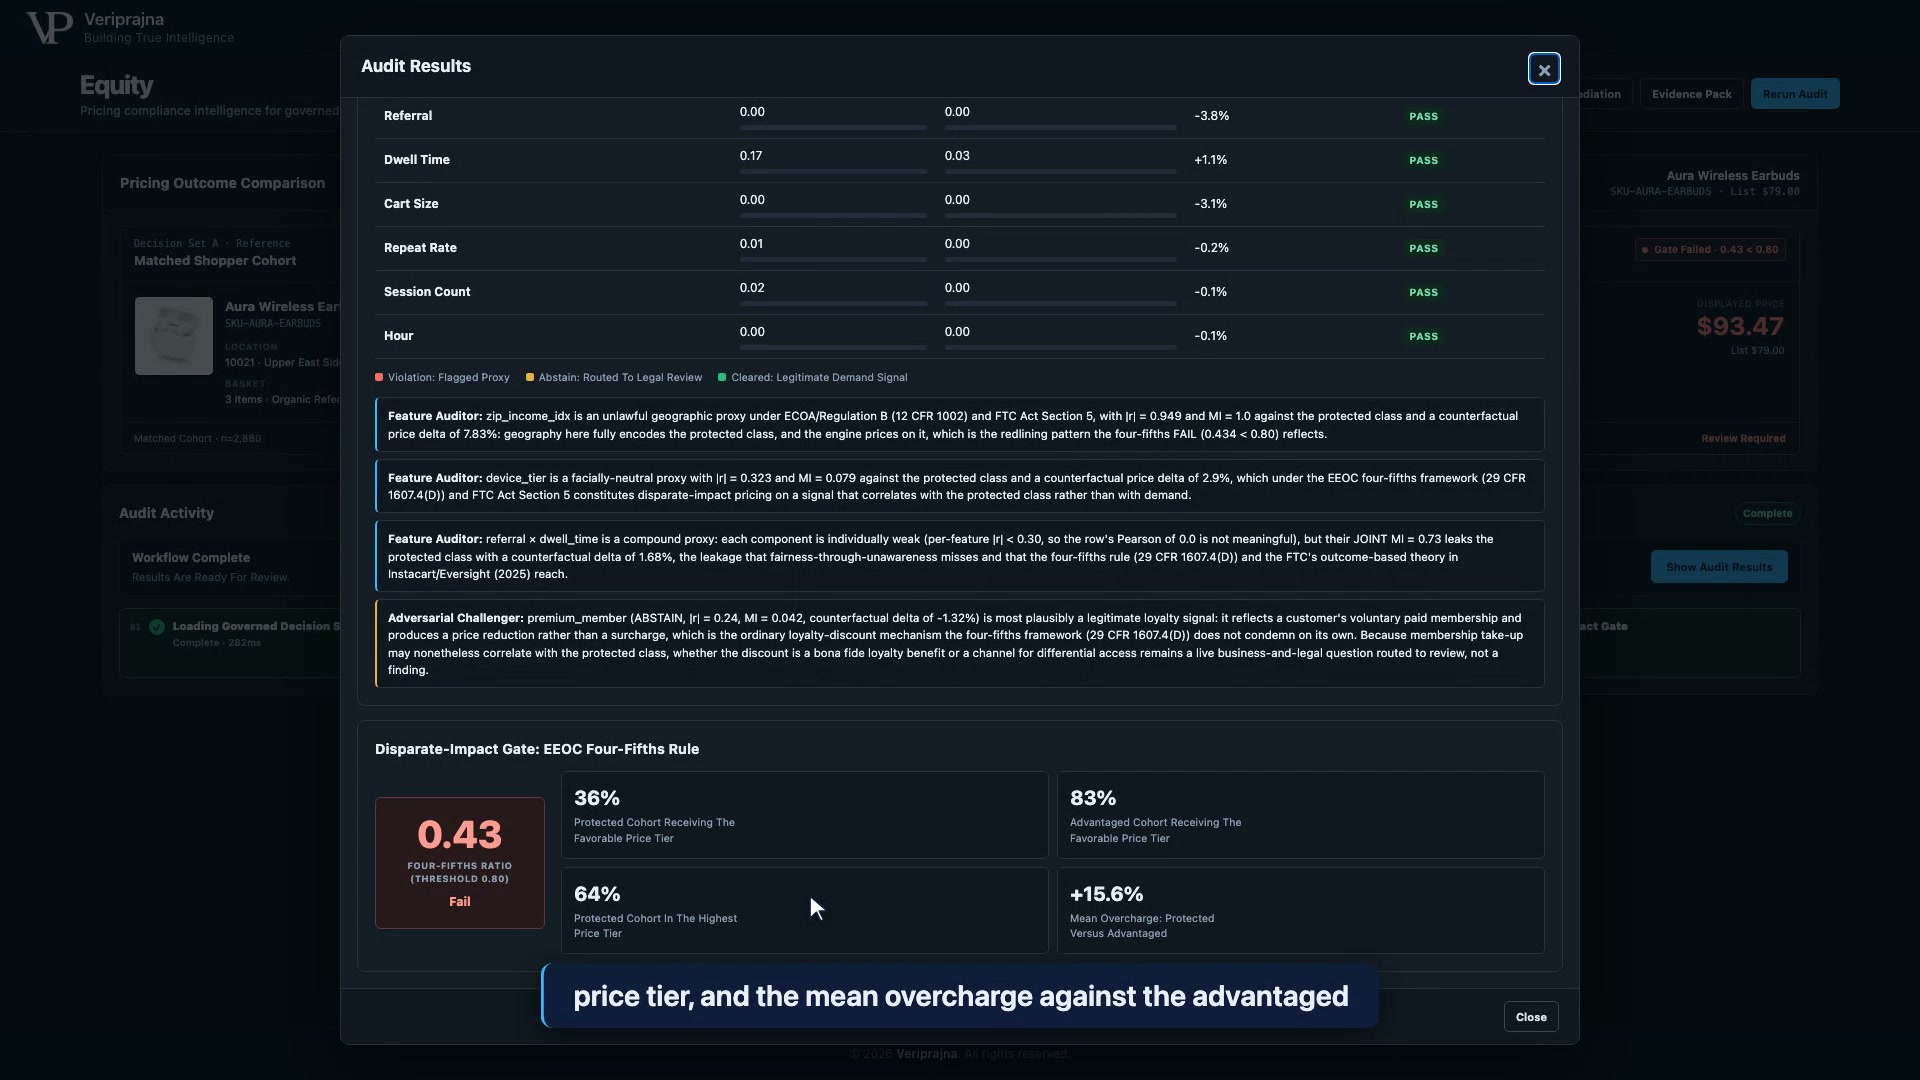
Das Disparate-Impact-Gate wendet die EEOC four-fifths rule (29 CFR 1607.4(D)) angepasst auf Preisstufen an: Der Anteil der geschützten Kohorte, der die vorteilhafte Preisstufe erhält, geteilt durch den Anteil der begünstigten Kohorte, gemessen an einem Schwellenwert von 0.80. Die Remediation synthetisiert anschließend ein Fairness-Aware Reward Shaping, das jeden Preis kontinuierlich zu einem proxy-freien Referenzpreis eines zweiten Banditen hinzieht (der ohne die vier Proxy-Parameter trainiert wurde), und ermittelt per binärer Suche das geringste Zuggewicht (Pull Weight), das den Wert von 0.80 übertrifft. Dies wird neben einer Hard-Cap-Baseline bei 115% des fairen Preises dargestellt – der naiven Behebung –, wobei das Gaming-Verhalten für beide Ansätze quantifiziert wird.
04 / THE CREW AND THE PACK
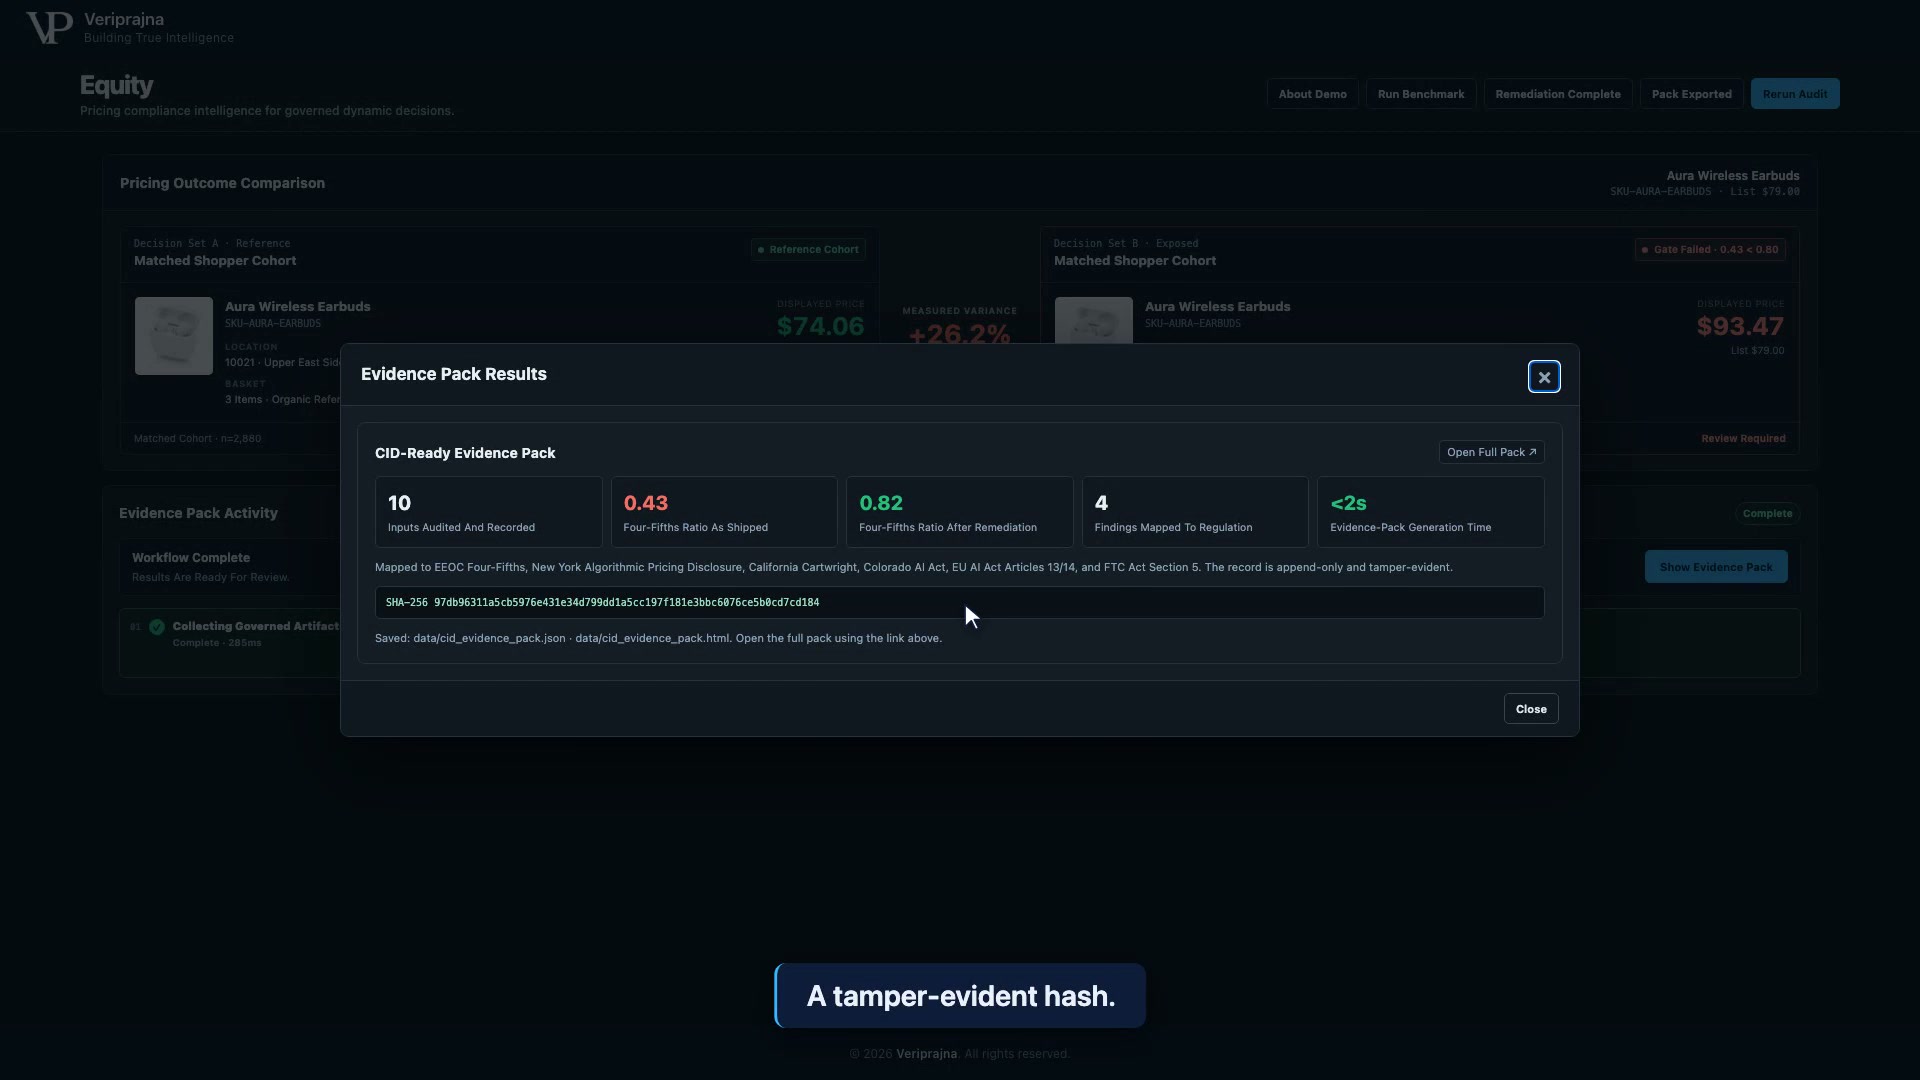
Ein Feature Auditor erläutert jeden markierten Eingabeparameter und ein Adversarial Challenger argumentiert dafür, den zurückgestellten Parameter (ABSTAIN) als legitimes Nachfragesignal einzustufen; die Rolle des Regulatory Mapper basiert auf einer festen Tabelle, die jede VIOLATION fünf Regularien zuordnet und den ABSTAIN einer separaten juristischen Prüfzeile zuweist. Das Agenten-Team ist anbieterunabhängig austauschbar, greift bei fehlender Modellanbindung auf deterministische Vorlagen zurück (wodurch die Anwendung absolut identisch operiert) und kann weder Zahlen berechnen noch Urteile fällen. Evidence Pack versiegelt den Namen und die Version der Engine, die auditierte Population, die Gate-Prüfung, jeden Befund samt Begründung, das regulatorische Mapping, das Behebungsergebnis und die narrative Zusammenfassung in JSON sowie einem druckfähigen HTML-Paket, abgesichert durch einen SHA-256-Digest des Paket-Bodys als manipulationssicheren Hash.
Die Konsole umfasst zwei Ansichten zuzüglich Dialogfenstern. Die manuelle Ansicht enthält die Karte Pricing Outcome Comparison sowie ein Aktivitätspanel, das jede Phase live darstellt; jedes Ergebnis öffnet sich in einem Dialogfenster mit dem Titel Audit Results, Remediation Results oder Evidence Pack Results, wobei Remediation und Evidence Pack deaktiviert bleiben, bis Run Audit abgeschlossen ist. Run Benchmark wechselt zu einer separaten Benchmark Results-Ansicht. About Demo definiert die Systemgrenzen des Szenarios auf dem Bildschirm: eine synthetische Engine mit bekannten Referenzwerten (Ground Truth), deren Resultate die Methodik demonstrieren und keinen Nachweis für in der Praxis validierten Vorsatz darstellen. Jede nachfolgende Kennzahl bewegt sich innerhalb dieser Grenzen.
Die Demo auditiert 10,000 deterministisch erzeugte synthetische Bepreisungsentscheidungen für eine einzelne SKU. Es folgt die Bildschirmdarstellung des Durchlaufs in exakter chronologischer Reihenfolge.


Die obigen Kennzahlen stammen aus einer deterministisch erzeugten synthetischen Population von 10,000 Bepreisungsentscheidungen für eine einzelne SKU mit einer hinterlegten, reproduzierbaren Proxy-Struktur. Die Zahlen belegen, dass die Methode hinterlegte Strukturen mit der Präzision eines gelabelten Datensatzes aufdeckt. Sie stellen keine Genauigkeitsrate auf realen Bepreisungsdaten dar, keinen Benchmark gegenüber Wettbewerbern und keine Behauptung über ein reales Einzelhandelsunternehmen.
| Frage | Was Equity in dieser Demo leistet | Was außerhalb der Demo bleibt |
|---|---|---|
| Integration | Auditiert den LinUCB-Banditen, den die Demo-Anwendung als Stellvertreter-Engine nutzt, und ist so konzipiert, dass die Engine eines Kunden über einen Adapter eingebunden werden kann. | Jeglicher Adaptercode oder Live-Konnektor zu Bepreisungsplattformen. In diesem Build ist keiner implementiert, und kein genannter Softwarehersteller ist Kunde oder Partner. |
| Demografische Daten | Liest eine kuratierte Referenztabelle mit zehn Postleitzahlen aus New York und California sowie eine fest in der Anwendung hinterlegte Verzerrung bei den Geräten ein. | Ein Live-Feed zu Zensusdaten oder Gerätebesitzverhältnissen. Die Tabelle ist kompakt und manuell kuratiert; die geschützte Kohorte ist ein hinterlegtes Label. |
| Befunde | Rekonstruiert die hinterlegte Proxy-Struktur und dokumentiert jedes Eingabe-Urteil samt Begründung im Beweispaket. | Der Nachweis realer Diskriminierung oder vorsätzlichen Handelns; das System fällt kein Urteil über Vorsatz. |
Equity legt für keinen Kunden Preise fest und ersetzt weder Pricefx, PROS, Zilliant noch Competera; die Engine bepreist, Equity auditiert und beschränkt. Es zertifiziert keine Konformität, garantiert kein Bestehen und erteilt keine Rechtsberatung; das Beweispaket dient als Evidenz für den Rechtsbeistand des Mandanten. Dieser Build deckt eine SKU und den Disparate-Impact-Pfad vom Audit bis zum Beweispaket ab; algorithmische Kollusion, gerichtsübergreifende Middleware zur Offenlegung, kontinuierliches Streaming-Monitoring und eine Checkout-Oberfläche liegen außerhalb des Rahmens. Die Profile für South Bronx und Upper East Side auf der Karte Pricing Outcome Comparison sind repräsentative Bezeichnungen für Kohorten aus mehreren Postleitzahlen und Gerätetypen, keine Behauptungen über reale Nachbarschaften.
Weil die Engine weder Ethnie noch Einkommen einsehen muss, um anhand dieser Faktoren zu bepreisen. In der Demo bepreist die geprüfte Engine auf Basis von ZIP-Einkommensindex, Gerätestufe und Sitzungsverhalten – und genau diese Eingabewerte transportieren die geschützte Klasse: Der ZIP-Einkommensindex korreliert damit zu 0.95 und die Gerätestufe zu 0.32. Das Ergebnis in der deterministisch erzeugten synthetischen Population ist ein um 26.2% höherer Preis für die Kohorte aus Mehrheits-Minderheiten-ZIP und Altgeräten bei denselben Earbuds mit identischen Nachfragesignalen sowie ein Vier-Fünftel-Verhältnis von 0.43 gegenüber der Schwelle von 0.80. Das Verfahren der FTC gegen Instacart war ein rein ergebnisbasiertes Verfahren, bei dem unterschiedlichen Käufern abweichende Preise für identische Artikel berechnet wurden, und keine Feststellung darüber, welche Parameter dem Algorithmus vorgegeben worden waren.
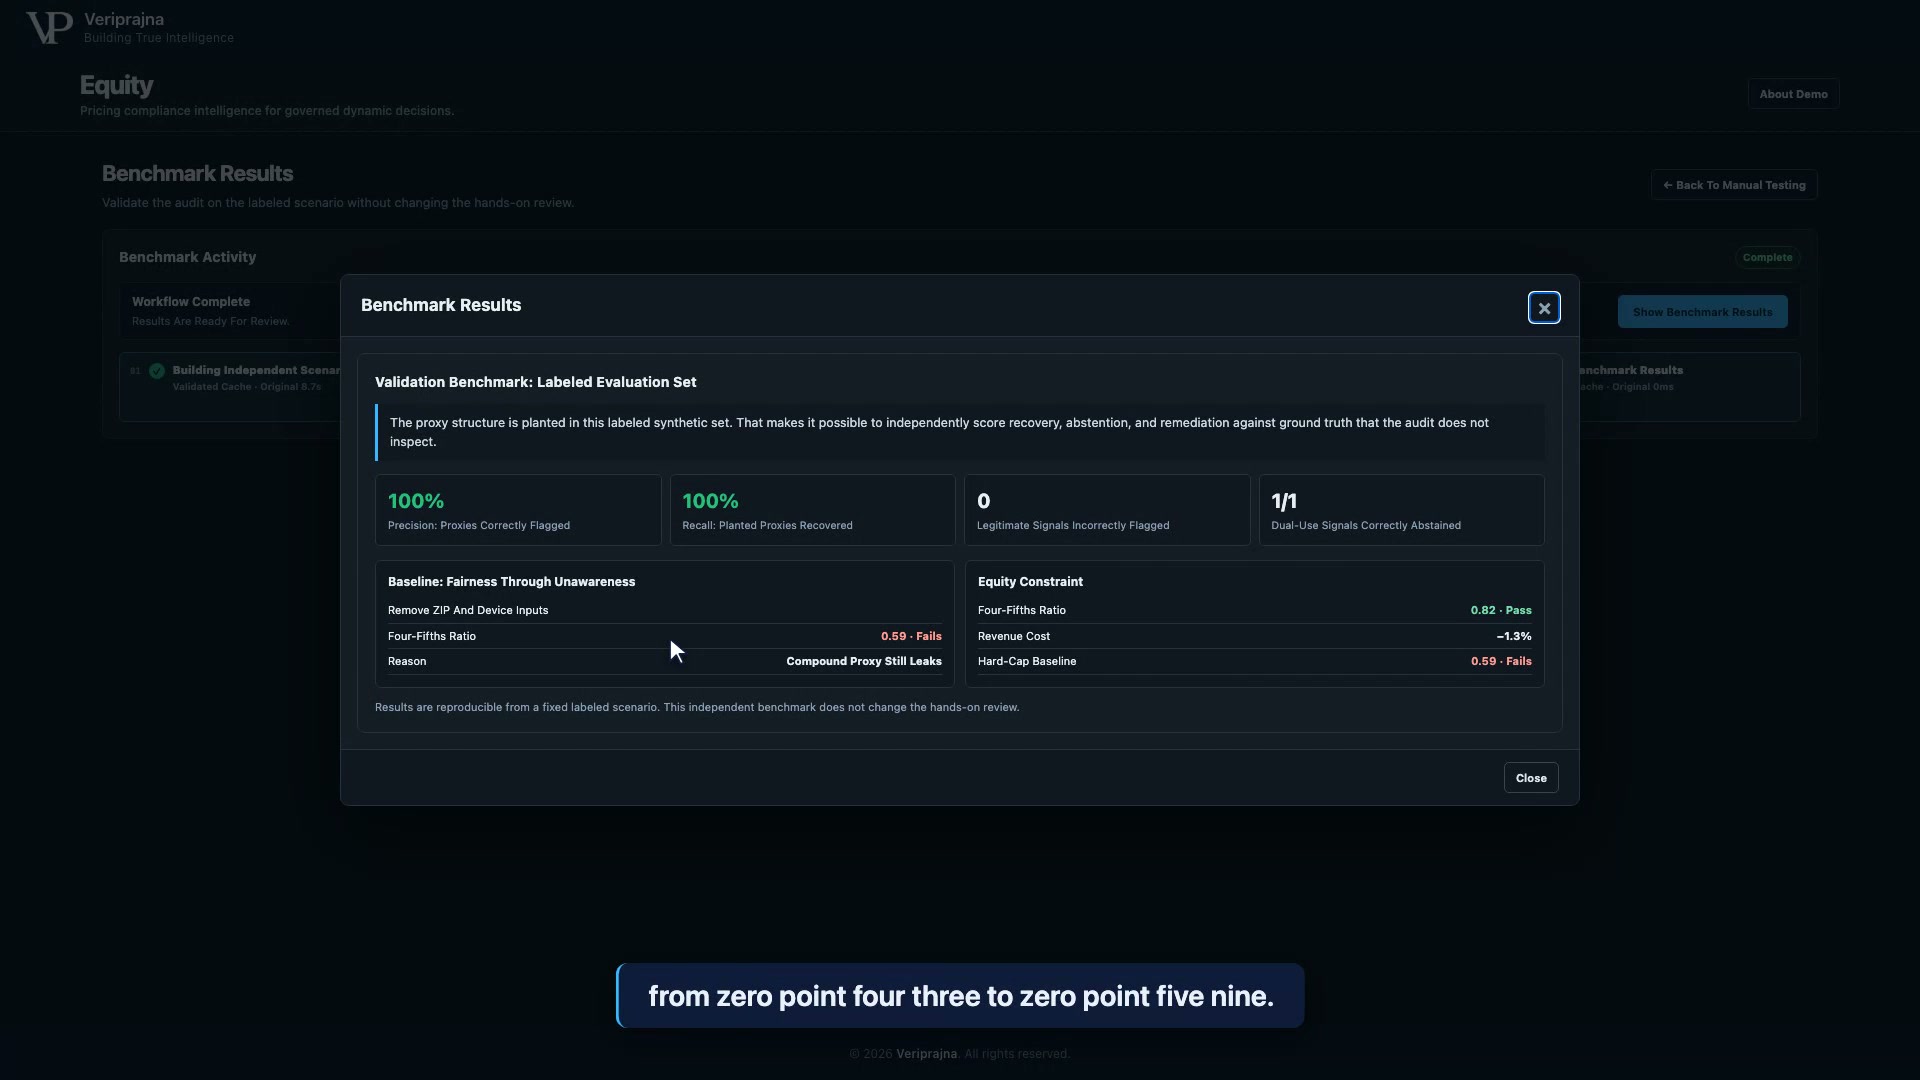
Bei dieser Engine: Nein. Die Fairness Through Unawareness-Baseline im Benchmark trainiert das Modell ohne die ZIP- und Geräteparameter neu, doch das Vier-Fünftel-Verhältnis klettert lediglich von 0.43 auf 0.59 – weiterhin ein Fail. Wie der Käufer auf die Seite gelangte und wie lange er verweilte, bestehen isoliert betrachtet jeweils die Prüfung, kodieren die Kohorte gemeinsam jedoch mit einer Transinformation von 0.73. Die Korrelationsanalyse einzelner Merkmale ist für diese Kombination blind; eine gemeinsame Transinformationsprüfung hingegen nicht – weshalb das Audit sowohl Interaktionen als auch Einzelparameter bewertet.
Das ist möglich, und die Demo zeigt, wie ein Erlösmaximierungsmodell damit umgeht. Die Hard-Cap-Baseline untersagt jeden Preis über 115% des fairen Referenzpreises. Die Engine verzichtet auf 0.2% ihres Erlöses, um die Vorgabe buchstabengetreu zu erfüllen, und platziert 29% der geschützten Kohorte innerhalb eines 1%-Intervalls direkt unter der Obergrenze. Dadurch erreicht das Vier-Fünftel-Verhältnis lediglich 0.59 und das Gate scheitert weiterhin. Eine Obergrenze fungiert als Zielmarke. Fairness-Aware Reward Shaping bietet keine starre Grenze zum Ausreizen und besteht bei 0.82 für 1.3% Erlöskosten bei dieser synthetischen Engine.
Nein. Equity legt niemals Preise fest. Es auditiert die Entscheidungen der Engine und schlägt eine Steuerungsbeschränkung vor; Ihre bestehende Engine – sei es Pricefx, PROS, Zilliant, Competera oder ein maßgeschneiderter Bandit – übernimmt weiterhin die Preisgestaltung. Die Schnittstelle für die Engine eines Kunden ist ein dokumentierter Anknüpfungspunkt; in der Demo existiert kein Adaptercode und keine Live-Integration, sodass der von uns implementierte LinUCB-Bandit als Engine fungiert und direkt auditiert wird.
Nichts, was ein Anwalt vor Gericht verteidigen müsste, stammt aus einer Modellausgabe: Die Statistiken, der Schwellenwertvergleich, jedes Urteil, die Steuerungsbeschränkung und der Hash des Beweispakets stammen aus deterministischem numpy-Code außerhalb der Agentenebene. Feature Auditor und Adversarial Challenger verfassen lediglich erläuternden Fließtext; sie berechnen niemals Zahlen und können Urteile weder fällen noch abändern, und das regulatorische Mapping ist eine feste Tabelle statt einer Modellausgabe. Ohne konfigurierten Modellanbieter greift das Agententeam auf deterministische Vorlagen zurück, sodass die Anwendung exakt dieselben Urteile liefert. Die Erläuterungen im aufgezeichneten Walkthrough sind validierte, gecachte Modellausgaben, was in der Kopfzeile des Pakets explizit deklariert ist.
Ein CID-festes Beweispaket als JSON und druckfähiges HTML. Es dokumentiert den Namen und die Version der Engine, die 10,000 auditierten Entscheidungen, das Vier-Fünftel-Gate vor und nach der Behebung, das Urteil jedes Eingabewerts samt Begründung, die Zuordnung jedes beanstandeten Eingabeparameters zur EEOC four-fifths rule (29 CFR 1607.4(D)), zum NY Algorithmic Pricing Disclosure Act, zu Colorado SB 24-205, zu den EU AI Act (Articles 13 and 14) sowie zu FTC Act Section 5, das Behebungsergebnis und einen SHA-256-Digest des Paket-Bodys. Wir liefern die Beweismittel; die juristische Entscheidung trifft Ihre Rechtsabteilung.
Es handelt sich um eine Selbstprüfung anhand eines gelabelten Testdatensatzes und sollte genau als solche verstanden werden. Der Benchmark generiert die synthetische Population der Demo mit 10,000 Entscheidungen neu und stellt eine zentrale Frage: Hat das Audit exakt die drei von uns platzierten Proxys identifiziert und sonst nichts? Das hat es. Alle drei wurden markiert, keines der vier legitimen Nachfragesignale wurde beanstandet, und das einzige Dual-Use-Signal wurde zurückgestellt (ABSTAIN), anstatt markiert oder als unbedenklich eingestuft zu werden. Dies demonstriert, dass die Methode hinterlegte Strukturen zuverlässig rekonstruiert. Reale Bepreisungsprotokolle weisen Störfaktoren auf, und es verbietet sich ethisch, demografischen Gruppen im A/B-Test unterschiedliche Preise zu berechnen. In einem Kundenprojekt liefert dieselbe Methodik daher fundierte Beweise zur juristischen Prüfung und niemals ein automatisiertes Urteil.
Die Forschung hinter dieser Demo – die Architektur, das Verifikationsdesign und der Unternehmensleitfaden.
Wir sind ein KI-Engineering-Team, kein Pricing-Softwareanbieter und kein Zertifizierungsdienstleister für Compliance. Wir setzen beim originären Entscheidungsprotokoll Ihrer Engine an und schließen mit einem Beweispaket ab, das Ihre Rechtsberatung einreichen kann; die Bewertung der Resultate obliegt allein Ihrem Rechtsbeistand.
Ein zielorientiertes Erstgespräch ist konkret: Welche Engine bepreist Ihren Katalog, welche Eingaben verarbeitet sie, ob sie Kreuzterme oder Entscheidungsbäume enthält, die zusammengesetzte Proxys ausnutzen könnten, und ob Ihr Transaktionsvolumen New York, California, Colorado oder die EU betrifft. Wir können das Audit, die Synthese von Steuerungsbeschränkungen und das Format des Beweispakets gemeinsam mit Ihren Pricing-, Rechts- und Datenteams erarbeiten.