Erkennung synthetischer Inhalte & gefälschter Bewertungen

Glaubwürdige Bewertungen können dennoch zu einer koordinierten Kampagne gehören.

Campaign Firewall zeigt, wie Beziehungsevidenz eine menschliche Überprüfungsroute unterstützen kann, wenn der Wortlaut allein das Muster übersieht. Alle hier gezeigten Bewertungen und Kontoverläufe sind synthetisch.

4 von 15

Von der lokalen reinen Text-Baseline markiert

Modellierte rein menschliche Kampagne, dieselbe Testumgebung

15 von 15

Vom Ensemble zur menschlichen Überprüfung weitergeleitet

Synthetische Datensätze, keine Plattformaktion

105 Kontopaare

Über gemeinsame Produkthistorie verknüpft

Beziehungsevidenz im selben Cluster

Diese Beobachtungen aus der Testumgebung erklären eine Designentscheidung. Beide Methoden nutzen aus dem Korpus abgeleitete Textperzentile, und der Überprüfungsschwellenwert des Ensembles wurde auf denselben Labels angepasst; dies ist keine Leistung auf ungesehenen Daten.

Eine plausible Botschaft lässt die Frage der Koordination offen

Ein Markenschutz-Team muss wissen, warum Bewertungen miteinander in Beziehung zu stehen scheinen, bevor es entscheidet, was eskaliert werden soll. Ein flüssiger Wortlaut allein kann nicht belegen, dass Konten unabhängig voneinander agierten, und eine negative Meinung allein begründet noch keinen Betrug.

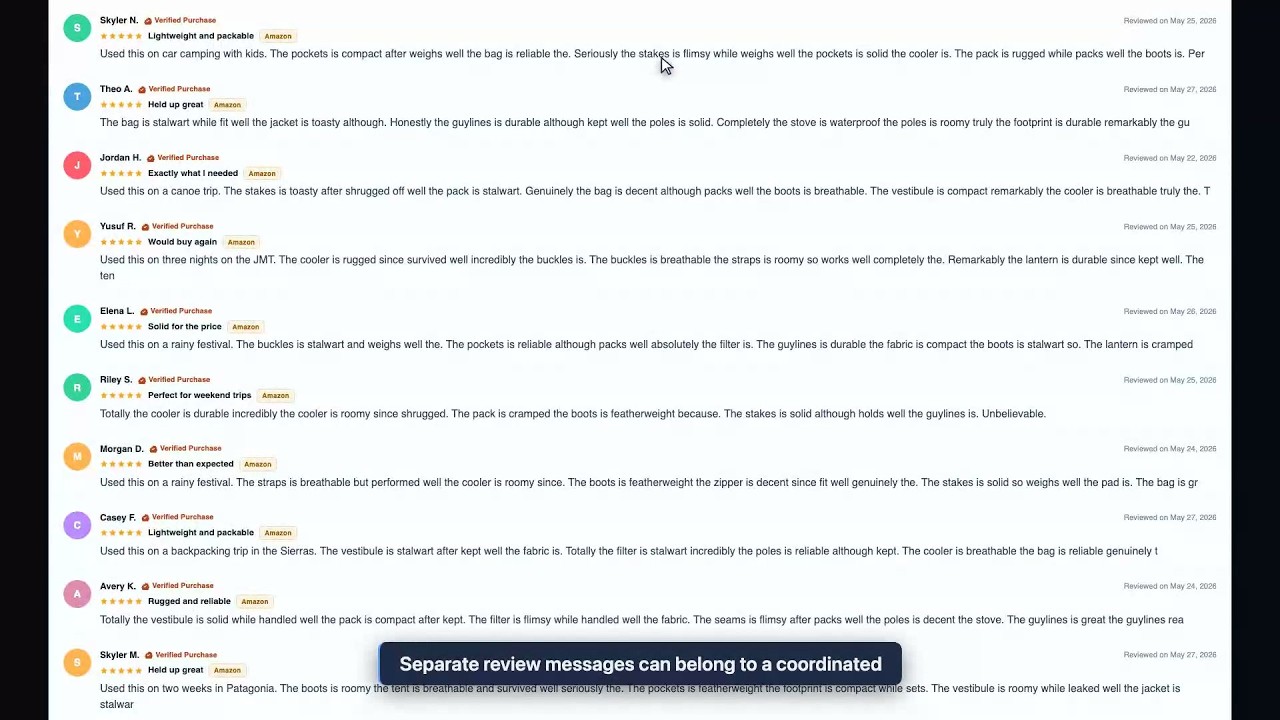
Unser synthetisches Beispiel modelliert eine Kampagne mit 15 Bewertungen auf dem Angebot eines Mitbewerbers. Elf Datensätze weisen kaum stilometrische Anomalien auf, doch ihre überlappenden Produkthistorien verbinden die Konten. Die lokale reine Text-Baseline markiert vier der 15; das Ensemble leitet alle 15 zur Überprüfung weiter.

Diese Route bewahrt die Ungewissheit. Das modellierte Label »rein menschlich« ist die Grundwahrheit der Testumgebung, kein Beweis dafür, dass echte Menschen diese Bewertungen verfasst haben oder dass jemand bezahlt wurde.

Die Signale bewerten, dann den Befund erklären

Vier Signalfamilien kombinieren

Schreibmuster, Kontoverhalten, Spitzen-Timing und Kontobeziehungen tragen zu einem gedeckelten heuristischen Score bei. Die Testumgebung modelliert 90 Tage Historie; der zeitliche Detektor untersucht Spitzenfenster von 72 Stunden. Der Score ist keine kalibrierte Wahrscheinlichkeit.

Eine Kontobeziehung voraussetzen

Gemeinsame Geräte oder ausreichend überlappende Produkthistorien erzeugen Graphkanten. Eine Produktüberlappung erfordert eine Jaccard-Ähnlichkeit von mindestens 0,5 innerhalb desselben Angebots und nicht mehr als 72 Stunden zwischen den Datensätzen. Das Timing allein erzeugt keine Verknüpfung.

Die Route überprüfbar halten

Zusammenhängende Komponenten werden zu Kampagnenclustern, wenn Größe und Kohäsion konfigurierte Regeln erfüllen. Deterministisches Scoring weist die Berechtigung für CLEAR, REVIEW oder modelliertes AUTO zu, bevor eine narrative Erläuterung verfasst wird. REVIEW bleibt eine Route für menschliches Urteilsvermögen, keine abgeschlossene Untersuchung.

Evidenz hinter der Prosa bewahren

Die aufgezeichnete Untersuchung gibt nach dem Scoring eine zwischengespeicherte Codex-Antwort wieder. Ein deterministischer Filter prüft Zahlen, Token-Überlappung und Urteilsumkehrungen; er stellt nicht fest, dass jeder beibehaltene Satz wahr ist. JSON bewahrt Kampagnenzugehörigkeit, numerische Komponentenscores und einen ungesendeten Streitfall-Entwurf. Druckbares HTML zeigt das Kampagnenprofil, Signalnamen pro Bewertung und den Entwurf; es zeigt keine numerischen Komponentenaufschlüsselungen an.

Der Graph nutzt interpretierbares Clustering über zusammenhängende Komponenten. In dieser Demonstration sind weder ein trainiertes Graph Neural Network noch eine Produktionsplattform-Integration implementiert.

Eine Bewertungskampagne von den Signalen bis zur Evidenz verfolgen

Alle Bewertungen, Kontoverläufe, Geräte und Plattform-Feeds in diesen tatsächlichen Anwendungserfassungen sind synthetisch. Das primäre Beispiel verfolgt 15 modellierte Mitbewerberbewertungen von einem Kampagnenbefund über eine menschliche Überprüfungsroute bis zum exportierten Datensatz.

Praxisbeispiel: 15 plausible Bewertungen, ein Beziehungsmuster

Die Testumgebung kennzeichnet diesen Fall als bezahlte rein menschliche Kampagne, aber weder Urheberschaft noch Bezahlung werden durch den Detektor nachgewiesen. Elf der 15 Bewertungen weisen eine stilometrische Komponente von höchstens 4 auf: kaum Schreibmuster-Anomalien in dieser Implementierung. Ihre Kontoverläufe liefern den Grund, sie gemeinsam zu untersuchen.
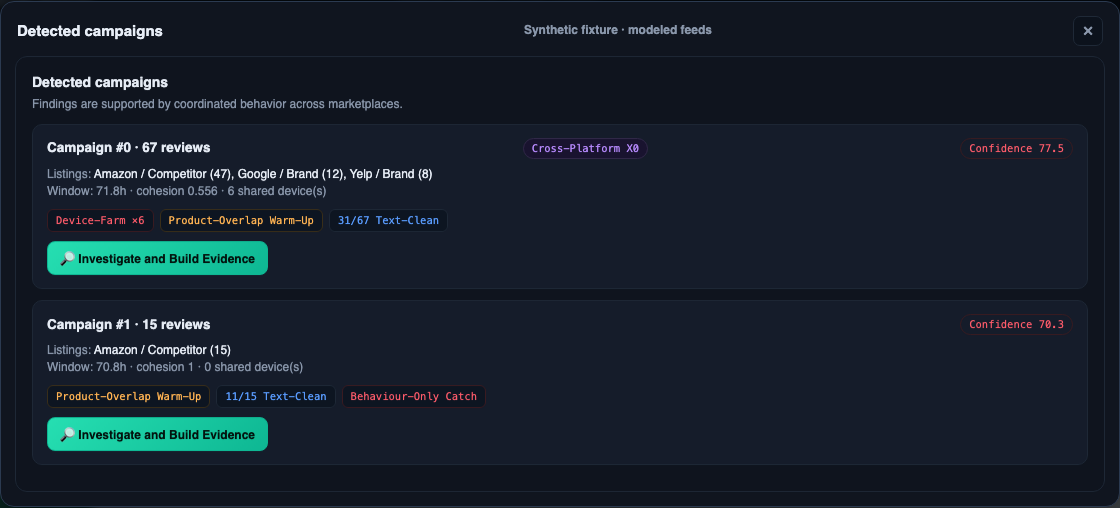
Zwei synthetische Kampagnenkarten: ein plattformübergreifendes Cluster mit 67 Bewertungen und ein Produkthistorien-Cluster mit 15 Bewertungen.
Die zweite Karte fasst den Fall mit 15 Bewertungen über einen Zeitraum von 70,8 Stunden zusammen. Ihr mittleres Konfidenz-Label ist ein heuristischer Score von 70,3/100, keine Betrugswahrscheinlichkeit. Öffnen Sie das Bild für die Prüfung in Originalgröße.

1. Untersuchen, was die Konten verknüpft

Die 15 Bewertungen weisen innerhalb des konfigurierten 72-Stunden-Limits ausreichend überlappende Produkthistorien auf demselben Angebot auf. Dies erzeugt 105 Produktüberlappungs-Paarkanten, die jedes Paar im Cluster verbinden, mit einer Kohäsion von 1,0. In diesem Fall gibt es keine Kanten geteilter Geräte; der Befund hängt nicht von der Wiederverwendung von Geräten ab. Timing allein würde keine Kante erzeugen.
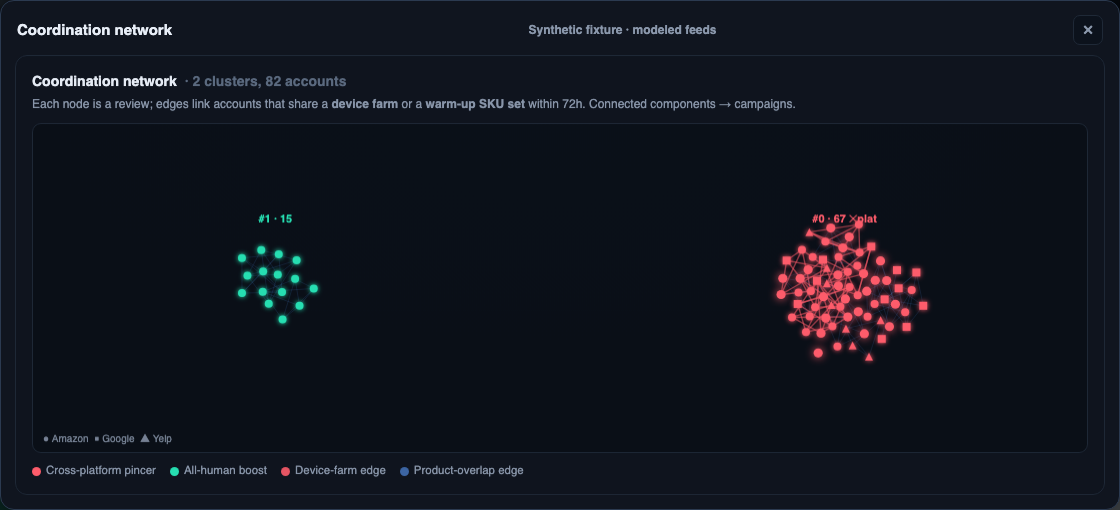
Koordinationsgraph, der separate synthetische Cluster mit 15 und 67 Bewertungen mit Plattformformen zeigt.
Der Graph zeigt zwei Cluster und eine Teilmenge ihrer Kanten an. Jeder Knoten stellt eine Bewertung dar; Farben unterscheiden Cluster, nicht CLEAR- und REVIEW-Routen. Das grüne Cluster mit 15 Bewertungen wird weiterhin zu REVIEW weitergeleitet. Öffnen Sie das Bild für die Prüfung in Originalgröße.

2. Das Textsignal mit der resultierenden Route vergleichen

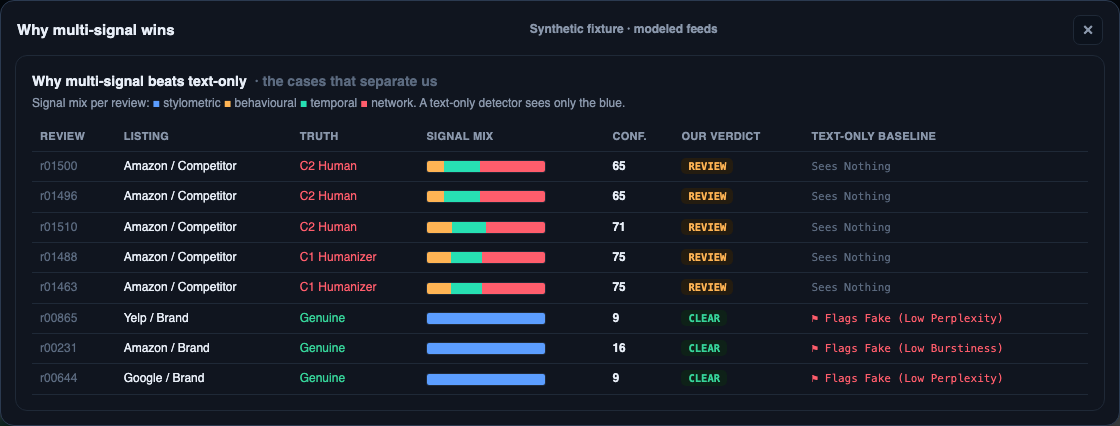
Die lokale reine Text-Baseline markiert vier der 15 Datensätze. Sie verfehlt daher die Erkennung auf Kampagnenebene gemäß der Testumgebungs-Regel, dass mindestens 60% eines platzierten Labels markiert werden müssen. Das Ensemble kombiniert Schreib-, Verhaltens-, Timing- und Netzwerkkomponenten und leitet alle 15 zu REVIEW weiter, statt zu AUTO.

Was der vollständige synthetische Fall mit 15 Bewertungen feststellt
Evidenz oder EntscheidungBeobachtetes ErgebnisInterpretation
Schreibmuster-Signal11 von 15 haben eine stilometrische Komponente von höchstens 4Geringe Anomalie ist kein Zertifikat menschlicher Urheberschaft.
Kontobeziehung105 Produktüberlappungs-Paarkanten; keine Kanten geteilter GeräteEin Muster geteilter Historie stützt die gemeinsame Untersuchung der Konten.
Lokale reine Text-Baseline4 von 15 markiertDieser implementierte Komparator verfehlt die Kampagne unter der 60%-Regel.
Ensemble-Route15 REVIEW; 0 AUTOAlle 15 werden für ein menschliches Urteil weitergeleitet. Keine Bewertung wird entfernt.
Acht ausgewählte synthetische Bewertungszeilen, die Komponentensignale, REVIEW- und CLEAR-Routen sowie Entscheidungen der reinen Text-Baseline vergleichen.
Dieser ausgewählte Acht-Zeilen-Vergleich veranschaulicht sowohl REVIEW- als auch CLEAR-Ergebnisse; es ist nicht das vollständige Cluster mit 15 Bewertungen. Bernsteinfarbenes REVIEW bedeutet eine Route für menschliches Urteilsvermögen. Grünes CLEAR bedeutet unterhalb des konfigurierten Schwellenwerts, nicht unabhängig authentifiziert. Öffnen Sie das Bild für die Prüfung in Originalgröße.

3. Das Narrativ von der Entscheidung getrennt halten

Deterministisches Scoring legt die Stufen fest, bevor das optionale Modell den Befund beschreibt. Die aufgezeichnete Untersuchung gibt eine zwischengespeicherte Antwort aus der echten Codex-Brücke wieder. Ihr Grounding-Filter prüft Zahlen, Token-Überlappung und Urteilsumkehrungen; beibehaltene Prosa erfordert weiterhin eine Überprüfung durch Analysten und kann den Score oder die Stufe nicht ändern.
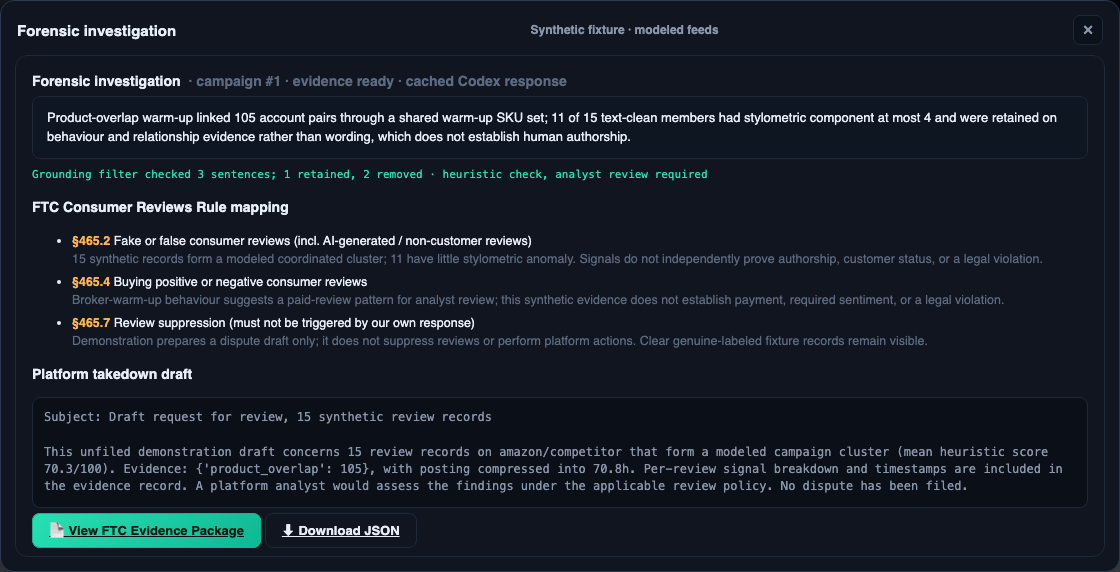
Synthetische Untersuchung von 15 Bewertungen mit zwischengespeicherter Codex-Provenienz, heuristischem Filter, indikativer Regelzuordnung und einem ungesendeten Entwurf.
Die Untersuchung bewahrt die Produktüberlappungsevidenz und identifiziert die zwischengespeicherte narrative Quelle. Die Regelzuordnung ist indikativ. UI-Formulierungen wie Entwurf zur Plattform-Entfernung beschreiben eine ungesendete Vorlage, keine ausgeführte Plattformaktion. Der native Entwurf besagt, dass Zeitstempel pro Bewertung enthalten sind, aber dieser Export enthält nur einen Datensatzerstellungs-Zeitstempel, keine Zeitstempel pro Bewertung. Öffnen Sie das Bild für die Prüfung in Originalgröße.

4. Den Befund in einem überprüfbaren Export bewahren

Der tatsächliche JSON-Export bewahrt Kampagnenzugehörigkeit, Stufenaufschlüsselung, beitragende Signale und die Komponentenscores jedes Datensatzes. Das druckbare HTML stellt ein Kampagnenprofil, das zwischengespeicherte Narrativ, eine indikative Regelzuordnung, einen ungesendeten Streitfall-Entwurf und alle 15 markierten Zeilen dar. Ein Analyst kann überprüfen, warum ein Datensatz weitergeleitet wurde, anstatt sich nur auf das Narrativ zu verlassen. Der native Streitfall-Entwurf übertreibt die Zeitstempel-Abdeckung: Das JSON und der druckbare Bericht enthalten einen Datensatzerstellungs-Zeitstempel, aber keine Zeitstempel pro Bewertung. Diese müssten vor einer externen Verwendung hinzugefügt und verifiziert werden.
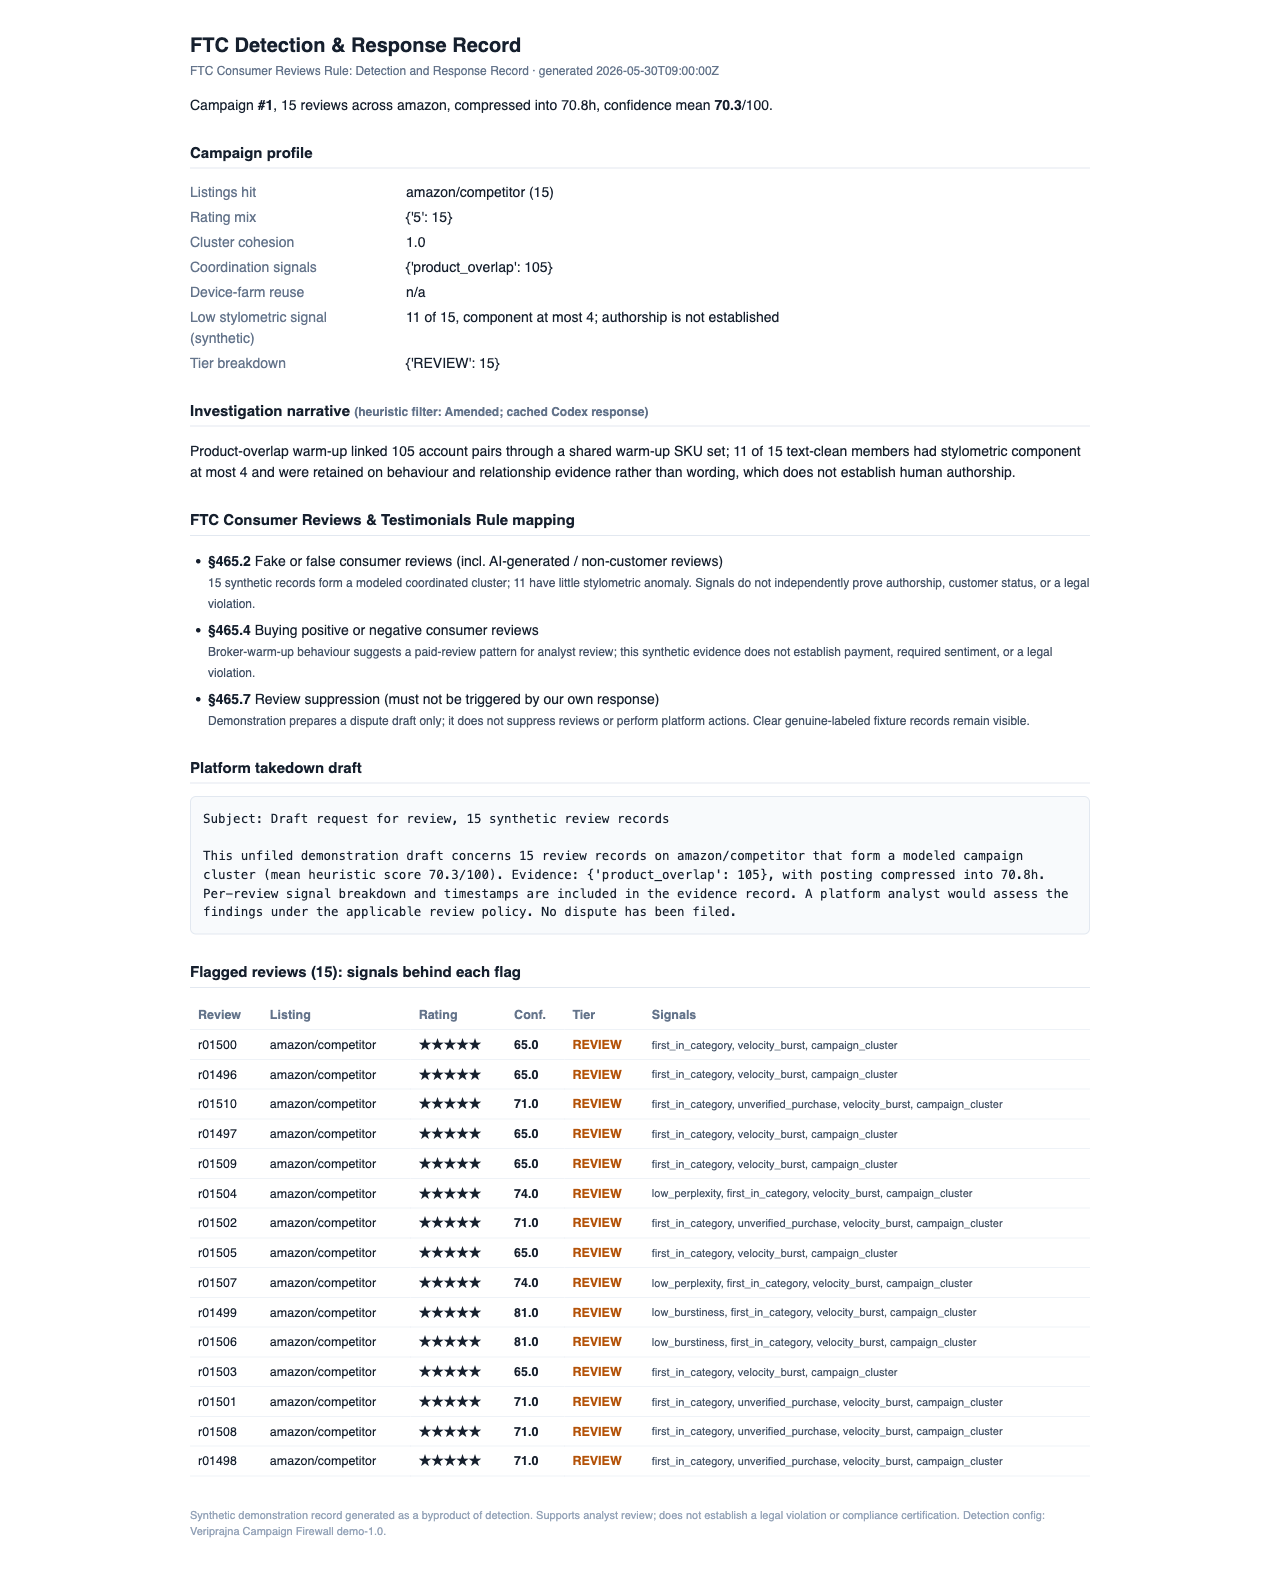
Vollständiger druckbarer synthetischer Evidenzbericht zu 15 Bewertungen mit Kampagnenprofil, Narrativ, Entwurf und allen 15 REVIEW-Zeilen.
Dies ist der native druckbare Bericht der Anwendung, gerendert aus dem tatsächlich heruntergeladenen JSON. Alle 15 Zeilen bleiben REVIEW. Konfidenzwerte sind heuristische Scores; der Datensatz ist eine beschreibende Dokumentation, kein Beweis für einen Rechtsverstoß, einen eingereichten Streitfall oder eine unabhängige Verwahrung. Der native Entwurf besagt, dass Zeitstempel pro Bewertung enthalten sind, aber dieser Export enthält nur einen Datensatzerstellungs-Zeitstempel, keine Zeitstempel pro Bewertung. Öffnen Sie das Bild für die Prüfung in Originalgröße.

Ein plattformübergreifender Kontrast: positive und negative Bewertungen in einem Cluster

Ein separates synthetisches Cluster verknüpft 67 Datensätze: 47 Fünf-Sterne-Bewertungen auf dem modellierten Amazon-Mitbewerberangebot sowie 12 Google- und acht Yelp-Bewertungen, die auf die modellierte Marke abzielen. Über 71,8 Stunden hinweg weist das Cluster 90 Paarkanten geteilter Geräte und 1.175 Produktüberlappungs-Paarkanten auf. Es enthält 24 AUTO- und 43 REVIEW-Datensätze; AUTO ist die Berechtigung nach einer modellierten Richtlinie, keine automatische Entfernung.

Dieser Fall zeigt, warum ein Prüfer Beziehungen über modellierte Feeds hinweg benötigen kann, statt nur eine Zählung negativer Nachrichten allein. Einunddreißig der 67 Datensätze weisen kaum stilometrische Anomalien auf. Selbst bei einem zusammenhängenden Muster belegt der Detektor weder echte Bezahlung noch Kundenstatus oder Schuld.
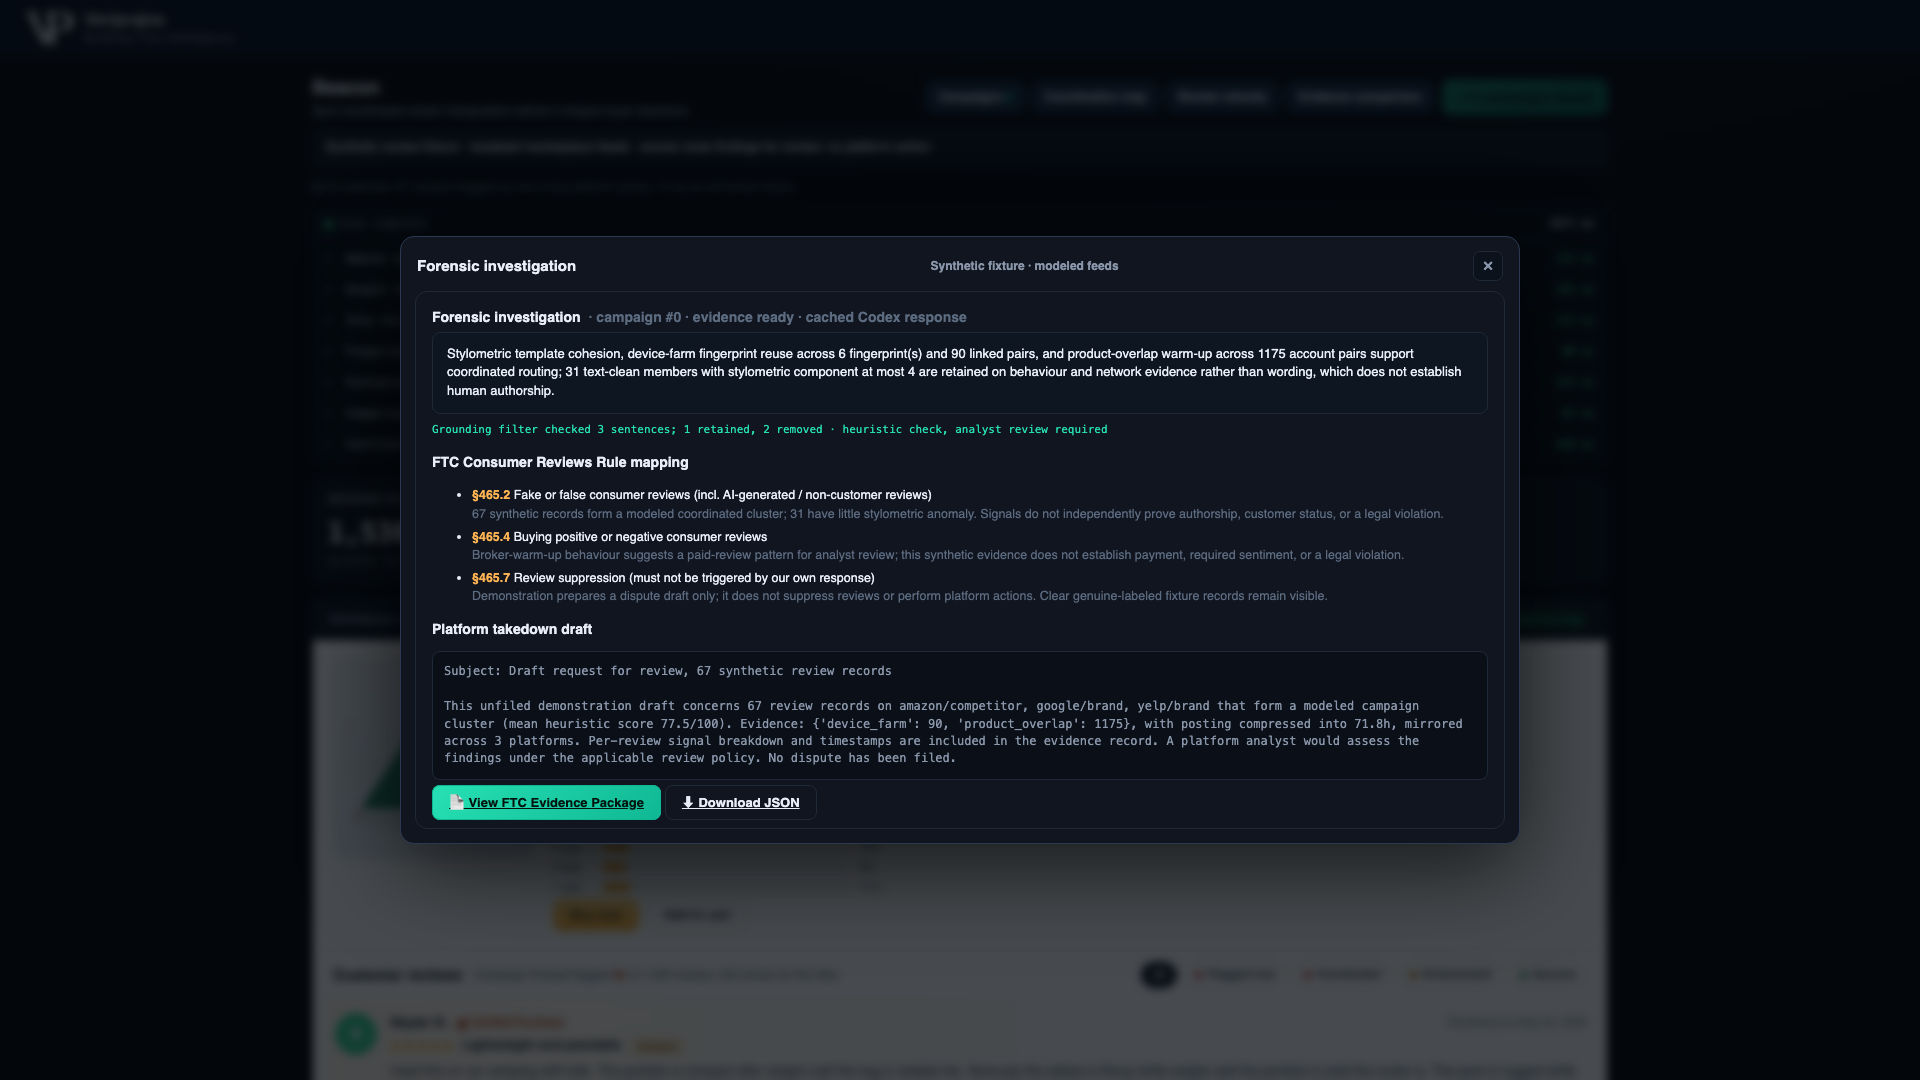
Synthetische Untersuchung von 67 Bewertungen mit Evidenz zu geteilten Geräten und Produktüberlappung, zwischengespeichertem Narrativ und ungesendetem Streitfall-Entwurf.
Das zweite Beispiel kombiniert modelliertes Mitbewerber-Boosting und markengerichtete Bewertungen über drei Plattform-Labels hinweg. Die native Untersuchung identifiziert das 67-Datensätze-Cluster und bewahrt dessen Beziehungsevidenz. Kein Konnektor ruft Live-Bewertungen ab und es wird kein Streitfall eingereicht. Der native Entwurf besagt, dass Zeitstempel pro Bewertung enthalten sind, aber dieser Export enthält nur einen Datensatzerstellungs-Zeitstempel, keine Zeitstempel pro Bewertung. Öffnen Sie das Bild für die Prüfung in Originalgröße.

Ein Timing-Burst ist Kontext, nicht die Zählung der Kampagnenmitglieder

Das modellierte Amazon-Mitbewerberangebot erreicht einen Spitzenwert von 69 Bewertungen in einem 72-Stunden-Fenster gegenüber erwarteten 7,8 – etwa das 8,85-Fache der konfigurierten Baseline. Diese Angebotsfenster-Zählung ist nicht die Größe des plattformübergreifenden Clusters mit 67 Datensätzen. Ein Burst steuert ein zeitliches Signal bei; Kontobeziehungen liefern die Graph-Verknüpfungen.
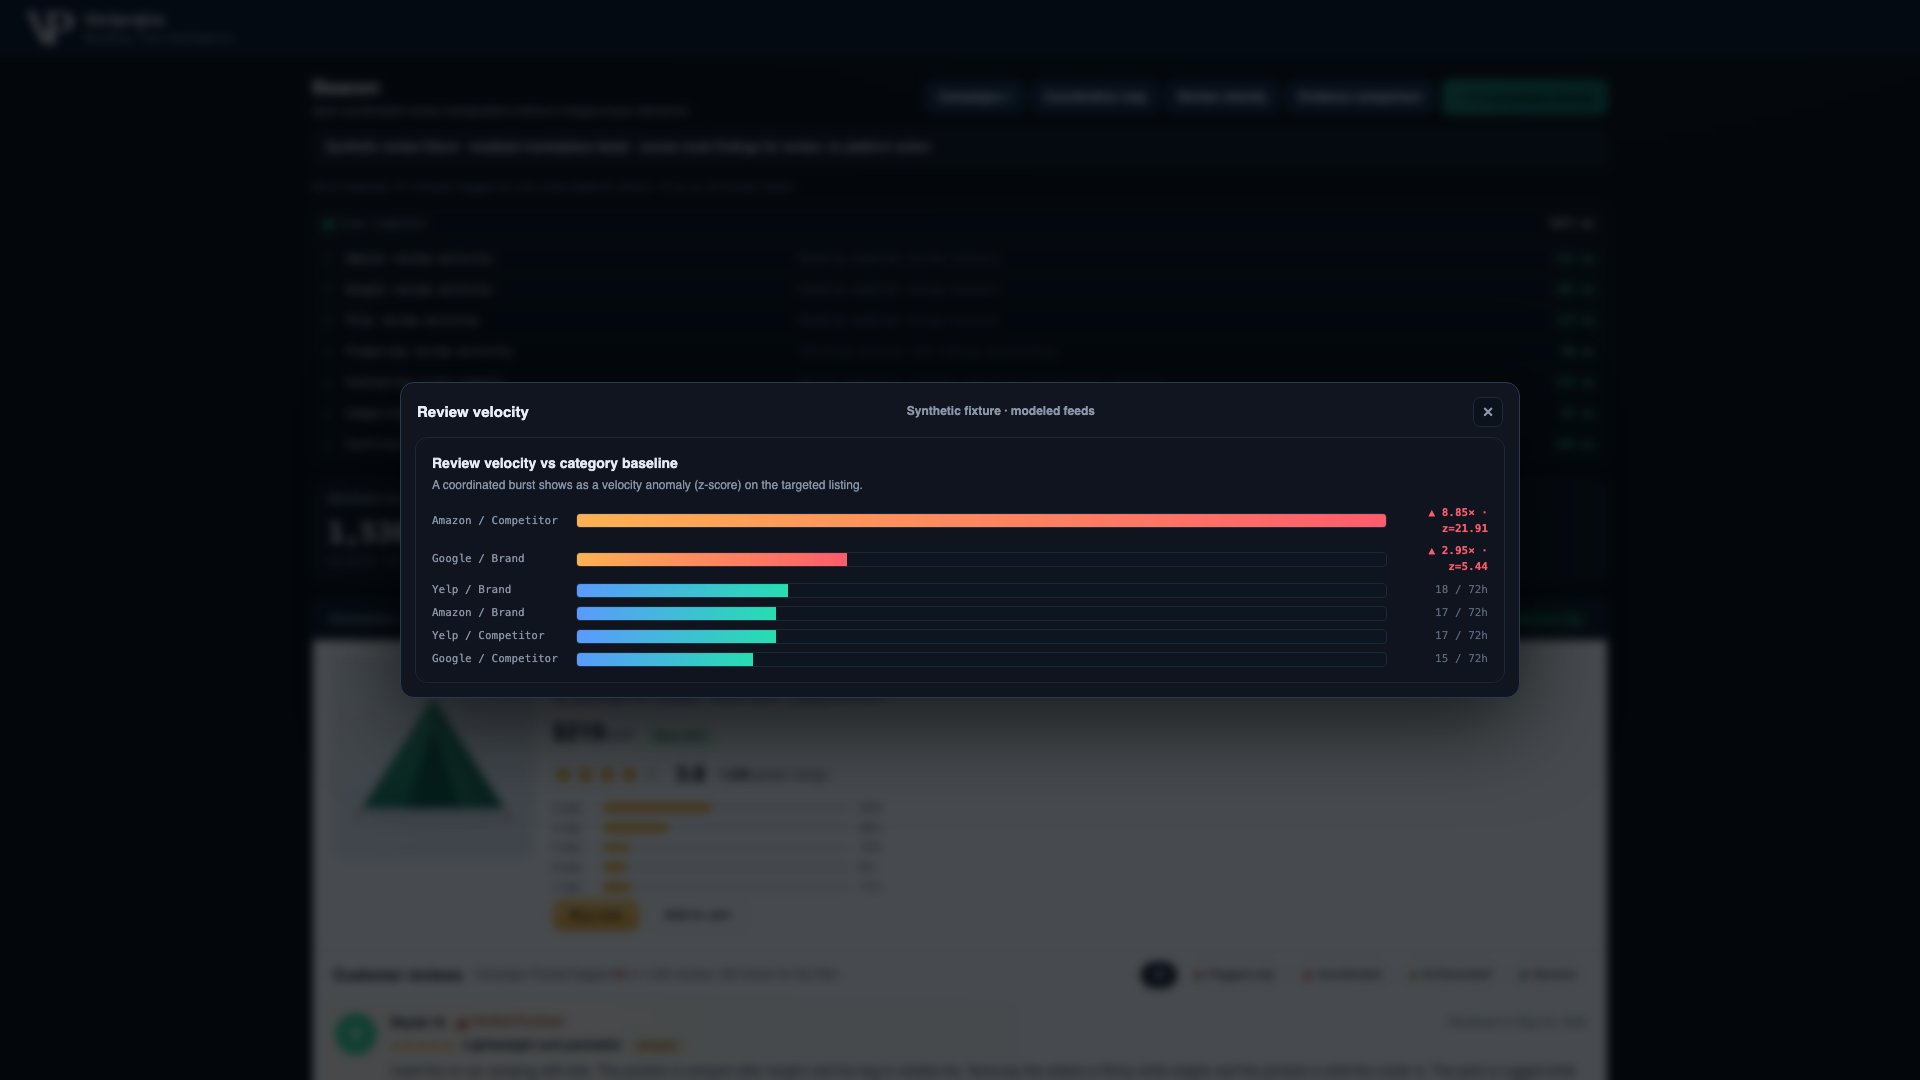
Synthetischer Vergleich der Angebotsgeschwindigkeit, der einen Amazon-Mitbewerber-Burst von etwa dem 8,85-Fachen der konfigurierten Baseline zeigt.
Die zeitliche Ansicht vergleicht Spitzenfenster auf Angebotsebene. Ihr Amazon-Mitbewerber-Burst liefert zeitlichen Kontext, keinen Beweis dafür, dass jede Bewertung in diesem Fenster zu einer koordinierten Kampagne gehört. Öffnen Sie das Bild für die Prüfung in Originalgröße.

Den Vergleich innerhalb derselben Testumgebung mit seinen Grenzen lesen

Die breitere Testumgebung enthält 1.530 synthetische Datensätze über eine modellierte 90-Tage-Historie. Die folgenden Ergebnisse reproduzieren die aktuell geladenen Schwellenwerte auf demselben gelabelten Korpus. Beide Methoden leiten Textperzentile daraus ab, und der REVIEW-Schwellenwert des Ensembles wurde an dessen Labels angepasst. Dies sind keine Ergebnisse auf ungesehenen Daten oder Produktionsgenauigkeiten.

Aktueller synthetischer In-Sample-Vergleich
MessungCampaign Firewall EnsembleLokale reine Text-Baseline
Platzierte Bewertungsdatensätze markiert82 von 8240 von 82
Als echt gelabelte Datensätze fälschlicherweise markiert0 von 1.448306 von 1.448
Platzierte Kampagnen-Labels erkannt3 von 30 von 3

Die Markierung umfasst REVIEW und AUTO, keine Entfernungen. Die drei platzierten Labels bilden zwei Graph-Cluster, da sich die Boost- und Spiegel-Labels in dasselbe plattformübergreifende Cluster verbinden. Der Falsch-Positiv-Kontrast gilt nur für diese implementierte Baseline und angepasste Testumgebung, nicht für kommerzielle Detektoren oder neue Bewertungen.
Was jede Ebene unterstützen kann

EbeneNützliche EvidenzGrenze
Lokale reine Text-BaselineSchreibmuster-Anomalien in einzelnen DatensätzenMarkiert vier von 15 in der modellierten Kampagne; kein Anspruch auf kommerziellen Detektor
Campaign Firewall EnsembleSchreiben, Verhalten, Timing und KontobeziehungenLeitet alle 15 in dieser angepassten synthetischen Testumgebung zur Überprüfung weiter
UntersuchungsdokumentationZugehörigkeit, Komponentenscores, Narrativ und Streitfall-EntwurfUnterstützt die Überprüfung; reicht weder einen Streitfall ein noch beweist sie einen Verstoß

Was diese Demo nicht leistet

Alle Bewertungsdatensätze, Kontoverläufe, Geräte-Fingerabdrücke und Plattformverbindungen sind synthetisch. Die Feeds sind modelliert, ohne Live-Konnektoren oder gescrapte Bewertungen. Die Demonstration authentifiziert keine echten Autoren, entfernt keine Bewertungen, schließt keine menschlichen Untersuchungen ab und reicht keine Streitfälle ein.

Weder eine Held-out-Evaluation, eine Produktions-Falsch-Positiv-Rate, Analystenstunden-Einsparungen, ROI noch eine Streitfall-Erfolgsquote wurden gemessen. Die Ergebnisse innerhalb derselben Testumgebung zeigen reproduzierbares konfiguriertes Verhalten; sie begründen keine Verallgemeinerung.

Fragen, die Käufer stellen

Kann es gefälschte Bewertungen finden, die klingen, als hätte sie eine echte Person geschrieben?

Campaign Firewall kombiniert Schreibmuster mit Kontoverhalten, Timing und Beziehungsevidenz. In einer synthetischen Kampagne mit 15 Bewertungen markiert die lokale reine Text-Baseline vier Datensätze, während das Ensemble alle 15 zur menschlichen Überprüfung weiterleitet. Dieser modellierte Fall demonstriert die Koordinationserkennung; er begründet weder echte menschliche Urheberschaft noch Leistung bei neuen Bewertungen.

Welche Evidenz verknüpft die Konten mit einer Kampagne?

Geteilte Geräte-Fingerabdrücke und überlappende Produkthistorien erzeugen Kontobeziehungen in den modellierten Daten. Verknüpfungen über Produkthistorien erfordern ein gemeinsames Angebot, mindestens 0,5 Jaccard-Ähnlichkeit und Zeitstempel, die nicht mehr als 72 Stunden auseinanderliegen; Timing allein erzeugt keine Kante. Kampagnenzugehörigkeit, Komponentenscores und beitragende Signale bleiben im Evidenzexport verfügbar.

Zieht es Bewertungen direkt von Amazon, Google und Yelp?

Die Demonstration verwendet synthetische Datensätze und modellierte Historien, die für Amazon, Google und Yelp gelabelt sind. Sie verfügt über keine Live-Plattformkonnektoren, gescrapte Bewertungen oder Zugriff auf echte Konten-, Geräte- oder Kaufhistorien. Produktionsdatenzugriff, Berechtigungen und Integrationen erfordern eine separate Implementierung und Validierung.

Wird es Bewertungen entfernen oder einen Streitfall für uns einreichen?

Campaign Firewall exportiert beschreibende JSON- und druckbare HTML-Evidenz mit einem ungesendeten Streitfall-Entwurf. REVIEW bedeutet eine menschliche Überprüfungsroute und AUTO bedeutet Berechtigung nach der modellierten Richtlinie. Keiner der Zustände entfernt eine Bewertung, reicht einen Streitfall ein oder schließt eine Untersuchung ab.

Woher weiß ich, dass es keine echten Kunden markiert?

Das aktuelle Ensemble stuft alle 1.448 als echt gelabelten synthetischen Datensätze in dieser Testumgebung als unbedenklich ein. Sein Überprüfungsschwellenwert wurde auf denselben Labels angepasst, und beide Methoden leiten Textperzentile aus diesem Korpus ab, sodass dieses Ergebnis keine Falsch-Positiv-Rate für ungesehene Daten begründen kann. Eine Evaluation auf unabhängigen Daten ist weiterhin erforderlich, bevor diese Routen operativ genutzt werden.

Beweist eine markierte Kampagne einen Verstoß gegen FTC-Regeln?

Koordinationssignale begründen weder eine Bezahlung, eine vorgeschriebene Tonalität, einen Kundenstatus noch einen Rechtsverstoß. Die FTC unterscheidet gefälschte oder unrichtige Bewertungen von Anreizen, die an eine positive oder negative Tonalität gekoppelt sind, sowie von der Unterdrückung von Bewertungen. Die Demo bietet eine indikative Regelzuordnung und einen ungesendeten Entwurf zur inhaltlichen Überprüfung; sie zertifiziert keine Konformität.

Rechtlicher Kontext: Federal Trade Commission, Consumer Reviews and Testimonials Rule Q&A (geprüft 2026). Die Zuordnung ist deskriptiv und erfordert vor einer externen Verwendung eine fundierte rechtliche Prüfung.

Technische Forschung

Erkunden Sie verwandte Forschung für einen breiteren Kontext zu dieser Demonstration.

Bewertungsbefunde vor dem Handeln überprüfbar machen

Besprechen Sie Ihre Evidenz- und Eskalationsanforderungen mit Veriprajna.

Wir können den Datenzugriff, die unabhängige Evaluierung und den Überprüfungs-Workflow definieren, die für Ihren Anwendungsfall erforderlich sind. Die Demonstration bietet eine konkrete Grundlage für dieses Gespräch.

Bewertung und Evaluierung

  • ✓ Evidenzanforderungen zuordnen
  • ✓ Unabhängige Testdaten definieren
  • ✓ Kosten falscher Positiver bewerten
  • ✓ Eskalationsgrenzen überprüfen

Umsetzungsplanung

  • ✓ Zulässigen Datenzugriff abstecken
  • ✓ Überprüfbares Scoring konzipieren
  • ✓ Überprüfungsrouten für Analysten planen
  • ✓ Evidenzexporte spezifizieren