KI-Sicherheit & Resilienz
Gegnerische Härtung, Integrität der Lieferkette und souveräne Deployment-Architektur für Unternehmen, die KI produktiv einsetzen.
Die Bedrohungslandschaft für KI-Systeme hat sich 2025 von der akademischen Forschung zur operativen Ausnutzung verlagert. Produktive KI-Werkzeuge, die von Millionen von Entwicklern genutzt werden, weisen inzwischen CVEs mit hohen CVSS-Werten auf, die Angriffsfläche vergrößert sich gleichzeitig über Software, Lieferkette und Hardware hinweg, und die regulatorische Uhr tickt. Anbieter von Einzellösungen und Governance-Frameworks lösen Teilbereiche davon, doch keines von beiden konzipiert die Sicherheitsarchitektur eines aktiven Produktivbetriebs von KI. Genau für diese Lücke entwickeln wir Lösungen.
Produktive KI steht unter aktivem Angriff, und die meisten Sicherheitsprogramme halten nicht Schritt
2025 wandelte sich die Ausnutzung von KI von Machbarkeitsnachweisen hin zu dokumentierten CVEs in Werkzeugen, auf die Millionen von Entwicklern vertrauen:
- Microsoft 365 Copilot – eine Zero-Click-Prompt-Injection-Schwachstelle (CVE-2025-32711, CVSS 9.3), bei der eine einzelne manipulierte E-Mail eine unbefugte Datenexfiltration aus der Ferne auslöste.
- GitHub Copilot – kompromittiert über in einem öffentlichen Repository eingebettete Code-Kommentare (CVE-2025-53773), was zu einer Remotecodeausführung eskalierte.
- Cursor IDE – ein Fehler bei der Groß-/Kleinschreibung (CVE-2025-59944) ermöglichte es Angreifern, agentisches Verhalten zur Ausführung beliebiger Befehle zu manipulieren.
Dies sind keine Demonstrationen. Es sind CVEs mit CVSS-Werten in produktiven Werkzeugen. Und die Angriffsfläche weitet sich in drei Richtungen gleichzeitig aus.
Agentische Systeme und Vertrauensgrenzen
Agentische KI-Systeme schaffen Probleme bei Vertrauensgrenzen, die traditionelle Perimetersicherheit nicht lösen kann. Nur 29 % der Unternehmen berichten von einer Bereitschaft zur Absicherung agentischer Systeme, und MITRE ATLAS v5.4.0 (Februar 2026) fügte dedizierte Techniken für agentenspezifische Bedrohungen hinzu, darunter „Publish Poisoned AI Agent Tool“ und „Escape to Host“.
Angriffe auf die KI-Lieferkette
Angriffe auf die Lieferkette haben sich von der Theorie zur Praxis verlagert. JFrog identifizierte rund 100 bösartige Modelle auf Hugging Face mit eingebetteten Payloads zur Codeausführung, und Palo Alto Unit 42 wies nach, dass gelöschte Hugging-Face-Namespaces von jedermann neu registriert werden können, was ein Hijacking der Lieferkette ermöglicht.
Schwachstellen auf Hardwareebene
Der GDDRHammer-Angriff (2026) zeigte, dass ein nicht privilegierter CUDA-Kernel über GDDR6-Rowhammer beliebigen Lese-/Schreibzugriff auf den GPU-Speicher erlangen kann – was bedeutet, dass mandantenfähige GPU-Umgebungen eine Hardware-Angriffsfläche besitzen, die keine Verteidigung auf Softwareebene schließen kann.
Zunehmender regulatorischer Druck
Parallel dazu verschärft sich die Regulierung. Im Rahmen des EU AI Act traten verbotene Praktiken im Februar 2025 in Kraft, Anforderungen an Hochrisikosysteme greifen ab August 2026 und die Strafen reichen bis zu EUR 35 Millionen oder 7 % des weltweiten Jahresumsatzes. CISA stufte Prompt Injection im September 2025 als kritische KI-Schwachstelle ein; NIST veröffentlichte das AI RMF 2.0 mit spezifischen Leitlinien zu Prompt Injection im Januar 2026. Unter dem Gesetz zum Schutz biometrischer Daten CUBI erstritt Texas $1,375 Milliarden von Google und $1,4 Milliarden von Meta allein im Jahr 2025. Der Compliance-Aufwand vervielfacht sich mit jedem Quartal.
In der KI-Lieferkette haben die meisten Unternehmen keinerlei Transparenz
Wenn wir KI-Implementierungen in Unternehmen bewerten, ist die Lücke in der Lieferkette durchweg der gefährlichste Befund. Die meisten Organisationen können kein vollständiges Inventar der in Produktion laufenden Modelle vorweisen, geschweige denn deren Herkunft überprüfen (Thema unserer Forschung zum Schutz von Unternehmensmodellen vor Poisoning). Eine Lineaje-Umfrage (Juni 2025) ergab, dass 48 % der Sicherheitsexperten angeben, dass ihre Unternehmen bereits bei grundlegenden Anforderungen an Software-Stücklisten (Software Bill of Materials) ins Hintertreffen geraten. Die Einführung von ML-BOM (Machine Learning Bill of Materials) liegt noch deutlich darunter.
Das Risiko ist dokumentiert und nicht theoretisch:
- Anthropic, das UK AI Safety Institute und das Alan Turing Institute wiesen nach, dass bereits 250 bösartige Dokumente erfolgreich Sprachmodelle mit einer Backdoor versehen können, von 600 Millionen bis 13 Milliarden Parametern.
- DeepSeeks DeepThink-R1 Modell (Januar 2025) wies nachweislich eine Backdoor auf, die durch versteckte Prompts in GitHub-Codekommentaren während des Trainings erzeugt wurde. Das Modell folgte vom Angreifer platzierten Anweisungen, sobald es auf eine bestimmte Trigger-Phrase stieß – Monate nach dem Training und ohne dass ein Internetzugang erforderlich war.
- Qwen 2.5s Suchwerkzeug wurde durch feindselige Webinhalte manipuliert, was das ausgerichtete Modell dazu brachte, schädliche Ausgaben zu erzeugen – ausgelöst durch eine Suchanfrage aus nur 11 Wörtern.
Herkömmliches Sicherheitsscanning erfasst diese Probleme nicht. Hugging Face setzt zwar Picklescan für bösartige Pickle-Dateien ein, doch bösartige LoRA-Adapter, vergiftete Trainingsdatensätze und neu registrierte Namespaces umgehen allesamt das Scanning auf Modellebene. Standards existieren bereits – CycloneDX veröffentlichte die ML-BOM-Spezifikation im Jahr 2023, SPDX 3.0.1 definiert KI- und Datensatzprofile, und OWASP startete das AI-BOM-Projekt – doch die Lücke zwischen der Verfügbarkeit von Spezifikationen und deren tatsächlicher Einführung in Organisationen bleibt enorm. Der Aufbau von Integrität in der KI-Lieferkette erfordert dieselbe Disziplin, die Anwendungssicherheit vor einem Jahrzehnt für Software-Abhängigkeiten etabliert hat: automatisierte Scans, Herkunftsnachweise, kontinuierliche Überwachung und ein Reaktions-Playbook für den Fall, dass ein Angriff durchdringt.
Warum das bestehende Sicherheits-Ökosystem Lücken auf Architekturebene hinterlässt
Die Landschaft der KI-Sicherheitsanbieter wächst rasant, und ihre Einzellösungen sind stark:
- Protect AI sammelte über $108 Millionen ein und betreibt das Bug-Bounty-Programm huntr.com für KI/ML-Schwachstellen; es scannt Modellartefakte auf bekannte Schwachstellen.
- HiddenLayer ($56 Millionen) konzentriert sich auf die Überwachung des Modellverhaltens zur Laufzeit.
- Lakera entwickelte das Produkt, das viele als führend für die Erkennung von Prompt Injection ansehen (Lakera Guard).
- Cisco übernahm Robust Intelligence im Jahr 2024; F5 übernahm CalypsoAI für $180 Millionen im Jahr 2025.
Allein für den Markt des KI-Red-Teamings wird ein Wachstum von $1,3 Milliarden (2025) auf $18,6 Milliarden bis 2035 prognostiziert. Doch diese Werkzeuge sind Sensoren und Filter, keine strukturellen Kontrollen – keines davon entwirft die gesamte Sicherheitsarchitektur eines KI-Einsatzes. Ein CISO, der ein Programm aus diesen Komponenten zusammenstellt, benötigt weiterhin jemanden, der festlegt, wo Vertrauensgrenzen in einem agentischen System verlaufen, wie die Herkunftsprüfung von Modellen in die CI/CD-Pipeline integriert wird, welches Monitoring eine erst nach dem Deployment aktivierte Backdoor erkennt und wie ein souveränes Deployment tatsächlich funktioniert, wenn das Compliance-Team vorschreibt, dass die Inferenz die Jurisdiktion nicht verlassen darf.
Die Big Four haben insgesamt über $10 Milliarden seit 2023 in KI investiert: PwC betreibt ein $1 Milliarde schweres GenAI-Programm und eine OpenAI-Partnerschaft; KPMG verfügt über ein formelles 10-Säulen-KI-Governance-Framework mit ISO-42001-Mapping; Deloitte entwickelte über 100 GenAI-Beschleuniger; EY implementiert NVIDIA-AI-Factory-Infrastruktur für regulierte Branchen. Ihre Governance- und Compliance-Arbeit ist legitim.
Wenn ein Kunde jedoch praktische gegnerische Tests (Adversarial Testing) einer RAG-Pipeline, eine architektonische Härtung gegen indirekte Prompt Injection in einem Multi-Agenten-System oder das operative Deployment einer souveränen KI-Infrastruktur mit Integritätsprüfung der Modellgewichte benötigt, reichen Governance-Frameworks nicht aus. Die Lücke klafft zwischen dem Wissen um das Risiko und der ingenieurtechnischen Fähigkeit, es strukturell zu verhindern.
Was wir für KI-Sicherheitsprogramme entwickeln
Wir arbeiten auf Architekturebene, weil Sicherheitsentscheidungen dort strukturelle Wirkung entfalten. Das Filtern von Prompt Injection auf der Eingabeebene weist bei adaptiven Angriffen eine dokumentierte Fehlerrate auf. Das Scannen von Modellen nach dem Download erkennt bekannte Muster, übersieht jedoch neuartige Angriffe auf die Lieferkette. Governance-Frameworks sagen Ihnen, was zu überwachen ist, bauen die Überwachung jedoch nicht auf. Wir konzentrieren uns auf vier Bereiche, in denen die Architektur darüber entscheidet, ob die Sicherheitslage standhält – einschließlich souveräner Deployments, bewiesen anhand einer funktionierenden Private-LLM-Demo.
Souveräne KI-Infrastruktur
Für Organisationen, die unter Auflagen der Datensouveränität operieren, besteht unser Ansatz im Aufbau einer Infrastruktur, in der Modelle, Inferenz und Trainingsdaten innerhalb kontrollierter Grenzen verbleiben. Dies ist kein VPC-Wrapper um einen API-Aufruf. Es bedeutet die Auswahl und Quantisierung von Modellen für On-Premises-Hardware – die Abwägungen zwischen einer Quantisierung mit GPTQ, AWQ und GGUF sind sowohl für die Leistung als auch für die Sicherheit maßgeblich –, die Konfiguration der GPU-Isolation für mandantenfähige Umgebungen, die Implementierung kryptografischer Nachweise (Attestation) für Modellgewichte und der Aufbau des Monitoring-Stacks zur Erkennung anomalen Inferenzverhaltens. Ein souveränes Deployment ist konzipiert als ein sechsmonatiges Engineering-Projekt, nicht als Konfigurationsänderung – durchgängig von Grund auf entwickelt statt aus einem Wrapper zusammengestellt.
Integrität der Lieferkette
Wir konzipieren die Verifizierungspipeline so, dass sie ausgeführt wird, bevor ein Modell jemals die Produktion erreicht (ausführlich beschrieben in unserer Forschungsarbeit zur Integrität der KI-Lieferkette über den gesamten ML-Lebenszyklus): automatisierte Herkunftsprüfungen von Modellgewichten und Trainingsdaten, Validierung des Serialisierungsformats (grundsätzlich safetensors statt pickle), Integritätsprüfung von LoRA-Adaptern und kontinuierliche Überwachung von Upstream-Repositories auf Namespace-Hijacking oder Manipulation von Modellgewichten. Das angestrebte Ergebnis ist ein ML-BOM , das die Herkunft jeder Komponente, die Version jeder Abhängigkeit und den Ursprung jedes Trainingsdatensatzes abbildet.
Gegnerische Härtung
Wir kombinieren Red-Teaming mit architektonischer Behebung und testen anhand der MITRE ATLAS -Taxonomie sowie den OWASP LLM Top 10 v2.0 – doch Tests allein lösen das Problem nicht. Wenn die Tool-Calling-Schnittstelle eines agentischen Systems für indirekte Prompt Injection über abgerufene Dokumente anfällig ist, konstruieren wir die Vertrauensgrenzen-Architektur, die nicht vertrauenswürdige Inhalte strukturell von privilegierten Operationen trennt (siehe unsere Forschung zur Absicherung der Mensch-KI-Schnittstelle). Wenn eine RAG-Pipeline System-Prompts über gezielt formulierte Anfragen preisgibt (OWASP LLM07, neu in der Ausgabe von 2025), gestalten wir die Retrieval- und Generierungs-Pipeline neu, um dies zu verhindern.
Regulatorisches Mapping
Wir verknüpfen spezifische technische Kontrollen mit den für Ihren Einsatz geltenden regulatorischen Anforderungen: EU AI Act Pflichten für Hochrisikosysteme, NIST AI RMF 2.0, OWASP LLM Top 10, bundesstaatliche Gesetze zum Schutz biometrischer Daten (BIPA, CUBI, Colorado H.B. 24-1130) und branchenspezifische Vorgaben. Das angestrebte Ergebnis ist keine Compliance-Matrix in einer Tabellenkalkulation. Es sind implementierte Kontrollen mit Monitoring, Nachweiserbringung und Audit-Trails, die Regulierungsbehörden überzeugen und die durchschnittlichen Kosten von $4,63 Millionen für eine KI-bezogene Datenschutzverletzung senken.
Wichtigste Erkenntnisse
- Die Ausnutzung von KI ist operativ, nicht akademisch: 2025 entstanden reale CVEs in Microsoft 365 Copilot, GitHub Copilot und Cursor IDE, flankiert von GDDRHammer-Angriffen auf GPU-Ebene im Jahr 2026.
- Die Lieferkette ist der gefährlichste blinde Fleck – bereits 250 bösartige Dokumente können ein Modell mit einer Backdoor versehen, und Standards wie CycloneDX ML-BOM, SPDX 3.0.1 sowie OWASP AI-BOM eilen ihrer praktischen Einführung voraus.
- Anbieter von Einzellösungen und die Governance-Programme der Big Four hinterlassen dieselbe Lücke: Niemand entwirft die Sicherheitsarchitektur des Produktiveinsatzes.
- Wir bauen auf Architekturebene in vier Bereichen – souveräne KI-Infrastruktur, Integrität der Lieferkette, gegnerische Härtung und regulatorisches Mapping – und verwandeln Risikobewusstsein in strukturell durchgesetzte Kontrollen.
KI-Sicherheit & Resilienz
 Ansehen
KI-Lieferkettensicherheit & Modellintegrität | Veriprajna
Beratung für KI-Lieferkettensicherheit. Wir bauen Modell-Prüfpipelines, ML-BOM-Architektur und Schatten-KI-Governance für CISOs in regulierten Unternehmen. Konform mit NIST AI 100-2 und EU AI Act.
 Ansehen
Biometrie- & Gesichtserkennungs-Compliance | Veriprajna
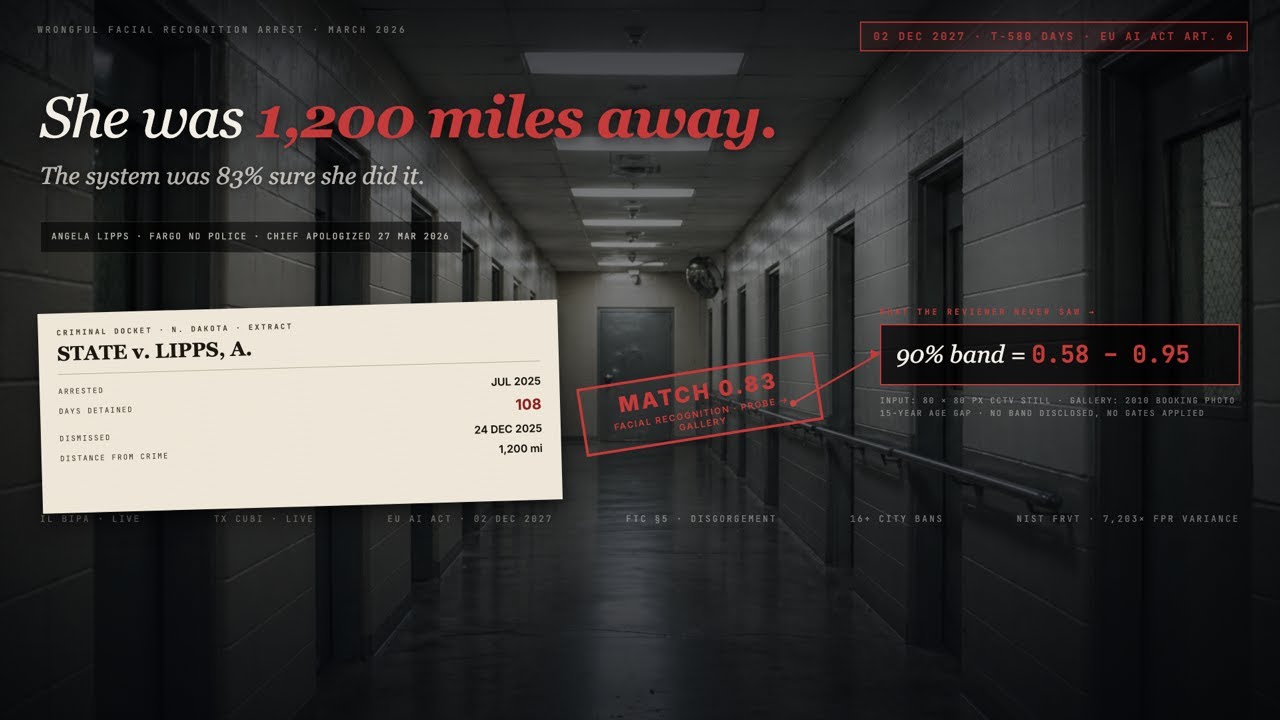
Ob Sie Gesichtserkennung bereits eingeführt haben und Ihr Risiko kennen müssen oder ob Sie Anbieter evaluieren und es von Anfang an richtig machen wollen: Wir prüfen biometrische Systeme anhand der Vorschriften, Benchmarks und betrieblichen Standards, die wirklich zählen.
 Ansehen
Integrität der Software-Update-Bereitstellung & IT-Resilienz | Veriprajna
Am 19. Juli 2024 brachte eine einzige Konfigurationsdatei in weniger als 90 Minuten 8,5 Millionen Windows-Rechner zum Absturz. Keine Schadsoftware.
 Ansehen
Sovereign AI & Private-LLM-Bereitstellung | Veriprajna
Jedes fünfte Unternehmen hat bereits einen Sicherheitsvorfall durch die nicht genehmigte Nutzung von KI-Tools erlitten. Ein Verbot von KI funktioniert nicht. Der Aufbau sicherer, souveräner Alternativen schon.
Häufig gestellte Fragen
Sollten wir ein Beratungsunternehmen für KI-Sicherheit beauftragen oder ein internes KI-Sicherheitsteam aufbauen?
Die ehrliche Antwort lautet: Sie benötigen Elemente von beidem, und das Timing ist entscheidend. Der Aufbau eines internen KI-Sicherheitsteams von Grund auf dauert 12 bis 18 Monate für Rekrutierung, Einarbeitung und Operationalisierung. Der Talentpool ist rar: Offensive KI-Sicherheitsforscher, die produktive LLM-Systeme einem Red-Teaming unterziehen und anschließend die architektonischen Behebungen entwerfen können, gibt es nur wenige. Eine Beratung bringt Sie schneller zu einer vertretbaren Sicherheitslage, während Sie interne Kapazitäten aufbauen. Wir werden typischerweise für 3 bis 6 Monate aktiv, um die aktuelle KI-Einsatzlandschaft zu bewerten, die Sicherheitsarchitektur aufzubauen (Lieferkettenprüfung, Vertrauensgrenzen, Monitoring), kritische Systeme einem Red-Teaming zu unterziehen und das Programm so zu dokumentieren, dass Ihr internes Team es weiterführen kann. Die Übergabe ist das Ziel: Wir bauen das Programm und das Tooling auf; Ihr Team betreibt es. Die Kosten eines sechsmonatigen Engagements sind ein Bruchteil dessen, was ein einziger KI-bezogener Sicherheitsvorfall oder der Vergleich in einer Sammelklage zu biometrischen Daten kostet (allein Texas erstritt 2025 $2,8 Milliarden von Google und Meta).
Wie lange dauert ein KI-Sicherheits-Assessment und was umfasst es?
Ein umfassendes KI-Sicherheits-Assessment dauert je nach Anzahl der einbezogenen KI-Systeme in der Regel 4 bis 8 Wochen. Woche eins erfasst das KI-Inventar: jedes Modell in Produktion, dessen Herkunft, Deployment-Methode, Datenflüsse und Zugriffskontrollen. Die meisten Unternehmen entdecken dabei Modelle, von deren Betrieb sie nichts wussten. Die Wochen zwei bis vier umfassen gegnerische Tests anhand der MITRE-ATLAS-Taxonomie und der OWASP LLM Top 10 v2.0, einschließlich Prompt Injection (direkt und indirekt), Integritätsprüfung der Lieferkette, Datenexfiltrationstests und Rechteausweitung über Tool-Calling-Schnittstellen. Die Abschlussphase liefert einen priorisierten Sanierungsplan mit architektonischen Empfehlungen, nicht bloß eine Mängelliste. Wir ordnen jeden Befund den geltenden regulatorischen Anforderungen zu (EU AI Act, NIST AI RMF, BIPA/CUBI, sofern biometrische Systeme betroffen sind), sodass die Behebung gleichzeitig Sicherheits- und Compliance-Lücken schließt.
Was hilft in der Produktion tatsächlich gegen Prompt Injection?
Keine einzelne Schutzmaßnahme stoppt Prompt Injection zuverlässig. Der Raum möglicher Injections ist unendlich, während Filter nur endliche Muster abdecken. Adaptive Angriffe gegen eine einzelne Schutzschicht erreichen in kontrollierten Tests Erfolgsquoten von über 85 %. Was wirklich funktioniert, ist eine mehrschichtige architektonische Verteidigung. Die Eingabevalidierung fängt die offensichtlichen Angriffe ab. Eine Ausgabevalidierung mittels LLM-as-a-Critic verbessert die Erkennungspräzision um 21 % gegenüber reiner Eingabefilterung (basierend auf über 600.000 gegnerischen Prompts aus dem HackAPrompt-Datensatz). Doch strukturelle Kontrollen sind am wichtigsten: die Trennung nicht vertrauenswürdiger Inhalte von privilegierten Anweisungen auf Architekturebene, die Durchsetzung des Least-Privilege-Prinzips an Tool-Calling-Schnittstellen, die Verpflichtung zur menschlichen Freigabe bei folgenschweren Operationen und die Gestaltung von Retrieval-Pipelines derart, dass abgerufene Dokumente Anweisungen auf Systemebene nicht überschreiben können. Speziell bei agentischen Systemen müssen Vertrauensgrenzen zwischen Agenten explizit definiert und durchgesetzt werden, statt sie vorauszusetzen. Wir integrieren diese Architekturkontrollen direkt in das System, anstatt nachträglich externe Filter anzusetzen.
Wie sichern wir unsere KI-Modell-Lieferkette ab, wenn wir Open-Source-Modelle von Hugging Face nutzen?
Akzeptieren Sie zunächst, dass Hugging Face eine öffentliche Registry ist und keine geprüfte Lieferkette. JFrog fand rund 100 bösartige Modelle mit eingebetteten Payloads zur Codeausführung. Palo Alto Unit 42 zeigte, dass gelöschte Namespaces von Angreifern neu registriert werden können. Bösartige LoRA-Adapter sind ohne Integritätsprüfung nicht von legitimen Fine-Tunings zu unterscheiden. Die praktische Verteidigung umfasst vier Schichten. Erstens: Laden Sie in der Produktion niemals Pickle-serialisierte Modelle; verlangen Sie das safetensors-Format, das bauartbedingt nicht ausführbar ist. Zweitens: Überprüfen Sie die Herkunft des Modells – kontrollieren Sie die Commit-Historie, die Reputation der Mitwirkenden und die Prüfsummen der Modellgewichte im Abgleich mit bekannten, sicheren Baselines. Drittens: Erstellen Sie eine ML-BOM (Machine Learning Bill of Materials) unter Verwendung von CycloneDX oder SPDX 3.0.1, die Herkunft, Version und Abhängigkeiten jeder Modellkomponente erfasst. Viertens: Führen Sie automatische Scans bei jedem Modellupdate durch, bevor es in Ihre CI/CD-Pipeline gelangt, und überwachen Sie Upstream-Repositories auf Namespace-Änderungen oder unerwartete Gewichtsmodifikationen. Wir bauen diese Verifizierungspipeline als festen Bestandteil Ihres MLOps-Workflows auf, nicht als separaten manuellen Prozess.
Welche Sicherheitsanforderungen des EU AI Act für Hochrisiko-KI-Systeme treten im August 2026 in Kraft?
Die Anforderungen des EU AI Act an Hochrisikosysteme (gültig ab 2. August 2026) verlangen spezifische Sicherheitskontrollen, darunter Robustheit gegen gegnerische Angriffe, Data Governance für Trainingsdatensätze, technische Dokumentation des Systemdesigns und der Tests, Mechanismen für menschliche Aufsicht sowie Genauigkeits- und Zuverlässigkeitsüberwachung über den gesamten Lebenszyklus. Die Strafen reichen bei schwersten Verstößen bis zu 35 Millionen EUR oder 7 % des weltweiten Jahresumsatzes. Die praktische Herausforderung besteht darin, dass die Anforderungen des Gesetzes prinzipienbasiert und nicht präskriptiv sind. Ein „angemessenes Maß an Robustheit“ besagt nicht, welche gegnerischen Tests durchzuführen sind. Wir bilden die gesetzlichen Vorgaben auf konkrete technische Kontrollen ab: Testprotokolle im Einklang mit MITRE ATLAS, Lieferketten-Integritätsprüfungen, die Transparenzpflichten erfüllen, Monitoring-Systeme zur Erzeugung der geforderten Nachweise und eine Dokumentation, die lückenlos von der regulatorischen Pflicht zur implementierten Kontrolle führt. Organisationen, die dies als reines Abhaken von Checklisten verstehen, werden feststellen, dass die Durchsetzungsmechanismen des Gesetzes darauf ausgelegt sind, Governance-Papiere zu durchleuchten und die tatsächliche technische Umsetzung zu prüfen.
Wie erlangen wir Transparenz über Schatten-KI-Nutzung in unserem Unternehmen?
Schatten-KI ist derzeit das größte operative KI-Risiko. Untersuchungen zeigen, dass 69 % der Unternehmen vermuten, dass Mitarbeiter nicht genehmigte GenAI-Tools nutzen, und im Durchschnitt verzeichnet ein Unternehmen 223 Vorfälle pro Monat, bei denen sensible Daten an KI-Anwendungen gesendet werden. Datenschutzverletzungen durch Schatten-KI kosten im Schnitt $4,63 Millionen – deutlich mehr als herkömmliche Sicherheitsvorfälle. Das Verbot von KI-Tools funktioniert nicht; Studien belegen immer wieder, dass Mitarbeiter Verbote umgehen. Der „Sunlight AI“-Ansatz des SANS Institute weist den richtigen Weg: Schattennutzung sichtbar machen, statt sie zu untersagen. Technisch bedeutet dies: Erkennung auf Netzwerkebene für KI-API-Traffic, Aufbau eines Katalogs genehmigter Tools mit angemessenen Datenklassifizierungskontrollen, Implementierung von DLP-Regeln (Data Loss Prevention) speziell für KI-Service-Endpunkte und Schaffung von Richtlinien, die Mitarbeitern einen offiziellen Pfad zur KI-Nutzung eröffnen. Wir errichten die technische Überwachungsschicht und integrieren sie in Ihren bestehenden SIEM/SOAR-Stack, sodass die KI-Nutzung in denselben Dashboards erscheint, die Ihr SOC ohnehin überwacht.
Wie sichern wir agentische KI-Systeme ab, bei denen Agenten Tools aufrufen und autonome Entscheidungen treffen?
Agentische KI bringt Sicherheitsprobleme mit sich, die bei Ein-Modell-Implementierungen nicht existieren. Kontrollierte Tests zeigen Angriffs-Erfolgsquoten von 84 % bei Multi-Agenten-Systemen gegenüber rund 50 % bei Einzelagenten-Architekturen. Das Kernproblem ist die Vertrauensweitergabe (Trust Propagation): Wenn Agent A der Ausgabe von Agent B vertraut und diese für Tool-Aufrufe nutzt, breitet sich eine Kompromittierung von Agent B (beispielsweise durch indirekte Prompt Injection in einem abgerufenen Dokument) kaskadierend über das gesamte Agentennetzwerk aus. MITRE ATLAS v5.4.0 katalogisiert mittlerweile agentenspezifische Techniken wie das Bereitstellen vergifteter Tools und Host-Escapes. Die architektonische Verteidigung erfordert explizite Vertrauensgrenzen zwischen Agenten, Least-Privilege-Berechtigungen an jeder Tool-Calling-Schnittstelle (ein Agent mit Lesebedarf darf niemals Schreibrechte besitzen), Eingabebereinigung an jeder Schnittstelle zwischen Agenten sowie Human-in-the-Loop-Prüfpunkte für Operationen mit realen Konsequenzen. Wir entwerfen diese Vertrauensarchitekturen für spezifische agentische Implementierungen, denn die richtige Platzierung der Grenzen hängt davon ab, welche Aufgaben ein Agent ausführt, welche Tools er aufrufen darf und welche Daten er verarbeitet.
Sollten wir MITRE ATLAS oder OWASP LLM Top 10 als Framework für KI-Sicherheit verwenden?
Verwenden Sie beides. Sie dienen unterschiedlichen Zwecken und ergänzen sich gegenseitig. Die OWASP LLM Top 10 v2.0 (Ausgabe 2025) ist eine priorisierte Risikoliste für LLM-Anwendungen: Prompt Injection, Offenlegung sensibler Informationen, Schwachstellen in der Lieferkette, übermäßige Handlungsmacht (Excessive Agency), System-Prompt-Leaks sowie Schwachstellen bei Vektoren und Embeddings. Sie zeigt auf, worüber Sie sich zuerst Gedanken machen müssen. MITRE ATLAS ist eine gegnerische Bedrohungstaxonomie mit 16 Taktiken, 84 Techniken und 56 Subtechniken, die beschreibt, wie Angreifer ML-Systeme tatsächlich kompromittieren. ATLAS bildet Angriffsketten ab; OWASP priorisiert Risiken. In der Praxis nutzen wir OWASP, um den Umfang eines Assessments festzulegen, und MITRE ATLAS, um die Tests für jeden Risikobereich zu strukturieren. Für Organisationen, die ein KI-Sicherheitsprogramm aufbauen, bietet NIST AI 600-1 (das Profil für generative KI des AI RMF) den Governance-Rahmen, der beide Frameworks mit dem Risikomanagement der Organisation verbindet. Alle drei zusammen liefern Ihnen Risikopriorisierung (OWASP), Methodik zur Angriffssimulation (ATLAS) und Governance-Struktur (NIST).
Entwickeln Sie Ihre KI mit Zuversicht.
Arbeiten Sie mit einem Team zusammen, das über umfassende Erfahrung im Aufbau der nächsten Generation von Unternehmens-KI verfügt. Wir helfen Ihnen, eine KI-Strategie zu entwerfen, zu entwickeln und einzuführen, der Sie vertrauen können.
Veriprajna Deep-Tech-Beratung ist auf die Entwicklung sicherheitskritischer KI-Systeme für die Bereiche Gesundheitswesen, Finanzen und Regulierung spezialisiert. Unsere Architekturen werden anhand etablierter Protokolle validiert und mit umfassender Compliance-Dokumentation belegt.