Wissensgraphen & Domänenontologie-Engineering
Produktive Wissensgraphen und formale Domänenontologien, die KI-Systeme in verifiziertem, abfragbarem Unternehmenswissen mit lückenlosem Herkunftsnachweis verankern.
Ihre KI kann nicht über das nachdenken, was sie nicht kennt
Die Vektorsuche findet Dinge, die ähnlich klingen. Wissensgraphen finden Dinge, die wahr sind. Dieser Unterschied ist der Unterschied zwischen einem KI-System, das rät, und einem, das schlussfolgert.
Klinische Benchmarks machen dies greifbar: In ontologiestrukturierten Wissensgraphen verankerte LLMs reduzierten die Halluzinationsraten von 63 % auf 1,7 %, während rein vektorbasiertes Retrieval bei komplexen Wissensaufgaben bei etwa 70 % Genauigkeit stagniert, verglichen mit 85 %+ bei hybriden Ansätzen aus Vektor plus Graph (siehe unsere Forschung zu fundierter KI im Gesundheitswesen).
Die meisten Teams, die sich an Wissensgraphen versuchen, landen bei etwas ganz anderem: einem beschrifteten Property-Graphen in Neo4j ohne formale Semantik, ohne Inferenzfähigkeit und ohne Herkunftsnachverfolgung. Das ist eine Datenbank, kein Wissensgraph. Sie funktioniert, bis Sie Fragen beantworten müssen, die die Schema-Designer nicht vorhergesehen haben, eine KI-Ausgabe auf ihre Quellfakten zurückverfolgen möchten oder Ihr Domänenmodell weiterentwickeln müssen, ohne jeden nachgelagerten Verbraucher zu beeinträchtigen.
Unser Ansatz besteht darin, das Echte zu bauen: formale Ontologien mit Inferenz, produktive Graph-Infrastruktur mit Herkunftsnachweis auf Tripel-Ebene und Wartungs-Frameworks, die darauf ausgelegt sind, das Wissen aktuell zu halten, wenn sich Ihre Domäne unweigerlich ändert.
Property-Graph, RDF-Triple-Store oder beides: Die richtige Architektur wählen
Die Debatte Neo4j gegen RDF verschlingt mehr Entwicklungszyklen als nötig, meist weil die Entscheidung getroffen wird, bevor die Anforderungen verstanden sind.
| Ansatz | Beispiele | Stärken | Kompromisse & beste Eignung |
|---|---|---|---|
| Property-Graphen | Neo4j, Neptune, TigerGraph | Traversierungsabfragen – kürzester Pfad, Mustererkennung, Nachbarschaftsexploration; entwicklerfreundlich, performant, gut mit Werkzeugen ausgestattet | Kein formales Schlussfolgern, keine automatisierte Inferenz und keine standardbasierte Interoperabilität. Die richtige Wahl für Empfehlungssysteme, Betrugserkennung oder Netzwerkanalyse |
| RDF-Triple-Stores | Ontotext GraphDB, Stardog, Neptune im SPARQL-Modus | Formale Ontologien (OWL), Constraint-Validierung (SHACL), standardisierte Abfragen (SPARQL) und automatisiertes Schlussfolgern | Büßt bei Traversierungslasten an Abfrageleistung ein und bringt eine steilere Lernkurve mit sich |
| Hybrid | RDF-Store + Property-Graph + Vektor-Embeddings | Kombiniert Schlussfolgern/Compliance, Traversierung und unscharfe Ähnlichkeit in einer einzigen Retrieval-Pipeline | Erfordert eine Synchronisierungsschicht, um die Stores konsistent zu halten |
Der Vorteil von RDF ist das automatisierte Schlussfolgern: Deklarieren Sie, dass jedes Medikament, das mit einem MAO-Hemmer interagiert, für SSRI-Patienten kontraindiziert ist, und der Reasoner leitet jede spezifische Kontraindikation ohne manuelle Aufzählung ab.
Unser Ansatz bevorzugt Hybridsysteme, bei denen die formale Ontologie für Schlussfolgern und Compliance in einem RDF-Store liegt, während ein Property-Graph Traversierungsabfragen übernimmt, wobei eine Synchronisierungsschicht sie konsistent hält. Ergänzen Sie Vektor-Embeddings (TransE, CompGCN oder Graph Neural Networks) für die semantische Ähnlichkeit, und Sie erhalten ein Retrieval-System, das exakte Übereinstimmungen, logische Inferenz und unscharfe Ähnlichkeit in einer Pipeline bewältigt.
Ontologie-Engineering: Der Teil, den alle unterschätzen
Eine Graphdatenbank zu kaufen ist einfach. Die Ontologie zu bauen, die sie nützlich macht, ist der Punkt, an dem Projekte ins Stocken geraten. Eine Domänenontologie ist eine formale Spezifikation dessen, was in Ihrer Domäne existiert, wie Dinge zusammenhängen und welche Einschränkungen diese Beziehungen regeln.
Dies richtig hinzubekommen erfordert zwei Arten von Fachwissen, die selten zusammen auftreten: tiefes Domänenwissen (was ein pharmazeutischer Regulierungsspezialist über IDMP-Substanzklassifikationen weiß) und formale Fähigkeiten zur Wissensrepräsentation (wie man dieses Wissen in OWL 2 DL ausdrückt, ohne Engpässe beim Schlussfolgern zu erzeugen), ausführlich beschrieben in unserem Whitepaper zu neuro-symbolic KI in einer regulierten klinischen Domäne.
Beginnen Sie mit Kompetenzfragen
Unser Ontologie-Engineering-Prozess beginnt mit Kompetenzfragen: den konkreten Abfragen, die der Wissensgraph beantworten können muss. Nicht vage Anforderungen wie „Arzneimittelsicherheitsanalyse unterstützen“, sondern präzise wie „Ermittle anhand der Medikamentenliste eines Patienten und eines neuen Rezepts alle transitiven Kontraindikationen über Interaktionen von Stoffwechselwegen innerhalb von 200 Millisekunden.“ Diese Kompetenzfragen bestimmen jede Modellierungsentscheidung und werden zur Regressionstest-Suite für die Ontologie-Evolution.
Den richtigen Formalismus wählen
Wir wählen den richtigen Formalismus für die jeweilige Aufgabe:
- OWL 2 DL – Domänen, die vollständiges Description-Logic-Schlussfolgern erfordern (Pharmazie, Recht, Regulierung).
- OWL 2 EL – große Ontologien, bei denen eine handhabbare Klassifikation zählt (SNOMED CT hat über 350.000 Konzepte und läuft in EL problemlos).
- SKOS – Taxonomien und kontrollierte Vokabulare, bei denen Sie Hierarchie und Bezeichnungen benötigen, aber keine logische Inferenz.
- SHACL – Constraints für Datenvalidierungsregeln, die neben der Ontologie stehen.
Die meisten Produktivsysteme verwenden mehrere Formalismen in Kombination, und zu wissen, welchen man wo anwendet, ist ein wesentlicher Teil dessen, was ein Engagement liefert.
Entitätsauflösung: Der 3-fache Budgetmultiplikator, mit dem niemand plant
Bevor ein Wissensgraph über Ihre Daten schlussfolgern kann, müssen diese Daten bereinigt, dedupliziert und verknüpft werden. Entitätsauflösung – festzustellen, dass „JPMorgan Chase“, „JP Morgan“, „JPMC“ und „J.P. Morgan Chase & Co.“ dieselbe Entität sind – klingt einfach und ist im Unternehmensmaßstab wirklich schwer.
Die Schwierigkeit vervielfacht sich bei heterogenen Quellen. Wissen aus 10 bis 15 verschiedenen Quellsystemen zusammenzuführen bedeutet, sich mit widersprüchlichen Schemata, unterschiedlichen Kennungskonventionen, schwankender Datenqualität und zeitlichen Inkonsistenzen auseinanderzusetzen (ein System sagt, das Unternehmen sei im Q3 übernommen worden, ein anderes sagt Q4). Teams unterschätzen die Kosten der Entitätsauflösung routinemäßig um das 3- bis 5-Fache.
Wir entwerfen Entitätsauflösungs-Pipelines, die regelbasiertes Matching, erlernte Ähnlichkeitsmodelle und menschliche Überprüfung (Human-in-the-Loop) für Grenzfälle kombinieren. Die Pipeline ist so konzipiert, dass sie einen kanonischen Entitätsgraphen mit Herkunftsverknüpfungen zu jedem Quelldatensatz ausgibt, sodass Sie stets nachvollziehen können, warum zwei Datensätze zusammengeführt oder getrennt gehalten wurden.
Diese Herkunftskette wird entscheidend für die regulatorische Nachverfolgbarkeit unter Rahmenwerken wie dem EU-KI-Gesetz, wo die Artikel 12–13 von Ihnen verlangen, den Verlauf der Daten nachzuweisen, die Hochrisiko-KI-Systeme speisen.
Warum Wissensgraph-Projekte scheitern (und wie man es vermeidet)
Das Fehlermuster der Branche ist gut dokumentiert: 95 % der GenAI-Pilotprojekte in Unternehmen scheitern, und Wissensgraph-Projekte haben ihre eigenen spezifischen Fehlerarten.
- Die POC-Falle. Ein kleiner Proof-of-Concept gelingt mit einem kuratierten Datensatz und einem einfachen Schema, also gibt die Führung grünes Licht für den vollständigen Aufbau. Dann stellt das Team fest, dass reale Daten 10-mal unordentlicher sind, die Ontologie 50-mal mehr Konzepte benötigt und die Abfragemuster, für die sie optimiert haben, nur 30 % der tatsächlichen Anwendungsfälle abdecken. Unser Ansatz dimensioniert Engagements von Tag eins an rund um Produktivdatenstichproben und reale Abfragelasten.
- Über-Axiomatisierung. Ontologie-Ingenieure mit akademischem Hintergrund fügen jedes mögliche Axiom und jede mögliche Einschränkung hinzu, und der Reasoner verlangsamt sich bei bescheidenen Wissensbasen von Sekunden auf Stunden. Wir profilieren die Reasoner-Leistung früh und kontinuierlich und wenden das Prinzip der minimalen Axiomatisierung an: Constraints nur hinzufügen, wenn sie einer bestimmten Kompetenzfrage dienen.
- Ontologie-Drift. Der Wissensgraph geht in Betrieb, funktioniert gut, verschlechtert sich dann aber langsam, während sich die Domäne weiterentwickelt – SNOMED CT veröffentlicht vierteljährliche Updates, regulatorische Taxonomien verschieben sich, neue Produktkategorien entstehen, und niemand ist für die Wartung zuständig. Ein Engagement ist so dimensioniert, dass es Ontologie-Wartungs-Frameworks mit Änderungserkennung, Auswirkungsanalyse und Regressionstests hervorbringt, wobei jedes neue Konzept und jede neue Beziehung vor der Bereitstellung gegen die vollständige Kompetenzfragen-Suite validiert wird.
- Keine Verantwortung auf Führungsebene. Wissensgraphen sind Infrastruktur – sie ermöglichen nachgelagerte KI-Fähigkeiten, erzeugen aber für sich genommen keine sichtbaren Funktionen. Ohne ein Sponsoring auf Führungsebene, das die Graphqualität mit Geschäftsergebnissen verbindet (weniger Halluzination, schnellere Compliance, bessere Erkennung von Arzneimittelwechselwirkungen), verliert das Projekt im zweiten Jahr die Finanzierung. Wir helfen Teams, den Business Case mit konkreten Kennzahlen aufzubauen, die an ihre spezifischen Anwendungsfälle geknüpft sind.
Wissensgraphen mit LLMs, RAG und agentic AI verbinden
Microsofts GraphRAG (und seine kostenreduzierte Variante LazyGraphRAG, die die Extraktionskosten auf 0,1 % des ursprünglichen Werts senkt) hat gezeigt, dass graphstrukturiertes Retrieval bei komplexen Multi-Hop-Abfragen besser abschneidet als rein vektorbasiertes. Aber produktives GraphRAG ist schwieriger, als die Paper vermuten lassen: Community-Detection erzeugt Retrieval-Artefakte, Extraktions-Pipelines brauchen domänenspezifisches Tuning, und es gibt keine integrierte Herkunftsnachverfolgung.
Wir entwerfen KG-gestütztes Retrieval, bei dem jeder abgerufene Fakt sein Quelltripel, seinen Konfidenzwert und seine zeitliche Gültigkeit mitführt. Wenn das LLM eine Aussage generiert, verifiziert das System sie gegen den Graphen und zitiert die konkreten Tripel, die sie stützen oder ihr widersprechen (siehe eine funktionierende Demo der Zitationsverifizierung gegen den Graphen). Bei Vektor-RAG ist „das Modell hat eine ähnliche Passage gefunden“ die stärkste Attribution, die Sie erhalten.
Wissensgraphen als agentenzugängliche Werkzeuge
Für agentic-AI-Architekturen dienen Wissensgraphen als werkzeugzugängliche Wissensquellen. Neo4j hat im April 2026 eine Wissensschicht für agentische Systeme auf Google Cloud eingeführt, und die Verbreitung des Model Context Protocol (MCP) beschleunigt sich als Konnektorstandard zwischen Agenten und Wissen.
Unser Ansatz besteht darin, Wissensgraphen zu bauen, die von Tag eins an agenten-abfragbar sind: SPARQL-Endpunkte, strukturierte APIs oder MCP-kompatible Schnittstellen, die es KI-Agenten ermöglichen, auf Domänenwissen als Werkzeugaufruf statt als Prompt-Injektion zuzugreifen – ein Ansatz, der ausführlich beschrieben ist in unserer Forschung zur Haftungs-Firewall für Unternehmens-KI-Agenten.
Was wir liefern
Jedes Engagement ist auf Ihre Domäne, Ihre Datenlandschaft und Ihre nachgelagerten KI-Anforderungen zugeschnitten. Zu den Lieferergebnissen gehören:
- Eine formale Domänenontologie (OWL, vollständig annotiert), validiert durch automatisierte Reasoner.
- Der befüllte Wissensgraph mit Ingestion-Pipelines für strukturierte und unstrukturierte Quellen.
- Entitätsauflösungs-Services mit vollständigem Herkunftsnachweis.
- SHACL-Constraint-Definitionen für die Datenvalidierung.
- Eine Kompetenzfragen-Testsuite (SPARQL- oder Cypher-Muster) als Regressionstests für die Ontologie-Evolution.
- Integrationsschnittstellen für RAG, LLM-Grounding oder Werkzeugzugriff durch agentic AI.
- Ein Ontologie-Wartungs-Framework mit Änderungserkennung und versionierter Bereitstellung.
Wir liefern außerdem eine ehrliche Einschätzung, wo Ihnen ein einfacherer Ansatz ebenso gut dienen würde.
Zentrale Erkenntnisse
- Die Vektorsuche ruft Passagen ab, die ähnlich klingen; Wissensgraphen liefern strukturell verifizierte, herkunftsnachverfolgte Fakten – und senken die Halluzination in klinischen Benchmarks von 63 % auf 1,7 %.
- Wählen Sie Property-Graphen für die Traversierung (Empfehlung, Betrug, Netzwerkanalyse), RDF-Triple-Stores für formales Schlussfolgern und Compliance und hybride Architekturen, wenn Sie beides plus Vektorähnlichkeit benötigen.
- Ontologie-Engineering – nicht die Datenbanklizenz – ist der Punkt, an dem Projekte ins Stocken geraten; Kompetenzfragen bestimmen jede Modellierungsentscheidung und Formalismuswahl (OWL 2 DL, OWL 2 EL, SKOS, SHACL).
- Die Entitätsauflösung überschreitet das Budget routinemäßig um das 3- bis 5-Fache und ist der Kostenpunkt, den die meisten Teams übersehen.
- Die vier Fehlerarten – POC-Falle, Über-Axiomatisierung, Ontologie-Drift und fehlende Verantwortung auf Führungsebene – sind vermeidbar durch Dimensionierung anhand von Produktivdaten, kontinuierliches Reasoner-Profiling, Wartungs-Frameworks und einen messbaren Business Case.
Wissensgraphen & Domänenontologie-Engineering
 Ansehen
KI-Vertriebsintelligenz & verifizierte Ansprache | Veriprajna
KI-Tools für Outbound versenden mehr E-Mails. Sie halluzinieren aber auch Details zu Interessenten, lösen Spamfilter aus und schaffen rechtliche Risiken. Signalpersonalisierte Ansprache konvertiert 5-mal besser als generische Massensendungen – aber nur, wenn jede Aussage gegen Quelldaten verifiziert wird.
 Ansehen
KI für die Rekrutierung klinischer Studien | Veriprajna
80 % der klinischen Studien verfehlen ihre Rekrutierungsfristen. Der Engpass liegt nicht am Patientenangebot. Es ist die Präzision des Abgleichs.
 Ansehen
Haftung & Guardrails für Unternehmens-KI | Veriprajna
Im Dezember 2023 erklärte sich ein Chatbot bereit, einen 76.000-Dollar-Chevy-Tahoe für 1 Dollar zu verkaufen. Im Januar 2024 verfasste ein Liefer-Chatbot ein Gedicht, das sein eigenes Unternehmen als nutzlos bezeichnete. Im Februar 2024 erfand ein Trauerfall-Chatbot ein Erstattungsfenster, das es gar nicht gab, und ein Tribunal erklärte die Fluggesellschaft für haftbar.
 Ansehen
Sicherheit klinischer KI für Gesundheitssysteme | Veriprajna
Ambient-Scribes, die klinische Notizen entwerfen. Patientenportal-KI, die im Namen Ihrer Ärztinnen und Ärzte Nachrichten versendet. Sepsis-Modelle, die Alarme auslösen.
 Ansehen
Legacy-COBOL-Modernisierung mit Knowledge-Graph-Intelligenz | Veriprajna
70–80 % der Mainframe-Modernisierungsprojekte scheitern. Nicht weil die Technologie falsch ist, sondern weil die Werkzeuge Code als Text statt als Topologie behandeln. Wir erstellen die Karte Ihrer Codebasis, bevor wir eine einzige Zeile anfassen, damit Ihre Migration dort gelingt, wo andere Millionen verbrannt und nichts geliefert haben.
 Ansehen
Zitatverifizierung & Governance für juristische KI | Veriprajna
Westlaw Precision halluzinierte in begutachteten Tests bei 33 % der komplexen Anfragen. Lexis+ AI bei 17 %. Sanktionen haben pro Vorfall 30.000 $ überschritten.
 Ansehen
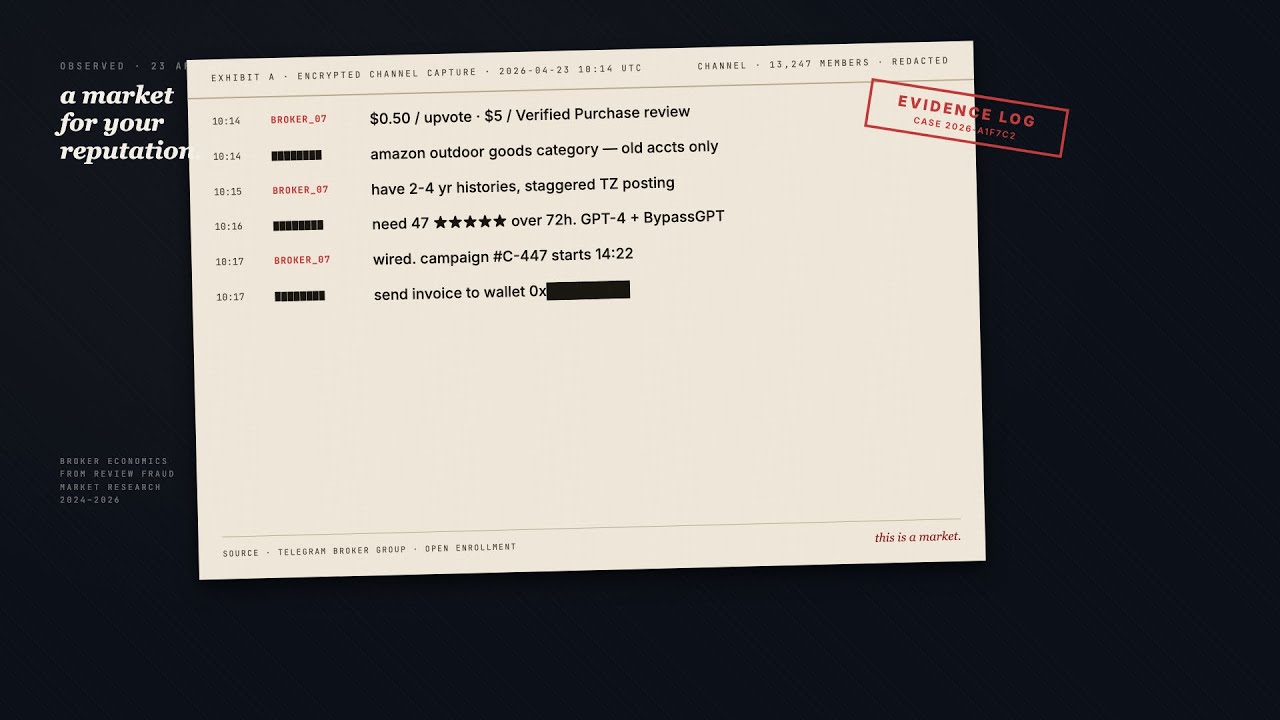
Synthetische Inhalte & Erkennung gefälschter Bewertungen | Veriprajna
Maßgeschneiderte KI-Systeme, die gefälschte Bewertungen, synthetische Inhalte und koordinierten Betrug auf jeder Plattform erkennen, auf der Ihre Marke erscheint. Entwickelt für die neue Durchsetzungsrealität der FTC.
Häufig gestellte Fragen
Wie viel kostet es, einen unternehmensweiten Wissensgraphen zu bauen und zu warten?
Vollständige unternehmensweite Wissensgraph-Implementierungen kosten über ihre gesamte Lebensdauer typischerweise 10–20 Mio. $, angetrieben in erster Linie durch ein Kernteam aus 5–15 Spezialisten. Der größte Kostenpunkt ist nicht die Lizenz der Graphdatenbank; es sind das Ontologie-Engineering, die Entitätsauflösung und die laufende Wartung. Eine von Stardog in Auftrag gegebene ROI-Studie ermittelte 320 % Rendite und 9,86 Mio. $ an Vorteilen über drei Jahre für eine gut umgesetzte Unternehmensbereitstellung. Wir dimensionieren Engagements so, dass zuerst der wertvollste Teilgraph geliefert wird, mit einem klaren Ausbaupfad, sodass Sie nicht 10 Mio. $ im Voraus binden müssen. Der entscheidende Budgetfaktor, den die meisten Teams übersehen, ist die Entitätsauflösung, die routinemäßig das 3- bis 5-Fache der ursprünglichen Schätzungen überschreitet, weil die Qualität der Quelldaten immer schlechter ist als angenommen.
Sollte ich für meinen Wissensgraphen einen Property-Graphen (Neo4j) oder einen RDF-Triple-Store verwenden?
Es hängt davon ab, ob Sie formales Schlussfolgern benötigen. Property-Graphen (Neo4j, TigerGraph) glänzen bei Traversierungsabfragen, Mustererkennung und Graphanalyse. Sie sind entwicklerfreundlich und performant. Aber sie unterstützen kein OWL-Schlussfolgern, keine automatisierte Inferenz und keine standardbasierte Interoperabilität. RDF-Triple-Stores (Ontotext GraphDB, Stardog, Amazon Neptune im SPARQL-Modus) unterstützen formale Ontologien, SHACL-Constraint-Validierung und SPARQL-Abfragen und versetzen das System in die Lage, Fakten abzuleiten, die Sie nie explizit angegeben haben. Wenn Ihr Anwendungsfall regulatorische Nachverfolgbarkeit, organisationsübergreifende Interoperabilität (wie FDA IDMP) oder logische Inferenz über Domänenregeln erfordert, benötigen Sie RDF. Für Empfehlungssysteme oder Betrugserkennung sind Property-Graphen die richtige Wahl. Viele Produktivsysteme verwenden beides, wobei eine Synchronisierungsschicht sie konsistent hält.
Wie reduzieren Wissensgraphen LLM-Halluzinationen im Vergleich zu rein vektorbasiertem RAG?
Die Vektorsuche findet Passagen, die der Abfrage semantisch ähnlich klingen. Wissensgraphen liefern Fakten, die strukturell verifiziert und herkunftsnachverfolgt sind. Klinische Benchmarks zeigten, dass ontologiegestützte Wissensgraphen die LLM-Halluzination von 63 % auf 1,7 % reduzierten. Hybrides Retrieval aus Vektor plus Graph erreicht bei komplexen Wissensaufgaben eine Genauigkeit von 85 %+ gegenüber 70 % bei rein vektorbasierten Ansätzen. Der entscheidende Unterschied ist die Attribution: Mit einem Wissensgraphen lässt sich jede Aussage auf konkrete Quelltripel mit Konfidenzwerten und zeitlicher Gültigkeit zurückführen. Bei Vektor-RAG ist das Beste, was Sie erhalten, „das Modell hat eine ähnliche Passage gefunden.“ Für regulierte Branchen, in denen Sie erklären müssen, warum die KI etwas gesagt hat, ist dieser Unterschied der Unterschied zwischen konform und nicht konform.
Was ist der Unterschied zwischen GraphRAG und traditionellem Wissensgraph-Abfragen?
Traditionelles KG-Abfragen verwendet SPARQL oder Cypher, um exakte, strukturierte Antworten auf klar definierte Abfragen zu liefern. GraphRAG (Microsofts Open-Source-Ansatz und seine Varianten) nutzt LLMs, um Entitäten und Beziehungen aus unstrukturiertem Text in einen Graphen zu extrahieren, und führt dann Community-Detection durch, um hierarchische Zusammenfassungen für das Retrieval zu erstellen. GraphRAG bewältigt explorative Multi-Hop-Abfragen besser als traditionelles Abfragen, hat aber produktive Einschränkungen: Community-Detection erzeugt Retrieval-Artefakte, Extraktions-Pipelines brauchen domänenspezifisches Tuning, und es gibt keine integrierte Herkunftsnachverfolgung. LazyGraphRAG (Juni 2025) senkte die Extraktionskosten auf 0,1 % des ursprünglichen Werts und machte es in größerem Maßstab tragfähig. Wir bauen Systeme, die beides kombinieren: formales, ontologiegetriebenes Abfragen für präzise, herkunftsnachverfolgte Antworten und GraphRAG-artiges Retrieval für explorative Fragen.
Warum scheitern unternehmensweite Wissensgraph-Projekte?
Vier spezifische Fehlerarten sind für die meisten Todesfälle von KG-Projekten verantwortlich. Erstens die POC-Falle: Ein kleiner Proof-of-Concept gelingt mit kuratierten Daten, dann offenbart der vollständige Aufbau, dass reale Daten 10-mal unordentlicher sind und die Ontologie 50-mal mehr Konzepte benötigt. Zweitens die Über-Axiomatisierung: Ontologie-Ingenieure fügen jede mögliche formale Einschränkung hinzu, und der Reasoner verlangsamt sich von Sekunden auf Stunden. Drittens die Ontologie-Drift: Der Graph geht erfolgreich in Betrieb, verschlechtert sich aber, während sich Taxonomien aktualisieren, Regulierungen verschieben und neue Domänenkonzepte entstehen, ohne dass jemand für die Wartung zuständig ist. Viertens keine Verantwortung auf Führungsebene, die die Graphqualität mit Geschäftsergebnissen verbindet, was im zweiten Jahr zu Projekten ohne Finanzierung führt. Wir begegnen allen vieren, indem wir von Tag eins an anhand von Produktivdaten dimensionieren, die Reasoner-Leistung kontinuierlich profilieren, Ontologie-Wartungs-Frameworks liefern und Teams helfen, messbare Business Cases aufzubauen.
Wie unterstützen Wissensgraphen die Nachverfolgbarkeitsanforderungen des EU-KI-Gesetzes?
Die Artikel 12–13 des EU-KI-Gesetzes (vollständige Anwendung ab August 2026) verlangen von Hochrisiko-KI-Systemen, Nachverfolgbarkeitsprotokolle zu führen, die die Herkunft der Daten und die Begründung hinter den Ausgaben nachweisen. Wissensgraphen mit Herkunftsnachverfolgung auf Tripel-Ebene erfüllen diese Anforderung unmittelbar: Jeder Fakt trägt Metadaten über seine Quelle, Extraktionsmethode, seinen Konfidenzwert und seine zeitliche Gültigkeit. TraceGov.ai erreichte mit graphbasiertem Schlussfolgern eine Genauigkeit von 74 % bei der Beantwortung von EU-Regulierungsfragen, eine Verbesserung von 93 % gegenüber rein vektorbasiertem Retrieval. Wenn ein Prüfer fragt „Warum hat die KI diese Empfehlung ausgesprochen“, liefert ein herkunftsnachverfolgter Wissensgraph eine vollständige Kette von der Ausgabe zurück zu den Quellfakten, was eine Vektorähnlichkeitssuche grundsätzlich nicht leisten kann.
Wie passen Wissensgraphen in agentic-AI-Architekturen?
Agentic-AI-Systeme benötigen strukturiertes, abfragbares Domänenwissen, um ihre Werkzeugnutzungsentscheidungen zu fundieren. Wissensgraphen dienen als agentenzugängliche Wissensquellen, abfragbar über SPARQL-Endpunkte, strukturierte APIs oder Schnittstellen des Model Context Protocol (MCP). Neo4j hat im April 2026 eine Wissensschicht für agentic AI auf Google Cloud eingeführt, und die Verbreitung von MCP beschleunigt sich als Konnektorstandard zwischen Agenten und Wissensquellen. Wir bauen Wissensgraphen, die von Tag eins an agenten-abfragbar sind, sodass Domänenwissen KI-Agenten als Werkzeugaufruf zur Verfügung steht, statt in einen Prompt gestopft zu werden. Das bedeutet, der Agent kann fragen „Welche Medikamente interagieren mit dieser Verbindung über den CYP3A4-Stoffwechsel“ und erhält eine verifizierte, herkunftsnachverfolgte Antwort, statt zu hoffen, dass das LLM sich aus den Trainingsdaten erinnert.
Welche Werkzeuge sollten wir für die Ontologie-Entwicklung verwenden?
Protégé (Open Source, Stanford) ist das Standard-Werkzeug zur Ontologie-Erstellung und eignet sich gut für einzelne Ontologie-Ingenieure und kleine Teams. Es fehlen CI/CD-Integration, Mehrbenutzer-Zusammenarbeit und unternehmensweite Governance. TopBraid EDG bietet unternehmenstaugliches Ontologie-Management mit Versionierung, Zugriffskontrolle und Data Governance, kostet aber über 100.000 $ jährlich und erzeugt eine Anbieterbindung. PoolParty konzentriert sich auf Taxonomie- und Thesaurus-Management mit SKOS, stark bei kontrollierten Vokabularen, aber schwächer beim formalen OWL-Schlussfolgern. Ontotexts Werkzeuge integrieren sich eng mit GraphDB. Wir verwenden typischerweise Protégé zur Ontologie-Erstellung, automatisierte Reasoner (HermiT für OWL 2 DL, ELK für OWL 2 EL) zur Validierung und bauen eigene CI/CD-Pipelines für die Ontologie-Versionierung und -Bereitstellung, statt uns an die Management-Plattform eines einzelnen Anbieters zu binden.
Wann ist ein Wissensgraph überdimensioniert und wann reicht eine relationale Datenbank aus?
Eine relationale Datenbank reicht aus, wenn Ihr Datenmodell stabil ist, Ihre Abfragen vorhersehbar sind und Sie keine Inferenz oder Herkunftsnachverfolgung benötigen. Produktkataloge, Transaktionsdatensätze und Nutzerprofile brauchen selten einen Wissensgraphen. Ein beschrifteter Property-Graph (Neo4j) ist die richtige Wahl, wenn Sie Traversierungsabfragen, Mustererkennung oder Graphanalyse benötigen, aber kein formales Schlussfolgern. Sie benötigen einen vollständigen Wissensgraphen mit formaler Ontologie, wenn: Ihre Domäne komplexe, sich entwickelnde Beziehungen aufweist, die automatisierte Inferenz erfordern; regulatorische Anforderungen eine Herkunftsnachverfolgung von der KI-Ausgabe bis zu den Quelldaten verlangen; Sie organisationsübergreifende Interoperabilität benötigen (wie IDMP in der Pharmabranche); oder Ihr KI-System über Domänenregeln schlussfolgern muss, statt nur ähnlichen Text abzurufen. Wir sagen Ihnen, wenn Ihr Anwendungsfall keinen Wissensgraphen benötigt.
Entwickeln Sie Ihre KI mit Zuversicht.
Arbeiten Sie mit einem Team zusammen, das über umfassende Erfahrung im Aufbau der nächsten Generation von Unternehmens-KI verfügt. Wir helfen Ihnen, eine KI-Strategie zu entwerfen, zu entwickeln und einzuführen, der Sie vertrauen können.
Veriprajna Deep-Tech-Beratung ist auf die Entwicklung sicherheitskritischer KI-Systeme für die Bereiche Gesundheitswesen, Finanzen und Regulierung spezialisiert. Unsere Architekturen werden anhand etablierter Protokolle validiert und mit umfassender Compliance-Dokumentation belegt.