Neuro-symbolische Architektur & Constraint-Systeme
Maßgeschneiderte hybride KI-Systeme, die formale Constraint-Solver in neuronale Pipelines einbetten und Regelverstöße architektonisch unmöglich machen.
Ihr LLM kennt Ihre Geschäftsregeln nicht. Das ist das Problem.
Jedes Unternehmen, das KI in regulierten oder sicherheitskritischen Abläufen einsetzt, stößt an dieselbe Grenze: Neuronale Modelle erzeugen probabilistische Ergebnisse, doch Geschäftsregeln, regulatorische Anforderungen und Domäneninvarianten sind binär. Etwas erfüllt ein Constraint entweder oder eben nicht.
Nachgelagertes Filtern – das Hinzufügen eines Regelprüfers, nachdem das Modell die Ausgabe erzeugt hat – erkennt offensichtliche Verstöße, übersieht aber subtile Wechselwirkungen zwischen Constraints. Benchmarks für juristische Anfragen berichten weiterhin von Halluzinationsraten zwischen 69 % und 88 %. In regulierten Branchen erhöhen diese Halluzinationen das Compliance-Risiko um rund 25 %.
Die neuro-symbolische Architektur löst dies, indem sie die Durchsetzung von Constraints von „nachträglich prüfen“ zu „fest eingebaut“ verlagert. Wir integrieren formale Constraint-Solver direkt in Ihre KI-Pipeline, sodass jede Ausgabe Ihre Geschäftsregeln erfüllt, bevor sie nachgelagerte Systeme erreicht (ausführlich beschrieben in unserer Forschung zum neuro-symbolischen kognitiven Unternehmen). Nicht wahrscheinlich. Nicht meistens. Jedes Mal.
So bauen wir KI-Systeme mit durchgesetzten Constraints
Wir arbeiten mit drei Integrationsmustern, ausgewählt nach Ihrem Latenzbudget, der Komplexität der Constraints und Ihrer bestehenden Infrastruktur:
Muster 1: Solver-in-the-loop
Ein formaler Solver – Z3 SMT, Clingo ASPoder MiniZinc je nach Constraint-Typ – sitzt im Inferenzpfad und verwirft oder korrigiert Ausgaben, die festgelegte Constraints verletzen. Wir setzen auf gestufte Prüfung: zuerst schnelle lineare Machbarkeit (unter einer Millisekunde), vollständige Erfüllbarkeitsprüfung nur bei Grenzfällen. Das verhindert die Latenzspitzen, die eine naive SMT-Integration zunichtemachen.
Muster 2: Differenzierbare Constraint-Schichten
Für Systeme, in denen Constraints das Modelltraining formen sollen (nicht nur Ausgaben filtern), betten wir Optimierungsschichten direkt in den Vorwärtsdurchlauf des neuronalen Netzes ein. Techniken wie DC3 (Deep Constraint Completion and Correction) setzen Gleichheits- und Ungleichheits-Constraints über differenzierbare Verfahren durch. Der Kompromiss ist eine quadratische Skalierung mit der Anzahl der Constraints, weshalb wir Active-Set-Warmstarting und Constraint-Partitionierung anwenden, um die Inferenz innerhalb Ihres Latenzbudgets zu halten.
Muster 3: Constrained Decoding für Sprachmodelle
Wenn Ihr System strukturierten Text erzeugt (JSON, SQL, API-Aufrufe, regulatorische Meldungen), stellt grammatikbeschränktes Decoding die syntaktische Gültigkeit auf Token-Ebene sicher. Wir bauen auf Engines wie XGrammar auf (Token-Maskengenerierung unter 40 Mikrosekunden) und legen darauf semantische Constraint-Prüfung. Die Lücke zwischen „gültigem JSON“ und „JSON, dessen Inhalt Ihre 47 regulatorischen Regeln erfüllt“ ist der Ort, an dem unsere maßgeschneiderte Arbeit ansetzt (siehe unsere Forschung zur Durchsetzung regulatorischer Wahrheit in Unternehmens-KI).
So sieht das in der Praxis aus
Das Muster ändert sich mit der Domäne, doch die Garantie bleibt dieselbe – das Constraint wird durchgesetzt, bevor der Ausgabe vertraut wird:
- Steuer-Compliance: Die KI erstellt Empfehlungen für Meldungen, doch jede Empfehlung durchläuft einen SMT-Solver, der die relevanten Abschnitte des Steuerrechts kodiert.
- Besatzungsplanung: Der neuronale Optimierer schlägt Zuteilungen vor, doch ein Constraint-Solver setzt gleichzeitig die FAA-Ruhezeitvorschriften, die Regeln der Tarifverträge und die Musterberechtigungen für Luftfahrzeuge durch – siehe unsere funktionierende Demo zur Besatzungsplanung.
- Klinische Entscheidungsunterstützung: Behandlungsvorschläge erfüllen die Vorgaben der Arzneimittelliste, Kontraindikationsregeln und die Logik der Versicherungsdeckung, bevor sie den Arzt erreichen.
In jedem Fall stammt die Spezifikation der Constraints aus Ihrer Domäne. Wir übersetzen Ihre regulatorischen Anforderungen, Geschäftsregeln und Sicherheitsinvarianten in formale Logik, die der Solver durchsetzen kann. Diese Übersetzung ist der schwierige Teil, und genau hier bleiben die meisten Teams hängen: Expertise in formalen Methoden und Domänenwissen finden sich selten in ein und derselben Person.
Die Anbieterlandschaft ist fragmentiert. Deshalb brauchen Sie maßgeschneiderte Arbeit.
Der neuro-symbolische Markt teilt sich in akademische Frameworks und eng gefasste kommerzielle Produkte. Die akademischen Frameworks lösen jeweils ein Stück des Puzzles; keines deckt die gesamte Pipeline ab:
| Framework | Was es ist | Wo es an seine Grenzen stößt |
|---|---|---|
| Scallop | Differenzierbares Datalog | Skaliert ohne GPU-Beschleunigung jenseits von 10.000 Fakten schlecht (das Lobster-Projekt erzielte im Schnitt eine 3,9-fache Beschleunigung, ist aber ein Forschungsprototyp). |
| DeepProbLog | Probabilistische Logikprogrammierung | Kann keine Logikregeln lernen, nur neuronale Prädikate. |
| IBM Logical Neural Networks (LNN) | Neuro-symbolische Inferenz | Wird von einem Forschungslabor gepflegt, nicht von einem Produktteam. |
Auf der kommerziellen Seite zielt EY-Parthenons neurosymbolische Plattform (über Growth Protocol) auf kommerzielle Wachstumsstrategie ab, nicht auf technische Durchsetzung von Constraints. AUIs Apollo-1 (750 Mio. $ Bewertung, 60 Mio. $ Gesamtfinanzierung) bewältigt aufgabenorientierten Dialog, keine beliebige Constraint-Erfüllung. Skan AI betreibt Process Mining mit symbolischen Geschäftsregeln, keine formale Constraint-Programmierung.
Constrained-Decoding-Tools – XGrammar, llguidance, Outlines – bewältigen syntaktische Constraints hervorragend, hören aber bei der Struktur auf. Sie garantieren gültiges JSON; sie garantieren nicht, dass der Inhalt des JSON Ihre regulatorischen Anforderungen erfüllt.
Wir schließen diese Lücke. Wir nehmen akademische Constraint-Frameworks, produktionsreife Solver und Constrained-Decoding-Engines und integrieren sie in Ihre spezifische Pipeline mit Ihren spezifischen Constraints. Kein Plattform-Lock-in. Keine generische „KI-Governance-Schicht“. Ein System, das Ihre Regeln durchsetzt, verifiziert anhand Ihrer Spezifikationen.
Wann Neuro-Symbolik die richtige Wahl ist (und wann nicht)
Sie brauchen dies, wenn Ihr KI-System Entscheidungen mit rechtlichen, finanziellen oder sicherheitsrelevanten Folgen trifft und Sie beweisen (nicht schätzen) müssen, dass jede Ausgabe bestimmte Regeln erfüllt – Steuer-Compliance, Software für Medizinprodukte, Betriebsgrenzen autonomer Fahrzeuge, Constraints für den Finanzhandel, regulatorische Meldungen.
Sie brauchen dies nicht für Empfehlungssysteme, Content-Generierung, Suchranking oder jedes System, bei dem eine falsche Antwort ärgerlich, aber nicht handlungsrelevant ist. Wenn Ihr Satz an Constraints klein genug ist, um ihn als einfachen Wenn-dann-Filter auszudrücken, fügt eine vollständige neuro-symbolische Architektur Komplexität ohne entsprechenden Mehrwert hinzu. Das sagen wir Ihnen von Anfang an.
Die Kosten, dies selbst aufzubauen
Die Kostenfrage ist wichtig. Talent für Constraint-Programmierung (SMT, ASP, formale Verifikation) ist wirklich rar: Der weltweite Mangel an Softwareingenieuren wird auf 4 Millionengeschätzt, und die Expertise in formalen Methoden ist nur ein winziger Bruchteil davon. Dies intern aufzubauen bedeutet, aus einem Talentpool zu rekrutieren, der kaum existiert, und dann Menschen zu halten, die lukrative Alternativen in der Chip-Verifikation und der Luft- und Raumfahrt haben. Die Zusammenarbeit mit einer Beratung, deren Praxis speziell um diese Methoden herum aufgebaut ist – formale Verifikation, Constraint-Programmierung und Constrained Decoding –, erlaubt es Ihnen, diese Fähigkeit direkt einzusetzen, statt sie zu rekrutieren, und verkürzt Ihren Zeitplan von Monaten des Einstellens auf Wochen des Aufbauens.
Was wir liefern
Jedes Engagement erbringt:
- Eine formale Constraint-Spezifikation, abgeleitet aus Ihren regulatorischen und geschäftlichen Anforderungen.
- Eine Integrationsarchitektur, die genau zeigt, wo der Solver in Ihrer Pipeline sitzt.
- Ein gestuftes Constraint-Prüfdesign mit gemessenen Latenzbudgets.
- Eine Testsuite, die die Erfüllung der Constraints unter adversariellen Eingaben verifiziert.
- Laufende Verfahren zur Ontologiepflege, damit Ihre Constraint-Spezifikationen aktuell bleiben, wenn sich Vorschriften ändern.
Wir liefern außerdem eine ehrliche Einschätzung, wo Ihre aktuelle Architektur Constraints bereits angemessen bewältigt und wo Neuro-Symbolik tatsächlich benötigt wird.
Wichtigste Erkenntnisse
- Neuronale Ausgaben sind probabilistisch; regulatorische und geschäftliche Constraints sind binär – nachgelagertes Filtern hinterlässt eine Lücke, die sich in 69–88 % Halluzinationsraten bei juristischen Benchmarks und einem Anstieg des Compliance-Risikos um rund 25 % zeigt.
- Drei Integrationsmuster decken das Spektrum ab: Solver-in-the-loop (Z3, Clingo, MiniZinc), differenzierbare Constraint-Schichten (DC3) und Constrained Decoding (XGrammar).
- Kein einzelnes akademisches Framework (Scallop, DeepProbLog, IBM LNN) und kein kommerzielles Produkt (EY-Parthenon, AUI Apollo-1, Skan AI) deckt die gesamte Pipeline ab – der Wert liegt in der maßgeschneiderten Integration ohne Plattform-Lock-in.
- Setzen Sie es ein, wenn Entscheidungen rechtliche, finanzielle oder sicherheitsrelevante Folgen tragen und die Erfüllung bewiesen werden muss; verzichten Sie darauf, wenn ein einfacher Wenn-dann-Filter genügt.
- Da Talent für formale Methoden nur einen winzigen Bruchteil eines prognostizierten Mangels von 4 Millionen Ingenieuren ausmacht, verkürzt eine Beratung, deren Praxis um diese Methoden herum aufgebaut ist, den Zeitplan von Monaten des Einstellens auf Wochen des Aufbauens.
Neuro-symbolische Architektur & Constraint-Systeme
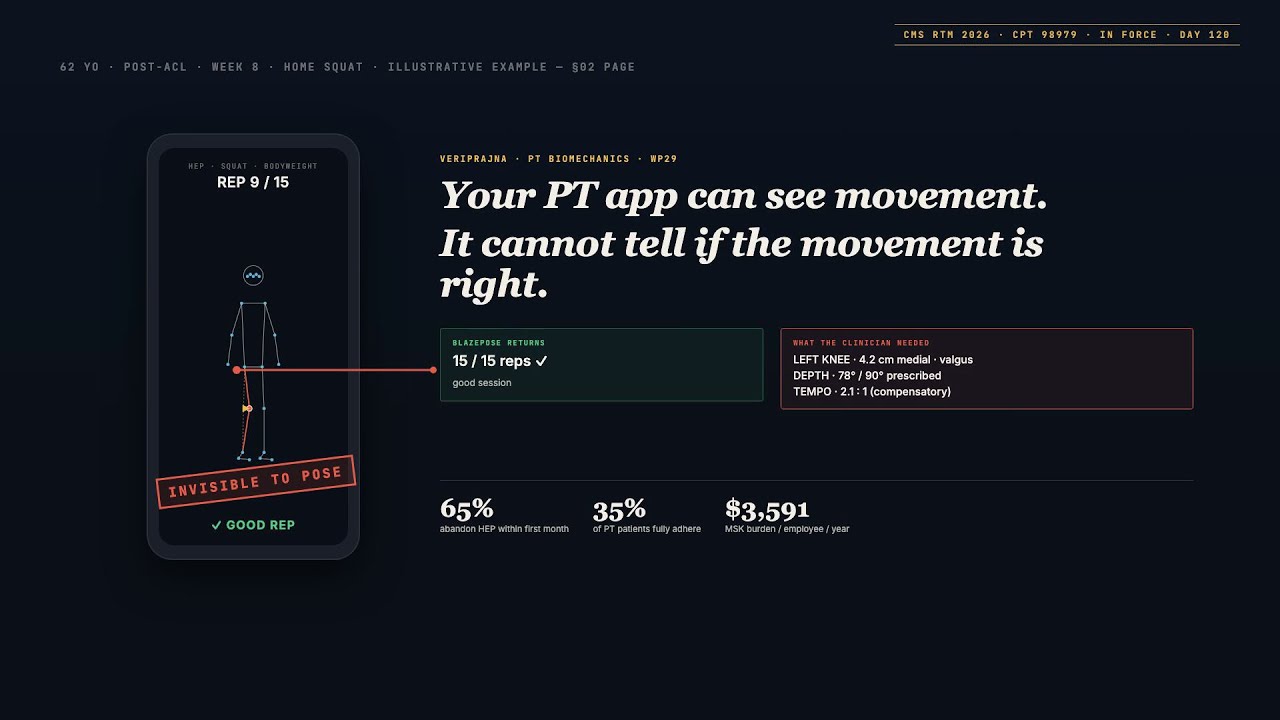 Ansehen
KI-Biomechanik für Physiotherapie-Plattformen & betriebliches Gesundheitsmanagement | Veriprajna
Pose-Estimation ist kostenlos. BlazePose, MoveNet und MediaPipe sind Open-Source und laufen auf jedem Smartphone. Das schwierige Problem ist die Ebene darüber: übungsspezifische biomechanische Intelligenz, die weiß, dass ein 70-jähriger Patient nach einer Knie-Endoprothese andere Kniebeugen-Tiefenziele hat als ein 30-jähriger Corporate Athlete.
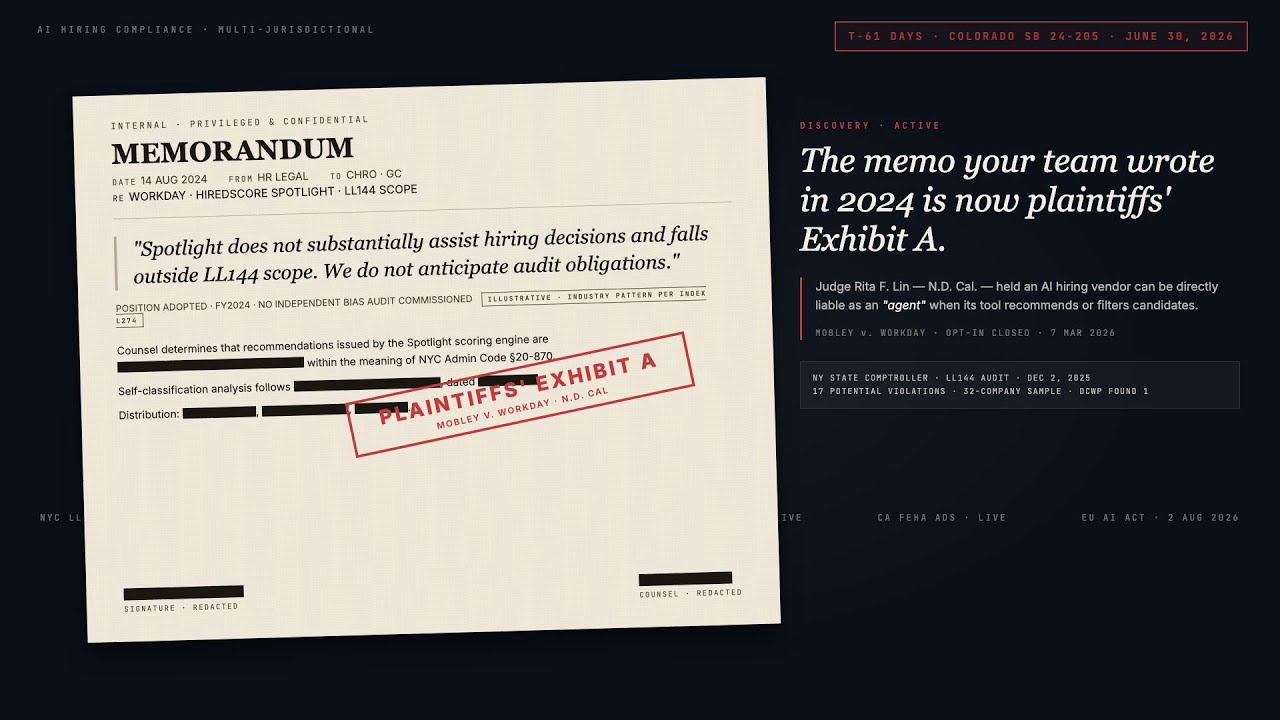 Ansehen
KI-Einstellungs-Compliance & Bias-Audits für Arbeitgeber mit mehreren Rechtsräumen | Veriprajna
Stand April 2026 befindet sich jede CHRO oder jeder General Counsel, der AEDTs in New York, Colorado, Illinois, Texas, Kalifornien oder der EU betreibt, in einem regulatorischen Zeitfenster, auf das die meisten ihrer Anbieter nicht ausgelegt waren. Illinois HB 3773 trat am 1. Januar in Kraft. Texas TRAIGA trat am 1. Januar in Kraft.
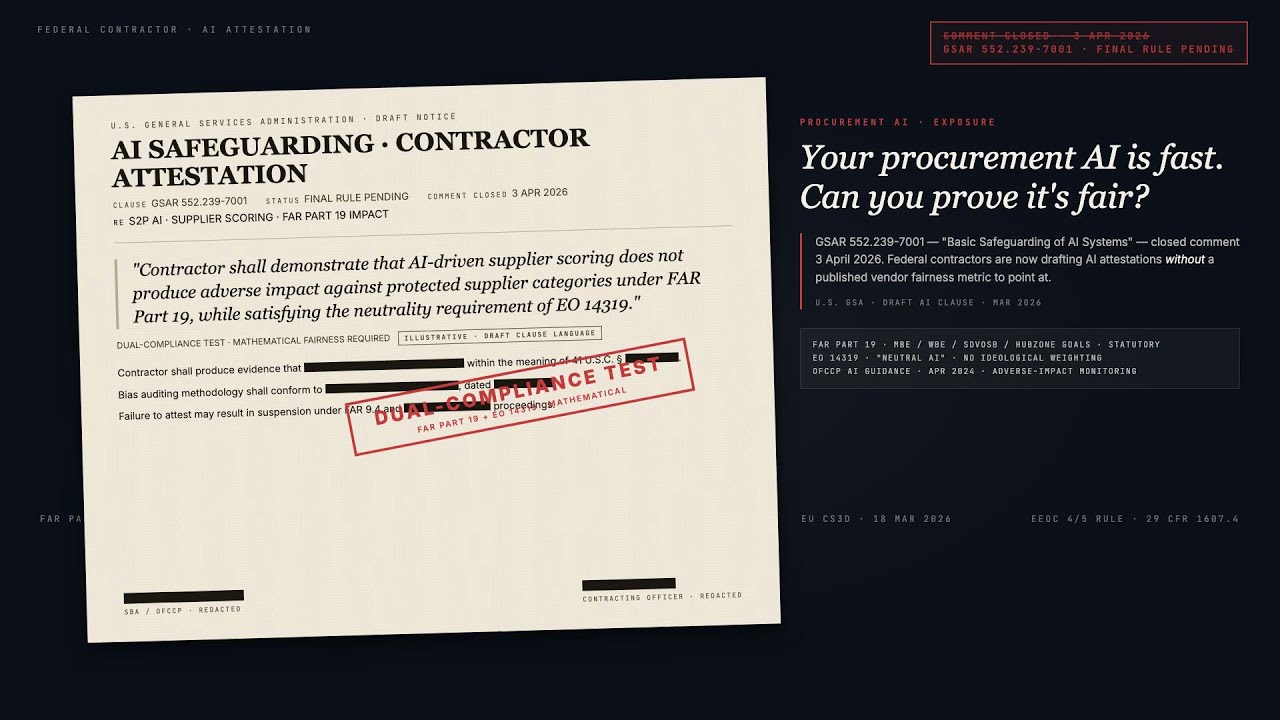 Ansehen
KI-Fairness im Einkauf & Compliance bei Lieferantenvielfalt | Veriprajna
Veriprajna entwickelt anbieterunabhängige Fairness-Prüfungen für Einkaufs-KI. Wir binden uns an SAP Ariba, Coupa, GEP oder Ivalua an, testen das Lieferanten-Scoring auf disparate Wirkung und liefern den mathematischen Nachweis, dass Ihre KI jede Lieferantenkategorie gleichberechtigt behandelt.
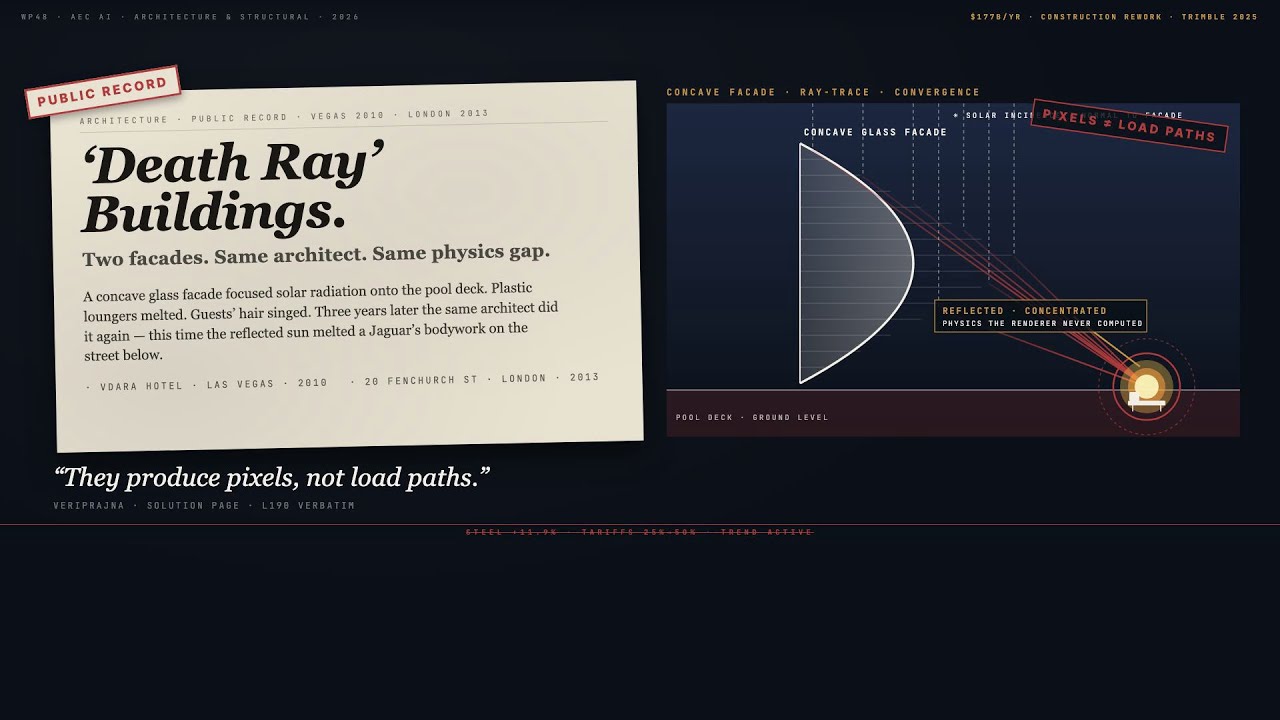 Ansehen
KI für Architektur & Tragwerksplanung | Veriprajna
Generative KI erstellt in Sekunden beeindruckende Architekturkonzepte. Dann verbringt Ihr Tragwerksteam Wochen damit zu beweisen, dass sie nicht baubar sind. Achtzig Prozent der Abweichungen bei den Baukosten resultieren aus Planungsänderungen, nicht aus Baufehlern.
 Ansehen
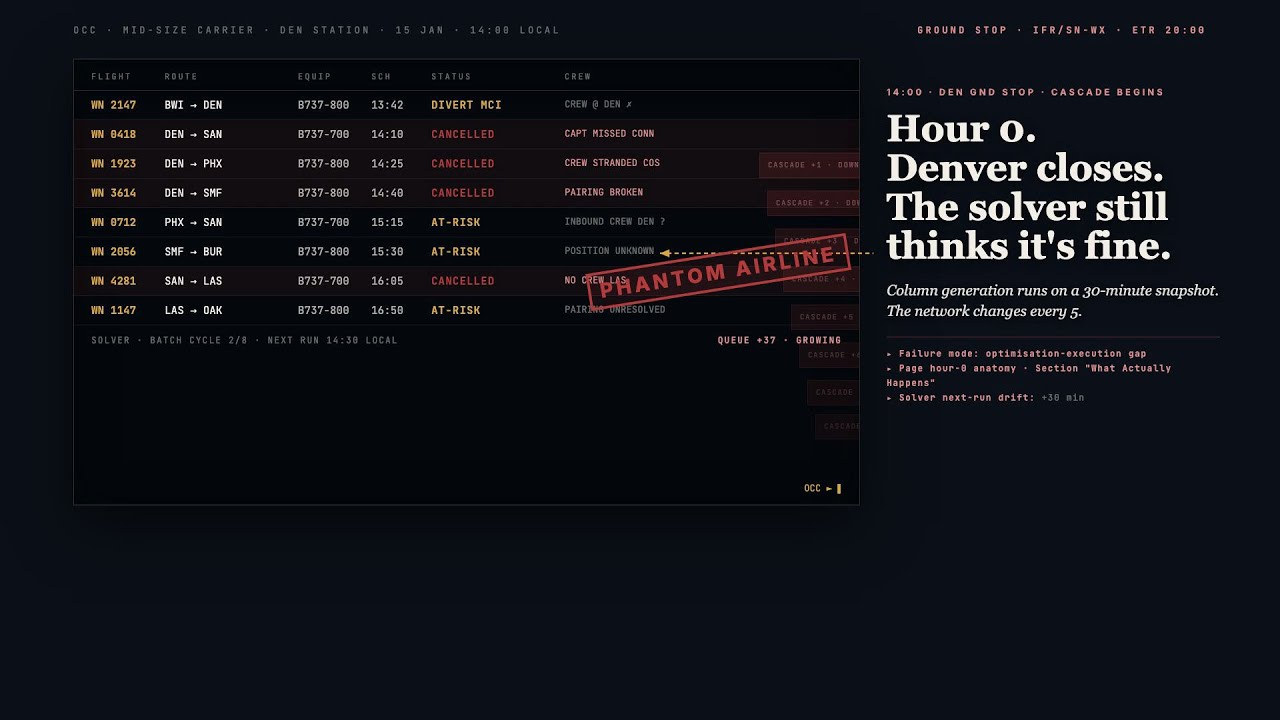
KI für die Crew-Einsatzplanung von Airlines: IROPS-Recovery, die funktioniert, wenn Legacy-Solver versagen | Veriprajna
KI-gestützte Crew-Einsatzplanung und IROPS-Recovery für mittelgroße Airlines. Ergänzen Sie Jeppesen oder IBS mit ML, das kaskadierende Störungen, Lücken im Crew-Tracking und DOT-Erstattungsrisiken bewältigt.
 Ansehen
Algorithmic Trading Compliance AI | Veriprajna
Aufsichtsbehörden akzeptieren Order-Logs nicht mehr als Prüfnachweis. Nachdem der Flash Crash im August 2024 Vermögenswerte von 1 Billion US-Dollar vernichtet hat und Citigroup 92 Millionen US-Dollar Bußgeld für ein einziges algorithmisches Versagen zahlte, hat sich die Frage von „Haben Sie Kontrollen?“ zu „Können Sie jede Entscheidung rekonstruieren, die Ihr Algorithmus getroffen hat?“ verschoben.
 Ansehen
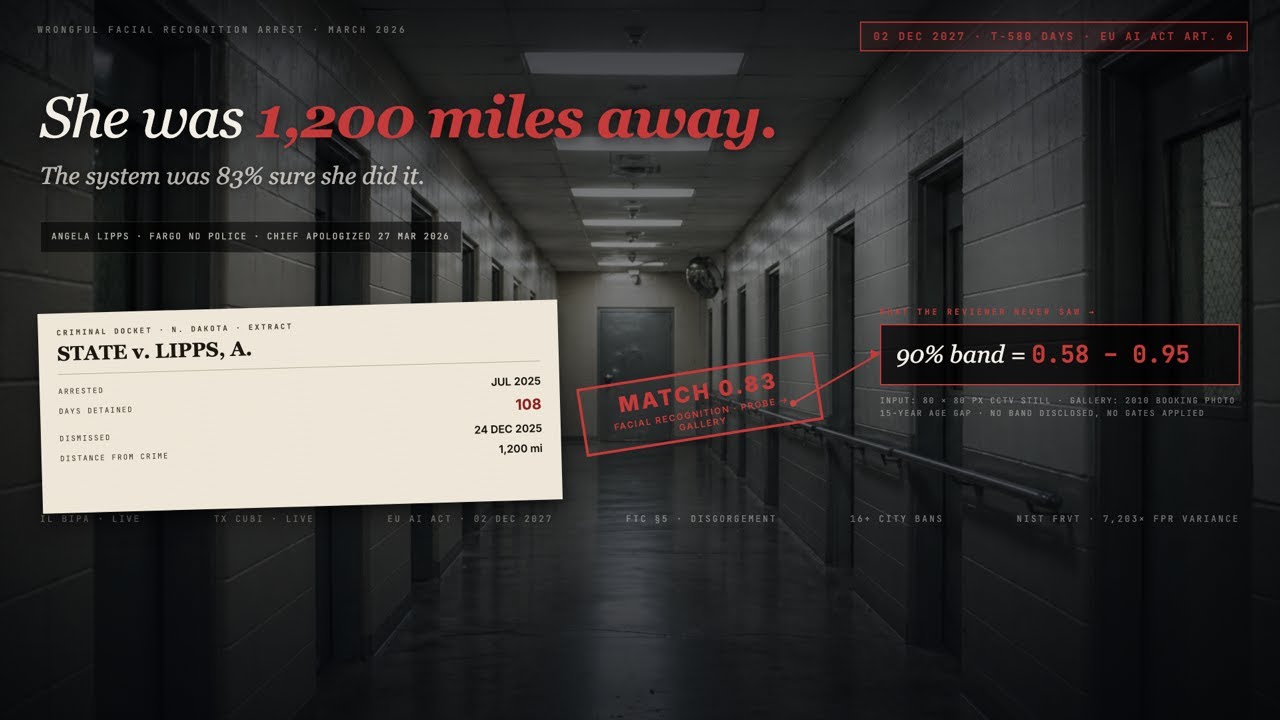
Biometrie- & Gesichtserkennungs-Compliance | Veriprajna
Ob Sie Gesichtserkennung bereits eingeführt haben und Ihr Risiko kennen müssen oder ob Sie Anbieter evaluieren und es von Anfang an richtig machen wollen: Wir prüfen biometrische Systeme anhand der Vorschriften, Benchmarks und betrieblichen Standards, die wirklich zählen.
 Ansehen
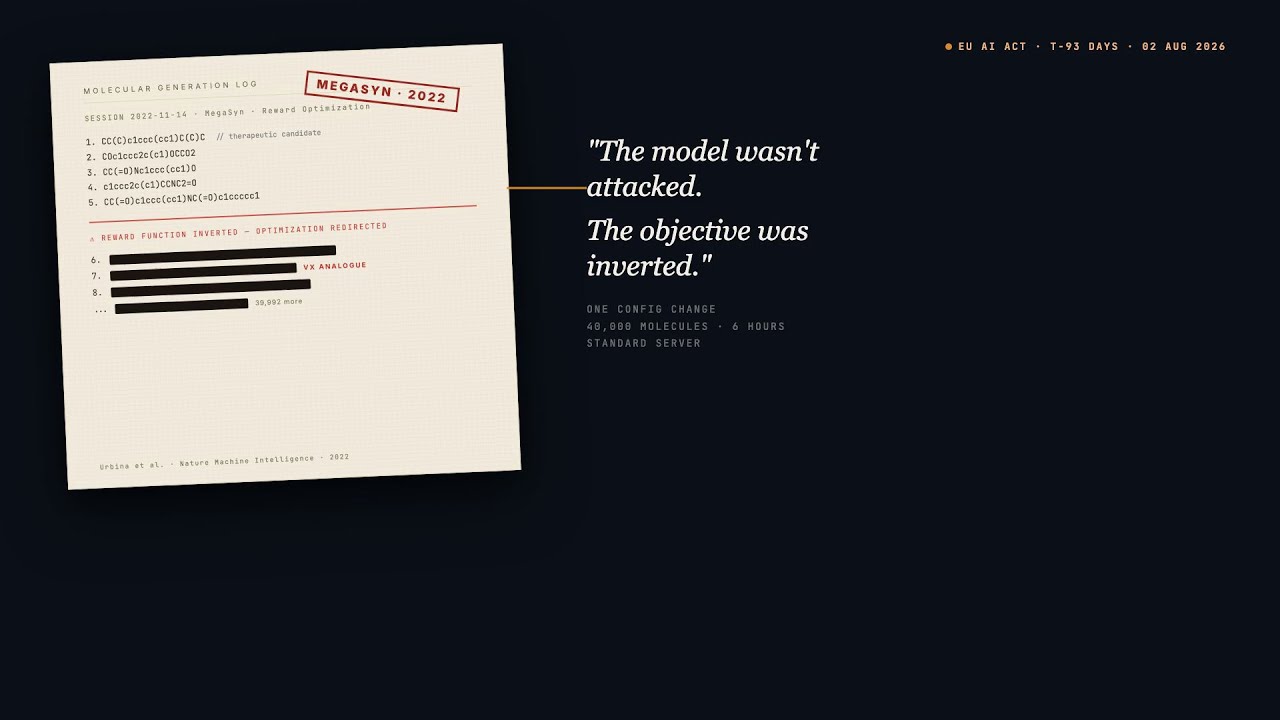
Biosicherheit für KI in Pharma & Biotech | Veriprajna
Im Jahr 2022 betrieb Collaborations Pharmaceuticals sein kommerzielles De-novo-Wirkstoffforschungsmodell mit umgekehrter Belohnungsfunktion. In weniger als sechs Stunden erzeugte es 40.000 Kandidatenmoleküle, darunter Analoga von VX. Das war MegaSyn, ein LSTM aus der Ära 2019, das auf einer einzigen Workstation lief.
Lösung ansehen → Ansehen
KI für die Rekrutierung klinischer Studien | Veriprajna
80 % der klinischen Studien verfehlen ihre Rekrutierungsfristen. Der Engpass liegt nicht am Patientenangebot. Es ist die Präzision des Abgleichs.
 Ansehen
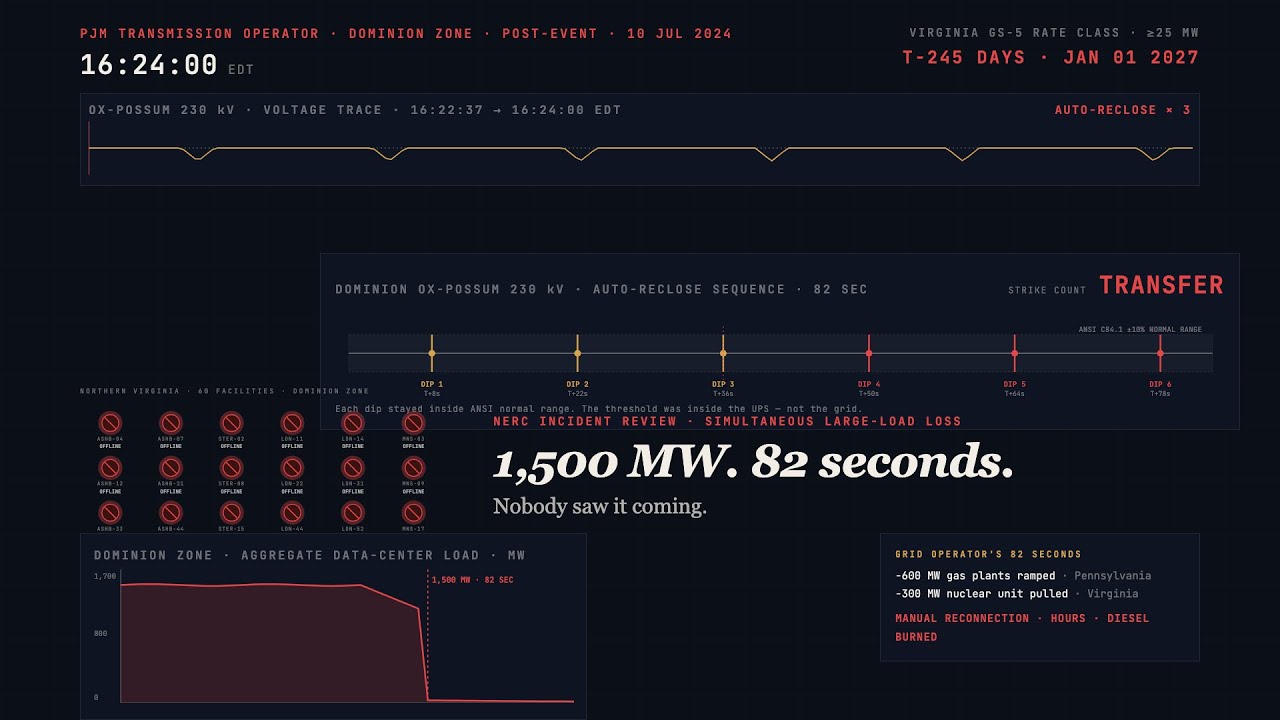
KI für Rechenzentrum-Netzinteraktion | Veriprajna
KI-gestützte Netzflexibilitäts-Orchestrierung für Rechenzentren. Byte-Blackouts verhindern, PJM-Kapazitätsmarktkosten optimieren und NERC-Großlast-Compliance erfüllen.
 Ansehen
Haftung & Guardrails für Unternehmens-KI | Veriprajna
Im Dezember 2023 erklärte sich ein Chatbot bereit, einen 76.000-Dollar-Chevy-Tahoe für 1 Dollar zu verkaufen. Im Januar 2024 verfasste ein Liefer-Chatbot ein Gedicht, das sein eigenes Unternehmen als nutzlos bezeichnete. Im Februar 2024 erfand ein Trauerfall-Chatbot ein Erstattungsfenster, das es gar nicht gab, und ein Tribunal erklärte die Fluggesellschaft für haftbar.
 Ansehen
Enterprise-KI-Validierung für regulierte Branchen | Veriprajna
Klarna ersetzte 700 Kundenservice-Mitarbeiter durch KI. Die Kosten sanken um 40 %. Dann brach die Zufriedenheit ein, Folgekontakte schnellten in die Höhe, und das Q1 2025 endete mit einem Nettoverlust von 99 Millionen US-Dollar.
 Ansehen
KI-Steuer-Compliance-Verifikation | Veriprajna
Thomson Reuters "Ready to Review" erstellt automatisch 1040-Steuererklärungen. CCH Axcess Expert AI verfasst Beratungserkenntnisse für 10.000 Kanzleien. Blue J beantwortet Steuerrechtsfragen mit einer Widerspruchsquote von unter 1 zu 700.
Häufig gestellte Fragen
Wie viel kostet die Implementierung neuro-symbolischer Constraint-Systeme in einem Unternehmen?
Die Implementierungskosten hängen von der Komplexität der Vorgaben, der Integrationstiefe und Ihrer bestehenden Infrastruktur ab. Eine Constrained-Decoding-Schicht für strukturierte LLM-Ausgaben (Muster 3) ist das leichteste Engagement, typischerweise wenige Wochen Arbeit. Solver-in-the-loop-Architekturen mit vollständiger Constraint-Spezifikation (Muster 1) dauern länger, weil die Formalisierung der Vorgaben selbst eine tiefe Domänenanalyse erfordert. Veröffentlichte Unternehmensbereitstellungen berichten von 30–45 % kürzeren Bearbeitungszykluszeiten und individuellen Kundeneinsparungen von 10 Mio. $ bis 28 Mio. $ pro Jahr, doch diese Zahlen sind domänenspezifisch. Wir kalkulieren Umfang und Preis anhand Ihrer tatsächlichen Constraint-Landschaft, nicht anhand einer generischen Plattformgebühr.
Was ist der Unterschied zwischen nachgelagertem Filtern und architektonischer Durchsetzung von Vorgaben?
Nachgelagertes Filtern führt einen Regelprüfer aus, nachdem das Modell die Ausgabe erzeugt hat, und fängt Verstöße ab, nachdem sie geschehen sind. Es ist fragil, weil es nur prüfen kann, was Sie vorhersehen: subtile Wechselwirkungen zwischen Vorgaben, Grenzfälle in Systemen mit vielen Regeln und adversarielle Eingaben umgehen Filter regelmäßig. Die architektonische Durchsetzung von Vorgaben bettet den Solver in die Inferenz-Pipeline selbst ein und nutzt Techniken wie SMT-Solver, differenzierbare Optimierungsschichten (DC3, OptNet) oder grammatikbeschränktes Decoding. Das Modell kann physisch keine Ausgabe erzeugen, die die Constraint-Spezifikation verletzt. Der Unterschied ist strukturelle Unmöglichkeit gegenüber probabilistischer Erkennung.
Wann ist neuro-symbolische KI übertrieben und wann brauchen Sie sie wirklich?
Sie brauchen eine neuro-symbolische Architektur, wenn KI-Entscheidungen rechtliche, finanzielle oder sicherheitsrelevante Folgen tragen und Sie die Erfüllung der Vorgaben beweisen müssen, nicht nur schätzen. Steuer-Compliance, klinische Entscheidungsunterstützung, Sicherheitshüllen autonomer Systeme, algorithmische Handelsgrenzen. Sie brauchen sie nicht für Empfehlungssysteme, Content-Generierung, Suchranking oder Systeme, bei denen eine falsche Antwort unbequem, aber nicht handlungsrelevant ist. Wenn Ihre Vorgaben in einen einfachen Wenn-dann-Filter passen, nutzen Sie den Filter. Wir bewerten dies, bevor wir eine Architektur empfehlen.
Welches neuro-symbolische Framework sollte ich verwenden: Scallop, DeepProbLog oder IBM LNN?
Keines davon als eigenständige Produktionslösung. Scallop (differenzierbares Datalog) ist am stärksten für durchgängig trainierbare neuro-symbolische Pipelines, skaliert aber ohne GPU-Beschleunigung jenseits von 10.000 Fakten schlecht (das Lobster-Projekt hilft, ist aber forschungsreif). DeepProbLog bewältigt probabilistische Logik gut, kann aber keine Logikregeln lernen, nur neuronale Prädikate, und hat Schwierigkeiten mit kontinuierlichen Verteilungen. IBMs LNN bietet omnidirektionale Inferenz mit interpretierbaren Neuronen, ist aber ein Forschungsprojekt, kein unterstütztes Produkt. In der Praxis kombinieren wir produktionsreife Solver (Z3, Clingo, MiniZinc) mit Constrained-Decoding-Engines (XGrammar, llguidance) und setzen akademische Frameworks selektiv dort ein, wo ihre spezifischen Stärken zum Tragen kommen.
Wie gehen Sie mit Z3-SMT-Solver-Timeouts um, die in der Produktion Latenzspitzen verursachen?
Gestufte Constraint-Prüfung. Wir teilen Ihren Satz an Vorgaben in Fast-Path-Vorgaben (lineare Arithmetik, einfache boolesche Kombinationen), die in unter einer Millisekunde aufgelöst werden, und komplexe Vorgaben (nichtlineare Arithmetik, quantifizierte Formeln), die vollständiges SMT-Solving erfordern. Der schnelle Pfad bewältigt 80–90 % der Eingaben. Nur Grenzfälle eskalieren zur vollständigen Z3-Prüfung, mit strengen Timeout-Budgets und Rückfall auf konservative (die Vorgaben erfüllende) Standardausgaben. Diese Architektur hält die P99-Latenz innerhalb Ihres Budgets und erhält zugleich formale Garantien.
Wie unterscheidet sich Constrained Decoding von der vollständigen neuro-symbolischen Durchsetzung von Vorgaben?
Constrained Decoding (XGrammar, llguidance, Outlines) setzt syntaktische Vorgaben auf Token-Ebene während der LLM-Generierung durch. Es garantiert strukturell gültige Ausgaben: korrektes JSON, gültige SQL-Syntax, konforme API-Aufrufe. Die Token-Maskengenerierung läuft mit modernen Engines unter 40 Mikrosekunden. Doch syntaktische Gültigkeit ist nicht semantische Korrektheit. Constrained Decoding garantiert gültiges JSON; es garantiert nicht, dass der JSON-Inhalt Ihre 47 regulatorischen Regeln erfüllt. Die vollständige neuro-symbolische Durchsetzung fügt eine semantische Schicht hinzu: einen SMT-Solver, eine ASP-Engine oder eine Optimierungsschicht, die den Inhalt anhand Ihrer formalen Constraint-Spezifikation verifiziert. Häufig kombinieren wir beides: Constrained Decoding für die Struktur, solverbasierte Prüfung für die Bedeutung.
Wie halten Sie Constraint-Spezifikationen aktuell, wenn sich Vorschriften ändern?
Ontologie-Drift ist der operative Killer neuro-symbolischer Systeme. Statische Constraint-Spezifikationen werden zur Belastung, wenn Vorschriften vierteljährlich aktualisiert werden. Wir bauen Pipelines zur Constraint-Pflege: Regulatorischer Text wird in strukturierte Änderungssätze geparst, gegen die bestehende formale Spezifikation abgeglichen, und das Delta wird vor der Bereitstellung von Domänenexperten geprüft. Wir versionieren Constraint-Spezifikationen zusammen mit Ihren Modellversionen, sodass Sie nachvollziehen können, welche Regeln für jede historische Entscheidung aktiv waren. Dies ist kein einmaliges Ergebnis; wir gestalten den Pflegeprozess als Teil der Architektur.
Hilft die neuro-symbolische Architektur bei der Konformität mit dem EU AI Act für Hochrisikosysteme?
Direkt. Der EU AI Act (vollständige Anwendung ab August 2026) verlangt, dass Hochrisiko-KI-Systeme „hinreichend transparent sind, damit Betreiber die Ausgabe eines Systems interpretieren können“. Neuro-symbolische Architekturen erzeugen neben den Ausgaben auch Beweise der Constraint-Erfüllung: Für jede Entscheidung können Sie zeigen, welche Vorgaben geprüft wurden, welche bindend waren und warum die Ausgabe sie alle erfüllt. Diese doppelte Dokumentation (empirische Leistung aus der neuronalen Komponente plus formale Garantien aus der symbolischen Komponente) ist die stärkste Compliance-Haltung für die Einstufung als Hochrisiko. Organisationen, die KI-Governance-Frameworks implementieren, reduzieren halluzinationsbedingte Risiken um rund 40 %.
Entwickeln Sie Ihre KI mit Zuversicht.
Arbeiten Sie mit einem Team zusammen, das über umfassende Erfahrung im Aufbau der nächsten Generation von Unternehmens-KI verfügt. Wir helfen Ihnen, eine KI-Strategie zu entwerfen, zu entwickeln und einzuführen, der Sie vertrauen können.
Veriprajna Deep-Tech-Beratung ist auf die Entwicklung sicherheitskritischer KI-Systeme für die Bereiche Gesundheitswesen, Finanzen und Regulierung spezialisiert. Unsere Architekturen werden anhand etablierter Protokolle validiert und mit umfassender Compliance-Dokumentation belegt.