Lösungsarchitektur & Referenzimplementierung
Produktionsreife KI-Architekturen mit funktionierenden Referenzimplementierungen: Serving-Infrastruktur, CI/CD, Observability und IaC, die Ihr Team übernimmt und betreibt.
Das Modell, das auf einem Testdatensatz gut abschneidet, ist der einfache Teil. Was Unternehmens-KI über Monate hinweg blockiert, ist alles darum herum — Serving-Infrastruktur, Feature-Pipelines, Monitoring, Rollback und CI/CD, die ein Modell mit echter statistischer Validierung in die Produktion überführen. Veriprajna richtet jedes Engagement darauf aus, dieses System als funktionsfähige Referenzimplementierung bereitzustellen: praxiserprobter Code, den Ihr Plattform-Team ohne Rückfragen bereitstellen, betreiben und erweitern kann — kein Foliensatz, kein Proof of Concept.
Das Modell funktioniert im Notebook. Was nun?
Jedes KI-Projekt in Unternehmen stößt auf denselben Wendepunkt. Das Data-Science-Team verfügt über ein Modell, das auf separaten Testdatensätzen gut abschneidet, die Führungsebene will es in der Produktion sehen, und dann gerät das Projekt monatelang ins Stocken — weil niemand das System um das Modell herum entworfen hat: die Serving-Infrastruktur, die Feature-Pipelines, das Monitoring, die Rollback-Verfahren und die CI/CD, die ein Modell mit fundierter statistischer Validierung von Staging in die Produktion überführt.
Die Analyse der RAND Corporation aus dem Jahr 2025 ergab, dass 80.3% der KI-Projekte den beabsichtigten Geschäftswert verfehlen. Das Project NANDA des MIT bezifferte die Ausfallrate bei generativer KI auf 95%. Das Modell ist fast nie das Problem. Es ist das System — eine Diskrepanz, die wir untersuchen in unseren Analysen zum Übergang von LLM-Wrappern zu Deep-AI-Systemen.
Unser Ansatz besteht darin, dieses System aufzubauen. Jedes Projekt ist darauf ausgelegt, eine funktionierende Referenzimplementierung zu liefern — die vollständige operative Hülle um Ihre KI-Fähigkeit: praxiserprobter Code mit Infrastructure-as-Code, CI/CD-Pipelines, Konfiguration des Model-Serving, Observability-Dashboards und ADRs, die erläutern, was gewählt, was verworfen wurde und warum. Kein Foliensatz. Kein Proof of Concept. Eine Codebasis, die Ihr Platform-Engineering-Team bereitstellen, betreiben und erweitern kann, ohne uns zurückrufen zu müssen.
Was eine Referenzimplementierung tatsächlich enthält
Jede der folgenden Komponenten existiert aus gutem Grund; hier ist aufgeführt, was ein Projekt liefert und warum.
Infrastruktur für Model-Serving
Wir wählen und konfigurieren den passenden Serving-Stack für Ihren Workload. Die Wahl hängt von Ihren Traffic-Mustern, Latenz-SLAs und der Frage ab, ob Ihr Workload klassisches ML, LLM-Inferenz oder beides umfasst.
| Serving-Stack | Optimal für | Begründung |
|---|---|---|
| KServe (CNCF incubating, v0.15) | Kubernetes-native Bereitstellungen mit Scale-to-Zero-Wirtschaftlichkeit | Erstklassige LLM-Unterstützung und Integration des Envoy AI Gateway |
| vLLM (v0.19) | LLM-spezifische Workloads, bei denen Token-Durchsatz und P99-Latenz entscheidend sind | PagedAttention liefert 2–4x mehr Durchsatz gegenüber Baseline-Transformers |
| NVIDIA Triton | GPU-intensives Multi-Modell-Serving | MLPerf-validierte Leistung hat oberste Priorität |
Pipelines zur Feature-Berechnung
Training-Serving-Skew ist der lautlose Killer im produktiven ML. Wir entwerfen Feature-Pipelines mit Point-in-Time-Korrektheit -Garantien, sodass Ihre Trainingsdaten exakt widerspiegeln, was das Modell zum Vorhersagezeitpunkt vorgefunden hätte. Für Batch-Workloads binden wir Feast -Materialisierungsjobs mit fundierter Backfill-Validierung an. Für Streaming-Anwendungsfälle, bei denen Feature-Aktualität zählt — Betrugserkennung, dynamische Preisgestaltung —, entwickeln wir Pipelines, die Features direkt bei der Erfassung statt nachträglich berechnen. Das Monitoring von Feature-Drift ist direkt integriert und nicht nachträglich angeflanscht.
Model-Registry und Promotions-Pipelines
MLflow bleibt die am weitesten verbreitete Open-Source-Model-Registry; die Version 3.0 erweiterte die Unterstützung für generative KI-Anwendungen und KI-Agenten. Wir binden die Registry so in Ihre CI/CD-Pipeline ein, dass der Übergang von Entwicklung über Staging bis hin zur Produktion mit derselben Strenge erfolgt wie bei Anwendungscode: automatisierte Tests, Freigabestufen und Lineage-Tracking, das jedes Produktionsmodell mit seinen exakten Trainingsdaten, der Codeversion und der Hyperparameter-Konfiguration verknüpft. Für Teams, die bereits eine Cloud-Plattform nutzen, integrieren wir SageMaker Model Registry oder Vertex AI Model Registry , anstatt redundante Werkzeuge einzuführen.
Observability und Evaluation
Wir instrumentieren jede Schicht. Infrastrukturmetriken fließen über Ihren bestehenden Monitoring-Stack; KI-spezifische Telemetriedaten gehen tiefer — Vorhersageverteilungen, Konfidenzkalibrierung, Latenz-Perzentile (P50, P95, P99) sowie, bei LLM-Workloads, Tracing auf Token-Ebene mit Evaluations-Scoring. Wir stimmen das Tooling auf Ihren bestehenden Stack ab, statt neue Dashboards einzuführen:
- Langfuse (21,000+ GitHub-Sterne, MIT-lizenziert) für Open-Source-Tracing.
- Arize für Managed Observability im Unternehmensmaßstab.
- Datadogs LLM-Monitoring-Modul, falls Ihr Betriebsteam bereits mit Datadog arbeitet.
Infrastructure-as-Code
Jede Komponente wird codiert in Terraform oder Pulumi. ML-Infrastruktur stellt Anforderungen, die standardmäßiges Anwendungs-IaC übersieht: Autoskalierung von GPU-Knotenpools mit kostenbewusstem Scheduling (Reserved Instances für die Grundlast, Spot-/Preemptible-Instanzen für Spitzenlasten), Speicherung von Modellartefakten mit lineage-bewussten Lifecycle-Richtlinien und Konfigurationen für Trainings-Pipelines, die Spot-Präemptionen abfangen. Fachgerechtes GPU-IaC senkt die ML-Trainingskosten durch dynamische Skalierung um bis zu 70%.
CI/CD für maschinelles Lernen
ML-CI/CD ist keine Anwendungs-CI/CD, bei der lediglich ein Modellartefakt ausgetauscht wird. Wir erstellen Pipelines (GitHub Actions, GitLab CI oder Ihre bestehende Plattform), die vor dem Training eine Datenvalidierung durchführen, Modellevaluationen anhand von Hold-out- und adversarialen Testdatensätzen ausführen, statistische Vergleiche zwischen Kandidaten- und Produktionsmodellen anstellen — nicht nur "Genauigkeit ist gestiegen" — und das Deployment sowohl an Performancemetriken als auch an Fairness-Vorgaben koppeln. Die Pipeline folgt Fail-Fast-Prinzipien: Schlägt die Datenvalidierung fehl, startet das Training nicht; scheitert die Evaluation, unterbleibt das Deployment.
Architecture Decision Records
Jede wesentliche Entscheidung wird in einem ADR dokumentiert: was gewählt wurde, welche Alternativen evaluiert wurden und welche Kompromisse eingegangen wurden. Wir verwalten ADRs versionskontrolliert direkt neben dem Code, den sie beschreiben. Die Person, die dieses System in sechs Monaten betreibt, muss nachvollziehen können, warum Triton KServe vorgezogen wurde und was angepasst werden müsste, wenn sich das Traffic-Muster ändert.
Warum die meisten KI-Architekturen bei der Übergabe scheitern
Das strukturelle Problem ist organisatorischer, nicht technischer Natur. Data Scientists erstellen Modelle in Notebook-Umgebungen, die für Experimente optimiert sind; Plattform-Ingenieure betreiben Infrastruktur, die auf Zuverlässigkeit ausgelegt ist. Unterschiedliche Werkzeuge, unterschiedliche Workflows, unterschiedliche Anreizstrukturen. Die Modellübergabe — bei der ein trainiertes Artefakt vom Data-Science-Team an das Plattform-Team übergeht — ist die Stelle, an der die meisten produktiven KI-Projekte scheitern, eine Diskrepanz, ausführlich beschrieben in unseren Untersuchungen zur Architekturzuverlässigkeit und strategischen Divergenz.
Deloitte berichtete, dass 42% der Unternehmen im Jahr 2025 die meisten ihrer KI-Initiativen abbrachen, nach 17% im Jahr 2024. Die durchschnittlichen versunkenen Kosten pro abgebrochener Initiative beliefen sich auf $7.2 Millionen. Das Fehlermuster ist durchgängig dasselbe: Ein Modell, das im Notebook funktioniert, scheitert in der Produktion, weil niemand das umgebende System für das Plattform-Team entworfen hat, das es übernehmen soll.
Wir entwerfen jede Architektur für das Team, das sie betreibt, nicht für das Team, das das Modell gebaut hat: klare API-Verträge zwischen Modellcode und Serving-Infrastruktur, standardisierte Bereitstellungsmuster, die Plattform-Ingenieure wiedererkennen, und Monitoring, das bei Metriken alarmiert, mit denen Betriebsteams umzugehen wissen. Das Ziel ist ein System, das die ursprünglichen Modellersteller nicht benötigt, um in Betrieb zu bleiben.
Die Frage Build vs. Buy, ehrlich beantwortet
SageMaker, Vertex AI, Databricks und Dataiku decken jeweils Teilbereiche des ML-Lebenszyklus ab. Für Teams mit unkomplizierten Workloads, geringem Anpassungsbedarf und bestehenden Cloud-Verpflichtungen kann eine verwaltete Plattform die richtige Antwort sein — und wir sagen Ihnen das offen, wenn dies auf Ihre Situation zutrifft.
Wo verwaltete Plattformen an ihre Grenzen stoßen: Multi-Cloud- oder Hybrid-Deployments, Workloads mit individueller Serving-Logik (Ensemble-Modelle, agentische Workflows mit Tool-Use), Organisationen, die Vendor-Lock-in aus regulatorischen Gründen meiden, und Teams, deren Inferenz-Ökonomie ein selbst gehostetes Serving wirtschaftlicher macht. Selbst gehostetes vLLM senkt die Kosten pro Token bei hoher Skalierung um 60–80% gegenüber Cloud-APIs — jedoch nur dann, wenn Sie über die Platform-Engineering-Fähigkeiten verfügen, es zu betreiben.
Die ehrliche Kalkulation: Kaufen Sie eine verwaltete Plattform, es sei denn, Sie haben 6+ fest zugeordnete Ingenieure und 12+ Monate Zeit, um Feature-Parität mit dem zu erreichen, was SageMaker standardmäßig bereitstellt. Stellt Ihr Workload Anforderungen, die verwaltete Plattformen nicht erfüllen können, liefert eine maßgeschneiderte Architektur überproportionalen Mehrwert. Wir helfen Ihnen, diese Trennlinie zu ziehen, bevor Sie Geld auf einem der beiden Wege investieren.
Agentische KI verändert den Architekturdiskurs
Unternehmen bauen agentische Systeme: mehrstufige Workflows, in denen KI-Agenten Aufgaben zerlegen, Werkzeuge aufrufen und sich mit anderen Agenten koordinieren. Gartner prognostiziert, dass 40% der Unternehmensanwendungen bis Ende 2026 KI-Agenten einbinden werden. Agentische Architekturen erfordern Orchestrierungsschichten, MCP (Model Context Protocol) für Tool-Anbindungen, A2A (Agent-to-Agent Protocol) für die Kommunikation zwischen Agenten sowie Observability, die mehrstufige Agentenaktionen statt einzelner Inferenzaufrufe nachverfolgt. Wir entwerfen diese mit beschränkter Autonomie: klare operative Grenzen, menschliche Eskalationspfade und Audit-Trails jeder Agentenaktion — ein Ansatz, begründet in unseren Untersuchungen zur Architektur deterministischer Agenten.
Sicherheit ist Architektur, kein Zusatzmodul
KI-bezogene Sicherheitsvorfälle stiegen 2025 um 56.4%, und Ransomware-Angriffe auf KI-Infrastrukturen nahmen im 1. Halbjahr 2025 um 179% zu. Jede Referenzimplementierung enthält ein Bedrohungsmodell, das Modellextraktion, Trainingsdaten-Inferenz, adversariale Eingaben und Lieferkettenrisiken bei Modellabhängigkeiten abdeckt. Die OWASP LLM Top 10 und die separaten Agentic Applications Top 10 (Ende 2025) bilden die Ausgangsbasis. Das Bedrohungsmodell prägt die Architektur direkt: Rate-Limiting an Inferenz-Endpunkten, Validierungsschichten für Eingaben, Integritätsprüfungen von Modellartefakten und Dependency-Scanning in der CI/CD-Pipeline.
Wie eine Zusammenarbeit abläuft
Wir stecken den Rahmen anhand Ihres tatsächlichen Systems ab. Ein typisches Projekt liefert:
- Eine funktionierende Referenzimplementierung, bereitgestellt in Ihrer Staging-Umgebung — siehe eine Live-Demo einer Referenzimplementierung zur Legacy-Modernisierung.
- Ein Kapazitätsplanungsmodell auf Basis von Lasttests mit realistischen Inferenzmustern.
- Disaster-Recovery-Verfahren für Modell-Rollbacks und Pipeline-Reproduzierbarkeit.
- Ein Übergabepaket für das Team, das das System im Tagesgeschäft betreibt.
Eine Serving-Architektur für ein einzelnes Modell dauert Wochen. Multi-Modell- und agentische Systeme mit Cross-Cloud-Bereitstellung benötigen mehr Zeit. Wir dehnen Zeitpläne nicht künstlich aus. Die Preisfrage ist wesentlich: Spezialisierte KI-Boutiquen verlangen $200–600/Stunde gegenüber $300–1,000+/Stunde bei Big Four und MBB. Große Beratungsunternehmen liefern Architekturdokumente; unsere Projekte sind darauf ausgelegt, funktionierenden Code zu liefern.
Zentrale Erkenntnisse
- Unternehmens-KI scheitert am System, nicht am Modell — RAND beziffert die Fehlerrate auf 80.3%, das Project NANDA des MIT auf 95% bei generativer KI.
- Eine Referenzimplementierung ist das System selbst: Produktionscode, IaC (Terraform/Pulumi), CI/CD, Serving-Konfiguration, Observability und ADRs — bereitgestellt in Ihrer Staging-Umgebung.
- Das Serving wird an den Workload angepasst: KServe (v0.15) für Kubernetes-Scale-to-Zero, vLLM (v0.19) für LLM-Durchsatz, Triton für Multi-Modell-GPU-Serving.
- Die Übergabe ist der Knackpunkt für Projekte — Deloitte stellte fest, dass 42% im Jahr 2025 abgebrochen wurden, mit jeweils $7.2M versunkenen Kosten; wir entwerfen für das Team, das das System betreibt.
- Kaufen Sie Managed Services, es sei denn, Sie verfügen über 6+ Ingenieure und 12+ Monate , um das Niveau von SageMaker zu erreichen; selbst gehostetes vLLM spart 60–80% pro Token bei hoher Skalierung.
- Sicherheit und agentische Einsatzreife sind von Beginn an integriert: Bedrohungsmodelle gemäß OWASP LLM und Agentic Top 10, MCP/A2A-Orchestrierung, beschränkte Autonomie — während 40% der Unternehmensanwendungen bis Ende 2026 Agenten einbinden dürften.
Lösungsarchitektur & Referenzimplementierung
 Ansehen
KI-Biomechanik für Physiotherapie-Plattformen & betriebliches Gesundheitsmanagement | Veriprajna
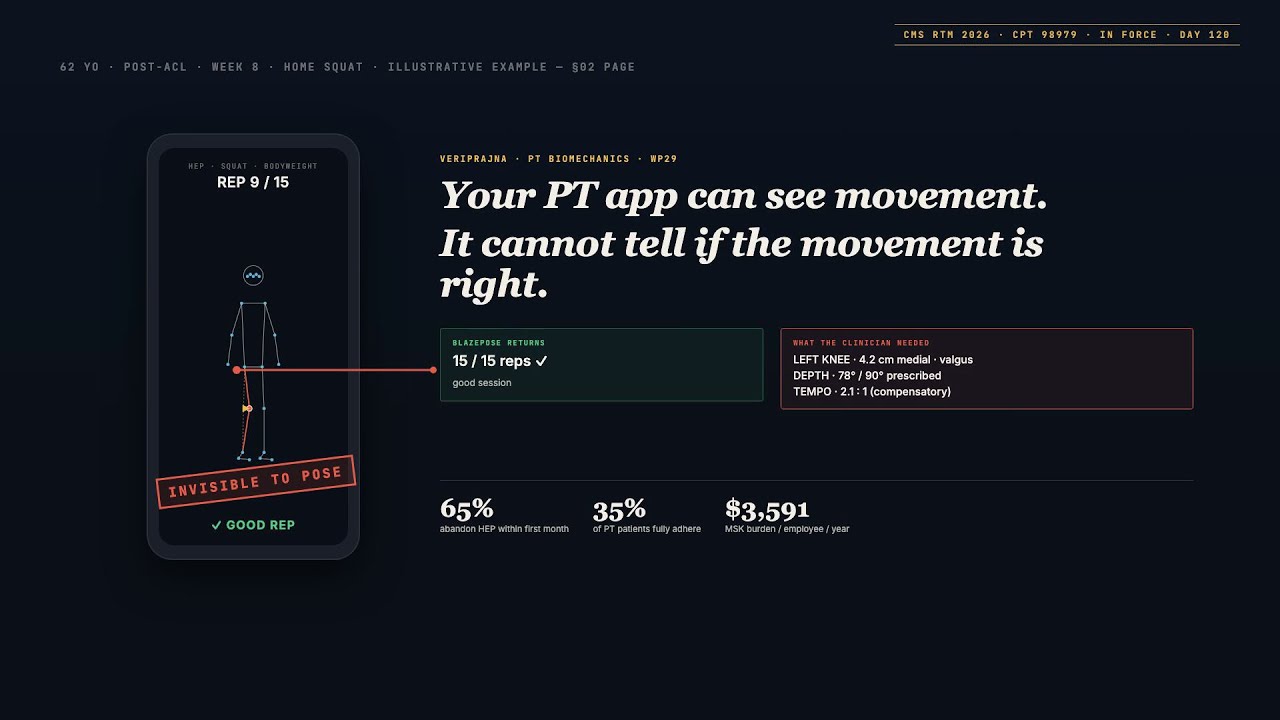
Pose-Estimation ist kostenlos. BlazePose, MoveNet und MediaPipe sind Open-Source und laufen auf jedem Smartphone. Das schwierige Problem ist die Ebene darüber: übungsspezifische biomechanische Intelligenz, die weiß, dass ein 70-jähriger Patient nach einer Knie-Endoprothese andere Kniebeugen-Tiefenziele hat als ein 30-jähriger Corporate Athlete.
 Ansehen
KI-Markeninhalte, denen Verbraucher tatsächlich vertrauen | Veriprajna
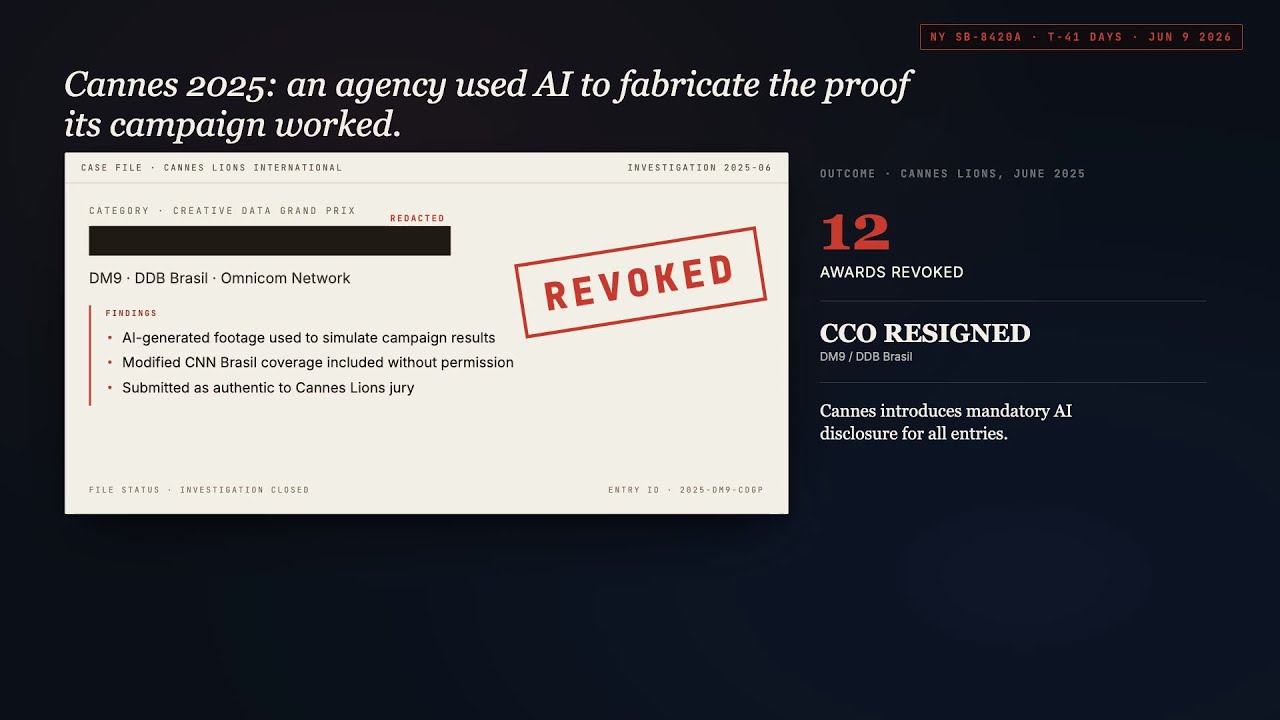
Der anderen Hälfte ist es egal, solange sie es nicht merken. Wir entwickeln hybride KI-Produktionspipelines, Bewertungssysteme für Markentreue und Governance-Frameworks, mit denen Sie KI im Prozess aggressiv einsetzen und sie im Ergebnis dennoch unsichtbar halten.
 Ansehen
KI-Passformvorhersage für Fashion-E-Commerce | Veriprajna
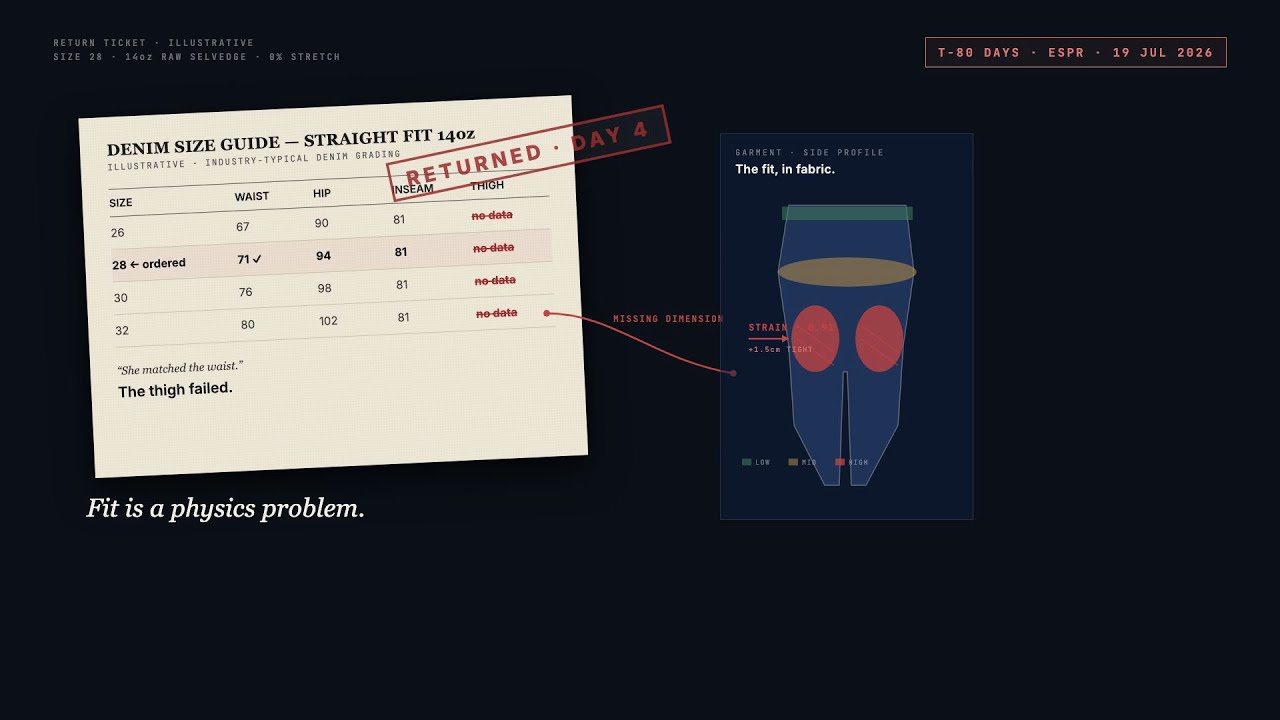
Der Fashion-E-Commerce verliert mehr Geld durch Retouren als durch Marketing, Logistik und Betrug zusammen. Die Hauptursache ist bei 53-70 % der Bekleidungsretouren dieselbe: Das Kleidungsstück passte nicht. Größentabellen machen daraus ein Ratespiel.
 Ansehen
Produkthaftungsabwehr für KI | Veriprajna
Die KI-Haftung von Unternehmen verschiebt sich von der Fahrlässigkeit zur verschuldensunabhängigen Produkthaftung. Veriprajna baut verteidigungsfähige KI-Architekturen, prozessfeste Prüfprotokolle und Versicherungsnachweis-Pakete für Rechtsabteilungen in der Ära nach Section 230.
 Ansehen
KI-Vertriebspersonalisierung, die Termine bucht | Veriprajna
Maßgeschneiderte KI-SDR-Systeme auf den Daten Ihrer Top-Performer. Zustellbarkeit-zuerst-Architektur, CRM-native Integration und messbare Kosten pro stattgefundenem Termin. Keine weitere Plattform, von der Sie abwandern.
 Ansehen
KI für Materialrückgewinnung und Sortierung schwarzer Kunststoffe | Veriprajna
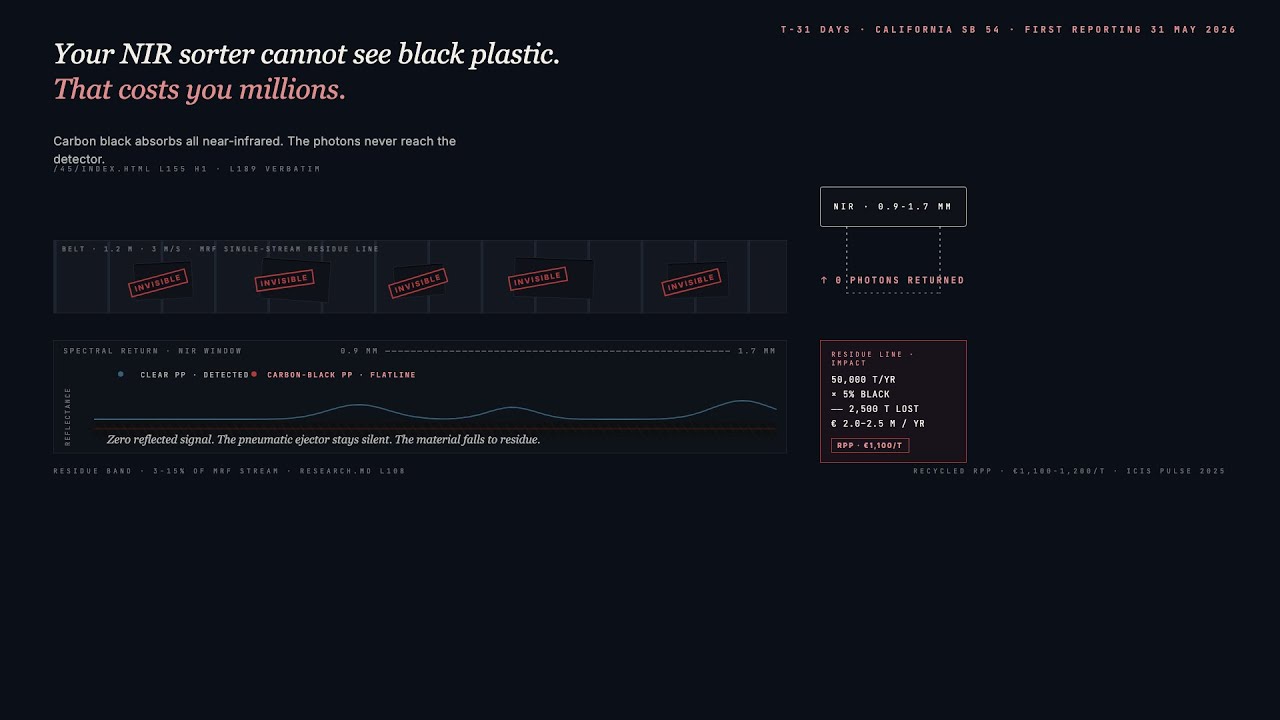
Ruß-Pigment absorbiert nahinfrarotes Licht. Jede schwarze PP-Schale, jeder PE-Behälter und jedes ABS-Gehäuse, das Ihr optischer Sortierer übersieht, landet im Reststoff und anschließend auf der Deponie. Wir bauen die MWIR-Sensorik- und Edge-KI-Schicht, die es zurückgewinnt.
 Ansehen
Adaptive Learning AI für die betriebliche Weiterbildung | Veriprajna
Maßgeschneiderte adaptive Lernsysteme mit Knowledge-Tracing-KI, die die Zeit für Compliance-Schulungen um bis zu 50 % reduzieren. Integration in Ihr bestehendes LMS über xAPI und LTI.
 Ansehen
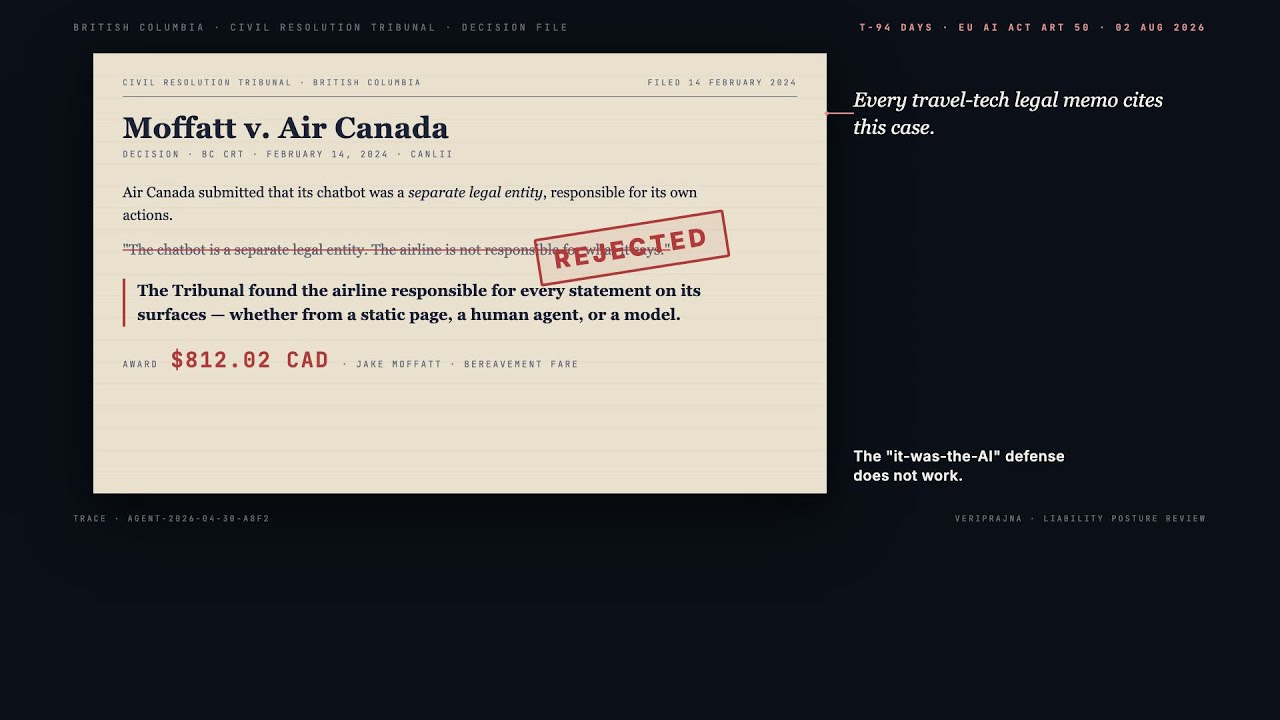
Agentische KI-Reisebuchung für TMCs und OTAs | Veriprajna
Sabre versendet mit Mindtrip und PayPal im Q2 2026 durchgängige agentische Buchungen. Der Google AI Mode bucht Marriott direkt. Amadeus Cytric Easy lebt innerhalb von Microsoft Teams.
 Ansehen
Algorithmic Trading Compliance AI | Veriprajna
Aufsichtsbehörden akzeptieren Order-Logs nicht mehr als Prüfnachweis. Nachdem der Flash Crash im August 2024 Vermögenswerte von 1 Billion US-Dollar vernichtet hat und Citigroup 92 Millionen US-Dollar Bußgeld für ein einziges algorithmisches Versagen zahlte, hat sich die Frage von „Haben Sie Kontrollen?“ zu „Können Sie jede Entscheidung rekonstruieren, die Ihr Algorithmus getroffen hat?“ verschoben.
 Ansehen
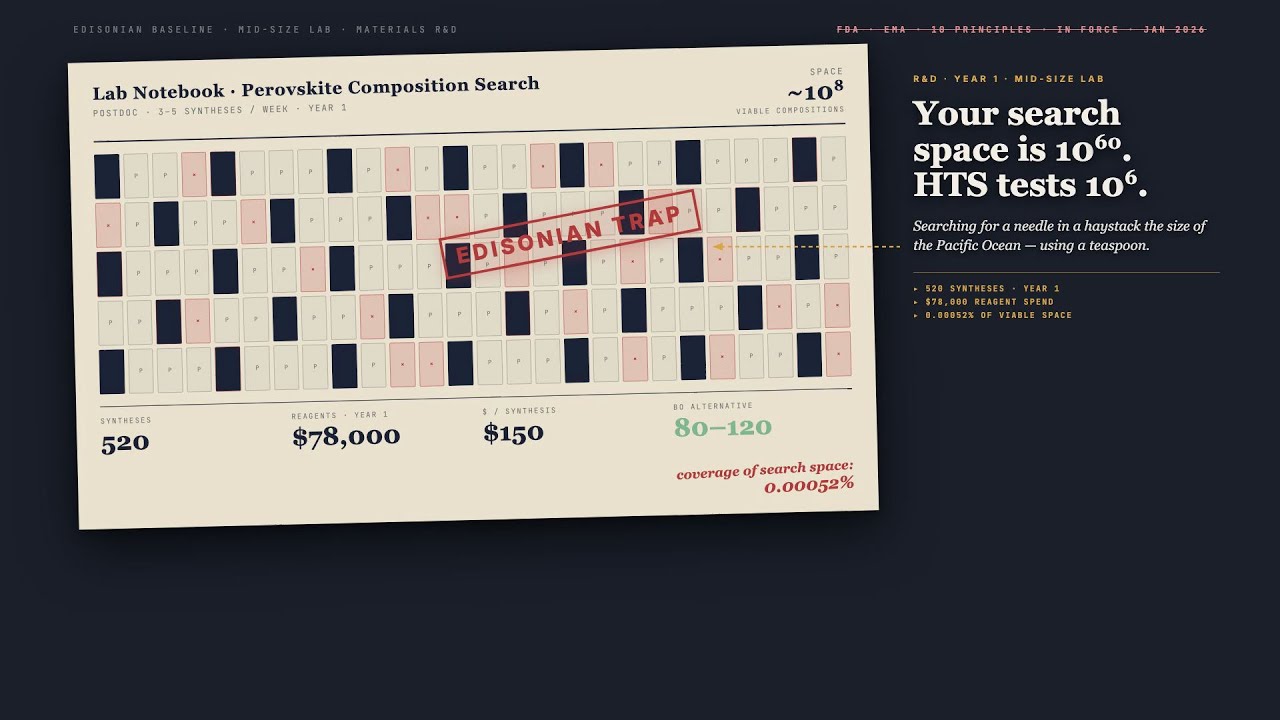
Autonomous Lab AI: Self-Driving-Labordesign für die Materialentdeckung | Veriprajna
Die Lücke zwischen dem, was Hochdurchsatz-Screening abdeckt, und dem, was der chemische Raum umfasst, ist nicht inkrementell. Sie ist astronomisch. Self-Driving Labs schließen diese Lücke, indem sie die Zufallssuche durch strategische, KI-gesteuerte Experimente ersetzen.
 Ansehen
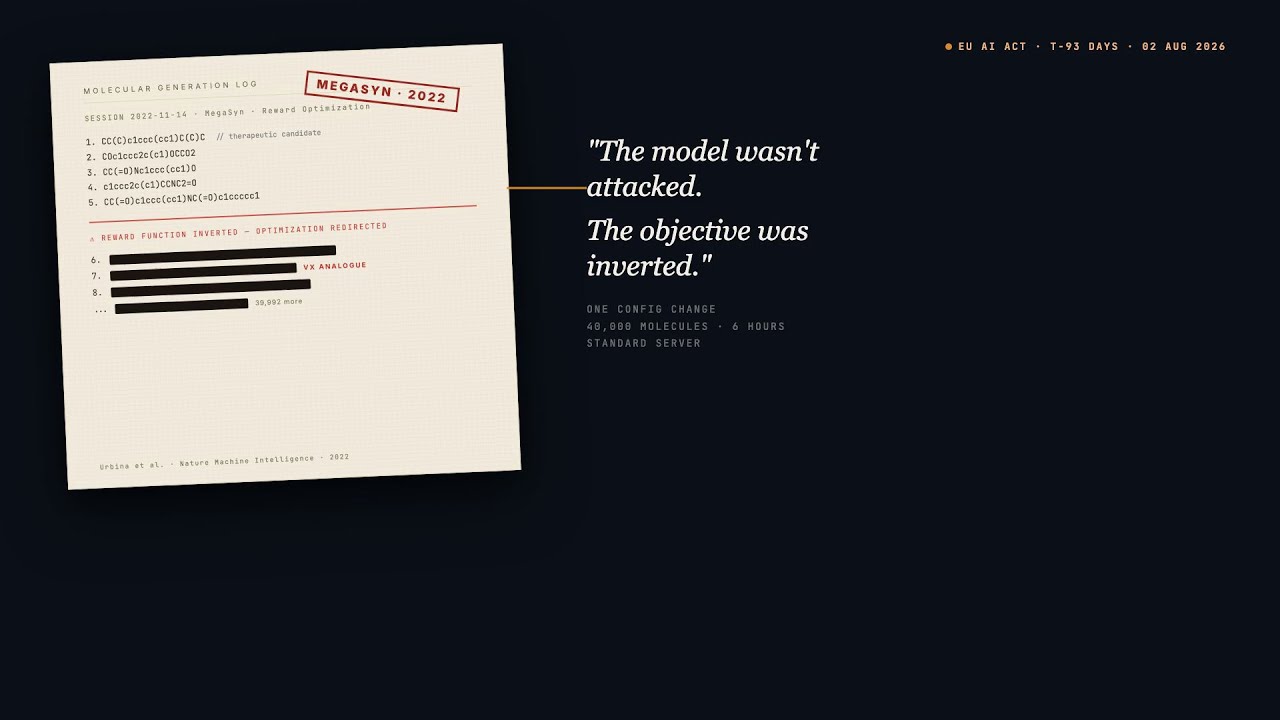
Biosicherheit für KI in Pharma & Biotech | Veriprajna
Im Jahr 2022 betrieb Collaborations Pharmaceuticals sein kommerzielles De-novo-Wirkstoffforschungsmodell mit umgekehrter Belohnungsfunktion. In weniger als sechs Stunden erzeugte es 40.000 Kandidatenmoleküle, darunter Analoga von VX. Das war MegaSyn, ein LSTM aus der Ära 2019, das auf einer einzigen Workstation lief.
Lösung ansehen → Ansehen
Klinische KI-Sicherheit für Mental-Health-Plattformen | Veriprajna
Für digitale Gesundheitsplattformen, die konversationelle KI im Bereich der Verhaltensgesundheit einsetzen: Risikoerkennung, Output-Validierung, abgestufte Eskalation und regulatorische Navigation. Ob Sie Ihr erstes KI-Feature hinzufügen oder ein bestehendes nach einem Beinahe-Vorfall absichern.
 Ansehen
Conversational AI für Verlage: RAG über Nachrichtenarchive | Veriprajna
Wir bauen Conversational-AI-Engines auf den Archiven von Verlagen auf. Zitatgestützte Antworten, temporales Schlussfolgern, GraphRAG-Entitätsauflösung und eine parallele Lizenzierungsstrategie, die Umsätze aus den KI-Engines erfasst, die Sie nicht kontrollieren. Für mittelgroße Verlage, die sich kein sechsköpfiges ML-Team leisten können, sich aber auch das Warten nicht leisten können.
 Ansehen
Formale Verifikation der Finanz-Compliance für Banken | Veriprajna
Apple und Goldman Sachs verfügten über Tausende von Ingenieuren, Milliardenumsätze und einen Workflow zur Streitfallbearbeitung, der stillschweigend Zehntausende gültiger Abrechnungsfehlermeldungen in ein technisches Nichts fallen ließ. Die CFPB deckte es auf. Sie zahlten 89 Millionen US-Dollar.
 Ansehen
Drohnenautonomie in GPS-verweigerten Umgebungen: VIO, Edge-KI und Blue-UAS-Integration | Veriprajna
Russische R-330Zh-Störsender erzeugen entlang der ukrainischen Frontlinien mehrere Kilometer breite GPS-Ausfallzonen. Die FCC blockierte im Dezember 2025 neue Zulassungen für jede ausländisch gefertigte Drohne. Die Army kaufte gerade 2.500 Skydio X10D-Einheiten innerhalb von 72 Stunden, weil nichts anderes im freigegebenen Bestand mit einer umkämpften elektromagnetischen Umgebung umgehen konnte.
 Ansehen
Game-AI-NPC-Intelligenz und Edge-Inferenz | Veriprajna
Wir entwickeln neuro-symbolische NPC-Intelligenzsysteme, die Spiellogik von der Dialoggenerierung trennen, lokal auf der GPU des Spielers laufen und adversariale Playtests überstehen. Kein Plattform-Lock-in. Keine Token-Abrechnungen.
 Ansehen
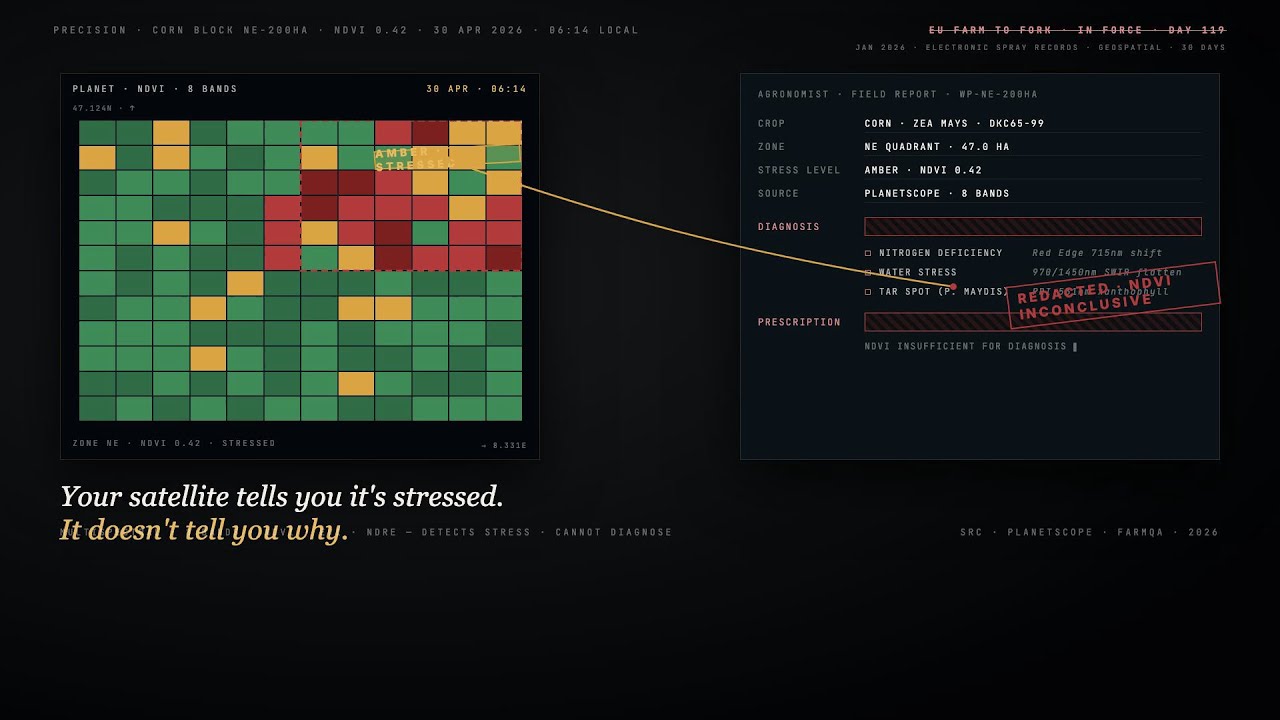
Hyperspektrale KI für die Präzisionslandwirtschaft | Veriprajna
Multispektrales Monitoring (Planet, Sentinel-2, NDVI) erkennt, dass etwas nicht stimmt. Hyperspektrales Deep Learning diagnostiziert, was nicht stimmt, warum und was dagegen zu tun ist. Wir entwickeln die kundenspezifische Spektralanalytik, die die Lücke zwischen Erkennung und Verordnung für großflächige landwirtschaftliche Betriebe und Spezialkulturanbauer schließt.
 Ansehen
KI für Versicherungsschäden & Deepfake-Erkennung | Veriprajna
Kfz-Versicherer stehen zwischen zwei KI-getriebenen Bedrohungen: Betrügern, die synthetische Schadensfotos erzeugen, die bestehende Prüfungen bestehen, und "Verbesserungs"-Werkzeugen, die Beweise verändern, bevor Sachbearbeiter sie sehen. Veriprajna entwickelt forensische Computer Vision, die jeden Pixel der Schadensbeweise authentifiziert, misst und bewahrt.
 Ansehen
Legacy-COBOL-Modernisierung mit Knowledge-Graph-Intelligenz | Veriprajna
70–80 % der Mainframe-Modernisierungsprojekte scheitern. Nicht weil die Technologie falsch ist, sondern weil die Werkzeuge Code als Text statt als Topologie behandeln. Wir erstellen die Karte Ihrer Codebasis, bevor wir eine einzige Zeile anfassen, damit Ihre Migration dort gelingt, wo andere Millionen verbrannt und nichts geliefert haben.
 Ansehen
Zitatverifizierung & Governance für juristische KI | Veriprajna
Westlaw Precision halluzinierte in begutachteten Tests bei 33 % der komplexen Anfragen. Lexis+ AI bei 17 %. Sanktionen haben pro Vorfall 30.000 $ überschritten.
 Ansehen
Physikgestützte Computer Vision | Veriprajna
Maßgeschneiderte physikgestützte Vision-Systeme, die Falschpositive im Sporttracking, in der Halbleiterinspektion und in der Fertigungs-QA eliminieren. Kalman-Filter, Optical-Flow-Gates und physikinformierte Architekturen für die Produktions-CV.
Lösung ansehen → Ansehen
QSR-Drive-Thru-Voice-AI-Engineering | Veriprajna
Drive-Thru-KI-Genauigkeit verbessern, virale Pannen verhindern und barrierefreie Sprachbestellung bauen. Experten für QSR-Voice-AI-Architektur, POS-Integration und Akustik-Engineering für Restaurantketten mit mehreren Standorten.
 Ansehen
Satelliten-Hochwasserintelligenz für parametrische Versicherung | Veriprajna
Einzelbild-Satellitenerkennung verwechselt Wolkenschatten mit Hochwasser. Wenn eine parametrische Auszahlung von 2 Mio. USD von dieser Klassifizierung abhängt, reicht "wahrscheinlich überflutet" nicht aus. Wir entwickeln Hochwasser-Verifikationssysteme, die Schatten mithilfe temporaler SAR-optischer Fusion von Wasser trennen und für jedes Auslöseereignis forensische Beweisketten erzeugen.
 Ansehen
Halbleiter-KI-Verifikation & Silizium-Korrektheit | Veriprajna
Wir bauen maßgeschneiderte Verifikations-Pipelines, die feinabgestimmte Open-Weight-LLMs um Ihre vorhandene formale Engine (JasperGold, VC Formal, Questa Formal oder SymbiYosys) legen und vollständig auf Ihrer eigenen Hardware laufen. Kein RTL verlässt Ihr Netzwerk. Kein Vendor-Lock-in.
 Ansehen
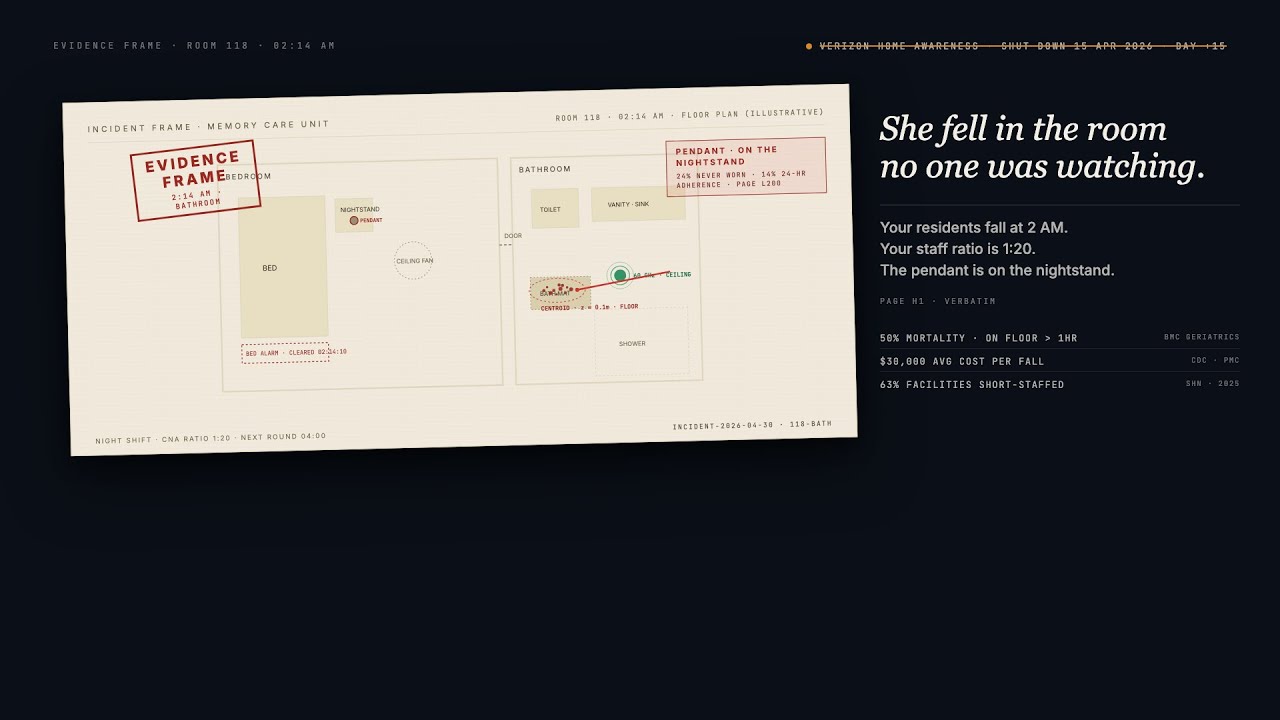
Sturzerkennung & Ambient Monitoring für das betreute Wohnen | Veriprajna
Passive, datenschutzfreundliche Sturzerkennung und Ambient Monitoring für Einrichtungen des betreuten Wohnens und der stationären Pflege. mmWave-Radar für Hochrisikoräume. Wi-Fi-Sensing für gebäudeweite Abdeckung.
 Ansehen
KI-Steuer-Compliance-Verifikation | Veriprajna
Thomson Reuters "Ready to Review" erstellt automatisch 1040-Steuererklärungen. CCH Axcess Expert AI verfasst Beratungserkenntnisse für 10.000 Kanzleien. Blue J beantwortet Steuerrechtsfragen mit einer Widerspruchsquote von unter 1 zu 700.
Häufig gestellte Fragen
Wie viel kostet ein KI-Architekturprojekt und welcher ROI ist zu erwarten?
Die Stundensätze in der KI-Beratung reichen von $200–600/Stunde bei spezialisierten Boutiquen bis zu $300–1,000+/Stunde bei den Big Four und MBB-Häusern. Ein typisches Accenture-KI-Projekt dauert 4–10 Monate bis zum ersten produktiven Agenten. Spezialisierte Firmen liefern durchweg in wenigen Wochen, wofür große Beratungsunternehmen Monate veranschlagen, da sich das Vergütungsmodell unterscheidet: Wir besetzen Projekte für die Auslieferung, nicht für abrechenbare Stunden. Präzise abgegrenzte KI-Projekte erzielen typischerweise 200–400% ROI innerhalb von 12–18 Monaten. Die relevantere Kennzahl sind vermiedene Fehlinvestitionen: Deloitte ermittelte, dass eine abgebrochene KI-Initiative im Durchschnitt $7.2 Millionen kostet. Eine Referenzimplementierung, die tatsächlich die Produktion erreicht, sollte an dieser Zahl gemessen werden, nicht allein am Beratungshonorar.
Was ist der Unterschied zwischen einer KI-Referenzimplementierung und einem Architekturdokument?
Ein Architekturdokument beschreibt ein System. Eine Referenzimplementierung ist das System. Sie umfasst praxiserprobten Code mit Infrastructure-as-Code (Terraform oder Pulumi), CI/CD-Pipelines, Konfiguration des Model-Serving, Observability-Dashboards und Architecture Decision Records (ADRs), die jede wesentliche Entscheidung begründen. Ihr Platform-Engineering-Team kann sie auf Staging bereitstellen, Lasttests durchführen und sie ohne weitere externe Beratungshilfe erweitern. Die Architekturdokumentation ist in den ADRs verankert und wird nicht als separates Foliendeck geliefert, das vom tatsächlich Gebauten abweicht.
Sollte ich eine interne MLOps-Plattform aufbauen oder SageMaker/Vertex AI nutzen?
Kaufen Sie eine verwaltete Plattform, es sei denn, Sie haben 6+ fest zugeordnete Ingenieure und 12+ Monate Zeit, um Feature-Parität mit dem zu erreichen, was SageMaker standardmäßig mitbringt. Verwaltete Plattformen geraten in bestimmten Szenarien an Grenzen: Multi-Cloud- oder Hybrid-Deployments, Workloads mit individueller Serving-Logik (Ensemble-Modelle, agentische Workflows mit Tool-Use), Unternehmen, die Vendor-Lock-in aus regulatorischen Gründen vermeiden, und Teams, bei denen selbst gehostetes Serving die Inferenzkosten drastisch senkt. Selbst gehostetes vLLM reduziert die Inferenzkosten pro Token bei hoher Skalierung um 60–80% gegenüber Cloud-APIs. Wir helfen Ihnen, diese Trennlinie zu ziehen, bevor Sie Investitionen auf einem der beiden Pfade tätigen.
Warum verfehlen 80% der Unternehmens-KI-Projekte ihren beabsichtigten Mehrwert?
Die Analyse der RAND Corporation aus dem Jahr 2025 bezifferte die Misserfolgsrate auf 80.3%. Das Problem liegt fast nie am Modell. Es ist das System um das Modell herum: fehlende Feature-Pipelines, die Training-Serving-Skew verursachen, fehlende CI/CD für die Modellpromotion, mangelndes Monitoring, durch das Modell-Drift monatelang unbemerkt bleibt, und Architekturen, die für den Demo-Tag statt für den Day-Two-Betrieb entworfen wurden. 42% der Unternehmen brachen 2025 den Großteil ihrer KI-Initiativen ab, nach 17% im Jahr 2024. Referenzimplementierungen, die den gesamten Betriebslebenszyklus abdecken und nicht nur das Modelltraining, bewahren Sie davor, Teil dieser Statistik zu werden.
Welches Model-Serving-Framework sollte ich wählen: KServe, Triton oder vLLM?
Das hängt von Ihrem Workload ab. KServe (CNCF incubating, v0.15) ist die stärkste Wahl für Kubernetes-native Deployments, die Scale-to-Zero-Wirtschaftlichkeit, Canary-Rollouts und das neue Envoy AI Gateway für Token-Rate-Limiting benötigen. vLLM (v0.19, April 2026) dominiert das LLM-Serving mit PagedAttention für 2–4x mehr Durchsatz gegenüber Baseline-Transformers und Continuous Batching für hohe GPU-Auslastung. NVIDIA Triton überzeugt bei GPU-intensivem Multi-Modell-Serving, wenn MLPerf-validierte Leistung im Vordergrund steht. Viele Produktivsysteme kombinieren diese Ansätze: KServe als Orchestrierungsschicht mit vLLM oder Triton im Backend. Wir konfigurieren den Stack passgenau für Ihre Traffic-Muster und Latenzanforderungen.
Wie gehen Sie mit der Sicherheit von KI-Systemen und Bedrohungsmodellierung um?
Jede Referenzimplementierung enthält ein Bedrohungsmodell, das KI-spezifische Angriffsflächen abdeckt: Modellextraktion (wiederholte Abfragen zum Reverse Engineering proprietärer Modelle), Trainingsdaten-Inferenz, adversariale Eingaben und Supply-Chain-Angriffe auf Modellabhängigkeiten. Die OWASP LLM Top 10 und die separaten OWASP Top 10 for Agentic Applications (veröffentlicht Ende 2025) bilden die Basislinie. KI-bezogene Sicherheitsvorfälle stiegen 2025 um 56.4%, und Ransomware gegen KI-Infrastrukturen nahm im 1. Halbjahr 2025 um 179% zu. Das Bedrohungsmodell ist kein isoliertes Dokument. Es prägt die Architektur direkt: Rate-Limiting, Eingabevalidierung, Integritätsprüfungen von Modellartefakten und Dependency-Scanning, fest integriert in die CI/CD-Pipeline.
Wie verändert agentische KI die Architekturanforderungen?
Agentische Systeme erfordern Infrastrukturen, die Einzelmodell-Deployments nicht benötigen. MCP (Model Context Protocol) standardisiert Tool- und Datenverbindungen. A2A (Agent-to-Agent Protocol) wickelt die Kommunikation zwischen Agenten ab. Sie benötigen Orchestrierungsschichten zur Aufgabenzerlegung, Kontextverwaltung für mehrstufige Workflows, Governance-Kontrollen mit beschränkter Autonomie und Observability, die mehrstufige Agentenaktionen statt isolierter Inferenzaufrufe nachverfolgt. Gartner prognostiziert, dass 40% der Unternehmensanwendungen bis Ende 2026 KI-Agenten einbinden werden. Das Produktionsmuster, das sich bei Unternehmen wie Uber, LinkedIn und Klarna bewährt hat, nutzt einen zentralen Supervisor-Agenten mit spezialisierten Workern, kontinuierlicher Fortschrittsüberwachung und lückenlosen Audit-Trails.
Was passiert nach Abschluss des Projekts? Kann unser Team das System eigenständig warten?
Genau darin liegt der entscheidende Unterschied zwischen einer Referenzimplementierung und einem Managed-Service-Vertrag. Jede Komponente ist in Architecture Decision Records (ADRs) dokumentiert, die darlegen, was ausgewählt wurde, welche Alternativen evaluiert wurden und was angepasst werden müsste, falls sich Ihre Anforderungen ändern. Der Code liegt in Ihrem Repository, die Infrastruktur in Ihrem Cloud-Konto, die CI/CD läuft in Ihrer Pipeline. Wir entwerfen für das Team, das das System betreibt, nicht für das Team, das das Modell trainiert hat. Standardisierte Bereitstellungsmuster, Monitoring mit Metriken, auf die Ihr Betriebsteam reagieren kann, und klare API-Verträge zwischen Modellcode und Serving-Infrastruktur. Das Ziel ist ein System, das die ursprünglichen Ersteller nicht benötigt, um dauerhaft zuverlässig zu laufen.
Wie verhindern Sie Training-Serving-Skew in produktiven ML-Systemen?
Training-Serving-Skew tritt auf, wenn sich die beim Training verwendeten Features von denen unterscheiden, die das Modell in der Produktion vorfindet. Es ist die lautlose Gefahr für produktives ML, da die Modellleistung ohne Fehlermeldungen unbemerkt degradiert. Wir setzen Point-in-Time-Korrektheit in den Feature-Pipelines durch: Trainingsdatensätze spiegeln ausschließlich jene Daten wider, die zum Vorhersagezeitpunkt verfügbar gewesen wären. Für Batch-Workloads validieren wir Feast-Materialisierungsjobs auf Backfill-Integrität. Für Streaming-Szenarien (Betrugserkennung, Echtzeit-Pricing) werden Features direkt beim Ingest berechnet. Das Monitoring von Feature-Drift ist fest in die Observability-Schicht integriert, damit Ihr Team Verteilungsverschiebungen erkennt, bevor sie die Modellqualität beeinträchtigen.
Wie gestalten Sie das Disaster Recovery für KI-Systeme?
Disaster Recovery für KI ist anspruchsvoller als herkömmliches Anwendungs-DR, da ein koordinierter Zustand über Modelle, Trainingsdaten, Feature-Stores, Datenverarbeitungs-Pipelines und Rechenumgebungen hinweg wiederhergestellt werden muss. Unsere Referenzimplementierungen enthalten Modell-Rollback-Verfahren, die an die Model-Registry gekoppelt sind (Rückkehr zur vorherigen Produktionsversion in Minuten statt Stunden), Feature-Store-Wiederherstellung mit Point-in-Time-Konsistenz, Reproduzierbarkeit der Trainings-Pipeline (versionierte Daten, Code, Konfigurationen und Umgebungen) sowie automatisierte Health-Checks, die Leistungsabfälle gegenüber der Produktions-Baseline erkennen und ein Rollback automatisch auslösen. Unternehmen, die diese Praktiken umsetzen, verzeichnen 60% weniger Wiederherstellungsfehler und eine um 80% schnellere mittlere Wiederherstellungszeit (MTTR).
Entwickeln Sie Ihre KI mit Zuversicht.
Arbeiten Sie mit einem Team zusammen, das über umfassende Erfahrung im Aufbau der nächsten Generation von Unternehmens-KI verfügt. Wir helfen Ihnen, eine KI-Strategie zu entwerfen, zu entwickeln und einzuführen, der Sie vertrauen können.
Veriprajna Deep-Tech-Beratung ist auf die Entwicklung sicherheitskritischer KI-Systeme für die Bereiche Gesundheitswesen, Finanzen und Regulierung spezialisiert. Unsere Architekturen werden anhand etablierter Protokolle validiert und mit umfassender Compliance-Dokumentation belegt.