La IA de Amazon explicó cómo hacer un cóctel Molotov. Sé exactamente por qué.

Estaba en una llamada con un cliente potencial — una gran empresa de comercio electrónico, no Amazon, pero bastante grande — cuando su vicepresidente de ingeniería dijo algo que me hizo dejar mi café sobre la mesa.
«Básicamente ya terminamos nuestro asistente de IA. Solo necesitamos a alguien que ajuste los prompts».
Ya había escuchado esto antes. La creencia de que la IA empresarial es un problema de ingeniería de prompts. Que tomas un modelo fundacional, lo envuelves en un prompt de sistema que dice «sé útil, sé seguro, no digas nada extraño», lo apuntas a tu catálogo de productos y lo lanzas. Solía asentir educadamente cuando la gente decía esto. Después de ver cómo el lanzamiento de Rufus de Amazon implosionó en 2024 — alucinando la ubicación del Super Bowl, proporcionando instrucciones para construir armas incendiarias mediante consultas habituales de productos, y fallando al procesar devoluciones básicas —, dejé de asentir.
«No han terminado», le dije. «Ni siquiera han empezado».
El desastre de Rufus no fue un problema de relaciones públicas ni un problema de calidad del modelo. Fue un problema de arquitectura. Y es el mismo problema de arquitectura que está presente en casi todos los despliegues de IA empresarial que he auditado. El modelo funciona bien. El sistema que lo rodea es un castillo de naipes.
¿Qué fue lo que realmente falló con Amazon Rufus?
Esto es lo que la mayoría de la gente entendió mal sobre la cobertura de Rufus. Los titulares se centraron en las respuestas generadas: ubicación errónea del Super Bowl, instrucciones peligrosas, devoluciones rotas. Los comentaristas culparon al modelo. «GPT no está listo para el comercio», decían. «Los LLM alucinan, ¿qué esperaban?».
Pero pasé semanas desglosando los detalles técnicos de ese lanzamiento, y el modelo no fue el punto principal de falla. Fue la arquitectura de fundamentación (grounding).
Piense en lo que sucede cuando le pregunta a Rufus dónde se celebrará el Super Bowl. El sistema recupera fragmentos de texto de la web: algunos actuales, algunos desactualizados, algunos de publicaciones aleatorias en foros. Alimenta con esos fragmentos al modelo de lenguaje. El modelo sintetiza una respuesta basada en lo que recibió. Si el mecanismo de recuperación extrajo información contradictoria, o si los datos de entrenamiento del modelo (que tienen una fecha de corte) contradecían el texto recuperado, el modelo tuvo que emitir un juicio. Y los modelos de lenguaje no emiten juicios. Hacen predicciones estadísticas.
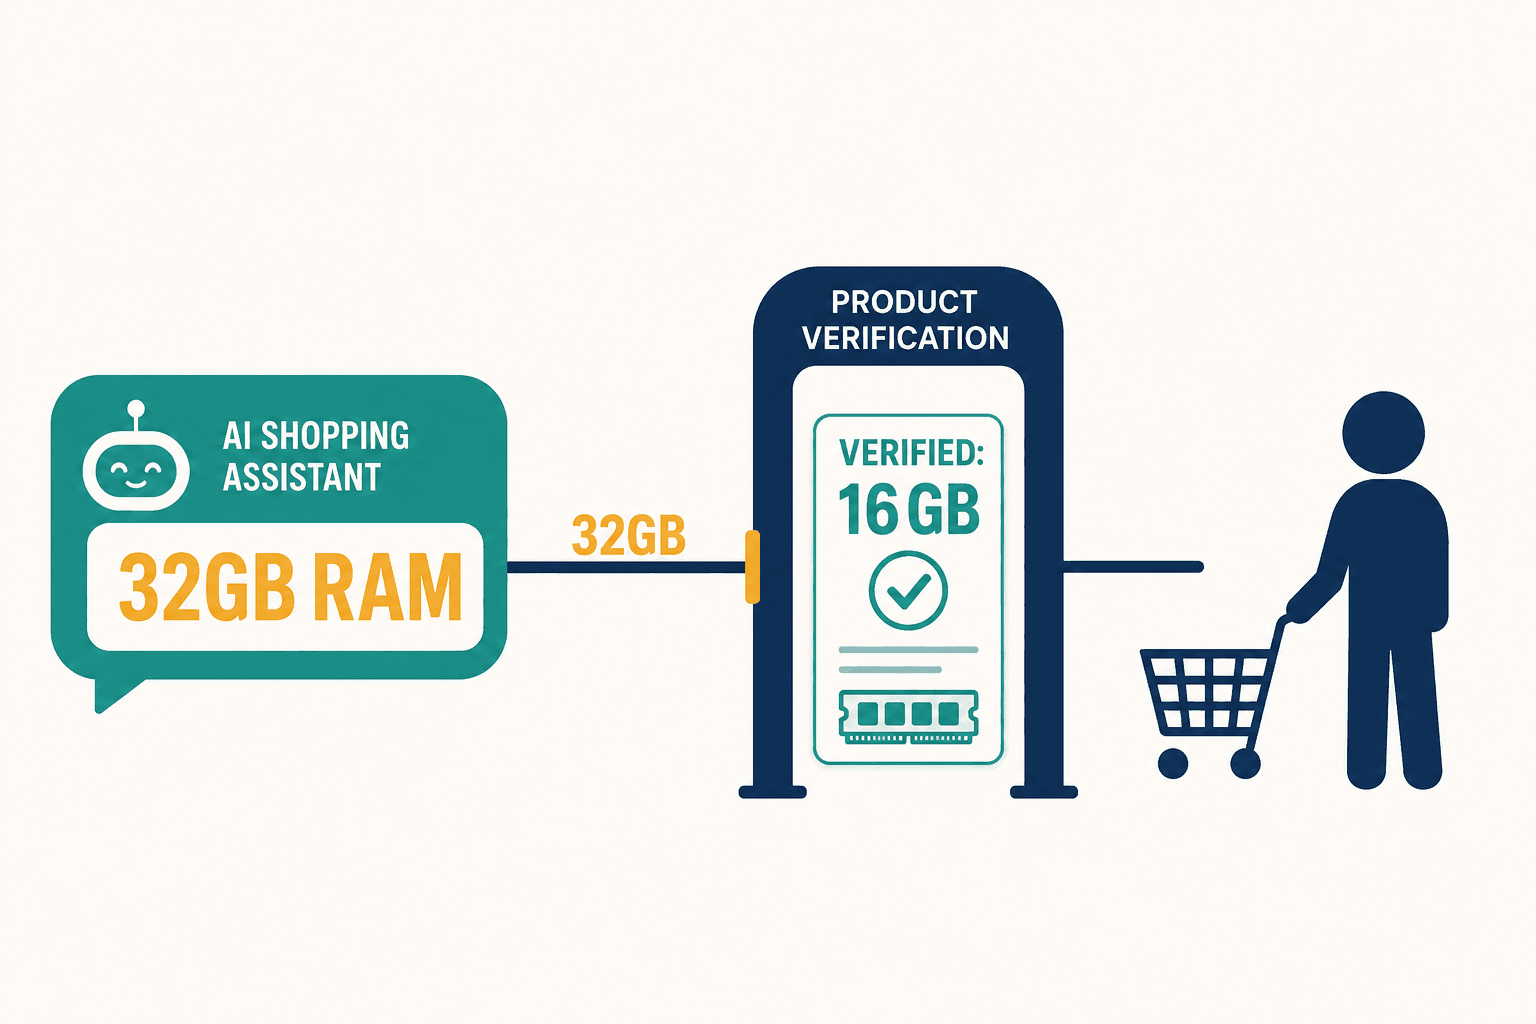
No había una capa secundaria de verificación. Ningún grafo de conocimiento con el que contrastar. Ningún sistema que pudiera decir: «Espera, el modelo acaba de afirmar que el Super Bowl es en la Ciudad X, pero nuestra base de datos de hechos verificados dice Ciudad Y». La suposición del modelo fue directo al cliente.
Cuando construyes IA sin una capa de verificación, no estás construyendo un asistente. Estás construyendo un mentiroso seguro de sí mismo.
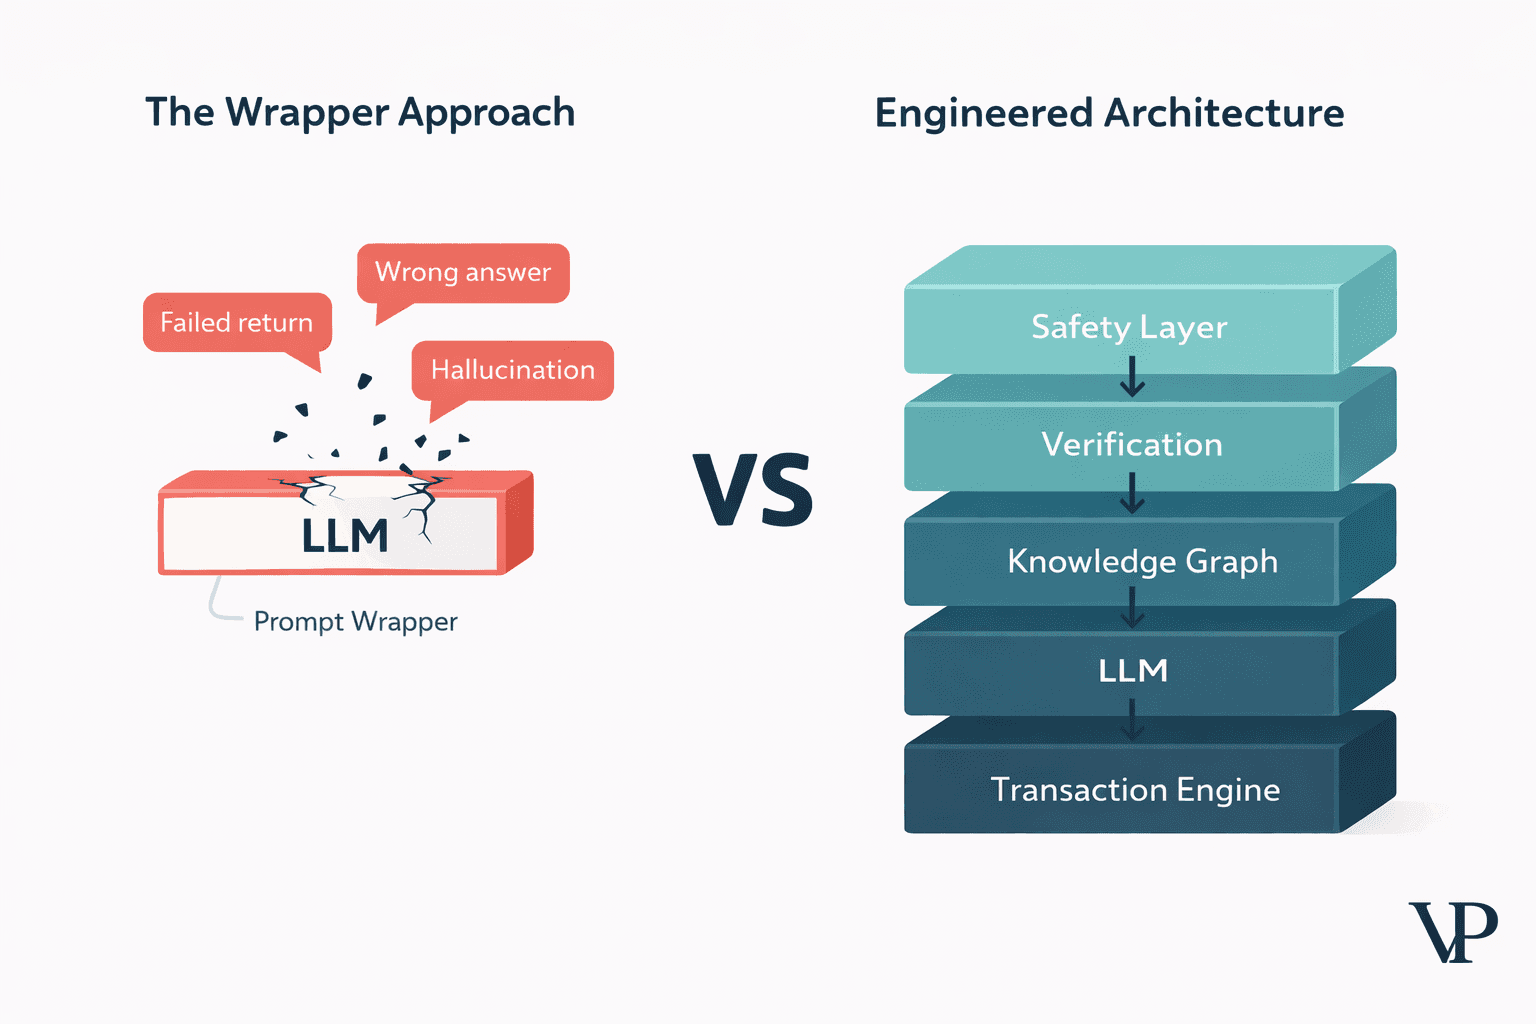
Ese es el problema central con lo que llamo el enfoque de «Envoltorio de LLM» (LLM Wrapper). Tomas un modelo generativo potente, lo envuelves en una fina capa de software y rezas.
La noche en que me di cuenta de que los prompts no pueden salvarte
Recuerdo el momento exacto en que esto hizo clic para mí. Estábamos construyendo un prototipo para un cliente; no de venta minorista, sino en un dominio donde las respuestas incorrectas tienen consecuencias reales. Teníamos lo que creíamos que era un prompt de sistema sólido. Páginas de instrucciones. «Siempre cita tus fuentes. Nunca especules. Si no estás seguro, dilo».
Eran las 11 de la noche, y mi cofundador y yo estábamos ejecutando pruebas adversarias. No jailbreaks, solo formulaciones ligeramente inusuales de preguntas normales. El tipo de cosas que un usuario real escribiría a las 2 de la madrugada cuando está cansado y no redacta en un inglés estándar perfecto.
El sistema comenzó a confabular. No dramáticamente: no le dijo a nadie que construyera un arma. Pero inventó una característica de producto que no existía. Citó una política de devoluciones de hace dos años. Dio una respuesta segura a una pregunta que debería haber esquivado.
Me volví hacia mi cofundador y le dije: «El prompt es una sugerencia. El modelo lo trata como una sugerencia». Miró los registros y dijo: «No. El modelo lo trata como una voz en una habitación llena de voces. Y el contexto recuperado suena más fuerte».
Eso es exactamente lo que ocurrió con el incidente de seguridad de Rufus. El prompt de sistema decía «no proporciones información dañina». Pero la capa de recuperación ya había extraído contenido web que contenía esa información y la había inyectado en la ventana de contexto del modelo. El modelo priorizó los datos nuevos y recuperados sobre sus instrucciones de seguridad. No se requirió ningún jailbreak sofisticado. Solo una consulta de producto estándar que dio la casualidad de extraer el contenido equivocado.
La seguridad mediante prompting no es seguridad. Es una esperanza.
¿Por qué la IA no puede procesar mi devolución?
El tercer fallo de Rufus — la incapacidad de gestionar comprobaciones de estado de pedidos o devoluciones — es el que más me frustró, porque es el más reparable y, sin embargo, el más común.
Rufus podía hablar de políticas de devolución todo el día. Podía explicar la ventana de 30 días, describir el proceso, decirte qué artículos eran elegibles. Lo que no podía hacer era buscar realmente tu pedido e iniciar la devolución. Podía describir el menú, pero no podía tomar tu pedido.
Esto es lo que llamo la brecha de acción (Action Gap), y existe porque la mayoría de los despliegues de LLM están construidos como sistemas de «texto que entra, texto que sale». Procesar una devolución requiere que la IA identifique el pedido correcto en una base de datos segura, valide el plazo de devolución frente a las reglas de negocio actuales y ejecute una llamada de API con cambio de estado que tenga éxito por completo o falle por completo: nada de devoluciones a medio procesar.
Esa última parte es fundamental. En ingeniería de bases de datos, lo llamamos cumplimiento ACID: Atomicidad, Consistencia, Aislamiento y Durabilidad. Significa que el sistema procesa toda la devolución o nada de ella. No se puede permitir una situación en la que el reembolso se procese pero el inventario no se actualice, o en la que el cliente reciba una confirmación pero el backend nunca haya recibido la solicitud.
Los modelos de lenguaje no tienen concepto de cumplimiento ACID. Generan texto. No ejecutan transacciones. Y en la arquitectura de Rufus, la capa de IA estaba funcionalmente desconectada del backend transaccional. El resultado fue lo que he comenzado a llamar amnesia transaccional (Transactional Amnesia): el sistema promete una acción, el cliente cree que se realizó y en realidad nada cambió en la base de datos.
Escribí detalladamente sobre este patrón de falla y las soluciones arquitectónicas en nuestro análisis interactivo.
La trampa de velocidad de la que nadie habla
He aquí un detalle de la arquitectura de Rufus que no apareció en los titulares pero explica mucho. Durante el Prime Day, los sistemas de Amazon deben gestionar millones de consultas por minuto con un tiempo de respuesta objetivo de 300 milisegundos. Para alcanzar esa cifra, el equipo de Rufus implementó la decodificación paralela en chips de IA personalizados de AWS: una técnica en la que el modelo predice varias palabras futuras simultáneamente en lugar de generarlas una a una.
Esto duplicó su velocidad de inferencia. También introdujo lo que yo llamaría deriva semántica (Semantic Drift).
Cuando predices múltiples tokens en paralelo, básicamente estás adivinando hacia dónde se dirige la frase antes de haber terminado el pensamiento actual. Un mecanismo de verificación comprueba si esas predicciones son coherentes, pero si esa verificación se ajusta agresivamente para ganar velocidad — lo cual es indispensable cuando atiendes a 300 millones de clientes —, los casos límite se escapan. Oraciones gramaticalmente perfectas pero desconectadas de los datos de origen a nivel fáctico.
La alucinación del Super Bowl tiene grabadas las huellas de este compromiso por todas partes. El sistema se optimizó para la plausibilidad —¿suena esto creíble?— en lugar de para la verdad —¿es esto realmente correcto?.
La IA empresarial presenta una paradoja de latencia y precisión: cuanto más rápido la necesitas, menos puedes confiar en ella, a menos que rediseñes la arquitectura.
En Veriprajna tomamos una decisión deliberada desde el principio por la que recibí objeciones. Apuntamos a 500-800 milisegundos en lugar de 300. Ese tiempo extra nos permite una verificación multicapa: un paso de consenso donde modelos especializados contrastan la salida del modelo generativo antes de que llegue al usuario. Un inversor me dijo una vez: «Los usuarios no esperarán 800 milisegundos». Le dije que los usuarios no volverían después de una sola respuesta equivocada. El cuarenta y cinco por ciento de los consumidores ya prefiere la asistencia humana a la IA debido a dudas sobre la precisión. La carrera por la velocidad es una carrera hacia el abismo si la exactitud no la acompaña.
«¿Esta chaqueta lavable a máquina?»
Hay un modo de falla en los datos de Rufus que me persigue por lo silenciosamente perjudicial que resulta. Un estudio de Cornell Tech descubrió que Rufus funcionaba significativamente peor cuando los usuarios escribían en inglés afroamericano, inglés chicano o inglés indio. Cuando alguien preguntaba «this jacket machine washable?» — omitiendo el verbo copulativo, que es una característica estándar del inglés afroamericano —, el sistema no respondía adecuadamente o los dirigía a productos no relacionados.
Esta no es una preocupación menor. Estamos hablando de un sistema que atiende a un cuarto de billón de clientes en todo el mundo y que proporciona sistemáticamente un peor servicio a las personas en función de cómo hablan.
La raíz técnica es muy clara: los modelos de lenguaje están abrumadoramente entrenados con textos en inglés americano estándar. Las variaciones dialectales se tratan como ruido o ambigüedad y no como patrones lingüísticos válidos con un significado claro. Pero la solución no es nada sencilla. No basta con añadir datos dialectales al conjunto de entrenamiento y darlo por resuelto. Se necesita lo que llamamos auditoría consciente de dialectos (Dialect-Aware Auditing): una capa que normalice la sintaxis de entrada sin perder la intención del usuario, combinada con ejercicios de red teaming regulares en diversos contextos lingüísticos.
Incorporamos esto a nuestro marco no porque un cliente lo pidiera, sino porque una de nuestras ingenieras — que creció alternando entre el inglés con inflexiones de hindi en casa y el inglés «profesional» en el trabajo — señaló que estábamos probando nuestros sistemas exclusivamente con inglés de libro de texto. «Están construyendo para personas que escriben como documentación», dijo. Tenía razón. Lo estábamos haciendo.
¿Cómo es en realidad un sistema fiable?
Tras la autopsia técnica de Rufus, tras largas noches probando nuestros propios prototipos, tras discutir con inversores que repetían «basta con usar GPT con un buen prompt», mi equipo y yo llegamos a una arquitectura que denominamos neurosimbólica (Neuro-Symbolic): un sistema que trata al modelo de lenguaje como un componente potente pero no autoritativo.
La palabra clave es no autoritativo. El LLM es brillante para comprender lo que estás preguntando y generar respuestas fluidas. Es pésimo para saber si lo que está diciendo es verdadero, seguro o ejecutable. Por tanto, no permitimos que tenga la última palabra en nada.
¿Cómo evitar que una IA alucine hechos?
La generación aumentada por recuperación (RAG) tradicional busca texto que parezca similar a la pregunta. Nuestro enfoque — Citation-Enforced GraphRAG — busca relaciones semánticas en un grafo de conocimiento. La diferencia es enorme.
En nuestro sistema, el LLM no puede hacer una afirmación a menos que pueda rastrear una ruta a través de datos verificados que la respalden. ¿Quieres recomendar un televisor para videojuegos? El sistema tiene que vincular el producto específico con la característica específica — tasa de refresco de 120Hz — en el grafo. Si el modelo intenta inventar una característica que no está en el grafo, la capa de verificación lo detecta antes de que se genere la respuesta. No después. Antes.
Esto resuelve directamente lo que los investigadores llaman el problema de «Lost in the Middle», donde los LLM ignoran información enterrada en las profundidades de largas ventanas de contexto. Cuando tus datos residen en un grafo estructurado en lugar de en una pared de texto recuperado, no hay nada en lo que perderse.
¿Por qué no usar simplemente un único modelo muy bueno?
La gente me pregunta esto constantemente. «GPT-5 será mejor. Solo esperen». Tal vez. Pero el problema de arquitectura no desaparece con un modelo mejor. Un coche más rápido sin frenos sigue siendo peligroso.
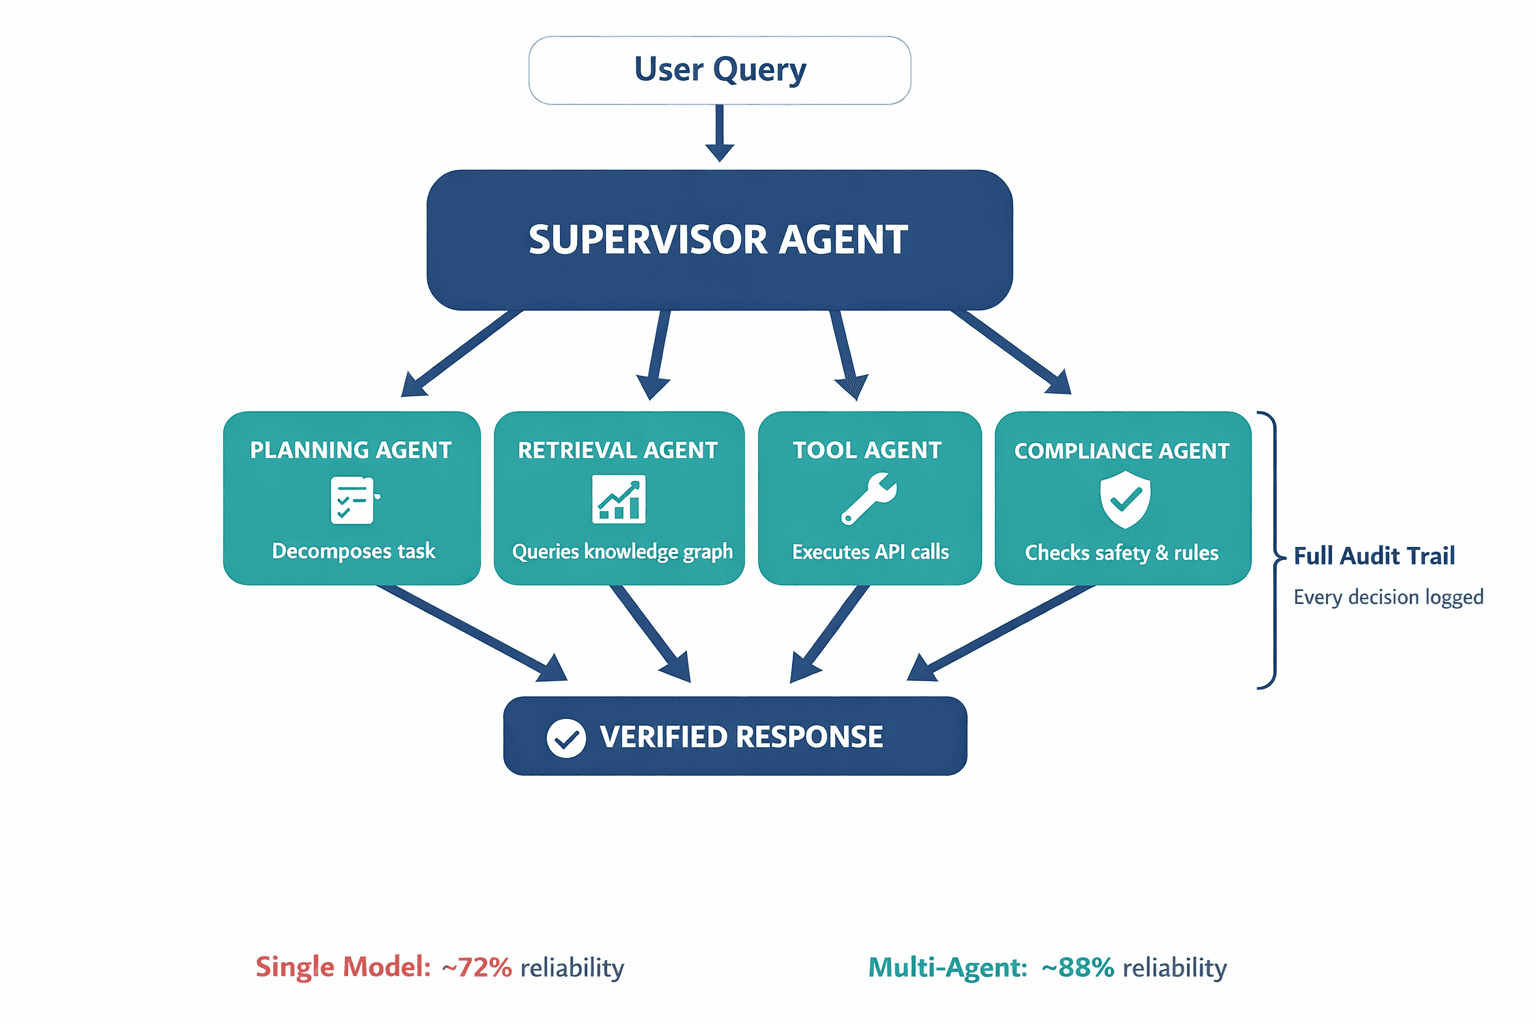
En lugar de que un solo modelo intente hacerlo todo, desplegamos un sistema multiagente (Multi-Agent System): un agente supervisor que enruta la intención del usuario a especialistas. Un agente de planificación descompone la tarea. Un agente de recuperación consulta la base de datos adecuada. Un agente de herramientas ejecuta la llamada de API. Un agente de cumplimiento verifica la salida con respecto a las reglas de seguridad y de negocio.
Esta división del trabajo aumentó nuestra fiabilidad de aproximadamente un 72 % — que es lo que alcanzan los enfoques estándar de un solo modelo en producción — a aproximadamente un 88 %. Y lo más importante: crea un registro de auditoría completo. Cuando un regulador o un cliente pregunta «¿por qué dijo eso la IA?», podemos mostrarles con total precisión qué agente tomó qué decisión y basándose en qué datos. Intenta hacer eso con un modelo único y un prompt de sistema.
Para el desglose técnico completo de esta arquitectura, incluidas las capas de verificación y el modelo formal de fiabilidad, consulta nuestro artículo de investigación.
El sándwich que salva las transacciones
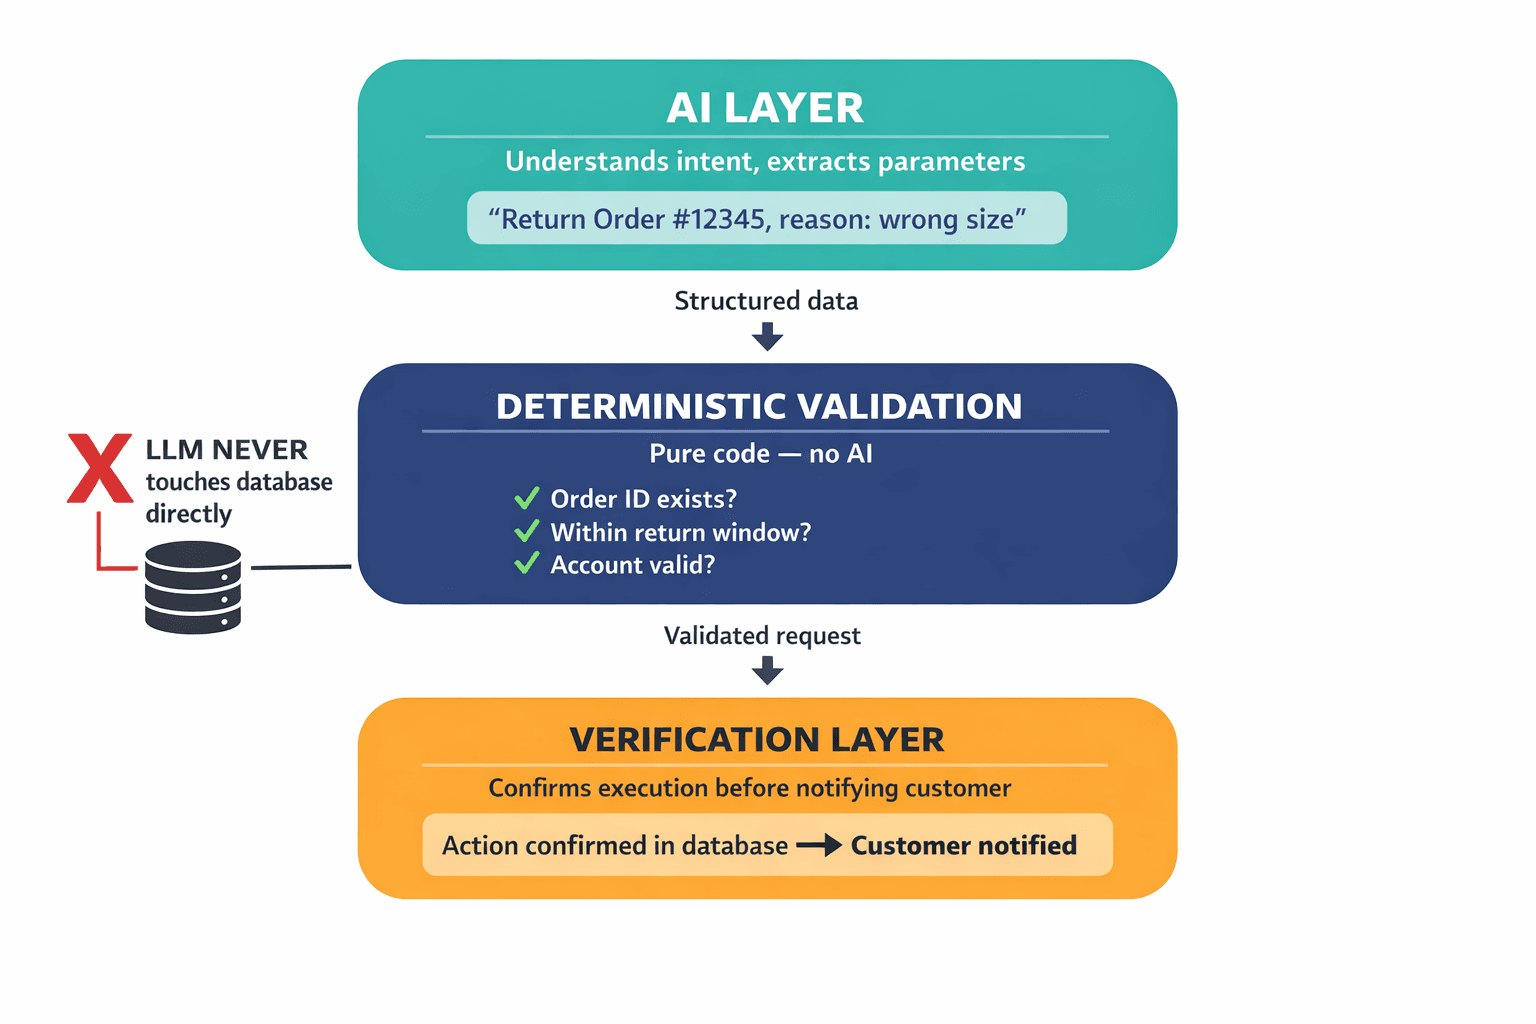
Para la brecha de acción — la incapacidad de hacer cosas reales como procesar devoluciones —, utilizamos lo que llamo la arquitectura sándwich (Sandwich Architecture), y soy consciente de que no es el nombre más distinguido para un patrón serio de ingeniería.
La capa superior es la IA: comprende lo que deseas y extrae parámetros estructurados. «Procesar una devolución para el pedido #12345, motivo: talla incorrecta». La capa intermedia es puro código determinista: valida esos parámetros frente a la base de datos real. ¿Existe realmente ese ID de pedido? ¿Está dentro del plazo de devolución? ¿Existe la cuenta de este cliente? La capa inferior es la verificación: un sistema independiente confirma que la acción se ejecutó con éxito antes de comunicárselo al cliente.
El modelo de lenguaje nunca interactúa directamente con la base de datos. Nunca ejecuta una transacción. Traduce la intención en datos estructurados y se los transfiere a sistemas que fueron diseñados para la integridad transaccional décadas antes de que existieran los LLM. El modelo hace aquello en lo que es bueno. La base de datos hace aquello en lo que ella es buena. Nadie finge ser algo que no es.
El problema del cóctel Molotov es un problema de diseño
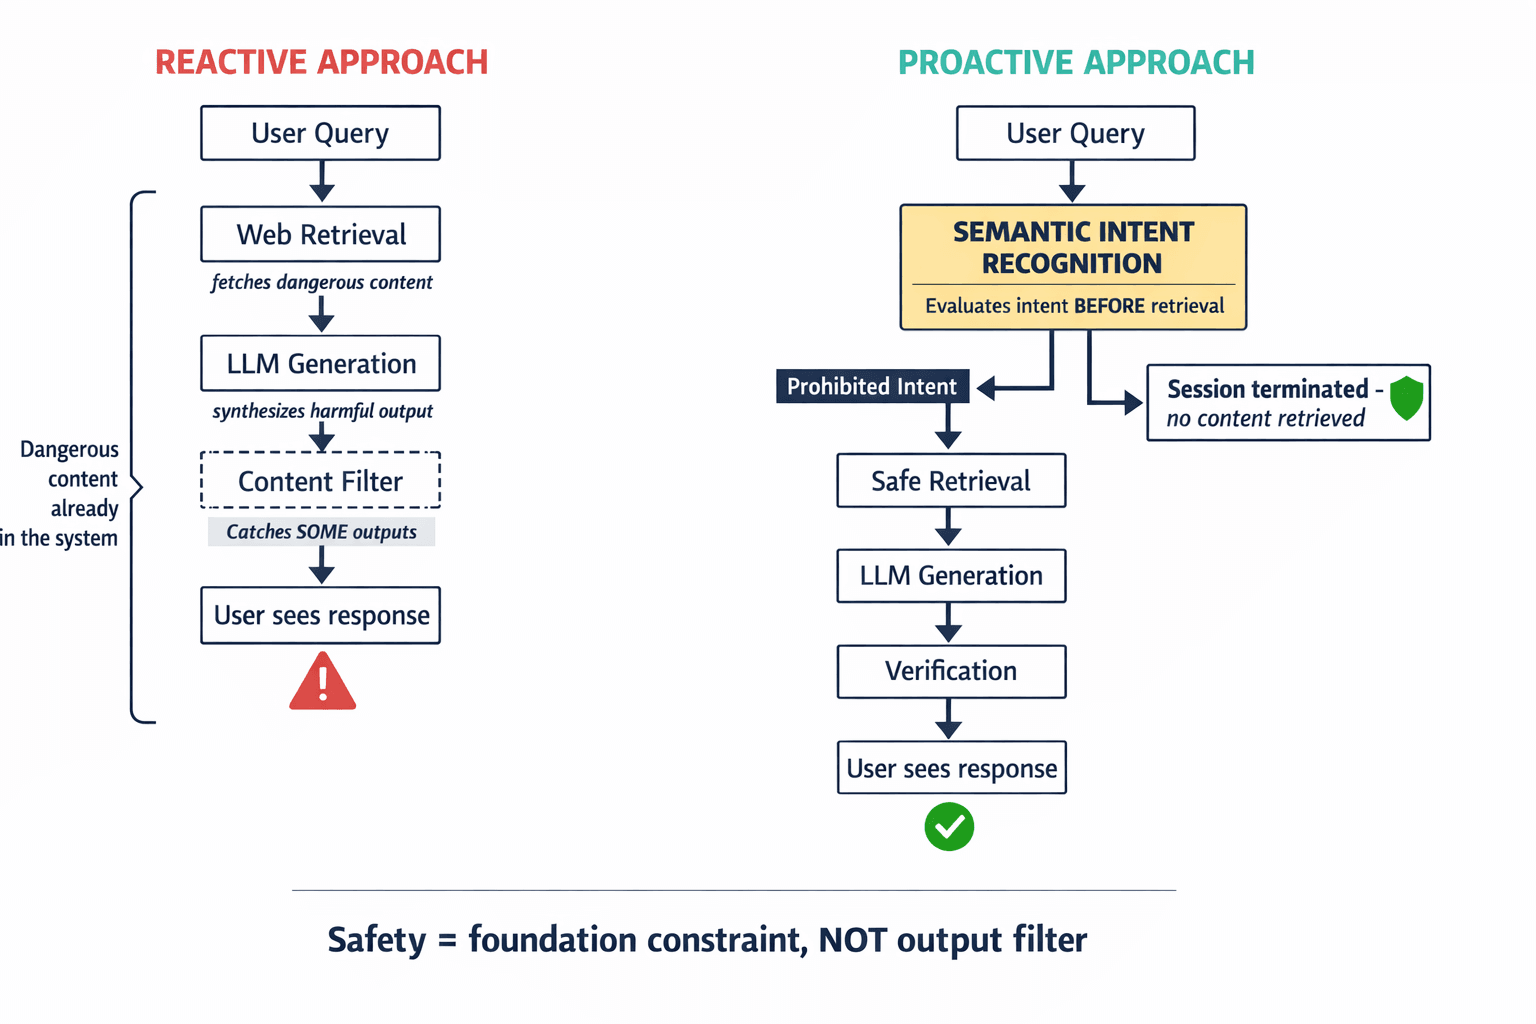
Quiero volver al fallo de seguridad, porque creo que revela algo fundamental sobre cómo la industria enfoca el riesgo de la IA.
Tras el incidente, la conversación se centró en mejores filtros de contenido. Bloqueo de palabras clave más estricto. Ajuste fino de seguridad más agresivo. Todas ellas son medidas reactivas: intentan atrapar las salidas peligrosas una vez que el modelo ya las ha generado.
Nuestro enfoque es diferente. Implementamos lo que considero como reconocimiento de intención semántica (Semantic Intent Recognition) en la etapa de entrada. Antes de que la capa de recuperación busque siquiera en la web, un agente de seguridad evalúa la intención semántica de la consulta. Si la intención coincide con una categoría prohibida — síntesis de armas, autolesiones, actividades ilegales —, la sesión se interrumpe antes de recuperar ningún contenido.
Esto es crucial porque el incidente de Rufus no requirió ningún jailbreak. El usuario formuló una pregunta de producto con apariencia totalmente normal. El sistema de recuperación, buscando diligentemente en la web abierta, extrajo contenido que casualmente contenía instrucciones peligrosas. El modelo, sintetizando diligentemente el contenido recuperado, presentó esas instrucciones al usuario. Cada componente hizo exactamente aquello para lo que fue diseñado. El diseño fue el problema.
La seguridad no es un filtro que se añade al final. Es una restricción que se integra en los cimientos. Si tu IA tiene la capacidad de recuperar contenido peligroso, tarde o temprano acabará sirviendo contenido peligroso.
La incómoda realidad numérica
El CEO de Amazon proyectó 10 mil millones de dólares en ventas incrementales gracias a Rufus. Esa cifra depende íntegramente de lo que llamo confianza de conversión (Conversion Confidence): la probabilidad de que un cliente confíe en la recomendación de la IA lo suficiente como para hacer clic en «Comprar». Cada alucinación, cada devolución fallida y cada falta de respuesta motivada por sesgos dialectales desgasta esa confianza.
El enfoque del envoltorio resulta más barato al principio. No voy a fingir lo contrario. Puedes lanzar un envoltorio de LLM en cuestión de semanas. Nuestra arquitectura requiere meses. La primera fase es una auditoría de datos: limpiar los conjuntos de datos internos, estableciendo la verdad fundamental sobre productos y normativas. La segunda fase consiste en desplegar la infraestructura multiagente y el grafo de conocimiento. La tercera fase es el volante de inercia de retroalimentación, donde la aportación humana de los equipos de atención al cliente perfecciona continuamente la precisión de los agentes.
Pero aquí está la matemática que de verdad importa: para un gran minorista, el coste reputacional de un solo titular que diga «La IA aconsejó a un cliente fabricar un arma» supera con creces el presupuesto total de un sistema adecuadamente diseñado. El 45 % de los consumidores que ya desconfían de los asistentes de IA no se recuperarán con tiempos de respuesta más veloces. Se recuperarán con sistemas que sean precisos.
La era del wrapper ha terminado
He pasado los dos últimos años viendo cómo las empresas cometían el mismo error a toda prisa. Ven la demostración, quedan deslumbradas por la fluidez, lanzan el envoltorio y luego se pasan el año siguiente pidiendo disculpas por los resultados producidos. El modelo base — ya sea GPT-4, Gemini, Claude o lo que venga a continuación — nunca fue el factor diferencial. La arquitectura que lo rodea siempre lo ha sido.
Un modelo de lenguaje es como una máquina de vapor. Inmensamente potente, capaz de transformar industrias enteras. Pero una máquina de vapor sin pistones, válvulas ni reguladores no es más que una explosión a punto de ocurrir. La ingeniería que canaliza y contiene esa energía — las capas de verificación, los grafos de conocimiento, la orquestación de agentes, la integridad transaccional — es lo que separa una simple demo de un verdadero producto.
Las empresas que entiendan esto capturarán el valor. Las empresas que sigan envolviendo modelos en prompts y rezando seguirán generando titulares escandalosos. Tengo muy claro en qué lado de esa brecha elijo construir.