Una estimación de menor riesgo de firmware no es permiso de lanzamiento

Una revisión correctiva (hotfix) de firmware puede mejorar drásticamente una estimación de riesgo y, aun así, dejar un lanzamiento inaceptable según la política declarada. Para un equipo de ingeniería que decide si actualizar una flota de medidores, esas son evaluaciones diferentes. La mejora dice algo sobre el candidato. El permiso depende del riesgo remanente, la población evaluada y la evidencia detrás de la estimación.
Construí MeterGuard para mantener esas evaluaciones visibles. Es una demostración de verificación previa al despliegue de firmware que utiliza poblaciones de medidores y manifiestos de firmware sintéticos. Estima el comportamiento a partir de un registro de cambios (changelog), modela dicho comportamiento frente a la salud de la flota y emite una recomendación local. No envía firmware a los medidores ni bloquea una actualización real. La pregunta útil es qué permite inspeccionar esta separación a un responsable de lanzamiento y qué sigue sin poder determinar.
La mejora y la aceptabilidad responden a preguntas diferentes
Consideremos la población sintética denominada Plano Water. Un candidato inicial produce una tasa media modelada de fallos del 74.22% de los terminales evaluados. Un hotfix produce el 2.85%. Ambos resultados utilizan perfiles de comportamiento asistidos por modelos almacenados en caché, en lugar de un comportamiento medido a partir de binarios de firmware. Dentro de esos supuestos, el hotfix supone una mejora sustancial. Vale la pena preservar esa comparación incluso cuando la recomendación final siga siendo NO-GO.
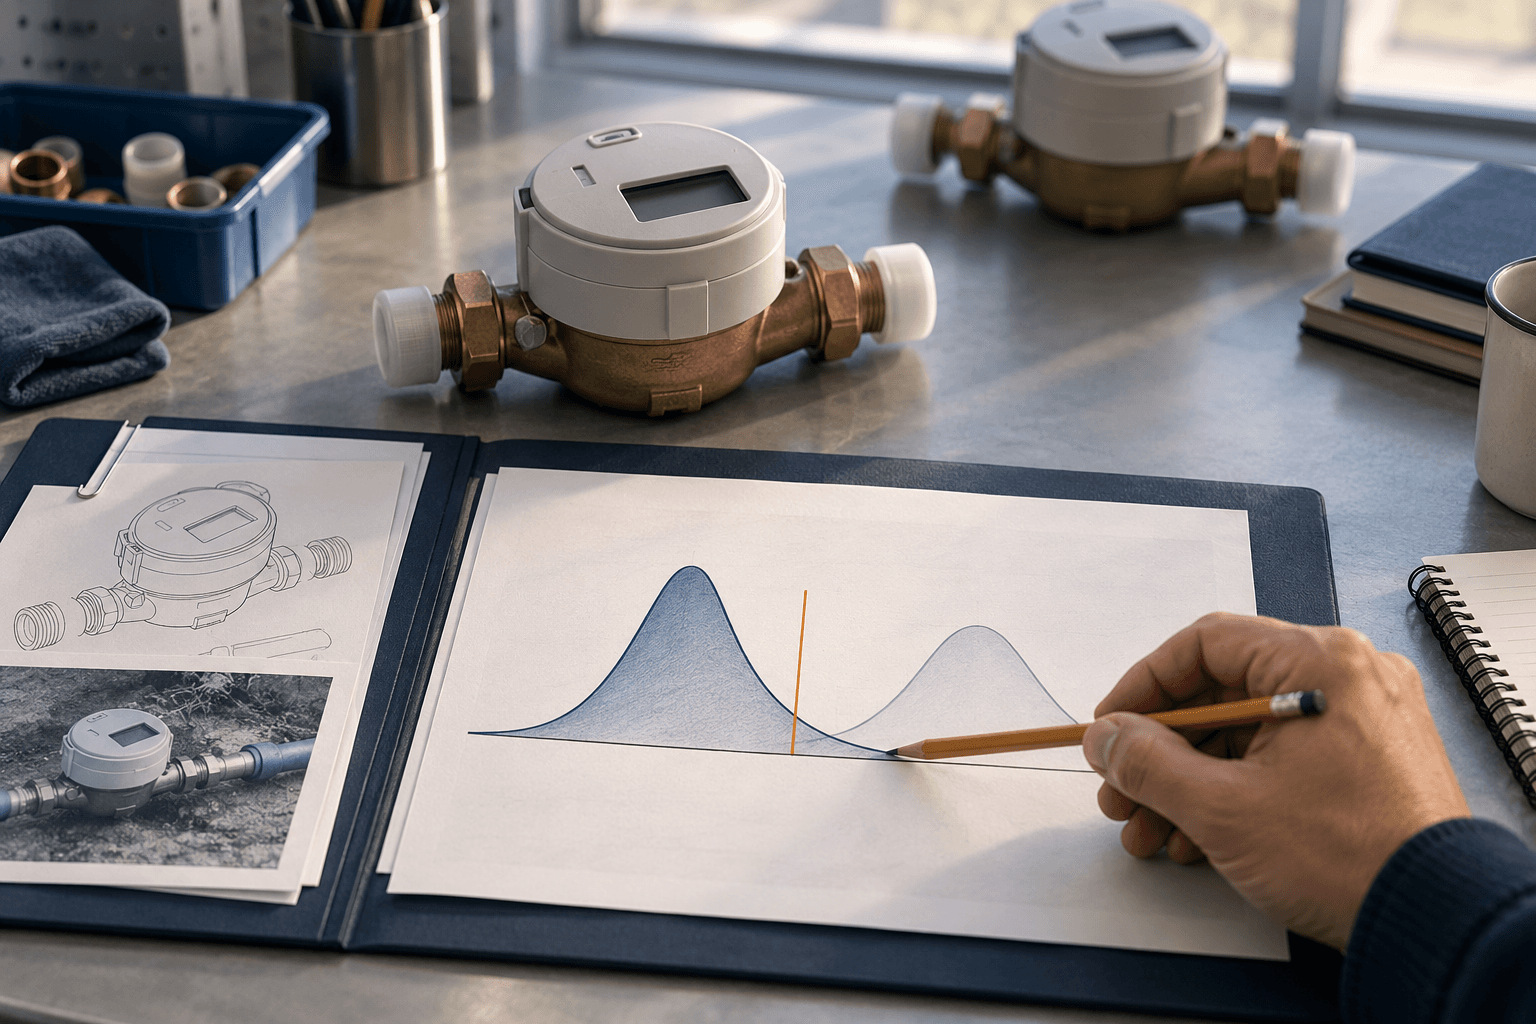
La compuerta de lanzamiento verifica primero el extremo superior del intervalo modelado del 90%. Si es igual o superior al 3.0% de los terminales evaluados, devuelve NO-GO. Para el hotfix, la media es de 2,449 fallos modelados entre 86,078 terminales evaluados, con un intervalo de 1,536 a 3,531. La tasa superior es del 4.10%, por lo que se aplica la regla de bloqueo estricto. Otros 1,922 terminales carecen de telemetría suficiente y quedan excluidos de esa predicción, recomendándose una revisión manual.
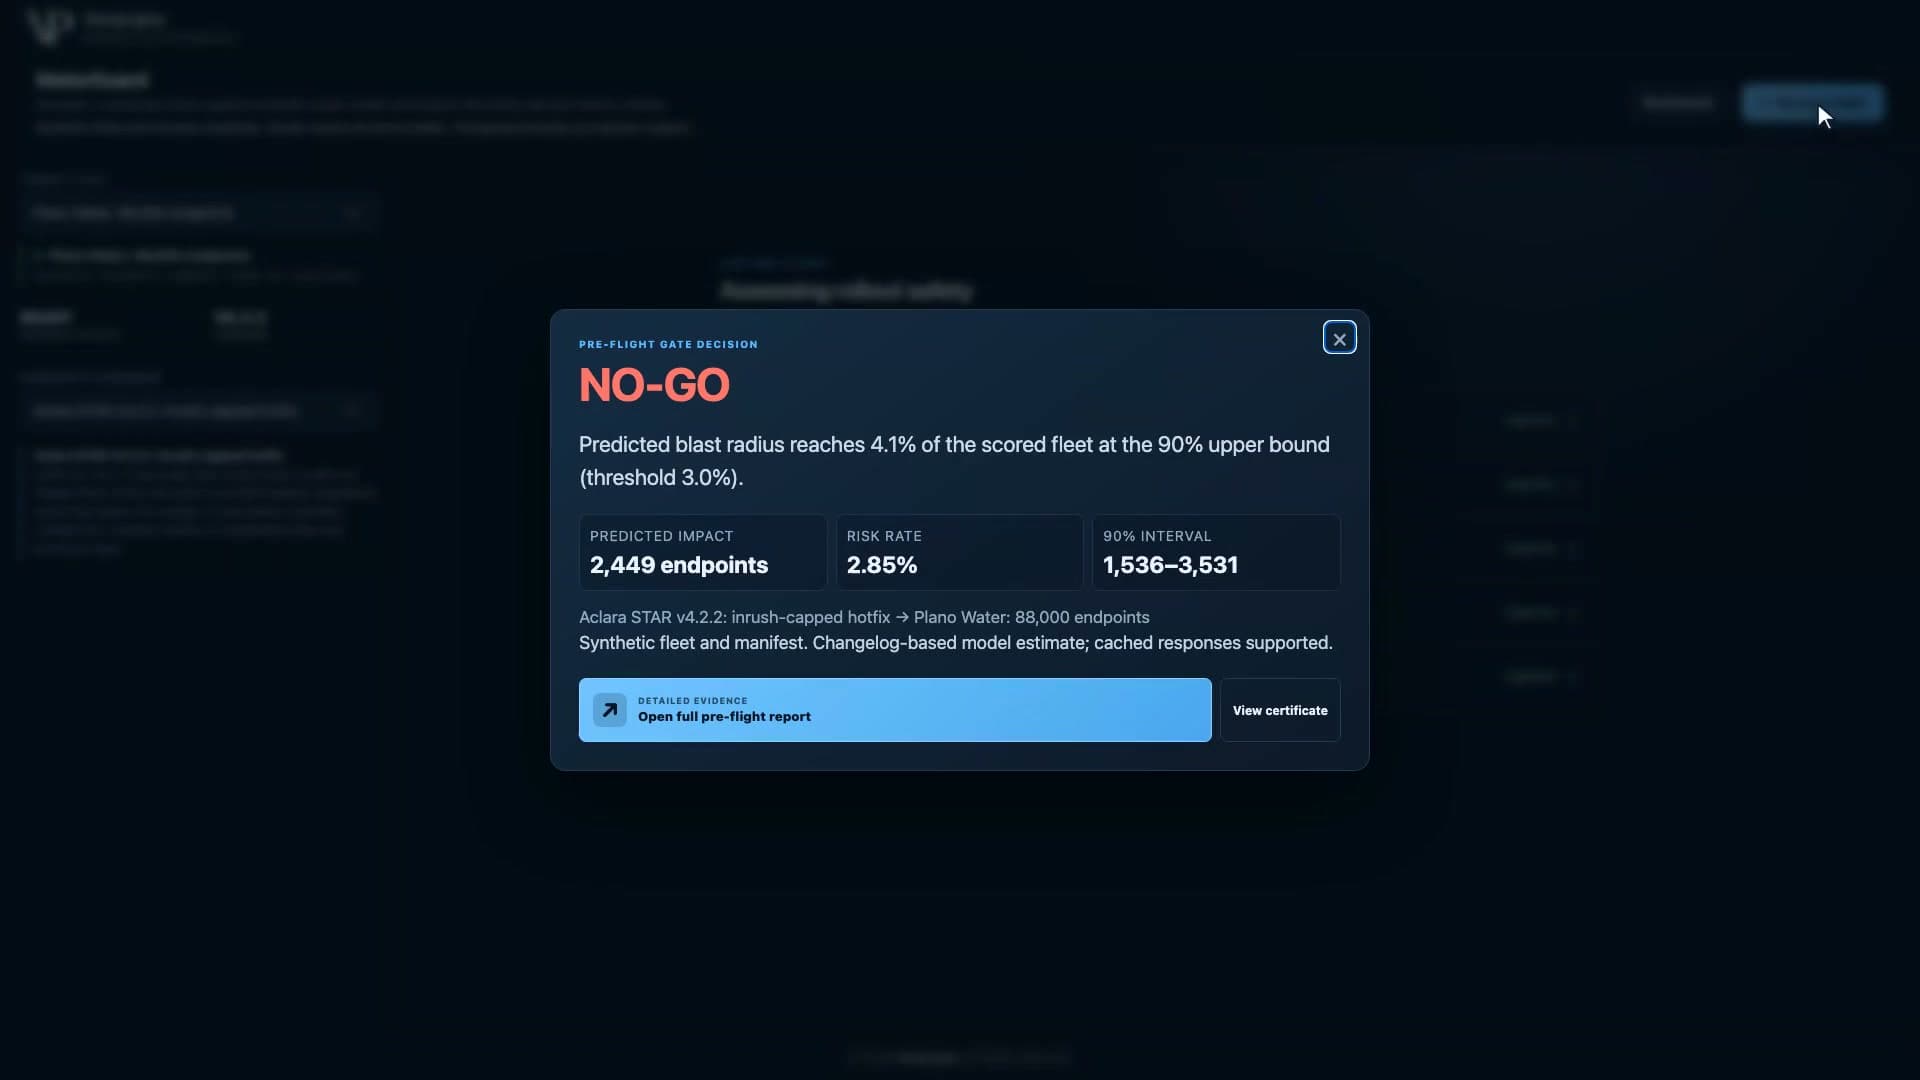
Una lectura limitada a la media pasaría por alto por qué se trata de un bloqueo estricto. Tampoco haría que el candidato fuera apto para GO según el resto de la política: GO requiere una media igual o inferior al 0.5%, tras superar las comprobaciones de límite superior y de confianza. Un riesgo numérico intermedio conduce a STAGED-CANARY. La distinción importa porque «mejor», «apto para un paso limitado de recopilación de evidencia» y «dentro de la regla GO» no deben colapsar en una única etiqueta tranquilizadora.
Prefiero mantener visible la mejora sin permitir que renegocie el límite. Si un equipo responde a una recomendación decepcionante relajando el umbral, ha cambiado su política de aceptación. Puede ser una decisión defendible en un contexto concreto, pero es una decisión independiente que exige sus propios motivos. La evidencia de que un candidato es mejor que otro no aporta esos motivos por sí sola.
Esta postura tiene un coste. Un límite conservador puede retrasar a un candidato que habría tenido éxito. El extremo superior de un intervalo modelado no es un resultado observado en campo, y llamar al intervalo «90%» no demuestra su cobertura en una flota de servicios públicos. Esta demo no puede determinar qué umbral debe adoptar una empresa real de servicios públicos. Lo que sí puede mostrar es si una recomendación respeta el umbral declarado, en lugar de un umbral ajustado silenciosamente para adaptarse al resultado.
El permiso pertenece a un candidato y a una población
La misma estimación de comportamiento del hotfix arroja un resultado muy diferente frente a la población generada denominada Hill Country Electric Co-op. Su tasa media modelada de fallos es del 0.02%, con una tasa de intervalo superior del 0.03%, y la compuerta devuelve GO para 118,222 terminales evaluados. La población tiene una distribución de batería más saludable y una señal de radio menos débil que la población sintética de Plano. Sus 1,778 terminales excluidos permanecen fuera de esa recomendación.
Esta es una comparación del comportamiento de escritura estimado a través de distribuciones de salud generadas. No dice nada sobre la instalación de la imagen de un fabricante en el hardware de otro. La compatibilidad y la validación derivada de binarios son trabajos independientes que la demo no realiza.
La comparación cambia la forma en que deseo que se exprese una recomendación de lanzamiento. «Este firmware es de bajo riesgo» deja sin definir el alcance. «Este comportamiento estimado cumple esta política en esta población evaluada» preserva las condiciones bajo las cuales el resultado es válido. El estado de la batería y la recuperación de radio son entradas del resultado modelado, por lo que un resultado favorable no puede separarse de ellas y trasladarse a otra flota.
Para un responsable de lanzamiento, esto genera dos formas diferentes de responder a una recomendación desfavorable. Una es mejorar el comportamiento del candidato o la evidencia utilizada para estimarlo. Otra es considerar una población más estrecha cuyas condiciones respalden una evaluación diferente. Responden a problemas distintos. Una evaluación más estrecha puede reducir la exposición modelada, pero deja sin resolver el resto de la población. Una mejor evidencia sobre el candidato puede mejorar la estimación, pero no puede hacer que aparezca la telemetría de flota ausente.
Esas alternativas son decisiones de ingeniería prospectivas, no operaciones que ejecute esta demo. Su valor es que orientan el trabajo hacia la fuente de la incertidumbre. El veredicto por sí solo no puede decirle a un equipo si necesita un mejor candidato, un mejor perfil o mejor información sobre los destinatarios previstos. Las entradas y exclusiones que lo acompañan sí pueden.
Una compuerta de código no puede validar lo que cree el modelo
MeterGuard mantiene la política en código simple. El memorando de gobernanza asistido por modelos se emite después del veredicto y no tiene autoridad directa para anularlo. Deseo esa separación porque una explicación elocuente no debería convertirse silenciosamente en una nueva regla de lanzamiento.
El modelo sigue teniendo una influencia determinante antes en el flujo de trabajo. Su perfil de firmware estima el consumo de corriente, la recuperación tras el reinicio y el comportamiento de escritura flash a partir de texto sintético del changelog. Esas estimaciones alimentan el simulador. Un perfil diferente puede cambiar los fallos modelados y, por lo tanto, modificar el veredicto, incluso si el código de la compuerta nunca cambia. Una política auditable establece cómo se evaluaron las entradas; no demuestra que las entradas fueran correctas.
El caso de un changelog escaso hace visible la distinción. Frente a la misma población generada de la cooperativa, su media modelada es de solo el 0.05% y su tasa superior es del 0.06%. Esos números superan los límites numéricos. Sin embargo, el perfil presenta baja confianza, por lo que la compuerta recomienda STAGED-CANARY en lugar de GO. La escasa evidencia sobre el firmware se trata como una razón independiente para retener la recomendación más amplia.
Esa es una protección útil, con su propio límite. La etiqueta de confianza de un modelo no es una certeza empírica calibrada. Exigir una etiqueta que no sea baja puede evitar que se ignore una brecha de evidencia reconocida; no puede certificar que una etiqueta «alta» sea precisa. Para confiar en producción, el perfil requeriría validación contra el comportamiento real del firmware y sus resultados efectivos. Esto sigue siendo una tarea que va más allá de la demostración sintética.
La muestra más segura deja una pregunta más difícil
La ruta por etapas propuesta utiliza 500 terminales de la cohorte con el menor riesgo modelado, con una pausa de 72 horas y una reevaluación mediante telemetría observada antes de ampliar el alcance. La demo recomienda este plan; no ha ejecutado un despliegue canario ni ha recopilado sus observaciones. El criterio de ampliación configurado es una tasa de fallos observada por debajo del 0.1%.
Veo una verdadera compensación al elegir primero la cohorte más segura. Reduce la exposición propuesta para el paso inicial. Pero la misma lógica que hizo relevante el estado de la flota también limita lo que ese paso podría demostrar sobre terminales en peores condiciones. En una campaña hipotética, observar una actualización exitosa en baterías en buen estado y conexiones de radio estables respaldaría una afirmación sobre esa muestra probada. Dejaría abierta la incógnita sobre cómo se comporta el candidato en baterías envejecidas o conexiones de radio débiles.
Existen al menos dos respuestas defendibles a esa brecha. Un equipo podría mantener la ampliación restringida a poblaciones suficientemente similares a la muestra observada, aceptando una cobertura más lenta y dejando los terminales degradados pendientes. O podría buscar evidencia orientada a las condiciones degradadas, como una validación controlada del comportamiento relevante de la batería y la recuperación, antes de considerar esos terminales. El segundo camino exige más trabajo; el primero acepta una conclusión más estrecha. Ninguno de los dos hace que una muestra segura sea representativa por mera declaración.
Por eso trato a STAGED-CANARY como una solicitud de evidencia específica, no como un sinónimo suave de GO. Un plan por etapas debe detallar lo que justificarán sus observaciones y dónde se detendrán. Sin ese alcance, un proceso que parece cauteloso puede seguir produciendo una conclusión excesivamente amplia.
Aquí está la guía paso a paso del fundador sobre estas decisiones de lanzamiento de medidores inteligentes en MeterGuard.
El explicador de MeterGuard muestra el flujo de trabajo previo al lanzamiento y sus registros de decisión. Mi postura de diseño es mantener el comportamiento estimado, la población evaluada, las exclusiones y la regla declarada junto a la recomendación. Para un responsable de lanzamiento, la prueba consiste en si el siguiente paso propuesto resuelve la incertidumbre que motivó la pausa. Si solo observa las condiciones más fáciles mientras la decisión atañe a las más difíciles, el límite todavía está esperando evidencia.