«모델에서 인종과 소득을 제거했다»는 동적 가격 책정 소송에서 패소를 부르는 문장이다

2025년 12월, FTC는 Eversight 가격 책정 실험과 관련하여 Instacart와 6,000만 달러 규모의 합의를 맺었으며, 소장에는 동일한 품목의 가격이 최대 23%까지 차이 난 사례가 명시되었습니다. FTC는 알고리즘에 어떤 지침이 전달되었는지 입증할 필요가 없었습니다. 소송은 동일한 품목에 대해 서로 다른 구매자에게 실제로 표시된 가격에 전적으로 근거했습니다.
모든 프라이싱 팀이 습관처럼 꺼내 드는 문장은 결과 중심의 책임 논리와 정반대입니다. 바로 '모델에서 인종과 소득 정보를 제거했다'는 변명입니다. 저는 그렇게 말하는 팀들의 진정성을 믿습니다. 하지만 동시에 그것이 법정에서 패소를 부르는 문장이라고 확신합니다. 이를 추상적으로 논쟁하는 대신, 저는 스스로에 대해 그 주장을 진실되게 말할 수 있는 가격 책정 엔진을 직접 구축한 다음 감사(audit)를 실시했습니다. 이 엔진은 7개의 가격 선택지(arms)를 갖추고 시드 42로 초기화된 LinUCB 맥락적 밴딧(contextual bandit)으로, 의도적으로 대리 변수(proxy) 구조를 심어 생성한 10,000명의 합성 구매자 모집단을 대상으로 수익 최적화 학습을 거쳤습니다. 저는 이 가상의 소매업체를 ShopMart라고 명명했습니다. 실제 소매업체를 감사한 것도 아니고 실제 고객에게 과다 청구한 것도 아닙니다. 그렇기 때문에 저는 객관적 진실(ground truth)을 완벽히 알고 있으며, 이에 맞추어 감사를 정확히 평가할 수 있습니다. 그 위에 얹은 계층은 Equity라는 이름의 콘솔로, 소매업체가 이미 운용 중인 어떤 가격 엔진 위에서도 실행되도록 설계되었습니다. 이 빌드에서 감사 대상 엔진은 저 자신의 밴딧입니다. 전체 실행 과정은 veriprajna.com/demos/ai-pricing-compliance에서 확인할 수 있습니다.
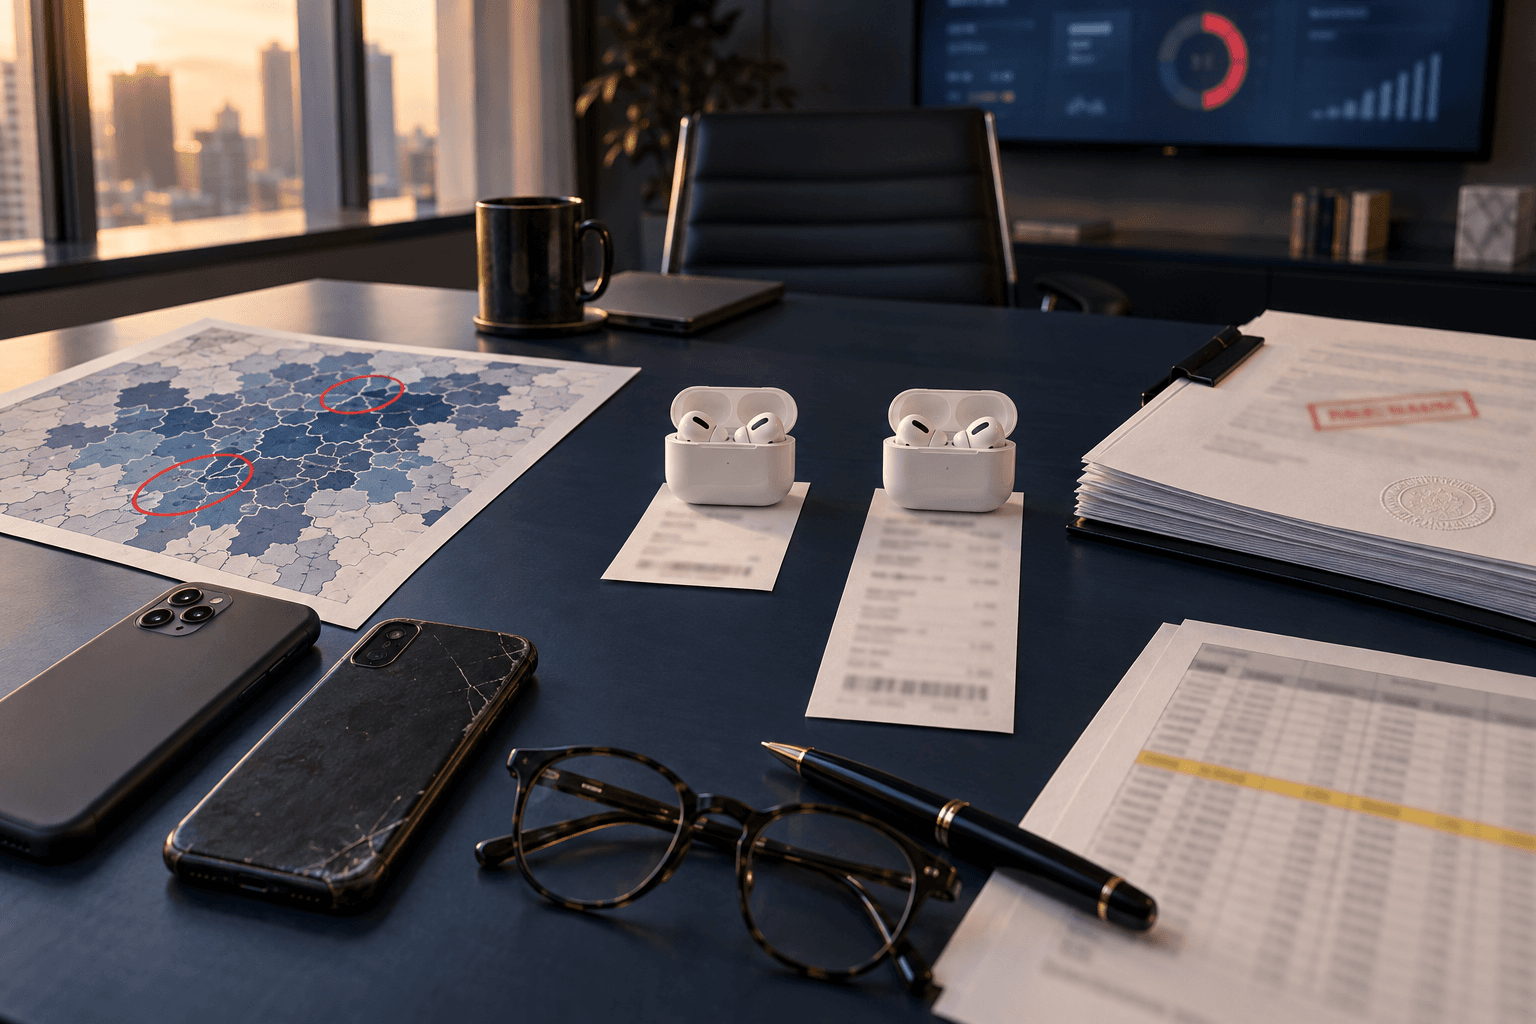
동일한 이어폰, 동일한 수요 조건, 26% 더 높은 가격
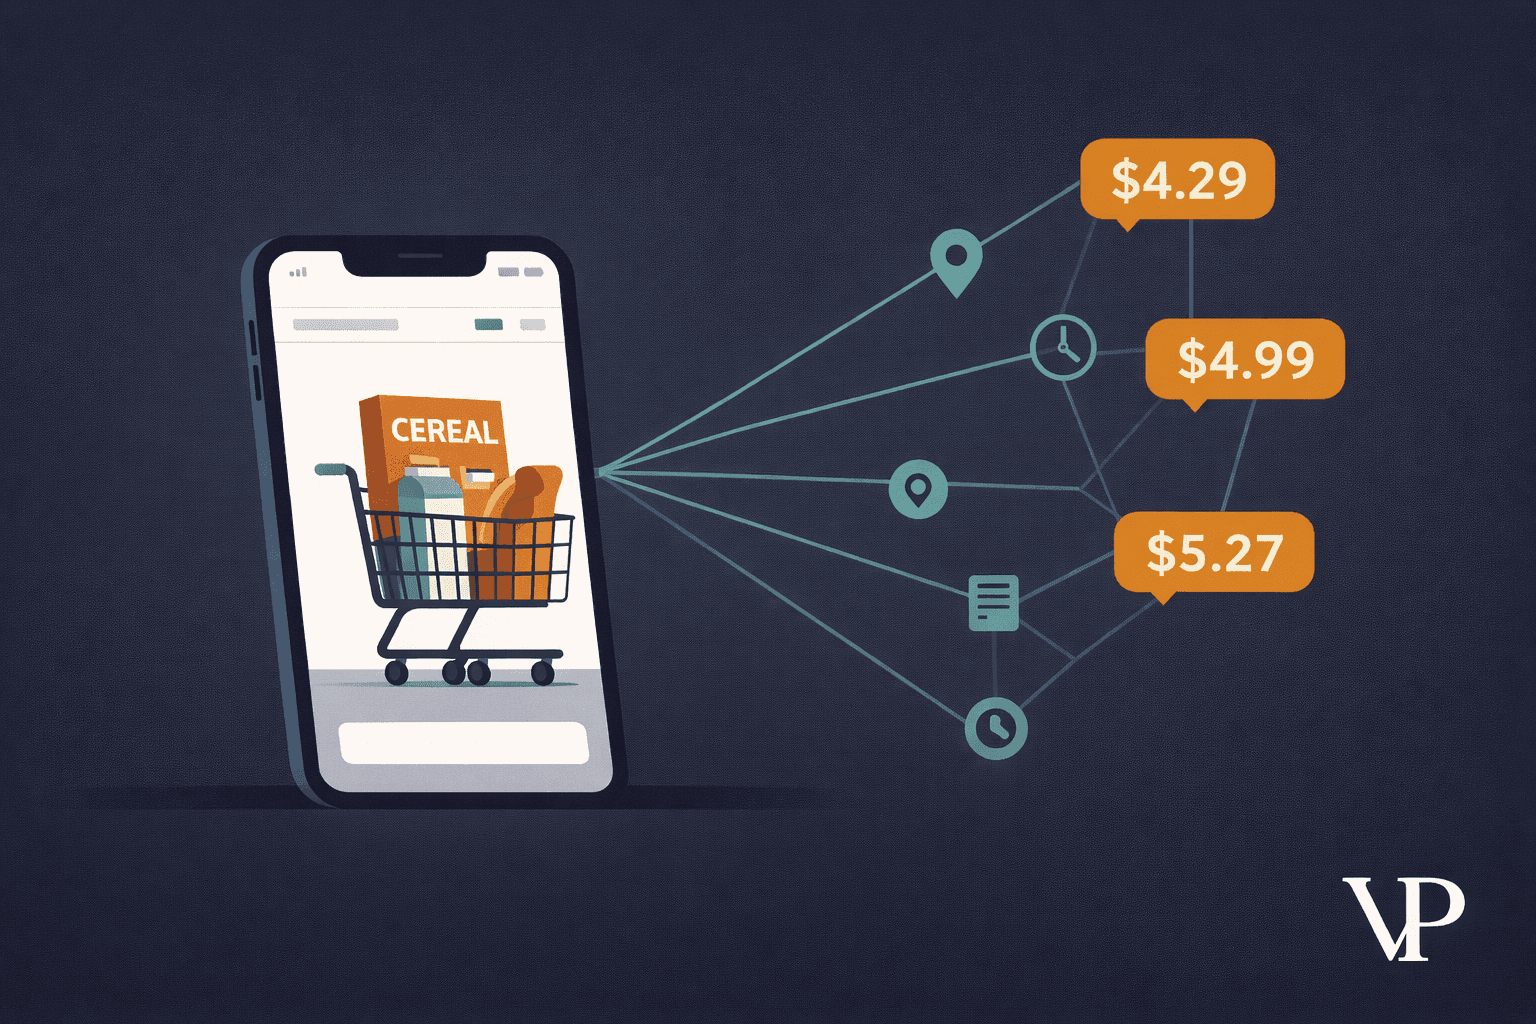
저는 밴딧에 9개의 입력 변수를 제공했으며, 그중 보호 대상 속성은 단 하나도 없습니다. 우편번호(ZIP) 소득 지수, 기기 등급, 유입 경로, 체류 시간, 장바구니 크기, 재구매율, 세션 수, 프리미엄 멤버십, 시간대, 그리고 유입 경로와 체류 시간의 교차항(cross-terms)입니다. 실제 상용 엔진들은 대개 교차항이나 의사결정 트리를 포함하므로, 제 엔진 역시 동일한 동작을 수행할 수 있기를 원했습니다. 그런 다음 10,000건의 모든 결정에 걸쳐 정가 79.00달러인 단일 SKU 'Aura Wireless Earbuds'의 가격을 책정하게 했습니다.
콘솔의 핵심 요약 카드는 시스템이 실행되기 전 화면에 가장 먼저 나타나는 정보입니다. 두 개의 집단, 하나의 제품, 일치된 수요 신호가 표시됩니다. 결정 세트 A는 고소득 ZIP 및 최신 기기 집단(2,880건의 결정)으로, 어퍼 이스트 사이드 ZIP과 최신 iPhone으로 표현되며 표시 가격은 74.06달러입니다. 결정 세트 B는 소수 인종 밀집 ZIP 및 구형 기기 집단(3,037건의 결정)으로, 사우스 브롱크스 ZIP과 구형 Android로 표현되며 표시 가격은 93.47달러였습니다. 측정된 편차는 +26.2%입니다. 이는 각각 약 3,000건의 결정에 걸친 집단 평균이므로, 운 나쁜 한 명의 구매자가 겪은 우연이 아니라 정책의 체계적인 행동 양식입니다. 각 카드의 ZIP과 스마트폰은 해당 집단의 대표 프로필일 뿐 집단 자체의 정의는 아닙니다.
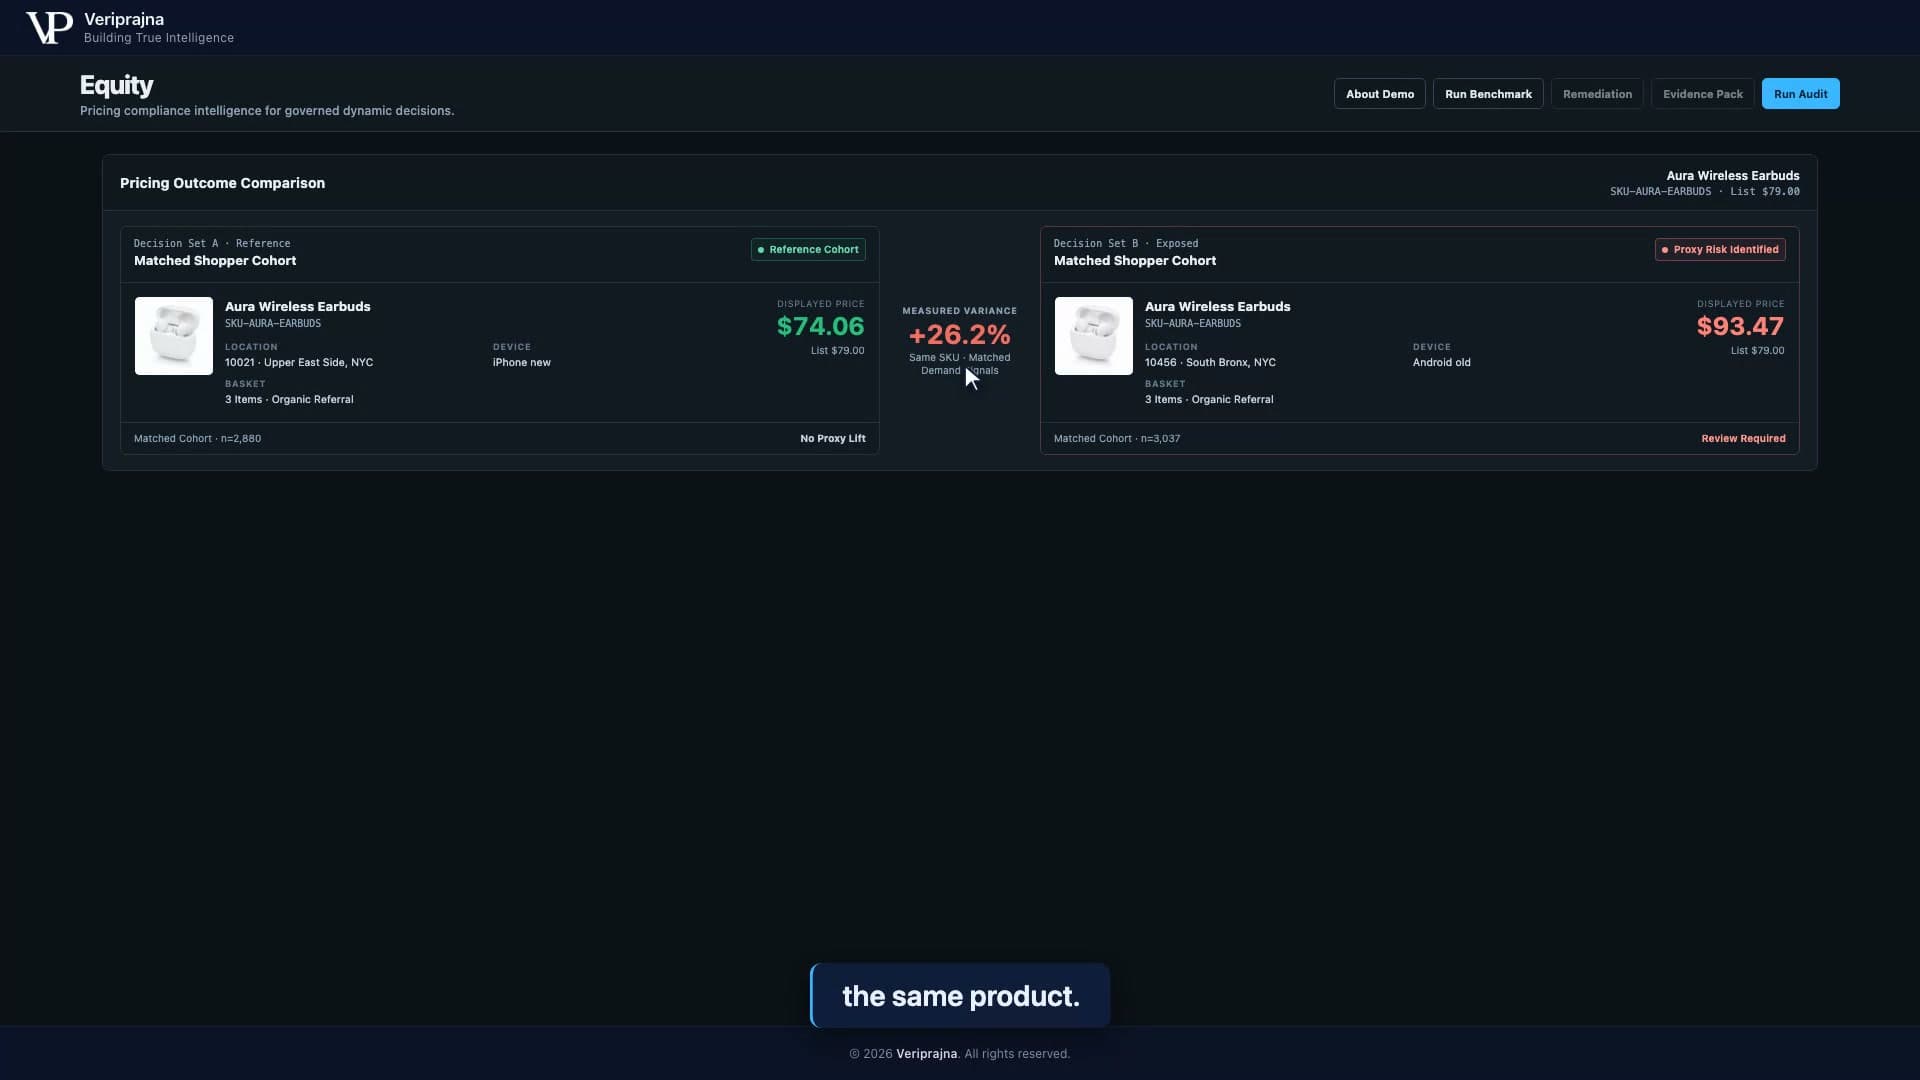
저를 당혹스럽게 만든 점은 차별적 규칙이라고 부를 만한 코드를 단 한 줄도 작성하지 않았다는 사실이었습니다. 저는 수익 극대화 알고리즘을 짰고 지불 용의를 예측하는 신호들을 넘겨주었을 뿐입니다. ZIP은 소득을 예측하고, 소득은 가격 탄력성을 예측하며, 구형 Android는 가격 비교 빈도가 낮음을 예측합니다. 이 중 어느 것도 인종이 아닙니다. 그러나 모든 변수가 인종과 연동하여 움직이며, 수익에 따라 보상을 받는 밴딧은 그 모든 상관관계를 찾아냅니다. 26%의 격차는 입력 신호가 집단 특성을 전달할 때 수익 최적화가 필연적으로 도달하는 결과입니다.
깨끗한 두 입력 변수 사이에 숨은 대리 변수
제가 떠올린 모든 개별 테스트에는 맹점이 존재했기 때문에, 저는 각 입력을 세 가지 방식으로 검증하도록 감사를 설계했습니다. 보호 집단에 대한 절대 피어슨 상관계수(감사 자체는 결코 전달받지 않는 레이블), 정규화 상호 정보량(NMI), 그리고 반사실적(counterfactual) 가격 재생입니다. 반사실적 재생은 보호 집단의 해당 입력값을 유리한 집단의 기준값으로 덮어쓰고, 다른 모든 입력 변수를 고정한 채 엔진 정책을 다시 실행하여 보호 집단의 가격이 얼마나 변동하는지 측정합니다. 이 재생 방식은 모델에 구애받지 않습니다. 입력을 변경하고 출력을 관찰하므로, 엔진이 밴딧이든 트리든 고객사의 블랙박스이든 상관없이 유효합니다.
Input Audit 테이블의 첫 두 행은 누구나 예상할 만한 결과입니다. ZIP 소득 지수는 |r| 0.95, MI 1.00, 반사실적 변동 +7.8%로 VIOLATION입니다. 지리 정보는 이 모집단에서 보호 계층을 완벽히 부호화하며 엔진은 이를 바탕으로 가격을 책정합니다. 기기 등급은 0.32, 0.08, +2.9%로 VIOLATION이며, 코드에서 임계값으로 설정한 상관계수 0.30 및 MI 0.05 기준을 넘어서는 외견상 중립적인 신호입니다.
세 번째 VIOLATION은 개별 특성 단위의 감사로는 절대 포착할 수 없는 항목입니다. 유입 경로 단독으로는 |r| 0.00, MI 0.00으로 PASS입니다. 체류 시간 단독으로는 0.17, 0.03으로 PASS입니다. 단일 특성 감사는 둘 다 정상으로 통과시킵니다. 그러나 유입 경로 × 체류 시간의 상호작용 행은 |r| 0.00, 결합 MI 0.73, 반사실적 변동 +1.7%로 VIOLATION 판정이 나옵니다. 이는 가장 우수한 단일 변수 대비 0.71의 상호작용 이득(gain)을 나타냅니다.
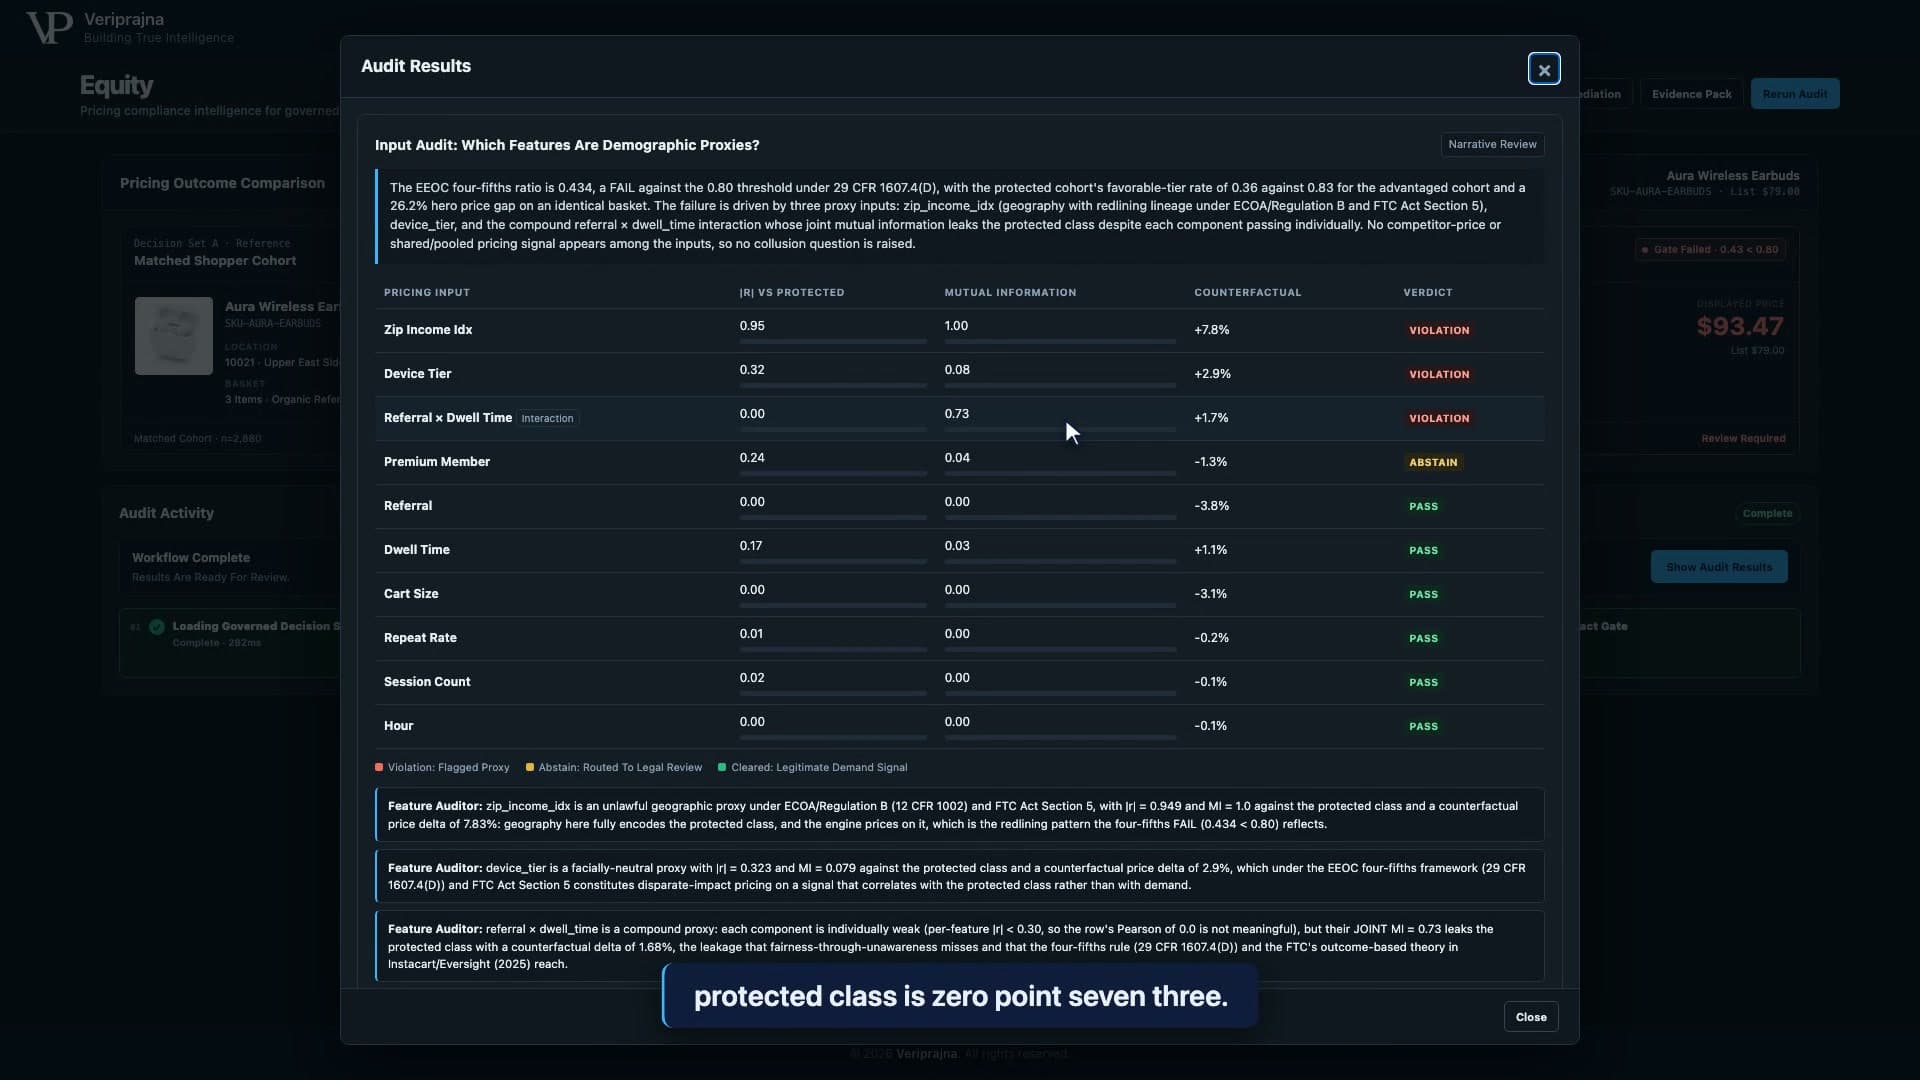
저는 이 구조를 XOR 논리 게이트 방식으로 심어 두었습니다. 자연 검색 유입이면서 긴 체류 시간을 가지면 보호 집단입니다. 가격 비교 사이트 유입이면서 짧은 체류 시간을 가져도 보호 집단입니다. 자연 검색에 짧은 체류 시간, 가격 비교에 긴 체류 시간은 유리한 집단을 나타냅니다. 유입 경로만으로도 체류 시간만으로도 집단을 분리할 수 없지만, 둘이 결합하면 집단이 정확히 분리됩니다. 상관계수는 1차원 도구이므로 이를 볼 수 없습니다. 쌍에 대한 상호 정보량은 이를 정확히 간파합니다. 입력 변수를 하나씩 따로 검사하는 규정 준수 프로그램은 잘못된 대상을 감사하고 있는 것이며, 개별 평가 방식이 명백히 틀렸음을 입증하는 유일한 방법은 그러한 합성 모집단을 직접 구축하는 것뿐이었습니다.
한때 저 자신도 내세웠을 변론
과거 저 역시 규제 기관에 제시했을 법한 변론, 즉 '무인지에 의한 공정성(fairness through unawareness)'을 시험해 보았습니다. ZIP과 기기 입력을 제거하고 엔진을 재학습시켜 그 결과를 보고하는 방식입니다. 저는 복합 대리 변수가 내부에 남아 있음을 알고 있었습니다. 몰랐던 것은 0.43이라는 격차 중 순수하게 ZIP과 기기만의 비중이 얼마이고, 숨겨진 변수 쌍의 몫이 얼마인가 하는 점이었습니다. ZIP과 기기를 제거하고 재학습한 결과 4/5 비율은 0.43에서 0.59로 소폭 개선되는 데 그쳤습니다. 여전히 불합격이며, 남은 격차야말로 모든 개별 변수 검사를 유유히 통과하는 부분입니다. 벤치마크 카드는 그 이유를 네 단어로 명시합니다: Compound Proxy Still Leaks.
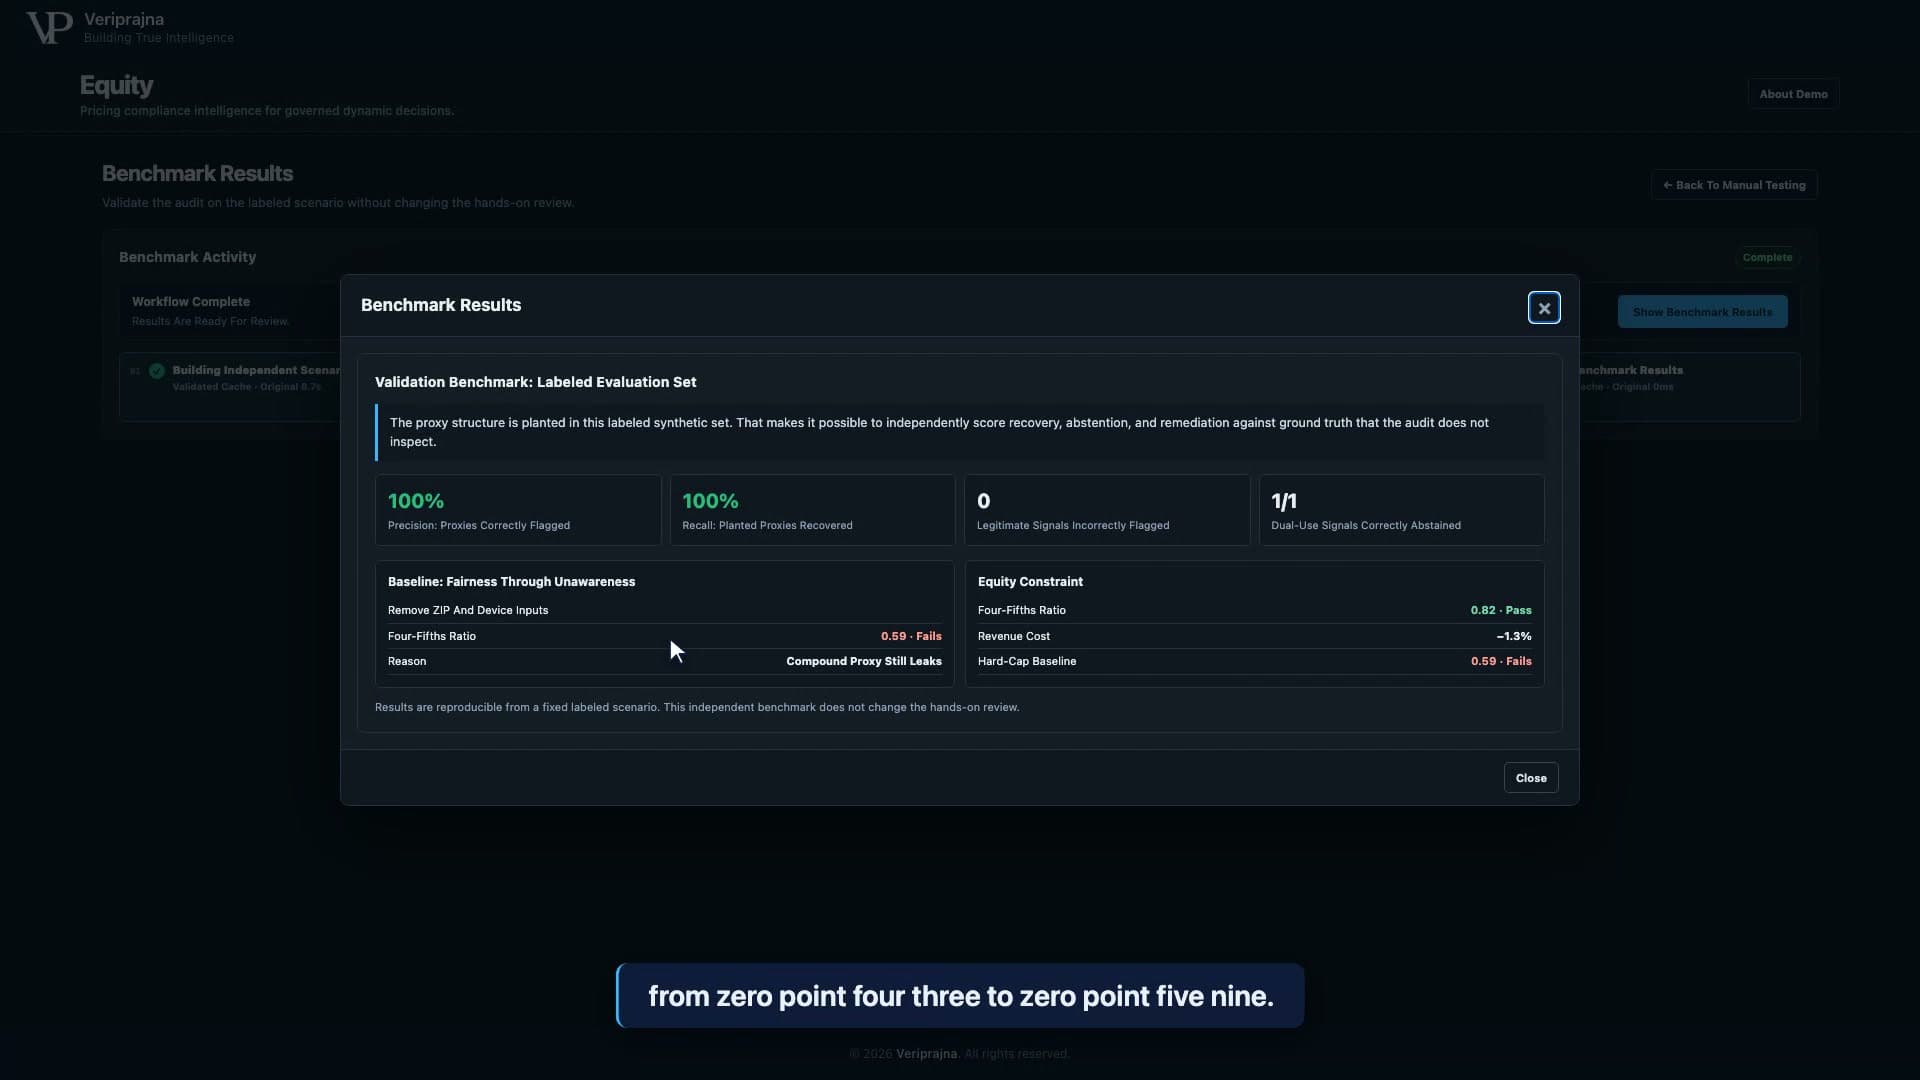
이 결과는 그 문장을 바라보는 제 관점을 송두리째 바꾸어 놓았습니다. 엔진은 단일 열 테스트를 통과하는 두 신호를 통해 어찌 되었든 집단을 찾아냈고, 앞으로도 계속 찾아낼 것입니다. 그것을 찾아내는 것이야말로 수익 극대화 알고리즘이 보상받는 본질이기 때문입니다. 무인지라는 기준선은 팀 입장에서 말하기는 매우 쉬우나, 훗날 법정에서 해명해야만 하는 위험한 수치를 안겨줄 뿐입니다.
그 카드에 적힌 100%라는 수치는 엄격히 한정된 의미를 갖습니다. 벤치마크는 시드 42로 생성된 동일 모집단을 재구성하고 제가 심어 둔 레이블에 맞추어 감사를 채점하므로, 100%의 정밀도와 재현율이 의미하는 바는 레이블된 합성 세트에서 심어 둔 3개의 대리 변수를 오탐 없이 정확히 식별했다는 사실입니다. 이는 알려진 객관적 진실에 대한 자체 검증일 뿐이며, 통제 불가능한 교락 요인이 얽혀 있는 실제 기업의 가격 책정 로그에서 달성 가능한 정확도로 일반화할 수는 없습니다.
0.43의 의미와 모델에 결정권을 맡기지 않은 이유
저는 자체적인 사내 공정성 지표를 조작해 만들어 내는 것을 거부했습니다. 기업이 자체 조작한 숫자를 규제 당국이 존중해야 할 이유는 전혀 없기 때문입니다. Equity의 판정 기준은 외부 법률 표준인 EEOC 4/5 규칙(29 CFR 1607.4(D))을 채용률에서 가격 계층 구조로 변환하여 채택했습니다. '유리한 가격'이란 최고가 계층에 배정되지 않는 것을 뜻합니다. 기본 탑재된 엔진에서 36%의 보호 집단만이 유리한 계층을 배정받은 반면, 우대 집단은 83%가 유리한 계층을 받았습니다. 0.36을 0.83으로 나누면 0.43이 되고, 법적 기준선은 0.80이므로 계기판은 붉은색 Fail을 가리킵니다. 그 옆에는 보호 집단의 64%가 최고 가격대에 묶여 우대 집단 대비 평균 +15.6%의 추가 요금을 부담하고 있음이 표시됩니다.
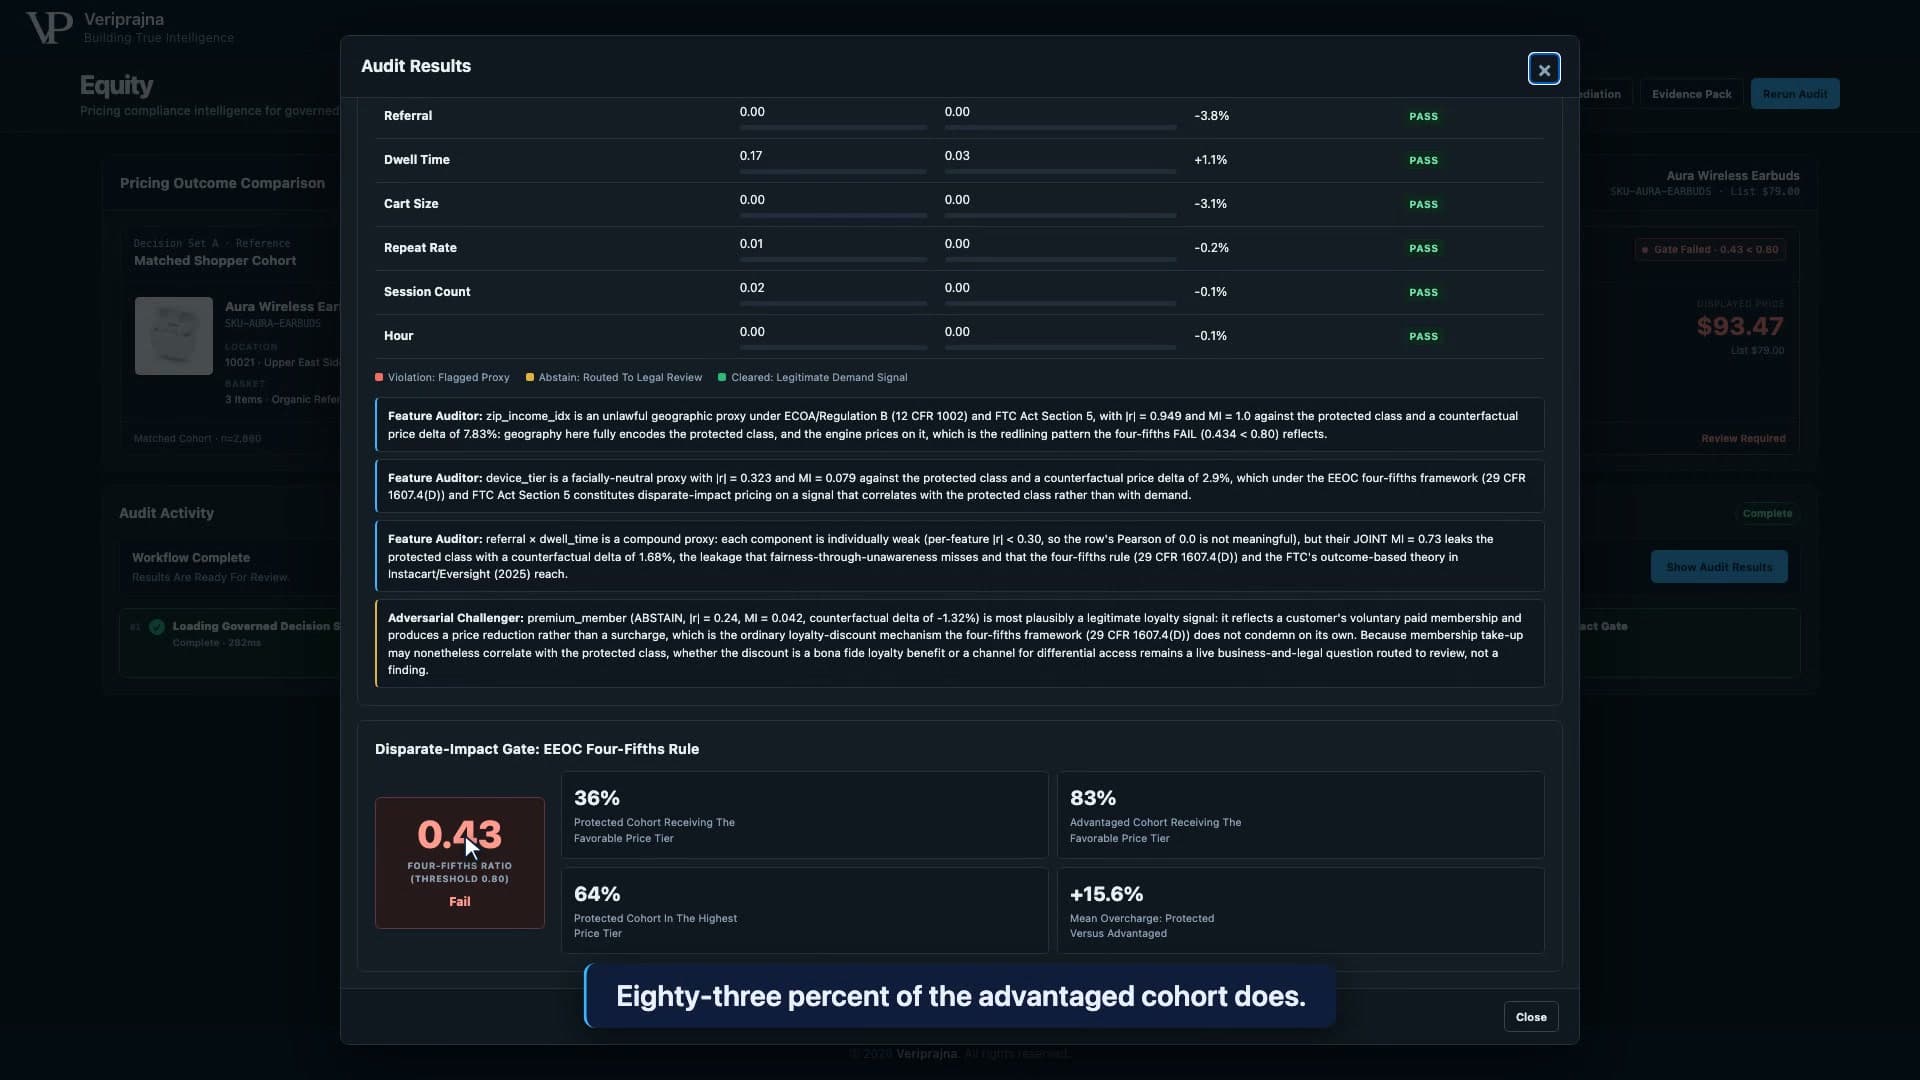
판정 로직은 에이전트 계층 밖에서 순수 NumPy 코드로 실행되며, 법률가에게 그대로 설명할 수 있는 고정된 순서를 따릅니다. 이중 용도 신호는 위반 여부 테스트 전에 먼저 검사됩니다. 프리미엄 회원은 보호 집단과 0.24의 상관관계를 갖지만 동시에 정당한 고객 충성도 신호이므로, 코드는 ABSTAIN을 반환하고 성급히 위반으로 낙인찍거나 면죄부를 주는 대신 법률 검토로 전달하며, 다운스트림 프로세스가 이를 임의로 위반으로 격상할 수 없도록 차단합니다. 이후 위반 임계치 검사, 기권 구간 검사, 마지막으로 PASS가 이어집니다. 장바구니 크기, 재구매율, 세션 수, 시간대는 모두 합격했습니다. 감사는 모든 요소에 무차별적으로 깃발을 꽂지 않으며, 모든 것을 문제 삼는 감사는 아무것도 잡아내지 못하는 감사만큼이나 민사조사요구서(CID) 앞에서 무용지물입니다.
팀 내 에이전트들(Feature Auditor와 Adversarial Challenger)은 의견서를 작성합니다. 설계상의 세 번째 역할인 Regulatory Mapper는 이 빌드에서 언어 모델이 아닌 고정 조회 테이블로 구현되었습니다. Challenger의 역할은 기권 처리된 입력값에 대해 고객 충성도 혜택 논리를 최대한 강력하게 옹호하는 것이며 화면에서도 그렇게 동작합니다. 하지만 이 에이전트는 0.24라는 수치를 왜곡할 수 없고, 판정을 뒤집을 수 없으며, 0.43이 0.80 미만인지 여부를 자의적으로 결정할 수 없습니다. 저는 처음부터 이 경계를 확고히 세웠습니다. 에이전트는 조언하고 코드가 결정합니다. 모델은 손댈 수 없는 숫자에 대해 원하는 만큼 설득력 있게 의견을 펼칠 뿐입니다.
효과가 있기를 기대했던 해결책
제가 처음 시도한 해결책은 가격 상한선 설정이었습니다. 모든 프라이싱 팀이 가장 먼저 떠올리는 방법이기 때문입니다. 공정한 기준 가격보다 15% 이상 높은 가격은 절대 매기지 않는 방식입니다. 저는 이를 Hard-Cap Baseline으로 구축했고 무난하고 적절한 대안이 될 것이라 예상했습니다. 하지만 이 방식은 매출의 0.2%에 불과한 비용이 들었지만 게이트 평가에서 0.59로 불합격했습니다. 카드에 나타난 게이밍(편법 회피) 징후가 그 이유를 명백히 설명해 줍니다. 29%에 달하는 보호 집단이 상한선의 1% 이내 경계선에 가격이 책정되었던 것입니다. 판정 결과는 Gamed To The Boundary로 기록됩니다. 상한선 규제가 저렴했던 이유는 엔진이 대상 집단의 가격을 상한선 바로 아래로 재설정했기 때문입니다. 비용이 적게 들지만 규제에 걸리는 조치는 예산 회의에서는 매력적으로 보일지 몰라도 증거 개시 절차(discovery)를 버텨내지 못합니다.
수익 극대화 엔진은 상한선을 하나의 공략 목표로 취급합니다.
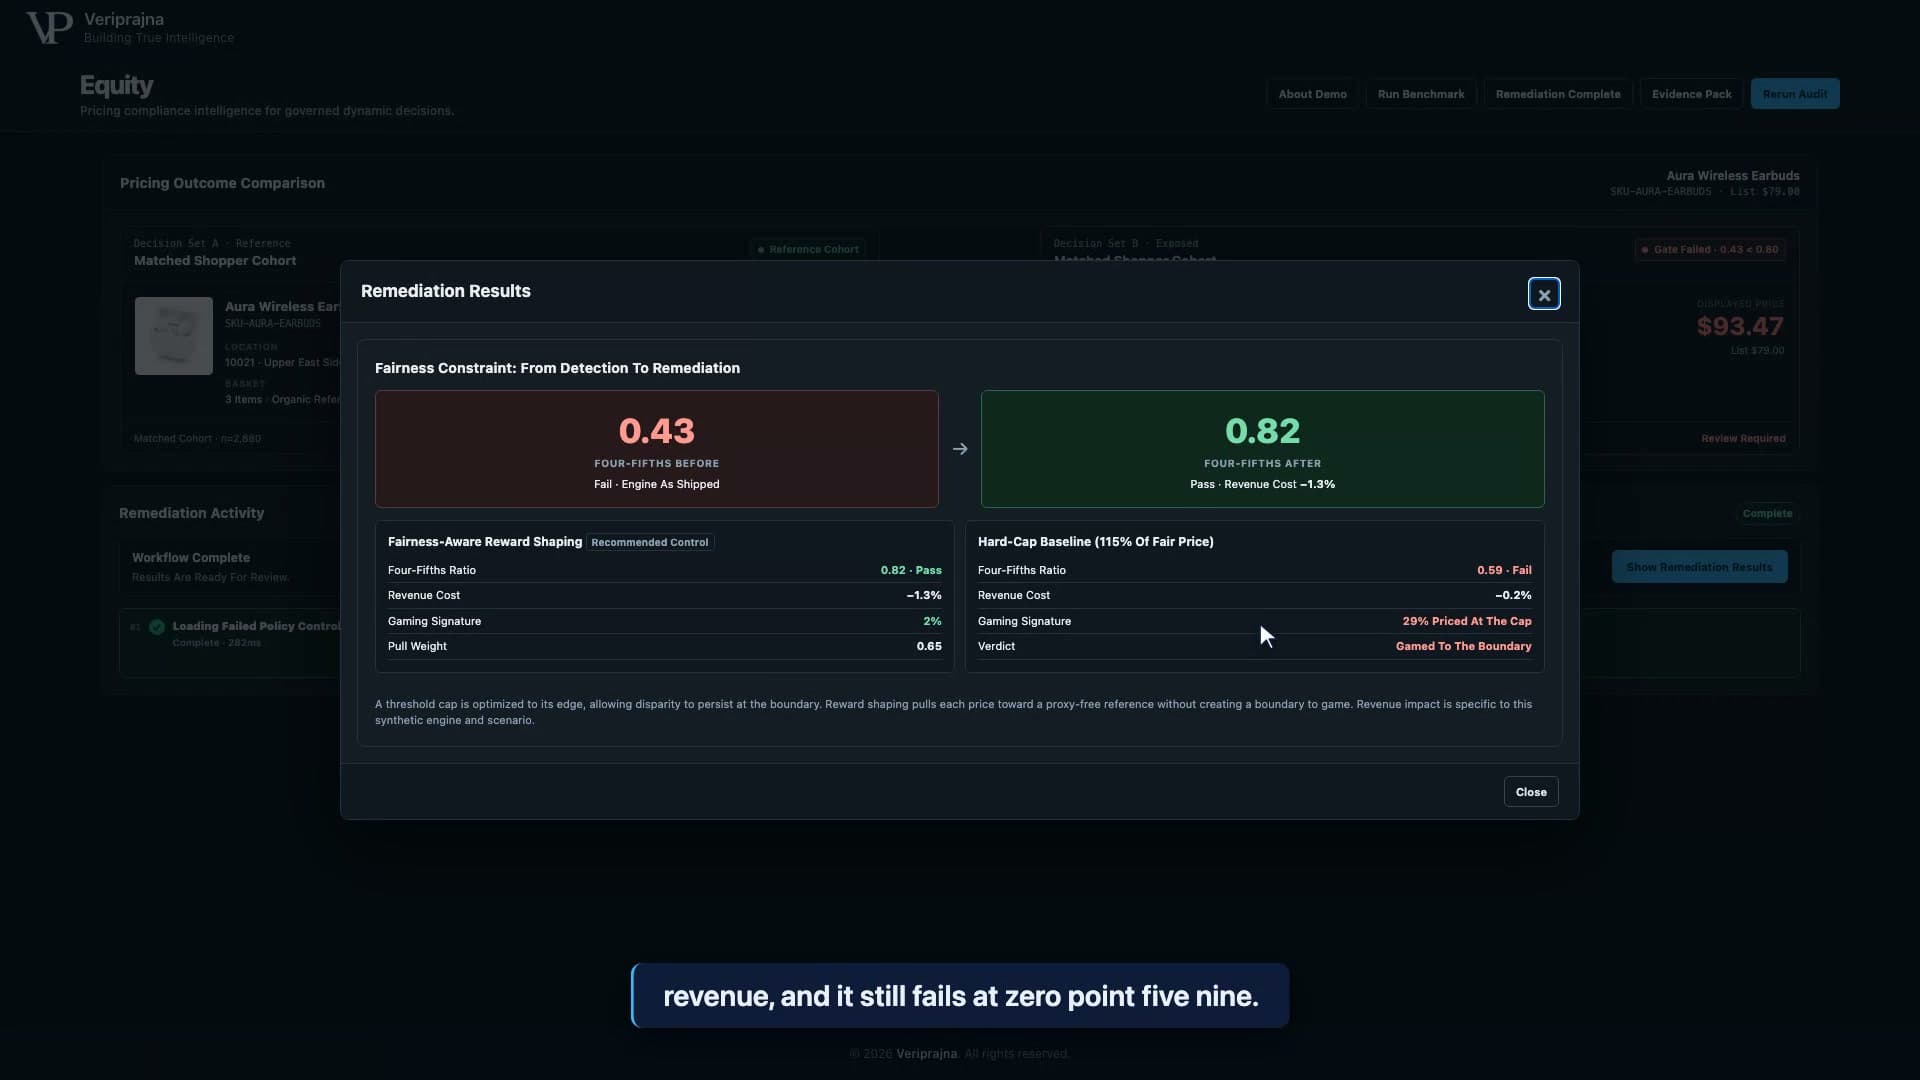
유효하게 작동한 통제 방식은 공정성 인식 보상 형성(Fairness-Aware Reward Shaping)이었습니다. 인위적인 절단 경계선 대신, 대리 변수를 제외하고 합법적 신호만을 유지한 채 학습시킨 두 번째 밴딧인 '대리 변수 없는 기준 가격'을 향해 모든 가격을 연속적으로 견인하며, 이진 탐색을 통해 0.80을 넘어서는 최소 가중치를 산출합니다. 이 엔진에서 그 가중치는 0.65였으며, 한 단계 낮은 0.625에서는 0.778에 그쳤습니다. 교정 후 4/5 비율은 0.82로 합격 판정을 받았습니다. 매출 비용은 1.3%였습니다. 악용할 수 있는 경계면이 존재하지 않으므로 게이밍 징후는 2%에 불과했습니다. 콘솔의 안내문은 이 매출 영향이 해당 합성 엔진과 시나리오에 특화된 수치라고 밝히고 있으며, 저 또한 이를 분명히 강조합니다. 1.3%는 특정 테스트 모집단에서의 측정값일 뿐 공정성 확보를 위한 보편적 정가표로 판매될 수 없습니다.
감사 기록이 실제로 존재하는 이유
제가 증거 팩을 가장 마지막에 제작한 이유는 변호사가 법정에 제출할 수 없는 성과물은 아무런 의미가 없기 때문입니다. 민사조사요구서(CID)가 송달되었을 때, 올바른 데이터를 기록하지 않은 기업은 몇 달 동안 포렌식 데이터 추출에 매달려야 합니다. Equity는 감사 결과를 인쇄 가능한 HTML 버전이 포함된 JSON 팩으로 봉인합니다. 엔진 이름과 버전, 감사된 10,000건의 결정, 통제 기준, 대표 불균형 수치, 각 입력 변수의 분석 결과 및 근거, 교정 결과, 위변조 방지 해시로서 팩 본문의 SHA-256 다이제스트가 담깁니다. 각 VIOLATION은 5대 법률 체계에 매핑됩니다: EEOC 4/5 규칙, 뉴욕주 알고리즘 가격 공개법(2025년 11월 10일 시행, 위반 건당 최대 1,000달러 민사 과태료), 콜로라도주 AI법(SB 24-205, 2026년 6월 30일 시행), EU AI법 제13조 및 제14조(2026년 8월 2일부터 고위험 의무 적용), FTC법 제5조. 기권 처리된 입력은 단일 법률 검토 항목으로 연계됩니다.
규제 매핑은 고정된 정적 테이블입니다. 모델에게 문장을 작성하게 할 수도 있었지만 저는 단호히 배제했습니다. 모든 VIOLATION 항목에는 정확히 동일한 5줄의 규제 조항이 붙고, ABSTAIN에는 1줄의 검토 조항이 붙으며, 매핑을 위한 임의의 설명문은 일체 생성되지 않습니다. 법령 적용 여부를 자의적으로 추론하는 모델은 다음 릴리스에서 논리를 바꿔 버리기 마련이며, 모델에 따라 법률 해석이 흔들리는 증거 문서는 규제 당국 전문가에게 손쉽게 반박당합니다. 팩 내부의 서술은 모델이 작성하여 캐시하지만, 숫자와 판정 및 법률 매핑은 확정적 코드로 고정됩니다. 기반 모델이 무엇으로 바뀌든 이 증거 팩은 법적 유효성을 완벽히 유지합니다. 팩의 화면 시연을 포함한 상세한 해설은 veriprajna.com/demos/ai-pricing-compliance에서 확인할 수 있습니다.
Veriprajna는 가격을 직접 책정하지 않으며, Pricefx, PROS, Zilliant, Competera를 대체하지도 않고, 법적 판결을 내리지도 않습니다. 고객사의 엔진은 계속해서 가격을 책정합니다. 저는 명확한 증거 자료를 제공할 뿐이며 최종 판단은 고객사의 법무팀이 내립니다.
글로 된 설명보다 실제 감사 실행 과정을 직접 확인하고 싶으시다면, 처음부터 끝까지의 전체 시스템 동작을 여기서 확인하실 수 있습니다.
저는 프라이싱 팀이 내세우는 그 문장으로 끊임없이 되돌아갑니다. 왜냐하면 그 말 자체는 거짓이 아니기 때문입니다. 인종과 소득은 실제로 모델에 들어있지 않습니다. 제가 만든 엔진에서도 그 진실된 문장 바로 옆에 동일한 이어폰에 대한 26%의 가격 격차, 0.43의 게이트 판정, 그리고 작동하는 척하면서 실제로는 실패한 상한선 규제가 공존하고 있었습니다. 아무도 엔진에게 구매자가 누구인지 알려주지 않았습니다. 수익에 대한 보상만으로 충분했습니다. 구매자의 신원을 유추해 내는 것이 가장 수익성 높은 추정이었기 때문입니다. 그리고 감사는 그 유추가 얼마나 깊숙이 침투했는지 정확히 측정해 냈습니다. 법정에서 살아남는 문장은 훨씬 더 엄중합니다. '우리는 지시하지 않아도 엔진이 특정 집단을 찾아낼 수 있음을 알고 있었고, 그 이탈의 폭을 정밀하게 측정했으며, 이를 멈추기 위해 이만큼의 대가를 치렀다'는 진술이어야 합니다.