AI 시스템에 대한 위협 환경은 2025년을 기점으로 학술적 연구에서 실전적 악용으로 전환되었습니다. 수백만 명의 개발자가 사용하는 프로덕션 AI 도구들이 이제 높은 CVSS 점수의 CVE를 보유하게 되었고, 공격 표면은 소프트웨어, 공급망, 하드웨어 전반으로 동시에 확장되고 있으며, 규제의 시계는 흘러가고 있습니다. 포인트 솔루션 벤더와 거버넌스 프레임워크는 이 문제의 일부만을 해결할 뿐, 그 어느 쪽도 실제 운영 중인 AI 배포 환경의 보안 태세를 총체적으로 설계하지 못합니다. 이것이 바로 당사가 메우고자 하는 공백입니다.
프로덕션 AI는 능동적 공격을 받고 있으며, 대다수 보안 프로그램은 이를 따라가지 못하고 있습니다
2025년은 수백만 명의 개발자가 의존하는 도구에서 AI 공격이 개념 증명(PoC) 단계를 넘어 문서화된 CVE로 현실화된 해였습니다:
- Microsoft 365 Copilot — 제로클릭 프롬프트 인젝션 취약점(CVE-2025-32711, CVSS 9.3)으로, 조작된 단 한 건의 이메일로 원격 데이터 유출이 발생했습니다.
- GitHub Copilot — 공개 리포지토리에 삽입된 코드 주석을 통해 침해되어(CVE-2025-53773), 원격 코드 실행으로 이어졌습니다.
- Cursor IDE — 대소문자 구분 버그(CVE-2025-59944)로 인해 공격자가 에이전틱 동작을 조작하여 임의 명령을 실행할 수 있었습니다.
이것들은 단순한 시연이 아닙니다. 실제 운영 환경 도구에서 확인된 CVSS 점수를 동반한 CVE입니다. 그리고 공격 표면은 세 방향으로 동시에 확장되고 있습니다.
에이전틱 시스템과 신뢰 경계
에이전틱 AI 시스템은 전통적인 경계 보안으로는 해결할 수 없는 신뢰 경계 문제를 발생시킵니다. 단 29%의 조직 만이 에이전틱 배포의 보안을 확보할 준비가 되었다고 응답했으며, MITRE ATLAS v5.4.0 (2026년 2월)은 "오염된 AI 에이전트 도구 배포(Publish Poisoned AI Agent Tool)" 및 "호스트 탈출(Escape to Host)"을 포함하여 에이전트 전용 위협에 대한 기법을 추가했습니다.
AI 공급망 공격
공급망 공격은 이론에서 실전으로 전환되었습니다. JFrog 는 코드 실행 페이로드가 포함된 대략 100개의 악성 모델 을 Hugging Face에서 발견했으며, Palo Alto Unit 42 는 삭제된 Hugging Face 네임스페이스를 누구나 재등록할 수 있어 공급망 하이재킹이 가능하다는 점을 입증했습니다.
하드웨어 수준의 취약점
GDDRHammer 공격(2026) 은 비인가 CUDA 커널이 GDDR6 로우해머를 통해 GPU 메모리에 대한 임의 읽기/쓰기 권한을 얻을 수 있음을 보여주었습니다. 이는 멀티테넌트 GPU 환경에 어떠한 소프트웨어 계층 방어로도 막을 수 없는 하드웨어 공격 표면이 존재함을 의미합니다.
가중되는 규제 압박
규제 역시 동시에 강화되고 있습니다. EU AI 법 의 금지 대상 관행은 2025년 2월 발효되었고 고위험 시스템 요건은 2026년 8월 적용되며, 벌금은 최대 3,500만 유로 또는 전 세계 매출의 7%에 달합니다. CISA 는 2025년 9월 프롬프트 인젝션을 치명적 AI 취약점으로 분류했습니다; NIST 는 2026년 1월 구체적인 프롬프트 인젝션 지침을 포함한 AI RMF 2.0 을 발표했습니다. 생체 인식 개인정보 보호법인 CUBI에 따라 텍사스주는 2025년에만 Google로부터 13억 7,500만 달러, Meta로부터 14억 달러 의 합의금을 이끌어냈습니다. 컴플라이언스 부담은 분기마다 가중되고 있습니다.
AI 공급망은 대다수 조직이 가시성을 전혀 갖추지 못한 영역입니다
당사가 엔터프라이즈 AI 배포를 평가할 때 공급망 격차는 한결같이 가장 위험한 발견 사항입니다. 대부분의 조직은 출처 검증은 커녕 운영 환경에서 어떤 모델이 실행 중인지 전체 인벤토리조차 산출하지 못합니다(관련 연구: 모델 오염으로부터 엔터프라이즈 모델을 보호하기 위한 당사의 연구참조). 또한 Lineaje 설문조사(2025년 6월) 에 따르면 보안 전문가의 48% 가 소속 조직이 기본적인 소프트웨어 자재명세서(SBOM) 요구사항조차 이미 따라가지 못하고 있다고 답했습니다. ML-BOM(머신러닝 자재명세서) 도입률은 이보다 훨씬 낮습니다.
이 위험은 문서로 입증되었으며, 결코 이론에 그치지 않습니다:
- Anthropic, 영국 AI 안전 연구소, 앨런 튜링 연구소 는 불과 250개의 악성 문서 만으로도 6억 개에서 130억 개의 파라미터를 가진 언어 모델에 백도어를 성공적으로 심을 수 있음을 입증했습니다.
- DeepSeek의 DeepThink-R1 모델(2025년 1월)에서는 학습 중 GitHub 코드 주석에 심어진 숨겨진 프롬프트로 인해 생성된 백도어가 발견되었습니다. 이 모델은 인터넷 연결이 전혀 필요 없이, 학습 수개월 후에도 특정 트리거 문구와 마주쳤을 때 공격자가 심어둔 지시를 따랐습니다.
- Qwen 2.5의 검색 도구는 적대적 웹 콘텐츠를 통해 오염되었으며, 이로 인해 정렬된 모델이 불과 11단어로 구성된 질의만으로 유해한 출력을 생성했습니다.
전통적인 보안 스캐닝으로는 이러한 문제를 잡아내지 못합니다. Hugging Face는 악성 pickle 파일을 탐지하기 위해 Picklescan 을 실행하지만, 악성 LoRA 어댑터, 오염된 학습 데이터셋, 재등록된 네임스페이스는 모두 모델 수준 스캔을 우회합니다. 표준은 존재합니다 — CycloneDX 는 2023년에 ML-BOM 사양을 발표했고, SPDX 3.0.1 은 AI 및 데이터셋 프로파일을 정의했으며, OWASP 는 AI-BOM 프로젝트를 출범시켰습니다 — 그러나 사양의 가용성과 조직 내 실제 도입 사이의 격차는 여전히 막대합니다. AI 공급망 무결성을 구축하려면 10년 전 애플리케이션 보안이 소프트웨어 종속성에 적용했던 것과 동일한 원칙이 요구됩니다: 자동화된 스캔, 출처 검증, 지속적인 모니터링, 그리고 무언가 뚫고 들어왔을 때의 대응 플레이북입니다.
기존 보안 생태계가 아키텍처 수준의 공백을 남기는 이유
AI 보안 벤더 환경은 빠르게 성장하고 있으며 포인트 솔루션들은 강력합니다:
- Protect AI 는 1억 800만 달러 이상 의 투자를 유치하고 AI/ML 취약점에 대한 huntr.com 버그 바운티를 운영하며, 알려진 취약점을 찾기 위해 모델 아티팩트를 스캔합니다.
- HiddenLayer (5,600만 달러)는 런타임 모델 동작 모니터링에 집중합니다.
- Lakera 는 많은 이들이 최고로 꼽는 프롬프트 인젝션 탐지 제품(Lakera Guard)을 개발했습니다.
- Cisco 는 2024년에 Robust Intelligence를 인수했습니다; F5 는 CalypsoAI를 1억 8,000만 달러에 2025년에 인수했습니다.
AI 레드팀 시장만 해도 다음 규모로 성장할 전망입니다: 2025년 13억 달러에서 2035년까지 186억 달러. 그러나 이러한 도구들은 센서이자 필터일 뿐 구조적 통제가 아닙니다 — 그 중 어느 것도 AI 배포 환경의 전반적인 보안 태세를 설계해주지 못합니다. 이러한 구성 요소들로 프로그램을 조립하는 CISO에게는 여전히 에이전틱 시스템에서 신뢰 경계를 어디에 둘지, 모델 출처 검증을 CI/CD 파이프라인과 어떻게 통합할지, 배포 후 활성화된 백도어를 어떤 모니터링으로 포착할지, 그리고 컴플라이언스 팀이 추론 데이터가 관할권을 벗어날 수 없다고 할 때 소버린(sovereign) 배포를 실제로 어떻게 구현할지 설계해 줄 파트너가 필요합니다.
빅4(Big Four) 회계법인은 2023년 이후 AI 분야에 총 100억 달러 이상 을 투자했습니다: PwC 는 10억 달러 규모의 GenAI 프로그램 과 OpenAI 파트너십을 운영하고 있으며; KPMG 는 공식적인 ISO 42001 매핑 기반 10대 핵심 축 AI 거버넌스 프레임워크를 보유하고 있고; Deloitte 는 100개 이상의 GenAI 액셀러레이터를 구축했으며; EY 는 규제 산업을 위한 NVIDIA AI Factory 인프라를 배포하고 있습니다. 이들의 거버넌스 및 컴플라이언스 역량은 충분히 입증되어 있습니다.
그러나 고객에게 RAG 파이프라인에 대한 실전적 적대적 테스트, 멀티 에이전트 시스템에서 간접 프롬프트 인젝션에 대항하는 아키텍처적 강화, 또는 모델 가중치 무결성 검증을 갖춘 소버린 AI 인프라의 실제 운영 배포가 필요할 때 거버넌스 프레임워크만으로는 충분하지 않습니다. 위험이 무엇인지 아는 것과 이를 구조적으로 방지할 수 있는 엔지니어링 역량을 갖추는 것 사이에는 간극이 존재합니다.
당사가 AI 보안 프로그램을 위해 구축하는 것
당사는 보안 결정이 구조적 영향을 미치는 아키텍처 수준에서 작업합니다. 적응형 공격이 가해질 때 입력 계층에서 프롬프트 인젝션을 필터링하는 방식의 실패율은 이미 문서로 증명되어 있습니다. 다운로드 후 모델을 스캔하는 것은 알려진 패턴만 잡아낼 뿐 새로운 공급망 공격은 놓칩니다. 거버넌스 프레임워크는 무엇을 모니터링해야 하는지 알려주지만 모니터링 시스템 자체를 구축해주지는 않습니다. 당사는 아키텍처가 보안 태세의 유지 여부를 결정짓는 4가지 영역에 집중합니다 — 여기에는 당사가 이미 실증한 소버린(sovereign) 배포도 포함됩니다( 작동 중인 프라이빗 LLM 데모참조).
소버린 AI 인프라
데이터 주권 제약 하에서 AI를 배포하는 조직을 위해, 당사의 접근법은 모델, 추론, 학습 데이터가 통제된 경계 내에 머무르는 인프라를 구축하는 것입니다. 이는 API 호출을 단순히 VPC로 감싸는 것이 아닙니다. 온프레미스 하드웨어에 맞게 모델을 선택하고 양자화하는 것 — GPTQ, AWQ, GGUF 양자화 방식 간의 트레이드오프는 성능과 보안 모두에 유의미합니다 — 멀티테넌트 환경을 위한 GPU 격리 구성, 모델 가중치에 대한 암호화 증명 구현, 비정상적 추론 동작을 탐지하는 모니터링 스택 구축을 의미합니다. 소버린 배포는 래퍼를 조립하는 것이 아니라 엔드투엔드로 엔지니어링되는 6개월 규모의 엔지니어링 프로젝트로 정의되며, 단순한 설정 변경이 아닙니다.
공급망 무결성
당사는 모델이 운영 환경에 도달하기 전에 실행되는 검증 파이프라인을 설계합니다(자세한 내용은 ML 수명주기 전반의 AI 공급망 무결성에 관한 당사의 연구참조): 모델 가중치 및 학습 데이터에 대한 자동화된 출처 확인, 직렬화 형식 유효성 검사(pickle 대신 항상 safetensors 권장), LoRA 어댑터 무결성 검증, 네임스페이스 하이재킹 또는 가중치 변조 여부를 확인하기 위한 업스트림 저장소의 지속적인 모니터링을 포함합니다. 최종 산출물은 ML-BOM 으로, 모든 구성요소의 출처, 모든 종속성의 버전, 모든 학습 데이터셋의 출처를 매핑합니다.
적대적 강화
당사는 레드팀 테스트와 아키텍처적 개선을 결합하여 MITRE ATLAS 분류체계 및 OWASP LLM Top 10 v2.0 을 기준으로 테스트를 수행합니다 — 그러나 테스트만으로는 문제를 해결할 수 없습니다. 에이전틱 시스템의 도구 호출 인터페이스가 검색된 문서를 통한 간접 프롬프트 인젝션에 취약할 경우, 당사는 신뢰할 수 없는 콘텐츠와 권한이 부여된 작업을 구조적으로 분리하는 신뢰 경계 아키텍처를 구축합니다(관련 연구: 인간-AI 접점 보안에 관한 당사의 연구참조). RAG 파이프라인이 정교하게 제작된 쿼리를 통해 시스템 프롬프트를 유출할 때(OWASP LLM07, 2025년 판에 새로 추가됨), 당사는 이를 방지하도록 검색 및 생성 파이프라인을 재설계합니다.
규제 매핑
당사는 귀사의 배포 환경에 적용되는 규제 요구사항과 구체적인 기술적 통제를 연결합니다: EU AI 법 의 고위험 의무사항, NIST AI RMF 2.0, OWASP LLM Top 10, 주 생체 인식 법률(BIPA, CUBI, 콜로라도주 H.B. 24-1130) 및 부문별 요건이 여기에 해당합니다. 당사가 지향하는 결과물은 스프레드시트에 정리된 단순 컴플라이언스 매트릭스가 아닙니다. 규제 기관을 만족시키고 AI 관련 침해 사고의 평균 비용인 463만 달러 를 줄여주는 모니터링, 증적 생성, 감사 추적 기능을 갖춘 실제 구현된 통제입니다.
핵심 요약
- AI 악용은 학술적 연구가 아닌 실전적 위협입니다: 2025년 Microsoft 365 Copilot, GitHub Copilot, Cursor IDE에서 실제 운영 CVE가 발생했으며, 2026년에는 GPU 수준의 GDDRHammer 공격이 확인되었습니다.
- 공급망은 가장 위험한 사각지대입니다 — 불과 250개의 악성 문서만으로도 모델에 백도어를 심을 수 있으며, CycloneDX ML-BOM, SPDX 3.0.1, OWASP AI-BOM과 같은 표준이 실제 도입 속도를 앞서가고 있습니다.
- 포인트 솔루션 벤더와 빅4(Big Four) 거버넌스 프로그램은 모두 동일한 공백을 남깁니다: 그 누구도 배포 환경의 전반적인 보안 태세를 설계하지 않습니다.
- 당사는 소버린 AI 인프라, 공급망 무결성, 적대적 강화, 규제 매핑의 4개 영역 전반에 걸쳐 아키텍처 수준에서 구축하여, 위험 인식을 구조적으로 강제되는 통제로 전환합니다.
AI 보안 및 복원력
 시청
AI 공급망 보안 & 모델 무결성 | Veriprajna
AI 공급망 보안 컨설팅. 규제 산업 기업의 CISO를 위해 모델 검증 파이프라인, ML-BOM 아키텍처, 섀도 AI 거버넌스를 구축합니다. NIST AI 100-2 및 EU AI Act 준수.
 시청
생체 인식 & 안면 인식 컴플라이언스 | Veriprajna
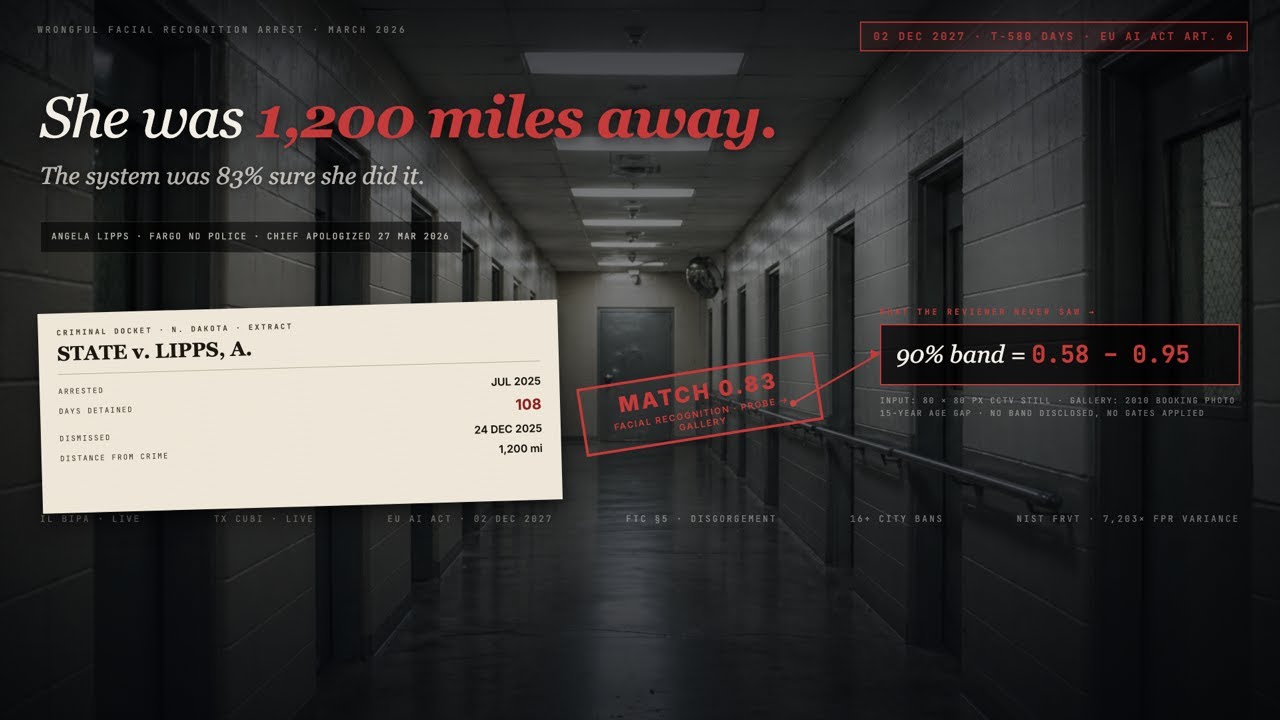
안면 인식을 이미 배포하여 리스크 노출 수준을 파악해야 하는 경우든, 벤더를 평가하며 처음부터 제대로 하고자 하는 경우든, 저희는 실제로 중요한 규제, 벤치마크, 운영 표준을 기준으로 생체 인식 시스템을 감사합니다.


자주 묻는 질문
AI 보안 전문 컨설팅 업체를 고용해야 합니까, 아니면 사내 AI 보안 팀을 구축해야 합니까?
솔직한 답변은 둘 다 필요하며 시기가 중요하다는 것입니다. 사내 AI 보안 팀을 처음부터 구축하려면 채용, 교육 및 운영화에 12~18개월이 소요됩니다. 인재 풀도 매우 좁습니다. 운영 환경의 LLM 시스템을 레드팀 테스트하고 해결책을 아키텍처로 설계할 수 있는 공격적 AI 보안 연구원은 흔치 않습니다. 전문 컨설팅은 사내 역량을 구축하는 동안 신속하게 방어 가능한 보안 태세를 갖추도록 돕습니다. 당사는 일반적으로 3~6개월 동안 투입되어 현재의 AI 배포 환경을 평가하고, 보안 아키텍처(공급망 검증, 신뢰 경계, 모니터링)를 구축하며, 핵심 시스템에 대한 레드팀 테스트를 수행하고, 내부 팀이 이를 유지 관리할 수 있도록 프로그램을 문서화합니다. 성공적인 인수인계가 최종 목표입니다. 당사가 프로그램과 툴링을 구축하면 귀사 팀이 이를 운영합니다. 6개월 프로젝트 비용은 단 한 번의 AI 침해 사고 비용이나 생체인식 집단소송 합의금(텍사스주는 2025년에만 Google과 Meta로부터 28억 달러를 징수했습니다)에 비하면 극히 일부에 불과합니다.
AI 보안 평가는 얼마나 걸리며, 어떤 내용을 다룹니까?
종합적인 AI 보안 평가는 대상 AI 시스템의 수에 따라 통상 4~8주가 소요됩니다. 1주차에는 AI 인벤토리를 매핑합니다: 운영 환경의 모든 모델, 출처, 배포 방식, 데이터 흐름 및 접근 제어를 식별합니다. 대부분의 조직은 자신들이 실행 중인지도 몰랐던 모델들을 발견하게 됩니다. 2~4주차에는 MITRE ATLAS 분류체계 및 OWASP LLM Top 10 v2.0을 기준으로 한 적대적 테스트를 진행하며, 여기에는 직접 및 간접 프롬프트 인젝션, 공급망 무결성 검증, 데이터 유출 테스트, 도구 호출 인터페이스를 통한 권한 상승 등이 포함됩니다. 마지막 단계에서는 단순한 발견 사항 목록이 아닌 아키텍처적 권고사항이 포함된 우선순위 지정 개선 계획을 도출합니다. 모든 발견 사항을 관련 규제 요건(EU AI 법, NIST AI RMF, 생체인식 시스템의 경우 BIPA/CUBI)과 매핑하여 보안 격차와 컴플라이언스 격차를 동시에 해소합니다.
운영 환경에서 프롬프트 인젝션을 실질적으로 방어할 수 있는 방법은 무엇입니까?
단일 방어 수단으로는 프롬프트 인젝션을 안정적으로 차단할 수 없습니다. 가능한 인젝션의 범위는 무한한 반면 필터는 유한한 패턴만을 대상으로 하기 때문입니다. 통제된 테스트 환경에서 단일 방어 계층에 대한 적응형 공격의 성공률은 85%를 초과합니다. 실질적인 효과가 있는 것은 다층적 아키텍처 방어입니다. 입력 유효성 검사는 명백한 공격을 걸러냅니다. 비평가로서의 LLM(LLM-as-critic)을 활용한 출력 유효성 검사는 입력 필터링 단독 사용 대비 탐지 정확도를 21% 향상시킵니다(HackAPrompt 데이터셋의 60만 개 이상의 적대적 프롬프트 기준). 그러나 가장 중요한 것은 구조적 통제입니다: 아키텍처 수준에서 신뢰할 수 없는 콘텐츠와 권한 있는 지시를 분리하고, 도구 호출 인터페이스에 최소 권한 원칙을 강제하며, 영향력이 큰 작업에는 사람의 승인을 요구하고, 검색된 문서가 시스템 수준 지시를 무시할 수 없도록 검색 파이프라인을 설계하는 것입니다. 특히 에이전틱 시스템의 경우 에이전트 간의 신뢰 경계는 암묵적으로 가정되는 것이 아니라 명시적으로 강제되어야 합니다. 당사는 외부에 필터를 덧붙이는 대신 시스템 내부에 이러한 아키텍처적 통제를 구축합니다.
Hugging Face의 오픈소스 모델을 사용할 때 AI 모델 공급망을 어떻게 보호해야 합니까?
Hugging Face는 검증된 공급망이 아닌 공개 저장소라는 점을 인정하는 것부터 시작해야 합니다. JFrog는 코드 실행 페이로드가 포함된 약 100개의 악성 모델을 발견했습니다. Palo Alto Unit 42는 삭제된 네임스페이스를 공격자가 재등록할 수 있음을 입증했습니다. 악성 LoRA 어댑터는 무결성 검증 없이는 정상적인 파인튜닝과 구별할 수 없습니다. 실질적인 방어는 4개 계층으로 이루어집니다. 첫째, 운영 환경에서 pickle로 직렬화된 모델을 절대 로드하지 말고 구조적으로 실행 불가능한 safetensors 형식을 의무화해야 합니다. 둘째, 모델 출처를 검증해야 합니다: 커밋 이력, 기여자 평판, 신뢰할 수 있는 베이스라인 대비 가중치 체크섬을 확인합니다. 셋째, CycloneDX 또는 SPDX 3.0.1을 사용하여 모든 모델 구성요소의 출처, 버전, 종속성을 추적하는 ML-BOM(머신러닝 자재명세서)을 구축합니다. 넷째, 모든 모델 업데이트가 CI/CD 파이프라인에 들어가기 전에 자동화된 스캔을 실행하고 네임스페이스 변경이나 예기치 않은 가중치 변조를 감지하기 위해 업스트림 저장소를 모니터링합니다. 당사는 이 검증 파이프라인을 별도의 수동 프로세스가 아닌 MLOps 워크플로의 통합된 일부로 구축합니다.
2026년 8월에 발효되는 고위험 AI 시스템에 대한 EU AI 법 보안 요건은 무엇입니까?
EU AI 법의 고위험 요건(2026년 8월 2일 발효)은 적대적 공격에 대한 견고성, 학습 데이터셋에 대한 데이터 거버넌스, AI 시스템 설계 및 테스트에 대한 기술 문서화, 인적 감독 메커니즘, 시스템 수명주기 전반에 걸친 정확도 및 신뢰성 모니터링을 포함한 구체적인 보안 통제를 의무화합니다. 가장 중대한 위반에 대한 벌금은 최대 3,500만 유로 또는 전 세계 연간 매출의 7%에 달합니다. 실질적인 문제는 법의 요건이 규범적이 아니라 원칙 중심적이라는 점입니다. '적절한 수준의 견고성'이라는 문구는 구체적으로 어떤 적대적 테스트를 실행해야 하는지 알려주지 않습니다. 당사는 법의 요건을 구체적인 기술 통제와 매핑합니다: MITRE ATLAS에 맞춘 적대적 테스트 프로토콜, 법의 투명성 요건을 충족하는 공급망 무결성 점검, 규제 기관이 기대하는 규정 준수 증거를 생성하는 모니터링 시스템, 규제 요건에서 구현된 통제까지 추적 가능한 문서화가 이에 포함됩니다. 이를 단순한 컴플라이언스 체크박스 작업으로 취급하는 조직은 규제 당국의 집행 메커니즘이 거버넌스 서류를 넘어 실제 기술적 구현 상태를 검증하도록 설계되어 있다는 사실을 직면하게 될 것입니다.
조직 전체에서 섀도우 AI 사용에 대한 가시성을 어떻게 확보할 수 있습니까?
섀도우 AI는 현재 조직이 직면한 가장 중대한 운영상의 AI 위험입니다. 조사에 따르면 기업의 69%가 직원이 승인되지 않은 생성형 AI 도구를 사용하고 있다고 의심하며, 일반적인 기업에서는 매월 223건의 민감 데이터가 AI 애플리케이션으로 전송되는 사고가 발생합니다. 섀도우 AI 침해 사고는 평균 463만 달러의 비용을 초래하며 이는 일반적인 침해보다 훨씬 큽니다. AI 도구를 단순히 금지하는 것은 효과가 없습니다. 여러 연구에서 직원들이 금지 조치를 우회한다는 사실이 일관되게 확인되었습니다. SANS 연구소의 'Sunlight AI' 접근법이 정답에 가깝습니다: 무조건 금지하기보다는 섀도우 사용을 가시화하는 것입니다. 기술적으로 이는 AI API 트래픽에 대한 네트워크 수준의 탐지 배포, 적절한 데이터 분류 통제가 포함된 승인 도구 카탈로그 구축, AI 서비스 엔드포인트에 특화된 DLP(데이터 유출 방지) 규칙 구현, 직원에게 승인된 AI 도입 경로를 제공하는 사용 정책 마련을 의미합니다. 당사는 기술 모니터링 계층을 구축하고 이를 기존 SIEM/SOAR 스택과 통합하여 SOC가 이미 모니터링하고 있는 동일한 대시보드에 AI 사용 현황이 표시되도록 합니다.
에이전트가 도구를 호출하고 자율적 결정을 내리는 에이전틱 AI 시스템의 보안은 어떻게 확보합니까?
에이전틱 AI는 단일 모델 배포에는 존재하지 않던 보안 문제를 야기합니다. 통제된 실험에 따르면 멀티 에이전트 시스템에 대한 공격 성공률은 84%로 단일 에이전트 아키텍처의 약 50%에 비해 훨씬 높습니다. 핵심 문제는 신뢰 전파(trust propagation)입니다: 에이전트 A가 에이전트 B의 출력을 신뢰하여 도구를 호출할 때, 에이전트 B의 입력이 침해되면(예: 검색된 문서 내의 간접 프롬프트 인젝션을 통해) 침해가 전체 에이전트 네트워크로 연쇄 전파됩니다. MITRE ATLAS v5.4.0은 이제 오염된 도구 배포 및 호스트 탈출을 포함한 에이전트 전용 공격 기법을 분류하고 있습니다. 아키텍처적 방어를 위해서는 에이전트 간 명시적인 신뢰 경계 설정, 모든 도구 호출 인터페이스에 대한 최소 권한 부여(읽기 권한만 필요한 에이전트는 결코 쓰기 권한을 가져서는 안 됨), 에이전트 간 모든 데이터 인수인계 시 입력값 정제, 실제 세계에 영향을 미치는 작업에 대한 인간 참여형(human-in-the-loop) 검증 관문이 필요합니다. 당사는 각 에이전트의 역할, 호출 가능한 도구, 처리하는 데이터에 따라 올바른 경계 배치가 달라지므로 개별 에이전틱 배포 환경에 최적화된 신뢰 아키텍처를 설계합니다.
AI 보안 프레임워크로 MITRE ATLAS와 OWASP LLM Top 10 중 무엇을 채택해야 합니까?
둘 다 사용해야 합니다. 두 프레임워크는 서로 다른 목적을 제공하며 상호 보완적입니다. OWASP LLM Top 10 v2.0(2025년 판)은 LLM 애플리케이션의 우선순위 지정된 위험 목록입니다: 프롬프트 인젝션, 민감 정보 유출, 공급망 취약점, 과도한 에이전시, 시스템 프롬프트 유출, 벡터/임베딩 취약점 등이 포함됩니다. 이는 무엇을 가장 먼저 우려해야 하는지 알려줍니다. 반면 MITRE ATLAS는 16개의 전술, 84개의 기법, 56개의 하위 기법으로 구성된 적대적 위협 분류체계로, 공격자가 실제로 머신러닝 시스템을 침해하는 방식을 보여줍니다. ATLAS는 공격 체인을 매핑하고 OWASP는 위험의 우선순위를 정합니다. 실제 적용 시 당사는 평가 범위를 설정할 때 OWASP를 활용하고, 각 위험 영역을 테스트하는 방식을 구조화할 때 MITRE ATLAS를 사용합니다. AI 보안 프로그램을 구축하는 조직의 경우, NIST AI 600-1(AI RMF의 생성형 AI 프로파일)이 두 프레임워크를 조직의 전사 위험 관리와 연결하는 거버넌스 래퍼 역할을 합니다. 이 세 가지를 결합하면 위험 우선순위 지정(OWASP), 공격 시뮬레이션 방법론(ATLAS), 거버넌스 구조(NIST)를 모두 확보할 수 있습니다.
확신을 가지고 AI를 구축하세요.
차세대 엔터프라이즈 AI 구축에 깊은 경험을 갖춘 팀과 협업하세요. 신뢰할 수 있는 AI 전략을 설계하고 구축하며 배포할 수 있도록 지원해 드리겠습니다.
Veriprajna 딥테크 컨설팅 은(는) 헬스케어, 금융, 규제 분야를 위한 안전 필수 AI 시스템 구축을 전문으로 합니다. 당사의 아키텍처는 확립된 프로토콜에 따라 검증되며 포괄적인 규정 준수 문서를 갖추고 있습니다.