엔터프라이즈 게이밍 AI의 포스트 클라우드 시대 설계
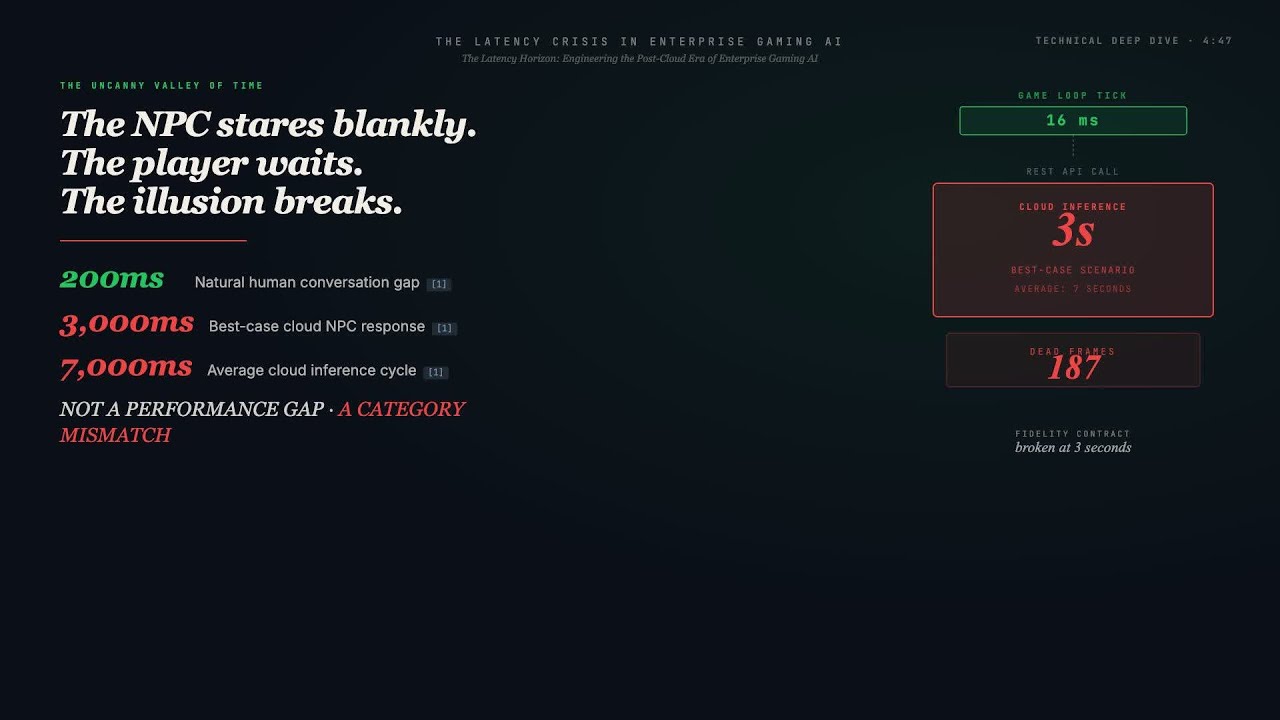
클라우드 기반 NPC는 "3초짜리 '시간의 불쾌 골짜기'" 를 만들어 몰입을 파괴합니다. 3000ms를 초과하는 REST API 레이턴시는 현대 고충실도 게이밍에 요구되는 실시간 피드백 루프를 근본적으로 무너뜨립니다.
Veriprajna의 엣지 네이티브 AI 아키텍처는 클라우드 LLM에서 소비자 하드웨어에 로컬로 구동되는 최적화된 소형 언어 모델(SLM)로 전환하여 50ms 미만의 레이턴시, 제로 한계 추론 비용, 그리고 완전한 오프라인 기능을 실현합니다.
Veriprajna는 AAA 스튜디오, 인디 개발자, 엔터프라이즈 게이밍 플랫폼과 협력하여, NPC가 레이턴시 세금 없이 주체성과 기억, 그리고 각본에 없는 상호작용 능력을 갖춘 살아있는 게임 월드를 설계합니다.
클라우드 추론의 '성공 세금(Success Tax)'을 제거하십시오. 가장 충성도 높은 플레이어가 AI 연산 비용을 전혀 발생시키지 않습니다. 엣지 배포는 AI 경제학을 기존 소프트웨어 방식에 맞춥니다. 높은 초기 개발 비용, 거의 제로에 가까운 유통 한계 비용입니다.
'시간의 불쾌 골짜기'를 돌파하십시오. Unreal Engine 5로 구축한 포토리얼 환경에서는 시각적 충실도가 '충실도 계약'을 만들어내므로, 오디오-비주얼 레이턴시도 이에 부합해야 합니다. 50ms 미만의 엣지 추론은 클라우드가 실패하는 자리에서 몰입을 지켜줍니다.
'썬더링 헤드(Thundering Herd)' 문제에서 벗어나십시오. 플레이어 10,000명이 동시에 NPC 상호작용을 일으키면 중앙집중식 클라우드는 치명적인 p99 레이턴시 급등에 직면합니다. 엣지는 추론을 플레이어 기반 자신의 하드웨어에 분산시킵니다.
서로 다른 레이턴시가 어떻게 몰입형 피드백 루프를 파괴하는지 확인해 보십시오. 3초의 지연은 단순한 기술적 불편이 아니라 존재감을 무너뜨리는 심리적 장벽입니다.
현재의 클라우드 중심 접근법은 단순히 느릴 뿐만 아니라 아키텍처 차원에서 실시간 시뮬레이션과 양립할 수 없습니다. 우리는 상태 비저장 요청-응답 웹 패러다임을 상태를 지닌 60 FPS 환경에 억지로 끼워 넣으려 하고 있습니다.
자연스러운 대화 간격은 약 200ms입니다. NPC 응답이 1초를 넘으면 인지부조화가 심하게 일어납니다. 3초가 되면 존재감의 환상은 완전히 무너집니다. 시각적 충실도가 만들어낸 기대를 오디오-비주얼 레이턴시가 따라갈 수 없기 때문입니다.
에이전트형 워크플로는 추론 단계를 사슬처럼 잇습니다(위협 분석 → 탄약 확인 → 결정 → 대사 생성). 각 단계: 500ms 네트워크 + 500ms 추론. 3단계 = 해당 액터의 시뮬레이션이 멈춰 선 3초 분량의 '데드 프레임'입니다.
클라우드 API에는 메모리가 없습니다. 모든 요청은 전체 게임 상태, 즉 대화 이력, 인벤토리, 관계를 직렬화해야 합니다. 컨텍스트 윈도우는 선형적으로 커지며, 상호작용할 때마다 대역폭, 처리 시간, 비용이 늘어납니다.
"역설: 클라우드 LLM으로 NPC가 똑똑해질수록 반응 속도는 느려지며, 이는 지능이 강화하려 했던 바로 그 사실감을 파괴합니다. 이것은 아키텍처의 실패이지 AI 능력의 실패가 아닙니다."
— Veriprajna 기술 백서, 2024
클라우드 AI는 역설적인 유인을 낳습니다. 게임이 인기 있을수록 운영 비용이 더 커집니다. 이 OPEX 모델은 게이밍 비즈니스 모델과 구조적으로 양립할 수 없습니다.
| 지표 | 클라우드 LLM (GPT-4) | 엣지 SLM (Llama-3-8B) |
|---|---|---|
| 10분 세션당 비용 | $0.03 | $0.00 |
| 월간 OPEX (사용자당 평균 5세션) | $150,000 | $0 |
| 연간 운영 비용 | $1.8M | $0 (일회성 개발 비용) |
| 성공에 따라 함께 증가? | 예 (죽음의 나선) | 아니요 (고정 비용) |
| 오프라인 플레이 지원 | 아니요 (서버 필요) | 예 (기기 내장) |
10억~80억 파라미터 모델은 고급 증류 및 양자화 기법을 활용해 프론티어 모델의 방대한 풋프린트 없이도 게임에 적합한 지능을 제공합니다.
방대한 '교사' 모델(Llama-3-70B)의 출력으로 작은 '학생' 모델(3.8B 파라미터)을 학습시킵니다. 학생 모델은 추론 패턴을 모방하도록 배우며, 지능을 더 작은 파라미터 공간으로 압축합니다.
16비트 가중치를 4비트 정수(INT4)로 압축합니다. 품질 손실은 무시할 수 있을 정도이면서 메모리 사용량을 약 70% 줄입니다. 16GB VRAM이 필요했던 8B 모델이 이제 5.5GB에 들어가며, 중형 소비자 GPU에도 배포할 수 있습니다.
게임이 먼 오브젝트에 폴리곤 LOD를 쓰듯, NPC에도 지능 LOD를 적용합니다. 플레이어의 관심을 끄는 상호작용에 연산을 동적으로 할당합니다.
엣지 배포의 실현 가능성은 보급된 기기 기반에 달려 있습니다. 우리는 소비자 기기 스펙트럼 전반에서 50ms 미만 목표를 검증했습니다.
| 하드웨어 클래스 | 대표 기기 | VRAM | 실행 가능 모델 | 속도 (TPS) | 사용 사례 |
|---|---|---|---|---|---|
| 하이엔드 PC | RTX 4090 | 24GB | Llama-3-70B (4-bit) | 40-50 | 갓 모드 / 월드 시뮬레이션 |
| 메인스트림 PC | RTX 3060 | 12GB | Llama-3-8B (4-bit) | 35-45 | 고충실도 NPC |
| 콘솔/핸드헬드 | Steam Deck / Switch 2 | 공유 | Phi-3 Mini (3.8B) | 15-20 | 표준 상호작용 |
| 플래그십 모바일 | Snapdragon 8 Gen 2 | N/A | TinyLlama (1.1B) | 8-12 | 기본 단발 대사 / 텍스트 |
제약은 연산량(FLOPS)이 아니라 메모리입니다. 8GB 카드는 게임 텍스처와 상주 LLM을 함께 돌리기 버겁습니다. 최적화는 순수 속도보다 메모리 관리를 우선합니다.
통합 메모리(CPU/GPU 공유 RAM)는 AI에 유리합니다. PS5/Xbox Series는 유연한 할당을 허용합니다. Switch 2 소문: Tensor 코어 + DLSS 지원 NVIDIA T239.
상위 안드로이드 기기는 3B 모델을 10-15 TPS로 구동합니다. 텍스트나 간단한 음성 명령에는 충분합니다. 발열 스로틀링이 장시간 세션을 제한하므로 전략적으로 사용하십시오.
모델 배포는 첫걸음일 뿐입니다. 50ms 미만을 달성하려면 최첨단 추론 기법을 게임 엔진에 통합해야 합니다.
작은 '초안(draft)' 모델(150M 파라미터)을 대상 모델(7B)과 짝지어 씁니다. 초안 모델이 다음 5개 토큰을 빠르게 추측하고, 대상 모델이 병렬 배치로 검증합니다. 맞히면 하나의 비용으로 5개 토큰을 생성합니다.
KV 캐시(대화 메모리)를 OS 가상 메모리처럼 관리합니다. 캐시를 비연속 페이지로 나누어 VRAM의 모든 바이트를 효율적으로 채웁니다. OOM 크래시 없이 더 긴 컨텍스트를 가능하게 합니다.
여러 NPC의 요청을 하나의 GPU 연산으로 묶습니다. 별도 스레드에서 게임 루프와 비동기로 실행합니다. 토큰이 준비되면 NPC 상태를 갱신하며, 프레임률은 60 FPS 아래로 떨어지지 않습니다.
날 것의 LLM은 환각을 일으키고 캐릭터를 이탈하며 존재하지 않는 게임 메커니즘을 지어냅니다. 엔터프라이즈급 AI에는 엄격한 논리 제약이 필요합니다. 사실에는 지식 그래프, 행동에는 상태 그래프입니다.
게임 세계관, 아이템, 관계를 지식 그래프로 구조화합니다. 플레이어가 질문하면 그래프에서 관련 엔티티를 조회하고, 검색된 팩트를 LLM 컨텍스트에 주입합니다. 검색된 서브그래프에 없는 엔티티를 언급하는 것은 금지됩니다.
LLM이 담당하는 것은 대화이며, 유한 상태 머신(FSM)이 담당하는 것은 논리입니다. 게임은 결정론적 상태(Neutral, Hostile, Trading, Dead)를 필요로 합니다. LLM이 플레이어 의도를 분류 → 상태 전이를 트리거 → 새로운 시스템 프롬프트.
절대적 안전을 위해 디코딩 알고리즘이 지식 그래프에 대한 '맞춤법 검사기' 역할을 합니다. 유효한 그래프 트라이(trie)에 없는 엔티티에 해당하는 토큰 시퀀스는 물리적으로 생성이 차단됩니다.
AI를 클라이언트 측으로 옮기면 고유한 공격 벡터가 생깁니다. 플레이어가 모델과 프롬프트에 물리적으로 접근할 수 있기 때문입니다. 방어에는 다층 아키텍처가 필요합니다.
스튜디오는 선택에 직면합니다. 자체 추론 스택을 설계하거나, 게임 맥락에 최적화된 신흥 미들웨어 솔루션을 활용하거나.
추론, 메모리, 안전을 추상화하는 종합 '캐릭터 엔진'. 'Contextual Mesh'가 세계관 준수를 보장합니다. 주된 강점은 통합 속도입니다. 하이브리드 엣지 기능 쪽으로 이동 중입니다.
런타임 텍스트를 생성하는 것이 아니라 개발자를 보조하는 데 AI를 사용합니다. 작가가 큐레이션하는 수천 개의 단발 대사(bark, 전투 함성·군중 잡담)를 생성합니다. 품질 관리는 Human-in-the-Loop 방식입니다.
'실행 가능한 AI'로 NPC가 환경을 지각(Vision 모듈)하고 행동("저 총을 집어라")을 실행할 수 있게 합니다. 물리 및 내비게이션 시스템과의 긴밀한 결합이 필요합니다.
엣지 기기는 강력하지만 유한합니다. MMO와 복잡한 시뮬레이션의 미래는 즉각성과 깊이의 균형을 잡는 하이브리드 아키텍처에 있습니다.
로컬 기기는 레이턴시 민감 작업(립싱크, 즉각 대화, 기본 이동)을 담당합니다. 복잡한 '월드 로직'(도시 경제 변화, 세력 정치)은 포그 노드로 오프로드합니다.
과제: 로컬 NPC가 퀘스트 제공자를 죽였는데 서버가 이를 부정하면 게임은 깨집니다.
Veriprajna는 클라우드에서 엣지 네이티브 AI로 전환하는 단계적 접근을 권장합니다. 조직 역량을 키우는 동시에 리스크를 최소화하는 방식입니다.
플레이어 참여 패턴을 바탕으로 클라우드 OPEX에서 엣지 CAPEX로의 전환 재무 효과를 모델링해 보십시오.
클라우드 API 비용: GPT-4o 추론 기준 약 $0.01/분
'시간의 불쾌 골짜기'는 차세대 몰입에 대한 최대 위협입니다. 고유한 레이턴시와 경제적 예측 불가능성을 지닌 클라우드 기반 AI는 실시간 상호작용의 막다른 길입니다.
미래는 엣지 네이티브 AI의 것입니다. 소비자 실리콘의 막대한 분산 파워를 활용해 최적화되고 양자화되며 그래프 제약을 받는 모델을 플레이어가 있는 바로 그곳에서 구동하는 아키텍처입니다. 이 전환을 받아들이면 개발자는 '3초의 정지'를 넘어, 입력을 기다리기만 하는 것이 아니라 진정으로 숨쉬고, 반응하고, 기억하는세계를 전달하게 됩니다.
기술은 준비되어 있습니다. 하드웨어도 충분합니다.
이제 만들 때입니다.
자연스러운 인간 대화 간격은 약 200ms입니다. 클라우드 LLM API는 REST API 왕복, 추론 대기열, TTS 생성으로 3000ms 이상의 레이턴시를 더합니다. 이는 60 FPS 게임 루프에서 NPC 응답당 187개의 데드 프레임을 만듭니다. 포토리얼 UE5 환경에서는 시각적 충실도가 오디오-비주얼 레이턴시가 따라갈 수 없는 '충실도 계약'을 만들어 존재감의 환상을 완전히 무너뜨립니다.
클라우드 AI는 플레이어 참여에 정비례해 늘어나는 세션당 $0.01~0.05의 비용을 만듭니다. 월간 활성 플레이어 100만 명이 각자 평균 5회의 AI 세션을 진행하면 연간 OPEX가 $180만에 이릅니다. 플레이어 하드웨어에서 구동되는 엣지 SLM은 한계 추론 비용이 제로입니다. 4비트 양자화된 Llama-3-8B 모델은 5.5GB VRAM만 필요하며 RTX 3060에서 초당 35-45토큰을 달성해, 변동 OPEX를 고정 CAPEX로 바꿉니다.
GraphRAG는 게임 세계관, 아이템, 관계를 지식 그래프로 구조화합니다. 플레이어가 질문하면 시스템은 그래프에서 관련 엔티티를 조회하고 검색된 팩트만 LLM 컨텍스트에 주입합니다. 그래프 제약 디코딩은 지식 그래프에 대한 맞춤법 검사기처럼 작동해, 유효한 그래프 트라이에 없는 엔티티에 해당하는 토큰 시퀀스를 물리적으로 생성하지 못하게 하여 환각률을 거의 0으로 끌어내립니다.
Veriprajna의 엣지 네이티브 AI 아키텍처는 레이턴시를 줄일 뿐만 아니라 상호작용의 물리학을 근본적으로 바꿉니다.
게임 엔진, 플레이어 기반, 하드웨어 목표에 대한 배포 실현 가능성을 모델링하려면 컨설테이션을 예약하십시오.
전체 엔지니어링 사양: 소형 언어 모델, 4비트 양자화, 추측 디코딩, GraphRAG 아키텍처, 포그 컴퓨팅, 보안 프로토콜, 하드웨어 벤치마크, 그리고 전체 참고 문헌.