انخفاض تقدير مخاطر البرمجيات الثابتة ليس إذناً بالإصدار

يمكن للإصلاح العاجل للبرمجيات الثابتة أن يحسن تقدير المخاطر بشكل كبير، ومع ذلك يظل الإصدار غير مقبول بموجب السياسة المعلنة. بالنسبة لفريق هندسي يقرر ما إذا كان سيحدث أسطولاً من العدادات، فإن هذين حكمان مختلفان. يخبرك التحسين بشيء عن الإصدار المرشح؛ لكن الإذن يعتمد على المخاطر المتبقية، والمجموعة الخاضعة للتقييم، والأدلة التي تدعم التقدير.
لقد طورت MeterGuard لإبقاء هذه الأحكام واضحة ومرئية. إنه نموذج تجريبي للفحص المسبق لنشر البرمجيات الثابتة باستخدام مجموعات عدادات اصطناعية وبيانات برمجيات ثابتة اصطناعية. يقدر السلوك من سجل التغييرات، وينمذج ذلك السلوك مقابل صحة الأسطول، ويصدر توصية محلية. إنه لا يرسل برمجيات ثابتة إلى العدادات ولا يمنع تحديثاً فعلياً. والسؤال المفيد هو ما الذي يتيحه هذا الفصل لمسؤول الإصدار لفحصه، وما الذي لا يزال عاجزاً عن إثباته.
التحسين والمقبولية يجيبان عن سؤالين مختلفين
تأمل المجموعة الاصطناعية المسماة Plano Water. يُنتج الإصدار المرشح الأولي معدل فشل متوسطاً منمذجاً قدره 74.22% من نقاط النهاية المقيمة. بينما ينتج الإصلاح العاجل 2.85%. تستخدم كلتا النتيجتين ملفات تعريف سلوكية مدعومة بالنماذج ومخزنة مؤقتاً، بدلاً من السلوك المقاس من البرمجيات الثابتة الثنائية. وفي حدود تلك الافتراضات، يعد الإصلاح العاجل تحسيناً جوهرياً. ويستحق هذا التقييم المقارن الحفاظ عليه حتى عندما تظل التوصية النهائية NO-GO.
تتحقق بوابة الإصدار أولاً من الحد الأعلى لنطاق 90% المنمذج. وعند نسبة 3.0% أو أكثر من نقاط النهاية المقيمة، فإنها ترجع نتيجة NO-GO. بالنسبة للإصلاح العاجل، يبلغ المتوسط 2,449 حالة فشل منمذجة من بين 86,078 نقطة نهاية مقيمة، مع نطاق يتراوح بين 1,536 و 3,531. ويصل المعدل الأعلى إلى 4.10%، لذا تنطبق قاعدة الحظر الصارم. كما تفتقر 1,922 نقطة نهاية أخرى إلى القياس عن بُعد الكافي ويتم استبعادها من هذا التوقع، مع التوصية بإجراء مراجعة يدوية.
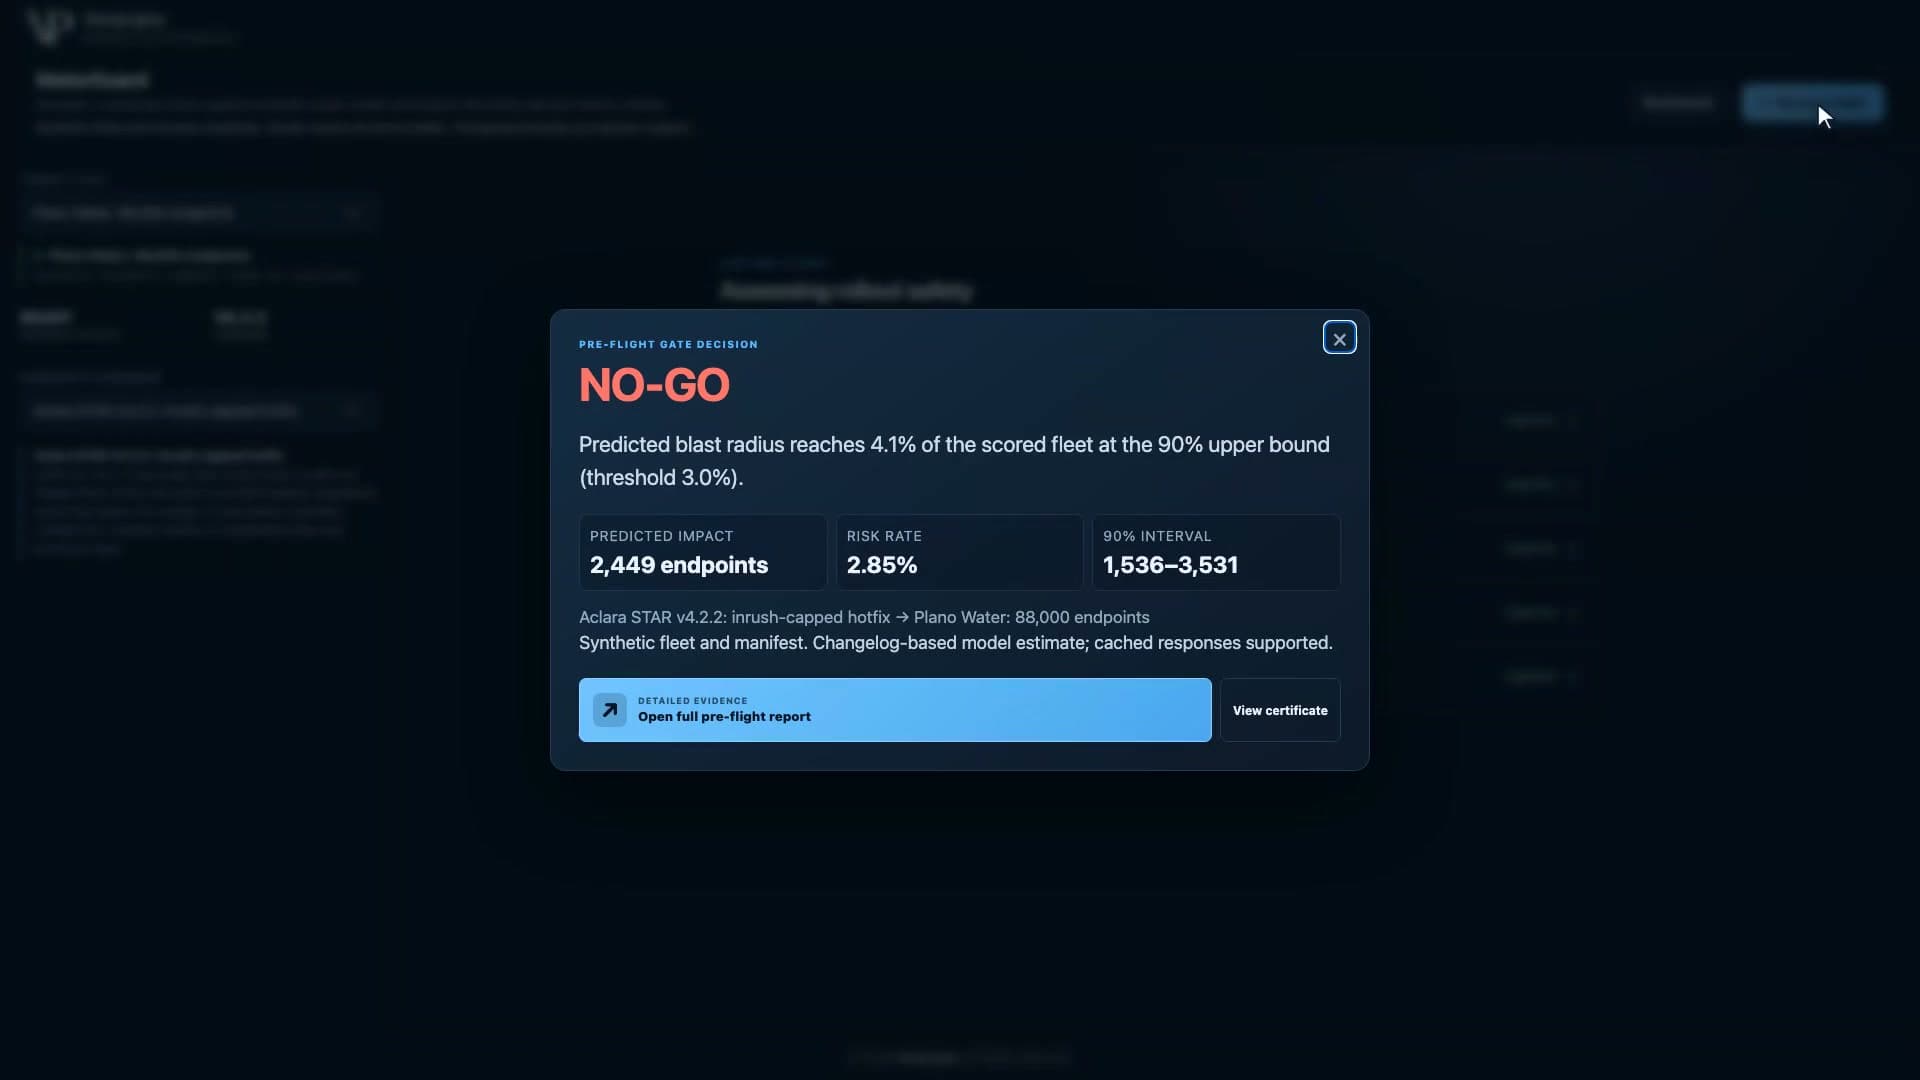
إن القراءة المستندة إلى المتوسط فقط ستغفل سبب كون هذا حظراً صارماً. كما أنها لن تجعل المرشح مؤهلاً للحصول على GO بموجب بقية بنود السياسة أيضاً: إذ تتطلب نتيجة GO متوسطاً عند 0.5% أو أقل، وذلك بعد اجتياز فحوصات الحد الأعلى ومستوى الثقة. وتؤدي المخاطر العددية المتوسطة إلى STAGED-CANARY. والتمييز مهم هنا لأن أوصاف «أفضل» و«مؤهل لخطوة جمع أدلة محدودة» و«ضمن قاعدة GO» لا ينبغي أن تدمج كلها في تصنيف مطمئن واحد.
أفضل إبقاء التحسين مرئياً دون السماح له بإعادة التفاوض على الحد المعين. فإذا استجاب فريق لتوصية مخيبة للآمال عبر تخفيف العتبة المحددة، فإنه يكون قد غير سياسة القبول الخاصة به. وقد يكون ذلك قراراً يمكن الدفاع عنه في سياق معين، لكنه قرار منفصل يتطلب أسبابه الخاصة. والأدلة على أن أحد المرشحين أفضل من الآخر لا توفر تلك الأسباب بمفردها.
هناك ثمن يترتب على هذا الموقف. فالحد المحافظ قد يؤخر إصداراً مرشحاً كان لينجح في الميدان. والطرف الأعلى للنطاق المنمذج ليس نتيجة ميدانية ملحوظة، ووصف النطاق بأنه «90%» لا يثبت مدى تغطيته في أسطول خدمات المرافق. ولا يمكن لهذا النموذج التجريبي تحديد العتبة التي ينبغي لشركة مرافق حقيقية اعتمادها. ولكن ما يمكنه إظهاره هو ما إذا كانت التوصية تتبع العتبة المعلنة، بدلاً من عتبة عُدلت سراً لتناسب النتيجة.
الإذن يخص الإصدار المرشح والمجموعة معاً
يعطي تقدير سلوك الإصلاح العاجل نفسه نتيجة مختلفة تماماً مقابل المجموعة المولدة المسماة Hill Country Electric Co-op. إذ يبلغ معدل الفشل المتوسط المنمذج 0.02%، مع معدل نطاق أعلى قدره 0.03%، وترجع البوابة نتيجة GO لـ 118,222 نقطة نهاية مقيمة. وتتمتع هذه المجموعة بتوزيع بطاريات أكثر صحة وإشارات لاسلكية ضعيفة أقل مقارنة بمجموعة Plano الاصطناعية. وتظل نقاط النهاية المستبعدة البالغ عددها 1,778 خارج نطاق تلك التوصية.
هذه مقارنة لسلوك الكتابة المقدر عبر توزيعات الصحة المولدة. وهي لا تقول شيئاً عن تثبيت صورة برمجية لمصنّع ما على أجهزة مصنّع آخر. فالتوافق والتحقق المستمد من الملفات الثنائية هما عملان منفصلان لا يؤديهما هذا النموذج التجريبي.
تغير هذه المقارنة الطريقة التي أريد بها التعبير عن توصية الإصدار. فعبارة «هذه البرمجيات الثابتة منخفضة المخاطر» تترك النطاق غير محدد. بينما عبارة «هذا السلوك المقدر يستوفي هذه السياسة في هذه المجموعة المقيمة» تحافظ على الشروط التي تصح النتيجة في ظلها. وتعد حالة البطارية واستعادة الاتصال اللاسلكي مدخلات في النتيجة المنمذجة، لذا لا يمكن فصل نتيجة إيجابية عنها ونقلها إلى أسطول آخر.
بالنسبة لمسؤول الإصدار، يخلق هذا طريقتين مختلفتين للتعامل مع توصية غير مواتية. إحداهما هي تحسين سلوك الإصدار المرشح أو الأدلة المستخدمة لتقديره. والأخرى هي النظر في مجموعة أضيق تدعم ظروفها تقييماً مختلفاً. وهما يجيبان عن مشكلتين مختلفتين. فقد يقلل التقييم الأضيق من التعرض المنمذج للمخاطر، لكنه يترك بقية المجموعة دون حسم. وقد تحسن الأدلة الأفضل حول الإصدار المرشح من التقدير، لكنها لا تستطيع إيجاد بيانات القياس عن بُعد المفقودة للأسطول من العدم.
وتعد هذه البدائل خيارات هندسية مستقبلية، وليست عمليات ينفذها هذا النموذج التجريبي. وتكمن قيمتها في أنها توجه العمل نحو مصدر عدم اليقين. فالقرار بمفرده لا يستطيع إخبار الفريق بما إذا كان بحاجة إلى إصدار مرشح أفضل، أو ملف تعريف أفضل، أو معلومات أفضل عن الأجهزة المستهدفة. ولكن المدخلات والاستثناءات المعروضة بجانبه تستطيع ذلك.
لا يمكن لبوابة برمجية التحقق مما يعتقده النموذج
يحتفظ MeterGuard بالسياسة في كود برمجي صريح. وتأتي مذكرة الحوكمة المدعومة بالنماذج بعد صدور القرار ولا تملك سلطة مباشرة لتجاوزه. وأريد هذا الفصل لأن التفسير السلس والمنمق لا ينبغي أن يتحول سراً إلى قاعدة إصدار جديدة.
لا يزال للنموذج تأثير بالغ الأهمية في مرحلة مبكرة من سير العمل. إذ يقدر ملف تعريف البرمجيات الثابتة الخاص به استهلاك التيار، والاستعادة بعد إعادة الضبط، وسلوك الكتابة على الذاكرة الوميضية من نص سجل التغييرات الاصطناعي. وتغذي تلك التقديرات أداة المحاكاة. ويمكن لملف تعريف مختلف أن يغير حالات الفشل المنمذجة وبالتالي يغير القرار، حتى لو لم يتغير كود البوابة مطلقاً. وتثبت السياسة القابلة للفحص كيفية الحكم على المدخلات؛ لكنها لا تثبت أن المدخلات كانت صحيحة.
توضح حالة سجل التغييرات المقتضب هذا التمييز بجلاء. ففي مواجهة مجموعة Co-op المولدة نفسها، يبلغ المتوسط المنمذج 0.05% فقط ومعدله الأعلى 0.06%. وتتجاوز هذه الأرقام الحدود العددية المطلوبة. ومع ذلك، يحمل ملف التعريف ثقة منخفضة، لذا توصي البوابة بـ STAGED-CANARY بدلاً من GO. ويتم التعامل مع ندرة أدلة البرمجيات الثابتة كسبب مستقل لحجب التوصية الأوسع.
وهذا إجراء وقائي مفيد، لكن له حدوده الخاصة أيضاً. فتصنيف الثقة الخاص بالنموذج ليس يقيناً تجريبياً مدرجاً بدقة. ويمكن لاشتراط تصنيف غير منخفض أن يمنع تجاهل فجوة أدلة معترف بها؛ لكنه لا يستطيع اعتماد تصنيف «مرتفع» على أنه دقيق. ومن أجل الاعتماد عليه في بيئة الإنتاج، سيحتاج ملف التعريف إلى التحقق مقابل سلوك ونتائج البرمجيات الثابتة الفعلية. ويظل هذا عملاً يتجاوز حدود النموذج التجريبي الاصطناعي.
العينة الأكثر أماناً تترك سؤالاً أكثر صعوبة
يستخدم المسار المرحلي المقترح 500 نقطة نهاية من المجموعة ذات أدنى مخاطر منمذجة، مع فترة انتظار مدتها 72 ساعة وإعادة تقييم باستخدام القياس عن بُعد الملحوظ قبل التوسيع. ويوصي النموذج التجريبي بهذه الخطة؛ لكنه لم ينفذ نشر الكناري ولم يجمع ملاحظاته. ومعيار التوسيع المكون هو معدل فشل ملحوظ أقل من 0.1%.
أرى مقايضة حقيقية في اختيار المجموعة الأكثر أماناً أولاً. فهو يقلل من التعرض المقترح للخطوة الأولى. ولكن المنطق نفسه الذي جعل حالة الأسطول مهمة يحد أيضاً مما يمكن أن تثبته تلك الخطوة بشأن نقاط النهاية ذات الحالة الأسوأ. وفي حملة افتراضية، فإن ملاحظة تحديث ناجح على بطاريات سليمة واتصالات لاسلكية جيدة ستدعم ادعاءً بشأن تلك العينة المختبرة. لكنها ستترك الباب مفتوحاً حول كيفية تصرف الإصدار المرشح على بطاريات متقادمة أو اتصالات لاسلكية ضعيفة.
هناك استجابتان يمكن الدفاع عنهما على الأقل لتلك الفجوة. يمكن للفريق إبقاء التوسيع مقصوراً على مجموعات مشابهة بدرجة كافية للعينة الملحوظة، مع قبول تغطية أبطأ وترك نقاط النهاية المتدهورة معلقة. أو يمكنه البحث عن أدلة تستهدف الظروف المتدهورة، مثل التحقق الخاضع للرقابة من سلوك البطارية والاستعادة ذي الصلة، قبل النظر في نقاط النهاية تلك. ويتطلب المسار الثاني عملاً إضافياً؛ بينما يقبل الأول استنتاجاً أضيق. ولا يجعل أي منهما العينة الآمنة ممثلة للمجموع بمجرد إعلان ذلك.
ولهذا السبب أتعامل مع STAGED-CANARY كطلب للحصول على أدلة محددة، وليس كمرادف مخفف لـ GO. إذ يجب أن توضح الخطة المرحلية ما ستبرره ملاحظاتها وأين تتوقف. وبدون ذلك النطاق، يمكن لعملية تبدو حذرة أن تنتج استنتاجاً مفرط الاتساع.
إليكم جولة المؤسس التفصيلية لقرارات إصدار العدادات الذكية في MeterGuard.
يوضح دليل MeterGuard التوضيحي سير عمل الفحص المسبق وسجلات قراراته. ويتمثل موقفي التصميمي في إبقاء السلوك المقدر، ومجموعة العدادات المقيمة، والاستثناءات، والقاعدة المعلنة جنباً إلى جنب مع التوصية. وبالنسبة لمسؤول الإصدار، فإن الاختبار الحقيقي هو ما إذا كانت الخطوة التالية المقترحة تحسم حالة عدم اليقين التي تسببت في التعليق. فإذا كانت ترصد أسهل الظروف فقط بينما يتعلق القرار بظروف أكثر صعوبة، فإن الحد يظل في انتظار الأدلة.