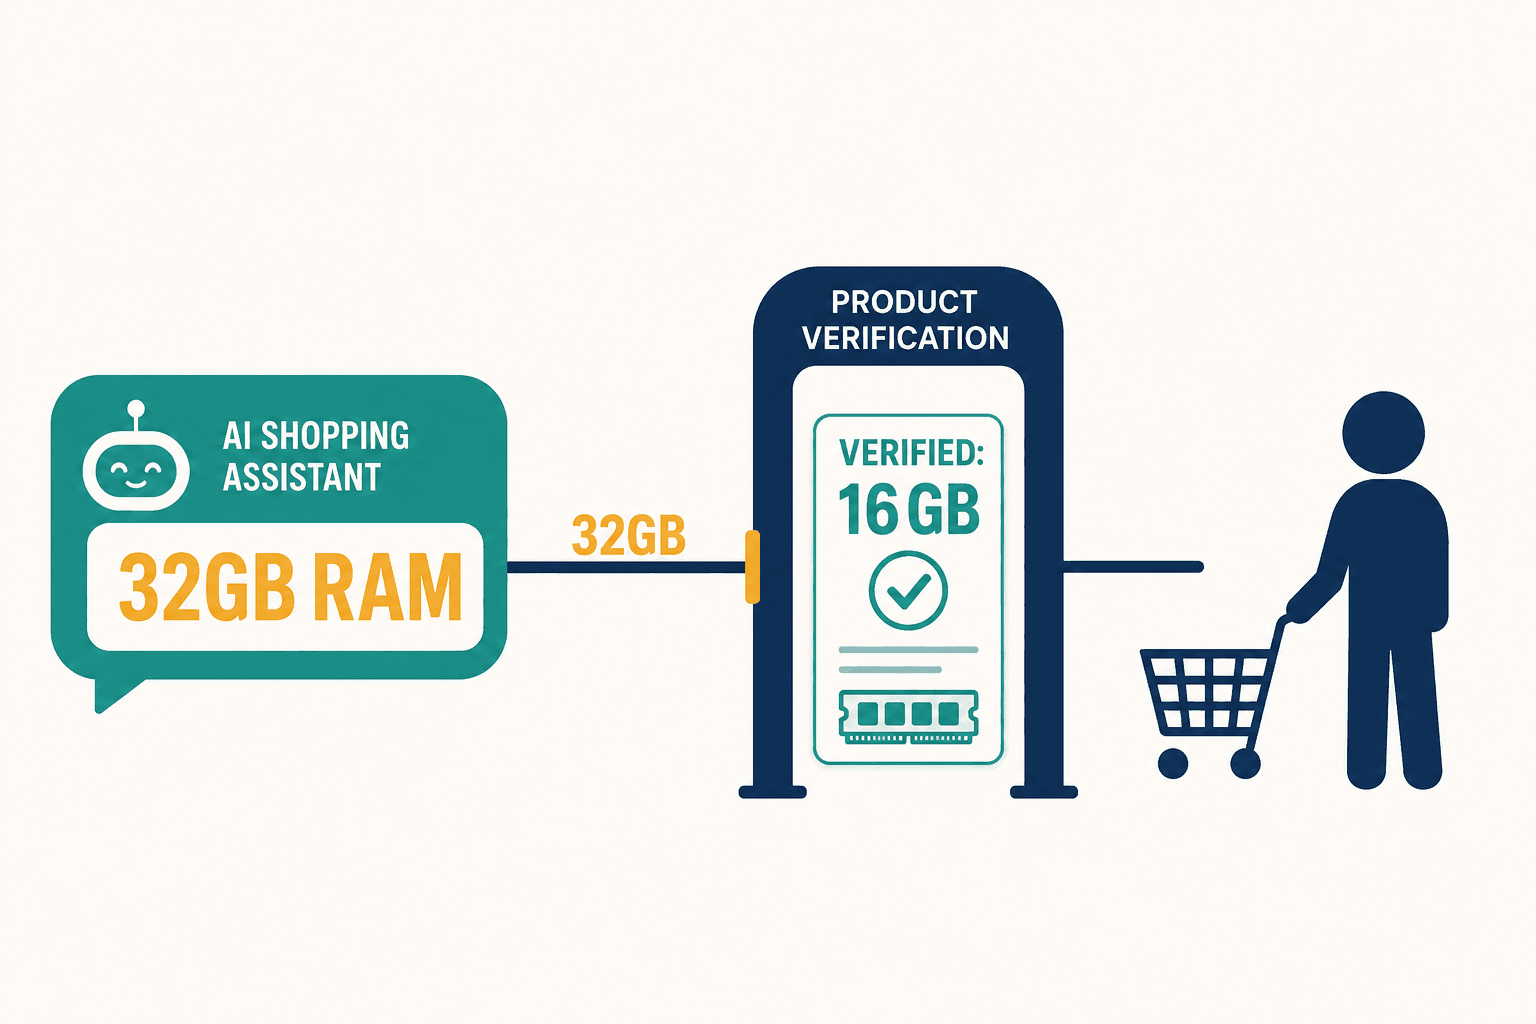
ذكاء Amazon الاصطناعي أرشد عميلاً لصنع كوكتيل مولوتوف. وأنا أعلم بالضبط لماذا حدث ذلك.

كنت في مكالمة هاتفية مع عميل محتمل — وهي شركة تجارة إلكترونية ضخمة، ليست Amazon ولكنها بحجم معتبر — عندما قال نائب رئيس قسم الهندسة لديهم شيئاً جعلني أضع فنجان قهوتي على الفور.
"لقد انتهينا عملياً من بناء مساعد الذكاء الاصطناعي الخاص بنا. كل ما نحتاجه الآن هو شخص يقوم بضبط المطالبات (prompts) فقط."
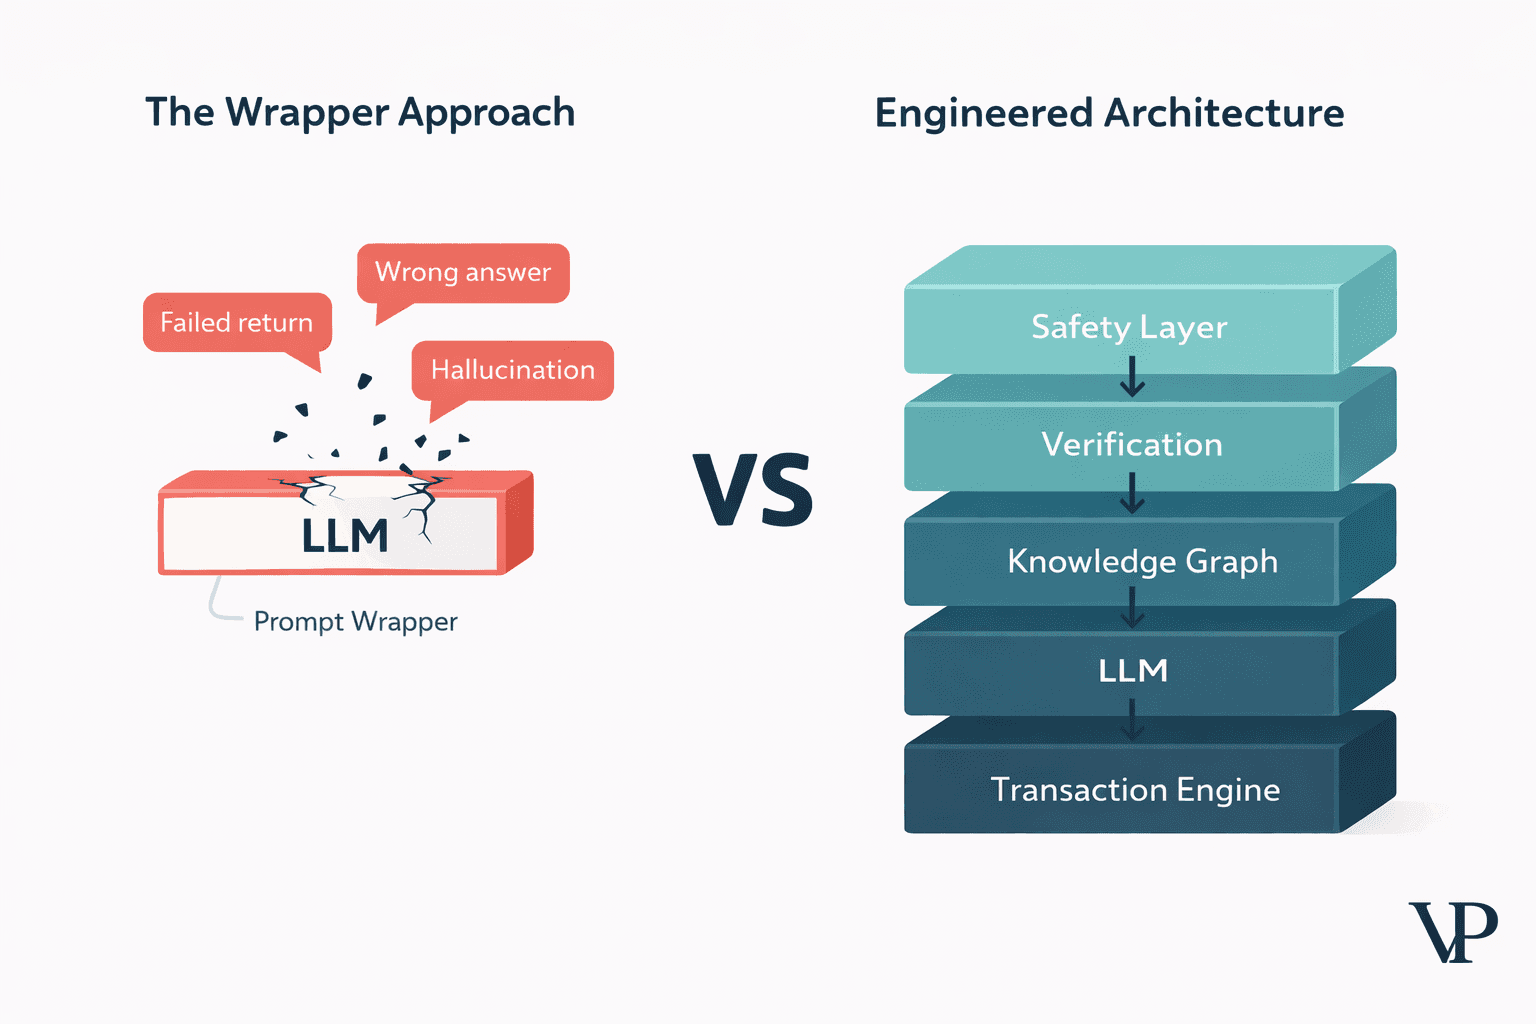
لقد سمعت هذا الطرح من قبل. ذلك الاعتقاد بأن الذكاء الاصطناعي للمؤسسات ما هو إلا مسألة هندسة مطالبات: اختر نموذجاً أساسياً، وأحطه بمطالبة نظام تنص على أن يكون "مفيداً وآمناً ولا يهلوس"، ثم أربطه بكتالوج المنتجات واطرحه في السوق. اعتدت أن أومئ برأسي بأدب عندما يخبرني الناس بذلك. ولكن بعد مشاهدة إطلاق Amazon Rufus الكارثي في عام 2024 — حيث اختلق موقع Super Bowl، وقدم إرشادات لصنع أسلحة حارقة بناءً على استفسارات عادية عن المنتجات، وفشل في إدارة عمليات الإرجاع البسيطة — توقفت عن الإيماء بالموافقة.
"أنتم لم تنتهوا بعد"، قلت له. "أنتم لم تبدأوا حتى الآن."
لم تكن كارثة Rufus مجرد مشكلة في العلاقات العامة، ولا مشكلة في جودة النموذج بحد ذاته. لقد كانت مشكلة في البنية الهندسية بالأساس. وهي مشكلة البنية ذاتها الكامنة في كل مشروع ذكاء اصطناعي مؤسسي قمت بمراجعته تقريباً. فالنموذج يعمل، لكن النظام المبني حوله هش كبيت من ورق.
ما الذي حدث حقاً لـ Amazon Rufus؟
إليكم ما أخطأ معظم الناس في فهمه بشأن تغطية أزمة Rufus. ركزت العناوين على المخرجات — مثل معلومة Super Bowl الخاطئة، وإرشادات صنع السلاح الحارق، وعمليات الإرجاع الفاشلة. وسارع المعلقون إلى إلقاء اللوم على النموذج نفسه: "إن نماذج GPT غير مناسبة للتجارة الإلكترونية"، أو "نماذج اللغة تهلوس، فماذا كنتم تتوقعون؟".
لكنني أمضيت أسابيع في تفكيك التفاصيل الفنية لذلك الإطلاق. لم يكن النموذج هو نقطة الفشل الرئيسية. بل كانت المشكلة تكمن في بنية التثبيت المعرفي (grounding architecture) وكيف تم تصميمها.
فكر فيما يحدث عندما تسأل Rufus عن موقع إقامة مباراة Super Bowl. يقوم النموذج بتوليد إجابة بناءً على أوزانه الاحتمالية ونتائج البحث على الويب التي جلبها. فإذا أعادت طبقة الاسترجاع نتائج مشوشة أو متناقضة — أو إذا كان النموذج مفرط الثقة في توقعاته — فإنه يقدم لك معلومة مغلوطة بكل ثقة. لم تكن المسألة أن النموذج "غبي"، بل لأن البنية عاملت مخرجات النموذج الاحتمالية كحقيقة مؤكدة دون أي تحقق قطعي مسبق.
لم تكن هناك طبقة تحقق ثانوية. لم يكن هناك رسم بياني معرفي (knowledge graph) للرجوع إليه للتحقق من الحقائق الأساسية. ولم تكن هناك آلية تحقق من الاتساق الدلالي لتقييم ما إذا كانت الإجابة متماسكة منطقياً مع المصادر الأصلية. بل تم تمرير ناتج النموذج مباشرة إلى المستخدم النهائي.
عندما تبني نظام ذكاء اصطناعي بدون طبقة تحقق مستقلة، فأنت لا تبني منتجاً هندسياً؛ أنت تدير كازينو للمقامرة باحتمالات الإجابة.
تلك هي المشكلة الجوهرية فيما أسميه نمط "غلاف نماذج اللغة" (LLM Wrapper) — وهو النمط الذي تعتمده 90% من الشركات دون إدراك للمخاطر.
الليلة التي أدركت فيها أن المطالبات لن تنقذك أبداً
أتذكر اللحظة الدقيقة التي استوعبت فيها هذا الواقع بوضوح. كنا نقوم ببناء محرك التقييم والمطابقة الدلالية في Veriprajna، وكنت مقتنعاً بأن مطالبات النظام المصممة بعناية فائقة مع بعض الأمثلة التوجيهية (few-shot examples) كافية للحفاظ على استقرار النظام.
كانت الساعة تشير إلى الحادية عشرة ليلاً، وكنت مع شريكي المؤسس نجري اختبارات هجومية عدائية (adversarial tests) على النظام. قمنا بتغذية النموذج بآلاف الاستفسارات المعقدة والمتناقضة لاختبار صمود دفاعات مطالباتنا التوجيهية.
وبدأ النظام بالهلوسة وتلفيق البيانات. لم يحدث ذلك بشكل صارخ أو درامي — فلم يبدأ بسب المستخدمين — ولكنه بدأ يختلق أرقام مواصفات دقيقة غير موجودة، وينسب ميزات لمنتجات لا تمتلكها، بكل هدوء وثقة مطلقة.
التفتُّ إلى شريكي المؤسس وقلت له: "المطالبة ليست سوى مجرد اقتراح مهذب للنموذج. وإذا كانت متطلبات الأمان أو الدقة مجرد اقتراح، فليس لديك أي أمان على الإطلاق".
وهذا بالضبط ما حدث في حادثة أمان Rufus الشهيرة. لقد كان لدى Amazon بطبيعة الحال مطالبات نظام صارمة تحظر المحتوى الضار. وكان لديهم مرشحات أمان (guardrails). لكنهم اعتمدوا على النموذج ذاته لفهم وتطبيق تلك القواعد في اللحظة التي يُطلب منه فيها تلخيص نتائج البحث من الويب. وعندما تطلب من نموذج تلخيص صفحة ويب تحتوي صدفة على تعليمات خطيرة، فإن آلية التلخيص تتغلب على توجيهات الأمان.
الأمان من خلال هندسة المطالبات ليس أماناً حقيقياً. بل هو مجرد تمنيات ورجاء.
لماذا يعجز الذكاء الاصطناعي عن إتمام طلب الإرجاع الخاص بي؟
إخفاق Rufus الثالث — وهو العجز التام عن التعامل مع حالات الطلبات وإتمام عمليات الإرجاع — هو الأكثر إثارة للإحباط، لأنه الأكثر قابلية للحل ومع ذلك فهو الأكثر شيوعاً بين الأنظمة الحالية.
كان بإمكان Rufus أن يتحدث طوال اليوم عن سياسات الإرجاع. وكان بإمكانه شرح نافذة الـ 30 يوماً وتفصيل شروط التغليف بدقة بليغة. ولكنه عندما كان العميل يطلب منه: "حسناً، قم ببدء عملية إرجاع طلبي الأخير"، كان يتجمد أو يهلوس بتأكيد وهمي دون تنفيذ أي إجراء فعلي في النظام الخلفي.
هذا ما أسميه فجوة التنفيذ (Action Gap)، وهي موجودة لأن معظم تطبيقات نماذج اللغة مصممة كأدوات "محادثة" وليست كبنى تحتية "لإدارة المعاملات". إن التحدث عن شيء ما وإنجازه فعلياً يتطلبان بنى هندسية مختلفة تماماً.
ذلك الجزء الأخير بالغ الأهمية. في هندسة قواعد البيانات والأنظمة السحابية مثل AWS، نطلق على هذا المفهوم ضمانات معايير ACID (الذرية، الاتساق، العزل، والمتانة). فإما أن تكتمل المعاملة بالكامل وبشكل متسق، أو لا تحدث مطلقاً، مع الحفاظ التام على سلامة البيانات.
نماذج اللغة لا تملك أي إدراك لمفاهيم ACID. إنها تولد رموزاً احتمالية لا معاملات بيانات قطعية. وعندما تجعل نموذج لغة يتولى مباشرة منطق المعاملات، فإنك تواجه ما نطلق عليه فقدان الذاكرة المعاملاتي (Transactional Amnesia) — حيث يعد النظام العميل بإجراء ما، ويظن العميل أنه تم، بينما لم تتغير أي خانة في قاعدة البيانات الخلفية.
لقد قمت بتفصيل هذا النمط من الإخفاق والحل المعماري المناسب له بالكامل في تحليلنا التفاعلي.
فخ السرعة القاتل الذي لا يتحدث عنه أحد
إليكم تفصيلاً مهماً من كواليس بنية Rufus لم يحظَ بالاهتمام الكافي: في محاولة لمواكبة أوقات الاستجابة السريعة المطلوبة في التجارة الإلكترونية، تم تطبيق تقنيات تسريع الاستدلال مثل فك التشفير التخميني (speculative decoding) والتنبؤ المتوازي بالرموز.
أدى ذلك لمضاعفة سرعة الاستجابة، ولكنه أدخل في الوقت نفسه ما يسميه الباحثون الانجراف الدلالي (Semantic Drift).
عندما تقوم بالتنبؤ برموز متعددة على التوازي، فإنك تضحي بقدرة النموذج على إعادة تقييم المسار المنطقي عند كل خطوة. هذا التسارع يعزز الأنماط الإحصائية الأكثر شيوعاً في بيانات التدريب على حساب الدقة الصارمة، مما يرفع احتمالية الهلوسة في التفاصيل المحددة والأسماء والتواريخ.
إن هلوسة موقع Super Bowl تحمل بوضوح بصمات هذا المقايضة التقنية: لقد تم تفضيل المعقولية الظاهرية — هل تبدو هذه الجملة مقنعة وسلسة؟ — بدلاً من الحقيقة القطعية — هل هذه المعلومة صحيحة ومثبتة بالفعل؟
يواجه الذكاء الاصطناعي للمؤسسات مفارقة حتمية بين زمن الاستجابة والدقة: كلما زادت سرعة التوليد دون طبقات فحص مستقلة، تدهورت موثوقية النتائج.
في Veriprajna، اتخذنا قراراً حاسماً منذ البداية: لا يتم تسليم أي إجابة للمستخدم مباشرة من النموذج دون التحقق منها عبر طبقة تدقيق منفصلة. حتى لو كلفنا ذلك 300 إلى 500 مللي ثانية إضافية في زمن الاستجابة. في التجارة الإلكترونية والاستشارات المؤسسية، يفضل العملاء الانتظار نصف ثانية إضافية للحصول على إجابة صحيحة، على أن يتلقوا معلومة خاطئة وفورية خلال 800 مللي ثانية تدمر مصداقية علامتهم التجارية.
"هل هذا المعطف قابل للغسيل في الغسالة؟"
هناك نمط فشل آخر في بيانات Rufus يثير القلق بشكل خاص: عندما يطرح المستخدمون استفسارات بلغات غير رسمية أو لهجات محلية أو لغات عامية. سأل أحد المتسوقين عما إذا كانت سترة معينة قابلة للغسيل الآلي، ولكن بأسلوب عامي، ففشل المساعد في مطابقة المعنى مع بيانات الكتالوج وقدم إجابة مناقضة تماماً لإرشادات الغسيل الحقيقية للمنتج.
هذه ليست مشكلة هامشية على الإطلاق؛ فنحن نتحدث عن نظام يخدم مئات الملايين من المتسوقين بمختلف خلفياتهم وثقافاتهم ولغاتهم في مناسبات كبرى مثل Prime Day.
الجذر الفني واضح تماماً: نماذج اللغة مصممة ومحسنة للغة المعيارية الفصحى. ولحل ذلك، قمنا ببناء ما نسميه التدقيق المراعي للهجات (Dialect-Aware Auditing) — وهي طبقة دلالية تقوم بتطبيع وتوحيد بنية المدخلات دون فقدان قصد العميل وخصوصيته الثقافية.
لم نقم ببناء هذا المكون في إطار عملنا لمجرد إرضاء متطلبات نظرية، بل لأن الواقع العملي أثبت أن 45% من استفسارات العملاء في العالم الحقيقي لا تصاغ بلغة قياسية مثالية، وإهمال هذا الجانب يعني استبعاد نصف المستخدمين من الاستفادة الآمنة من النظام.
كيف يبدو النظام الموثوق هندسياً حقاً؟
بعد تحليل إخفاقات Rufus، وبعد ليالٍ لا حصر لها من اختبار بنيتنا الخاصة في بيئات الإنتاج، استقرينا على منهج أطلقت عليه اسم العصبي الرمزي (Neuro-Symbolic) — وهو نظام يتعامل مع نموذج اللغة كمحرك استدلال قوي وفائق الذكاء، لكنه في الوقت ذاته غير مطلق السلطة.
والكلمة الجوهرية هنا هي غير مطلق السلطة. فالنماذج اللغوية بارعة للغاية في فهم النوايا وتوليد الصياغات الطبيعية، لكن لا ينبغي أبداً إسناد إدارة المعاملات أو التحقق النهائي من الحقائق إليها بمفردها.
كيف نمنع الذكاء الاصطناعي من هلوسة الحقائق والبيانات؟
يبحث نظام الاسترجاع المعزز بالتوليد التقليدي (RAG) عن تشابه الكلمات والفقرات، بينما يبحث نظامنا المتقدم GraphRAG عن العلاقات الدلالية الهيكلية داخل رسم بياني معرفي دقيق. وهذا الاختلاف الجوهري يصنع فارقاً هائلاً في الموثوقية.
في نظامنا، لا يستطيع نموذج اللغة إطلاق أي ادعاء أو تقديم أي معلومة ما لم يتمكن من تتبع مسار حقيقة موثق داخل الرسم البياني لإثباته. فإذا أردت التوصية بتلفزيون مناسب للألعاب، يجب على النظام ربط الطراز المعين بمعدل التحديث 120Hz المثبت بالرسم البياني. وإذا حاول النموذج اختلاق ميزة غير موثقة، تتدخل طبقة التحقق لمنع خروج الإجابة فوراً قبل التوليد النهائي.
يعالج هذا الحل بشكل جذري معضلة "الضياع في المنتصف" (Lost in the Middle) التي رصدها باحثو معهد Cornell Tech. فعندما تتواجد الحقائق في رسم بياني منسق بدلاً من فقرات نصية طويلة، لا يمكن للمعلومة أن تضيع أو تختلط.
لماذا لا نعتمد ببساطة على نموذج واحد خارق؟
يسألني الناس مراراً: "ألن يتم حل كل هذه المشاكل بمجرد إطلاق GPT-5؟". قد تكون النماذج الجديدة أكثر ذكاءً، لكن العيوب البنيوية لا تختفي بمحرك أحدث. فالسيارة السريعة بدون مكابح تصبح أكثر خطورة كلما زادت قوتها الحصانية.
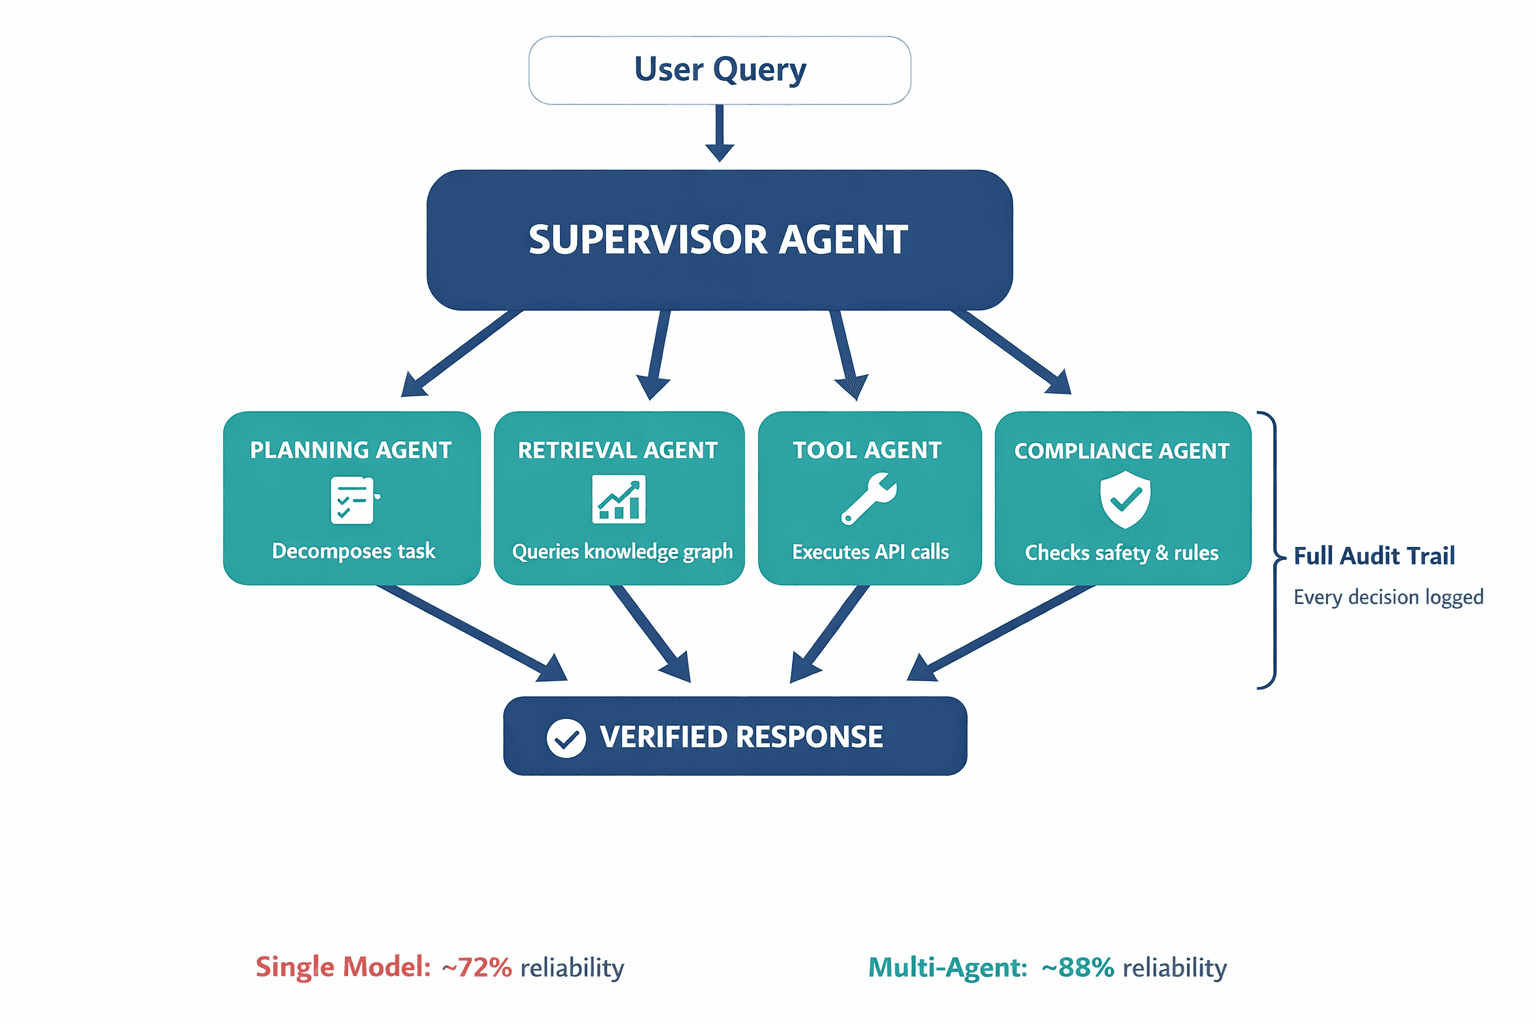
بدلاً من الاعتماد على نموذج وحيد يحاول إنجاز كل شيء، نقوم بنشر نظام متعدد الوكلاء (Multi-Agent System): وكيل مشرف يفسر النوايا ويوجه المهام إلى وكلاء متخصصين؛ وكيل تخطيط لتفكيك الخطوات، ووكيل استرجاع لقواعد البيانات، ووكيل أدوات لتنفيذ واجهات البرمجة، ووكيل امتثال لمراجعة الأمان.
هذا التوزيع المتخصص للمهام رفع موثوقية نظامنا في بيئة الإنتاج من 72% المعتادة في أنظمة النموذج الواحد إلى نحو 88%. والأهم من ذلك أنه ينشئ مسار تدقيق صارم وشفاف. فعندما يسأل المنظمون أو العملاء "لماذا قدم الذكاء الاصطناعي هذه الإجابة؟"، يمكننا تتبع كل خطوة استدلالية ومصدرها بدقة، وهو ما تعجز عنه أغلفة النماذج البسيطة تماماً.
للاطلاع على المواصفات الفنية الكاملة وآليات التحقق متعددة الطبقات، يرجى مراجعة ورقتنا البحثية.
بنية الشطيرة (Sandwich) التي تنقذ المعاملات والعمليات
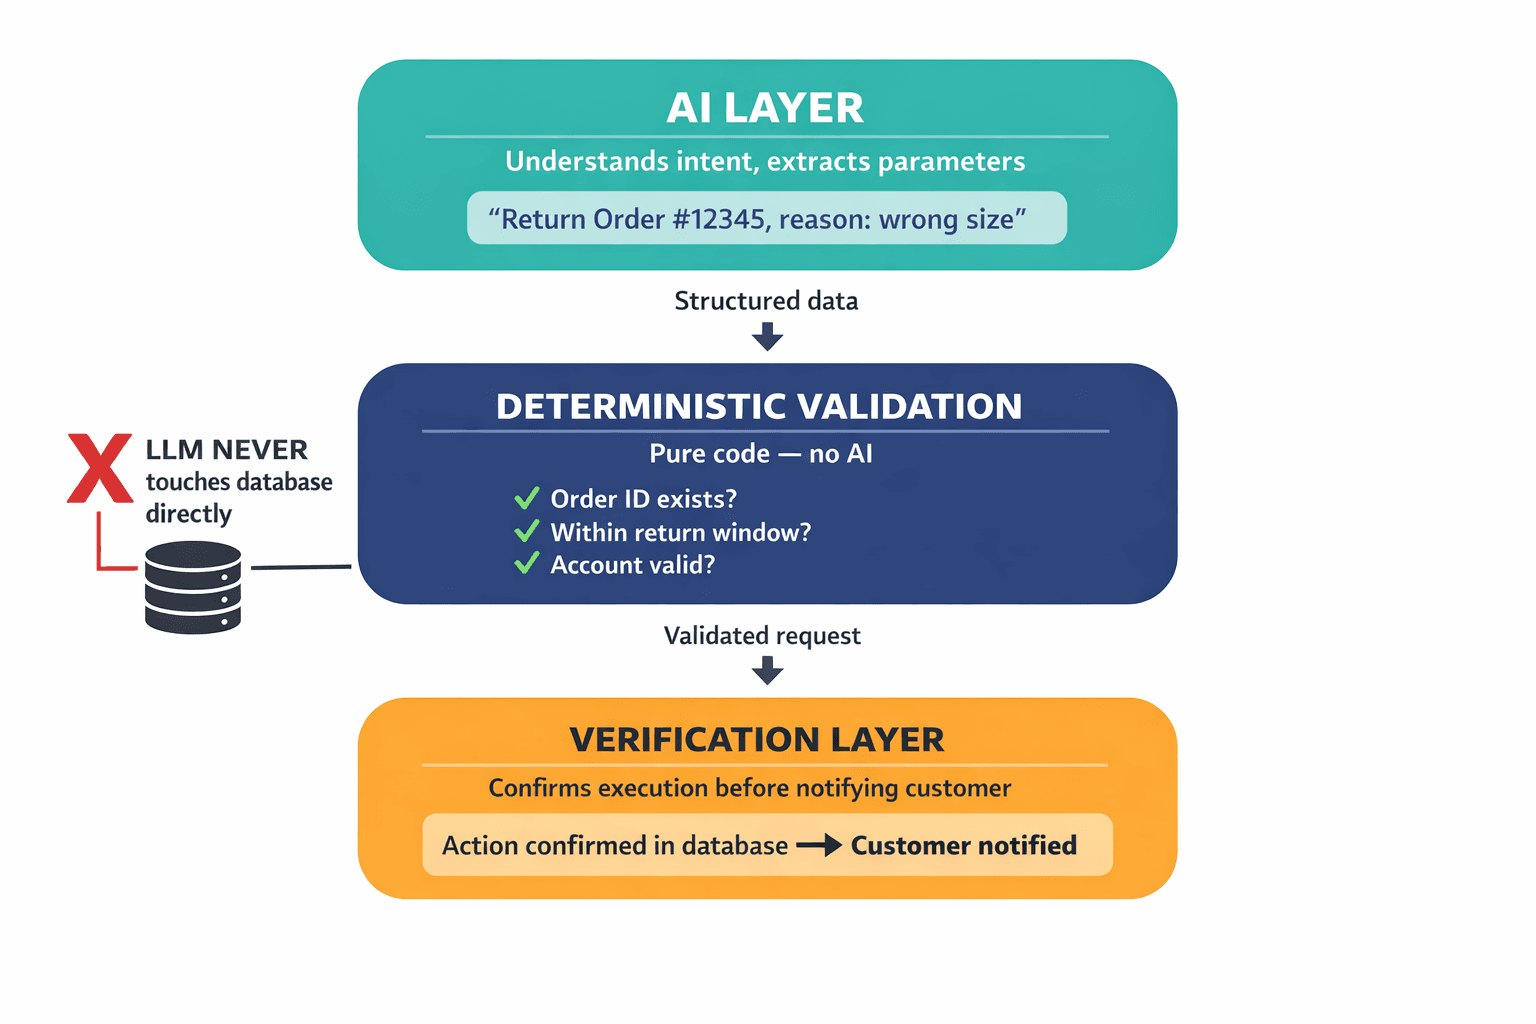
ولسد فجوة التنفيذ — أي العجز عن إنجاز الإجراءات الفعلية مثل إتمام طلبات الإرجاع — نعتمد ما أطلقت عليه اسم بنية الشطيرة (Sandwich Architecture)، ورغم اعترافي بأن هذا الاسم يبدو غير رسمي لنمط هندسي صارم، إلا أنه يعبر عن الجوهر بدقة.
الطبقة العليا هي طبقة الذكاء الاصطناعي الدلالية: تفهم طلب العميل وتستخرج المعلمات القياسية. "طلب إرجاع للأمر رقم 12345 بسبب عدم ملائمة المقاس". الطبقة الوسطى هي برمجية قطعية: تتحقق من صحة المعلمات مع قواعد البيانات الحية. هل رقم الطلب موجود؟ هل يقع ضمن فترة السماح؟ هل الحساب نشط؟ أما الطبقة السفلية فهي التحقق التنفيذي: تأكيد مستقل بتمام تنفيذ العملية في أنظمة الواجهة الخلفية قبل إرسال التأكيد النهائي للمستخدم.
نماذج اللغة لا تلمس قاعدة البيانات بشكل مباشر أبداً، ولا تملك سلطة مستقلة لإجراء أي تعديل في الحسابات. هي تترجم فقط رغبة الإنسان إلى بيانات مهيكلة، وتسلمها للأنظمة الموثوقة التي نضجت لعقود قبل ظهور هذه النماذج. النماذج تركز على ما تتقنه فقط، وقواعد البيانات تركز على حفظ اتساق البيانات، دون أن يتجاوز أي طرف حدوده.
فضيحة السلاح الحارق هي بالأساس عيب في تصميم النظام
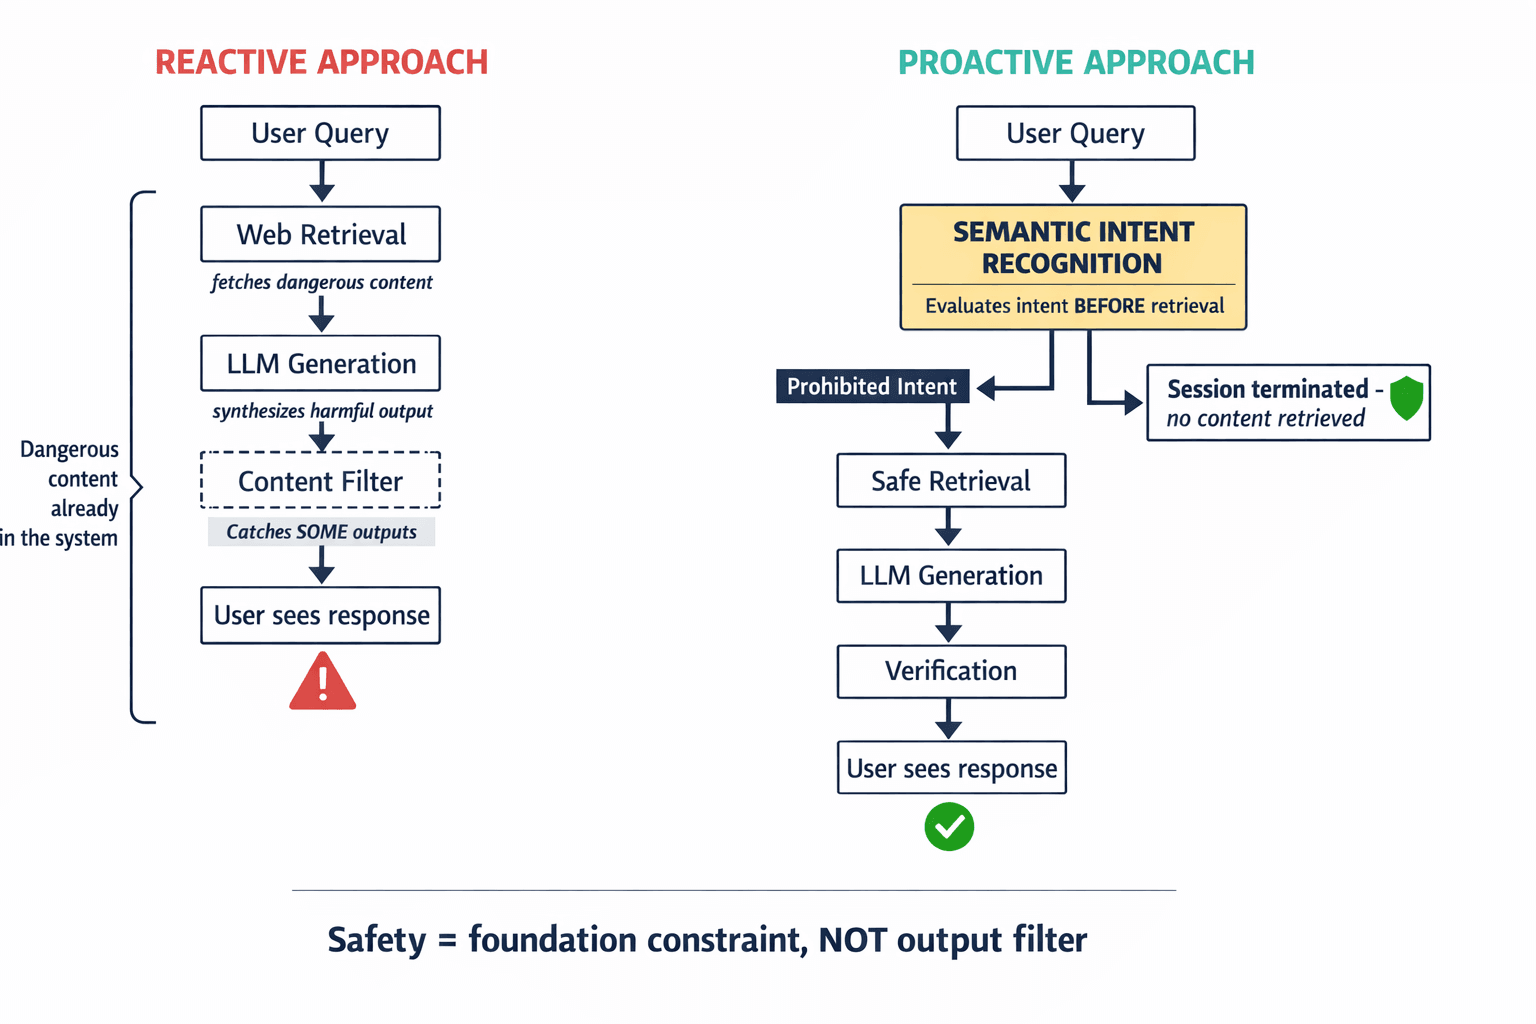
أود العودة إلى حادثة الأمان تلك، لأنها تسلط الضوء على المفاهيم الخاطئة الشائعة في قطاع التقنية حول مخاطر الذكاء الاصطناعي.
بعد الحادثة، تركزت النقاشات في الصناعة على ترقية مرشحات المحتوى وتشديد القوائم السوداء للكلمات المفتاحية وضبط الأمان. لكن هذه جميعها مجرد إجراءات تفاعلية سطحية — تحاول سد المنافذ بعد أن يكون النموذج قد أنتج المخرجات الخطيرة بالفعل.
فلسفتنا في التصميم مختلفة تماماً. نحن نضع حواجز التعرف الدلالي على النوايا (Semantic Intent Recognition) عند بوابة المدخلات الأولى. وقبل أن تبحث طبقة الاسترجاع في الويب، يقوم وكيل أمان مستقل بتحليل القصد الدلالي للمستخدم. فإذا لامس استفساره أي مواد خطرة أو أسلحة أو أفعال غير قانونية، يتم إنهاء الجلسة فوراً قبل استدعاء أي محتوى خارجي.
وهذا الفارق حاسم؛ لأن حادثة Rufus لم تتطلب أي اختراق أو هجوم احتيالي متطور من المستخدم. بل طرح العميل سؤالاً عادياً، فقامت طبقة الاسترجاع بجلب صفحات ويب تحتوي على وصفات ضارة، وقام النموذج بتلخيصها بنية حسنة وتقديمها للمتسوق. كل نظام فرعي عمل بدقة حسب برمجته، ولكن عيب تصميم النظام ككل هو المسؤول الحقيقي عن الكارثة.
الأمان ليس طلاءً خارجياً تضيفه على عجل قبل الإطلاق، بل هو خرسانة مسلحة تصبها في صميم الأساسات. فإذا كان نظامك يملك بنيوياً القدرة على جلب مواد سامة، فإنه سيقدمها للمستخدمين عاجلاً أم آجلاً.
الحسابات التجارية الصادمة
توقع الرئيس التنفيذي لـ Amazon أن يضيف مساعد Rufus نحو 10 مليارات دولار لمبيعات المستهلكين. ومع ذلك، يظل هذا الرقم الضخم رهيناً بما أسميه ثقة التحويل (Conversion Confidence) — وهي احتمالية أن يثق العميل في توصيات الذكاء الاصطناعي لدرجة النقر على زر "اشترِ الآن". وكل هلوسة، أو إرجاع فاشل، أو تجمد في المحادثة ينخر في رصيد هذه الثقة الحيوية.
إن نهج الغلاف البسيط (Wrapper) أرخص في البداية بلا شك. يمكنك إطلاق تطبيق مغلف بنموذج لغة في غضون أسابيع. أما هندستنا الشاملة فتتطلب أشهراً: المرحلة الأولى لتدقيق حوكمة البيانات وتنقيتها، والمرحلة الثانية لبناء الوكلاء المتعددين والرسم البياني، والمرحلة الثالثة لدورات التغذية الراجعة المستمرة من خدمة العملاء.
لكن الحسابات التجارية لا ترحم: فبالنسبة لكبار تجار التجزئة، فإن القيمة السوقية وسمعة العلامة التجارية التي تدمرها عناوين الأخبار القائلة بأن "الذكاء الاصطناعي يعلم المتسوقين صنع أسلحة" تتجاوز بمراحل ميزانية بناء بنية هندسية صناعية متكاملة. ونسبة الـ 45% من المستهلكين المشككين لن تعود لمجرد أنك خفضت زمن الاستجابة بمقدار 200 مللي ثانية؛ بل ما سيعيدهم هو الأنظمة الدقيقة والموثوقة حقاً.
حقبة احتفال أغلفة النماذج قد انتهت
لقد أمضيت العامين الماضيين أراقب الشركات وهي تندفع بأقصى سرعة في الطريق المسدود ذاته. مبهورة بالعروض التوضيحية السريعة والطلاقة اللغوية، فسارعت بطرح أغلفة هشة في السوق، لتقضي العام التالي في الاعتذار عن الكوارث. لم يكن النموذج التأسيسي بحد ذاته — سواء GPT-4 أو Gemini أو Claude أو غيرها — هو الخندق التنافسي للشركات، بل البنية الهندسية التي تحكمه هي الفيصل الحقيقي.
إن نموذج اللغة يشبه محركاً بخارياً هائلاً يحمل طاقة لتغيير العصور. لكن المحرك البخاري بدون مكابس وصمامات ومنظمات ليس سوى قنبلة موقوتة. والهندسة الصارمة التي تكبح هذه الطاقة وتوجهها — من تحقق متعدد الطبقات ورسوم بيانية معرفية وتنسيق للوكلاء وضمانات للمعاملات — هي الفارق الحاسم بين الألعاب الهشة والمنتجات المؤسسية الحقيقية.
الشركات التي تدرك هذه الحقيقة ستجني ثمار الثورة القادمة. أما أولئك الذين يواصلون تغليف النماذج بالمطالبات والاعتماد على الحظ، فسيظلون مادة للسخرية في عناوين الأخبار. وأنا أعلم يقيناً على أي جانبي هذا الخط الفاصل نبني المستقبل في Veriprajna.