Die formale Engine sagte "bewiesen". Der Chip war trotzdem kaputt.

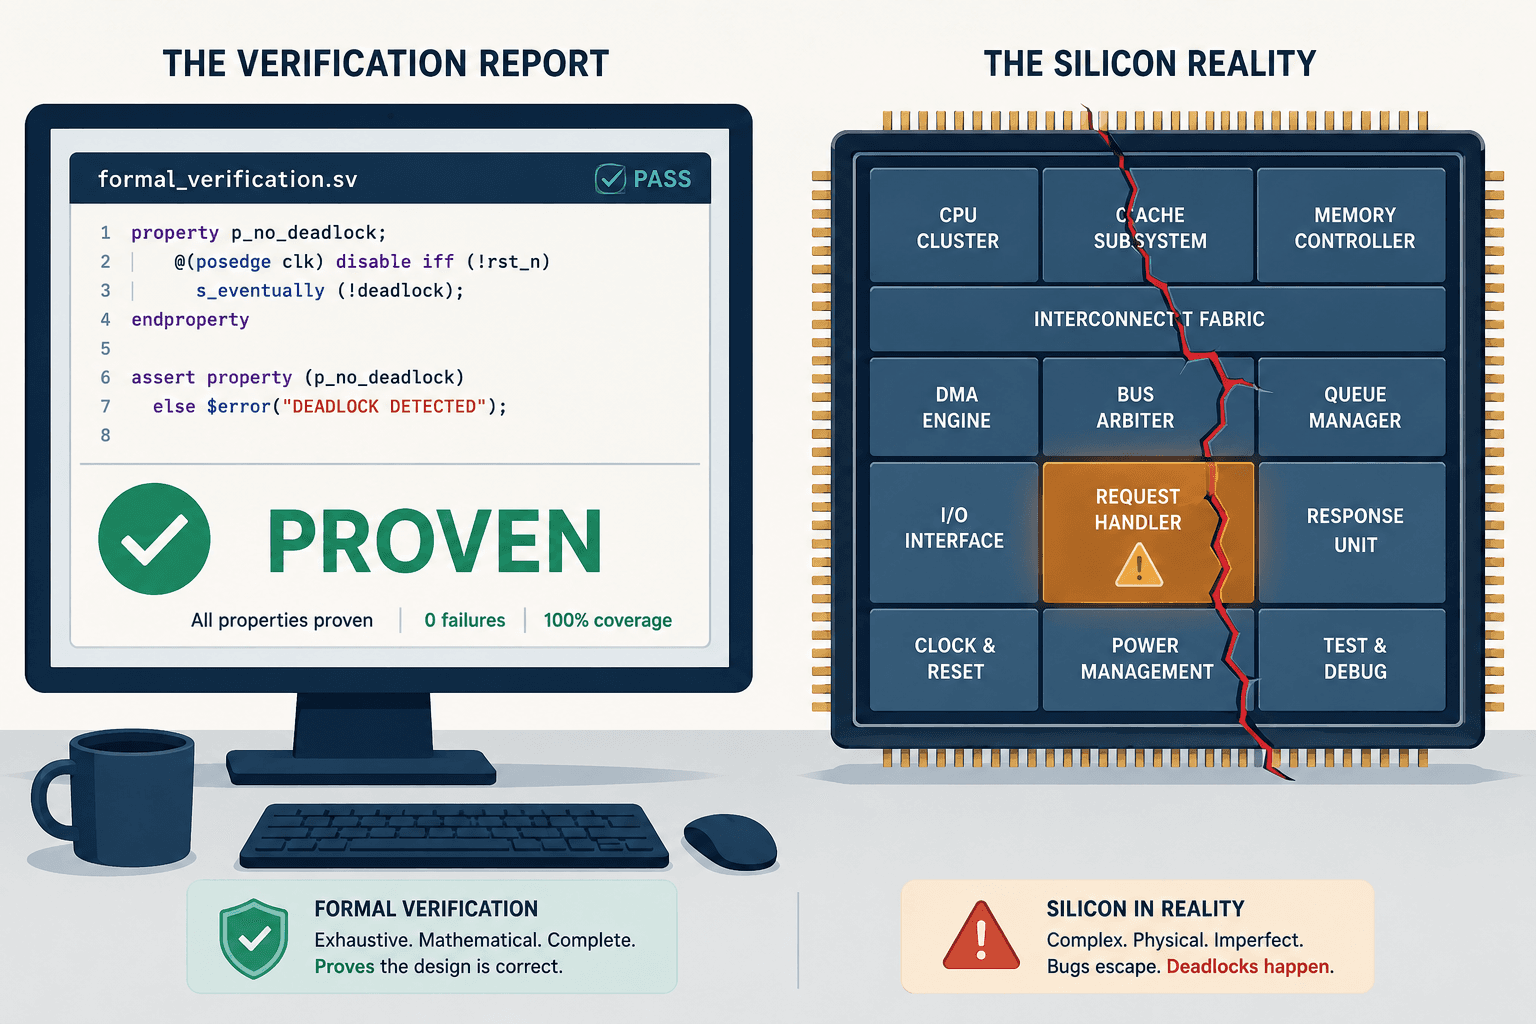
Das erste Mal, als eines unserer eigenen Werkzeuge mich anlog, tat es das höflich. Die formale Engine lieferte ein grünes Häkchen. Jede Eigenschaft, deren Beweis wir angefordert hatten, kam zurück als bewiesen. Die Assertion-Bibliothek wirkte vollständig. Auf dem Papier war das Design verifiziert.
Wir brauchten zwei Tage, um zu begreifen, dass das Zertifikat wertlos war — und dass alles, was ich über KI-gestützte Halbleiterverifikation angenommen hatte, uns vor dem falschen Fehler schützte.
Die Eigenschaften waren von einem großen Sprachmodell erzeugt worden, das wir um die formale Engine herumgebaut hatten — genau die Art von glatter, agentischer Chipdesign-Demo, die alle bauten. Und die Engine hatte sie in Millisekunden bewiesen, was das verräterische Zeichen hätte sein müssen. Sie galten als bewiesen, weil die Bedingungen, die sie geprüft hätten, nie ausgelöst wurden. Eine Eigenschaft, die besagt "jede Anfrage erhält irgendwann eine Freigabe", ist trivialerweise wahr, wenn die Anfrage niemals auftreten kann. Der Solver lag nicht falsch. Er beantwortete die Frage, die wir versehentlich gestellt hatten, und die Frage war leer. In diesem Moment verstand ich, wovor diese KI-Verifikations-Pipelines tatsächlich schützen müssen — und warum fast niemand, der eine verkaufte, sich gegen das Richtige wappnete.
Ich möchte Ihnen erzählen, was wir herausgefunden haben, denn die Fehlerklassen, die moderne Chips zu Fall bringen, sind nicht die, deren Erkennung die Branche bewirbt. Wir bauen maßgeschneiderte Verifikations-Pipelines für fabless Chip-Teams — feinabgestimmte Open-Weight-Modelle, die um die formale Engine herumgebaut sind, die ein Team bereits besitzt, und die vollständig auf dessen eigener Hardware laufen — und der gesamte Ansatz entstand daraus, dass wir das zuerst falsch gemacht haben. Die Form davon können Sie unter veriprajna.com/solutions/semiconductor-ai-verification sehen. Aber der Ansatz ergibt erst dann Sinn, wenn man ein "bestandenes" Design hat scheitern sehen.
Eine Zahl, die jeden fabless CFO erschrecken sollte
Eine einzige Statistik umreißt das ganze Problem. Die Studie "Functional Verification" der Wilson Research Group / Siemens EDA von 2024 — der am längsten laufende Benchmark der Branche — bezifferte den First-Silicon-Erfolg auf 14 %. Der niedrigste Wert seit zwanzig Jahren Erhebung. 2020 lag diese Zahl bei rund 32 %. Sie hat sich in vier Jahren mehr als halbiert.
Das ist keine Geschichte über Ingenieure, die faul werden. Es ist eine Geschichte über Komplexität, die den Werkzeugen davonläuft, und über eine Spezifikation, die schneller mutiert, als die Testbench ihr hinterherjagt. Dieselbe Studie ergab, dass rund 70 % der Respins durch Fehler verursacht werden, die mit Spezifikationsänderungen zusammenhängen — nicht durch reine Logikfehler.
Der First-Silicon-Erfolg sank nicht, weil Chip-Teams schlechter wurden. Er sank, weil sich die Spezifikation nun schneller bewegt, als die Verifikation sie abschließen kann.
Ich habe lange über dieser 70-Prozent-Zahl gebrütet, denn sie klagt still und leise viele "KI fürs Chipdesign"-Verkaufsgespräche an. Wenn die meisten Respins aus Spezifikationsdrift entstehen, dann adressiert ein Werkzeug, das nur Logikfehler findet, ein Stück des Problems und nennt es den ganzen Kuchen.
Und die Kosten des Irrtums sind auf eine Weise brutal, die Software-Leute unterschätzen. Ein 5-nm-Maskensatz kostet 10–20 Mio. $. Bei 3 nm nähern Sie sich 40 Mio. $, mit über siebzig Maskenschichten, darunter mehr als zwanzig EUV-Schichten. Ein vollständiger 2-nm-Tape-out kostet inzwischen in der Größenordnung von 725 Mio. $ all-in. Wenn etwas durchrutscht, ist ein Respin ein Terminverzug von 3 bis 6 Monaten obendrauf zur Maskenrechnung. In einem achtzehnmonatigen Produktfenster kann ein Verzug von sechs Monaten die Hälfte des Lebenszeitumsatzes eines Chips auslöschen. Der CFO sieht Verifikation nicht als Kostenstelle. Er sieht sie als Versicherung gegen einen einzigen achtstelligen Fehler.
Wie halluziniert ein LLM tatsächlich in Hardware?
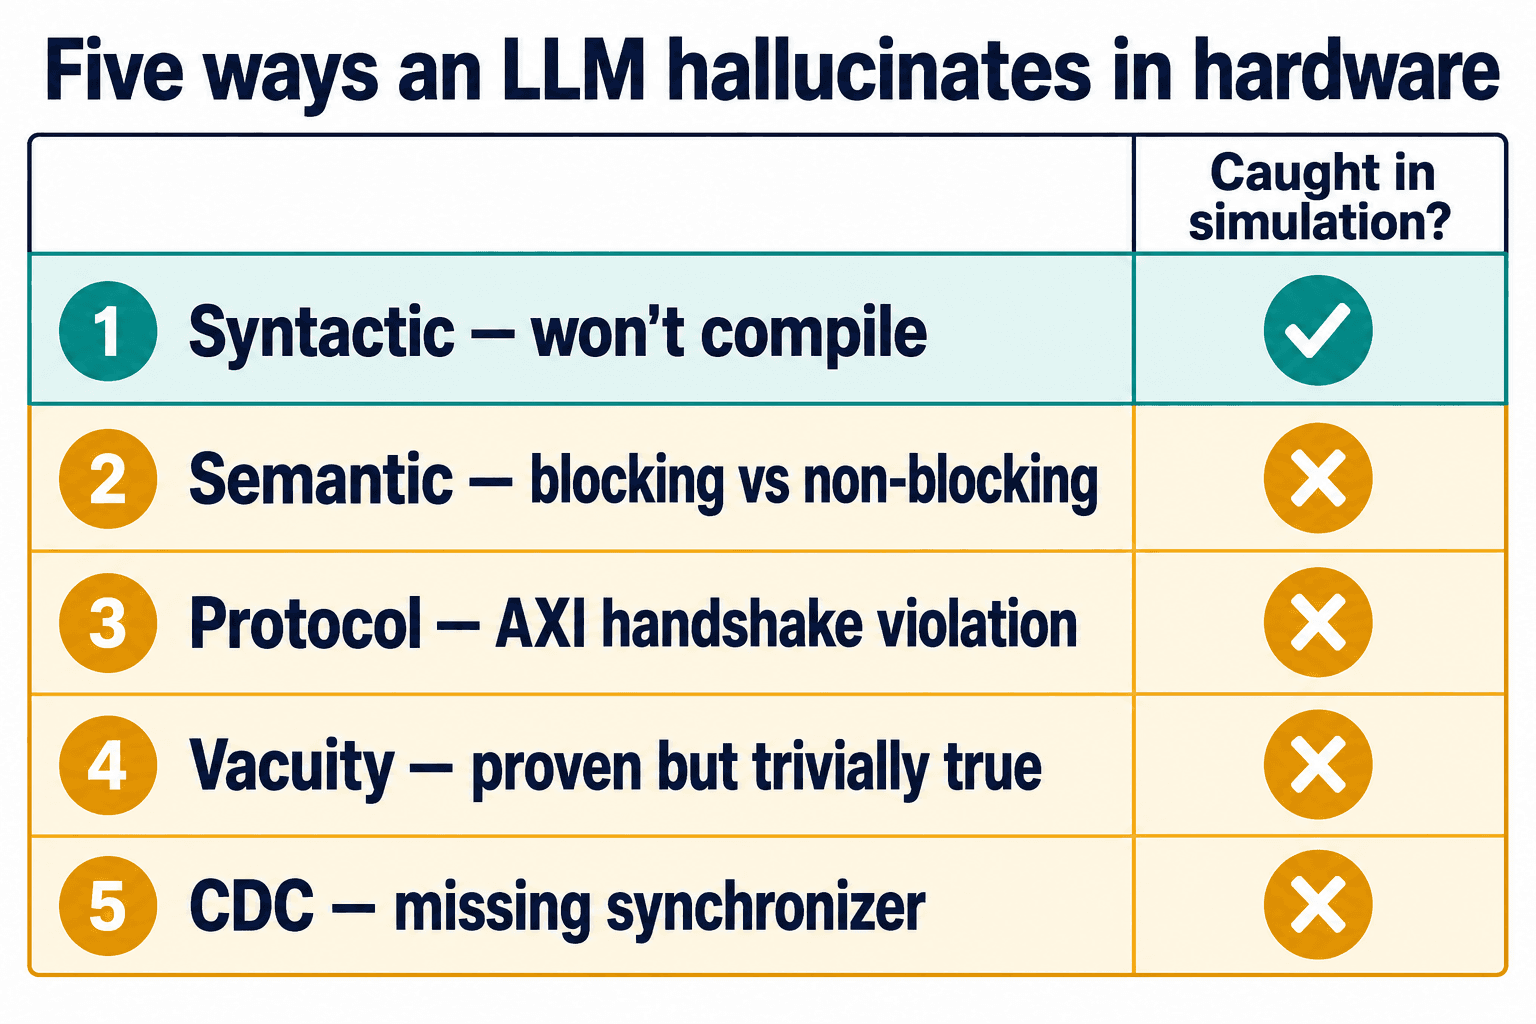
Ihr Team nutzt bereits LLMs für Verilog. Ich werde nicht so tun, als wäre es anders, und das sollte auch niemand, der an Sie verkauft. Das Forschungsfeld ist inzwischen real — Arbeiten über LLMs, die Verilog schreiben, stiegen von einer im Jahr 2020 auf vierundsechzig im Jahr 2025. Bei den schwierigeren Aufgaben im VerilogEval-Benchmark erreichen Modelle der GPT-4-Klasse etwa 43 % funktionale Korrektheit. Nützlich. Nicht vertrauenswürdig.
Die interessante Frage ist nicht, ob die Modelle helfen. Sie lautet, wie sie scheitern, denn die Fehlermodi sehen nicht aus wie die Fehler, die Software-Ingenieure zu fürchten gelernt haben. Nach genug durchwachten Nächten, in denen ich starrte, warum "korrekt aussehendes" RTL schiefging, begann ich, die Fehler in fünf Klassen einzuordnen.
Die erste ist die harmlose. Syntaktische Halluzination — Code, der sich schlicht nicht kompilieren lässt. Verilator oder das Synthese-Frontend fängt sie in Sekunden ab. Jeder weiß bereits, wie man damit umgeht, und es ist die Klasse, auf die die Leute zeigen, wenn sie behaupten wollen, das Problem sei gelöst.
Die zweite ist die, bei der es anfängt wehzutun. Semantische Halluzination, und der Lehrbuchfall ist blockierende versus nicht-blockierende Zuweisung. Ein Modell, das auf Python und C trainiert wurde, liest Verilog, als liefen Anweisungen von oben nach unten. Also schreibt es eine blockierende Zuweisung — ein schlichtes = — innerhalb eines getakteten always_ff-Blocks, wo die Sprache das nicht-blockierende <= verlangt. Der Designer wollte eine Zweizyklus-Pipeline. Mit blockierenden Zuweisungen liest die zweite Stufe den neuen Wert der ersten, nicht den alten, und das Silizium liefert einen Einzyklus-Bypass aus. Manche Simulatoren planen die Ereignisse in einer Reihenfolge, die die Race-Condition vollständig verbirgt. Es simuliert einwandfrei. Es synthetisiert zur falschen Maschine.
Die dritte Klasse ist jene, die mich lehrte, die AMBA-Spezifikation auf einem zweiten Monitor offen zu halten. Protokoll-Halluzination. Der Code kompiliert, besteht neunzig Prozent der gerichteten Tests und aktiviert dann ein Write-Data-Valid-Signal, bevor der Slave bereit ist, die Adresse anzunehmen — eine Verletzung des AXI-Handshakes. Oder er hält ein Valid-Signal high, während er die Daten darunter umschaltet. Oder er löst eine Unterklausel aus, vergraben auf Seite 84 der Bus-Spezifikation, die kein Mensch auswendig kennt. Der Chip funktioniert perfekt auf Ihrem internen Test-Harness und hängt sich in dem Moment auf, in dem er an einen Speichercontroller eines Drittanbieters angeschlossen wird. Das können Sie nicht mit mehr Simulationszyklen brute-forcen. Sie fangen es mit vorab verifizierten Assertion-Bibliotheken ab, die gegen jedes Protokoll geschrieben sind.
Die vierte Klasse ist jene, die uns hereinlegte, und sie ist die gefährliche.
Warum ist "bewiesen" das gefährlichste Wort in einem Verifikationsbericht?
Vakuitäts-Halluzination. Das Modell erzeugt eine SystemVerilog-Assertion. Die formale Engine beweist sie. Sie liefern aus. Und die Eigenschaft war trivialerweise wahr, weil ihr Antezedens — der "Wenn"-Teil — überhaupt nie wahr wurde.
Stellen Sie sich eine Arbiter-Eigenschaft vor: Wenn eine Anfrage erhoben wird, muss innerhalb einer bestimmten Anzahl von Zyklen eine Freigabe folgen. Nun nehmen Sie an, dasselbe Modell schrieb, um hilfreich zu sein, auch eine Annahme, die das Anfragesignal auf low zwingt. Die formale Engine beweist die Freigabe-Eigenschaft pflichtbewusst in Millisekunden, weil es keine Anfrage gibt, die sie je verletzen könnte. Der reale Arbiter darunter mag völlig kaputt sein. Das Zertifikat sagt "bewiesen". Es ist wertlos.
Ein formaler Beweis, der in Millisekunden läuft, ist nicht schnell. Er ist verdächtig. Die Engine hat möglicherweise überhaupt nichts bewiesen.
Das ist kein Randrisiko. Siemens veröffentlicht seit 2017 Warnungen vor vakuösen Beweisen, und das Feld liefert immer noch Flows ohne automatische Vakuitätsprüfung aus. Wenn ich den Leuten sage, dass ein formaler Verifikations-Flow ohne Vakuitätserkennung schlimmer ist als gar keine formale Verifikation, denken sie, ich dramatisiere. Tue ich nicht. Keine Verifikation lässt Sie angemessen verängstigt zurück. Ein vakuöses "bewiesen" lässt Sie selbstsicher und im Irrtum zurück, mit einem abgezeichneten Block auf dem Weg zum Tape-out. Das ist der Fehler, der in unserem eigenen frühen Prototyp beinahe ausgeliefert worden wäre, und er veränderte dauerhaft, was wir bauen.
Die fünfte Klasse ist jene, die die Simulation strukturell nicht sehen kann. Clock-Domain-Crossing-Blindstellen. Ein LLM liest Signalnamen; es nimmt keine Taktdomänen wahr. Also verbindet es ein Signal aus einer 2-GHz-CPU-Domäne direkt in ein 400-MHz-Peripheriedomänen-Flip-Flop und überspringt den Doppel-Flop-Synchronisierer, der Metastabilität verhindert. Die RTL-Simulation modelliert keine Metastabilität — also besteht die Regression, jedes Mal, und das Silizium blockiert im Feld. Deshalb fressen CDC-Bugs Maskensätze auf. Deshalb hat Accellera auch 2024 einen CDC/RDC-Interoperabilitätsstandard eröffnet: Die Fragmentierung über die kommerziellen CDC-Werkzeuge hinweg war schlimm genug geworden, um das Sign-off zu brechen.
Die Klassen zwei bis fünf teilen eine erschreckende Eigenschaft: Sie bestehen die Simulation. Sie treten erst im Silizium zutage. Das ist die Teilmenge von Bugs, die Tape-outs immer noch sprengt, und es ist genau die Teilmenge, die ein "fängt Logikfehler"-Verkaufsgespräch auf der Strecke lässt.
Die Anbieterwand, vor der ein Chip-Team tatsächlich steht
Als ich nach wirklich unabhängiger Hilfe für einen Tape-out suchte, kam ich auf weniger Optionen als noch ein paar Jahre zuvor — und das ist keine Nostalgie, es ist die Marktstruktur. Die drei EDA-Anbieter, aus denen ein Design-Verification-Lead tatsächlich wählen kann — Synopsys, Cadence, Siemens — sind von unter 75 % des Marktes vor einem Jahrzehnt auf über 85 % heute gestiegen. Rechnet man Synopsys' 35-Mrd.-$-Übernahme von Ansys hinzu, kontrollieren die Top vier rund 90 %. Das Feld, in dem ein fabless Startup einkauft, hat sich verengt, nicht verbreitert, genau als das Problem schwieriger wurde.
Und die etablierten Anbieter stehen bei KI nicht still. Synopsys lieferte AgentEngineer im März 2026 aus, einen agentischen Verifikations-Workflow, der eine zwei- bis fünffache Produktivität behauptet, und er sitzt auf VC Formal auf — der glaubwürdigste agentische Anbieter-Stack, den ich bewertet habe. Cadence kündigte seinen ChipStack AI Super Agent im Februar 2026 an und betreibt Cerebrus AI Studio für Reinforcement-Learning-getriebene Implementierung, wobei JasperGold die formale Goldstandard-Engine bleibt, an der sich alle anderen messen lassen. Ich sage das ohne Abstriche: JasperGold und VC Formal sind wirklich exzellent. Wer ein Verkaufsgespräch damit eröffnet, sie schlechtzumachen, hat Ihnen verraten, dass er nie einen echten Tape-out abgeschlossen hat.
Der Haken sind Preisgestaltung und Haltung. JasperGolds historische Basis lag bei rund 225.000 $ plus 45.000 $ pro Arbeitsplatz — in Ordnung für ein großes fabless Unternehmen, unerreichbar für die RISC-V- und KI-Beschleuniger-Startups im Frühstadium, die die interessanteste Arbeit leisten. Und die neuesten KI-Funktionen der etablierten Anbieter sind cloud-first, was frontal mit der einen Anforderung kollidiert, bei der diese Kunden nicht nachgeben werden. Dazu gleich mehr.
Dann gibt es die Startup-Welle, und sie ist laut. Auf der letzten DAC und DVCon war einem DV-Lead, mit dem ich arbeite, in einem einzigen Quartal von acht verschiedenen "agentische KI fürs Chipdesign"-Unternehmen ein Angebot gemacht worden. ChipAgents hat Anfang 2026 74 Mio. $ eingesammelt und behauptet eine zehnfache Design- und Verifikationsproduktivität. Normal Computing sammelte 50 Mio. $ ein, angeführt von Samsungs Catalyst Fund, und baut Auto-Formalisierung — LLMs, die die Absicht des Ingenieurs direkt in formale Eigenschaften übersetzen und sie beweisen — und sagt, die Hälfte der weltweit zehn größten Halbleiter-Designfirmen nutze es. Es gibt noch mehr: MooresLabAI, das vollständige Testbenches erzeugt, Bronco für Regressionsanalyse, Silimate für die Vorhersage von Power-Performance-Area.
Einige davon sind real. Keines von ihnen löst das eigentliche Problem des Kunden, nämlich dass er inzwischen drei dieser Einzelwerkzeuge gekauft hat und keine Ahnung hat, wie er sie innerhalb des Sign-off-Flows, dem er bereits vertraut, zusammenarbeiten lassen soll.
Die Reinforcement-Learning-Platzierungsgeschichte, die niemand laut aussprechen will
Es gibt jenseits der Verifikation eine parallele Versuchung im Chipdesign: Reinforcement Learning für das physische Floorplanning zu nutzen — also zu entscheiden, wo die großen Blöcke auf dem Die sitzen. Es ist verführerisch, und das meistzitierte Ergebnis ist auf eine Weise umstritten, die die meisten Verkaufsgespräche bequemerweise auslassen.
Das Google-Nature-Paper von 2020 behauptete, RL schlage Simulated Annealing bei der Makroplatzierung, und es wurde in echtem Silizium verwendet — TPU-Generationen wurden damit ausgeliefert. Doch 2023 fügte Nature nach aufgeworfenen methodischen Bedenken eine redaktionelle Anmerkung hinzu. Igor Markov, jetzt bei Synopsys, veröffentlichte eine zeilenweise Kritik, deren Kernvergleich schwer wieder zu vergessen ist: Der RL-Ansatz brauchte 32,31 Stunden, eine abgestimmte Simulated-Annealing-Basislinie brauchte 12,5 Stunden, und ein kommerzielles Cadence-Werkzeug erledigte dieselbe Aufgabe in 0,05 Stunden. DeepMind konterte mit einem Paper mit dem Titel "That Chip Has Sailed." Jahre später hat keine unabhängige externe Replikation die ursprünglichen Behauptungen bestätigt, und sowohl die Kritik als auch die Erwiderung sind noch offen.
Ich bringe das zur Sprache wegen dem, was passiert, wenn ein Berater einem echten formalen Team RL-Platzierung anpreist und so tut, als existiere die Kontroverse nicht. Sie riechen es innerhalb von zehn Minuten, und Sie haben den Raum verloren. Die ehrliche Position ist, dass es echte Nischen gibt — Chiplet- und 3D-IC-thermik-bewusstes Floorplanning, Analog-Layout, RISC-V-IP-Optimierung auf offener Toolchain — in denen ein hybrider Ansatz seinen Wert einbringt. Ein Frontalangriff auf die Platzierungs-Engines der etablierten Anbieter tut das nicht. Den Unterschied zu kennen und ihn laut auszusprechen, ist die eigentliche Aufgabe.
Was sich änderte, nachdem unser Werkzeug uns hereinlegte
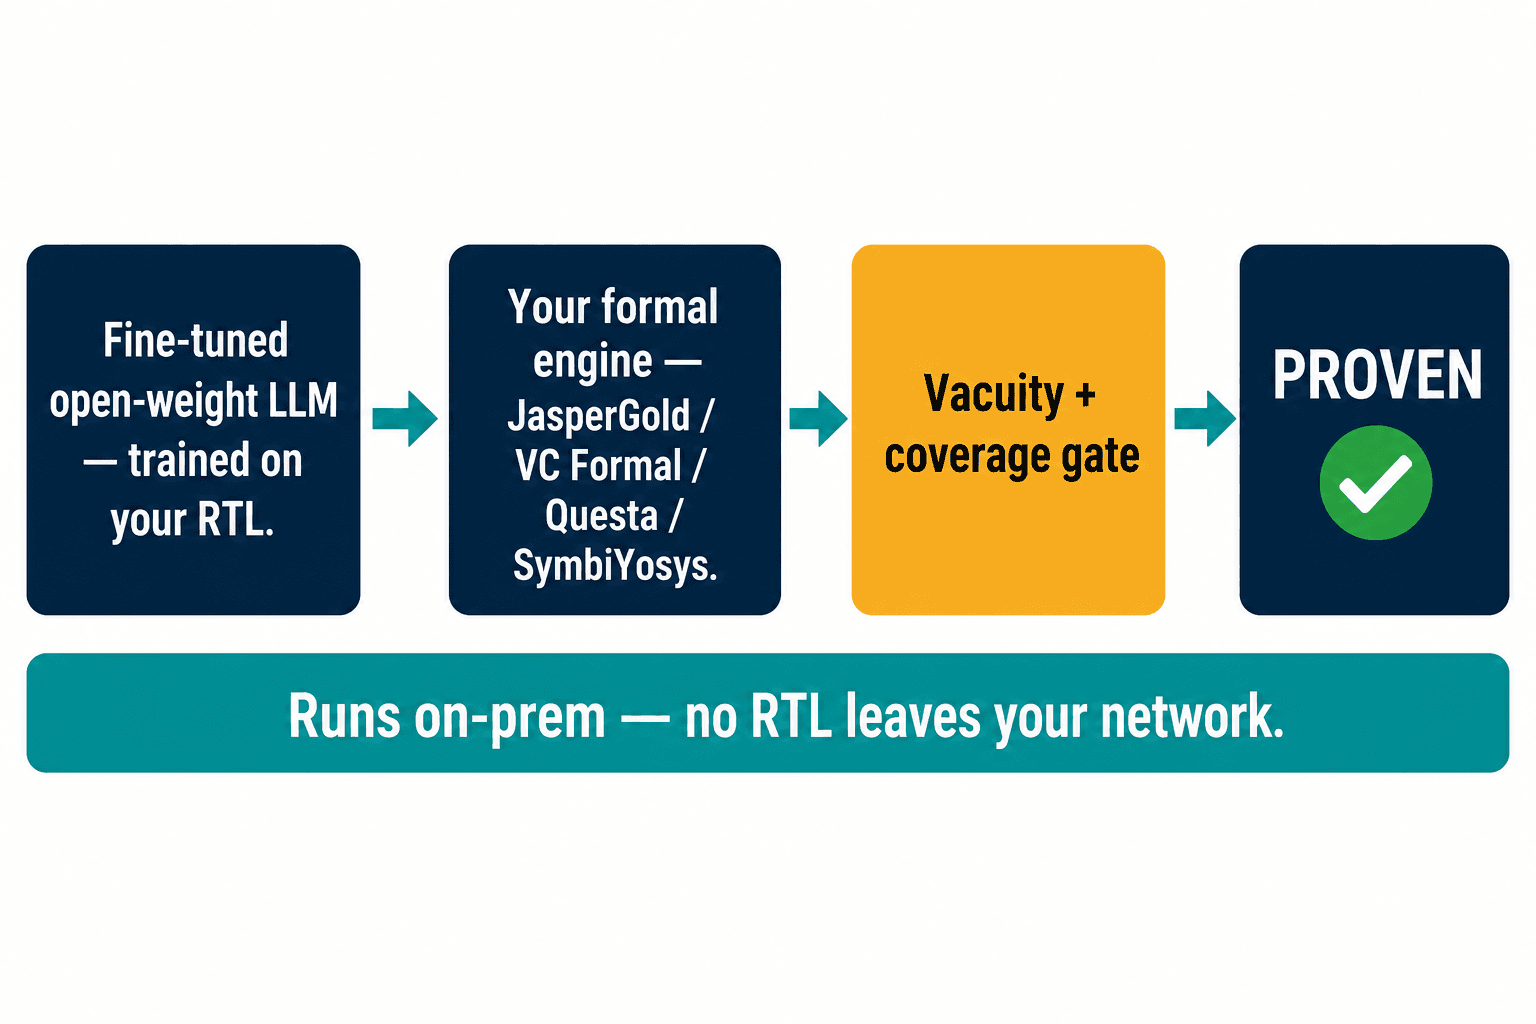
Hier also hat uns das Vakuösbeweis-Desaster hingeführt. Wir hörten auf, eine bessere KI zu bauen, die Verilog schreibt, denn das ist ein überfülltes Rennen mit acht finanzierten Läufern, und begannen, das zu bauen, was keiner von ihnen verkauft: die anbieterneutrale Integrationsschicht, die die vorhandenen Werkzeuge eines Teams vertrauenswürdig macht.
Konkret bedeutet das ein paar Entscheidungen, jede erzwungen durch einen Fehler, den wir gesehen hatten. Wir stimmen ein Open-Weight-Modell fein ab — Qwen Coder, Llama, was auch immer passt — auf dem eigenen RTL-Korpus des Kunden, seinen Spezifikationen, seiner bisherigen Fehlerhistorie, denn ein Modell, das Ihren Hausstil nicht gesehen hat, halluziniert dagegen. Wir bauen es um die formale Engine herum, die das Team bereits besitzt: JasperGold, VC Formal, Questa Formal oder das quelloffene SymbiYosys. Wir verlangen nie von ihnen, das Goldstandard-Werkzeug herauszureißen, dem sie bereits vertrauen. Und jede Eigenschaft, die das Modell vorschlägt, durchläuft Vakuitäts- und Coverage-Prüfungen, bevor irgendjemand das Wort "bewiesen" lesen darf — denn wir haben auf die teure Weise gelernt, dass ein ungeschützter Beweis Theater ist.
Die vorab verifizierten Assertion-Bibliotheken zählen genauso viel wie das Modell. Für einen RISC-V-Kern wird das formale Harness mit den AXI4-, AHB- und TileLink-Compliance-Prüfungen, den Pipeline-Hazard-Assertions, dem Load-Store-Scoreboarding und den Korrektheitseigenschaften der Debug-Einheit ausgeliefert — den Dingen, die Protokoll- und semantische Halluzination abfangen, bevor das Silizium es tut. Das ist nicht spekulativ. Die formale Beratungsfirma Axiomise hat über 65 Bugs in Ibex gefunden, dem offenen RISC-V-Kern innerhalb von Googles OpenTitan, darunter Branch-Instruction-Bugs in der Debug-Einheit, die nur formal gefunden werden konnten. Formal funktioniert bei RISC-V. Das Knappe ist nicht die Methode; es ist ein Team, das weiß, wie man sie einsetzt.
Die eigentliche Chance hier war nie ein klügeres Verilog-Modell. Es war ein ehrliches Harness, gebaut um die teuren Werkzeuge, denen ein Team bereits vertraut.
Warum lassen Sie es nicht einfach in der Cloud laufen?
Die Leute fragen mich das ständig, und die Antwort ist derselbe Grund, aus dem jedes cloud-first EDA-KI-Startup bei den Kunden, die mir am Herzen liegen, von vornherein zum Scheitern verurteilt ist: RTL sind die Kronjuwelen, und sie verlassen das Gebäude nicht.
Der Register-Transfer-Level-Code eines fabless Unternehmens ist das Unternehmen. Verteidigungs- und Luft- und Raumfahrtkunden brauchen ihn air-gapped, manchmal in einer sicheren Einrichtung. Kommerzielle fabless Teams wollen mindestens On-Prem, Virtual Private Cloud im absoluten Minimum. Also lassen wir alles auf der eigenen Hardware des Kunden laufen — vLLM oder ähnliche Inferenz auf ihrem vorhandenen H100- oder H200-Cluster, lokales Retrieval über ihrem eigenen Korpus, kein RTL, das jemals die Netzwerkgrenze überquert. Die neuesten agentischen Funktionen der etablierten Anbieter sind cloud-first; das ist ein Vorteil für sie und ein Ausschlusskriterium für ein IP-sensibles Chip-Team. Die größte Chance, die ich sehe, ist überhaupt kein Algorithmenproblem. Es ist ein Deployment- und Integrationsproblem, das die Leute mit den besten Algorithmen beschlossen haben, nicht zu lösen.
Die andere Frage kommt von den Automotive-Teams, und sie ist die, die für sie über alles entscheidet. Liefern Sie einen Chip bei ASIL C oder D in ein Auto — den Sicherheitsintegritätsstufen, auf denen die ISO 26262 formale Verifikation nicht mehr bloß empfiehlt, sondern vorzuschreiben beginnt — und das Werkzeug selbst muss ein TCL2- oder TCL3-Qualifizierungspaket mitbringen. Die Kern-Engines der etablierten Anbieter haben diese Drittanbieter-Zertifizierung; ein brandneues KI-Werkzeug hat sie nicht. Ich habe zugesehen, wie ein wirklich besseres Werkzeug in einem Automotive-Programm aus genau diesem Grund auf die Ersatzbank verwiesen wurde: kein Qualifizierungspaket, kein Platz im Sign-off-Flow, Ende der Diskussion. Also versuchen wir nicht, das qualifizierte Werkzeug zu sein. Wir helfen Teams, KI-Unterstützung neben den qualifizierten etablierten Engines laufen zu lassen, ohne die Qualifizierungskette zu brechen — denn im Automotive ist ein technisch überlegenes Werkzeug, das ein Audit nicht übersteht, nichts wert.
Das Zertifikat ist nicht der Chip
Ich komme immer wieder auf jene zwei Tage zurück, die wir damit verbrachten, einem grünen Häkchen zu vertrauen, das nichts bedeutete. Die Lektion war nicht "LLMs sind schlecht in Verilog". Sie werden jedes Quartal besser. Die Lektion war, dass in der Hardware die Kluft zwischen sieht verifiziert aus und ist verifiziert in achtstelligen Maskensätzen und sechsmonatigen Verzügen gemessen wird — und die Werkzeuge, die in diesen Bereich strömen, wetteifern größtenteils darum, den "sieht verifiziert aus"-Teil schneller zu machen.
Bei einem 10-Mio.-$-Maskensatz ist ein "bewiesen", das Sie nicht auf einen nicht-vakuösen Beweis zurückverfolgen können, ausgeführt auf Hardware, die Sie kontrollieren, gegen Assertions, die von jemandem geschrieben wurden, der Seite 84 der Spezifikation gelesen hat — das ist keine Verifikation. Es ist eine Hoffnung mit guten Produktionswerten. Wenn Sie sehen wollen, wie wir den Unterschied erkennen, ist alles dargelegt unter veriprajna.com/solutions/semiconductor-ai-verification.
Dem Chip ist es egal, was der Bericht sagt. Er tut nur, was das Silizium tatsächlich zu tun gebaut wurde. Verifikation ist die Disziplin, diese beiden Dinge gleich zu machen — und in dem Moment, in dem eine KI Ihnen in Millisekunden sagt, dass sie gleich sind, ist genau das der Moment, in dem Sie zur Spezifikation greifen sollten.