Retention-AI braucht einen Grund für Angebote

Ein Abonnent, der wahrscheinlich kündigt, ist ein offensichtlicher Kandidat für ein Retention-Angebot. Das macht Churn-Prediction zu einem verlockenden Ausgangspunkt für die Automatisierung. Die entscheidende Frage ist jedoch, ob diese konkrete Intervention das Ergebnis stark genug verbessert, um ihre Kosten zu rechtfertigen. Jemand kann mit hoher Wahrscheinlichkeit kündigen und dennoch kaum von einem Rabatt profitieren. Eine andere Person bleibt möglicherweise eher treu, bis die Intervention die Lage verschlimmert.
Ich möchte, dass Retention-Systeme sich die Entscheidung für ein Angebot erst erarbeiten, bevor sie die Fähigkeit erlangen, eines zu verfassen. Ein überzeugender Textentwurf kann die fehlenden Belege dafür, dass eine Intervention nützlich ist, nicht ersetzen. Und Belege dafür, dass ein Angebot helfen könnte, können nicht beweisen, dass die tatsächliche Botschaft akzeptabel ist. Dies sind getrennte Urteile mit separaten Gründen für die Zurückhaltung von Maßnahmen.
Dieselbe Anzahl an Angeboten kann unterschiedlichen Wert stiften
Unsere Demo „Ethical Subscription Retention AI“ nutzt eine synthetische Abo-Kohorte, um diese Unterscheidung überprüfbar zu machen. Der Vergleich evaluiert Richtlinien anhand verborgener synthetischer Ergebnisse, sodass er vergleichen kann, was mit einer Intervention geschieht und was ohne sie passiert. Diese verborgenen Ergebnisse dienen der Evaluierung und werden dem Modell nicht als Trainingslabels bereitgestellt.
Prädiktives Churn-Targeting und kausaler Uplift kontaktieren jeweils 2.239 der 6.000 Abonnenten der Kohorte mit aktuellen Kündigungsabsichten. Ersteres stuft das Churn-Risiko ein. Letzterer zielt auf den geschätzten Interventionsnutzen nach Berücksichtigung der konfigurierten Rabattkosten ab. Prädiktives Targeting generiert 144.162 $ an annualisiertem inkrementellem Umsatz im Vergleich dazu, die Kohorte unberührt zu lassen; Uplift generiert 187.956 $. Dies sind synthetische Richtlinienevaluierungen, getrennt von den vollständigen Routing-Beschränkungen der Demo für Abonnenten. Sie stellen weder realisierten Umsatz noch eine Prognose für einen im Einsatz befindlichen Dienst dar.
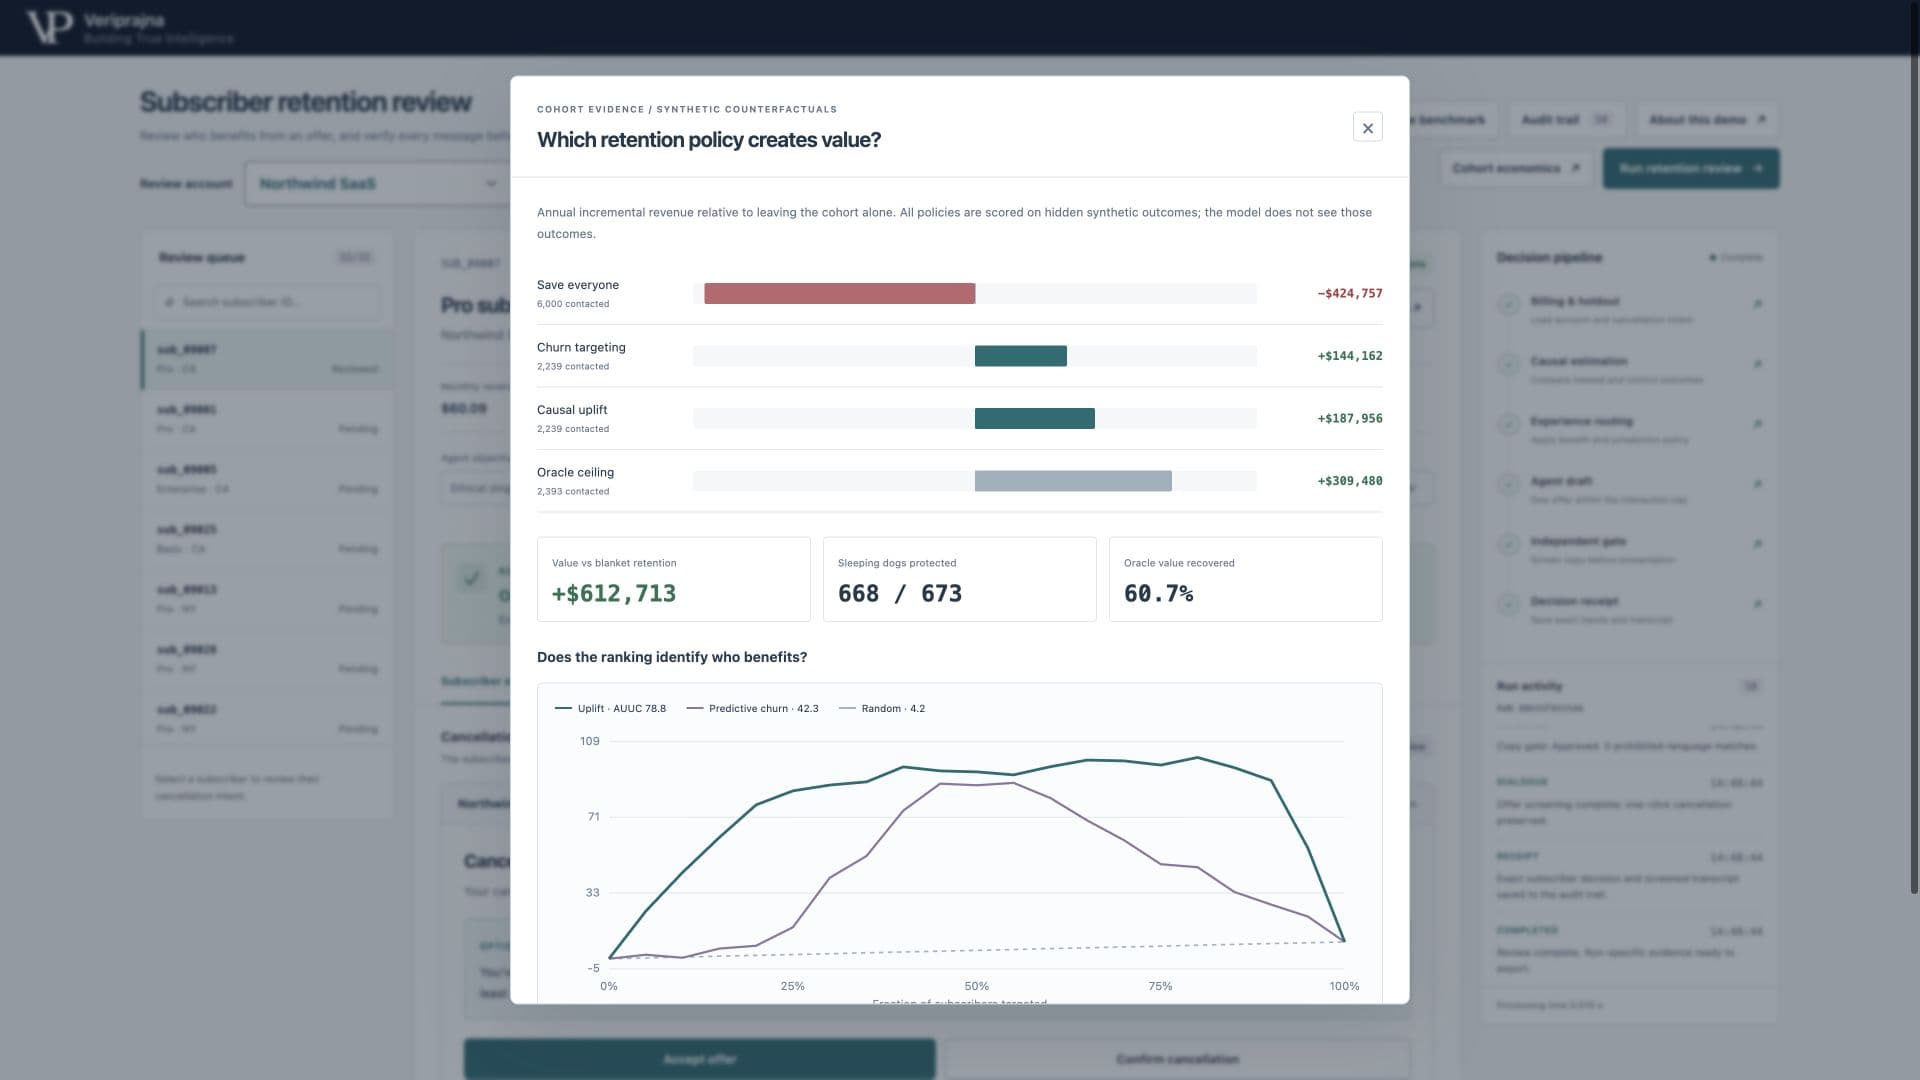
Das identische Kontaktbudget ist entscheidend. Der Vorteil der Uplift-Richtlinie entsteht hier nicht dadurch, dass weniger Angebote versendet werden. Er entsteht dadurch, dass eine andere Gruppe von Empfängern ausgewählt wird. Ein Team könnte ein Kontaktvolumenziel erreichen und seine Rabatte dennoch an Personen verschwenden, die ohnehin geblieben wären, an Personen, die das Angebot nicht überzeugen kann, oder an Personen, denen die Intervention schadet.
Dies verändert auch die Art und Weise, wie ich eine erfolgreiche Kundenrettung interpretiere. Ein Abonnent, der einen Rabatt annimmt, ist ein sichtbarer Erfolg für einen Angebots-Flow. Hätte dieser Abonnent zum vollen Preis verlängert, hat der Flow ein Ergebnis erkauft, das man nicht hätte kaufen müssen. Die bloße Zählung angenommener Angebote kann diese Kosten nicht aufdecken. Eine Evaluierung erfordert sowohl einen Vergleich mit dem Zustand ohne Intervention als auch die Berücksichtigung der Kosten des Angebots.
Zurückhaltung braucht eine Route, nicht nur einen Score
Die Demo schätzt die Retention mit und ohne Intervention auf Basis einer randomisierten Historie aus behandelter Gruppe und Kontrollgruppe. Ihre Differenz ist der geschätzte kausale Uplift: die Veränderung, die der Intervention unter dem Modell zugeschrieben wird. Es handelt sich um eine Schätzung, nicht um ein bekanntes kausales Ergebnis für einen einzelnen Abonnenten.
Ein synthetischer Abonnent weist mit Intervention eine wesentlich geringere geschätzte Retention auf als ohne sie. Die für diesen Abonnenten gewählte Route protokolliert keinen Retention-Kontakt und überspringt die Texterstellung. Die Modellierungsbezeichnung für diese durch die Intervention geschädigten Fälle lautet Sleeping Dogs. Auf dieser Route greift die Zurückhaltung, bevor eine überzeugende Botschaft zum standardmäßigen nächsten Schritt werden kann.
Die aggregierte Richtlinie ist unvollkommen. Sie lässt in der synthetischen Kohorte 668 von 673 echten Sleeping Dogs unkontaktiert, kontaktiert aber dennoch fünf. Anhand der verborgenen Fixture-Labels können wir diese Fehlschläge zählen. In einem produktiven System stünden sie als individuelle Ground Truth nicht zur Verfügung. Ich betrachte das Ergebnis als Anlass, schädliche Interventionen genau zu prüfen, nicht als Freibrief für die Behauptung, ein kausales Modell würde sie vollständig beseitigen.
Das ist ein unbequemer Grenzbereich für ein Retention-Team: Die Ablehnung eines Angebots kann eine echte Rettung verpassen, während die Genehmigung eines Angebots einen Rabatt verschwenden oder die Retention verschlechtern kann. Meine gestalterische Haltung besteht darin, beide Kosten sichtbar zu machen. Eine konservative Route ist eine Entscheidung unter Unsicherheit und sollte eine Begründung tragen, die man anfechten kann.
Was zu tun ist, wenn die Belege dünn sind
Ein zweiter synthetischer Account in der Demo weist zu wenige Daten für seine konfigurierten Evidenzanforderungen auf. Die Benutzeroberfläche hält kausale Entscheidungsprognosen zurück, überspringt den Agenten und bietet einen sauberen Ausstieg. Die Schwellenwerte sind Demonstrationsregeln, kein universeller Test auf statistische Hinlänglichkeit. Interne Berechnungen können weiterhin existieren; das entscheidende Verhalten ist, dass sie nicht zu Belegen für ein automatisiertes Angebot werden.
Es wäre einfach, diese fehlende kausale Empfehlung durch einen Churn-Score zu ersetzen. Das erhält die Automatisierung aufrecht, beantwortet aber eine andere Frage. Eine hohe Abwanderungswahrscheinlichkeit beweist nicht, dass der vorgeschlagene Rabatt die Entscheidung ändert. Die Ersetzung als Fallback zu bezeichnen, kann genau jene Unterscheidung verschleiern, für deren Erhalt das System gebaut wurde.
Für ein hypothetisches Produktivteam in dieser Situation befürworte ich einen vorübergehenden Ausstieg ohne automatisierten Retention-Rabatt, während es für die Intervention relevante Belege sammelt. Das kostet kurzfristig potenzielle Rettungen. Es vermeidet jedoch auch, weitreichende Rabattentscheidungen auf Basis eines Scores zu treffen, der deren Nutzen nicht misst. Diese Wahl sollte in der Evaluierung explizit sein, statt als Metrik erfolgreicher Abstinenz unsichtbar zu werden.
Wenn das Team beschließt, durch ein neues Experiment zu lernen, benötigt das Experiment eine Behandlungsgruppe, einen Vergleich ohne Intervention und definierte Angebotskosten. In diesem hypothetischen Szenario würde ich automatisierte Rabatte wieder einführen, sobald der Vergleich für die relevante Population einen inkrementellen Wert nach Kosten belegt. Mehr angenommene Angebote allein würden meine Entscheidung nicht ändern. Das Experiment erfordert weiterhin unabhängige Botschafts- und Kündigungskontrollen. Die bloße Anhäufung weiterer Churn-Beobachtungen beantwortet nicht, was das Angebot verändert. Dies ist eine separate, bewusst autorisierte Handlung; die Demo implementiert diesen produktiven Lernprozess nicht.
Der Wert eines Angebots genehmigt noch nicht die Botschaft
Selbst ein wirtschaftlich vielversprechendes Angebot bedarf einer weiteren Entscheidung, bevor es einen Abonnenten erreicht. Der verfasste künstliche Countdown-Benchmark der Demo macht dies greifbar: Ein deterministisches lexikalisches Gate außerhalb des Entwurfsmodells blockiert die Druck ausübende Botschaft, und der Wortlaut bleibt außerhalb der Abonnentenvorschau. Die Kündigung bleibt weiterhin möglich. Dies ist ein Referenztext-Fall, keine abgelehnte Modellantwort. Es demonstriert die Befugnis, eine Botschaft auch nach der Entscheidung, ein Angebot in Erwägung zu ziehen, zurückzuhalten.
Das Gate erkennt konfigurierte Sprachmuster; es zu passieren bescheinigt daher nicht jede Tatsache oder Bedeutung. Angebots- und Kündigungs-Buttons wirken sich zudem nur auf die lokale Vorschau aus, ohne Anbindung an ein produktives Abrechnungssystem. Innerhalb dieser Grenzen bietet die Kontrolle einen nützlichen Evaluierungstest: Ein unzulässiger Entwurf muss am Gate stoppen. Eine Warnung, die dieselben Worte auf ihrem Weg zum Abonnenten belässt, würde dieses Verhalten nicht gewährleisten.
Ein Team, das diese Architektur evaluiert, sollte daher zwei Dinge unabhängig voneinander testen: ob das Targeting inkrementellen Wert nach Kosten schafft und ob eine unzulässige Botschaft tatsächlich zurückgehalten wird. Starke ökonomische Werte können Druckausübung in der Botschaft nicht entschuldigen. Saubere Sprache kann kein Angebot retten, dessen erwarteter Nutzen seine Kosten nicht deckt.
Hier ist der Walkthrough des Gründers durch die Demo, einschließlich der Entscheidungen, ein Angebot zu unterbreiten oder einen Abonnenten in Ruhe zu lassen.
Das Demo-Erklärstück zeigt den synthetischen Workflow und dessen Entscheidungsbelege. Was ich Entwicklern und Entscheidern vermitteln möchte, ist ein Beschaffungs- und Evaluierungsstandard: Fragen Sie nach dem Grund, warum ein Angebot unterbreitet wurde, dem Grund, warum ein anderes zurückgehalten wurde, und den Belegen, die jede der beiden Entscheidungen ändern könnten. Ein System, das nur seine erfolgreichen Angebote erklären kann, überlässt das schwierigere Urteil allen nachgelagerten Stellen.