Verfolgen Sie die Kundenbindungsentscheidung von der Ökonomie bis zur Evidenz
Diese sechs nativen Aufnahmen zeigen einen synthetischen Kundenbindungsvergleich, Entscheidungen für ausgewählte Abonnenten und verfasste Textprüfungen. Northwind verzeichnet 6,000 aktuelle monatliche Kündigungsabsichten und 9,000 randomisierte historische Beobachtungen: 4,460 in der Behandlungs- und 4,540 in der Kontrollgruppe. Die 32-Fälle-Prüfwarteschlange ist eine repräsentative Auswahl zur Inspektion, keine Zufallsstichprobe der Kohorte. Jeder Screenshot öffnet sich in voller Größe.
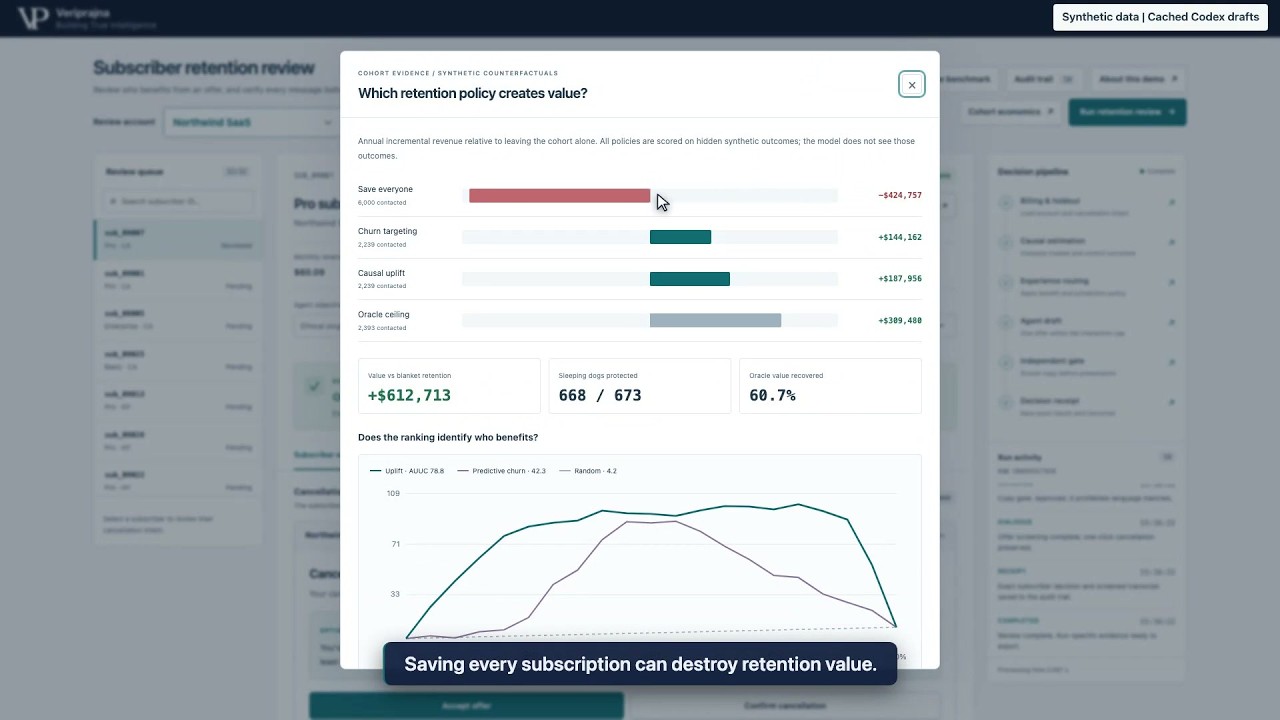
Policies bei gleichem Kontaktbudget vergleichen
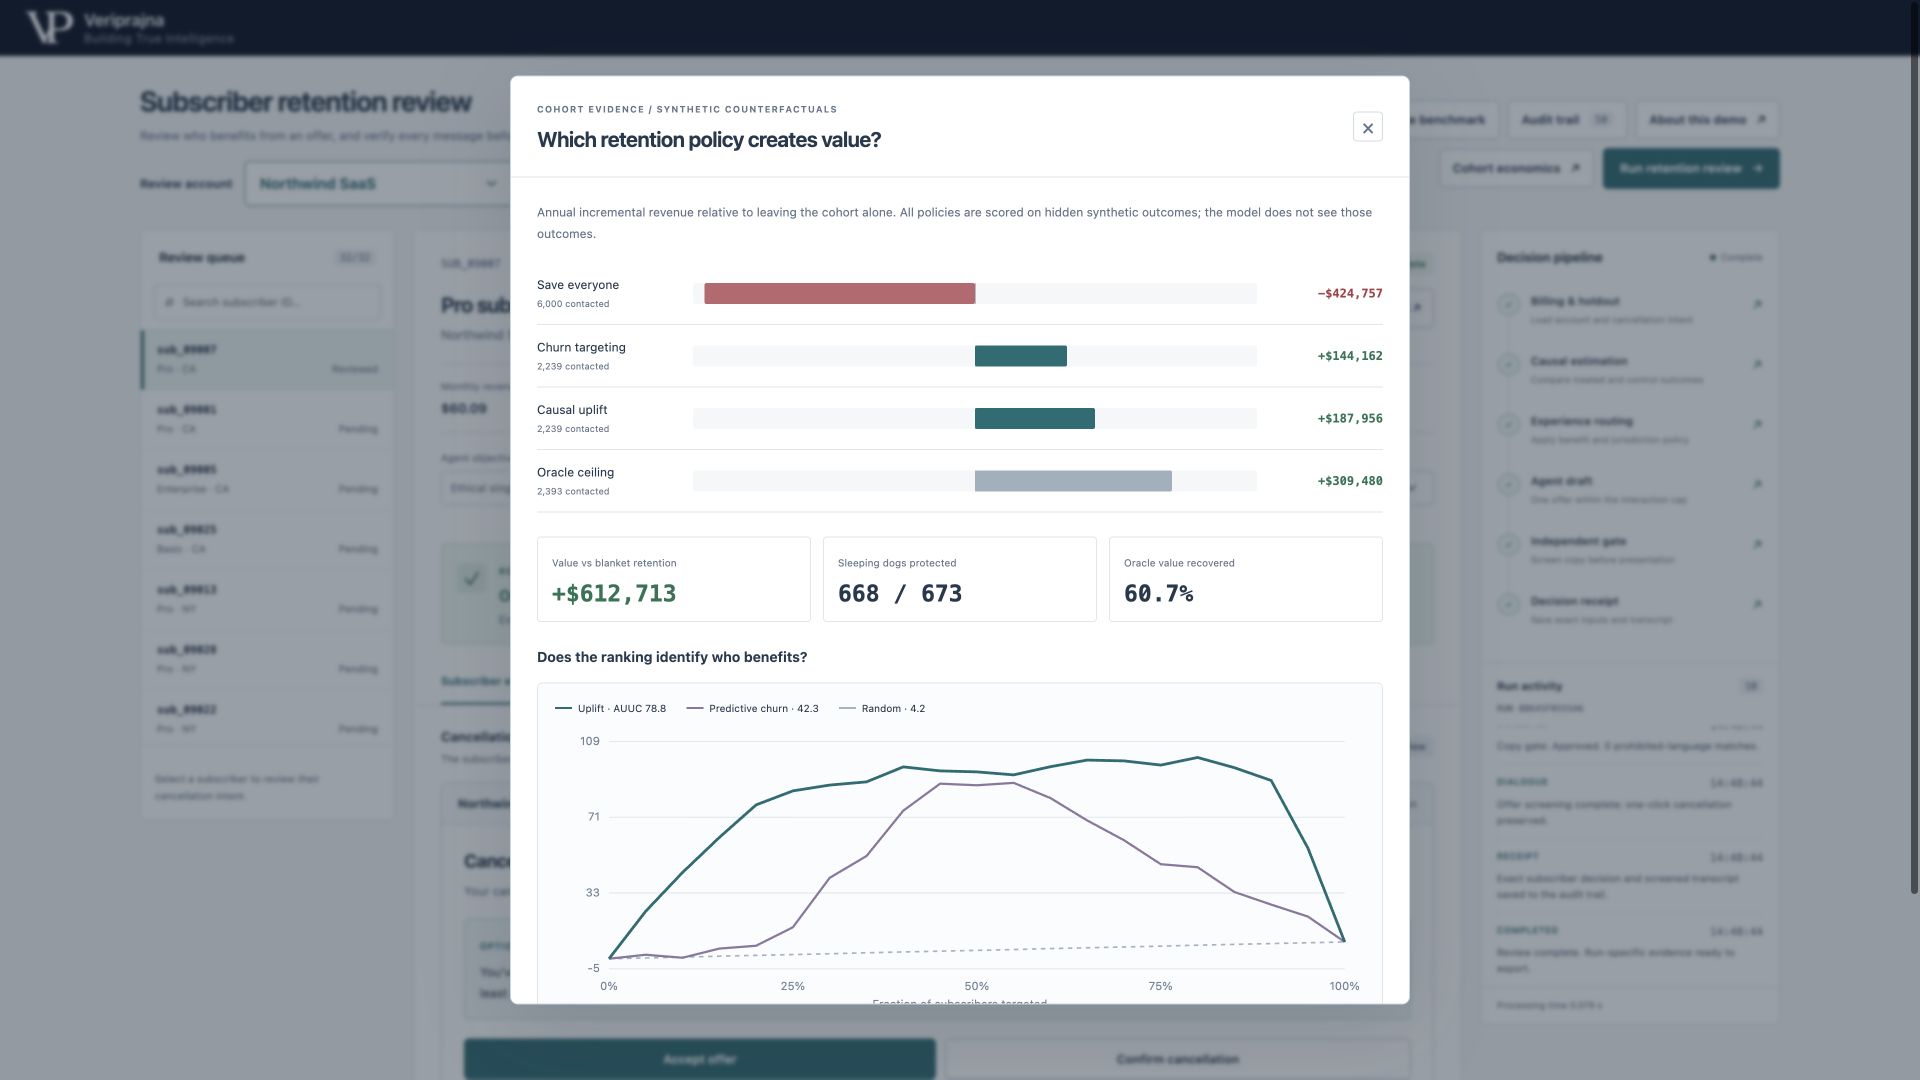
Save everyone kontaktiert alle 6,000 Kündigungsabsichten und generiert in diesem Testaufbau einen negativen inkrementellen Wert. Prädiktives Churn-Targeting und kausaler Uplift kontaktieren jeweils 2,239 Abonnenten, wählen diese jedoch aus unterschiedlichen Gründen aus: Das eine stuft nach der Abwanderungswahrscheinlichkeit ein, während das andere nach dem geschätzten Interventionswert abzüglich der Rabattkosten einstuft. Die Angleichung des Budgets isoliert diesen Targeting-Unterschied.
| Policy | Jährlicher Mehrumsatz | Kontaktierte Abonnenten |
|---|---|---|
| Save everyone | -$424,757 | 6,000 |
| Prädiktives Churn-Targeting | +$144,162 | 2,239 |
| Kausaler Uplift | +$187,956 | 2,239 |
| Perfektes Informationsorakel | +$309,480 | 2,393 |
Uplift übertrifft Churn-Targeting in dieser synthetischen Policy-Evaluierung um $43,794 pro Jahr. Die Werte werden anhand verborgener synthetischer potenzieller Ergebnisse berechnet und anhand des monatlichen Umsatzes mal 12 annualisiert. Sie stellen weder realisierte Kundeneinsparungen noch Prognosen für das vollständige operative Routing-System dar. Das Orakel sieht verborgene Ergebnisse, die einem im Einsatz befindlichen Modell nicht zur Verfügung stehen; es liefert daher eine Obergrenze bei perfekter Information und keine implementierbare Policy.
Die Ranking-Kurve fügt eine separate Prüfung auf 2,700 zurückgehaltenen randomisierten synthetischen Beobachtungen hinzu. AUUC steht für Area Under the Uplift Curve: Die angezeigten Werte betragen 78.8 für Uplift, rund 42.3 für prädiktiven Churn und rund 4.2 für zufälliges Ranking. Es handelt sich nicht um Genauigkeitsprozentsätze. Uplift kontaktiert weiterhin fünf der 673 Abonnenten, denen eine Intervention in der synthetischen Ground Truth schadet, und lässt 668 unkontaktiert; ein verbessertes Ranking begründet keinen perfekten Schutz.
Erklären, warum ein Abonnent keinen Kundenbindungskontakt erhalten sollte
Für einen synthetischen Northwind-Abonnenten schätzt das Modell eine Bindung von 87.1% ohne Intervention und 28.2% mit Intervention. Die Differenz beträgt -58.9 Prozentpunkte. Das Label Sleeping Dog bedeutet, dass die Intervention die Bindung schätzungsweise beeinträchtigt; das Routing für ausgewählte Abonnenten wählt daher Do Not Contact und überspringt den Save-Agenten.
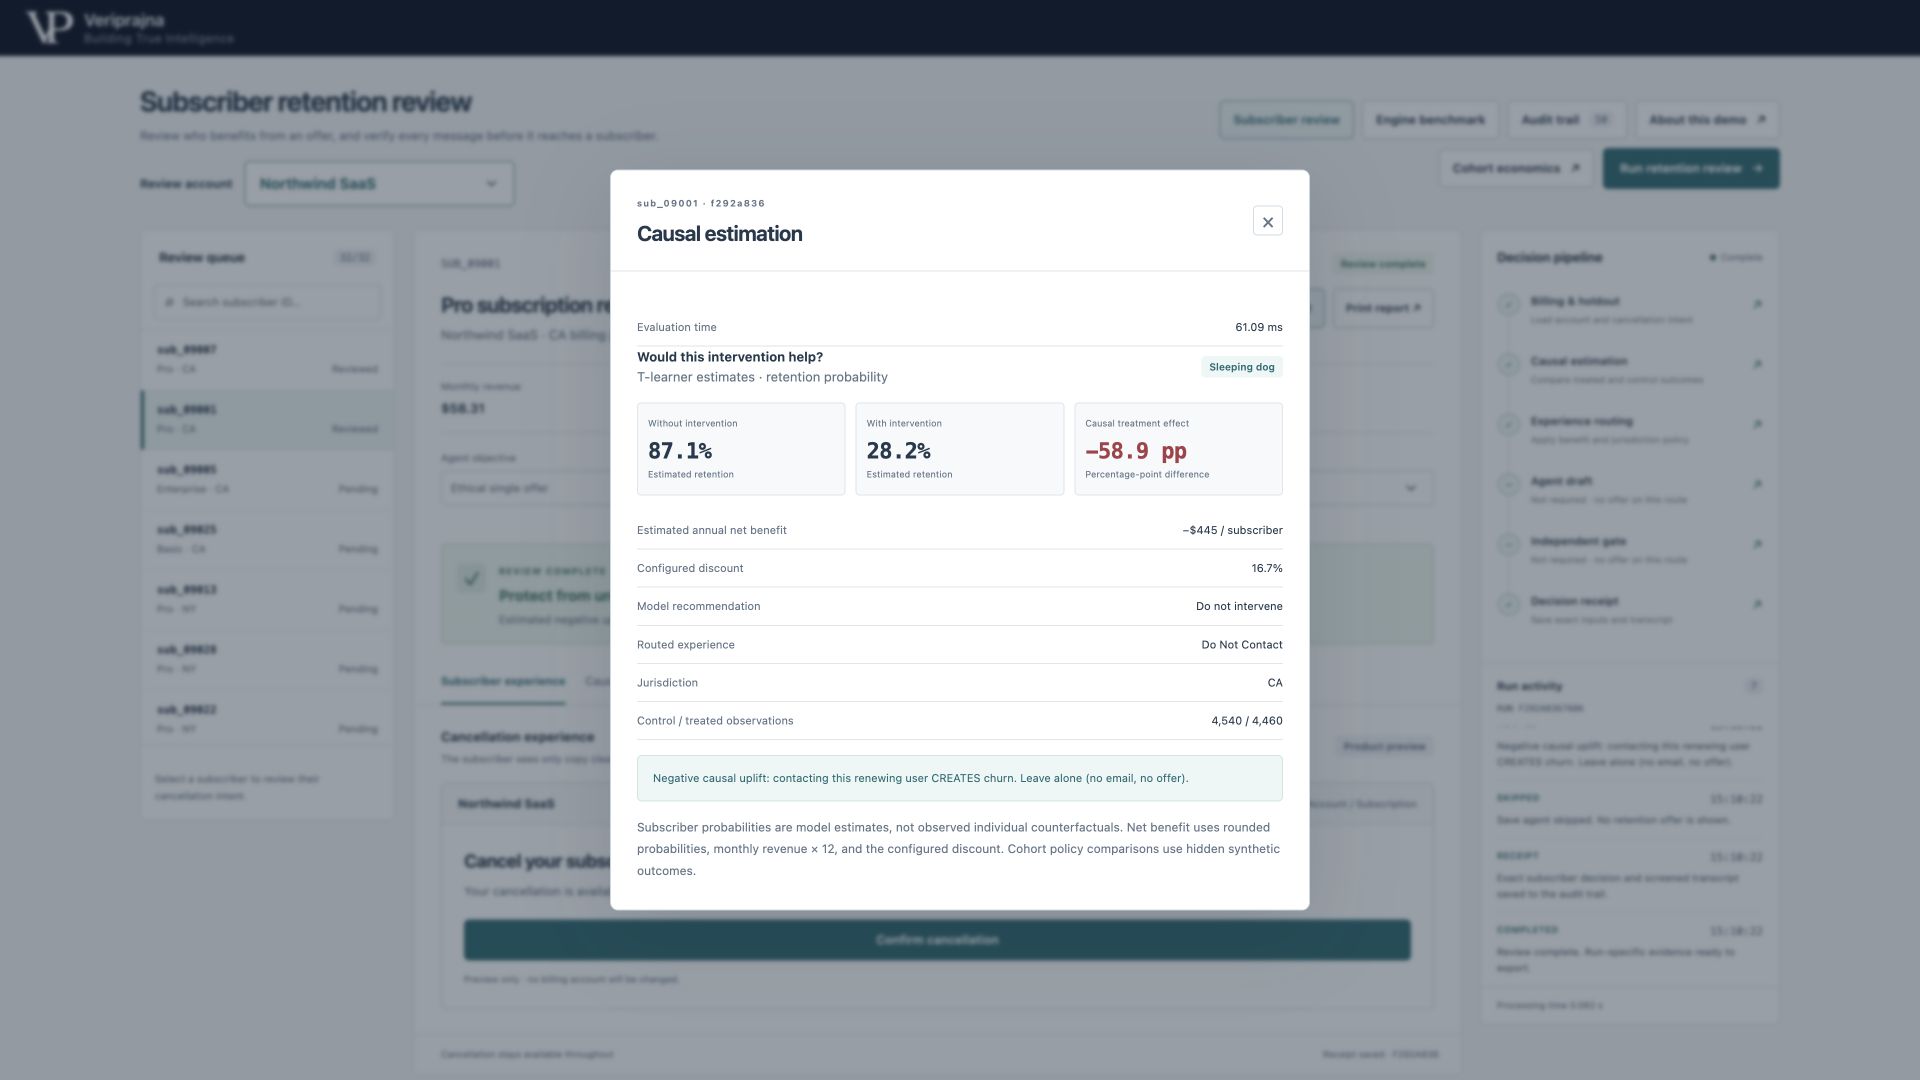
Die Routing-Regel kennzeichnet geschätzte Behandlungseffekte von -0.05 oder darunter als Sleeping Dogs. Schätzungen von +0.05 oder darüber sind Persuadables; unter den verbleibenden Fällen ergibt eine geschätzte Baseline-Bindung von mindestens 0.65 Sure Things, während die übrigen als Lost Causes eingestuft werden. Sure Things erhalten eine kurze Umfrage ohne Angebot, während Lost Causes und unbekannte Segmente einen sauberen Ausstieg erhalten. Dies sind konfigurierte modellbasierte Segmente, keine beobachteten individuellen kausalen Ergebnisse.
Die Entscheidung für keinen Kontakt und die aggregierte Policy-Metrik beantworten unterschiedliche Fragen. Dieser ausgewählte Abonnent vermeidet ein Angebot über die operative Route. Der Kohortenvergleich bewertet das Targeting unabhängig anhand verborgener synthetischer Labels und enthält nicht jede Segment- und Jurisdiktionsbeschränkung. Ein erfolgreiches lokales Beispiel ohne Kontakt kann die fünf schädlichen Kontakte in jenem aggregierten Vergleich nicht ungeschehen machen.
Ein berechtigtes Angebot muss seine Kosten decken und die Kündigung aufrechterhalten
Der synthetische Pro-Abonnent in dieser Aufnahme hat einen geschätzten Behandlungseffekt von +12.1 Prozentpunkten und eine geschätzte Baseline-Bindung von 58.6%. Ein positiver Behandlungseffekt allein autorisiert noch keinen Rabatt. Die Demo prüft die geschätzte Bindung mit dem Angebot nach seinem konfigurierten Rabatt von 16.7% im Vergleich zur Bindung ohne Intervention und wendet anschließend das Routing für ausgewählte Abonnenten sowie konfigurierte Jurisdiktionskontrollen an.
Der ökonomische Vergleich lautet: geschätzte Bindung der Behandelten multipliziert mit (1 minus Rabatt), abzüglich der geschätzten Bindung der Kontrollgruppe. Ein berechtigter Persuadable erreicht den Save-Agenten nur dann, wenn der geschätzte Zuwachs die Angebotskosten deckt. Das Beispiel mit Standardziel verwendet eine tatsächliche gecachte Codex-Antwort; das Text-Gate wird für diese zurückgegebenen Wörter erneut ausgeführt.
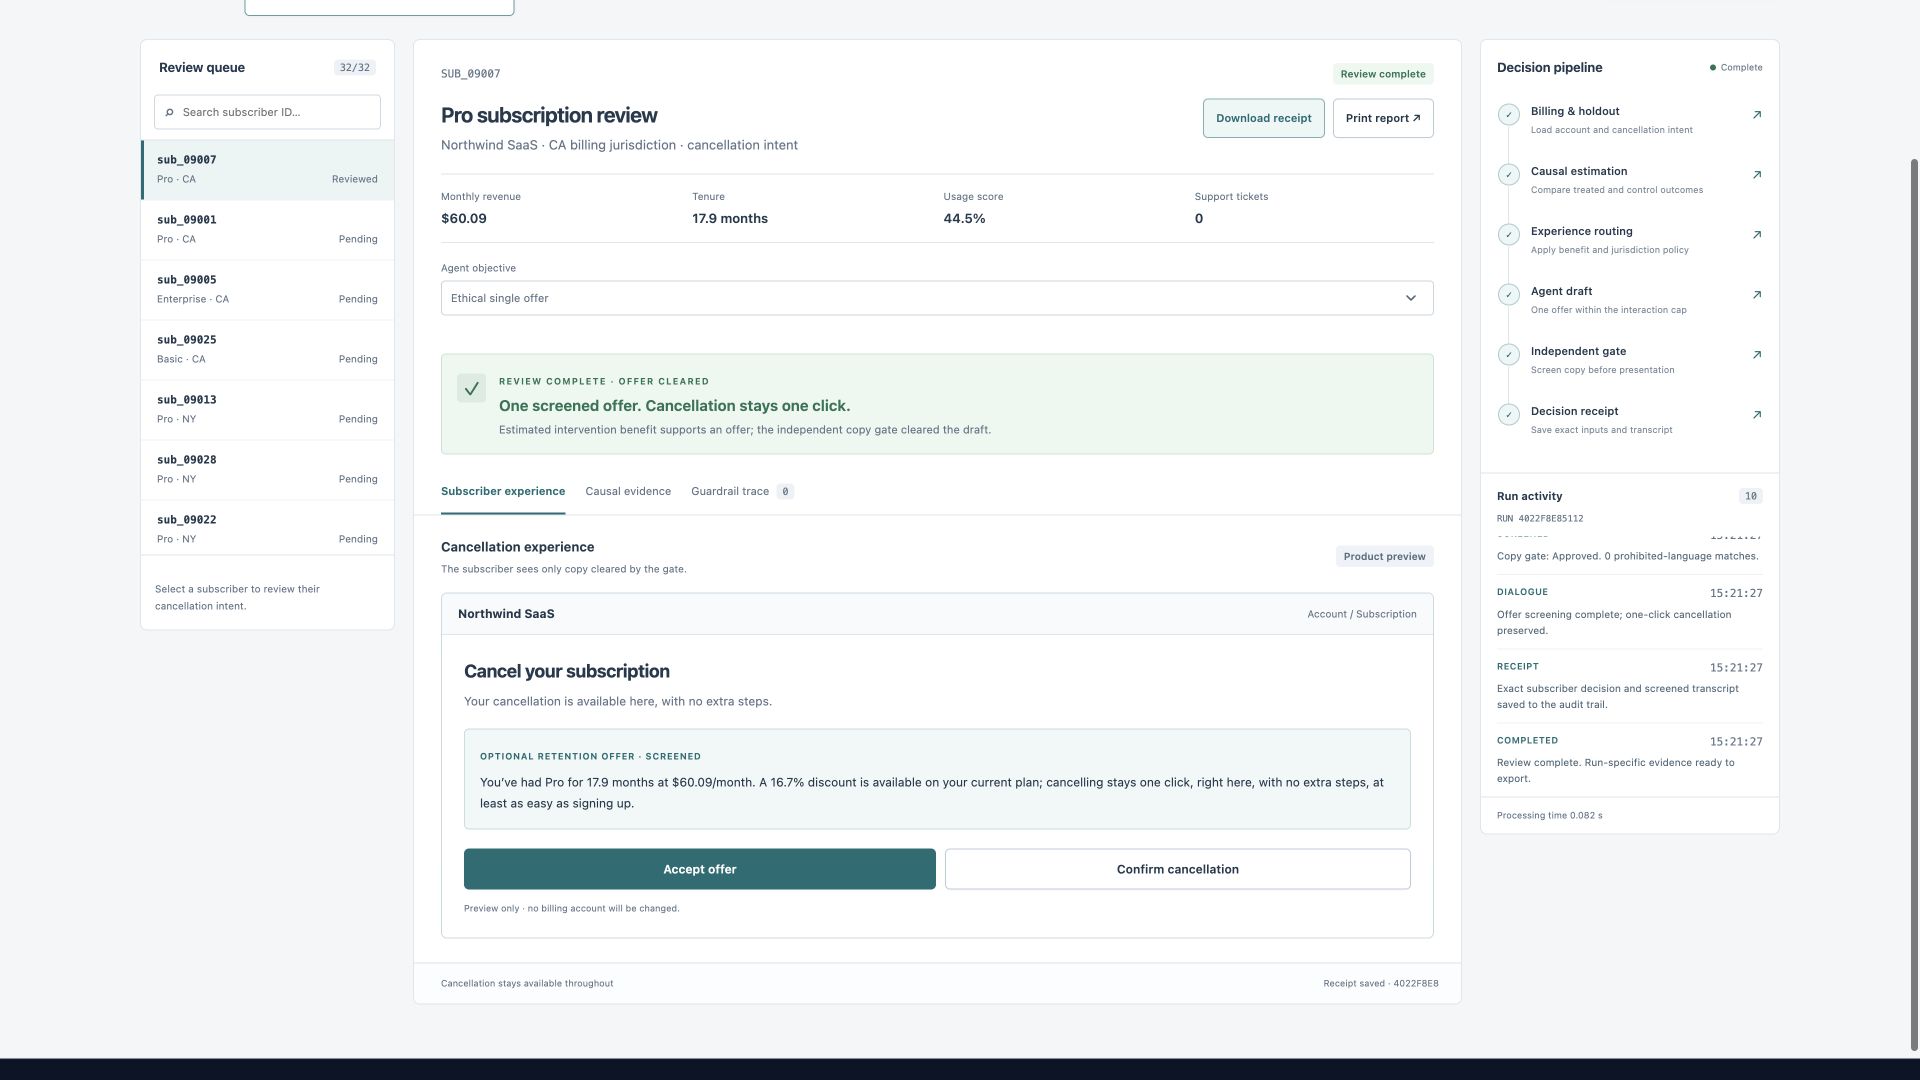
Ein freigegebenes optionales Angebot erscheint neben Confirm cancellation. Das konfigurierte Interaktionsbudget erlaubt höchstens ein Halteangebot und zwei Agenten-Züge; die Kündigung bleibt während der Entwurfserstellung und nach der Prüfung verfügbar. Review complete auf dem Bildschirm bezieht sich auf die automatisierte Pipeline, nicht auf eine abgeschlossene menschliche Prüfung. Angebotsannahme und Kündigung ändern nur diese lokale Vorschau, ohne ein Abrechnungskonto zu verändern.
Einen blockierten Satz unabhängig vom Entwurfsmodell prüfen
Das unabhängige Python-Gate normalisiert Unicode und prüft den eigentlichen Entwurf auf konfigurierte Muster von Confirmshaming, Schuldgefühlen, Druck und künstlicher Dringlichkeit. Auf eine Routing-Freigabe folgt daher eine separate Formulierungsentscheidung. Nur freigegebener Text erreicht die Abonnentenvorschau; blockierte und angehaltene Entwürfe bleiben intern.
Der nachfolgende Screenshot mit künstlichem Countdown zeigt bewusst verfassten Referenztext: "This deal disappears in 04:59. Act now!" Das Gate blockiert ihn und legt die erkannten Countdown- und Dringlichkeitsphrasen offen. Dies demonstriert eine konfigurierte Kontrolle über bereitgestellten Text und nicht ein Modell, das beim Erzeugen einer verbotenen Nachricht ertappt wurde.
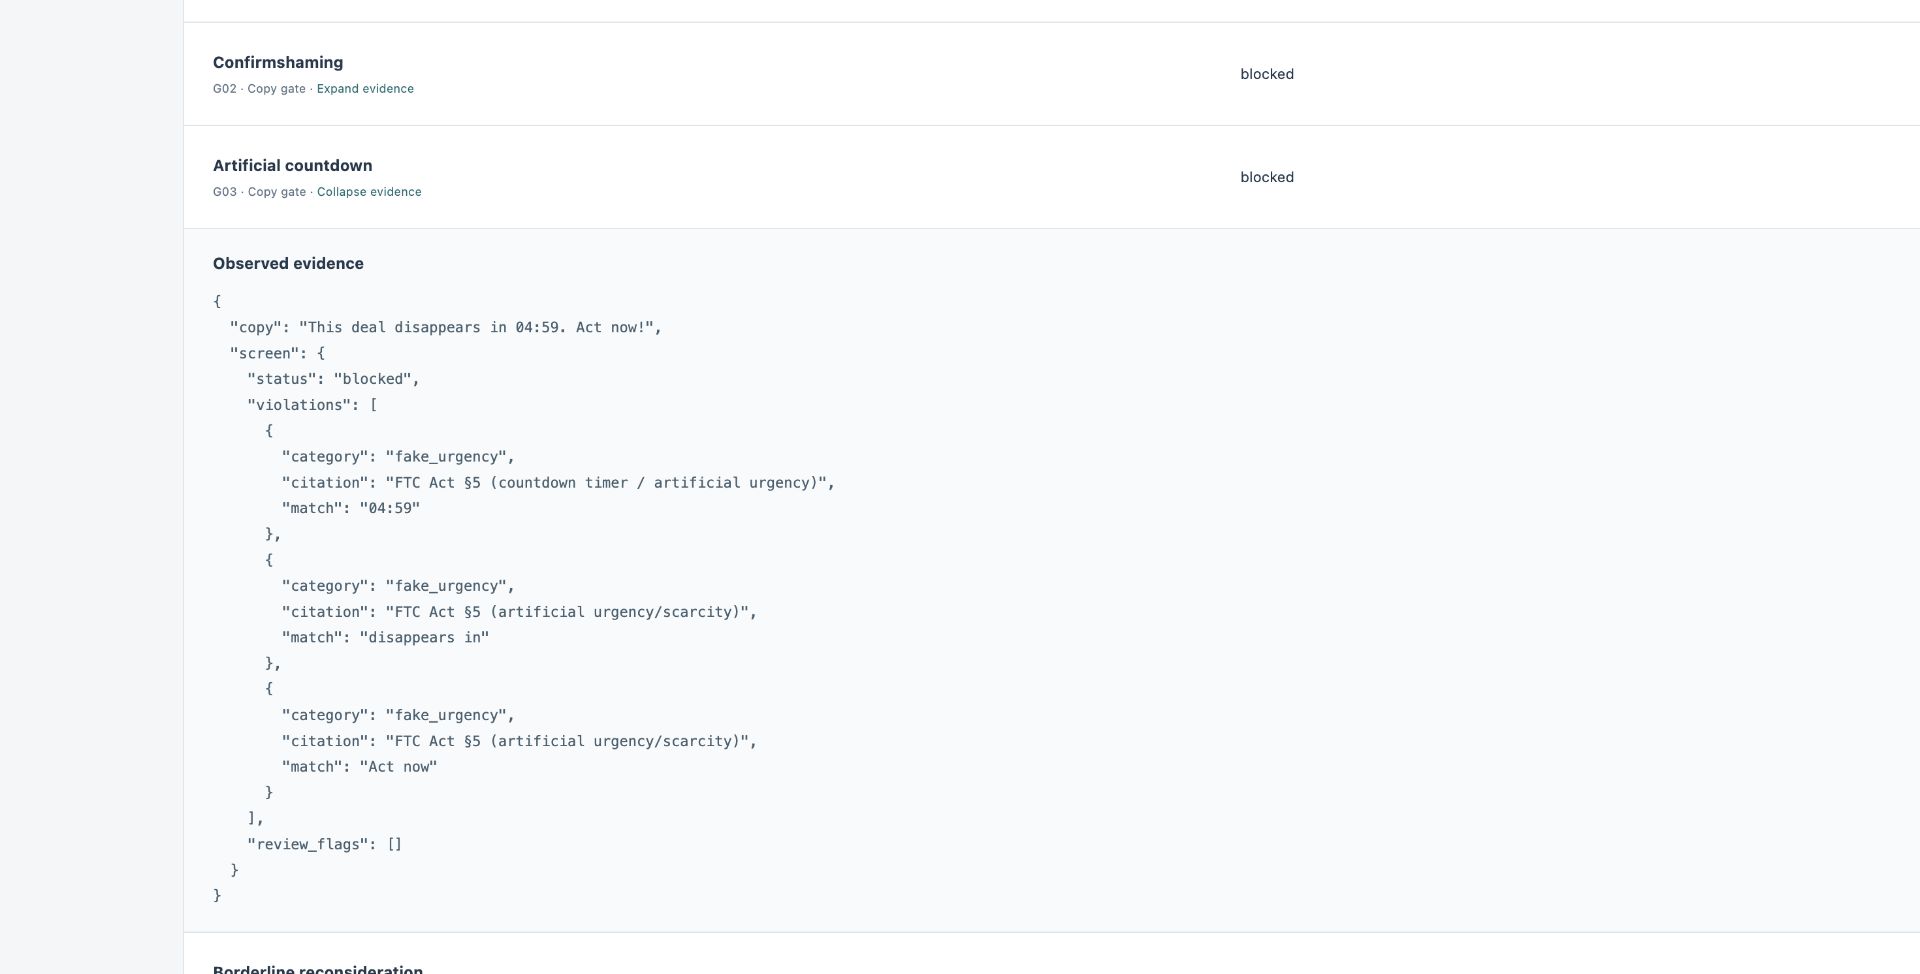
Alle 16 gespeicherten Modell-Cache-Antworten wurden bei der Überprüfung des Briefings als freigegeben eingestuft, einschließlich Entwürfen mit aggressivem Ziel. Die Wahl eines gegnerischen Ziels führt daher nicht zwingend zu einem blockierten Ergebnis. Der tatsächlich zurückgegebene Text bestimmt das Urteil. Zitationsbezeichnungen im Kontrollpfad sind illustrative konfigurierte Verweise, keine rechtliche Auslegung oder Zertifizierung.
Ein Prüf-Stopp hält unsicheren Text vom Abonnenten fern
Der nächste verfasste Fall lautet: "Before you decide, take a quick tour." Er entspricht den konfigurierten Bedenkzeit-Flags und gibt needs_review zurück. Dieses Ergebnis hält den Satz intern zurück. Es gibt die Nachricht weder frei noch belegt es, dass eine Person den Fall geprüft oder den Stopp aufgehoben hat.
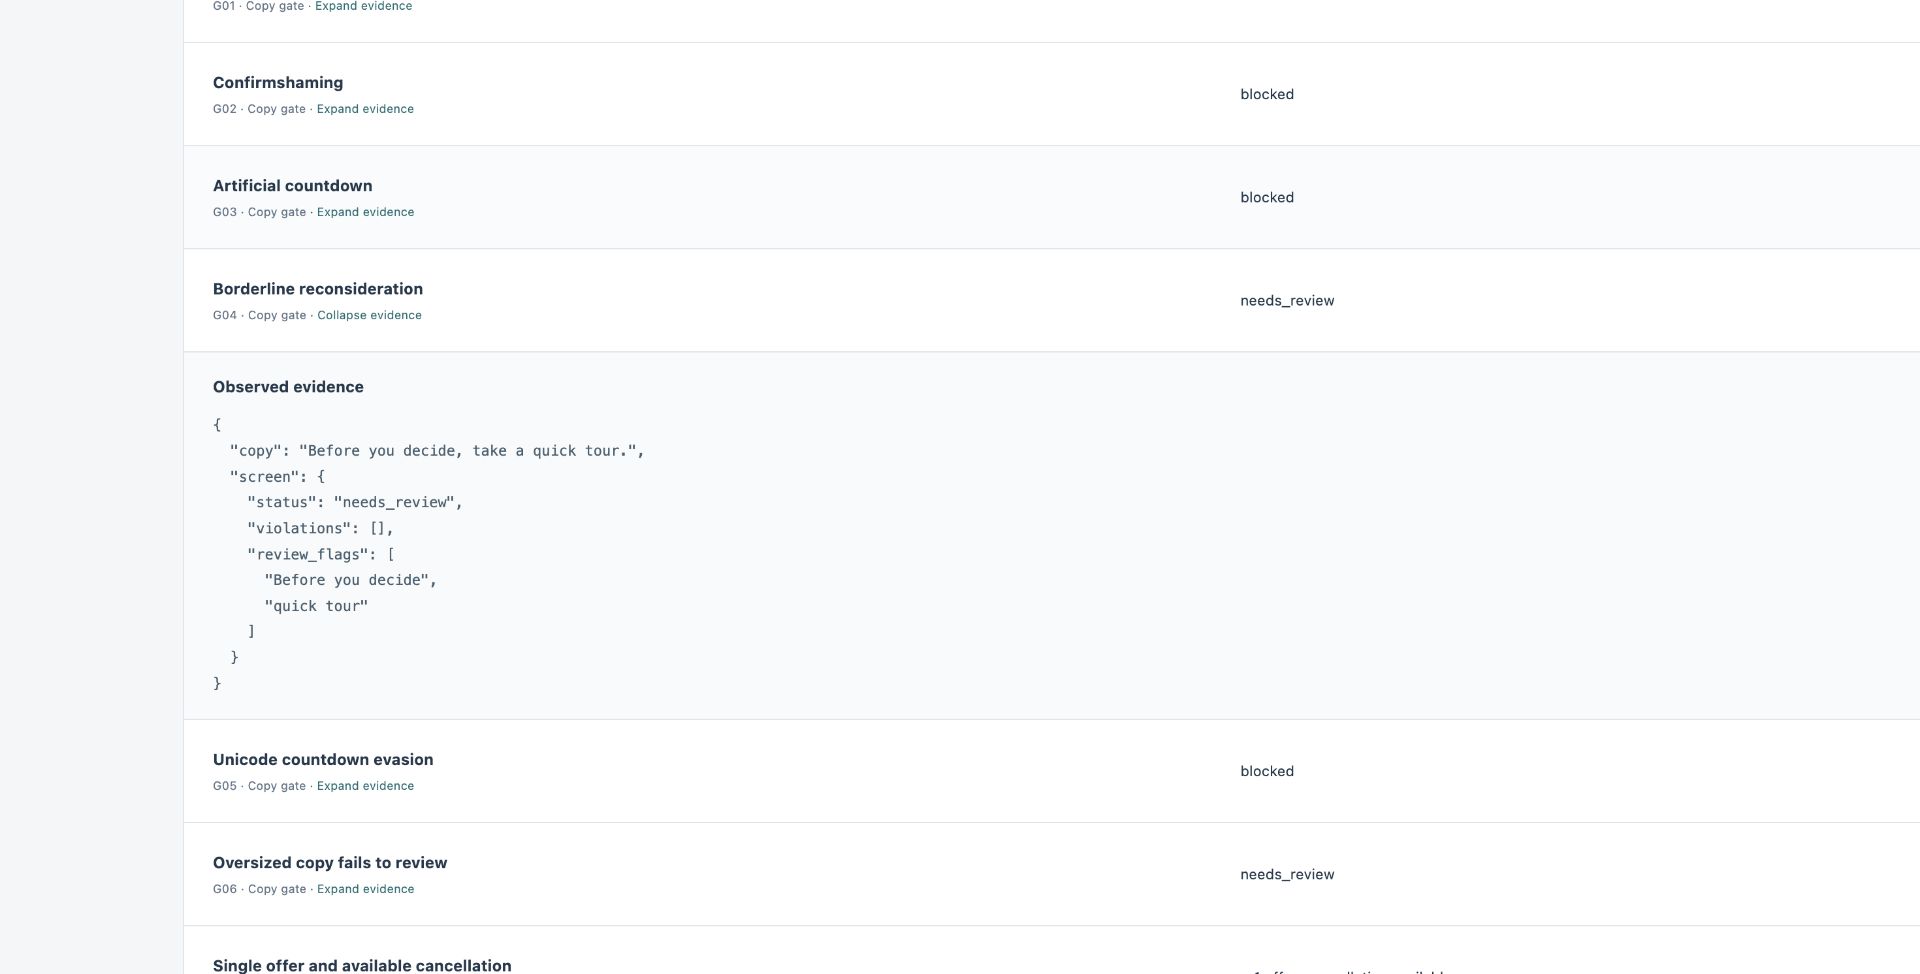
Der feste lokale Benchmark meldet 14 von 14 bestandene explizite Prüfungen: sechs Erwartungen an Ökonomie, Modell und Datenzulänglichkeit sowie acht Erwartungen an Text und Routing. Zu den Textkontrollen gehören sauberer Text, Confirmshaming, ein künstlicher Countdown, grenzwertige Überzeugung, Umgehung des Countdowns durch Unicode und die Prüfung überlanger Texte. Routing-Kontrollen prüfen das Verhalten mit Einzelangebot/Kündigung und einen sauberen Ausstieg bei unbekannten Segmenten. Dies ist Implementierungsevidenz auf einer festen Referenz-Suite, keine allgemeine Erkennungsgenauigkeit, unabhängige Modellvalidierung oder rechtliche Zertifizierung.
Unzureichende Daten verändern die Entscheidung, nicht nur den Warnhinweis
Das synthetische Pinegrove verzeichnet 180 monatliche Kündigungsabsichten und 520 Vergangenheitsbeobachtungen, aufgeteilt in 242 Behandlungs- und 278 Kontrollfälle. Die konfigurierten Mindestwerte liegen bei 500 aktuellen Kündigungsabsichten und 400 Beobachtungen in jedem Holdout-Arm. Beide Prüfungen schlagen fehl, sodass sich das kausale Routing enthält.
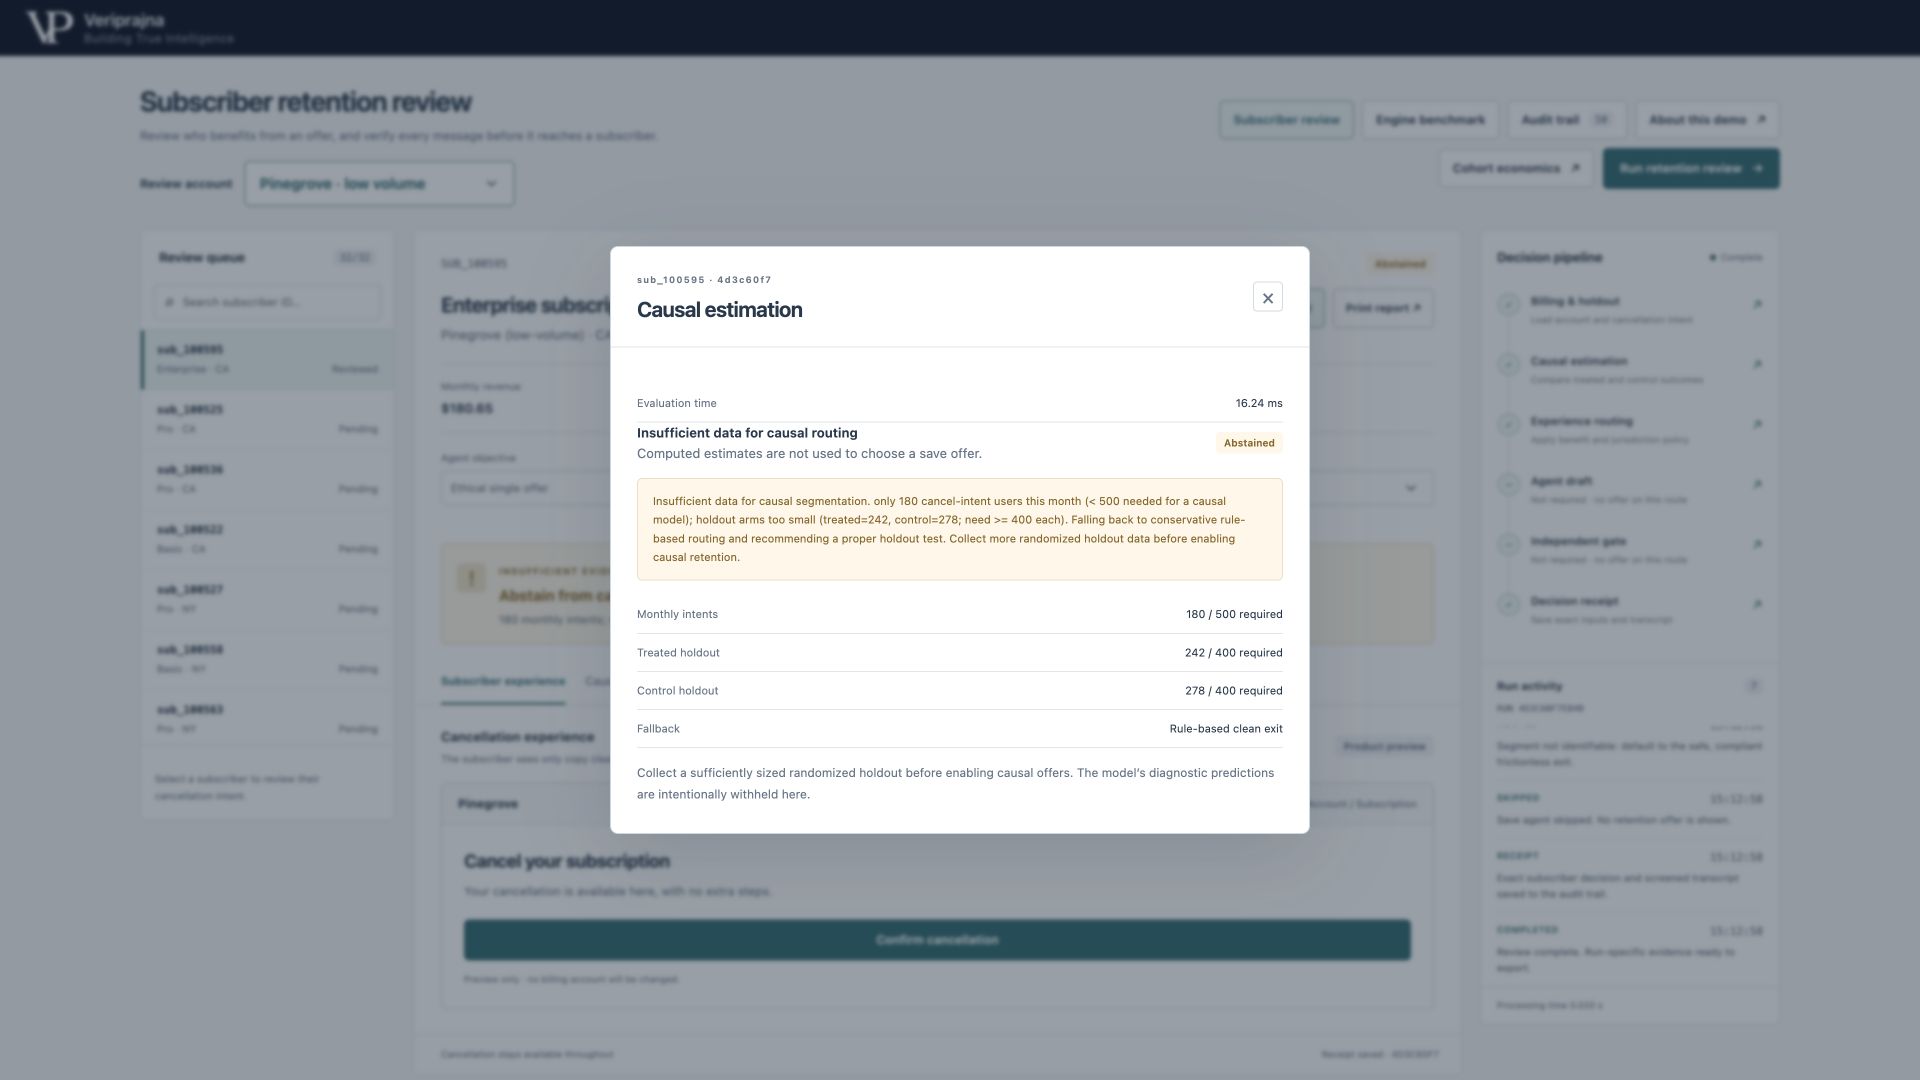
Die Benutzeroberfläche hält kausale Vorhersagen aus der Entscheidungsevidenz zurück, überspringt den Save-Agenten und verwendet einen konservativen sauberen Ausstieg. Interne Schätzungen können weiterhin berechnet werden; sie werden auf diesem Enthaltungspfad nicht zur Auswahl eines Halteangebots herangezogen. Die Schwellenwerte sind konfigurierte Demo-Schutzmaßnahmen und keine universellen statistischen Hinlänglichkeitsregeln, und das Hinzufügen von Daten würde weiterhin die Prüfung erfordern, ob die randomisierten Vergangenheitsdaten die zu treffende Entscheidung repräsentieren.
Die ausgewählte Entscheidung von der Kohortenzusammenfassung getrennt halten
Jeder abgeschlossene Durchlauf speichert einen Beleg mit dem ausgewählten Abonnenten, den Eingaben, dem Zeitstempel, der Route und dem geprüften Transkript. Exporte im JSON- und druckbaren HTML-Format ermöglichen einem Prüfer die Inspektion genau dieser Entscheidung. Die Policy-Ökonomie auf Kontoebene wird als separater synthetischer Vergleich dargestellt, sodass ein Kohortenwert nicht impliziert, dass jeder Abonnent überprüft oder jedes Angebot versendet wurde.
Die Audit-Ansicht listet die letzten 50 gespeicherten Belege auf, und lokale Dateien überstehen Neustarts. Ein gespeicherter Beleg bewahrt die durchlaufbezogene Evidenz innerhalb dieser Einzelprozess-Demonstration; er belegt keine unabhängige Verwahrung, Manipulationssicherheit oder regulatorische Hinlänglichkeit. Eine Produktionsbewertung müsste den Datenzugriff, das Eigentum an der Evidenz, die Prüfungsbefugnis und die operative Persistenz für die vorgesehene Umgebung festlegen.