Das Fallbeispiel: Ausschluss erklären, Prüfungshoheit wahren
Verfolgen Sie einen synthetischen Beschaffungsvorgang von den unbewerteten Eingangsdaten bis zum begründeten Prüfstopp. Die Vergleichsfälle zeigen anschließend, warum eine geänderte Shortlist-Berechtigung, das Bestehen einer Kategorie-Diagnostik und die Freigabe einer Vergabe getrennte Ergebnisse sind. Alle hier gezeigten Lieferantennamen, Zertifizierungen, Historien und Vergaben gehören zur lokalen Demonstration.
Mit den Nachweisen hinter der Punktzahl beginnen
Der Arbeitsbereich zeigt anfänglich die Lieferanteneingaben, während Punktzahlen und Shortlist-Entscheidungen noch ausstehen. Die Prüfung von Bridgepoint legt Liefertreue, Qualität, Transaktionshistorie, Audit-Historie und Finanzkennzahlen vor der Bewertung offen. Diese Unterscheidung ist entscheidend: Ein Lieferantenlabel oder ein scheinbar starker Lieferprozentsatz kann die Punktzahl nicht ohne die Formel erklären, die ihn verarbeitet.
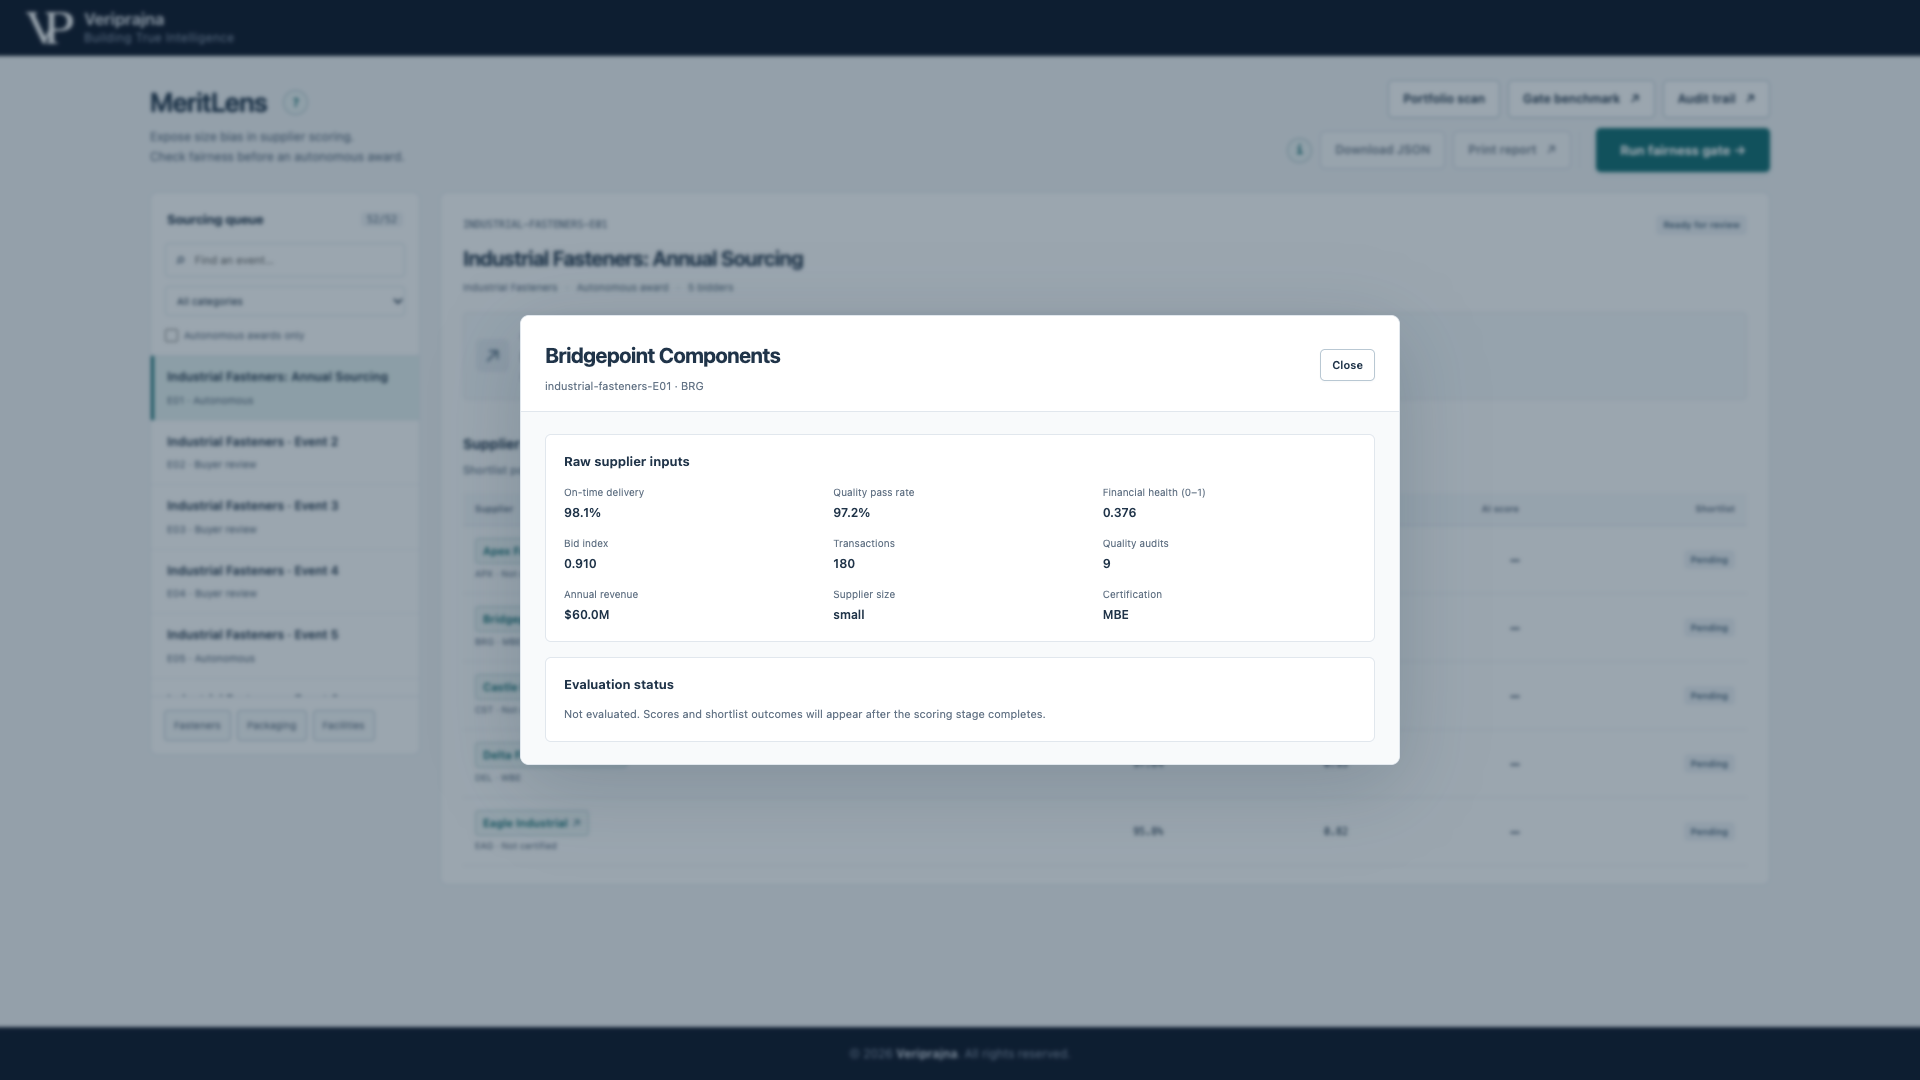
| Synthetische Eingabe | Apex | Bridgepoint |
|---|---|---|
| Pünktliche Lieferung | 97.2% | 98.1% |
| Qualitäts-Bestehensquote | 96.5% | 97.2% |
| Transaktionen | 4,200 | 180 |
| Audits | 140 | 9 |
| Umsatz | USD 820 million | USD 60 million |
Das simulierte Bewertungsmodell gewichtet Liefertreue, Qualität, finanzielle Faktoren und Preis mit jeweils 25 %. Transaktions- und Audithistorie beeinflussen, wie viel statistisches Vertrauen es in die reinen Liefer- und Qualitätsraten setzt; der Umsatz bestimmt die finanzielle Punktzahl. Diese Entscheidungen können einen kleineren Lieferanten benachteiligen, selbst wenn Zertifizierungsmerkmale von der Bewertung ausgenommen sind. Ein Einkäufer muss daher die Rechtfertigung dieser Annahmen prüfen, anstatt aus weggelassenen Merkmalen auf Neutralität zu schließen.
Ursprüngliche Shortlist und gespeicherten Prüfstopp analysieren
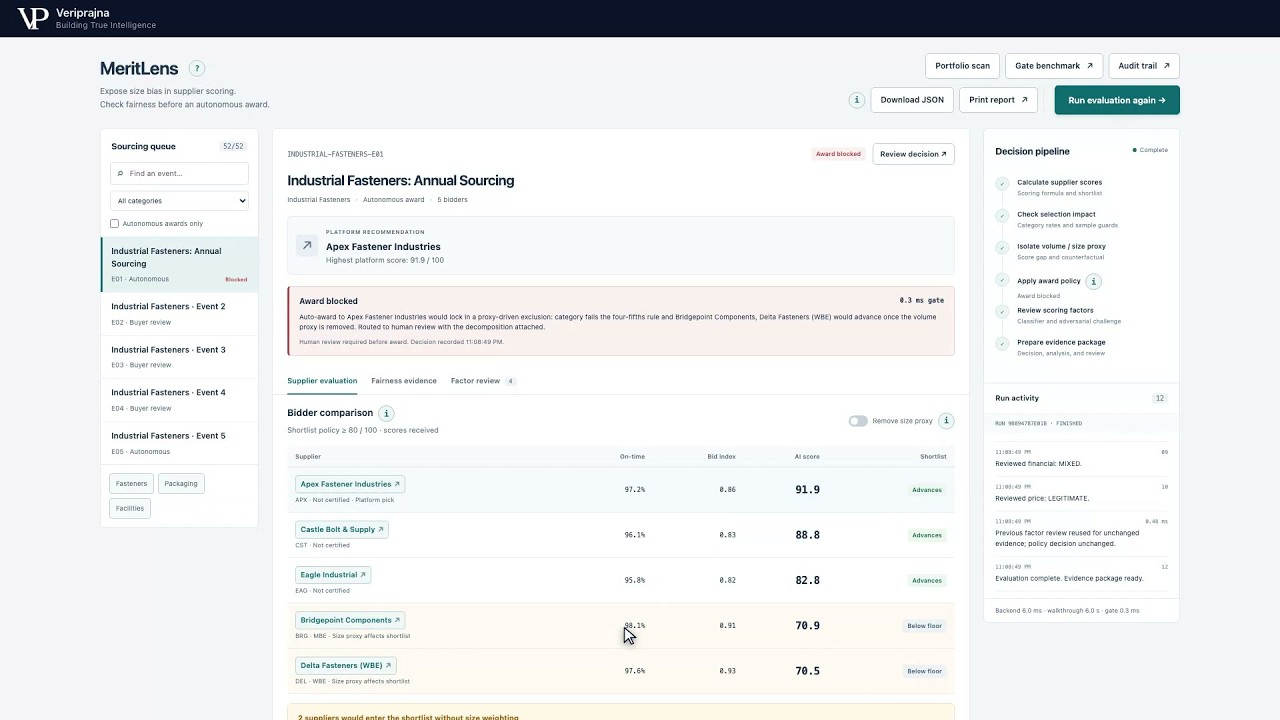
Nach der Auswertung ist Apex mit 91.9 der ursprüngliche Spitzenreiter. Bridgepoint erzielt 70.9 und Delta 70.5 Punkte, beides unter der konfigurierten Shortlist-Untergrenze von 80 Punkten. Bridgepoint weist zwar die bessere Lieferquote auf, doch dieser einzelne Kennwert belegt keine Überlegenheit hinsichtlich finanzieller Stabilität, Preis oder anderer legitimer Kriterien.
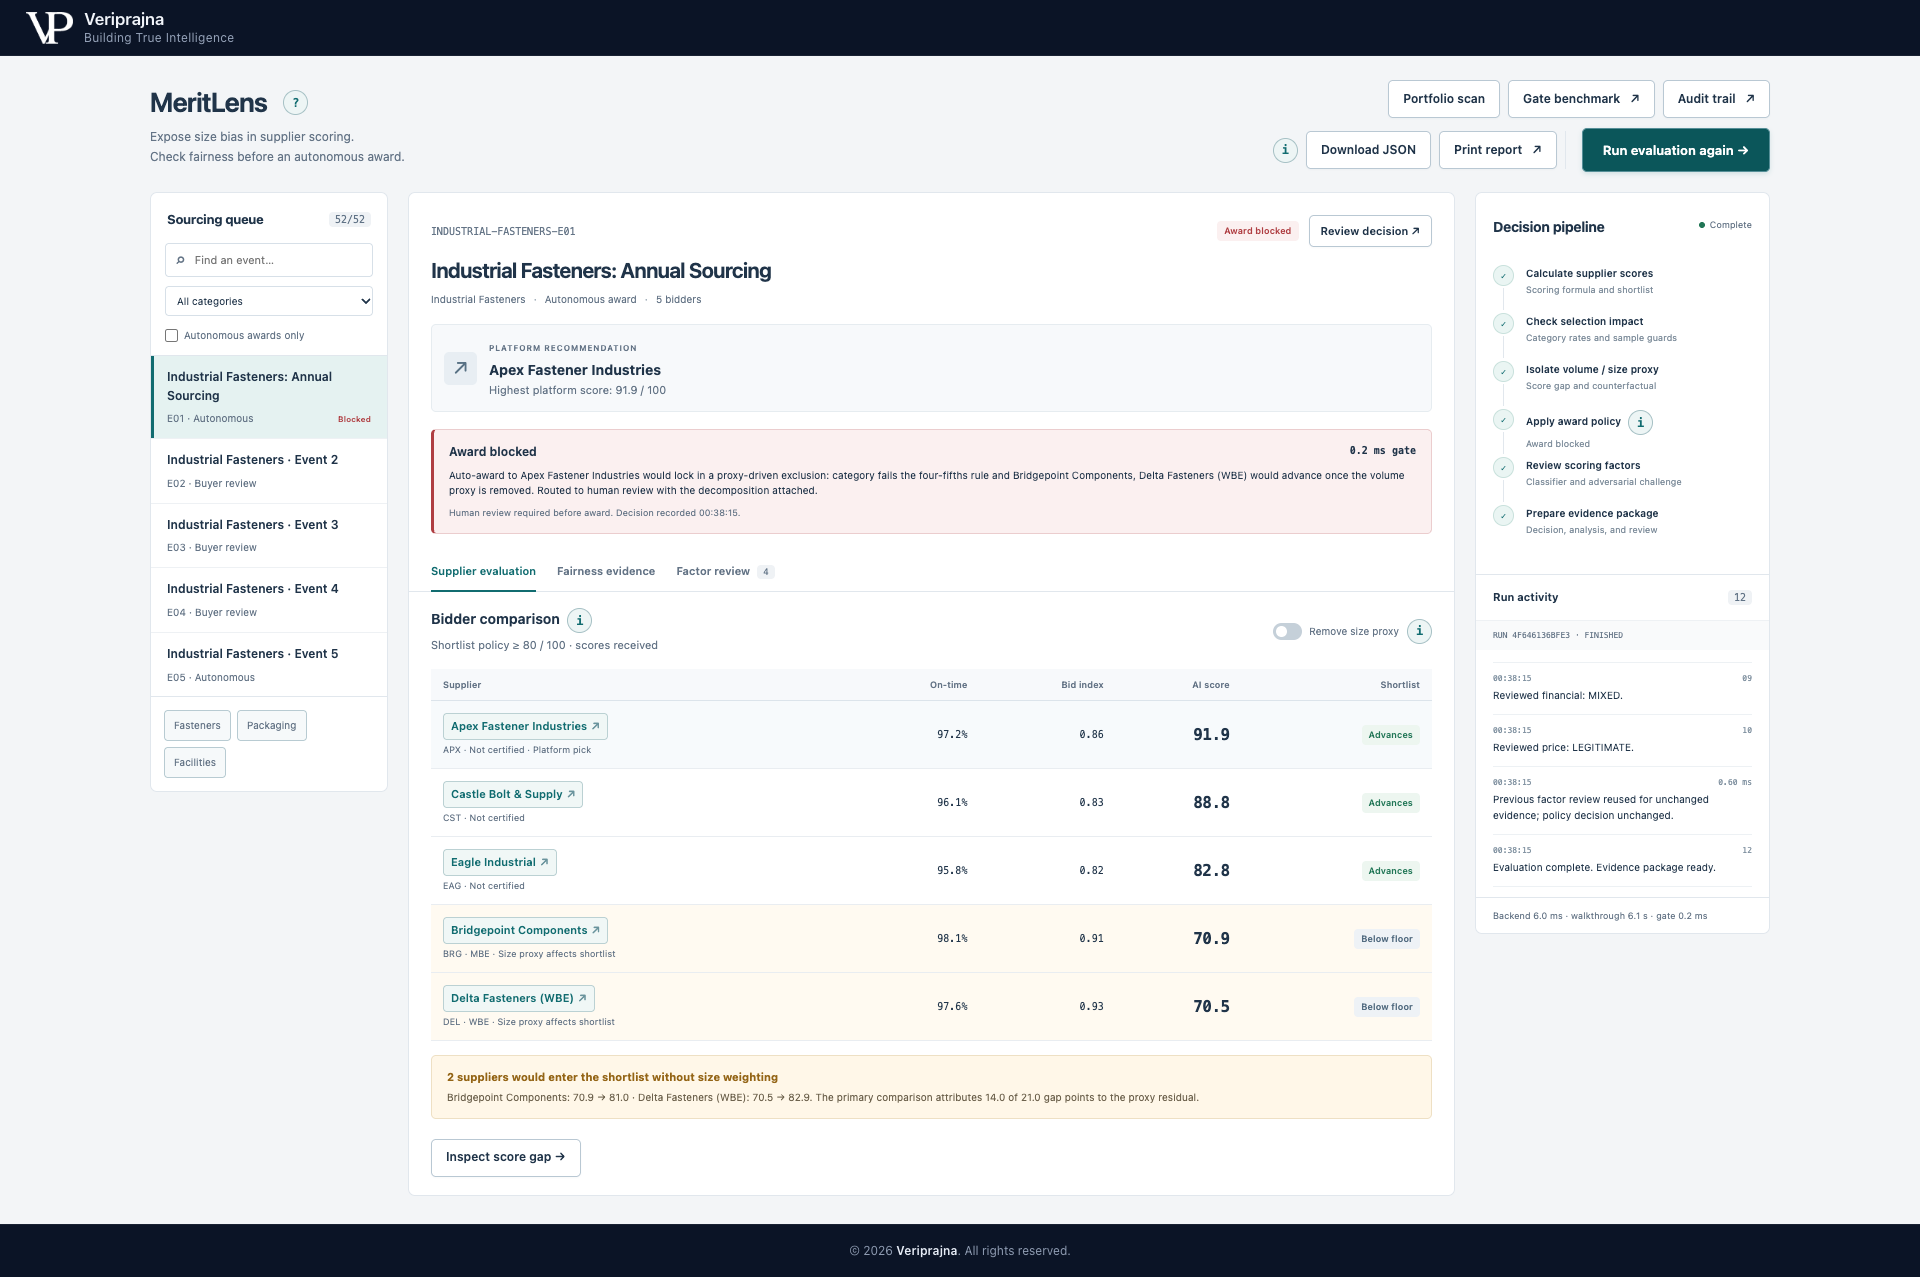
BLOCK verlangt alle drei konfigurierten Bedingungen: den Nachweis einer Benachteiligung (Adverse Impact) in der Kategorie, einen nicht-diversen ursprünglichen Spitzenreiter und einen diversen Herausforderer, der unter der ursprünglichen Untergrenze liegt, sie jedoch in der alternativen Formel erreicht. Das Verbindungselemente-Ereignis erfüllt diese Kombination. Die Entscheidung wird gespeichert, bevor die beratende Faktorenprüfung beginnt, wodurch die numerische Basis und die Gültigkeit des Stopps gewahrt bleiben.
Kategorie-Zählwerte und Ursache der Differenz untersuchen
Die Kategorie-Diagnostik bündelt Lieferanten-Ereignis-Zeilen einschließlich mehrfach auftretender Lieferanten. Zeilen für Unternehmen in Minderheitenbesitz weisen 7 Auswahlen bei 26 berücksichtigten Zeilen auf, verglichen mit 25 von 37 bei der nicht-diversen Baseline. Das Auswahlquoten-Verhältnis liegt bei etwa 0.40 und damit unter der konfigurierten Diagnose-Untergrenze von 0.80. Die Kategorie-Historie-Metadaten von 312 stellen eine separate Stichproben-Sicherheitsgrenze dar; sie bilden nicht den Nenner dieses Vergleichs.
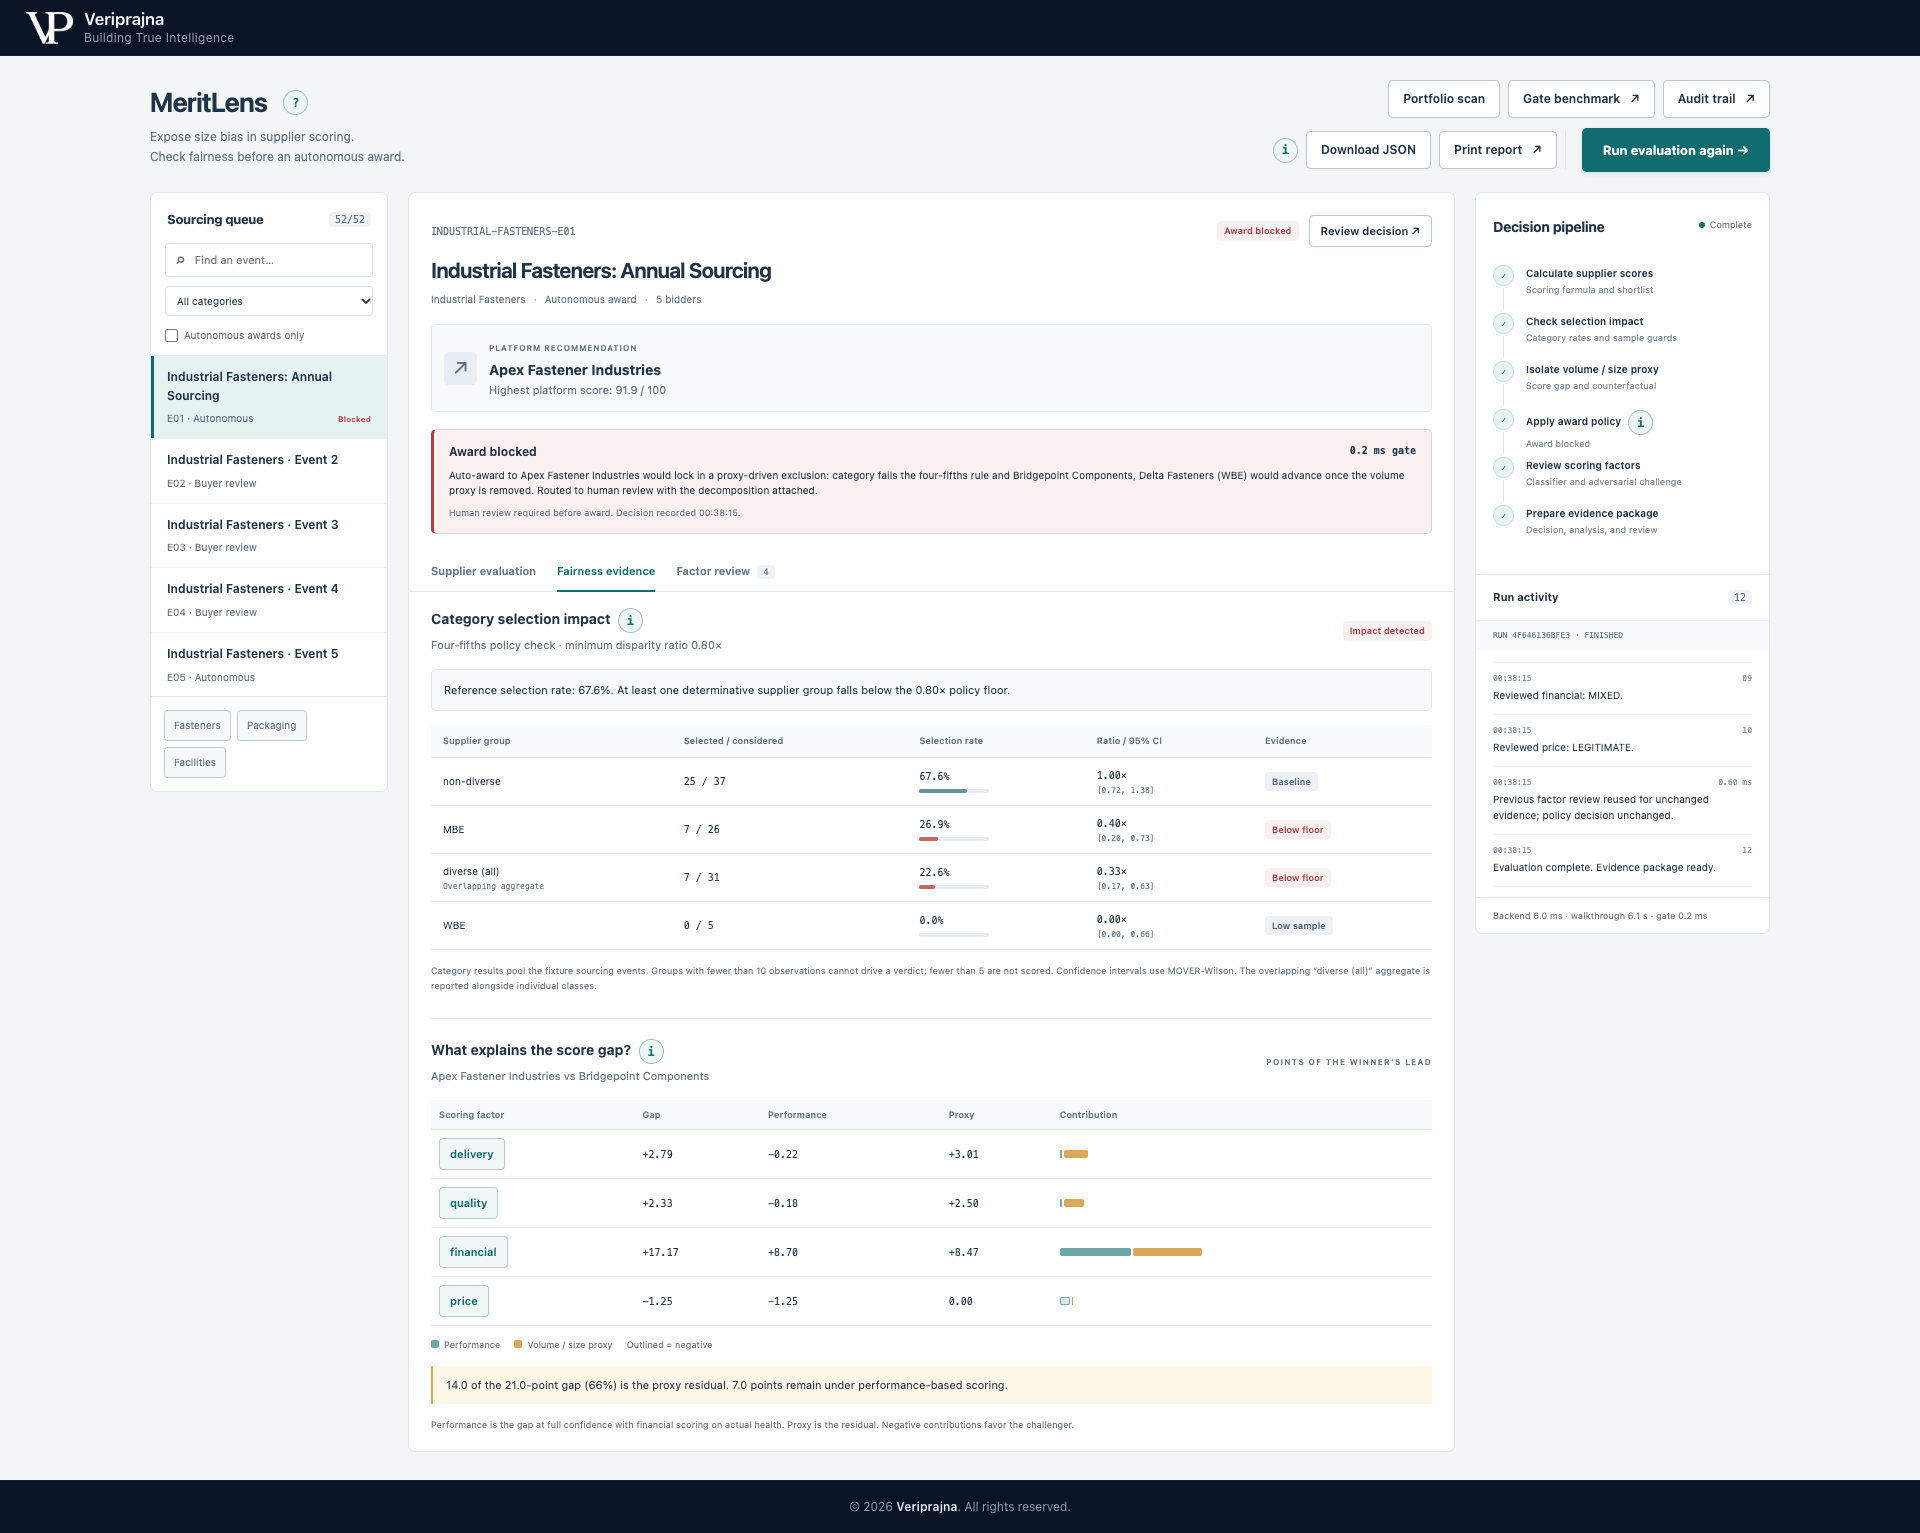
| Geänderte Annahme | Proxy-Beitrag zur Differenz |
|---|---|
| Liefervertrauen aus Transaktionshistorie | 3.01 points |
| Qualitätsvertrauen aus Audit-Historie | 2.50 points |
| Umsatzbasiertes Finanz-Scoring | 8.47 points |
| Preisbewertung, unverändert | 0.00 points |
Die Zerlegung nach Art von Oaxaca-Blinder vergleicht explizite Formeln. Die Alternative verwendet reine Liefer- und Qualitätsraten sowie die tatsächliche Finanzlage, wobei Preis und Gewichtungen unverändert bleiben. Etwa zwei Drittel der ursprünglichen Differenz werden den in diesem Vergleich modifizierten Annahmen zugeschrieben; die verbleibende Lücke begünstigt weiterhin Apex. Dieses Residuum ist abhängig von der gewählten Alternative und stellt keinen unabhängigen Kausalitätsbeweis für Diskriminierung dar.
Vorschau anpassen, ohne die Entscheidung zu überschreiben
| Lieferant | Ursprüngliche Punktzahl | Alternative Punktzahl | Vorschau-Ergebnis |
|---|---|---|---|
| Apex Fastener Industries | 91.9 | 88.0 | Bleibt Spitzenreiter |
| Bridgepoint Components | 70.9 | 81.0 | Wird berechtigt |
| Delta Fasteners | 70.5 | 82.9 | Wird berechtigt |
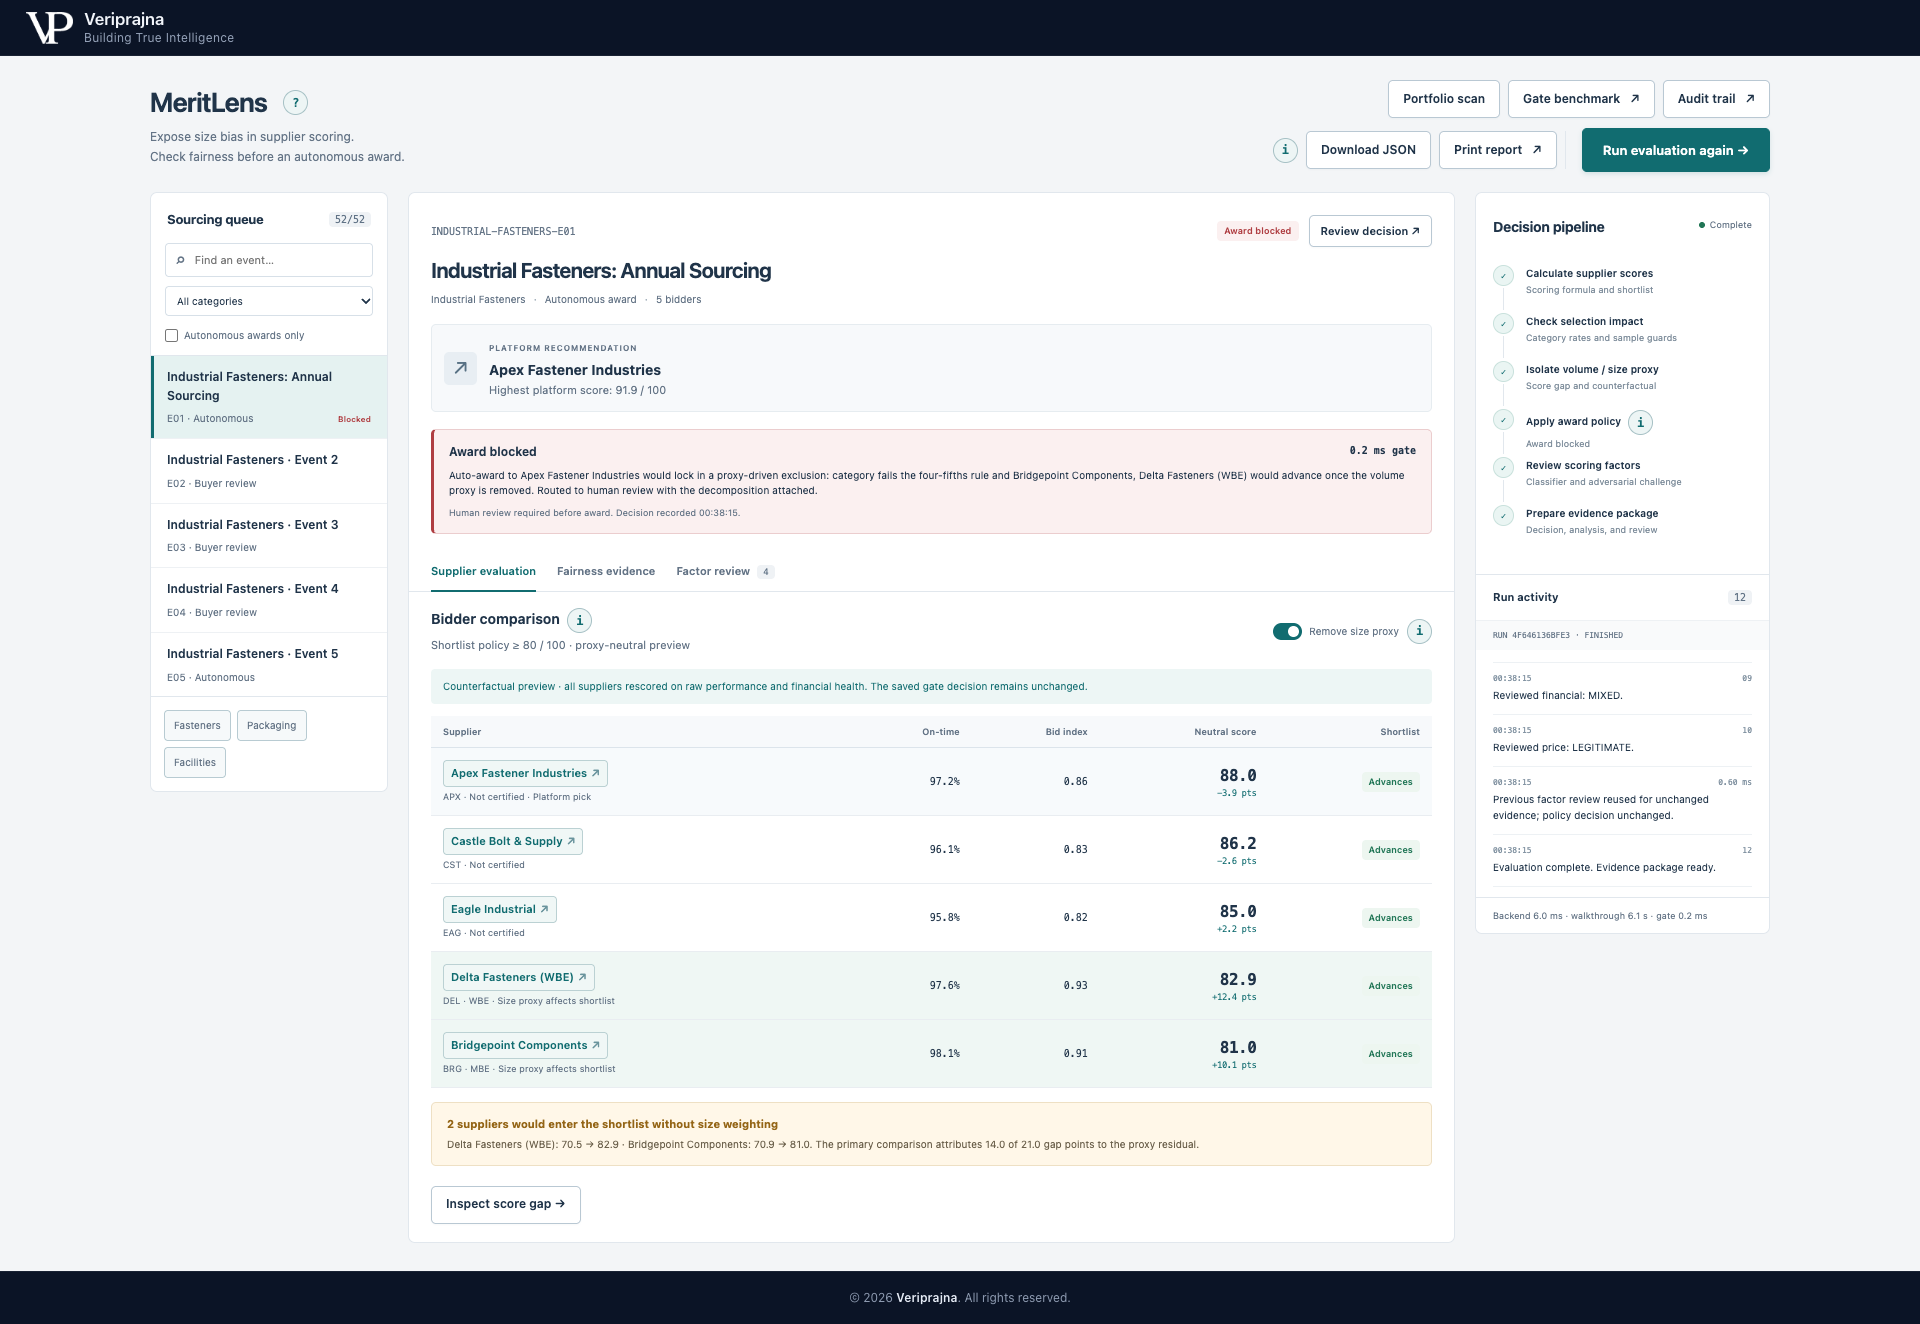
Diese Vorschau stellt Beschaffungsprüfern eine gezielte Frage: Wären diese Lieferanten unter Bewertungsannahmen ausgeschlossen worden, die die Organisation sachlich vertreten kann? Sie ernennt Bridgepoint nicht zum Gewinner, vollzieht keine Vergabe, bewertet die erfasste Kategorie-Prüfung nicht neu und ersetzt nicht das ursprüngliche Bewertungsmodell. Ein menschlicher Prüfer müsste weiterhin den Beschaffungskontext abwägen und entscheiden, wie mit den ermittelten Annahmen umzugehen ist.
Warum ALLOW nicht bedeutet, dass jede Lieferantenkategorie bestanden hat
Im Beispiel Packaging Materials lautet die ursprüngliche Empfehlung Beacon mit 91.7, die Kategorie-Diagnostik lautet PASS und das konfigurierte Gate liefert ALLOW. Dennoch verbessert sich Ironclad, ein synthetischer HUBZone-Lieferant, unter der alternativen Formel von 72.4 auf 81.4 Punkte. Eine Freigabe durch die Richtlinie kann somit koexistieren mit einem proxy-sensitiven Shortlist-Ausschluss.
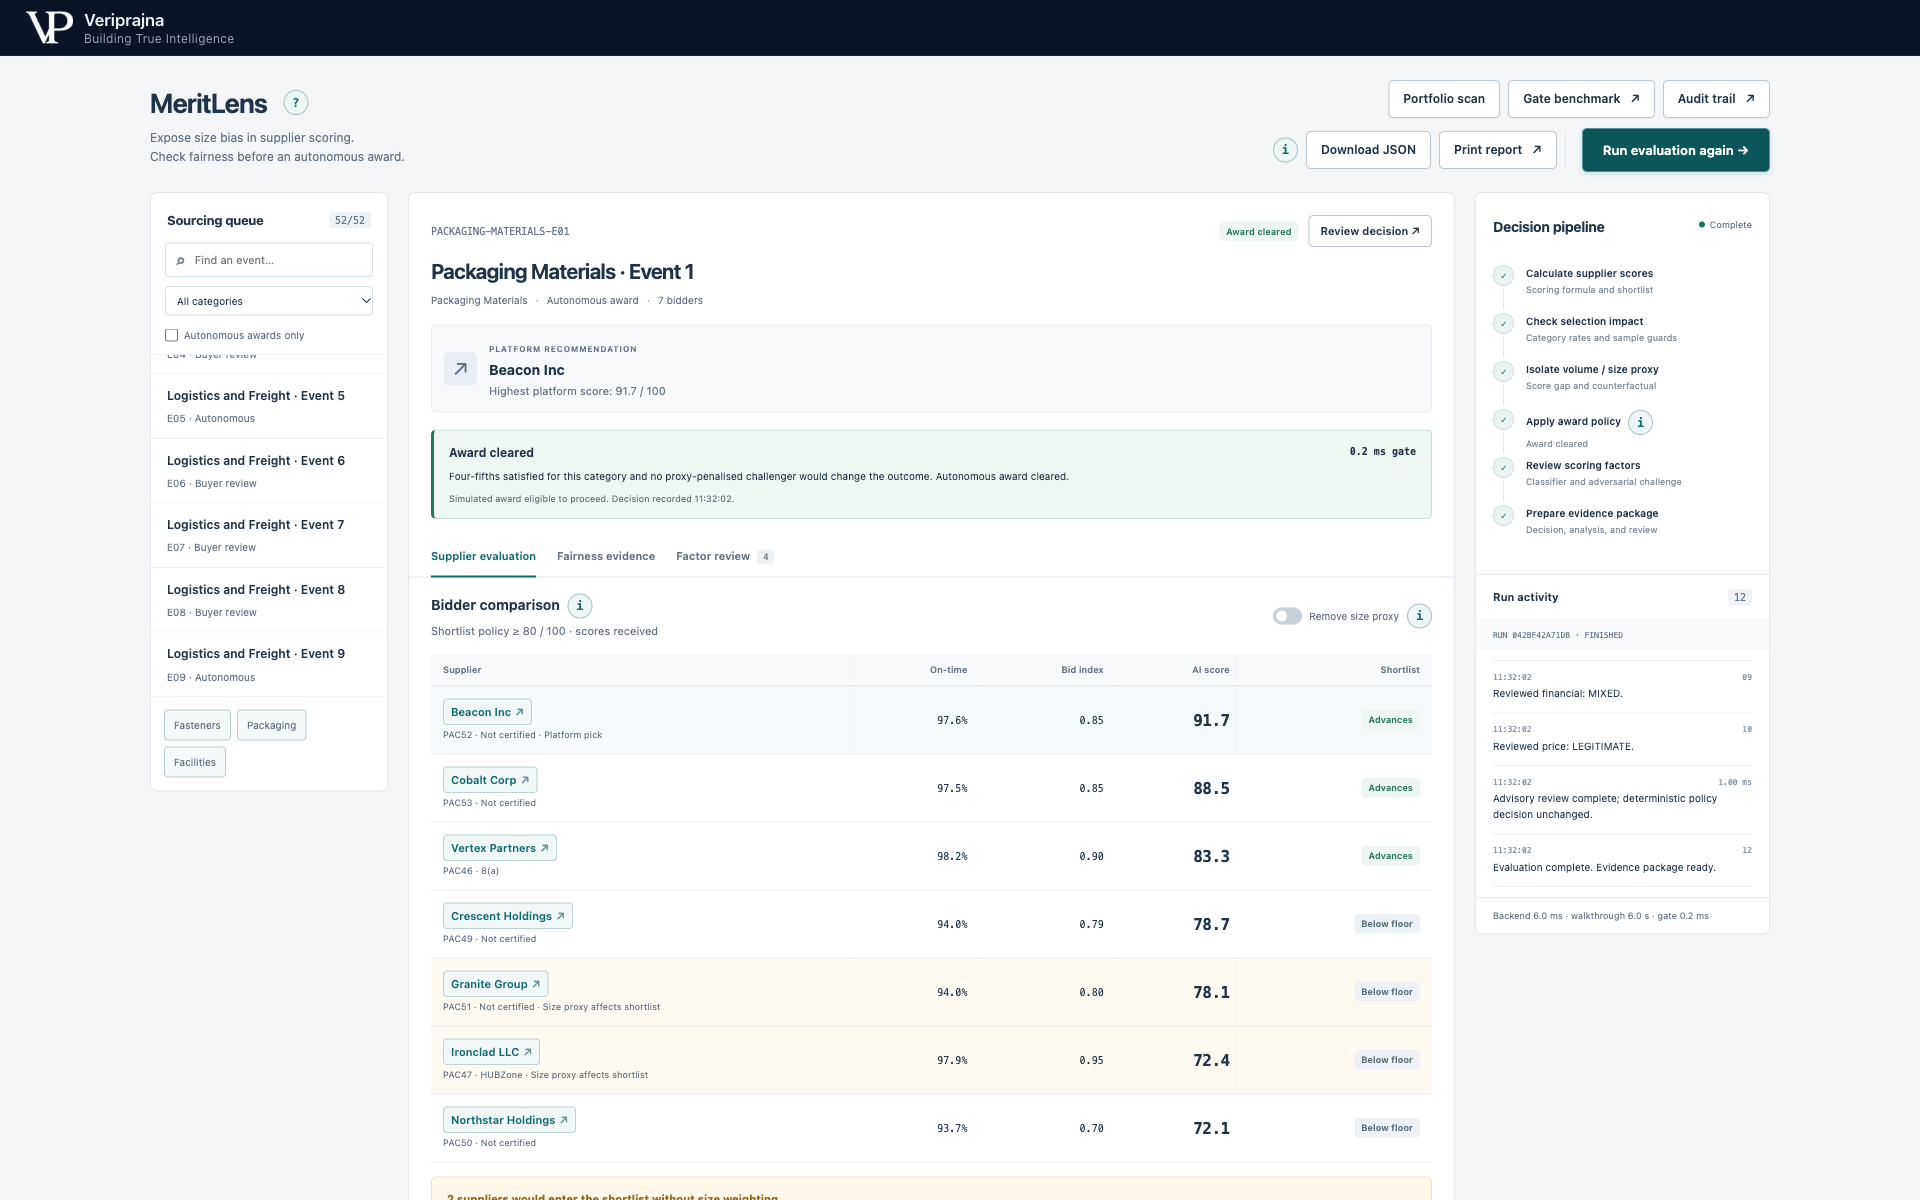
Das überlappende diverse Aggregat zählt 8 Auswahlen aus 12 berücksichtigten Zeilen, verglichen mit 18 aus 38 bei der nicht-diversen Baseline. Sein Verhältnis liegt bei etwa 1.41. Einzelne Gruppen in Minderheitenbesitz, HUBZone und 8(a) weisen jeweils nur vier berücksichtigte Zeilen auf und bleiben unbewertet. Kategorie-PASS belegt daher nicht, dass jede Gruppe geprüft wurde, und ALLOW belegt weder die Abwesenheit von Proxies noch von Ungleichheiten.
Warum unzureichende Belege die Vergabe anhalten
Das Ereignis für Facilities and MRO weist eine ausgewiesene Kategorie-Historie von 140 auf und liegt damit unter dem konfigurierten Minimum von 200. Sowohl seine Kategorie-Bewertung als auch das Gate liefern ABSTAIN, sodass die simulierte autonome Vergabe zur Überprüfung angehalten wird. Punktzahlen und eine Zerlegung können dennoch berechnet werden; keines von beiden verwandelt eine nicht verfügbare Kategorie-Prüfung in eine Freigabe.
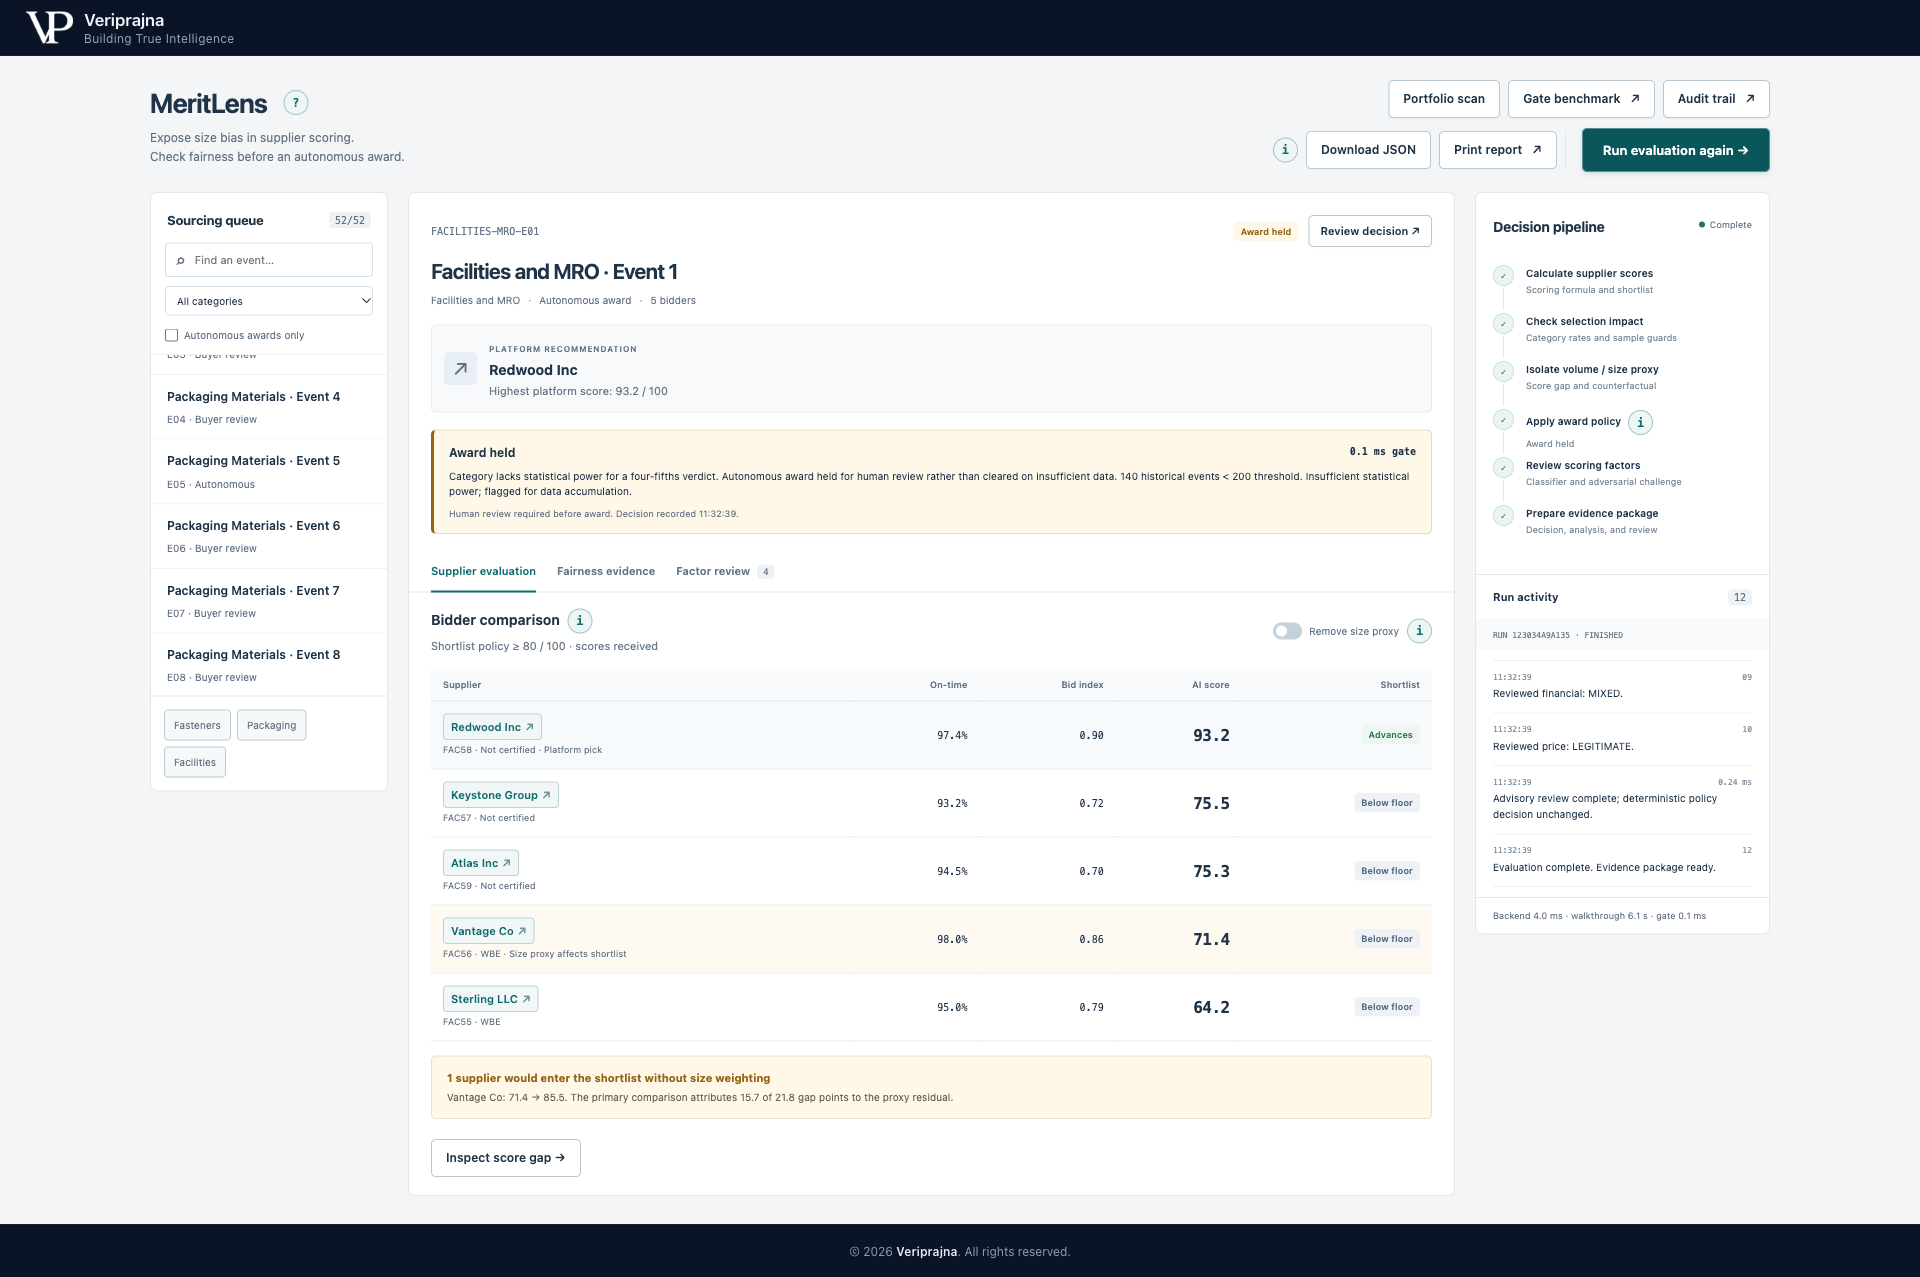
Weitere Sicherheitsgrenzen decken eine Referenz-Baseline mit weniger als fünf berücksichtigten Zeilen oder ohne Auswahlen ab. Einzelne Gruppen mit weniger als fünf Zeilen bleiben unbewertet, während Gruppen mit fünf bis neun Zeilen informatorisch sind und das Kategorie-Urteil nicht beeinflussen können. Die Mindesthistorie von 200 und diese Gruppen-Schutzmechanismen sind konfigurierte Grenzwerte, keine Garantie dafür, dass ein realer Beschaffungsdatensatz statistisch ausreichend ist.
Richtlinie anhand verifizierter Kontrollfälle prüfen
Die feste Suite umfasst zehn manuell definierte Rohdaten-Fälle mit erwarteten Ergebnissen: dreimal BLOCK, viermal ALLOW und dreimal ABSTAIN. Die beobachteten Ergebnisse stimmen mit allen zehn erwarteten Labels überein. Die Kontrollen decken Annahmen zu Historie, Audits und Umsatz, etablierte zertifizierte Lieferanten, reine Preisunterschiede, leistungsbasierten Ausschluss, spärliche Referenzdaten und eine Referenz-Baseline ohne Auswahlen ab.
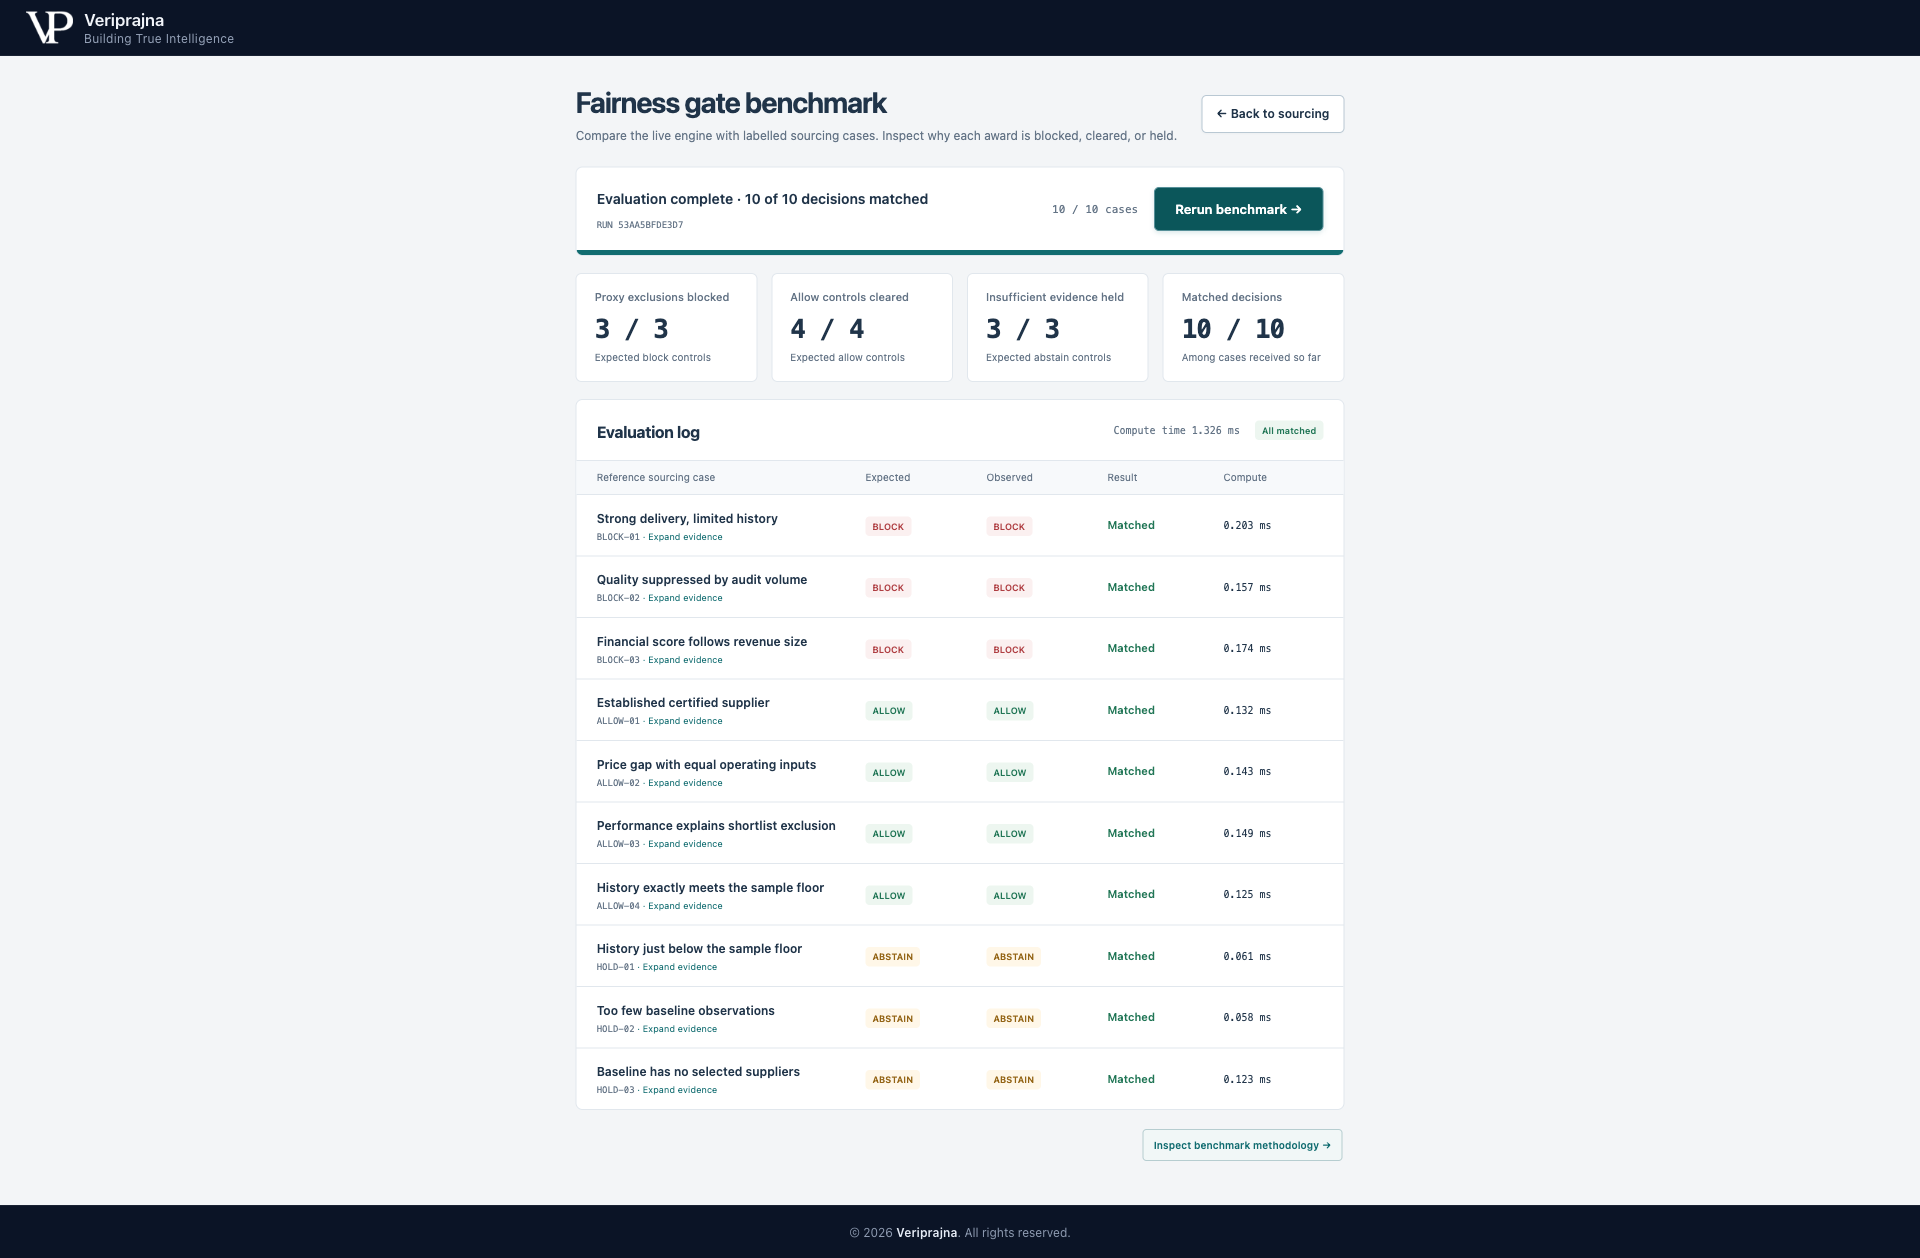
Ein Grenzfall erlaubt eine Bewertung bei einer Historie von exakt 200 und ergibt ALLOW; ein anderer bei 199 ergibt ABSTAIN. Diese Kontrollen helfen zu überprüfen, ob die Implementierung an entscheidenden Grenzwerten ihrer erklärten Richtlinie folgt. Sie begründen weder Genauigkeit in realen Beschaffungsszenarien noch Kalibrierung oder unabhängige Validierung. Der Benchmark läuft ohne Modellaufruf und fügt keine Sourcing-Audit-Einträge an.
Portfolio-Scan von durchgeführten Eingriffen trennen
Das synthetische Portfolio umfasst 52 Ereignisse über sechs Kategorien und 342 Lieferanten-Ereignis-Zeilen. Diese Zeilen sind wiederholte Teilnahme-Datensätze, keine 342 eindeutigen Lieferanten. Fünfzehn Ereignisse sind für autonome Vergaben markiert; eine Neuberechnung der Richtlinie ergibt darunter achtmal BLOCK, einmal ABSTAIN und sechsmal ALLOW. Neun der fünfzehn würden unter dieser Konfiguration somit zur Prüfung angehalten.
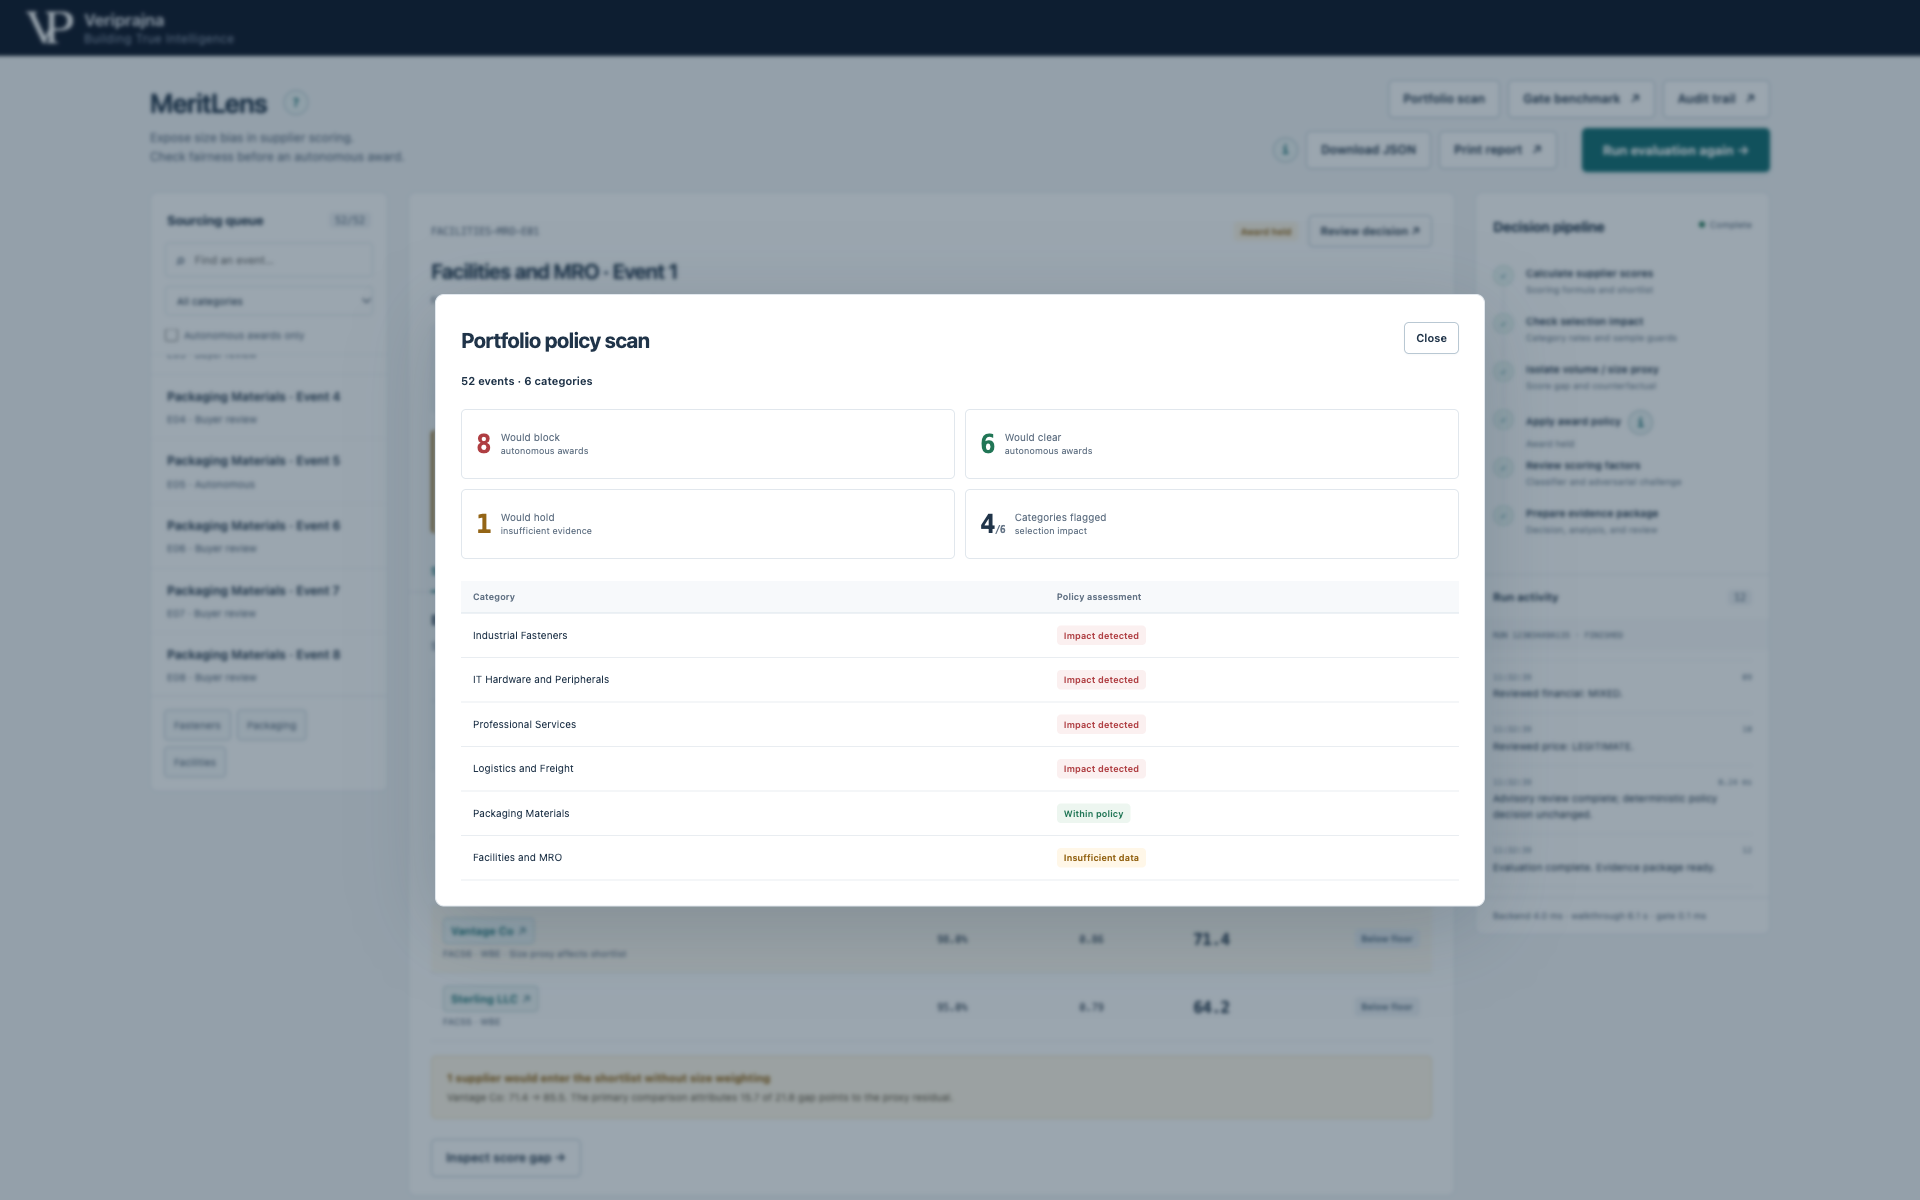
Auf Kategorieebene meldet der Scan vier ADVERSE_IMPACT-Befunde, einmal PASS und einmal ABSTAIN. Der Scan hilft dabei zu identifizieren, wo ein Prüfer als Nächstes die Belege untersuchen sollte. Er ist von der Kontrollsuite aus zehn Fällen getrennt: Der eine fasst ein initialisiertes Portfolio zusammen, während der andere das erwartete Implementierungsverhalten prüft. Keiner von beiden liefert Erkenntnisse über reale Lieferantenpopulationen.
Entscheidung und Nachweise an den Prüfer übergeben
Nach Abschluss der Bewertung und der beratenden Faktorenprüfung enthalten „JSON herunterladen“ und „Bericht drucken“ die gespeicherte Entscheidung, den Audit-Eintrag, die Kategorie-Zählwerte, die Zerlegung und die Faktorenprüfung. Optionale Empfehlungen von Proxy Classifier und Adversarial Challenger ergänzen Labels und Begründungen, nachdem das Gate gespeichert wurde. Numerische Belege bleiben fest im Code verankert; beratender Begleittext kann die Vergabe nicht autorisieren. Vollständig gespeicherte Beratungsergebnisse können für unveränderte Eingaben wiederverwendet werden, und nicht verfügbare Anbieter fallen auf eine deterministische Prüfung zurück.
Für eine Produktivbewertung betreffen die nächsten Fragen, welche Historien-Maßstäbe für den Vertrag vertretbar sind, ob Kategorie-Vergleiche die beabsichtigte Lieferantenpopulation repräsentieren und wer befugt ist, einen Prüfstopp aufzuheben. Die Demo macht diese Fragen überprüfbar. Ihre lokale JSON-Audit-Persistenz ist keine unveränderliche Verwahrung durch Dritte, und rechtlich benannte Exportfelder sind konfigurierte Zuordnungen und keine rechtliche Zertifizierung oder unabhängige Zusicherung.