La auditoría de IA de arrendamiento marcó rojo. Mi trabajo aún no estaba terminado.

El resultado rojo que no respondió lo suficiente
No pude ignorar la $2.275 millones de dólares de acuerdo en Louis et al. v. SafeRent Solutions cuando comencé a trabajar la pregunta de ingeniería detrás de las auditorías de IA para vivienda. Un tribunal federal aprobó definitivamente el acuerdo en noviembre de 2024, sin admisión de culpabilidad. El caso hizo visible un riesgo, pero el trabajo me impulsó hacia una pregunta operativa más difícil: una vez que una auditoría de modelo muestra una disparidad, ¿qué debe hacer exactamente el equipo a continuación?
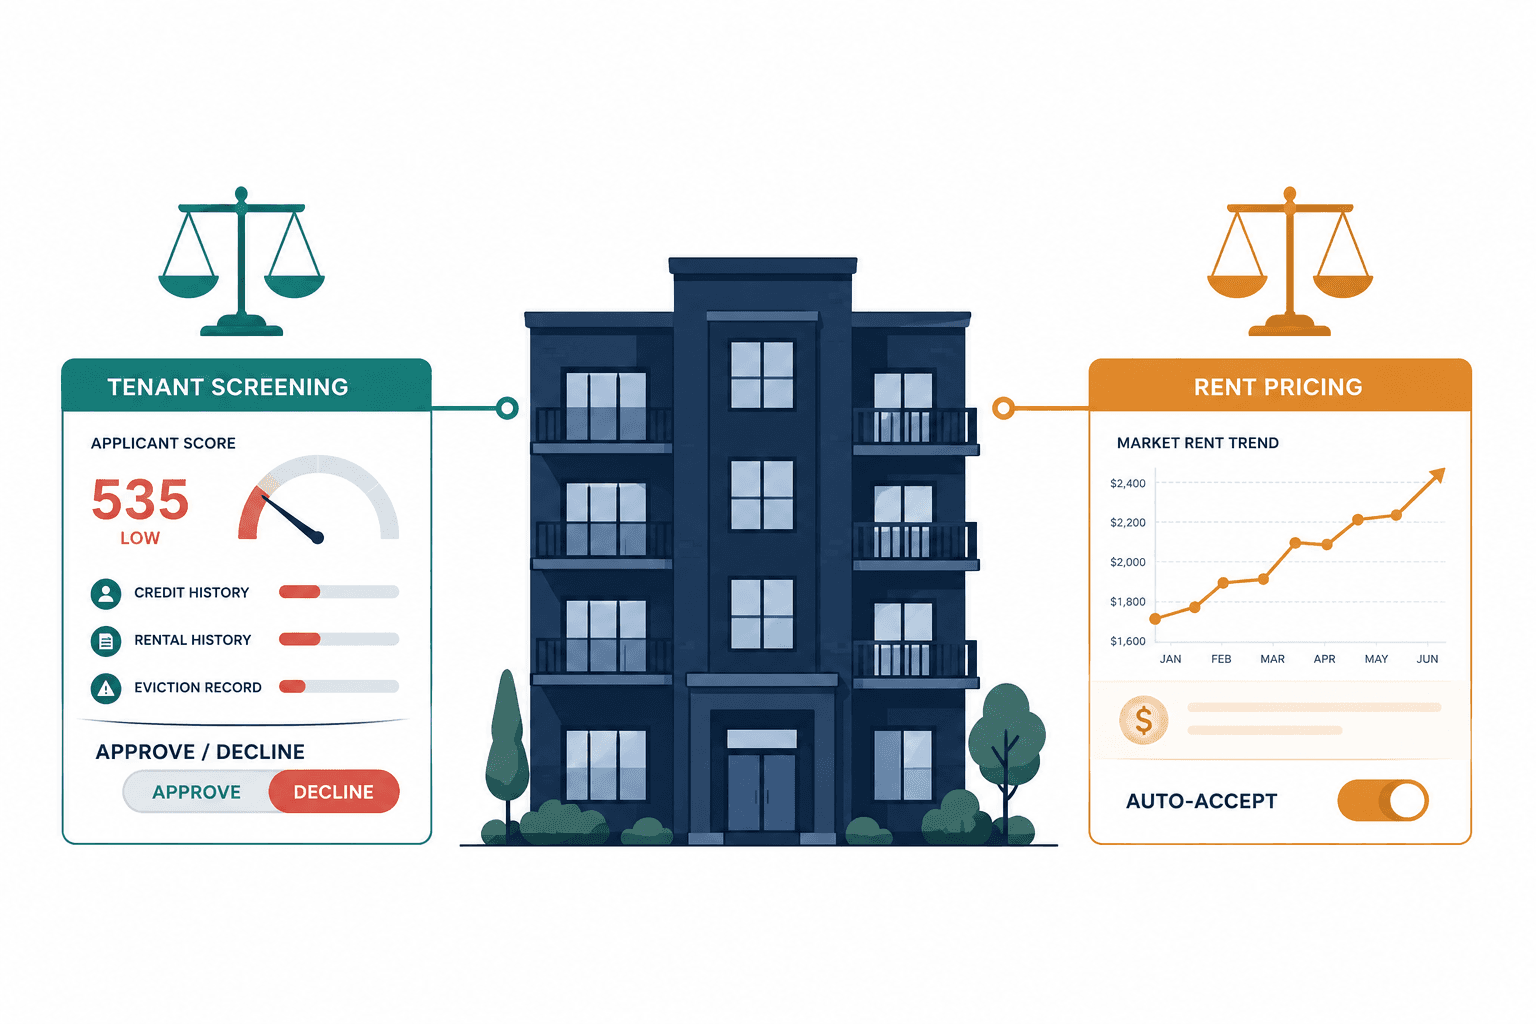
Ejecuté Equora contra un conjunto sintético fijo de solicitantes de arrendamiento de 9 000 registros. ScreenScore v3, el modelo base orientado al crédito en la demostración, produjo un AUC de 0.7823. La razón de impacto dispar mínima, o DIR, fue de 0.694 para los solicitantes afroamericanos. El umbral configurado de cuatro quintos de la demostración es 0.80. Ese umbral es una decisión de diseño para la demostración, no una conclusión legal ni una prueba automática de la Ley de Vivienda Justa.
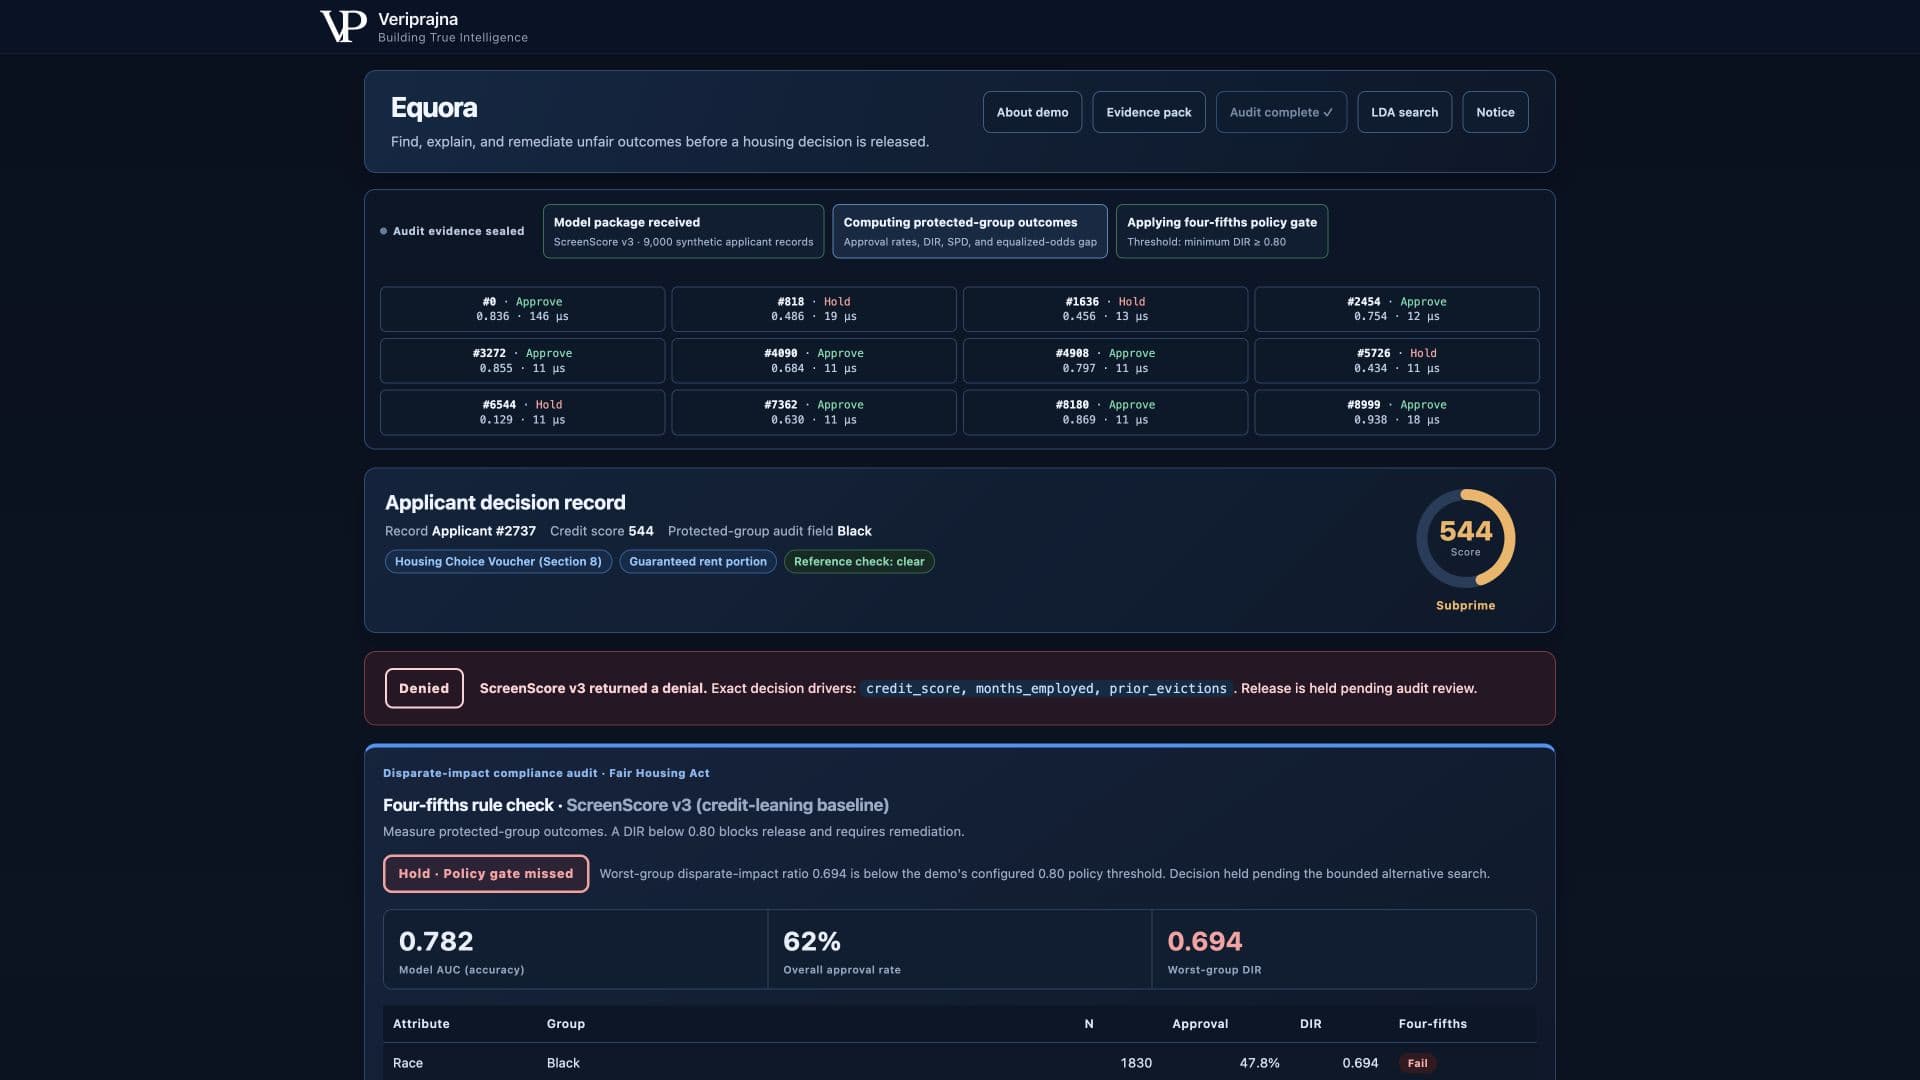
Mi primera versión podría haberse detenido ahí. Podría haber marcado el resultado en rojo, generado un informe y parecido completa en una reunión de revisión. En cambio, sentí que había construido una mejor alarma sin plan de respuesta. La métrica podía mostrarle al equipo dónde el modelo base no alcanzaba su umbral configurado. No podía mostrar si existía una alternativa con menor disparidad, qué utilidad sacrificaría esa alternativa, o cómo alguien podría reproducir la elección más adelante.
El recorrido inicial sigue siendo útil en el análisis detallado de cumplimiento de IA de vivienda de Equora, pero el trabajo solo se volvió interesante cuando la auditoría roja se convirtió en el punto de partida.
Lo que la métrica dejó sin respuesta
Seguí volviendo al mismo espacio en blanco debajo de la tabla de auditoría: qué cambio podría defender, y con qué evidencia. Hay formas fáciles de mover un número de equidad. Cambiar el umbral de aprobación. Eliminar una característica. Agregar una característica. Modificar la regularización. El número cambia, pero un movimiento sin un espacio de búsqueda definido y una regla de selección estable es difícil de gobernar.
Intenté pensar en el problema como una única edición del modelo. Eso falló rápidamente. Si limitaba la influencia del puntaje crediticio y el resultado mejoraba, aún no tenía razón para creer que ese límite era preferible a otro. Si acreditaba los ingresos garantizados por voucher, aún necesitaba ver su costo de utilidad con la misma tasa de selección. Cada cambio aislado generaba otra pregunta sobre las alternativas que no había evaluado.
Escribí esas preguntas junto al resultado y me di cuenta de que mi prototipo no tenía una respuesta estable para ninguna de ellas. Una segunda ejecución podía reflejar una corazonada diferente. Una tercera podía cambiar el conjunto de comparación sin documentar el cambio. Incluso si cada elección era sensata de forma aislada, la secuencia sería difícil de reconstruir. Ese fue el experimento fallido: había tratado la remediación como una serie de decisiones de ajuste de modelo cuando debía ser un procedimiento de búsqueda declarado. La distinción parece sutil hasta que alguien pregunta por qué se seleccionó un candidato aceptable sobre otro.
La solución fue convertir la búsqueda en sí misma en un artefacto. Equora evalúa 480 configuraciones explícitas y de apariencia neutral a igual selectividad. La cuadrícula varía subconjuntos de cuatro características opcionales de alto riesgo, límites de puntaje crediticio de sin límite, 720, 680 o 640, si los ingresos garantizados por voucher se acreditan, y seis valores L2 de 0.1 a 30.0. La razón deuda-ingreso, los meses empleados y los ingresos declarados permanecen incluidos.
Ese límite importa porque puedo describirlo. Puedo volver a ejecutarlo. También puedo decir qué no cubre. La búsqueda no pretende abarcar todos los modelos, políticas o transformaciones de características posibles. Es una demostración de ingeniería acotada con una cuadrícula conocida y un presupuesto de exactitud declarado.
Una métrica roja registra el problema. Una búsqueda gobernada registra la respuesta disponible.
Tuve que hacer la búsqueda inspeccionable
Recuerdo haber llegado a la etapa en que la búsqueda funcionaba correctamente pero aún parecía opaca. Aparecía una recomendación al final, pero el camino hacia ella estaba en gran medida oculto en el código. Ese resultado era matemáticamente defendible y operativamente débil. El asesor legal o un revisor de riesgo de modelo no deberían tener que confiar en mi memoria sobre qué combinaciones se probaron.
Trasladé el espacio de búsqueda a la interfaz y hice visible el progreso. El sistema prueba cada configuración contra el mismo conjunto sintético fijo y la misma restricción de selectividad. Registra el AUC y el DIR mínimo del candidato, y luego traza la frontera de Pareto de exactitud/equidad. Si ningún candidato supera el umbral configurado dentro del presupuesto AUC de 0.03, el motor no devuelve una alternativa segura en lugar de fabricar una recomendación.
Quería que un revisor pudiera hacer preguntas concretas. ¿Se evaluaron los límites de crédito? ¿Se acreditaron los ingresos garantizados? ¿Mantuvo cada candidato la selectividad constante? ¿Cuántos candidatos calificaron según la regla configurada? Estas preguntas tienen respuesta en el registro. El procedimiento de decisión permanece fuera del modelo de lenguaje: el código determinista calcula las métricas, aplica el umbral y selecciona al candidato calificado con la menor pérdida de AUC medida.
También tuve que resistir la tentación de eliminar los candidatos no exitosos. Una pantalla de producto naturalmente quiere destacar una respuesta, pero los otros puntos probados le dan contexto a la recomendación. La frontera permite que un revisor compare el AUC y el DIR mínimo en todas las configuraciones evaluadas en lugar de ver solo la coordenada seleccionada. Los candidatos perdedores son parte de la evidencia, porque muestran qué comparó la regla de selección antes de establecerse en el resultado calificado.
Este fue el momento en que mi propio encuadre cambió. Había comenzado con un panel de equidad en mente. Lo que realmente estaba construyendo era un proceso de decisión reproducible. El gráfico era útil porque cada punto representaba una configuración probada, no porque una frontera sea visualmente persuasiva.
El equilibrio que finalmente pude ver
Observé cómo la ejecución completada evaluaba las 480 configuraciones y devolvía 240 que superaban el umbral de 0.80 de la demostración dentro de su presupuesto de exactitud configurado. La configuración recomendada conservó las características del modelo base, agregó crédito por ingresos garantizados, limitó la influencia del puntaje crediticio a 640 y utilizó una regularización L2 de 10.0.
Luego pude leer el resultado como un equilibrio en lugar de una afirmación de perfección. En este conjunto sintético fijo, el DIR mínimo pasó de 0.694 a 0.875. El AUC pasó de 0.7823 a 0.7788, una pérdida medida de 0.0036 que la interfaz muestra como 0.36%. Para la intersección de titulares de voucher afroamericanos en el conjunto, el DIR pasó de 0.701 a 1.029.
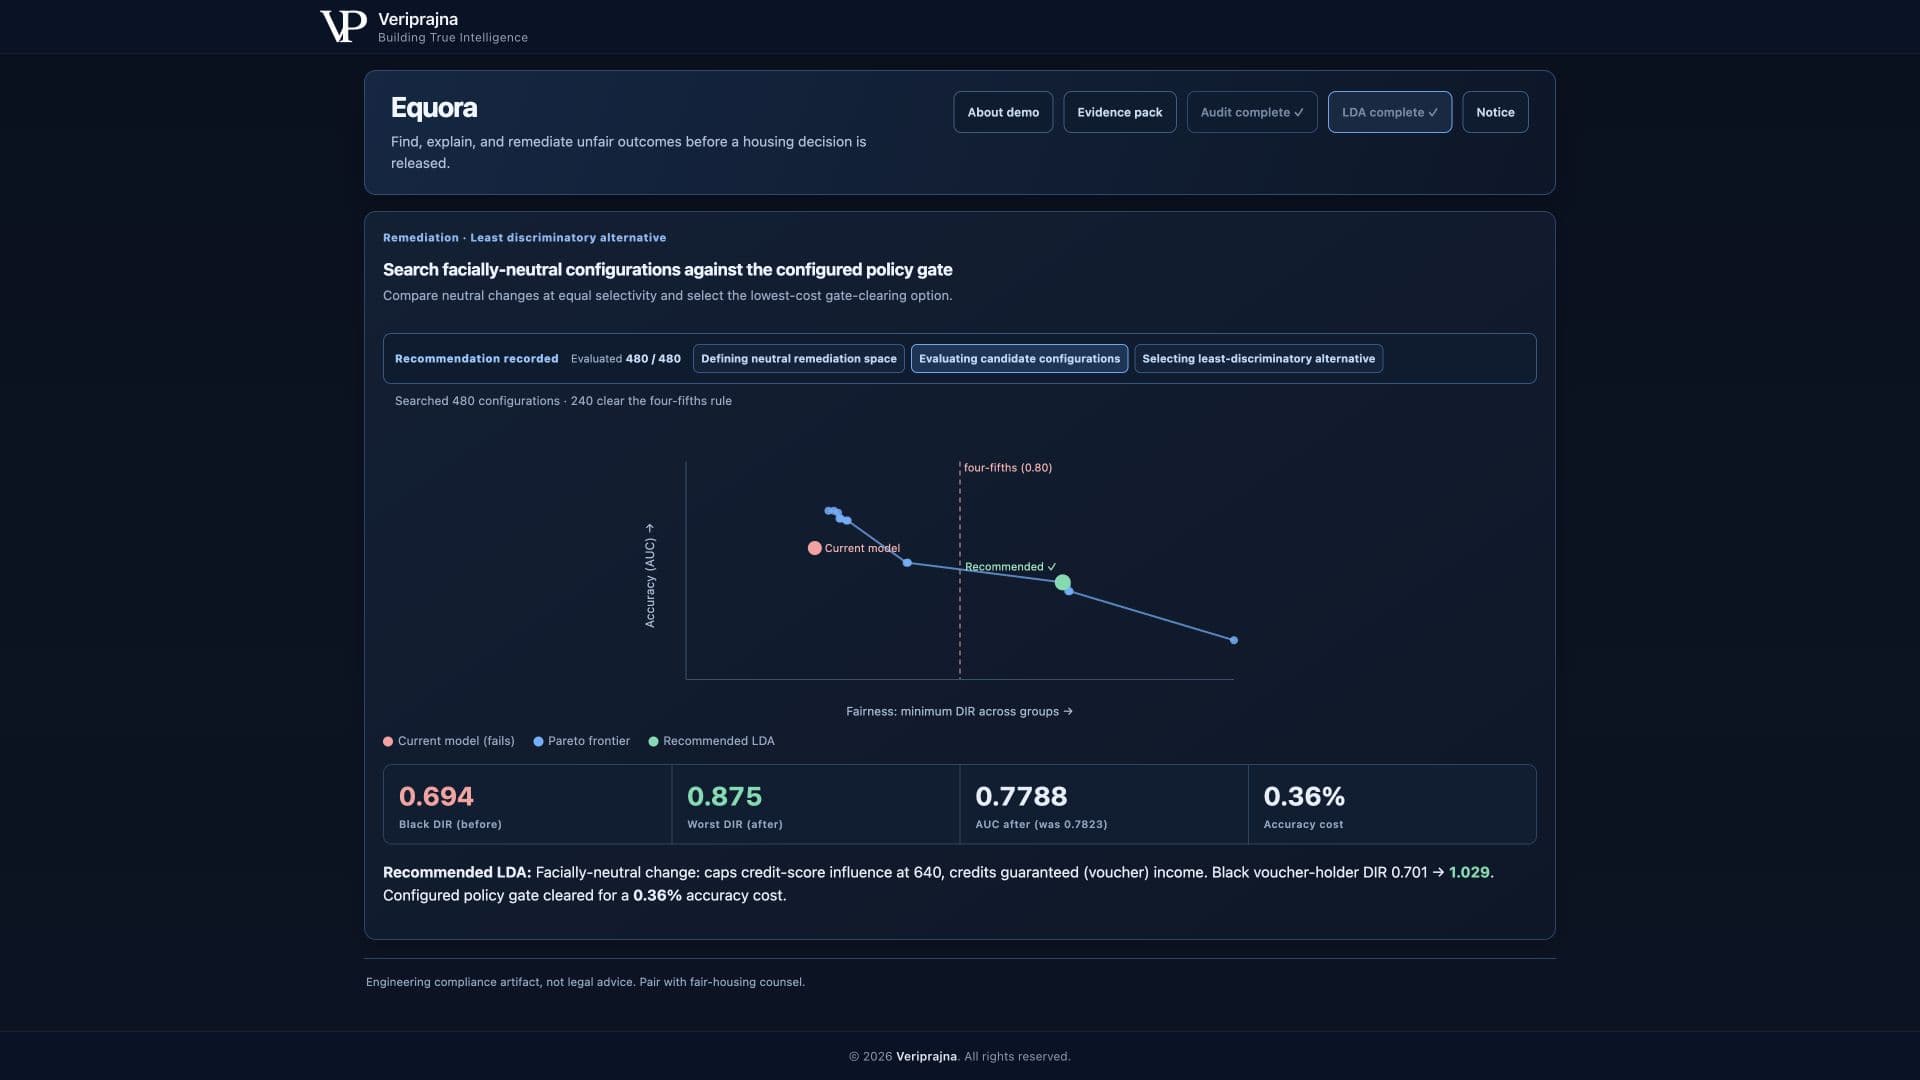
Soy cuidadoso con la palabra recomendado. Este candidato es la opción de menor costo AUC medido que califica dentro de esta cuadrícula específica. no es un óptimo universal, una certificación legal ni una prueba de un modelo libre de sesgos. Los números describen un modelo base ajustado y una búsqueda acotada sobre datos sintéticos. No describen un arrendador real, un proveedor de evaluación, un conjunto de solicitantes ni un mercado de vivienda real.
Encontré esa oración más difícil de escribir que el número de mejora. El lenguaje de producto recompensa la certeza, mientras que el trabajo de gobernanza depende de preservar el alcance. La afirmación acotada es más sólida precisamente porque otro revisor puede ver dónde se detiene. Si la organización amplía la cuadrícula, cambia el presupuesto o adopta un umbral de política diferente, debe esperar un registro diferente y quizás una recomendación diferente. El método sigue siendo reproducible incluso cuando cambian los supuestos.
Esa limitación no debilita la demostración. Hace explícito el límite de revisión. Un revisor puede cuestionar el presupuesto de 0.03, el umbral de política de cuatro quintos, las características disponibles, la restricción de selectividad o la cuadrícula misma. Esos desacuerdos se convierten en entradas para un proceso que puede volver a ejecutarse, en lugar de comentarios adjuntos a una puntuación roja estática.
Por qué mantuve la evidencia fuera del texto
Me tentó dejar que el texto generado llevara más de la explicación porque la prosa hace que una interfaz parezca terminada. Me alejé de eso. Un párrafo fluido no puede establecer qué configuraciones se probaron, calcular el DIR ni decidir si un candidato supera un umbral. Esas son afirmaciones computacionales, y quería que el registro sobreviviera incluso si se eliminara cada oración generada.
Separé los roles. El código determinista calcula la auditoría, busca las alternativas, aplica el umbral configurado y conserva el resultado. Un modelo de lenguaje, cuando está habilitado, se limita a redactar texto. El modo sin conexión usa una plantilla determinista. La evidencia no depende de la redacción.
Apliqué el mismo límite a una razón de cara al solicitante. Para un registro sintético denegado, la atribución exacta de características del modelo lineal identifica a los tres principales contribuyentes negativos. El redactor del aviso debe citar esas características. Un aviso de reserva fundamentado supera esa verificación estricta, mientras que un código de razón genérico que no nombra ninguna característica falla y se deriva a revisión humana. El crítico verifica solo la fundamentación de características. No establece cumplimiento total de la FCRA ni suficiencia legal.
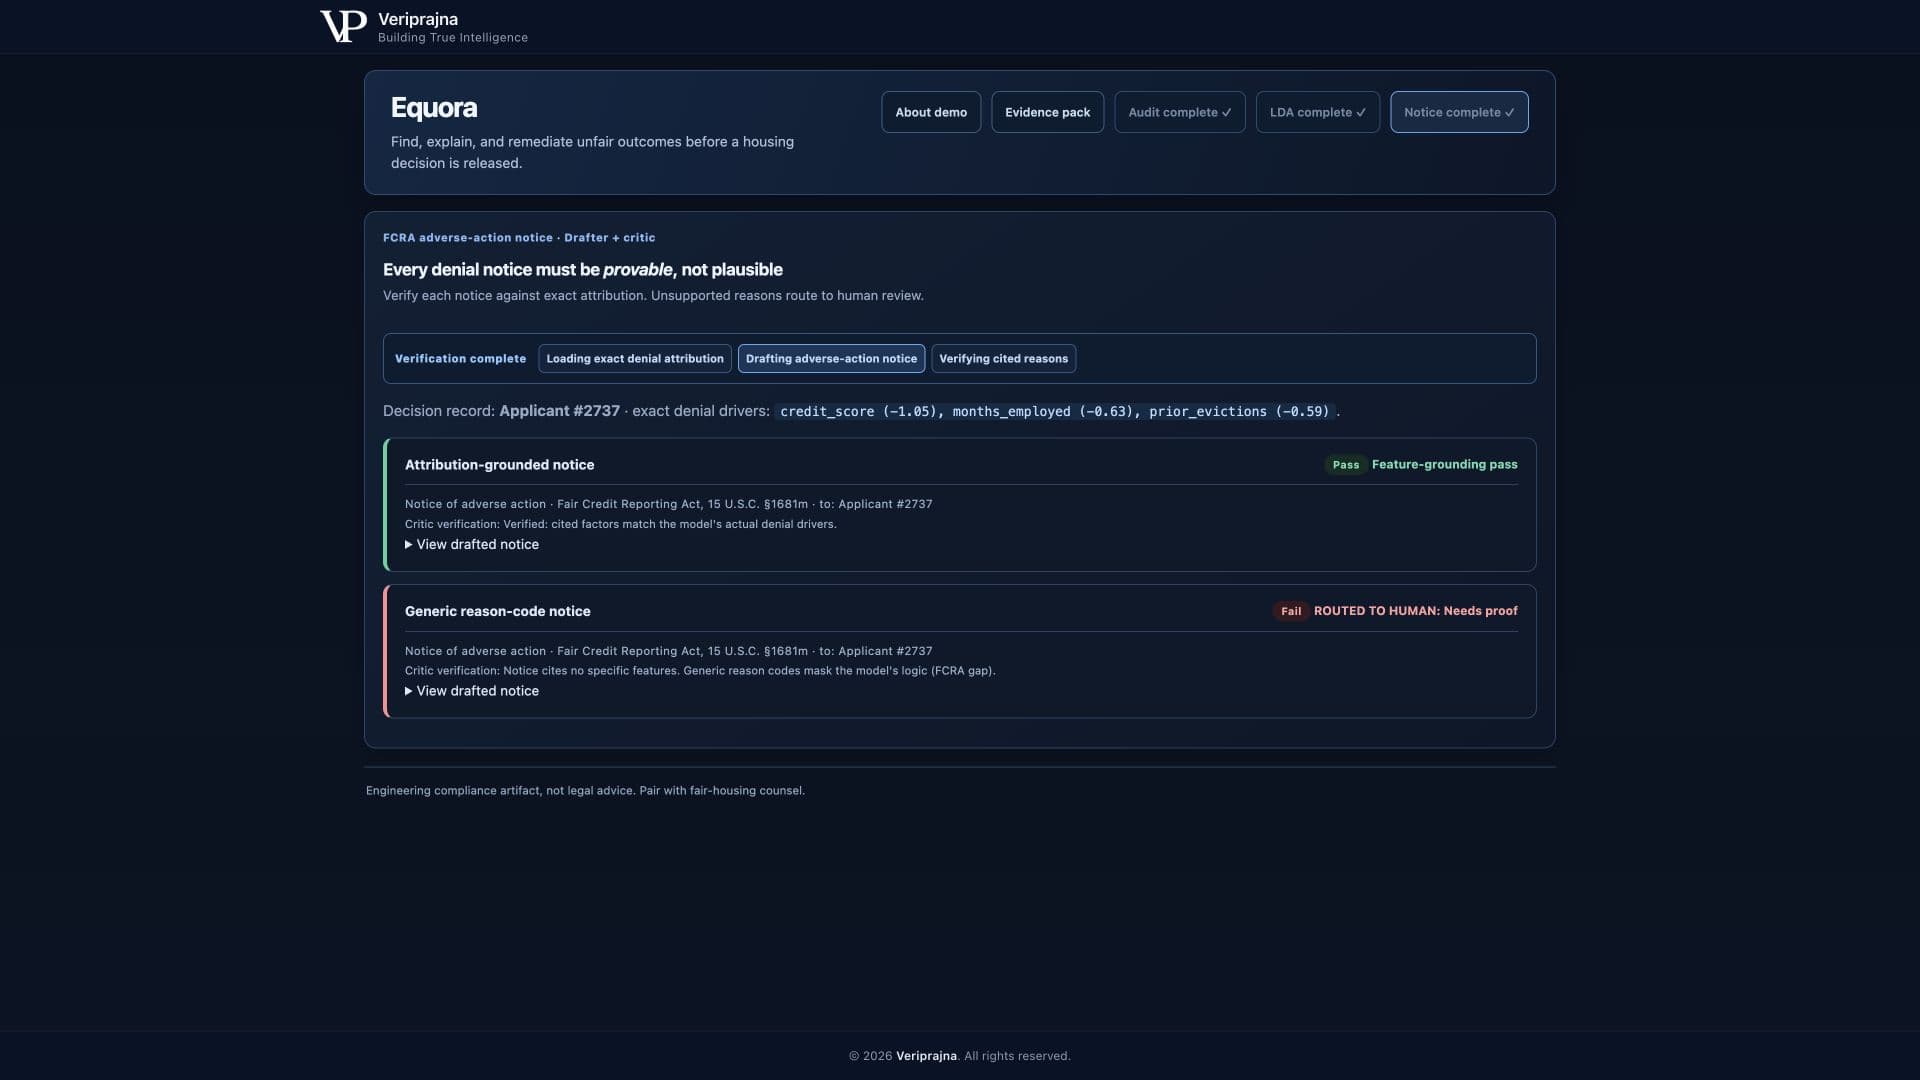
Esto es adyacente a la búsqueda más que una segunda tesis. Una vez que un equipo elige una alternativa, la evidencia aún debe trasladarse al registro de decisiones y a cualquier explicación que se emita a partir de él. Una búsqueda reproducible pierde su valor de gobernanza si el último tramo puede inventar una razón.
El artefacto que querría tener en la sala
Ahora imagino la reunión de revisión de manera diferente. No imagino a alguien presentando una puntuación roja y pidiendo a la sala que acepte una promesa amplia de mejorar el modelo. Imagino a un revisor abriendo la cuadrícula acotada, viendo a cada candidato con igual selectividad, revisando la frontera de Pareto y rastreando el resultado seleccionado hasta la regla configurada.
Querría que el registro mostrara tanto la ganancia como el costo. Aquí, eso significa DIR mínimo en 0.875 y AUC en 0.7788 después de la búsqueda, con los valores del modelo base junto a ellos. También querría que el sistema conservara las alternativas que rechazó y devolviera ninguna alternativa segura cuando ninguna califica. Una recomendación forzada borraría el resultado posible más importante.
El recorrido completo está disponible en el análisis detallado de cumplimiento de IA de vivienda de Equora. Muestra la auditoría, la búsqueda de Alternativa Menos Discriminatoria acotada, la vista de equilibrio y la transferencia de evidencia. Sigue siendo una demostración de ingeniería construida sobre datos sintéticos, no un sistema de decisión en producción ni asesoramiento legal.
Y si prefiere ver el flujo de trabajo en lugar de leer mi descripción, aquí está el recorrido del fundador ejecutándose de principio a fin.
Comencé con una métrica roja porque era lo más obvio que mostrar. Terminé convencido de que el artefacto más valioso es el camino reproducible desde el resultado rojo hasta una elección acotada, incluida la posibilidad de que el camino termine sin ninguna elección que califique. Una auditoría puede decirle a un equipo que se detenga. Un registro de búsqueda puede mostrar qué examinaron antes de decidir cómo proceder.