Il crash di CrowdStrike dipendeva da un conteggio: 21 campi dove il kernel ne attendeva 20. Nessun livello indipendente verificava.

Il 19 luglio 2024, un singolo aggiornamento di un fornitore ha mandato in crash milioni di macchine Windows in meno di 90 minuti, e la causa è stata un semplice numero. Un file di canale «Rapid Response Content» di CrowdStrike dichiarava 21 campi dove l'interprete kernel distribuito se ne aspettava 20. Quel campo aggiuntivo ha prodotto una lettura fuori dai limiti (out-of-bounds read), una schermata blu istantanea e, poiché il crash si è verificato così presto durante la fase di avvio, l'agente in blocco non è mai riuscito a ripartire per ricevere un comando di rollback. Il ripristino ha richiesto di raggiungere fisicamente ogni singola macchina e ripararla manualmente in modalità provvisoria (Safe Mode).
Ho letto l'analisi delle cause primarie (root-cause analysis) di CrowdStrike, pubblicata in agosto, più di una volta prima che emergesse ciò che realmente mi turbava. Non si trattava di un attacco informatico. Non era un modello imperfetto. Era un fatto aritmetico decidibile, 21 contro 20, inserito in un payload che nessun livello indipendente aveva mai verificato prima che raggiungesse la produzione. Il validatore del fornitore lo ha approvato. Le aziende che si sono ritrovate paralizzate non possedevano quel validatore. Ne hanno subito le conseguenze.
Ho trascorso l'ultimo periodo a costruire una demo attorno a questo divario: una console che ho chiamato Kestrel, che si posiziona tra un fornitore di software e una flotta di produzione e decide, tramite codice, cosa il fornitore sia autorizzato a distribuire. Potete vederne il funzionamento su veriprajna.com/demos/software-update-integrity. Ciò che mi ha sorpreso durante la costruzione è stato il punto esatto in cui risiedeva la soluzione. Ero partito con la convinzione che avrei avuto bisogno di un modello più intelligente, e poche righe di semplice Python hanno intercettato il crash prima di qualunque altra cosa.
Ho ricostruito il crash e poi ho lasciato che fosse il codice a decidere
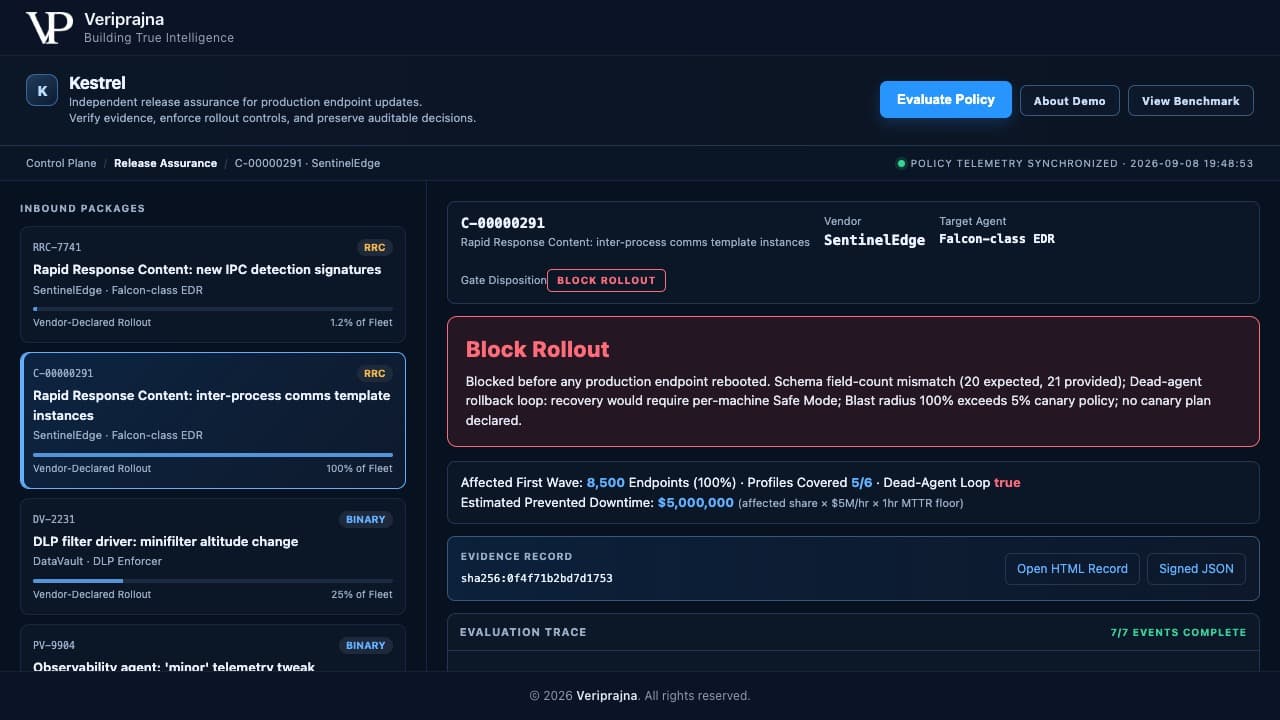
Ho ricostruito la sequenza di fallimento del 19 luglio sotto forma di fixture e vi ho indirizzato contro il mio stesso sistema, aspettandomi quasi di restare deluso dal mio stesso replay. Il pacchetto è C-00000291, un file di canale Rapid Response Content proveniente da un fornitore fittizio che ho chiamato SentinelEdge, inviato a una flotta sintetica di 8.500 endpoint denominata Acme Financial. Nessuna di queste è una società reale. La firma del guasto è invece autentica: uno schema dichiarato di 20 campi che sale a 21, distribuito al 100% della flotta in un'unica ondata, senza alcun piano di rilascio graduale (canary).
Il policy gate scatta simultaneamente su quattro controlli, e ciascuno di essi è pura aritmetica o una ricerca diretta, mai una valutazione soggettiva. Il diff dello schema individua 21 campi dove l'interprete ne attende 20 e segnala la lettura fuori dai limiti. Una sandbox simulata, che è un modello deterministico di esito per profilo e non una farm di macchine virtuali Windows reali, manda in boot-loop 5 profili su 6 della flotta attraverso cicli di riavvio. Ricava tale risultato da un segnale di compatibilità dei driver indipendente dal controllo dello schema, cosicché i due riscontri si corroborano a vicenda anziché ripetersi a eco. Il rilevatore di agenti inerti contrassegna il ciclo di rollback come vero, perché l'agente che va in crash è esso stesso il componente che dovrebbe ricevere il rollback, ed è inerte prima del completamento dell'avvio. Il raggio di impatto è del 100% a fronte di una policy canary del 5%. Verdetto: BLOCK. Sullo schermo si legge: bloccato prima che qualunque endpoint di produzione venisse riavviato.
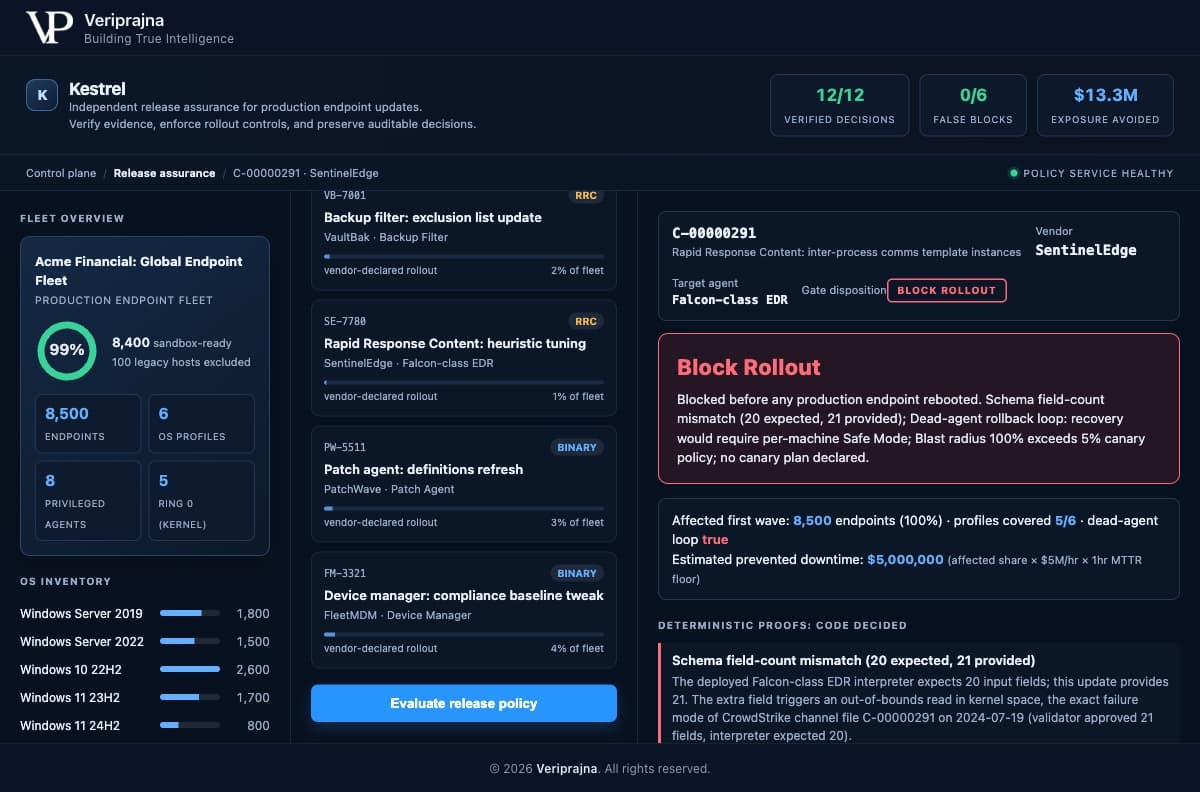
La stima del tempo di inattività evitato su quel singolo aggiornamento indica 5.000.000 $, e desidero essere preciso su cosa rappresenti tale cifra. Si tratta del modello interno della demo: la quota interessata moltiplicata per un parametro di 5 milioni di dollari l'ora e per un limite minimo di ripristino di un'ora, con la formula stampata a schermo. Non è denaro che un cliente ha concretamente risparmiato. Il vero ripristino del 19 luglio ha richiesto giorni, non un'ora, quindi la soglia minima è deliberatamente prudente.
Il caso verde mi ha spaventato più di quello rosso
Ero più preoccupato per il caso verde che per quello rosso, perché un livello di governance che blocca l'aggiornamento pericoloso ma soffoca anche quello sicuro non è altro che un disservizio programmato da noi stessi. Lo stesso fornitore fittizio rilascia RRC-7741, un aggiornamento benigno di firme di rilevamento, con schema dichiarato da 20 a 20 e un piano canary scaglionato all'1,2%. Il team di agenti si avvia, lo schema coincide, 5 profili su 6 superano i loro cicli di riavvio, il ciclo di agente inerte è falso, il raggio di impatto rientra nella policy. Verdetto: APPROVE ROLLOUT, distribuito a un anello canary di 102 endpoint. Verde, rapido, lineare.
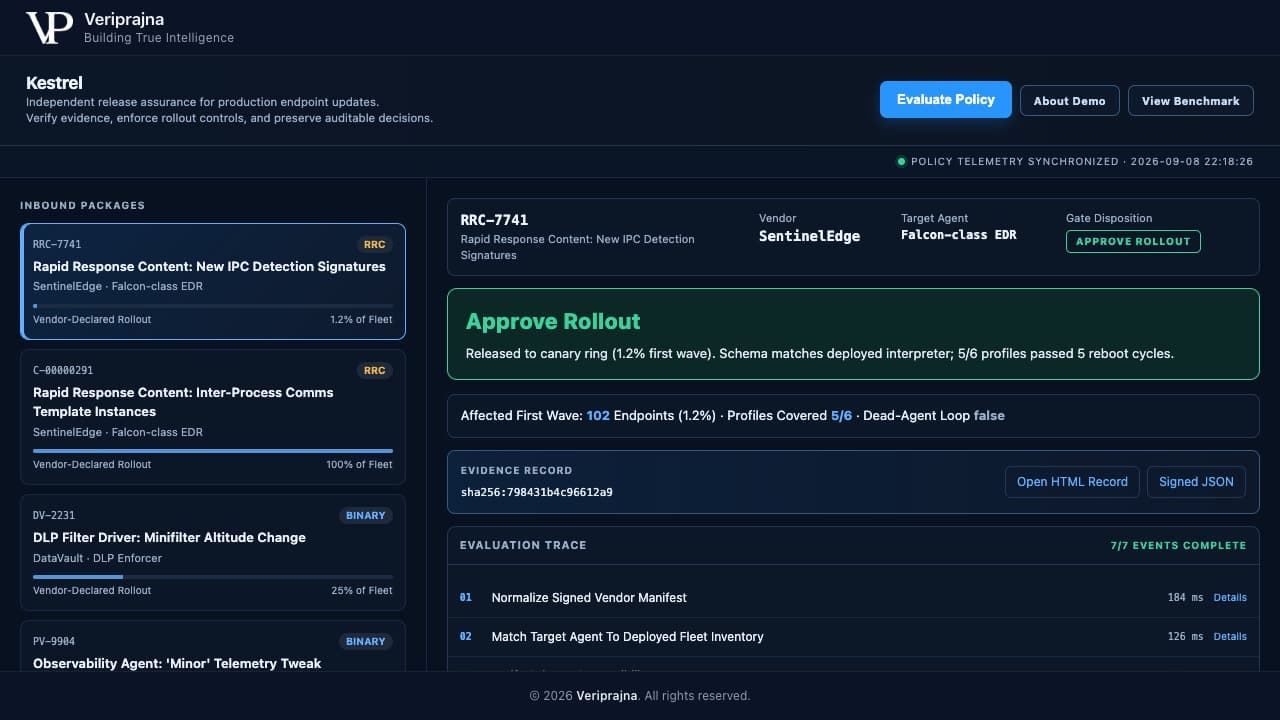
Tra i sei aggiornamenti benigni del set, il gate ha prodotto zero falsi blocchi. Lo affermo specificando il denominatore, perché sei è sei, e non consentirò che venga arrotondato in una promessa per la vostra flotta. Il valore del caso ALLOW è più circoscritto e più determinante di una percentuale. Un gate è credibile solo se risulta invisibile sul normale traffico e irremovibile nell'unico evento in grado di abbattere la vostra infrastruttura.
Perché ho tolto il verdetto dal modello
Ho intrapreso questo sviluppo partendo dal presupposto che la parte complessa risiedesse nel ragionamento e che un modello più affilato o un critico più accorto sarebbe stato l'elemento capace di cogliere l'aggiornamento errato. Mi sbagliavo, e ho impiegato del tempo ad ammetterlo. C'è un gruppo di LLM all'interno di Kestrel: un normalizzatore, un interprete di sandbox e due critici contrapposti, uno che sostiene che l'aggiornamento sia sicuro da distribuire e uno che sostiene che causerà un crash. La coppia avversaria guadagna il suo posto perché sottopone a red-teaming il verdetto da entrambe le direzioni prima che qualunque cosa venga decisa. Ma nessuno di questi agenti stabilisce il verdetto.
Il verdetto viene stabilito da due semplici file Python, verifier.py e gate.py, che risiedono interamente all'esterno del framework degli agenti. Il gruppo opera su Pydantic AI con il modello predefinito claude-opus-4-8, e l'intero sistema funziona anche offline senza alcuna chiave API tramite un fallback consultivo deterministico. In ciascuna di queste modalità il gate è identico e restituisce la medesima decisione, poiché la decisione è aritmetica, non inferenza. Gli agenti consigliano, il codice decide. Un agente consultivo orientato su «consenti» non può annullare un riscontro deterministico critico, e questa non è una questione di preferenze.
Un livello creato per controllare il fornitore non può fidarsi della parola del fornitore per quanto riguarda la sicurezza. Non può nemmeno fidarsi della parola del proprio modello.
Questa frase è il motivo per cui l'architettura si presenta in questo modo. La fiducia in un prodotto il cui unico compito è governare ciò che un fornitore distribuisce non deve mai passare attraverso un componente che possa essere convinto a dire sì.
Cosa consegnerei a un revisore
Ho tenuto il Cyber Resilience Act dell'UE aperto su un secondo monitor mentre costruivo il registro delle prove, perché quel registro è l'artefatto che dovrei effettivamente difendere. Ogni decisione esporta un file HTML immutabile e un file JSON firmato contenente un hash di contenuto SHA-256, il verdetto, le prove deterministiche, i risultati della sandbox per ciascun profilo, i verdetti degli agenti consultivi con l'identificativo del loro modello, le regole di policy attivate e una traccia di valutazione passo per passo in cui ogni fase riporta la propria latenza.
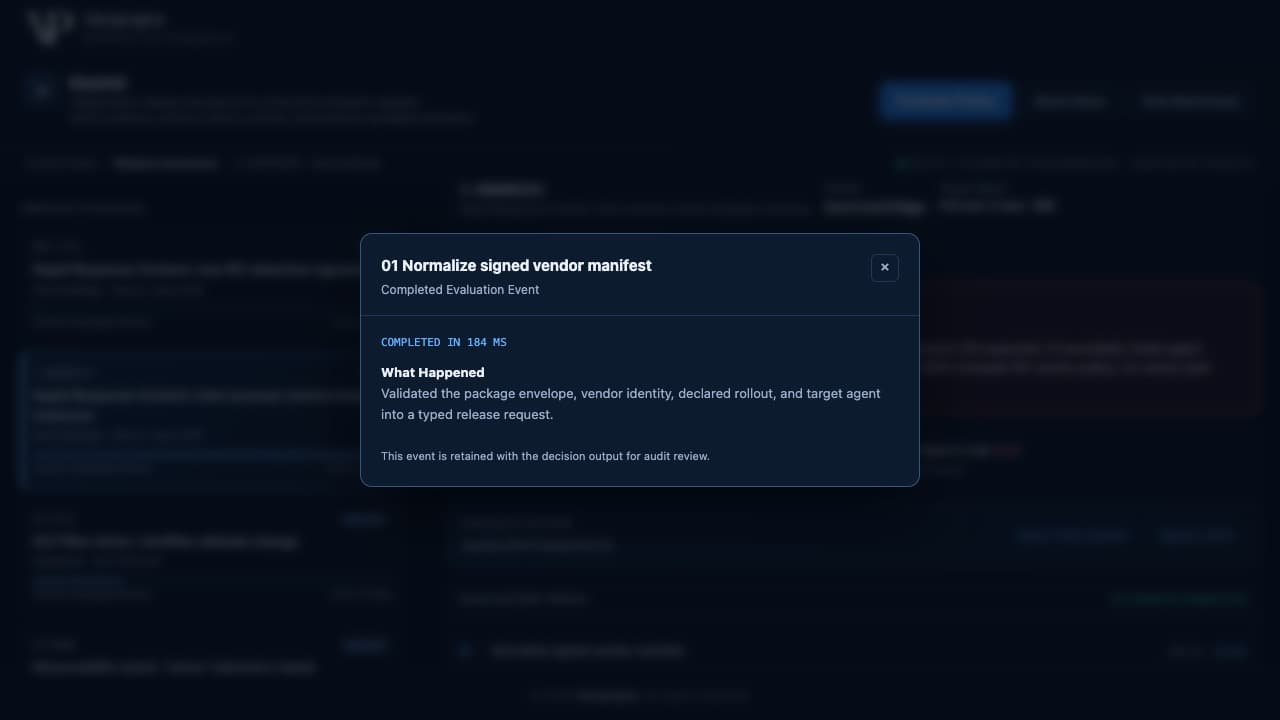
La traccia è la componente che ho sottovalutato finché non ho fatto clic su un singolo passaggio. Un evento recita: «Normalizzazione del manifesto del fornitore firmato, completata in 184 ms», e viene conservato con l'output della decisione per la verifica di conformità. Ogni passaggio è ricalcolabile. Un regolatore non deve fidarsi ciecamente della mia dashboard. Può ripetere l'aritmetica e ottenere il medesimo risultato.
Sono meticoloso su cosa sia e cosa non sia la firma. Si tratta di un SHA-256 locale, non di una PKI aziendale. Il feed degli aggiornamenti del fornitore e i ticket ITSM sottostanti sono stub di test, non connettori in tempo reale. Il registro è progettato per allinearsi alle esigenze di rendicontazione: la notifica tempestiva degli incidenti prevista dal CRA, l'obbligo di divulgazione entro quattro giorni lavorativi di un incidente di cybersicurezza rilevante imposto dalla SEC e le questioni di responsabilità del fornitore emerse nella causa Delta v. CrowdStrike nella contea di Fulton nel 2025. Progettato per allinearsi. Non rilascia certificazioni a nessuno, non costituisce consulenza legale e chiunque vi venda un registro di controllo sostenendo che vi renda conformi cerca solo di vendervi qualcosa.
C'è un'ulteriore decisione di cui sono orgoglioso, ed è un rifiuto. Il test fixture XX-0000 è un payload di contenuti proprietari crittografati che il gate non può analizzare, quindi non formula ipotesi. Restituisce ABSTAIN e lo inoltra a un revisore umano, perché un gate che dà il via libera a ciò che non sa interpretare è peggiore di nessun gate. Gli host legacy che la sandbox non è in grado di modellare vengono contrassegnati ed esclusi, mai considerati sicuri per presunzione. Il vocabolario conta quattro parole: ALLOW, HOLD, BLOCK, ABSTAIN, e quest'ultima è quella che difenderei con maggior vigore.
Cosa ha il diritto di significare 12 su 12
Qui devo rallentare, perché è esattamente il momento in cui un fondatore inizia ad arrotondare per eccesso. E ho chiamato l'azienda Veriprajna, «vera saggezza», quindi l'arrotondamento è fuori discussione. Su un set fisso ed etichettato di dodici aggiornamenti, il gate restituisce la decisione corretta su tutti e dodici. Sei di essi sono innocui e non ne blocca nessuno. Uno corrisponde all'onesto ABSTAIN. Il quadro mostra 12/12 decisioni verificate, 0/6 falsi blocchi e 13,3 milioni di dollari di tempo di inattività evitato stimato sull'intero set, di cui 5 milioni derivano dal solo blocco della classe CrowdStrike.
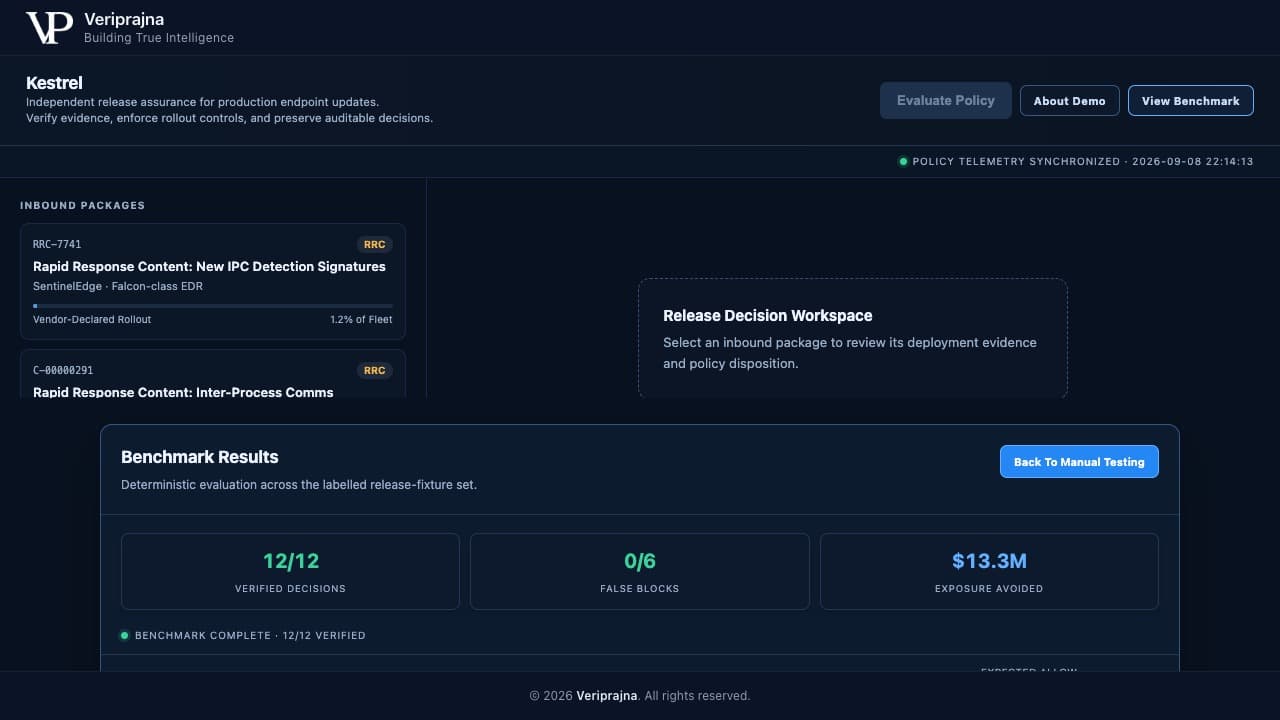
Ora la parte che mi rifiuto di abbreviare. Questi sono risultati ottenuti su dodici elementi etichettati, non una promessa sul prossimo aggiornamento che giungerà sulla vostra flotta. Sei elementi innocui sono sei. Questo non significa che «blocca il 100% degli aggiornamenti difettosi», non lo sarà mai, e se mai doveste cogliermi a scrivere questa frase dovreste smettere di leggermi. Il numero che sostengo è di diversa natura: medesimo input, medesima decisione, a ogni esecuzione, poiché il verdetto non comporta alcuna temperatura di modello. Eseguite nuovamente il set di test domani e restituirà risultati identici byte per byte, il che permette a un livello deterministico di essere verificato come un livello probabilistico non potrà mai essere.
La domanda che mi rimane
Ciò che mi rimane impresso di questo progetto è la totale ordinarietà del guasto. Ventuno campi dove ne erano attesi venti. Un numero che qualunque verificatore indipendente avrebbe potuto intercettare per via aritmetica prima ancora che una sola macchina si riavviasse, se solo ci fosse stato un verificatore indipendente tra il fornitore e la flotta. Non ce n'era nessuno. Ancora oggi, per lo più, non ce n'è alcuno.
Ogni azienda esegue da otto a dodici agenti dotati di privilegi di kernel provenienti da fornitori che non controlla, e ciascuno di essi può spingere un file direttamente nel ring 0. Gli strumenti SBOM controllano le dipendenze open source. La gestione delle identità controlla gli accessi. Nessuno legge l'aggiornamento proprietario del fornitore in entrata per dimostrarne l'innocuità. Kestrel non è un EDR e non tocca mai il kernel. Si colloca al di sopra di questi agenti e governa ciò che hanno la facoltà di distribuire. È questo il livello che ho cercato di costruire, e la spiegazione approfondita si trova su veriprajna.com/demos/software-update-integrity.
E se preferite vederlo in azione anziché leggermi mentre lo descrivo, ecco l'intero sistema in funzione da cima a fondo.
Ecco dunque ciò che ora domando a proposito di ogni flotta che incontro: quando arriverà il prossimo aggiornamento di un fornitore, cosa si interporrà tra quel file e la produzione, e sarà in grado di dimostrare il proprio lavoro? Se la risposta è un comitato di gestione dei cambiamenti (CAB) che si fida ciecamente del fornitore, allora l'aritmetica che ha paralizzato milioni di macchine continua a funzionare indisturbata. Non si annuncerà. Apparirà esattamente identica a ogni aggiornamento precedente, fino all'istante esatto del riavvio.