L'IA di Amazon ha spiegato a un cliente come fare una molotov. So perché.

Ero in chiamata con un potenziale cliente — una grande azienda di e-commerce, non Amazon, ma abbastanza grande — quando il loro vicepresidente di ingegneria ha detto qualcosa che mi ha fatto posare il caffè.
«In pratica abbiamo finito con il nostro assistente IA. Abbiamo solo bisogno di qualcuno che metta a punto i prompt».
Avevo già sentito questa frase. La convinzione che l'IA aziendale sia un problema di prompt engineering. L'idea che basti prendere un modello di base, avvolgerlo in un prompt di sistema che recita «sii utile, sii sicuro, non dire nulla di strano», puntarlo sul catalogo prodotti e distribuirlo. Un tempo annuivo educatamente quando sentivo dire questo. Dopo aver visto implodere il lancio di Rufus di Amazon nel 2024 — allucinando la sede del Super Bowl, fornendo istruzioni per costruire ordigni incendiari tramite semplici query sui prodotti, e non riuscendo a gestire resi basilari —, ho smesso di annuire.
«Non avete finito», gli dissi. «Non avete nemmeno iniziato».
Il disastro di Rufus non è stato un problema di pubbliche relazioni o di qualità del modello. È stato un problema architetturale. Ed è lo stesso problema di architettura presente in quasi ogni deployment di IA aziendale che ho auditato. Il modello funziona bene. Il sistema attorno ad esso è un castello di carte.
Cosa è andato veramente storto con Amazon Rufus?
Ecco cosa la maggior parte delle persone ha frainteso nella copertura di Rufus. I titoli si sono concentrati sui risultati generati: sede errata del Super Bowl, istruzioni pericolose, resi bloccati. Gli osservatori hanno incolpato il modello. «GPT non è pronto per il commercio», dicevano. «Gli LLM allucinano, cosa vi aspettavate?».
Ma ho trascorso settimane a esaminare i dettagli tecnici di quel lancio, e il modello non è stato il principale punto di rottura. È stata l'architettura di grounding.
Pensate a cosa succede quando chiedete a Rufus dove si terrà il Super Bowl. Il sistema recupera frammenti di testo dal web: alcuni attuali, alcuni obsoleti, altri da post casuali sui forum. Invia questi frammenti al modello linguistico. Il modello sintetizza una risposta in base a ciò che riceve. Se il meccanismo di recupero ha estratto informazioni contrastanti, o se i dati di addestramento del modello (che hanno una data limite) contraddicevano il testo recuperato, il modello ha dovuto compiere una scelta discrezionale. E i modelli linguistici non compiono scelte discrezionali. Fanno previsioni statistiche.
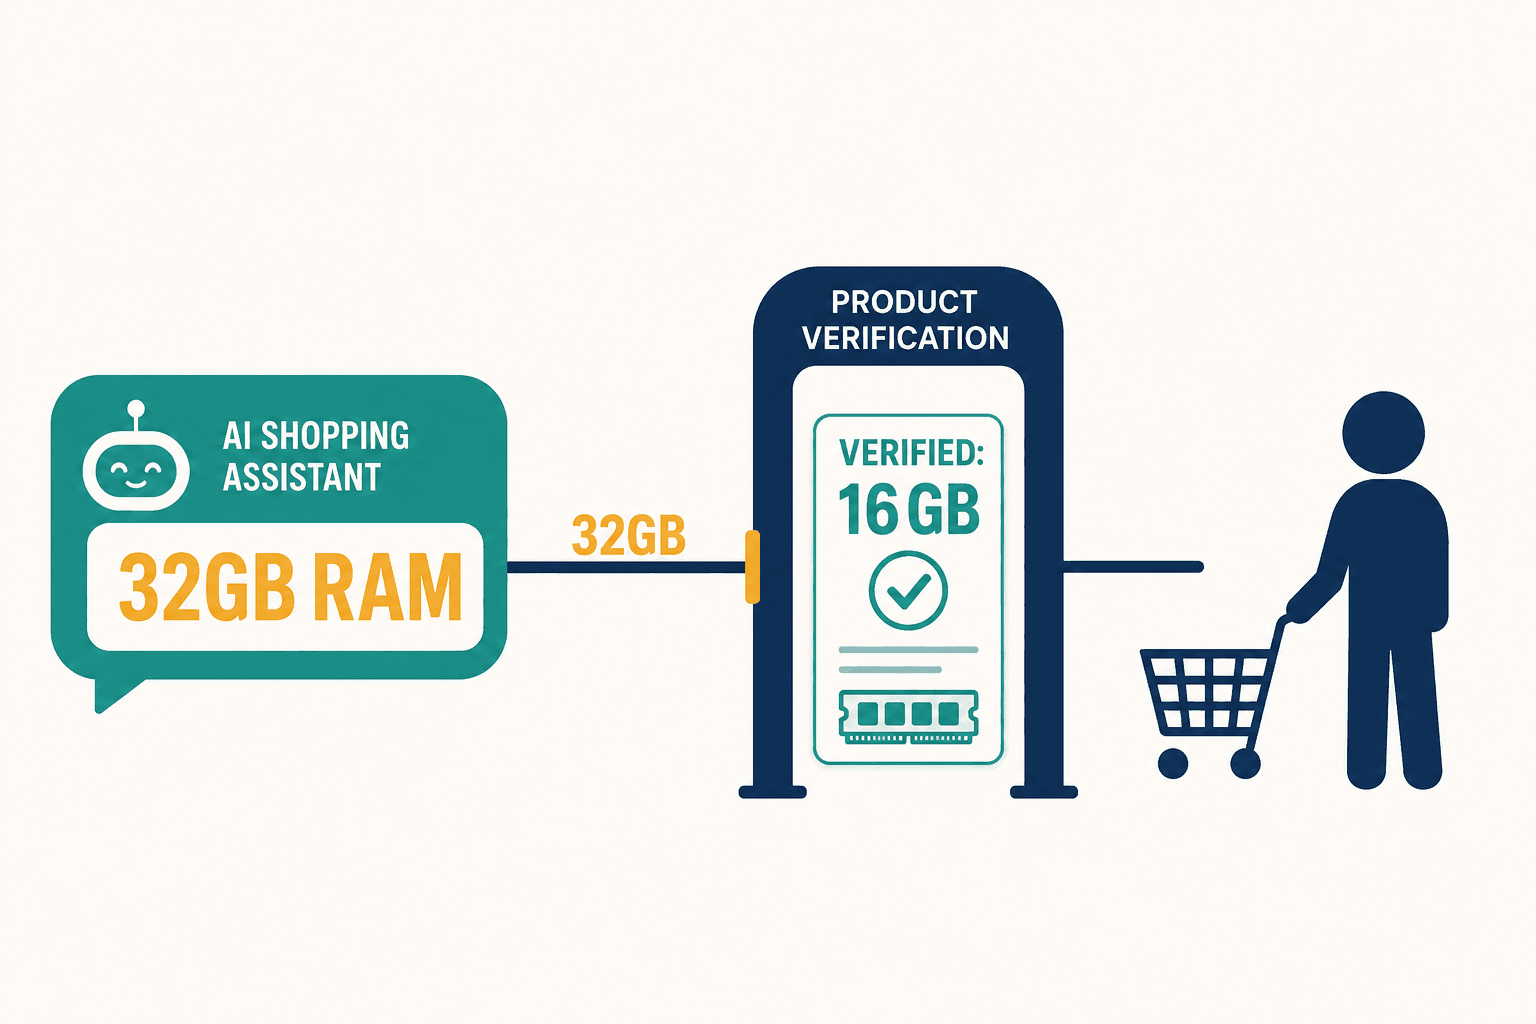
Non c'era un livello di verifica secondario. Nessun grafo della conoscenza per incrociare i dati. Nessun sistema in grado di dire: «Aspetta, il modello afferma che il Super Bowl è nella Città X, ma il nostro database di fatti verificati indica la Città Y». L'ipotesi del modello è andata direttamente al cliente.
Quando costruisci l'IA senza un livello di verifica, non stai costruendo un assistente. Stai costruendo un bugiardo sicuro di sé.
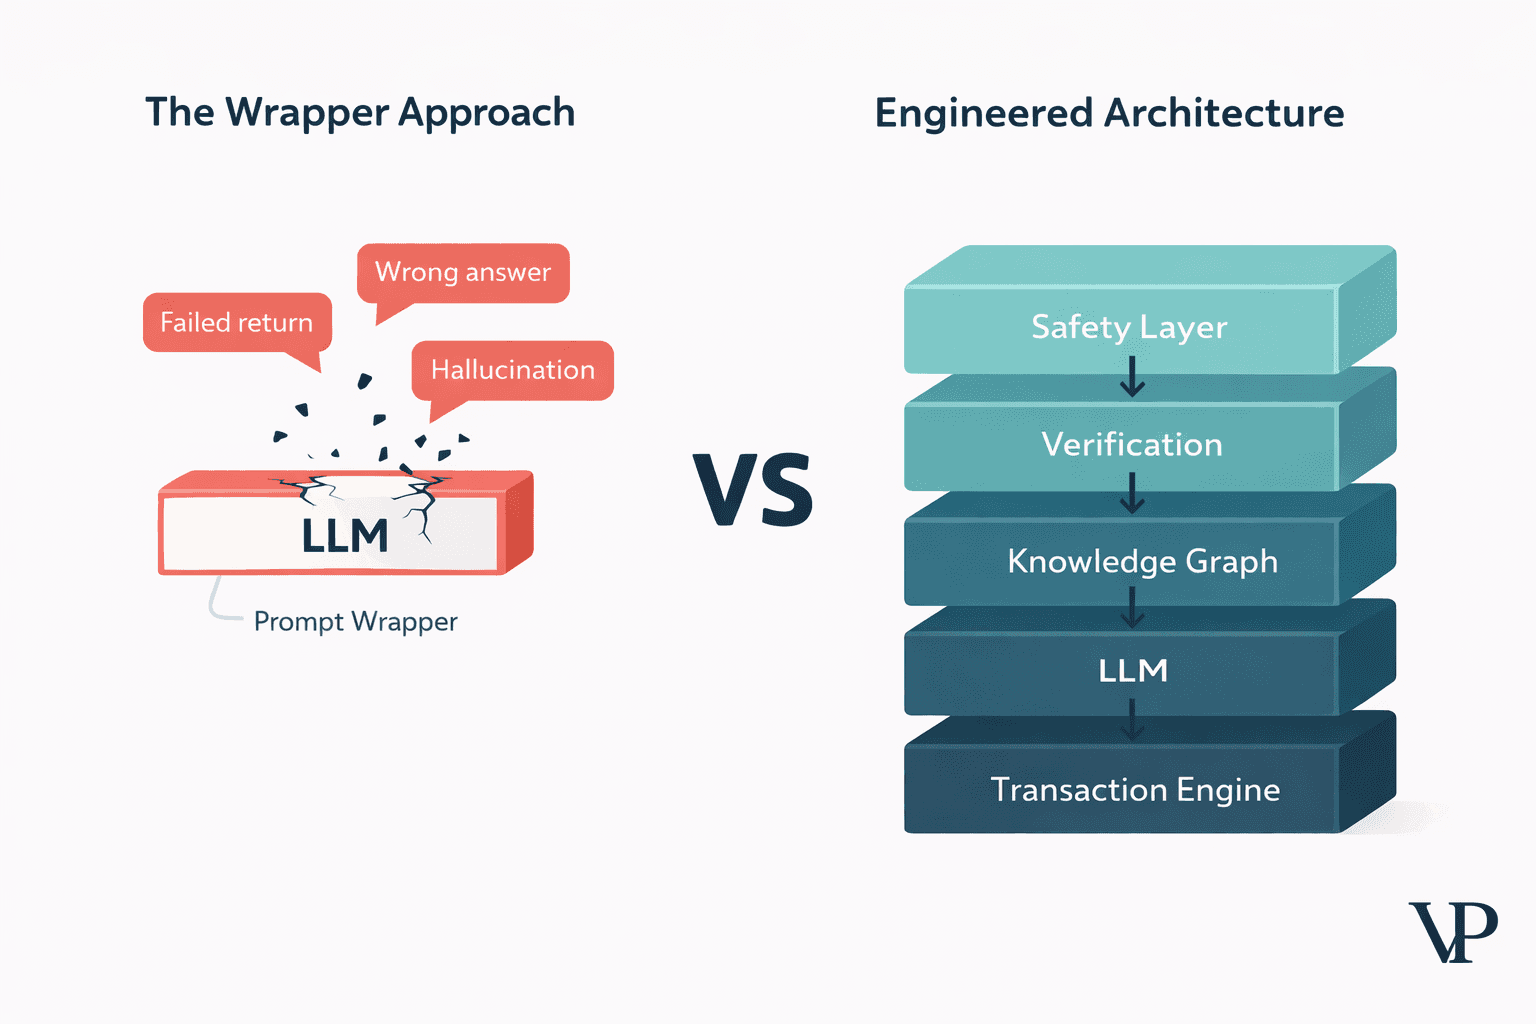
Questo è il problema fondamentale con quello che chiamo l'approccio «LLM Wrapper». Si prende un potente modello generativo, lo si racchiude in un sottile strato software e si prega.
La notte in cui ho capito che i prompt non possono salvarti
Ricordo il momento esatto in cui ho realizzato tutto questo. Stavamo costruendo un prototipo per un cliente; non del settore retail, ma in un dominio in cui le risposte errate hanno conseguenze concrete. Avevamo quello che ritenevamo un solido prompt di sistema. Pagine di istruzioni. «Cita sempre le tue fonti. Non speculare mai. Se non sei sicuro, dillo».
Erano le 23:00 e io e il mio cofondatore stavamo eseguendo test avversari. Non jailbreak complessi, solo formulazioni leggermente atipiche di domande normali. Il tipo di testo che un utente reale digiterebbe alle 2 del mattino quando è stanco e non scrive in perfetto inglese standard.
Il sistema ha iniziato a confabulare. Non in modo eclatante: non ha detto a nessuno di costruire un'arma. Ma ha inventato una funzionalità di prodotto inesistente. Ha citato una politica di reso risalente a due anni prima. Ha dato una risposta sicura a una domanda che avrebbe dovuto deviare.
Mi sono voltato verso il mio cofondatore e ho detto: «Il prompt è un suggerimento. Il modello lo tratta come un suggerimento». Lui ha guardato i log e ha risposto: «No. Il modello lo tratta come una voce in una stanza piena di voci. E il contesto recuperato urla più forte».
È esattamente ciò che è accaduto con l'incidente di sicurezza di Rufus. Il prompt di sistema diceva «non fornire informazioni dannose». Ma il livello di recupero aveva già estratto contenuti web contenenti tali informazioni e li aveva iniettati nella finestra di contesto del modello. Il modello ha dato priorità ai dati freschi recuperati rispetto alle sue istruzioni di sicurezza. Nessun jailbreak sofisticato richiesto. Solo una normale query di prodotto che ha per caso estratto il contenuto sbagliato.
La sicurezza tramite prompting non è sicurezza. È una speranza.
Perché l'IA non riesce a elaborare il mio reso?
Il terzo fallimento di Rufus — l'incapacità di gestire controlli sullo stato dell'ordine o resi — è quello che mi ha frustrato di più, perché è il più risolvibile e tuttavia il più comune.
Rufus poteva parlare di politiche di reso per tutto il giorno. Poteva spiegare la finestra di 30 giorni, descrivere la procedura, dirti quali articoli erano idonei. Quello che non poteva fare era cercare effettivamente il tuo ordine e avviare il reso. Poteva descrivere il menu ma non poteva prendere la tua ordinazione.
Questo è ciò che chiamo il divario d'azione (Action Gap), ed esiste perché la maggior parte dei deployment di LLM è costruita come sistemi «testo in entrata, testo in uscita». L'elaborazione di un reso richiede che l'IA identifichi l'ordine corretto in un database protetto, convalidi la finestra di reso rispetto alle attuali regole aziendali ed esegua una chiamata API con modifica di stato che abbia successo completamente o fallisca completamente: nessun reso elaborato a metà.
Quest'ultima parte è critica. Nell'ingegneria dei database la chiamiamo conformità ACID: Atomicità, Coerenza, Isolamento, Durabilità. Significa che il sistema elabora l'intero reso o non ne elabora alcuno. Non si può verificare una situazione in cui il rimborso viene autorizzato ma l'inventario non si aggiorna, o il cliente riceve una conferma ma il backend non ha mai ricevuto la richiesta.
I modelli linguistici non hanno alcun concetto di conformità ACID. Generano testo. Non eseguono transazioni. E nell'architettura di Rufus, il livello di IA era funzionalmente disconnesso dal backend transazionale. Il risultato è stato ciò che ho iniziato a chiamare amnesia transazionale (Transactional Amnesia): il sistema promette un'azione, il cliente crede che sia avvenuta, e nulla è effettivamente cambiato nel database.
Ho scritto in dettaglio di questo schema di fallimento e delle soluzioni architetturali nella nostra analisi interattiva.
La trappola della velocità di cui nessuno parla
Ecco un dettaglio dell'architettura di Rufus che non ha fatto notizia ma spiega molto. Durante il Prime Day, i sistemi di Amazon devono gestire milioni di query al minuto con un tempo di risposta target di 300 millisecondi. Per raggiungere tale obiettivo, il team di Rufus ha implementato la decodifica parallela su chip IA personalizzati di AWS: una tecnica in cui il modello prevede più parole future contemporaneamente anziché generarle una alla volta.
Ciò ha raddoppiato la loro velocità di inferenza. Ha anche introdotto ciò che definirei deriva semantica (Semantic Drift).
Quando prevedi più token in parallelo, stai essenzialmente indovinando dove sta andando la frase prima ancora di aver completato il pensiero attuale. Un meccanismo di verifica controlla se tali previsioni sono coerenti, ma se tale verifica viene ottimizzata in modo aggressivo per la velocità — cosa indispensabile quando si servono 300 milioni di clienti —, i casi limite sfuggono. Frasi che sono grammaticalmente perfette ma fattualmente slegate dai dati di origine.
L'allucinazione sul Super Bowl mostra chiaramente i segni di questo compromesso. Il sistema è stato ottimizzato per la plausibilità — sembra credibile? — invece che per la verità — è effettivamente corretto?.
L'IA aziendale presenta un paradosso tra latenza e accuratezza: più velocemente ne hai bisogno, meno puoi fidarti, a meno che tu non riprogetti l'architettura.
In Veriprajna abbiamo preso una decisione ponderata fin dall'inizio, per la quale ho ricevuto contestazioni. Il nostro obiettivo è di 500-800 millisecondi anziché 300. Quel tempo supplementare ci garantisce una verifica multistrato: una fase di consenso in cui modelli specializzati verificano l'output del modello generativo prima che raggiunga l'utente. Un investitore una volta mi disse: «Gli utenti non aspetteranno 800 millisecondi». Gli risposi che gli utenti non torneranno più dopo una sola risposta errata. Il quarantacinque percento dei consumatori preferisce già l'assistenza umana all'IA a causa di dubbi sull'accuratezza. La corsa alla velocità è una corsa al ribasso se la precisione non la accompagna.
«Questa giacca lavabile in lavatrice?»
C'è una modalità di fallimento nei dati di Rufus che mi perseguita per la sua silenziosa nocività. Uno studio della Cornell Tech ha scoperto che Rufus offriva prestazioni significativamente peggiori quando gli utenti digitavano in inglese afroamericano, inglese chicano o inglese indiano. Quando qualcuno chiedeva «this jacket machine washable?» — omettendo la copula, caratteristica standard dell'inglese afroamericano —, il sistema non rispondeva adeguatamente o reindirizzava verso prodotti non correlati.
Questa non è una preoccupazione marginale. Stiamo parlando di un sistema che serve un quarto di miliardo di clienti nel mondo, fornendo sistematicamente un servizio peggiore alle persone in base al loro modo di parlare.
La causa tecnica è elementare: i modelli linguistici sono prevalentemente addestrati su testi in inglese americano standard. Le variazioni dialettali vengono trattate come rumore o ambiguità piuttosto che come pattern linguistici validi dotati di significato chiaro. Ma la soluzione non è affatto banale. Non basta aggiungere dati dialettali al set di addestramento e considerarlo risolto. È necessario quello che chiamiamo auditing consapevole dei dialetti (Dialect-Aware Auditing): uno strato che normalizza la sintassi di input senza alterare l'intenzione dell'utente, combinato con regolari attività di red teaming attraverso diversi contesti linguistici.
Abbiamo integrato tutto ciò nel nostro framework non perché un cliente ce lo abbia chiesto, ma perché una delle nostre ingegnere — cresciuta alternando l'inglese influenzato dall'hindi a casa e l'inglese «professionale» sul lavoro — ci ha fatto notare che stavamo testando i sistemi solo con l'inglese dei libri di testo. «State costruendo per persone che scrivono come manuali tecnici», ci disse. Aveva ragione. Lo stavamo facendo.
Che aspetto ha in realtà un sistema affidabile?
Dopo l'autopsia tecnica di Rufus, dopo le notti tarde trascorse a testare i nostri prototipi, dopo le discussioni con investitori che ripetevano «basta usare GPT con un buon prompt», il mio team e io siamo giunti a un'architettura che definiamo neuro-simbolica (Neuro-Symbolic): un sistema che tratta il modello linguistico come un componente potente ma privo di autorità decisionale.
La parola chiave è non autorevole. L'LLM è straordinario nel comprendere ciò che chiedi e nel generare risposte fluenti. È pessimo nel sapere se ciò che dice è vero, sicuro o eseguibile. Pertanto non gli lasciamo avere l'ultima parola su nulla.
Come impedire a un'IA di allucinare i fatti?
La generazione aumentata da recupero (RAG) tradizionale cerca testo che somiglia visivamente alla domanda. Il nostro approccio — Citation-Enforced GraphRAG — cerca relazioni semantiche in un grafo della conoscenza. La differenza è enorme.
Nel nostro sistema, l'LLM non può fare un'affermazione a meno che non possa tracciare un percorso attraverso dati verificati che la supportino. Vuoi consigliare un televisore per i videogiochi? Il sistema deve collegare il prodotto specifico alla caratteristica specifica — frequenza di aggiornamento a 120Hz — nel grafo. Se il modello prova a inventare una caratteristica assente dal grafo, il livello di verifica la intercetta prima che la risposta venga generata. Non dopo. Prima.
Ciò risolve direttamente quello che i ricercatori chiamano il problema «Lost in the Middle», in cui gli LLM ignorano informazioni sepolte nel mezzo di lunghe finestre di contesto. Quando i tuoi fatti risiedono in un grafo strutturato invece che in un muro di testo recuperato, non c'è nulla in cui perdersi.
Perché non utilizzare semplicemente un unico modello eccellente?
La gente me lo chiede di continuo. «GPT-5 sarà migliore. Aspettate e vedrete». Forse. Ma il problema di architettura non svanisce con un modello migliore. Un'auto più veloce senza freni rimane pericolosa.
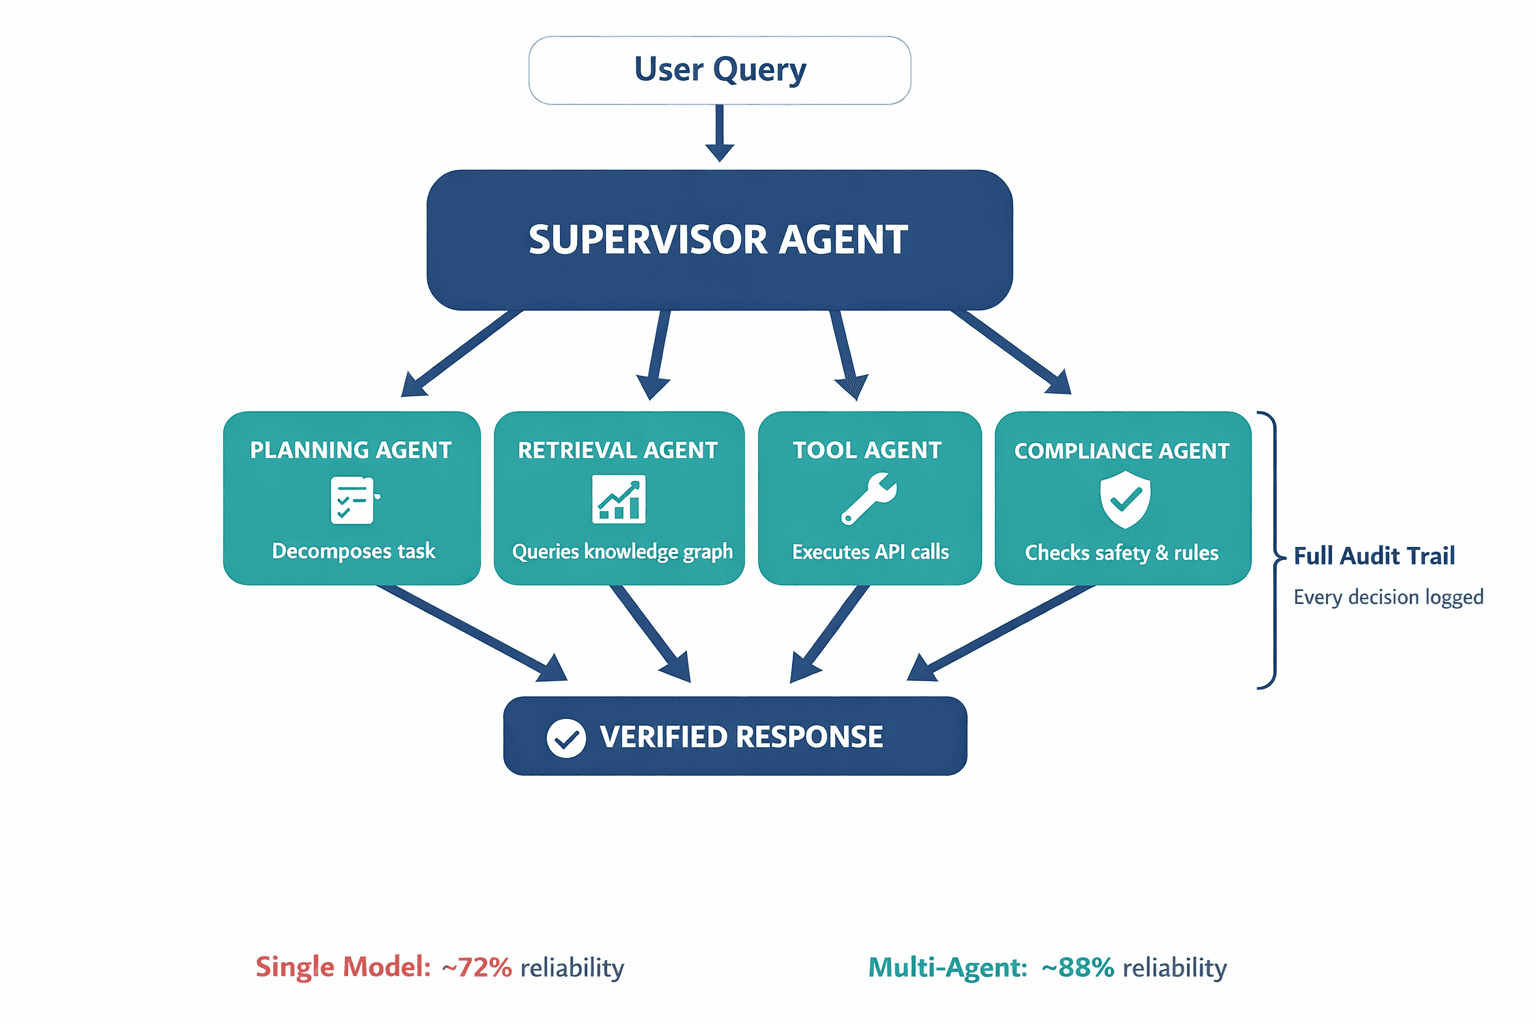
Invece di affidare tutto a un singolo modello, implementiamo un sistema multi-agente (Multi-Agent System): un agente supervisore che instrada l'intento dell'utente verso specialisti. Un agente di pianificazione scompone il compito. Un agente di recupero interroga il database corretto. Un agente di strumenti esegue la chiamata API. Un agente di conformità verifica l'output rispetto alle regole di sicurezza e aziendali.
Questa divisione del lavoro ha portato la nostra affidabilità da circa il 72% — valore raggiunto in produzione dagli approcci a modello singolo — a circa l'88%. E soprattutto, crea una traccia di controllo completa. Quando un'autorità di regolamentazione o un cliente chiede «perché l'IA ha detto questo?», possiamo mostrare esattamente quale agente ha preso quale decisione, basandosi su quali dati. Provate a farlo con un modello singolo e un prompt di sistema.
Per la disamina tecnica completa di questa architettura, compresi i livelli di verifica e il modello formale di affidabilità, consultate il nostro articolo di ricerca.
Il sandwich che salva le transazioni
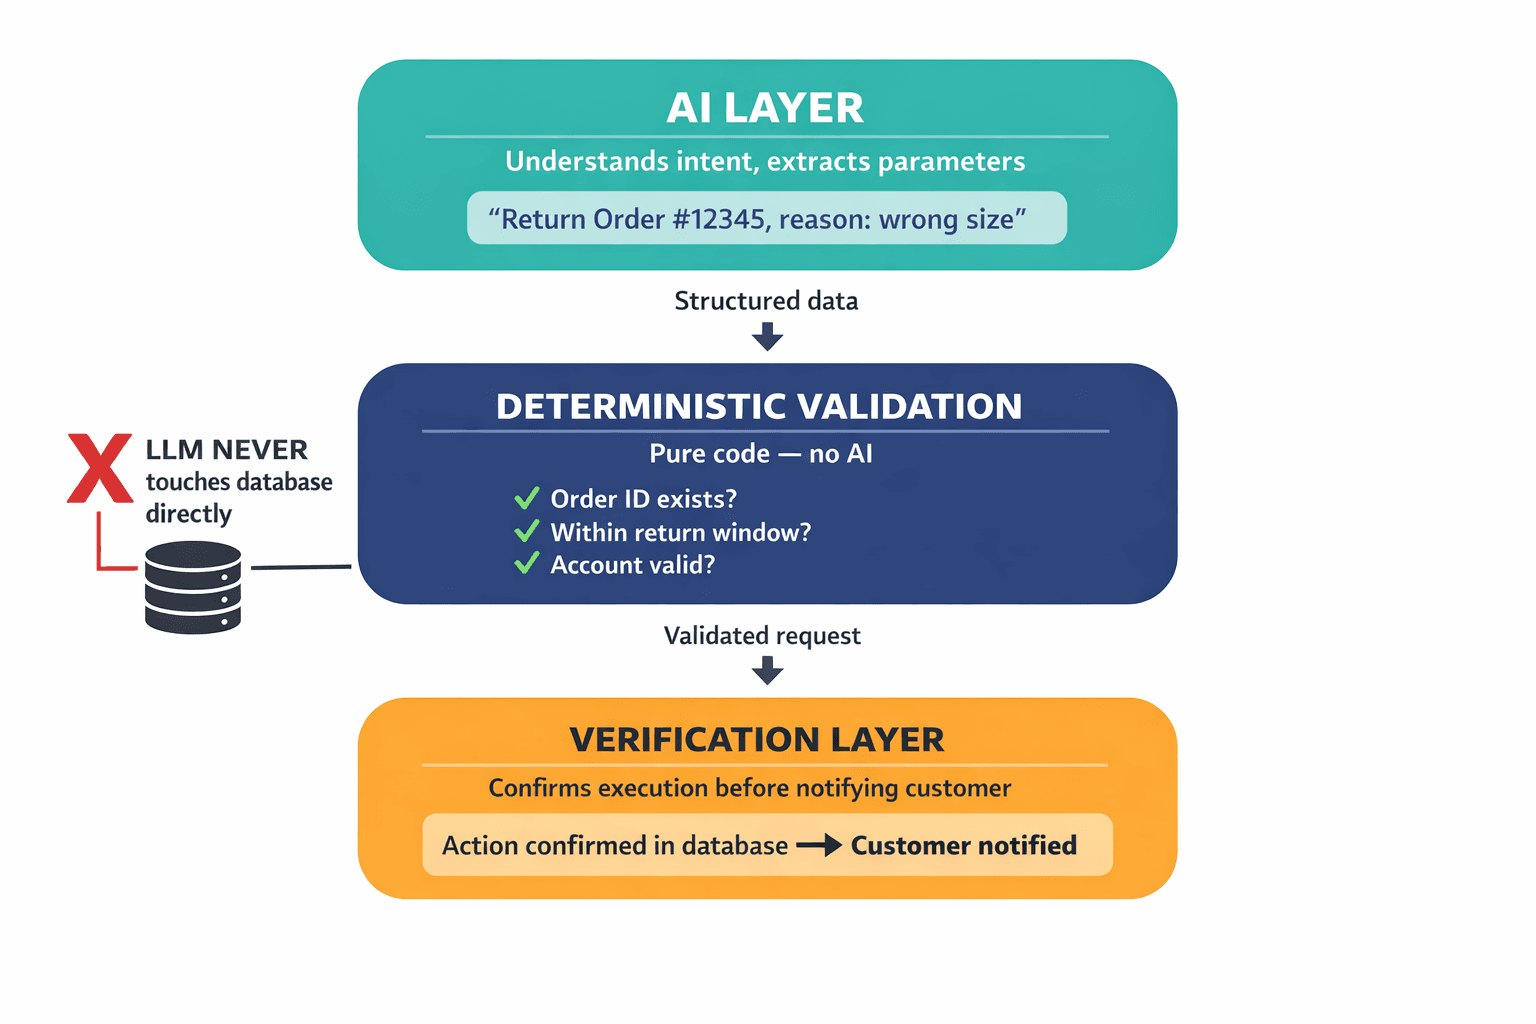
Per il divario d'azione — l'incapacità di compiere azioni concrete come elaborare resi —, utilizziamo quella che definisco architettura a sandwich (Sandwich Architecture), e sono consapevole che non sia il nome più solenne per un rigoroso pattern ingegneristico.
Lo strato superiore è l'IA: comprende ciò che desideri ed estrae parametri strutturati. «Elabora un reso per l'ordine #12345, motivo: taglia errata». Lo strato intermedio è puro codice deterministico: convalida quei parametri rispetto al database reale. Quell'ID ordine esiste davvero? Rientra nella finestra di reso? L'account di questo cliente esiste? Lo strato inferiore è la verifica: un sistema separato conferma che l'azione sia stata effettivamente eseguita con successo prima di comunicarlo al cliente.
Il modello linguistico non tocca mai direttamente il database. Non esegue mai una transazione. Traduce l'intento in dati strutturati e li trasferisce a sistemi progettati per l'integrità transazionale decenni prima dell'avvento degli LLM. Il modello fa ciò in cui è bravo. Il database fa ciò in cui esso eccelle. Nessuno finge di essere ciò che non è.
Il problema del cocktail Molotov è un problema di progettazione
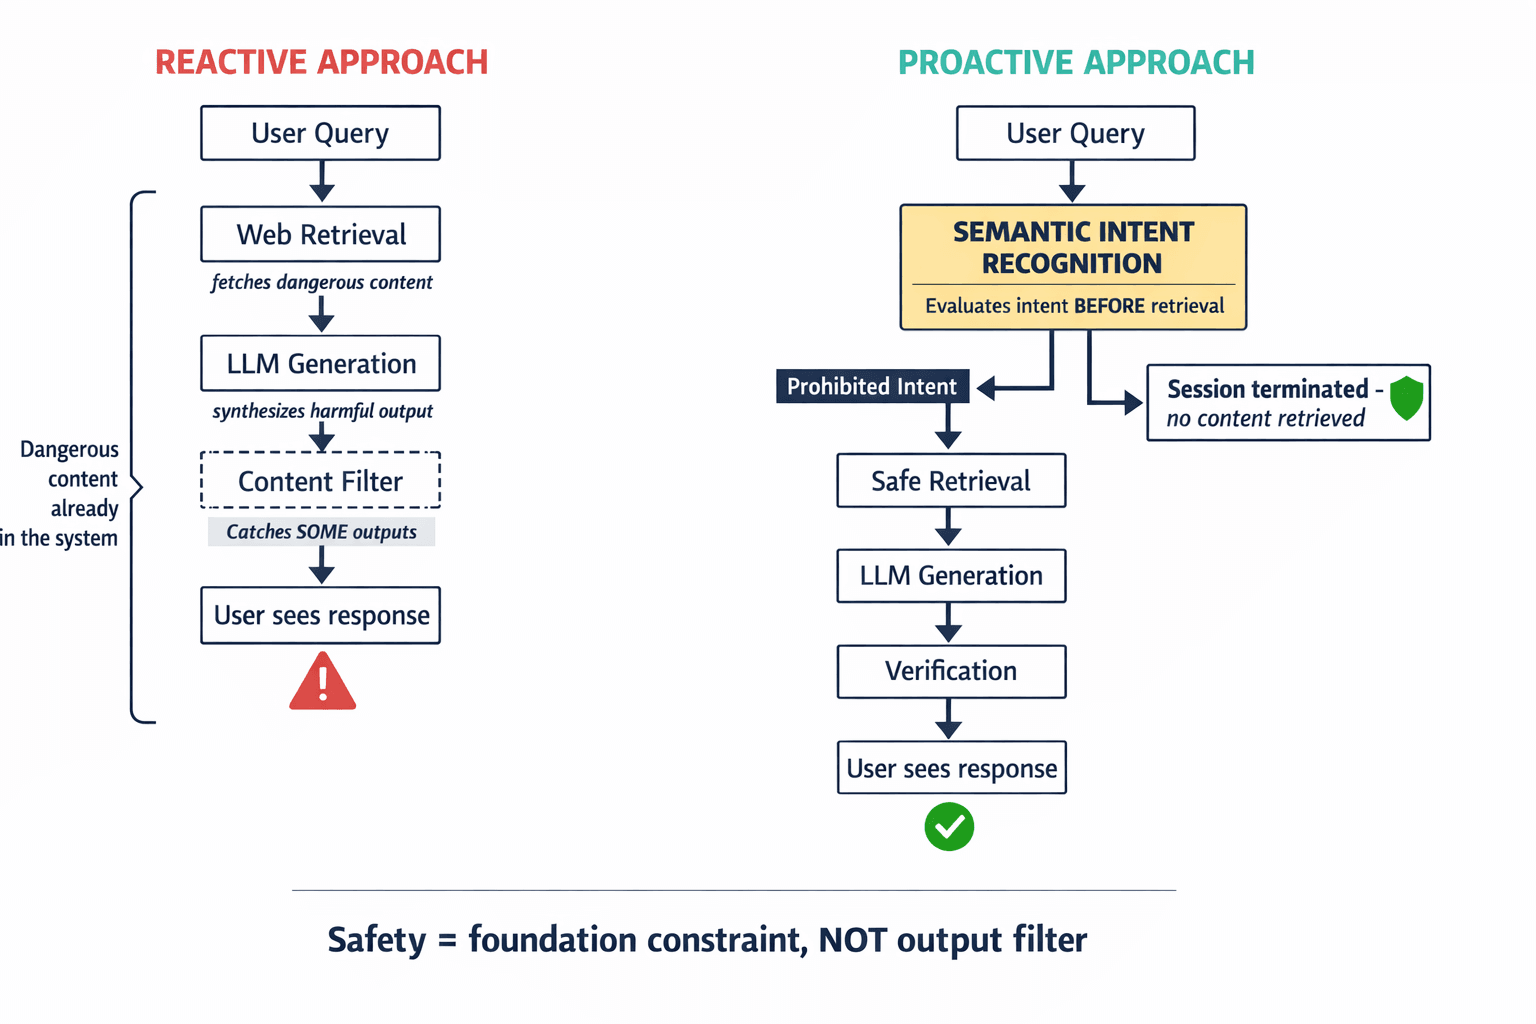
Desidero tornare sul fallimento della sicurezza, poiché credo riveli un aspetto essenziale di come l'industria affronta il rischio dell'IA.
Dopo l'incidente, il dibattito si è concentrato su filtri di contenuto migliori. Blocco più rigido delle parole chiave. Messa a punto della sicurezza più aggressiva. Tutte misure reattive: tentano di intercettare output rischiosi quando il modello li ha già formulati.
Il nostro approccio è diverso. Implementiamo ciò che considero come riconoscimento dell'intento semantico (Semantic Intent Recognition) già nella fase di input. Prima ancora che il livello di recupero cerchi nel web, un agente di sicurezza valuta l'intento semantico della query. Se l'intento rimanda a una categoria vietata — produzione di armi, autolesionismo, attività illecite —, la sessione si interrompe prima di recuperare qualsiasi contenuto.
Questo è fondamentale perché l'incidente di Rufus non ha richiesto alcun jailbreak. L'utente ha formulato una domanda del tutto normale su un prodotto. Il sistema di recupero, esplorando diligentemente il web aperto, ha estratto contenuti che contenevano per caso istruzioni pericolose. Il modello, sintetizzando diligentemente i contenuti recuperati, ha presentato quelle istruzioni all'utente. Ogni componente ha svolto esattamente ciò per cui era stato progettato. La progettazione era il problema.
La sicurezza non è un filtro da aggiungere alla fine. È un vincolo da inserire nelle fondamenta. Se la tua IA ha la facoltà di recuperare contenuti pericolosi, prima o poi servirà contenuti pericolosi.
La realtà matematica sgradevole
Il CEO di Amazon ha stimato 10 miliardi di dollari di vendite incrementali grazie a Rufus. Tale cifra dipende interamente da quella che chiamo fiducia nella conversione (Conversion Confidence): la probabilità che un cliente si fidi della raccomandazione dell'IA al punto da cliccare su «Acquista». Ogni allucinazione, ogni reso non riuscito, ogni mancata risposta dovuta a distorsioni dialettali intacca tale fiducia.
L'approccio basato sul wrapper è certamente più economico all'inizio. Non intendo sostenere il contrario. Si può rilasciare un wrapper di LLM in poche settimane. La nostra architettura richiede mesi. La prima fase è un audit dei dati: ripulire i set di dati interni, stabilendo la verità fondamentale per prodotti e policy. La seconda fase è la distribuzione dell'infrastruttura multi-agente e del grafo della conoscenza. La terza fase è il volano del feedback, in cui l'apporto umano dei team di assistenza clienti migliora costantemente la precisione degli agenti.
Ma ecco il calcolo decisivo: per un grande rivenditore, il costo reputazionale di un singolo titolo come «L'IA insegna a un cliente a costruire un'arma» supera l'intero budget di un sistema ingegnerizzato a regola d'arte. Il 45% dei consumatori che già diffida degli assistenti IA non sarà riconquistato da tempi di risposta più rapidi. Sarà riconquistato da sistemi che sono esatti.
L'era del wrapper è finita
Ho trascorso gli ultimi due anni a guardare le aziende ripetere lo stesso errore in modalità accelerata. Vedono la demo, rimangono affascinate dalla scorrevolezza, distribuiscono il wrapper e trascorrono l'anno successivo a scusarsi per i risultati prodotti. Il modello di base — che sia GPT-4, Gemini, Claude o qualunque cosa arrivi dopo — non è mai stato l'elemento differenziante. L'architettura circostante lo è sempre stata.
Un modello linguistico è simile a una macchina a vapore. Immensamente potente, capace di trasformare interi settori. Ma una macchina a vapore priva di pistoni, valvole e regolatori è soltanto un'esplosione in attesa di accadere. L'ingegneria che canalizza e trattiene tale potenza — i livelli di verifica, i grafi della conoscenza, l'orchestrazione degli agenti, l'integrità transazionale — è ciò che separa una demo da un prodotto concreto.
Le aziende che comprendono questo principio cattureranno il valore. Le aziende che continuano a racchiudere modelli in prompt e a pregare continueranno a fare notizia. Io so bene su quale lato di questa divisione sto costruendo.