Gezichtsherkenningsmelding scoorde 0.83: ik bouwde de poort die haar blokkeerde

Een ruwe FaceFirst-score van 0.83 kon geen toestemming creëren voor een synthetische gezichtsherkenningsmelding in Chicago, waardoor de deterministische beleidspoort deze blokkeerde. Ik heb dit scenario gebouwd om te testen of een biometrisch systeem governance behandelt als onderdeel van het besluit of als administratief papierwerk dat pas wordt toegevoegd wanneer het besluit al in gang is gezet.
De melding is LP-0834, een opzettelijk opgezet synthetisch scenario in Chicago. Het is geen klantgebeurtenis, geen livefeed en geen zaak van een echt persoon. De testopname is een 80-pixel opname bij weinig licht vergeleken met een 15 jaar oude politiefoto. FaceTrust kalibreert de ruwe score naar 0.50, met een interval van [0.217, 0.783] en een conforme 93%-voorspellingsset die zowel {mate, no_mate} bevat. Maar het doorslaggevende feit is eenvoudiger: er is geen toestemming geregistreerd, dus blokkeert de deterministische beleidspoort de scan onder de gesimuleerde BIPA-regel van de demo.
Ik blijf terugkeren naar die rangorde. Een model kan bewijs aandragen. Het mag echter niet bepalen dat een ontbrekende wettelijke voorwaarde kan worden genegeerd omdat de score overtuigend lijkt.
De volledige analyse toont de interface, de video en hoe het mechanisme werkt. Wat volgt is de hardere les die ik heb getrokken uit het bouwen ervan: als een controlemechanisme een verkeerde handeling pas achteraf kan verklaren, kwam het te laat.
Wat ik dacht dat 0.83 betekende
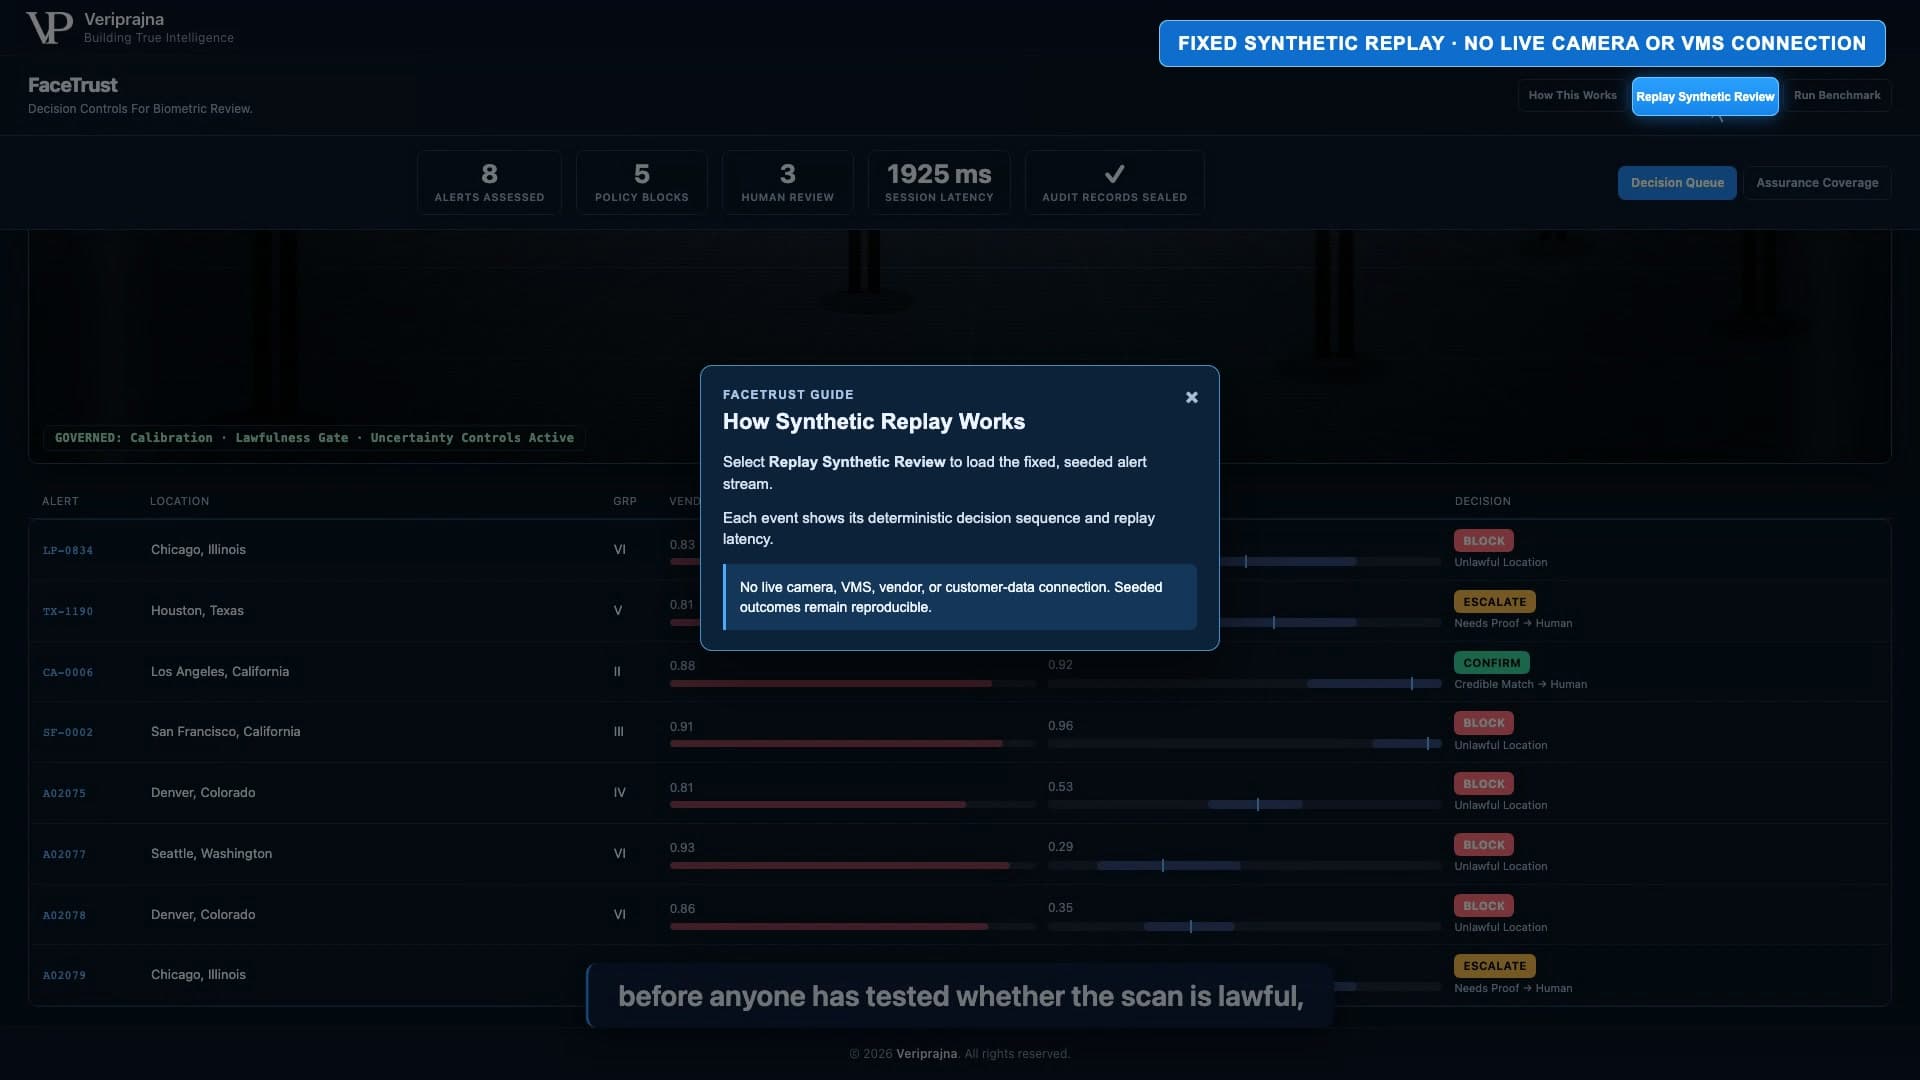
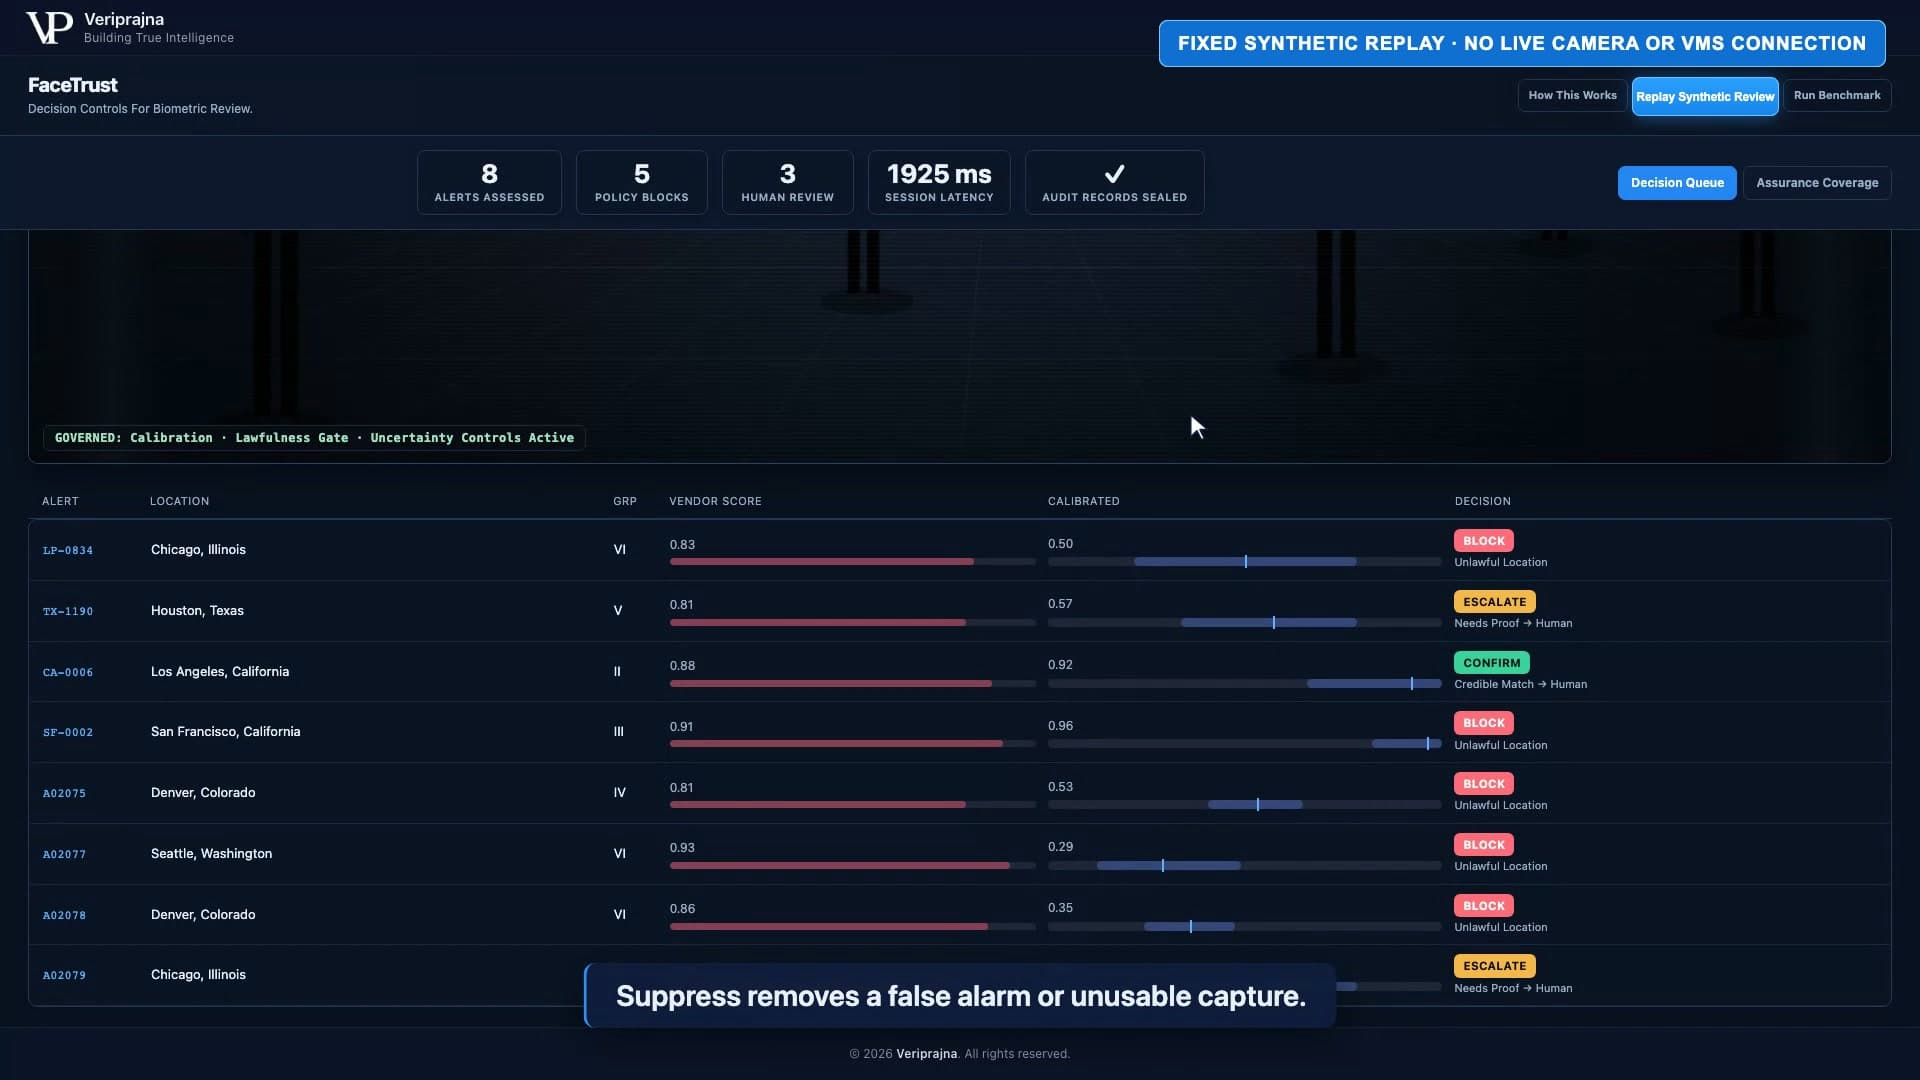
Ik begon bij het getal, omdat het oog daar van nature naartoe getrokken wordt. In de synthetische wachtrij staat LP-0834 naast andere meldingen met ruwe scores van 0.81 tot 0.91. In een oogopslag lijken ze variaties van hetzelfde fenomeen: sterke overeenkomsten die wachten op een operationele reactie. De wachtrij stimuleerde mijn eigen reflex om eerst te rangschikken en pas later vragen te stellen.
Die reflex is precies wat ik wilde onderzoeken. Een ruwe leveranciersscore is een invoerwaarde van een enkel herkenningssysteem. Het vertelt me niet of verzameling was toegestaan, of de opname toereikend was voor het voorliggende besluit, of dat de onzekerheid rond een gekalibreerd resultaat nog steeds een niet-overeenkomst omvat. Toch kan een score met twee decimalen afgerond aanvoelen. De visuele precisie loopt vooruit op het beslissingsgezag.
Ik vond de aangrenzende rijen verhelderend omdat ze me een gemakkelijke vuistregel ontzegden. TX-1190 draagt een ruwe score van 0.81 en leidt naar ESCALATE omdat het gekalibreerde bewijs onbeslist blijft. CA-0006 draagt 0.88 en leidt naar CONFIRM, wat betekent dat een getrainde beoordelaar actie mag ondernemen, niet dat het systeem automatisch iemand mag confronteren. SF-0002 draagt met 0.91 de hoogste ruwe score van de vier en leidt toch naar BLOCK omdat de ingestelde jurisdictietabel gezichtsherkenning in San Francisco als verboden markeert.
De rijen zijn opzettelijk synthetisch, maar de ontwerpvraag is tastbaar: welke informatie mag de score overrulen? Als het antwoord „niets“ is, is het omringende complianceproces puur decoratief. Als rechtmatigheid en onzekerheid de route kunnen wijzigen voordat een melding een operationeel team bereikt, is governance uitvoerbaar geworden.
Een hoge score kan bewijs versterken. Het kan geen toestemming creëren of een verbod opheffen.
Het moment waarop de score de controle verloor
Ik opende het dossier van LP-0834 in de verwachting dat het kalibratiepaneel de show zou stelen. De ruwe score van 0.83 daalt naar een gekalibreerde overeenkomstwaarschijnlijkheid van 0.50. Het interval strekt zich uit van 0.217 tot 0.783, en de voorspellingsset bevat beide mogelijke labels. Het bewijs ondersteunt geen zekerheid.
Vervolgens verschoof mijn aandacht omlaag naar de vaststelling omtrent toestemming. Dat is waar de route wordt beslecht. De opname telt 80 pixels en ligt daarmee boven de ondergrens van 72 pixels van de demo. De politiefoto is 15 jaar oud, wat het dossier registreert als controle- en auditnotitie, maar niet gebruikt als zelfstandige routeringspoort. Het ontbreken van toestemming is anders: het activeert BLOCK.
Ik worstelde meer met deze hiërarchie dan verwacht. Kalibratie is wiskundig fascinerend, en een interval voelt als het geavanceerde antwoord. Maar als ik het verhaal van onzekerheid laat domineren, riskeer ik te suggereren dat een gunstigere waarschijnlijkheid de scan zou kunnen redden. Het kan een ontbrekende randvoorwaarde niet herstellen. De deterministische beleidspoort moet de rechtmatigheid onafhankelijk van het modelvertrouwen beoordelen.
Dit veranderde de manier waarop ik het product aan mezelf uitlegde. FaceTrust demonstreert de Biometric Decision Firewall. Het is niet de zoveelste gezichtsherkenningsengine. Een leveranciersadapter normaliseert de melding, een lokale kalibrator drukt onzekerheid uit, en deterministische controles kiezen tussen BLOCK, SUPPRESS, ESCALATE en CONFIRM. De Compliance Reviewer kan een leesbare memo opstellen nadat die gestructureerde feiten bestaan, maar stuurt de route niet aan. In deze demo is die memo vooraf opgesteld en gecachet of afkomstig van een deterministische noodsjabloon.
Ik wilde dat de grens zichtbaar was omdat taalmodellen uitblinken in het genereren van coherent klinkende verklaringen. Een coherente memo is geen wettelijke grondslag. Advies hoort na de door controleerbare regels vastgelegde route te komen, niet ervoor als een overtuigend surrogaat.
Ik moest ophouden kalibratie als een vonnis te behandelen
Ik wilde telkens dat één gekalibreerde waarschijnlijkheid meer werk deed dan ze aankon. Dat was mijn haperende mentale model tijdens het bouwen: vervang een ruwe score door een betere score en gebruik die betere score als het besluit. LP-0834 doorbrak die kortere weg omdat het 0.50-resultaat nog steeds een interval, een voorspellingsset, een toestemmingscontrole, een jurisdictiecontrole en een menselijke procedure rondom elke toegestane actie vereiste.
De 93%-conforme voorspellingsset doet ertoe omdat deze de woordenschat van het systeem verandert. Wanneer de set zowel {mate, no_mate} bevat, comprimeert FaceTrust ambiguïteit niet tot een zelfverzekerd label. Het kan een rechtmatige maar onbesliste melding doorsturen naar ESCALATE. Wanneer bewijs een overeenkomst uitsluit, kan het SUPPRESS toepassen. Wanneer de set {mate} bevat, betekent een CONFIRM-route nog steeds actie door een getrainde beoordelaar, nooit automatische confrontatie, aanhouding of beschuldiging.
Ik schakelde over van de wachtrij naar het borgingsoverzicht omdat een enkel dossier dekkingsvragen niet kon beantwoorden. Op de deterministische synthetische testset van 3,000 meldingen behaalden de nominale 93%-conforme sets ten minste 91.5% empirische dekking over de zes geëvalueerde Fitzpatrick-groepen. Het minimum van de ruwe basislijn was 40.6%. De interface toont dekking over alle zes geëvalueerde Fitzpatrick-groepen.
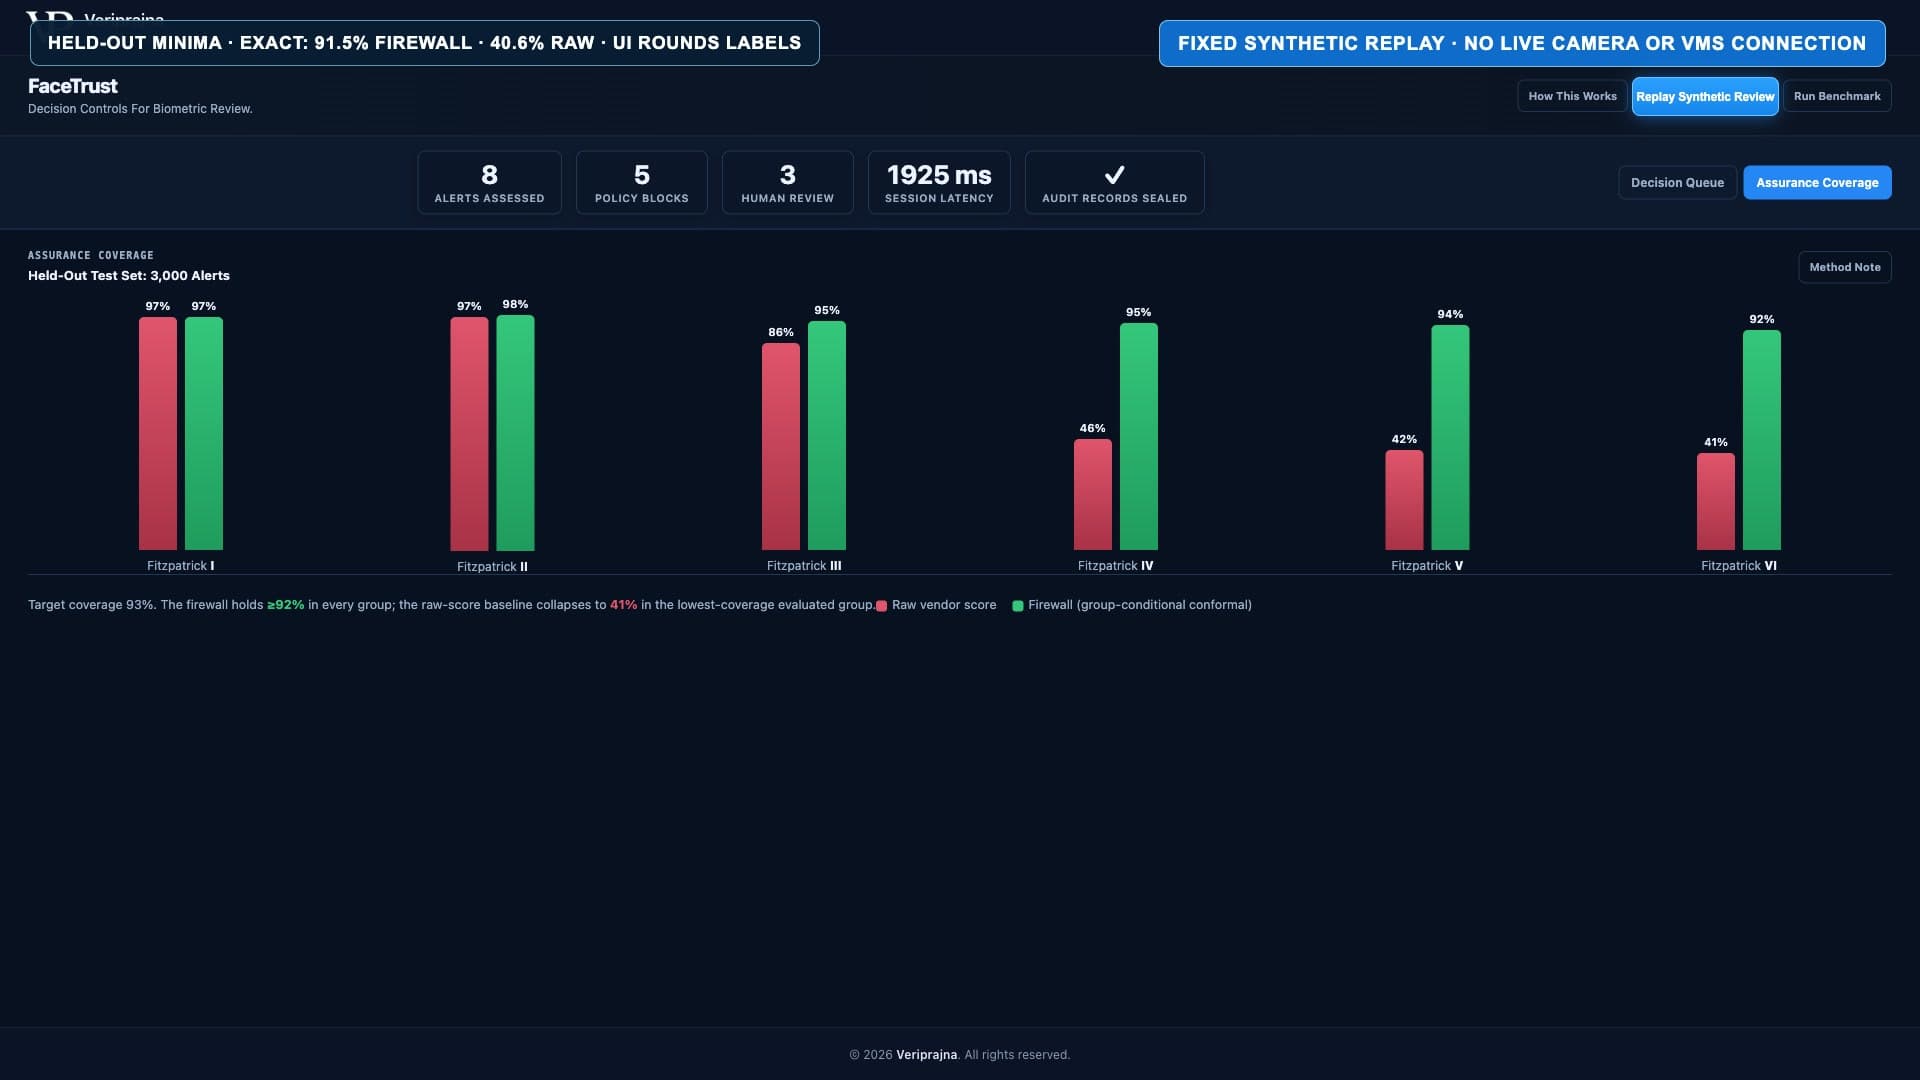
Die cijfers zijn geen productieclaims. De testset is synthetisch, ontworpen om gedocumenteerde faalmodi te modelleren, en een productie-kalibratie zou de beoordeelde geschiedenis van een klant vereisen. Ik voeg het resultaat toe omdat het toont wat ik moet inspecteren in plaats van een algemene score te bewonderen: de zwakste geëvalueerde groep, onder een vastgelegd testontwerp met expliciet afgebakend bereik.
De grafiek temperde ook mijn neiging om het nominale streefcijfer te vieren. Een doel van 93% betekent niet dat elke groep exact op 93% uitkomt, en het betekent zeker niet dat het systeem 93% accuraat is in de open wereld. De weergave biedt een dekkingsdiagnose, geen toestemming om te generaliseren buiten de synthetische testset.
Onzekerheid wordt pas nuttig wanneer de workflow anders mag handelen vanwege haar aanwezigheid.
De replay maakte de operationele kosten zichtbaar
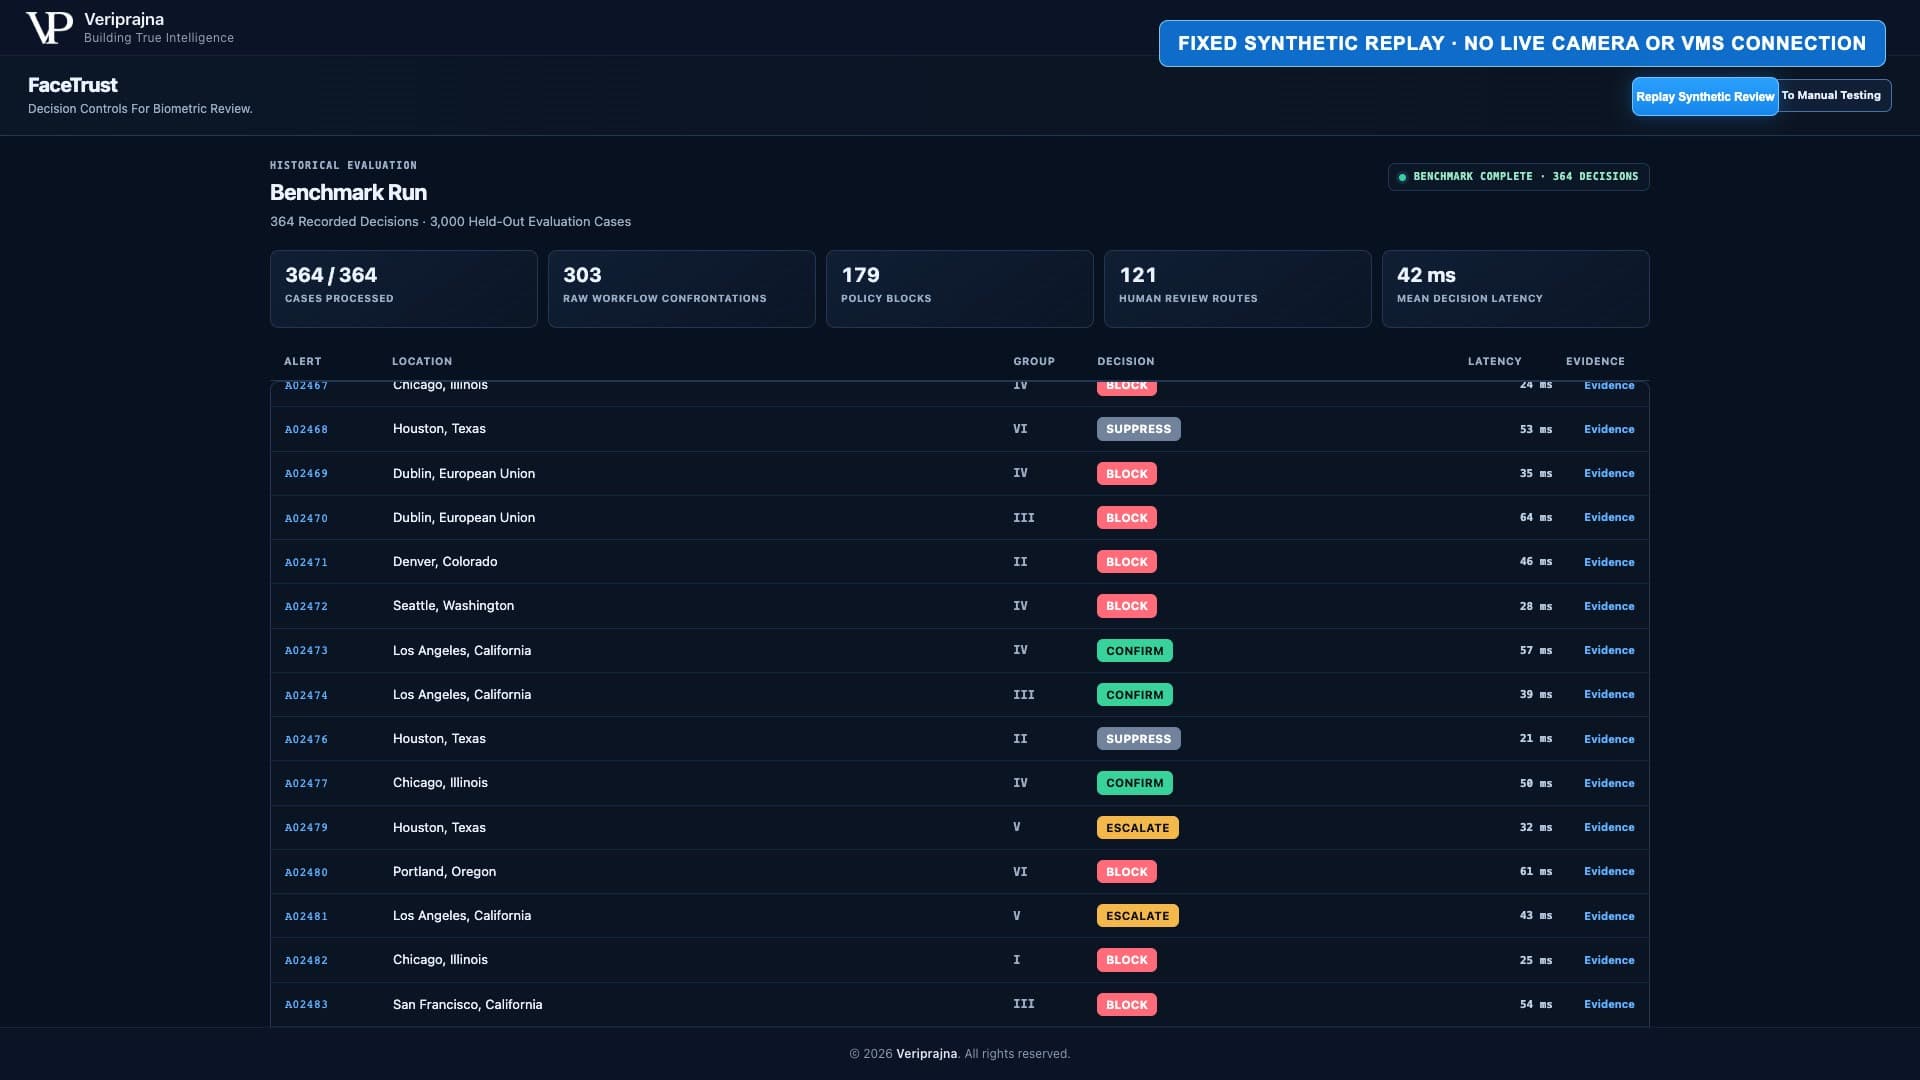
Ik draaide de vaste synthetische replay om te zien wat de hiërarchie op workflowschaal teweegbracht. Over de 364 meldingen heen zou de ruwe drempelwaarde 303 confrontaties opleveren. De firewall produceert in plaats daarvan 121 menselijke beoordelingsroutes en blokkeert 179 meldingen, een afname van 60.1% volgens de telmethode van deze replay. De reductie hoort bij deze gesimuleerde replay, niet bij een klantzitting of een productiebelofte.
Ik las het resultaat niet als „automatisering heeft meer afgehandeld“. Integendeel, de waarde van het ontwerp ligt in de weigering om het uiteindelijke menselijke gevolg te automatiseren. Het filtert verboden scans of scans zonder toestemming weg, onderdrukt ontlastend bewijs en plaatst onbesliste of aannemelijke gevallen in afgebakende menselijke beoordelingstrajecten. De operationele verschuiving beweegt van score-gestuurde dynamiek naar routespecifieke verantwoordelijkheid.
De testbenchmark vertelt een vergelijkbaar begrensd verhaal. Bij 1,566 synthetische niet-overeenkomsten (bedriegers) zou de ruwe basislijn tegen een tarief van 69.3% confronteren, terwijl het bevestigingspercentage van de firewall 3.8% bedraagt, een vermindering van 94.5% volgens die definitie. Bij 1,434 synthetische werkelijke overeenkomsten blijft het doelwit in 93.1% van de gevallen in de voorspellingsset van de firewall, vergeleken met 99.3% voor de ruwe drempelbasislijn. De vergelijking legt een wisselwerking bloot: meer ware overeenkomsten behouden is gemakkelijk als het systeem bereid is om op aanzienlijk meer bedriegers actie te ondernemen.
Die afweging veranderde hoe ik „minder meldingen“ interpreteerde, wat op zichzelf een armzalig doel zou zijn. Een systeem zou de werklast kunnen verlagen door moeilijke gevallen willekeurig weg te gooien. Hier blijft de reden voor elke route gekoppeld: toestemming, jurisdictie, opname-ondergrens, gekalibreerde voorspellingsset of bewijsuitsluiting. De route is verklaarbaar omdat de invoergegevens voor de route expliciet zijn.
Dit is ook de reden waarom inschrijvingsleeftijd in de demo een contextuele waarschuwing blijft in plaats van een onafhankelijke poort. De 15 jaar oude politiefoto van LP-0834 is relevante context voor een beoordelaar en een audit. Doen alsof de demo een universele leeftijdsregel kent, zou een schijnzekerheid toevoegen die het programma en de implementatie niet rechtvaardigen.
Ik wilde dat de weigering elke inspectie doorstond
Ik opende de bewijsweergave na de replay en bekeek de route naast haar verslaglegging. LP-0834 eindigt niet als een gekleurd label. Elk besluit creëert een SHA-256 hash-geketend dossier, en de interface kan een printbaar HTML-auditdocument exporteren. De weigering bezit herleidbare herkomst.
Ik ben wantrouwig geworden tegenover systemen die alleen verklaarbaar zijn via een gegenereerde alinea. Een alinea kan de feiten samenvatten, maar kan niet bewijzen dat de route werd vastgesteld voordat de tekst werd geschreven of dat het onderliggende dossier niet stilletjes is vervangen. De hashketen maakt de beslissing niet uit zichzelf juist. Het maakt latere wijzigingen binnen de keten detecteerbaar en geeft een onderzoeker een stabiel artefact om te inspecteren.
Dat onderscheid houdt de auditclaim integer. Deze demo is geen compliance-certificering, juridisch advies of vervanging van juridisch raadslieden. Het maakt gebruik van een synthetische opzet, testadapters en gesimuleerde regelgevingstabellen. Het heeft geen verbinding met live camera's, VMS, leveranciersengines, NIST, levendheidsdetectie of klantgegevens. Het bewijst een mechanisme en een volgorde, geen uitkomst in productie.
Ik kan me toekomstige auditvragen levendig voorstellen: niet „laat me de memo zien“, maar „laat me zien wat het systeem wist, welke deterministische regel afging, wie verantwoordelijk bleef voor actie en of het dossier naderhand ongewijzigd bleef“. Het auditexhibitum is ontworpen voor die specifieke volgorde van vragen.
De vuistregel die ik overhield aan de bouw
Ik beschouw governance van gezichtsherkenning niet langer als een laag die pas begint nadat een match is uitgeroepen. Tegen die tijd heeft de melding al momentum gekregen. Iemand ziet een hoge score, het operationele proces start, en elke latere waarborg moet vechten tegen een schijnbaar voldongen feit.
Het LP-0834-scenario biedt mij een striktere regel: wettigheid moet worden geëvalueerd voordat bewijsvertrouwen een route mag autoriseren, en bewijsvertrouwen moet met onzekerheid worden geformuleerd voordat een mens wordt gevraagd te handelen. De getrainde beoordelaar blijft verantwoordelijk voor wat volgt op een CONFIRM- of ESCALATE-route. BLOCK en SUPPRESS moeten legitieme uitkomsten zijn, geen foutstatussen die wachten om te worden overschreven.
Dat is het inzicht achter de Biometric Decision Firewall. Softwareagenten kunnen leesbare adviezen opstellen, maar deterministische controles bepalen de route. De stapsgewijze handleiding en de volledige analyse laten zien hoe FaceTrust die scheiding zichtbaar maakt.
En als u het liever in actie ziet dan mijn beschrijving te lezen, is hier de volledige demonstratie van begin tot eind.
Ik begon met een score die krachtig genoeg leek om de aandacht op te eisen. Ik eindigde met een weigering gegrondvest op een ontbrekende randvoorwaarde, begrensd bewijs en een controleerbaar dossier. De meest verantwoorde beslissing in het systeem is soms degene die voorkomt dat de score een actie wordt.