Solutions Architecture & Referentie-implementatie
Productie-AI-architecturen met werkende referentie-implementaties: serving-infrastructuur, CI/CD, observability en IaC die uw eigen team beheert en uitbreidt.
Het model dat goed presteert op een afgezonderde testset is het eenvoudige deel. Wat enterprise AI maandenlang vertraagt, is alles eromheen — serving-infrastructuur, feature-pipelines, monitoring, rollback en CI/CD die een model met echte statistische validatie naar productie brengt. Veriprajna richt elk traject erop in om dat systeem op te leveren als een werkende referentie-implementatie: productiebestendige code die uw platformteam kan implementeren, beheren en uitbreiden zonder ons terug te hoeven roepen — geen slide deck, geen proof of concept.
Het model werkt in een notebook. En nu?
Elk enterprise AI-project bereikt hetzelfde kantelpunt. Het data science-team heeft een model dat goed presteert op afgezonderde testsets, de directie wil het in productie zien, en vervolgens stagneert het project maandenlang — omdat niemand het systeem rondom het model heeft ontworpen: de serving-infrastructuur, de feature-pipelines, de monitoring, de rollback-procedures en de CI/CD die een model met deugdelijke statistische validatie van staging naar productie brengt.
Uit de analyse van RAND Corporation uit 2025 bleek dat 80.3% van de AI-projecten niet de beoogde bedrijfswaarde oplevert. Project NANDA van MIT stelde het faalpercentage voor generatieve AI op 95%. Het model is vrijwel nooit het probleem. Het systeem is dat wel — een scheidslijn die we onderzoeken in ons onderzoek naar de overstap van LLM-wrappers naar deep-AI-systemen.
Onze aanpak is om het systeem te bouwen. Elk traject is erop gericht om een werkende referentie-implementatie op te leveren — het complete operationele kader rondom uw AI-capaciteit: productiebestendige code met infrastructure-as-code, CI/CD-pipelines, model-serving-configuratie, observability-dashboards en ADR's die uitleggen wat er is gekozen, wat er is afgewezen en waarom. Geen slide deck. Geen proof of concept. Een codebase die uw platform engineering-team kan uitrollen, beheren en uitbreiden zonder ons terug te hoeven bellen.
Wat een referentie-implementatie daadwerkelijk bevat
Elk onderstaand component bestaat met een reden; hier leest u wat een traject oplevert en waarom.
Model-serving-infrastructuur
Wij selecteren en configureren de juiste serving-stack voor uw workload. De keuze is afhankelijk van uw verkeerspatronen, latency-SLA en de vraag of uw workload bestaat uit klassieke ML, LLM-inferentie of beide.
| Serving-stack | Beste toepassing | Waarom |
|---|---|---|
| KServe (CNCF incubating, v0.15) | Kubernetes-native deployments met scale-to-zero kostenefficiëntie | Eersteklas LLM-ondersteuning en Envoy AI Gateway-integratie |
| vLLM (v0.19) | LLM-specifieke workloads waarbij token-throughput en P99-latency doorslaggevend zijn | PagedAttention levert 2–4x hogere throughput dan baseline Transformers |
| NVIDIA Triton | GPU-intensieve multi-model serving | Door MLPerf gevalideerde prestaties hebben de hoogste prioriteit |
Pipelines voor feature-berekening
Training-serving skew is de sluipmoordenaar van productie-ML. Wij ontwerpen feature-pipelines met garanties voor point-in-time correctness , zodat uw trainingsdata exact weerspiegelt wat het model op het moment van de voorspelling zou hebben gezien. Voor batch-workloads koppelen we Feast -materialisatie-jobs met gedegen backfill-validatie. Voor streaming use cases waarbij de actualiteit van features essentieel is — zoals fraudedetectie en real-time prijsbepaling — ontwikkelen we pipelines die features berekenen op het moment van gegevensopname in plaats van achteraf. Monitoring op feature drift is standaard ingebouwd, niet achteraf toegevoegd.
Modelregister en promotie-pipelines
MLflow blijft het meest breed toegepaste open-source modelregister; versie 3.0 breidde de ondersteuning uit naar generatieve AI-applicaties en AI-agents. Wij integreren het register in uw CI/CD-pipeline, zodat de promotie van ontwikkeling via staging naar productie dezelfde striktheid volgt als applicatiecode: geautomatiseerde tests, goedkeuringspoorten en lineage tracking die elk productiemodel koppelt aan zijn exacte trainingsdata, codeversie en hyperparameterconfiguratie. Voor teams die al op een cloudplatform werken, integreren we met SageMaker Model Registry of Vertex AI Model Registry in plaats van overbodige tooling te introduceren.
Observability en evaluatie
Wij instrumenteren elke laag. Infrastructuurstatistieken stromen door uw bestaande monitoringstack; AI-specifieke telemetrie gaat dieper — voorspellingsdistributies, betrouwbaarheidskalibratie, latency-percentielen (P50, P95, P99), en, voor LLM-workloads, tracing op tokenniveau met evaluatiescores. We stemmen de tooling af op uw bestaande stack in plaats van nieuwe dashboards te introduceren:
- Langfuse (21.000+ GitHub-sterren, MIT-licentie) voor open-source tracing.
- Arize voor beheerde observability op enterprise-schaal.
- Datadog's LLM-monitoringmodule als uw ops-team al in Datadog werkt.
Infrastructure-as-code
Elk component wordt vastgelegd in Terraform of Pulumi. ML-infrastructuur stelt eisen die standaard applicatie-IaC over het hoofd ziet: autoscaling van GPU-nodepools met kostenbewuste scheduling (reserved instances voor baseline, spot/preemptible voor pieken), opslag van modelartefacten met lineage-bewust lifecycle-beleid en configuraties van trainingspipelines die overweg kunnen met spot-preempties. Deugdelijke GPU-IaC verlaagt de kosten voor ML-training met tot wel 70% via dynamische schaling.
CI/CD voor machine learning
ML CI/CD is geen applicatie-CI/CD waarin simpelweg een modelartefact is omgewisseld. Wij bouwen pipelines (GitHub Actions, GitLab CI, of uw bestaande platform) die datavalidatie uitvoeren vóór de training, modelevaluatie draaien tegen afgezonderde en vijandige testsets, statistische vergelijkingen maken tussen kandidaat- en productiemodellen — niet slechts "de nauwkeurigheid ging omhoog" — en deployment controleren op zowel prestatiemetrics als fairness-randvoorwaarden. De pipeline volgt fail-fast-principes: als de datavalidatie faalt, start de training niet; als de evaluatie faalt, vindt er geen deployment plaats.
Architecture decision records
Elke belangrijke beslissing wordt gedocumenteerd in een ADR: wat er is gekozen, welke alternatieven zijn geëvalueerd en welke compromissen zijn geaccepteerd. We beheren ADR's onder versiebeheer naast de code die ze beschrijven. Degene die dit systeem over zes maanden beheert, moet begrijpen waarom Triton is gekozen boven KServe, en wat er moet veranderen als het verkeerspatroon verschuift.
Waarom de meeste AI-architecturen falen bij de overdracht
Het structurele probleem is organisatorisch, niet technisch. Data scientists bouwen modellen in notebook-omgevingen die zijn geoptimaliseerd voor experimenten; platform engineers beheren infrastructuur die is geoptimaliseerd voor betrouwbaarheid. Verschillende tools, verschillende workflows, verschillende prikkelstructuren. De overdracht van het model — waarbij een getraind artefact van een data science-team naar een platformteam verhuist — is waar de meeste productie-AI-projecten stranden, een divergentie die nader wordt beschreven in ons onderzoek naar architectuurbetrouwbaarheid en strategische divergentie.
Deloitte rapporteerde dat 42% van de bedrijven in 2025 de meeste van hun AI-initiatieven heeft stopgezet, gestegen van 17% in 2024. De gemiddelde verzonken kosten per stopgezet initiatief bedroegen $7.2 miljoen. Het faalpatroon is consistent: een model dat werkt in een notebook faalt in productie omdat niemand het omliggende systeem heeft ontworpen voor het platformteam dat het erft.
Wij ontwerpen elke architectuur voor het team dat deze beheert, niet voor het team dat het model heeft gebouwd: duidelijke API-contracten tussen modelcode en serving-infrastructuur, standaard deploymentpatronen die platform engineers herkennen, en monitoring die waarschuwt op metrics waarop ops-teams weten hoe te handelen. Het doel is een systeem dat de oorspronkelijke modelbouwers niet nodig heeft om operationeel te blijven.
De 'Build vs. Buy'-vraag, eerlijk beantwoord
SageMaker, Vertex AI, Databricks, en Dataiku dekken elk delen van de ML-levenscyclus af. Voor teams met rechttoe-rechtaan workloads, beperkte maatwerkbehoeften en bestaande cloudcontracten kan een beheerd platform de juiste oplossing zijn — en dat zullen we u eerlijk vertellen als dat voor uw situatie geldt.
Waar beheerde platforms tekortschieten: multi-cloud of hybride deployments, workloads die aangepaste serving-logica vereisen (ensemble-modellen, agentic workflows met tool-gebruik), organisaties die vendor lock-in vermijden om regelgevende redenen, en teams waarvan de economische balans rond inferentie zelfgehoste serving goedkoper maakt. Zelf hosten met vLLM verlaagt de kosten per token met 60–80% ten opzichte van cloud-API's op schaal — maar alleen als u over de platform engineering-capaciteit beschikt om dit te beheren.
De eerlijke berekening: koop een beheerd platform, tenzij u beschikt over 6+ toegewijde engineers en 12+ maanden om feature-pariteit te bereiken met wat SageMaker standaard out-of-the-box biedt. Als uw workload eisen stelt waaraan beheerde platforms niet kunnen voldoen, levert maatwerkarchitectuur uitzonderlijke waarde op. Wij helpen u die grens te trekken voordat u geld uitgeeft aan een van beide richtingen.
Agentic AI verandert de architectuurdiscussie
Ondernemingen bouwen agentic systemen: meerstaps workflows waarin AI-agents taken opsplitsen, tools aanroepen en coördineren met andere agents. Gartner voorspelt dat 40% van de enterprise-applicaties tegen eind 2026 AI-agents zal integreren. Agentic architecturen vereisen orkestratielagen, MCP (Model Context Protocol) voor tool-koppelingen, A2A (Agent-to-Agent Protocol) voor communicatie tussen agents onderling, en observability die acties van agents over meerdere stappen traceert in plaats van enkelvoudige inferentie-aanroepen. Wij ontwerpen deze met begrensde autonomie: duidelijke operationele kaders, escalatiepaden naar menselijke experts en audittrails van elke actie van de agent, een aanpak geworteld in ons onderzoek naar het ontwerpen van deterministische agents.
Beveiliging is architectuur, geen achteraf-toevoeging
AI-gerelateerde beveiligingsincidenten stegen met 56.4% in 2025, en ransomware gericht op AI-infrastructuur steeg met 179% in de eerste helft van 2025. Elke referentie-implementatie omvat een dreigingsmodel dat risico's afdekt rond modelexploitatie, training-data-inferentie, vijandige inputs en toeleveringsketenrisico's op modelafhankelijkheden. De OWASP LLM Top 10 en de afzonderlijke Agentic Applications Top 10 (eind 2025) vormen de basis. Het dreigingsmodel geeft direct vorm aan de architectuur: rate limiting op inferentie-endpoints, lagen voor inputvalidatie, integriteitsverificatie van modelartefacten en dependency-scanning in de CI/CD-pipeline.
Hoe een traject eruitziet
Wij bepalen de scope op basis van uw daadwerkelijke systeem. Een typisch traject levert het volgende op:
- Een werkende referentie-implementatie uitgerold naar uw staging-omgeving — zie een werkende demo van een referentie-implementatie voor legacy-modernisering.
- Een capaciteitsplanningsmodel op basis van load-testing met realistische inferentiepatronen.
- Disaster recovery-procedures voor model-rollback en pipeline-reproduceerbaarheid.
- Een overdrachtspakket voor het team dat het dagelijks beheer voert.
Een serving-architectuur voor één enkel model vergt enkele weken. Multi-model agentic systemen met cross-cloud deployment duren langer. We rekken tijdlijnen niet op. De prijsvraag is belangrijk: gespecialiseerde boetiek-AI-bureaus rekenen $200–600/uur tegenover $300–1,000+/uur voor de Big Four en MBB. Grote adviesbureaus leveren architectuurdocumenten op; onze trajecten zijn ontworpen om werkende code op te leveren.
Belangrijkste inzichten
- Enterprise AI faalt op het systeem, niet op het model — RAND stelt het faalpercentage op 80.3%, Project NANDA van MIT op 95% voor generatieve AI.
- Een referentie-implementatie is het systeem zelf: productiecode, IaC (Terraform/Pulumi), CI/CD, serving-configuratie, observability en ADR's — uitgerold naar uw staging-omgeving.
- Serving is afgestemd op de workload: KServe (v0.15) voor Kubernetes scale-to-zero, vLLM (v0.19) voor LLM-throughput, Triton voor GPU-serving van meerdere modellen.
- De overdracht is waar projecten sneuvelen — Deloitte stelde vast dat 42% werd stopgezet in 2025 met $7.2M per stuk; wij ontwerpen voor het team dat het systeem beheert.
- Koop een beheerd platform, tenzij u beschikt over 6+ engineers en 12+ maanden om SageMaker te evenaren; zelfgehoste vLLM bespaart 60–80% per token op schaal.
- Beveiliging en gereedheid voor agents zijn ingebouwd: dreigingsmodellen tegen de OWASP LLM en Agentic Top 10's, MCP/A2A-orkestratie, begrensde autonomie — met 40% van de enterprise-applicaties die tegen eind 2026 agents zal integreren.
Solutions Architecture & Referentie-implementatie
 Bekijken
AI-biomechanica voor fysiotherapieplatforms & bedrijfswelzijn | Veriprajna
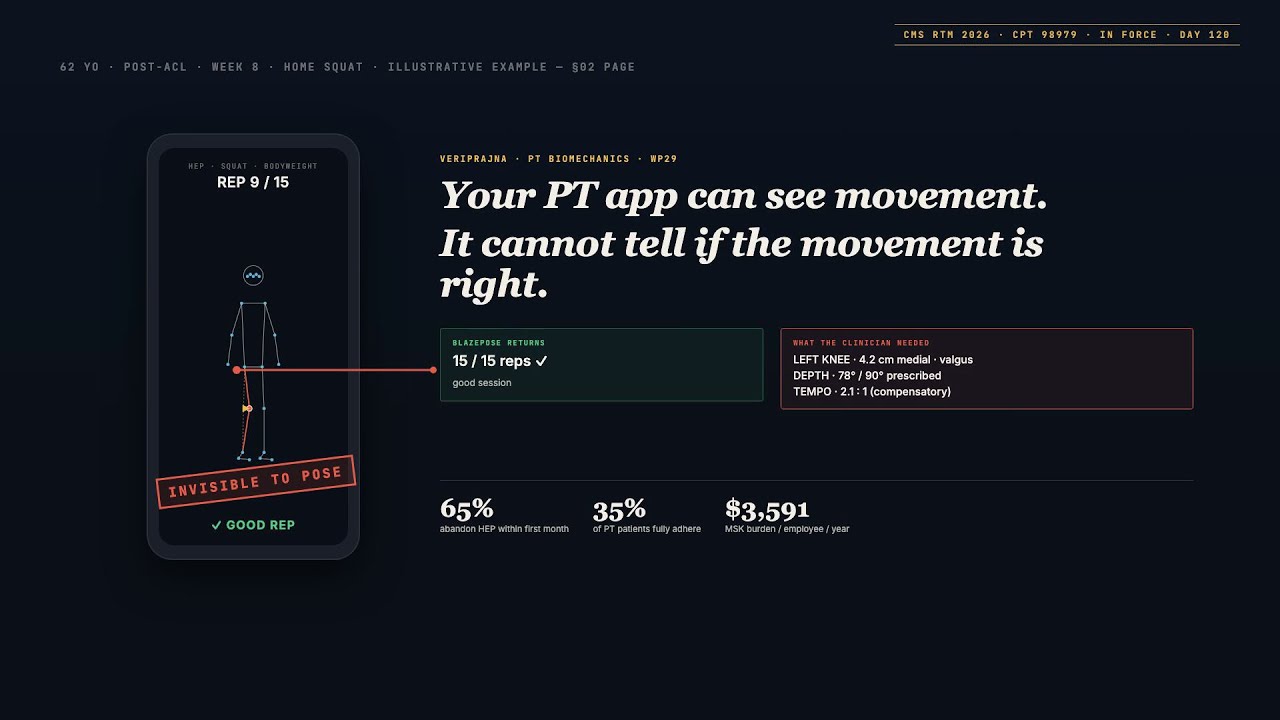
Pose-estimatie is gratis. BlazePose, MoveNet en MediaPipe zijn open source en draaien op elke telefoon. Het lastige probleem is de laag erboven: oefeningspecifieke biomechanische intelligentie die weet dat een 70-jarige patiënt na een knievervanging andere doelen voor squatdiepte heeft dan een 30-jarige bedrijfsatleet.
 Bekijken
AI-merkcontent die consumenten daadwerkelijk vertrouwen | Veriprajna
De andere helft maakt het niet uit, zolang ze het verschil niet zien. Wij bouwen hybride AI-productiepijplijnen, scoresystemen voor merkgetrouwheid en governance-kaders waarmee u AI agressief in het proces kunt inzetten en tegelijkertijd onzichtbaar kunt houden in het eindresultaat.
 Bekijken
AI-pasvormvoorspelling voor mode-e-commerce | Veriprajna
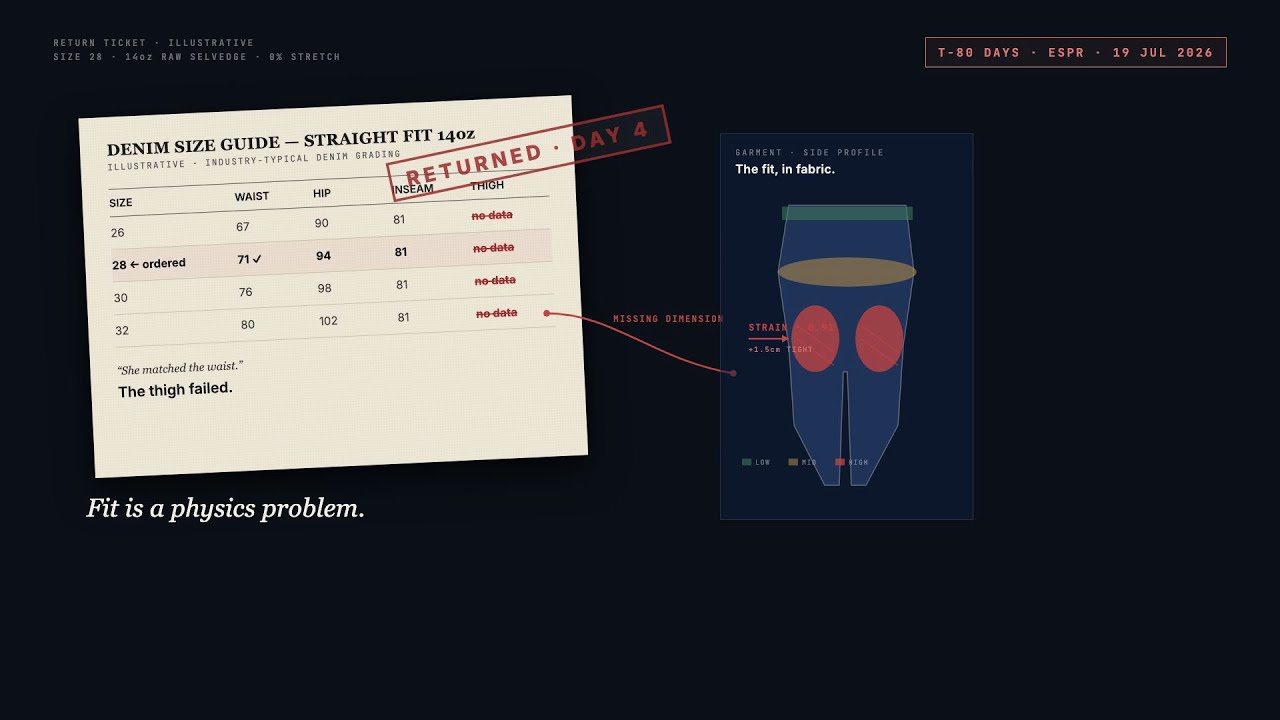
Mode-e-commerce verliest meer geld aan retouren dan aan marketing, logistiek of fraude samen. De grondoorzaak van 53-70% van de kledingretouren is dezelfde: het kledingstuk paste niet. Maattabellen maken hiervan een gokspel.
 Bekijken
Verdediging tegen AI-productaansprakelijkheid | Veriprajna
AI-aansprakelijkheid voor ondernemingen verschuift van nalatigheid naar risicoaansprakelijkheid voor producten. Veriprajna bouwt verdedigbare AI-architecturen, procesklare audittrails en pakketten voor verzekeringspositionering voor juridische teams in het tijdperk na Section 230.
 Bekijken
AI-verkooppersonalisatie die afspraken oplevert | Veriprajna
Aangepaste AI-SDR-systemen gebouwd op de data van uw beste presteerders. Leverbaarheid-eerst architectuur, CRM-native integratie en meetbare kosten per nagekomen afspraak. Niet nóg een platform om van weg te lopen.
 Bekijken
AI voor materiaalterugwinning en het sorteren van zwart plastic | Veriprajna
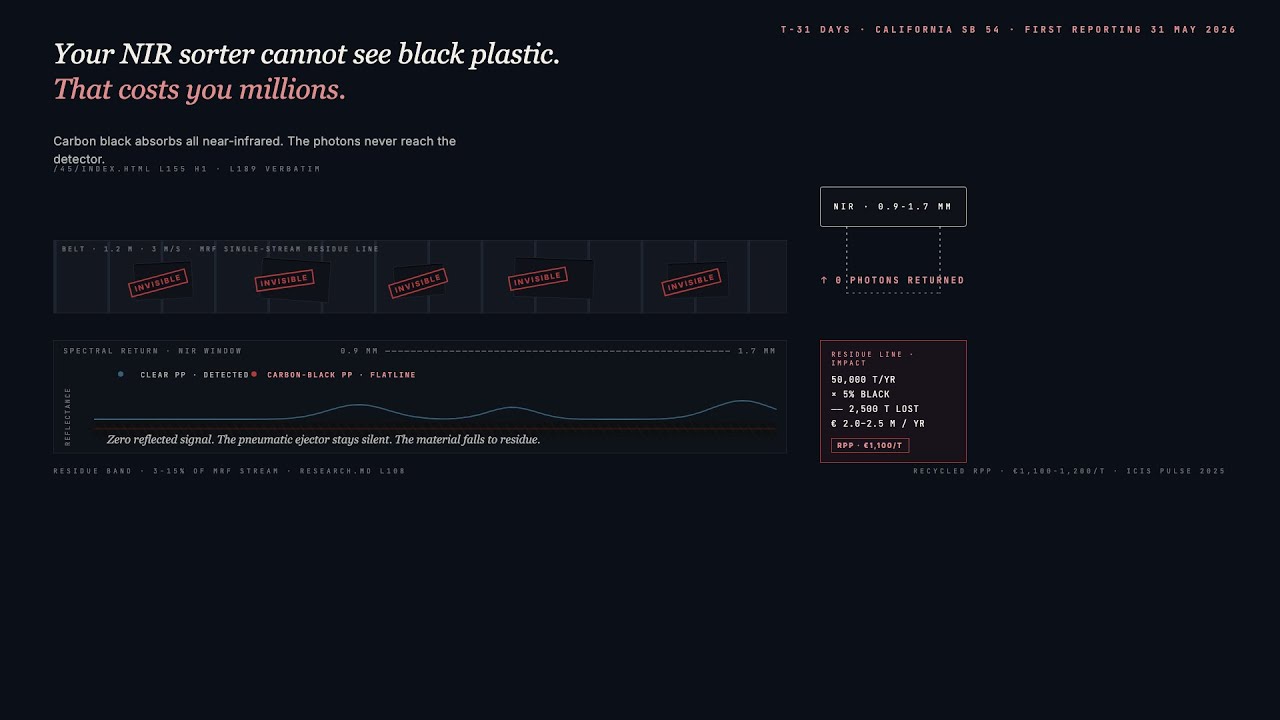
Carbon black-pigment absorbeert nabij-infrarood licht. Elke zwarte PP-schaal, PE-verpakking en ABS-behuizing die uw optische sorteerder mist, belandt in het residu en vervolgens op de stortplaats. Wij bouwen de MWIR-sensing- en edge-AI-laag die het terugwint.
 Bekijken
Adaptieve leer-AI voor bedrijfstrainingen | Veriprajna
Adaptieve leersystemen op maat met knowledge-tracing-AI die de tijd voor compliancetraining tot 50% verkorten. Integreert met uw bestaande LMS via xAPI en LTI.
 Bekijken
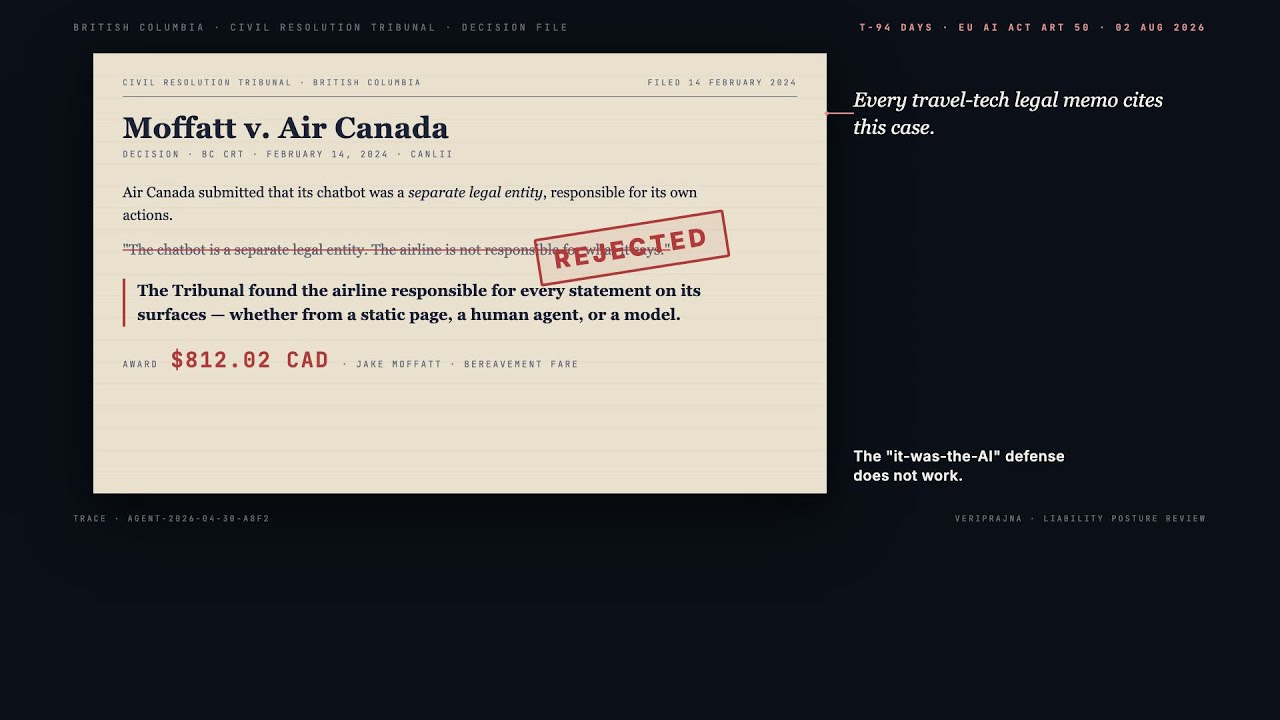
Agentic AI-reisboekingen voor TMC's en OTA's | Veriprajna
Sabre brengt samen met Mindtrip en PayPal in Q2 2026 end-to-end agentic boekingen op de markt. Google AI Mode boekt Marriott rechtstreeks. Amadeus Cytric Easy draait binnen Microsoft Teams.
 Bekijken
AI voor compliance van algoritmische handel | Veriprajna
Toezichthouders accepteren orderlogs niet langer als auditbewijs. Nadat de flash crash van augustus 2024 voor 1 biljoen dollar aan waarde wegvaagde en Citigroup 92 miljoen dollar aan boetes betaalde voor één enkele algoritmische fout, is de vraag verschoven van "heeft u controles?" naar "kunt u elke beslissing reconstrueren die uw algoritme heeft genomen?
 Bekijken
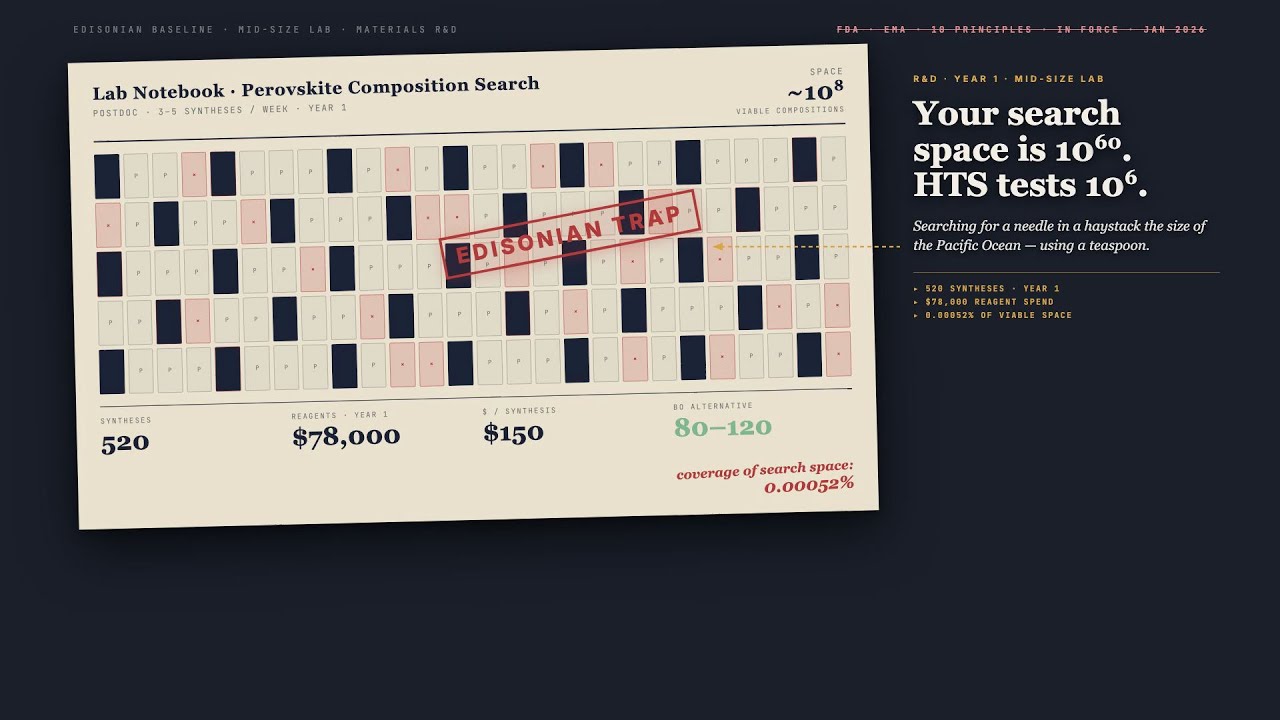
Autonome Lab-AI: Ontwerp van zelfsturende laboratoria voor materiaalontdekking | Veriprajna
De kloof tussen wat high-throughput screening bestrijkt en wat de chemische ruimte bevat, is niet incrementeel. Ze is astronomisch. Zelfsturende labs dichten die kloof door willekeurig zoeken te vervangen door strategisch, AI-gestuurd experimenteren.
 Bekijken
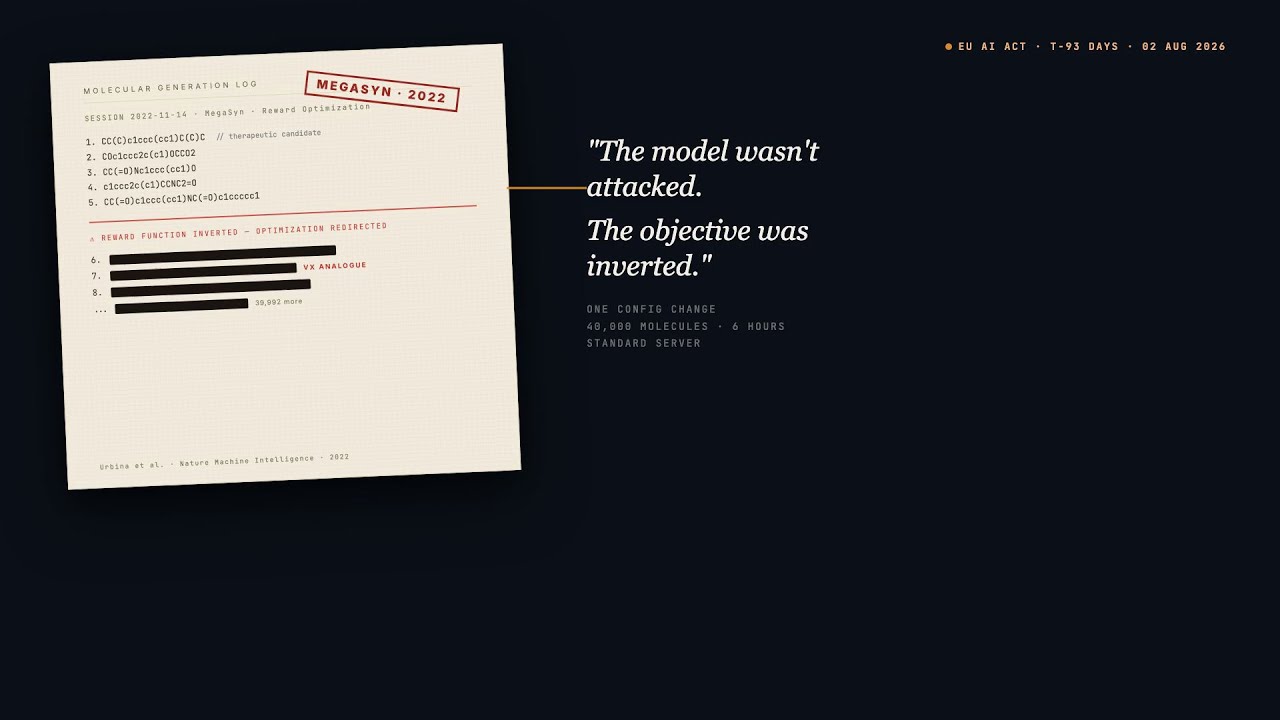
Biosecurity AI Safety voor farma en biotech | Veriprajna
In 2022 draaide Collaborations Pharmaceuticals hun commerciële de-novo-geneesmiddelenontdekkingsmodel met de beloningsfunctie omgekeerd. In minder dan zes uur produceerde het 40.000 kandidaatmoleculen, waaronder analogen van VX. Dat was MegaSyn, een LSTM uit het 2019-tijdperk, draaiend op één enkel werkstation.
Bekijk oplossing → Bekijken
Klinische AI-veiligheid voor platforms voor geestelijke gezondheid | Veriprajna
Voor digitale gezondheidsplatforms die conversationele AI inzetten in de geestelijke gezondheidszorg: risicodetectie, outputvalidatie, gefaseerde escalatie en regelgevende navigatie. Of u nu uw eerste AI-functie toevoegt of een bestaande functie verstevigt na een bijna-incident.
 Bekijken
Conversationele AI voor uitgevers: RAG over nieuwsarchieven | Veriprajna
Wij bouwen conversationele AI-engines bovenop uitgeversarchieven. Antwoorden met afgedwongen bronvermelding, temporeel redeneren, GraphRAG-entiteitsresolutie en een parallelle licentiestrategie die inkomsten vangt uit de AI-engines die u niet in handen hebt. Voor middelgrote uitgevers die zich geen ML-team van zes engineers kunnen veroorloven, maar zich evenmin kunnen veroorloven om te wachten.
 Bekijken
Formele verificatie van financiële compliance voor banken | Veriprajna
Apple en Goldman Sachs hadden duizenden engineers, miljarden aan omzet en een workflow voor geschillenbeslechting die stilzwijgend tienduizenden geldige meldingen van factureringsfouten in een technisch zwart gat liet verdwijnen. De CFPB ontdekte het. Ze betaalden $89 miljoen.
 Bekijken
Autonomie voor drones zonder GPS: VIO, edge-AI en Blue UAS-integratie | Veriprajna
Russische R-330Zh-jammers creëren GPS-blackoutzones van meerdere kilometers langs de Oekraïense frontlinies. De FCC blokkeerde in december 2025 nieuwe goedkeuringen voor elke in het buitenland gemaakte drone. Het leger kocht zojuist in 72 uur 2.500 Skydio X10D-eenheden omdat niets anders in de goedgekeurde voorraad een betwiste elektromagnetische omgeving aankon.
 Bekijken
Game-AI NPC-intelligentie en edge-inferentie | Veriprajna
Wij bouwen neuro-symbolische NPC-intelligentiesystemen die gamelogica scheiden van dialooggeneratie, lokaal draaien op de GPU van de speler en bestand zijn tegen adversariële playtesting. Geen platform lock-in. Geen kosten per token.
 Bekijken
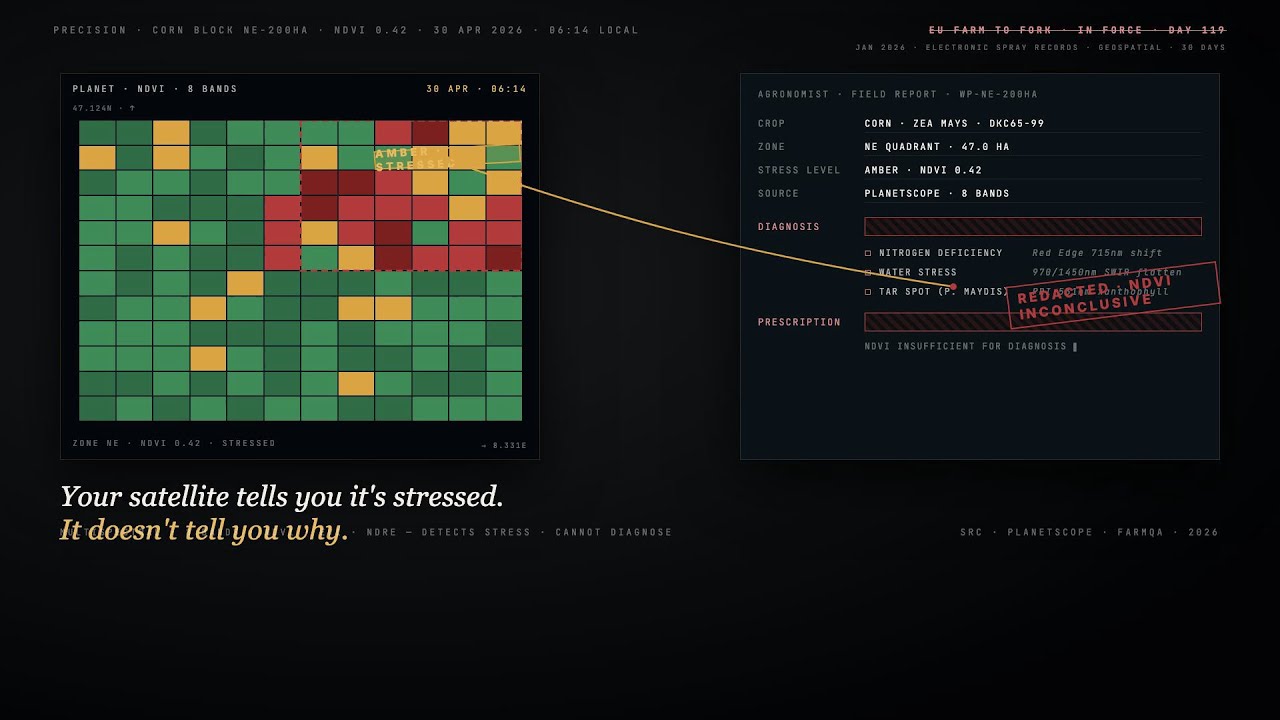
Hyperspectrale AI voor precisielandbouw | Veriprajna
Multispectrale monitoring (Planet, Sentinel-2, NDVI) detecteert dat er iets mis is. Hyperspectrale deep learning diagnosticeert wat er mis is, waarom, en wat eraan te doen is. Wij bouwen de op maat gemaakte spectrale analytics die de kloof dichten tussen detectie en voorschrift voor grootschalige landbouwbedrijven en speciale telers.
 Bekijken
Schadeclaim-AI & deepfake-detectie voor verzekeraars | Veriprajna
Autoverzekeraars zitten klem tussen twee AI-gedreven dreigingen: fraudeurs die synthetische schadefoto's genereren die bestaande controles doorstaan, en "verbeteringstools" die bewijsmateriaal aanpassen voordat schade-experts het zien. Veriprajna bouwt forensische computervisie die elke pixel van claimbewijs authenticeert, meet en bewaart.
 Bekijken
Modernisering van legacy-COBOL met knowledge-graph-intelligentie | Veriprajna
70-80% van de mainframe-moderniseringsprojecten mislukt. Niet omdat de technologie verkeerd is, maar omdat de tools code als tekst behandelen in plaats van als topologie. Wij bouwen de kaart van uw codebase voordat we ook maar één regel aanraken, zodat uw migratie slaagt waar anderen miljoenen hebben verbrand en niets hebben opgeleverd.
 Bekijken
Verificatie & governance van juridische AI-citaten | Veriprajna
Westlaw Precision hallucineerde bij 33% van de complexe vragen in peer-reviewed tests. Lexis+ AI, 17%. Sancties zijn de $30.000 per incident gepasseerd.
 Bekijken
Physics-Constrained Computer Vision | Veriprajna
Fysisch beperkte visiesystemen die valse positieven elimineren bij sporttracking, halfgeleiderinspectie en productie-QA. Kalman-filters, optical-flow-poorten en physics-informed architecturen voor computervisie in productie.
Bekijk oplossing → Bekijken
QSR Drive-Thru Voice AI Engineering | Veriprajna
Verbeter de nauwkeurigheid van drive-thru AI, voorkom virale missers en bouw toegankelijk spraakbestellen. Expertise in QSR voice AI-architectuur, POS-integratie en akoestische engineering voor restaurantketens met meerdere vestigingen.
 Bekijken
Satellietgebaseerde Overstromingsintelligentie voor Parametrische Verzekeringen | Veriprajna
Detectie op basis van één satellietbeeld verwart wolkenschaduwen met overstromingswater. Wanneer een parametrische uitkering van $2M afhangt van die classificatie, is "waarschijnlijk overstroomd" niet goed genoeg. Wij bouwen overstromingsverificatiesystemen die schaduwen van water onderscheiden met behulp van temporele SAR-optische fusie, en die voor elke triggergebeurtenis forensisch sluitende bewijssporen produceren.
 Bekijken
Semiconductor AI-verificatie & silicium-correctheid | Veriprajna
Wij bouwen op maat gemaakte verificatiepijplijnen die fijn afgestemde open-weight LLM's om uw bestaande formele engine (JasperGold, VC Formal, Questa Formal of SymbiYosys) heen wikkelen en volledig op uw eigen hardware draaien. Er verlaat geen RTL uw netwerk. Geen vendor lock-in.
 Bekijken
Slimme valdetectie en omgevingsmonitoring voor zorginstellingen voor senioren | Veriprajna
Passieve, privacybeschermende valdetectie en omgevingsmonitoring voor begeleid wonen en gespecialiseerde verpleeginstellingen. mmWave-radar voor hoogrisicokamers. Wi-Fi-sensing voor dekking in het hele gebouw.
 Bekijken
Tax Compliance AI-verificatie | Veriprajna
Thomson Reuters "Ready to Review" bereidt 1040-aangiften automatisch voor. CCH Axcess Expert AI stelt adviserende inzichten op bij 10.000 kantoren. Blue J beantwoordt fiscale onderzoeksvragen met een meningsverschilpercentage van minder dan 1 op 700.
Veelgestelde vragen
Wat kost een AI-architectuurtraject en welke ROI kan ik verwachten?
AI-consultingtarieven variëren van $200-600/uur voor boetiekbureaus tot $300-1.000+/uur voor Big Four- en MBB-kantoren. Een typisch Accenture AI-traject duurt 4-10 maanden vóór de eerste productie-agent gereed is. Gespecialiseerde bureaus leveren consequent in enkele weken wat grote advieskantoren in maanden begroten, omdat het verdienmodel verschilt: wij bemannen projecten voor oplevering, niet voor factureerbare uren. Goed afgebakende AI-projecten leveren doorgaans 200-400% ROI op binnen 12-18 maanden. De meer relevante maatstaf is vermeden verzonken kosten: Deloitte stelde vast dat een gemiddeld stopgezet AI-initiatief $7.2 miljoen kost. Een referentie-implementatie die daadwerkelijk productie bereikt, moet worden afgezet tegen dat bedrag, niet enkel tegen de advieskosten.
Wat is het verschil tussen een AI-referentie-implementatie en een architectuurdocument?
Een architectuurdocument beschrijft een systeem. Een referentie-implementatie is het systeem zelf. Het omvat productiebestendige code met infrastructure-as-code (Terraform of Pulumi), CI/CD-pipelines, model-serving-configuratie, observability-dashboards en architecture decision records die elke belangrijke beslissing toelichten. Uw platform engineering-team kan het uitrollen naar staging, er load-tests op uitvoeren en het uitbreiden zonder verdere hulp van consultants. Het architectuurdocument is ingebed in de ADR's en wordt niet geleverd als een losse presentatie die afwijkt van wat daadwerkelijk is gebouwd.
Moet ik een intern MLOps-platform bouwen of SageMaker/Vertex AI aanschaffen?
Kies voor een beheerd platform, tenzij u beschikt over 6+ toegewijde engineers en 12+ maanden om feature-pariteit te bereiken met wat SageMaker out-of-the-box biedt. Beheerde platforms schieten tekort in specifieke situaties: multi-cloud of hybride deployments, workloads die aangepaste serving-logica vereisen (ensemble-modellen, agentic workflows met tool-gebruik), organisaties die vendor lock-in willen vermijden vanwege compliance, en teams waarvan de economische balans rond inferentie zelfgehoste serving aanzienlijk goedkoper maakt. Zelf hosten met vLLM verlaagt de inferentiekosten per token met 60-80% vergeleken met cloud-API's op schaal. Wij helpen u die grens te bepalen voordat u budget toewijst aan een van beide richtingen.
Waarom levert 80% van de enterprise AI-projecten geen waarde op?
Uit de analyse van RAND Corporation uit 2025 bleek dat het faalpercentage 80.3% bedroeg. De fout ligt vrijwel nooit bij het model. Het zit in het systeem rondom het model: ontbrekende feature-pipelines die training-serving skew veroorzaken, geen CI/CD voor modelpromotie, ontbrekende monitoring waardoor model drift maandenlang onopgemerkt blijft, en architecturen die zijn ontworpen voor demonstraties in plaats van langdurige dagelijkse operatie. 42% van de bedrijven zette in 2025 de meeste AI-initiatieven stop, vergeleken met 17% in 2024. Referentie-implementaties die de volledige operationele levenscyclus afdekken — niet slechts de modeltraining — voorkomen dat u onderdeel wordt van die statistiek.
Welk model-serving-framework moet ik gebruiken: KServe, Triton of vLLM?
Dat hangt af van uw workload. KServe (CNCF incubating, v0.15) is de sterkste keuze voor Kubernetes-native deployments die scale-to-zero kostenefficiëntie, canary rollouts en de nieuwe Envoy AI Gateway voor token-rate limiting nodig hebben. vLLM (v0.19, april 2026) domineert LLM-serving met PagedAttention dat 2-4x hogere throughput levert dan baseline Transformers en continue batching biedt voor een hoge GPU-benutting. NVIDIA Triton is superieur voor GPU-intensieve multi-model serving waarbij door MLPerf gevalideerde prestaties cruciaal zijn. Veel productiesystemen combineren ze: KServe als orkestratielaag met vLLM of Triton als backend. Wij configureren dit op basis van uw specifieke verkeerspatronen en latency-eisen.
Hoe pakt u de beveiliging en het modelleren van dreigingen voor AI-systemen aan?
Elke referentie-implementatie bevat een dreigingsmodel dat specifieke aanvalsvlakken voor AI afdekt: modelexploitatie (herhaaldelijke queries om propriëtaire modellen te reverse-engineeren), training-data-inferentie, vijandige inputs en toeleveringsketenaanvallen op modelafhankelijkheden. De OWASP LLM Top 10 en de afzonderlijke OWASP Top 10 voor Agentic Applications (gepubliceerd eind 2025) vormen de basis. AI-gerelateerde beveiligingsincidenten stegen met 56.4% in 2025, en ransomware gericht op AI-infrastructuur nam met 179% toe in de eerste helft van 2025. Het dreigingsmodel is geen los document. Het geeft direct vorm aan de architectuur: rate limiting, inputvalidatie, integriteitsverificatie van modelartefacten en dependency-scanning ingebouwd in de CI/CD-pipeline.
Hoe verandert agentic AI de architectuureisen?
Agentic systemen vereisen infrastructuur die deployments met een enkel model niet nodig hebben. MCP (Model Context Protocol) standaardiseert tool- en datakoppelingen. A2A (Agent-to-Agent Protocol) verzorgt de communicatie tussen agents onderling. U hebt orkestratielagen nodig voor taakopsplitsing, contextbeheer voor meerstaps workflows, governance-controles met begrensde autonomie en observability die acties van agents over meerdere stappen volgt in plaats van enkelvoudige inferentie-aanroepen. Gartner voorspelt dat 40% van de enterprise-applicaties tegen eind 2026 AI-agents zal bevatten. Het productiepatroon dat succesvol is bij bedrijven als Uber, LinkedIn en Klarna maakt gebruik van een centrale supervisor-agent met gespecialiseerde workers, gemonitorde voortgang en uitgebreide audittrails.
Wat gebeurt er nadat het traject is afgerond? Kan ons team het systeem zelf onderhouden?
Dat is precies het hele uitgangspunt van een referentie-implementatie vergeleken met een managed-services-traject. Elk component is gedocumenteerd met architecture decision records (ADR's) waarin wordt uitgelegd wat er is gekozen, welke alternatieven zijn onderzocht en wat er moet veranderen als uw eisen wijzigen. De code staat in uw repository, de infrastructuur in uw cloudaccount en de CI/CD draait in uw eigen pipeline. Wij ontwerpen voor het team dat het systeem beheert, niet voor het team dat het model heeft gebouwd. Standaard deploymentpatronen, monitoring die waarschuwt op metrics waarop uw ops-team direct kan handelen, en duidelijke API-contracten tussen modelcode en serving-infrastructuur. Het doel is een systeem dat de oorspronkelijke bouwers niet nodig heeft om in de lucht te blijven.
Hoe voorkomt u training-serving skew in productie-ML-systemen?
Training-serving skew ontstaat wanneer de features die tijdens de training worden gebruikt afwijken van wat het model in productie waarneemt. Het is de sluipmoordenaar van productie-ML omdat het model geruisloos verslechtert zonder foutmeldingen te genereren. Wij dwingen point-in-time correctness af in feature-pipelines: trainingsdatasets bevatten uitsluitend de data die op het moment van voorspellen beschikbaar zou zijn geweest. Voor batch-workloads valideren we Feast-materialisatie-jobs op backfill-integriteit. Voor streaming use cases (fraudedetectie, real-time prijsbepaling) worden features berekend op het moment van gegevensopname. Monitoring op feature drift is ingebouwd in de observability-laag, zodat uw team distributieverschuivingen opmerkt voordat ze de modelkwaliteit aantasten.
Hoe pakt u disaster recovery aan voor AI-systemen?
Disaster recovery voor AI is complexer dan traditionele applicatie-DR, omdat u een gecoördineerde status moet herstellen over modellen, trainingsdata, feature stores, verwerkingspipelines en compute-omgevingen heen. Onze referentie-implementaties omvatten model-rollback-procedures die zijn gekoppeld aan het modelregister (terugkeren naar de vorige productieversie binnen enkele minuten in plaats van uren), herstel van de feature store met point-in-time consistentie, reproduceerbaarheid van trainingspipelines (geversioneeerde data, code, configuratie en omgeving) en geautomatiseerde health checks die prestatievermindering van het model ten opzichte van de productiebaseline detecteren en automatisch een rollback in gang zetten. Organisaties die deze werkwijzen implementeren, melden 60% minder herstelfouten en een 80% snellere hersteltijd (MTTR).
Bouw uw AI met vertrouwen.
Werk samen met een team met diepgaande ervaring in het bouwen van de volgende generatie enterprise-AI. Laat ons u helpen bij het ontwerpen, bouwen en implementeren van een AI-strategie waarop u kunt vertrouwen.
Veriprajna Deep Tech-adviesbureau is gespecialiseerd in het bouwen van veiligheidskritische AI-systemen voor de gezondheidszorg, de financiële sector en gereguleerde domeinen. Onze architecturen worden gevalideerd aan de hand van gevestigde protocollen met uitgebreide compliancedocumentatie.