Beveiligingsbeoordeling & hardening
Wij breken in op AI-systemen zoals echte aanvallers dat doen en harden ze vervolgens tegen de gevonden aanvalspaden — van modelextractie tot compromittering van de toeleveringsketen.
Onze aanpak is om AI-systemen te breken zoals echte aanvallers dat doen, en ze vervolgens te harden tegen de aanvalspaden die een assessment blootlegt — van modelextractie tot compromittering van de toeleveringsketen. Traditionele penetratietests dekken uw API's, infrastructuur en authenticatieflows af, maar testen nooit of een aanvaller uw gefinetunede model kan stelen, een backdoor kan plaatsen in uw afhankelijkheidsketen of uw RAG-pipeline kan kapen. Die assessmentmethodologie moet specifiek worden gebouwd voor de manieren waarop AI-systemen falen.
Aanvalsoppervlakken die uw beveiligingsteam nog nooit heeft getest
Traditionele penetratietests dekken uw API's, uw infrastructuur en uw authenticatieflows af. Ze testen niet of een aanvaller uw gefinetunede model kan extraheren via 50,000 zorgvuldig gestructureerde queries. Ze detecteren niet of een vergiftigde LoRA-adapter in uw HuggingFace-afhankelijkheidsketen drie maanden geleden een backdoor heeft geïntroduceerd. Ze evalueren niet of uw RAG-pipeline instructies zal uitvoeren die zijn ingebed in een opgehaald document. Dit zijn de aanvalspaden die AI-systemen in productie daadwerkelijk compromitteren.
Dit zijn geen theoretische risico's uit conferentiepresentaties. Protect AI trof 352,000 verdachte bestanden aan in 51,700 modellen op HuggingFace in april 2025. Door AI mogelijk gemaakte aanvallen stegen met 89% op jaarbasis, waarbij 97% van de getroffen organisaties niet beschikte over elementaire toegangscontroles op hun AI-systemen. De Mercor-toeleveringsketenaanval begin 2026 compromitteerde duizenden bedrijven via één enkele opensource-afhankelijkheid.
Wat we daadwerkelijk testen — en wat de meeste assessments missen
We structureren assessments rond het MITRE ATLAS -framework, dat inmiddels 84 technieken over 16 tactieken catalogiseert die specifiek gericht zijn op AI-systemen. Maar een framework is een kaart, geen test. Onze methodologie is gebouwd om de gecatalogiseerde aanvallen daadwerkelijk uit te voeren, niet om ze alleen maar af te vinken.
LLM-implementaties en prompt injection
We testen indirecte prompt injection via elk opnamepad: RAG-retrieval, tool-outputs, door gebruikers geüploade documenten en e-mailinhoud die aan agents wordt gevoed. Directe injectie haalt de krantenkoppen, maar Anthropic liet zijn meetwaarde voor directe injectie in februari 2026 volledig vallen omdat indirecte injectie via retrievalcontext is wat productiesystemen daadwerkelijk breekt. We testen ook meerstapsmanipulatie, extractie van systeemprompts en de specifieke faalmodi van welke guardrail-stack u ook heeft ingericht.
Beveiliging op modelniveau
We beoordelen extractierisico door gestructureerde querycampagnes uit te voeren tegen uw API en te meten hoeveel modelgedrag een aanvaller kan repliceren. We evalueren adversariële robuustheid met zowel gradiëntgebaseerde methoden (wanneer we modeltoegang hebben) als transfergebaseerde black-box-aanvallen (hoe echte aanvallers te werk gaan). We auditeren uw trainingspipeline op kwetsbaarheden voor data poisoning, waarbij we zowel uw directe trainingsdata controleren als de upstream-afhankelijkheden die deze voeden (gedetailleerd beschreven in ons onderzoek naar het beschermen van ondernemingen tegen model poisoning).
Integriteit van de toeleveringsketen
We herleiden elk modelartefact naar de bron: vooraf getrainde gewichten, fine-tuning-datasets, adapterlagen en versies van serving frameworks. We controleren op bekende kwetsbaarheden in uw ML-infrastructuur — PyTorch, vLLM en Triton Inference Server hadden allemaal CVE's in 2025–2026 — en verifiëren dat uw model-serialisatie veilige formaten gebruikt. De miljard aan verliezen door gecompromitteerde ML-modellen in 2025 kwam overweldigend voort uit toeleveringsketenaanvallen, niet uit directe modelexploitatie (zie ons onderzoek naar het beveiligen van de levenscyclus van de ML-toeleveringsketen).
Agentic systemen
We testen het aanvalsoppervlak dat OWASP's Agentic AI Top 10 definieert: goal hijacking, misbruik van tools, identiteitsmisbruik, geheugenvergiftiging en trapsgewijze storingen over multi-agentworkflows. De OpenClaw-crisis in 2026 — waarin 21,000+ instanties van een AI-agent met 135,000 sterren werden blootgesteld aan kritieke kwetsbaarheden — toonde aan wat er gebeurt wanneer agents zonder deze tests worden uitgeleverd (gedetailleerd beschreven in ons onderzoek naar het beveiligen van de mens-AI-grens).
Hardening die verandert hoe uw systeem opereert
Een assessment zonder remediatie is een dure PDF. Onze aanpak bouwt de hardeningcontroles in uw systeem in.
- Verdediging op inferentielaag: detectie van query-anomalieën die verkeer met extractiepatronen identificeert — systematische inputdekking, grenstesten en programmatische parafrase-sweeps — en dit onderscheidt van legitiem gebruik. Pijplijnen voor inputvalidatie zijn afgestemd op uw specifieke dreigingsmodel, geen generieke regex-filters die semantische aanvallen missen en legitieme queries blokkeren.
- Hardening van de toeleveringsketen: modelverificatie-pijplijnen die de herkomst van artefacten controleren, serialisatieformaten valideren, scannen op bekende kwaadaardige patronen en ondertekeningsvereisten afdwingen voordat enig modelartefact uw deployment-pipeline binnengaat — plus monitoring van afhankelijkheden die gecompromitteerde upstream-pakketten onderschept voordat ze productie bereiken.
- Hardening van agentic systemen: privilegegrenzen rond toegang tot tools, outputvalidatie tussen agentstappen en gedragsmonitoring die detecteert wanneer het uitvoeringspatroon van een agent afwijkt van zijn verwachte workflow.
Uw SIEM is gebouwd om afwijkingen in menselijk gedrag te detecteren. Een agent die 10,000 queries achter elkaar uitvoert, ziet er voor die systemen volkomen normaal uit, zelfs wanneer deze onder controle van een aanvaller staat.
Wanneer u dit niet nodig heeft
Als u een beheerde API aanroept (OpenAI, Anthropic, Google) zonder fine-tuning, zonder RAG, zonder toolgebruik en zonder gevoelige data in prompts, bestaat uw beveiligingsrisico uit API-sleutelbeheer en gegevensverwerking. Een standaard beveiligingsbeoordeling voor applicaties dekt dat af — u heeft geen AI-specifiek assessment nodig.
Als uw model een eenvoudige classifier is die intern draait zonder extern gerichte API en zonder hertrainingspipeline, is uw aanvalsoppervlak beperkt en is een korte beoordeling van het dreigingsmodel proportioneel. Volledige tests op adversariële robuustheid voor een interne sentiment-classifier achter een firewall betekent het uitgeven van ,000 om een risico van te beschermen.
We zeggen dit ronduit omdat geloofwaardigheid belangrijker is dan omzet. De organisaties die dit werk nodig hebben, weten wie ze zijn: iedereen met gefinetunede modellen, RAG-pipelines die externe inhoud verwerken, agentic systemen met toegang tot tools, modellen in gereguleerde sectoren of AI-systemen die beslissingen nemen met financiële of veiligheidsconsequenties.
De regelgevende druk is reëel en kent deadlines
Handhaving van de EU AI Act begint augustus 2026. Hoog-risico AI-systemen vereisen gedocumenteerd risicobeheer, technische robuustheidstests en beheersmaatregelen voor datagovernance. Niet-naleving brengt boetes met zich mee tot 7% van de wereldwijde jaaromzet of EUR 35 miljoen. NIST publiceerde zijn Cybersecurity Framework Profile for AI in december 2025, waarin AI-specifieke risico's worden gekoppeld aan CSF 2.0-controles. Deze frameworks duiken nu op in inkoopvereisten en risicobeoordelingen op directieniveau.
De uitdaging is dat geen enkel framework alles dekt. We koppelen uw assessmentbevindingen aan de frameworks die uw toezichthouders, auditors en klanten vereisen — waarmee bewijsmateriaal wordt geleverd dat aan compliance-eisen voldoet omdat het voortkomt uit daadwerkelijke tests, niet uit afvinkoefeningen.
| Framework | Wat het biedt |
|---|---|
| MITRE ATLAS | Brengt aanvalstechnieken in kaart |
| OWASP LLM Top 10 | Categoriseert kwetsbaarheidsklassen |
| NIST AI RMF | Biedt governancestructuur |
| ISO 42001 | Behandelt managementsystemen |
| EU AI Act | Legt wettelijke verplichtingen op |
Platformtools versus maatwerk-assessment
Geautomatiseerde AI-beveiligingsplatforms (HiddenLayer, Mindgard, Giskard) voeren bekende aanvalspatronen op schaal uit. Ze zijn nuttig voor continue regressietests na een eerste assessment, maar vormen geen vervanging voor het initiële assessment zelf. Een scanner begrijpt uw bedrijfslogica niet, weet niet welke model-outputs veiligheidskritieke gevolgen hebben en kan niet evalueren of uw dreigingsmodel overeenkomt met uw daadwerkelijke deployment-architectuur.
We gebruiken deze tools waar ze meerwaarde bieden. Continue geautomatiseerde red teaming hoort thuis in uw CI/CD-pipeline zodra we hebben vastgesteld waarop getest moet worden. Maar de aanvalspaden die er in uw specifieke systeem het meest toe doen, vereisen iemand die zowel de AI-faalmodi als uw operationele context begrijpt om ze op te sporen.
Voor organisaties die meerdere AI-leveranciers gebruiken (OpenAI, Anthropic, Google, opensource-modellen), beoordelen we de beveiligingsgrenzen van elke provider onafhankelijk en testen we de integratiepunten waar data tussen hen stroomt. Het aanvalsoppervlak van een multi-vendor-stack is niet de som van het risico van elke leverancier — het is de interactielaag, waar aannames over de beveiligingsgaranties van de ene provider instorten bij de overdracht naar een andere.
Belangrijkste inzichten
- AI-systemen falen op manieren die standaard penetratietests nooit raken — modelextractie, vergiftigde LoRA-adapters, indirecte prompt injection en agentic goal hijacking.
- We testen over vier oppervlakken — LLM-implementaties, beveiliging op modelniveau, toeleveringsketen en agentic systemen — gestructureerd volgens MITRE ATLAS (84 technieken, 16 tactieken), maar gedreven door echte aanvallen, niet door checklists.
- Het assessment omvat remediatie: hardening op inferentielaag, toeleveringsketen en agentic systemen ingebouwd in uw systeem, niet geleverd als een PDF.
- We koppelen bevindingen aan MITRE ATLAS, OWASP LLM Top 10, NIST AI RMF, ISO 42001 en de EU AI Act — waarvan de handhaving begint in augustus 2026 met boetes tot 7% van de omzet of EUR 35 miljoen.
- Niet elke implementatie heeft dit nodig. Beheerde API's en eenvoudige interne classifiers hebben het niet nodig; gefinetunede modellen, RAG met externe inhoud, agents die tools gebruiken en gereguleerde of veiligheidskritieke AI wel.
Beveiligingsbeoordeling & hardening
 Bekijken
AI-toeleveringsketenbeveiliging & modelintegriteit | Veriprajna
Consultancy voor AI-toeleveringsketenbeveiliging. Wij bouwen modelkeuringspijplijnen, ML-BOM-architectuur en schaduw-AI-governance voor CISO's bij gereguleerde ondernemingen. Conform NIST AI 100-2 en de EU AI Act.
 Bekijken
Deepfakedetectie & preventie van videobelfraude voor ondernemingen | Veriprajna
In februari 2024 gebruikten aanvallers AI-gegenereerde deepfakes van een volledig directieteam om $25,6 miljoen te stelen van Arup tijdens één enkel videogesprek. Sinds januari 2026 sluiten standaard cyberverzekeringspolissen deepfakefraude expliciet uit.
 Bekijken
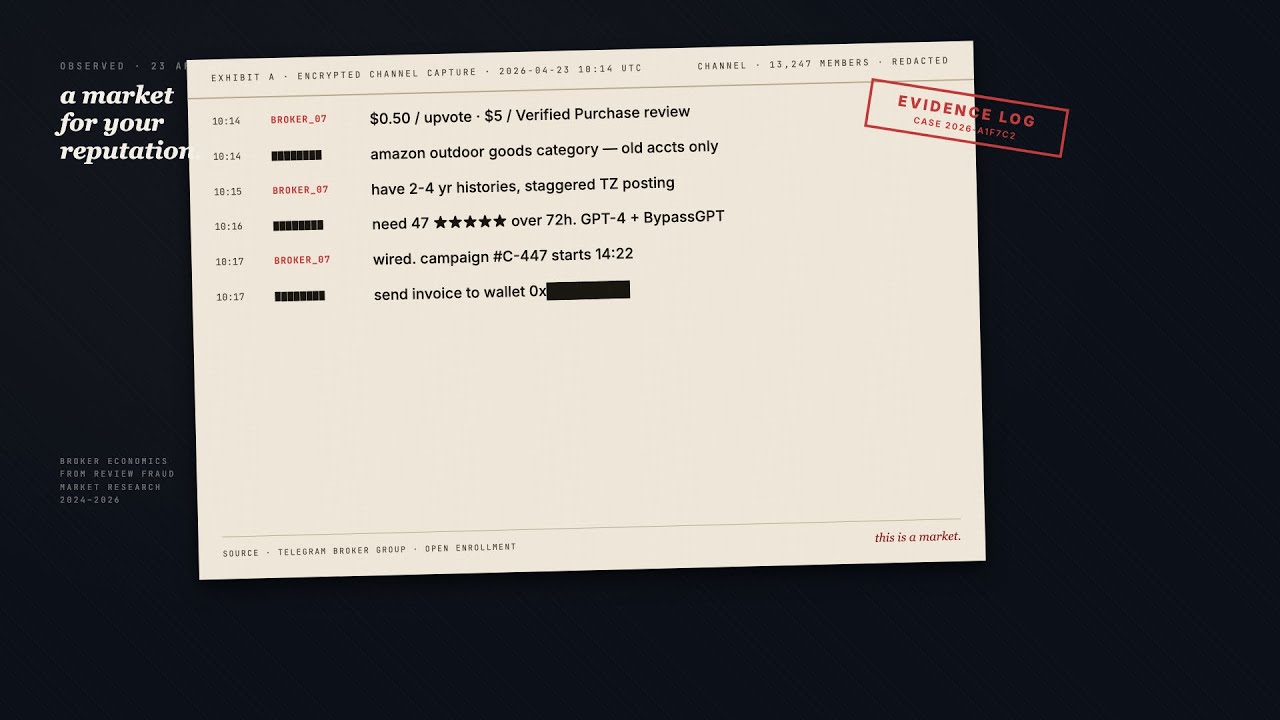
Synthetische content & detectie van nepreviews | Veriprajna
Op maat gemaakte AI-systemen die nepreviews, synthetische content en gecoördineerde fraude detecteren op elk platform waar uw merk verschijnt. Gebouwd voor de nieuwe handhavingsrealiteit van de FTC.
Veelgestelde vragen
Hoeveel kost een AI-specifieke beveiligingsbeoordeling?
AI-beveiligingsbeoordelingen variëren doorgaans van ,000 voor een afgebakende evaluatie van LLM-applicaties tot ,000+ voor een volledig red team-traject dat aanvallen op modelniveau, audits van de toeleveringsketen en tests van agentic systemen omvat. Vaste tarieven in het middensegment liggen tussen ,500-,500 per dag per consultant, terwijl toonaangevende specialistische bureaus ,000-,000 per dag vragen. De juiste omvang hangt af van uw deployment-architectuur: een beheerde API-aanroep zonder fine-tuning vereist aanzienlijk minder tests dan een gefinetuned model dat agentic workflows met toegang tot tools bedient.
Wat test een AI-beveiligingsbeoordeling dat een reguliere penetratietest niet test?
Traditionele penetratietests dekken API-endpoints, authenticatie, infrastructuur en applicatielogica af. AI-beveiligingsbeoordelingen voegen modelspecifieke aanvalsvectoren toe: het opstellen van adversariële input, modelextractie via gestructureerde querycampagnes, detectie van training data poisoning, prompt injection (zowel direct als indirect via RAG-retrieval), integriteit van de toeleveringsketen voor modelartefacten, en voor agentic systemen: goal hijacking, misbruik van tools en privilege-escalatie via workflows met meerdere stappen. Deze aanvalspaden vereisen een ML-specifieke methodologie die standaard pentest-frameworks niet behandelen.
Kan iemand ons gefinetunede model daadwerkelijk stelen via de API?
Ja. Modelextractie-aanvallen repliceren modelgedrag door systematisch query's uit te voeren. Voor gefinetunede classifiers kunnen enkele duizenden query's al een functioneel gelijkwaardige kopie opleveren. Voor grote taalmodellen is volledige extractie moeilijker, maar partiële extractie van fine-tuning-gedrag is haalbaar. Queryverkeer op scraping-niveau bereikte in 2025-2026 een mediaan van 20% van het wereldwijde API-verkeer. Verdedigingsmaatregelen omvatten analyse van querypatronen die verder gaat dan eenvoudige snelheidsbeperking, gedragsmatige fingerprinting van extractiepatronen en watermerken, hoewel huidige watermerkmethode kunnen worden verwijderd door parafrasering van de output.
Hebben we AI-beveiligingstests nodig voor compliance met de EU AI Act?
Als uw AI-systeem onder de EU AI Act kwalificeert als hoog risico: ja. Artikel 15 vereist technische robuustheid en cybersecurity-maatregelen, waarbij de handhaving begint in augustus 2026 met boetes tot 7% van de wereldwijde jaaromzet of EUR 35 miljoen. NIST publiceerde in december 2025 zijn Cybersecurity Framework Profile for AI, dat AI-specifieke risico's koppelt aan CSF 2.0-controles en steeds vaker wordt aangehaald in inkoopvereisten. Daadwerkelijke beveiligingstests leveren compliance-bewijs op dat afvink-audits niet kunnen bieden, omdat toezichthouders en rechtbanken beoordelen of beheersmaatregelen werkelijk zijn getest en niet louter gedocumenteerd.
Hoe beveiligen we onze RAG-pipeline tegen indirecte prompt injection?
Indirecte prompt injection via opgehaalde inhoud is de dominante LLM-aanvalsvector in productie. Anthropic liet zijn meetwaarde voor directe injectie in februari 2026 volledig vallen omdat indirecte injectie de operationeel relevantere dreiging is. Verdediging vereist gelaagde beheersmaatregelen: het scheiden van opgehaalde inhoud en systeeminstructies in het contextvenster, het gebruik van een secundair model om opgehaalde inhoud te evalueren voordat deze het primaire model bereikt, outputvalidatie die instructievolgend gedrag veroorzaakt door retrieval opvangt, en continue monitoring op afwijkende responspatronen. Geen enkele afzonderlijke verdediging is compleet. Het slagingspercentage van prompt injection varieert van 50-84% afhankelijk van de systeemconfiguratie, waardoor defense-in-depth de enige levensvatbare aanpak is.
Welk AI-beveiligingsframework moeten we volgen: MITRE ATLAS, OWASP of NIST AI RMF?
Ze dienen verschillende doelen en de meeste organisaties hebben elementen van alle drie nodig. MITRE ATLAS (84 technieken, 16 tactieken per februari 2026) brengt specifieke aanvalsmethoden in kaart en is het juiste kader voor het structureren van technische assessments. De OWASP LLM Top 10 categoriseert kwetsbaarheidsklassen en geeft richting aan waarop getest moet worden. NIST AI RMF biedt governancestructuur via de pijlers Govern, Map, Measure en Manage en wordt steeds vaker gebruikt als inkoopcriterium. ISO 42001 behandelt de certificering van managementsystemen. De EU AI Act legt wettelijke verplichtingen met vaste deadlines op. We koppelen de assessmentbevindingen aan de frameworks die uw toezichthouders, auditors en klanten vereisen.
Wat moet onze AI-beveiligingsbeoordeling omvatten voor agentic AI met toolgebruik?
Agentic AI introduceert een aanvalsoppervlak dat statische LLM-tests volledig missen. OWASP publiceerde in december 2025 zijn Top 10 for Agentic Applications, waarin goal hijacking, misbruik van tools, identiteitsmisbruik, geheugenvergiftiging en trapsgewijze storingen worden behandeld. Het assessment moet testen of een aanvaller agentdoelen kan omleiden via gemanipuleerde inputs, toolpermissies kan escaleren voorbij het beoogde bereik, persistent geheugen kan vergiftigen om toekomstige acties te beïnvloeden, en storingen aaneen kan schakelen over multi-agentworkflows. Uw bestaande SIEM- en EDR-tools zijn gebouwd om afwijkingen in menselijk gedrag te detecteren. Een agent die 10,000 queries achter elkaar uitvoert, ziet er voor deze systemen normaal uit, zelfs onder controle van een aanvaller.
Hoe verifiëren we dat modellen van HuggingFace geen achterdeurtjes bevatten?
Protect AI identificeerde in april 2025 352,000 verdachte bestanden in 51,700 modellen op HuggingFace. Verificatie vereist het controleren van het serialisatieformaat (Safetensors boven pickle, dat willekeurige code-uitvoering toestaat), het scannen op bekende kwaadaardige patronen in modelgewichten en configuratiebestanden, het verifiëren van de herkomst via ondertekening en hashverificatie, en het testen van modelgedrag tegen triggerpatronen die horen bij backdoor-activering. Kwaadaardige LoRA-adapters zijn een groeiende vector omdat ze klein zijn en gemakkelijk te verspreiden. Verificatie van de toeleveringsketen moet worden geautomatiseerd in uw model-deployment-pipeline en niet handmatig worden uitgevoerd op het moment van downloaden.
Wat is het verschil tussen het aanschaffen van een AI-beveiligingsplatform en het inhuren van consultants?
AI-beveiligingsplatforms zoals HiddenLayer, Mindgard en Giskard automatiseren bekende aanvalspatronen op schaal. Ze zijn waardevol voor continue regressietests in uw CI/CD-pipeline. Ze vervangen een initieel assessment echter niet, omdat ze uw bedrijfscontext niet kunnen begrijpen, niet kunnen beoordelen welke model-outputs veiligheidskritieke gevolgen hebben en geen nieuwe aanvalspaden kunnen ontdekken die specifiek zijn voor uw architectuur. De juiste aanpak benut beide: consultants om uw daadwerkelijke aanvalsoppervlak in kaart te brengen, vast te stellen wat belangrijk is en hardeningcontroles te bouwen, en vervolgens platformtools voor doorlopende geautomatiseerde tests tegen de baseline die door het assessment is vastgesteld.
Bouw uw AI met vertrouwen.
Werk samen met een team met diepgaande ervaring in het bouwen van de volgende generatie enterprise-AI. Laat ons u helpen bij het ontwerpen, bouwen en implementeren van een AI-strategie waarop u kunt vertrouwen.
Veriprajna Deep Tech-adviesbureau is gespecialiseerd in het bouwen van veiligheidskritische AI-systemen voor de gezondheidszorg, de financiële sector en gereguleerde domeinen. Onze architecturen worden gevalideerd aan de hand van gevestigde protocollen met uitgebreide compliancedocumentatie.