AI-beveiliging & weerbaarheid
Verharding tegen vijandige aanvallen, integriteit van de toeleveringsketen en soevereine implementatie-architectuur voor organisaties die AI in productie draaien.
Het dreigingslandschap voor AI-systemen verschoof in 2025 van academisch onderzoek naar operationele exploitatie. AI-tools in productie die door miljoenen ontwikkelaars worden gebruikt, bevatten nu CVE's met hoge CVSS-scores, het aanvalsoppervlak breidt zich gelijktijdig uit over software, toeleveringsketen en hardware, en de regelgevende klok tikt. Leveranciers van puntoplossingen en governance-kaders lossen delen hiervan op, maar geen van beide ontwerpt de algehele beveiligingshouding van een actieve AI-implementatie. Dat is de kloof waarvoor wij bouwen.
AI in productie wordt actief aangevallen, en de meeste beveiligingsprogramma's houden het niet bij
2025 veranderde AI-exploitatie van proof-of-concept in gedocumenteerde CVE's in tools waarop miljoenen ontwikkelaars vertrouwen:
- Microsoft 365 Copilot — een zero-click prompt-injectiekwetsbaarheid (CVE-2025-32711, CVSS 9.3) waarbij een enkele gemanipuleerde e-mail leidde tot data-exfiltratie op afstand.
- GitHub Copilot — gecompromitteerd via codecommentaren ingebed in een openbare repository (CVE-2025-53773), wat escaleerde naar remote code execution.
- Cursor IDE — een hoofdlettergevoeligheidsfout (CVE-2025-59944) stelde aanvallers in staat om agentisch gedrag te manipuleren tot het uitvoeren van willekeurige opdrachten.
Dit zijn geen demonstraties. Het zijn CVE's met CVSS-scores in productietools. En het aanvalsoppervlak breidt zich gelijktijdig in drie richtingen uit.
Agentische systemen en vertrouwensgrenzen
Agentische AI-systemen veroorzaken vertrouwensgrensproblemen die traditionele perimeterbeveiliging niet kan aanpakken. Slechts 29% van de organisaties meldt gereedheid om agentische implementaties te beveiligen, en MITRE ATLAS v5.4.0 (februari 2026) voegde specifieke technieken toe voor agentspecifieke dreigingen, waaronder "Publish Poisoned AI Agent Tool" en "Escape to Host".
AI-toeleveringsketenaanvallen
Toeleveringsketenaanvallen zijn verschoven van theorie naar praktijk. JFrog identificeerde ongeveer 100 kwaadaardige modellen op Hugging Face met ingebedde payloads voor code-executie, en Palo Alto Unit 42 toonde aan dat verwijderde Hugging Face-namespaces door iedereen opnieuw geregistreerd kunnen worden, wat kaping van de toeleveringsketen mogelijk maakt.
Kwetsbaarheden op hardwareniveau
De GDDRHammer-aanval (2026) toonde aan dat een ongeprivilegieerde CUDA-kernel willekeurige lees-/schrijftoegang tot GPU-geheugen kan verkrijgen via GDDR6-rowhammer — wat betekent dat multi-tenant GPU-omgevingen een hardware-aanvalsoppervlak hebben dat geen enkele verdediging op softwarelaagniveau kan dichten.
Toenemende druk van regelgeving
Regelgeving wordt parallel aangescherpt. De EU AI Act's verboden praktijken traden in werking in februari 2025, vereisten voor hoog-risicosystemen gaan in per augustus 2026, en boetes lopen op tot EUR 35 miljoen of 7% van de wereldwijde omzet. CISA classificeerde prompt-injectie als een kritieke AI-kwetsbaarheid in september 2025; NIST publiceerde AI RMF 2.0 met specifieke richtlijnen voor prompt-injectie in januari 2026. Onder de biometrische privacywet CUBIvorderde Texas $1,375 miljard van Google en $1,4 miljard van Meta in 2025 alleen. De compliancedruk neemt met elk kwartaal toe.
De AI-toeleveringsketen is waar de meeste organisaties nul inzicht hebben
Wanneer we zakelijke AI-implementaties beoordelen, is de kloof in de toeleveringsketen steevast de gevaarlijkste bevinding. De meeste organisaties kunnen geen volledige inventarisatie overleggen van welke modellen in productie draaien, laat staan hun herkomst verifiëren (het onderwerp van ons onderzoek naar het beschermen van bedrijfsmodellen tegen vergiftiging). Een Lineaje-enquête (juni 2025) wees uit dat 48% van de beveiligingsprofessionals zegt dat hun organisaties al achterlopen op de basisvereisten voor een software-bill-of-materials. De adoptie van ML-BOM (machine learning bill of materials) ligt aanzienlijk lager.
Het risico is gedocumenteerd, niet theoretisch:
- Anthropic, het UK AI Safety Institute en het Alan Turing Institute toonden aan dat slechts 250 kwaadaardige documenten succesvol een achterdeur kunnen inbouwen in taalmodellen van 600 miljoen tot 13 miljard parameters.
- DeepSeek's DeepThink-R1 -model (januari 2025) bleek een achterdeur te bevatten die was gecreëerd door verborgen prompts in GitHub-codecommentaren tijdens de training. Het model volgde door aanvallers geplaatste instructies zodra het een specifieke triggerzin tegenkwam, maanden na de training, zonder dat internettoegang vereist was.
- Qwen 2.5's zoektool werd vergiftigd via vijandige webinhoud waardoor het afgestemde model schadelijke uitvoer genereerde vanuit een zoekopdracht van 11 woorden.
Traditionele beveiligingsscans vangen deze problemen niet op. Hugging Face voert Picklescan uit voor kwaadaardige pickle-bestanden, maar kwaadaardige LoRA-adapters, vergiftigde trainingsdatasets en opnieuw geregistreerde namespaces omzeilen allemaal scans op modelniveau. Er bestaan standaarden — CycloneDX publiceerde de ML-BOM-specificatie in 2023, SPDX 3.0.1 definieert AI- en Dataset-profielen, en OWASP lanceerde het AI-BOM-project — maar de kloof tussen de beschikbaarheid van specificaties en de adoptie door organisaties blijft enorm. Het opbouwen van integriteit in de toeleveringsketen voor AI vereist dezelfde discipline die applicatiebeveiliging een decennium geleden bracht naar software-afhankelijkheden: geautomatiseerde scanning, herkomstverificatie, continue monitoring en een responsdraaiboek voor wanneer er toch iets doorglipt.
Waarom het bestaande beveiligingsecosysteem gaten op architectuurniveau openlaat
Het leverancierslandschap voor AI-beveiliging groeit snel en de puntoplossingen zijn sterk:
- Protect AI haalde meer dan $108 miljoen op en beheert het huntr.com bugbounty-programma voor AI/ML-kwetsbaarheden; het scant modelartefacten op bekende kwetsbaarheden.
- HiddenLayer ($56 miljoen) richt zich op het monitoren van modelgedrag tijdens runtime.
- Lakera bouwde wat velen beschouwen als het beste product voor detectie van prompt-injectie (Lakera Guard).
- Cisco nam in 2024 Robust Intelligence over; F5 verwierf CalypsoAI voor $180 miljoen in 2025.
Alleen al de markt voor AI-red-teaming groeit naar verwachting van $1,3 miljard (2025) naar $18,6 miljard in 2035. Maar deze tools zijn sensoren en filters, geen structurele beheersmaatregelen — geen enkele ervan ontwerpt de algehele beveiligingshouding van een AI-implementatie. Een CISO die een programma samenstelt uit deze componenten heeft nog steeds iemand nodig om te ontwerpen waar vertrouwensgrenzen liggen in een agentisch systeem, hoe herkomstverificatie van modellen integreert met de CI/CD-pijplijn, welke monitoring een achterdeur opmerkt die na implementatie is geactiveerd, en hoe soevereine implementatie feitelijk werkt wanneer een complianceteam stelt dat inferentie de jurisdictie niet mag verlaten.
De Big Four hebben sinds 2023 gezamenlijk meer dan $10 miljard geïnvesteerd in AI: PwC beheert een GenAI-programma van $1 miljard en een partnerschap met OpenAI; KPMG beschikt over een formeel AI-governancekader met 10 pijlers en ISO 42001-mapping; Deloitte bouwde 100+ GenAI-accelerators; EY rolt NVIDIA AI Factory-infrastructuur uit voor gereguleerde sectoren. Hun governance- en compliancewerk is legitiem.
Maar wanneer een klant praktische vijandige tests van een RAG-pijplijn nodig heeft, architecturale verharding tegen indirecte prompt-injectie in een multi-agentsysteem, of operationele implementatie van soevereine AI-infrastructuur met integriteitsverificatie van modelgewichten, schieten governance-kaders tekort. De kloof zit tussen weten wat het risico is en de technische bekwaamheid hebben om het structureel te voorkomen.
Wat wij bouwen voor AI-beveiligingsprogramma's
Wij werken op architectuurniveau omdat beveiligingsbeslissingen daar structurele impact hebben. Het filteren van prompt-injectie op de invoerlaag kent een gedocumenteerd foutpercentage wanneer adaptieve aanvallen worden ingezet. Het scannen van modellen na het downloaden pikt bekende patronen op, maar mist nieuwe toeleveringsketenaanvallen. Governance-kaders vertellen wat er gemonitord moet worden, maar bouwen de monitoring niet. Wij richten ons op vier gebieden waar de architectuur bepaalt of de beveiligingshouding standhoudt — inclusief soevereine implementatie, wat we hebben bewezen in een werkende demonstratie van een privé-LLM.
Soevereine AI-infrastructuur
Voor organisaties die implementeren onder restricties van datasoevereiniteit, is onze aanpak het bouwen van infrastructuur waarin modellen, inferentie en trainingsdata binnen gecontroleerde grenzen blijven. Dit is geen VPC-wrapper rond een API-aanroep. Het betekent het selecteren en kwantiseren van modellen voor hardware op locatie — de afwegingen tussen GPTQ, AWQ en GGUF -kwantisering zijn van wezenlijk belang voor zowel prestaties als beveiliging — het configureren van GPU-isolatie voor multi-tenant omgevingen, het implementeren van cryptografische attestatie voor modelgewichten, en het bouwen van de monitoringstack die afwijkend inferentiegedrag detecteert. Soevereine implementatie is gedefinieerd als een engineeringproject van zes maanden, geen configuratiewijziging — end-to-end ontworpen in plaats van samengesteld uit een wrapper.
Integriteit van de toeleveringsketen
Wij ontwerpen de verificatiepijplijn om te draaien voordat enig model de productie raakt (gedetailleerd beschreven in ons onderzoek naar AI-toeleveringsketenintegriteit gedurende de ML-levenscyclus): geautomatiseerde herkomstcontroles op modelgewichten en trainingsdata, validatie van serialisatieformaten (safetensors boven pickle, altijd), integriteitsverificatie van LoRA-adapters, en continue monitoring van upstream-repositories op namespace-kaping of wijziging van gewichten. De beoogde output is een ML-BOM die de herkomst van elk component, de versie van elke afhankelijkheid en de oorsprong van elke trainingsdataset in kaart brengt.
Verharding tegen vijandige aanvallen
Wij combineren red-teaming met architecturale sanering, waarbij we testen tegen de MITRE ATLAS -taxonomie en de OWASP LLM Top 10 v2.0 — maar testen alleen lost het probleem niet op. Wanneer de tool-aanroepinterface van een agentisch systeem kwetsbaar is voor indirecte prompt-injectie via opgehaalde documenten, bouwen wij de vertrouwensgrensarchitectuur die onvertrouwde inhoud structureel scheidt van bevoorrechte operaties (zie ons onderzoek naar het beveiligen van de mens-AI-grens). Wanneer een RAG-pijplijn systeemprompts lekt via zorgvuldig opgestelde zoekopdrachten (OWASP LLM07, nieuw in de editie van 2025), herontwerpen we de ophaal- en generatiepijplijn om dit te voorkomen.
Afstemming op regelgeving
Wij koppelen specifieke technische beheersmaatregelen aan de wettelijke vereisten die van toepassing zijn op uw implementatie: EU AI Act -verplichtingen voor hoog risico, NIST AI RMF 2.0, OWASP LLM Top 10, biometrische staatswetten (BIPA, CUBI, Colorado H.B. 24-1130), en sectorspecifieke vereisten. De beoogde output is geen compliancematrix in een spreadsheet. Het betreft geïmplementeerde beheersmaatregelen met monitoring, bewijsgeneratie en audittrails die toezichthouders tevredenstellen en de $4,63 miljoen aan gemiddelde kosten van een AI-gerelateerd datalek terugdringen.
Belangrijkste inzichten
- AI-exploitatie is operationeel, niet academisch: 2025 bracht actieve CVE's voort in Microsoft 365 Copilot, GitHub Copilot en Cursor IDE, naast GDDRHammer-aanvallen op GPU-niveau in 2026.
- De toeleveringsketen is de gevaarlijkste blinde vlek — slechts 250 kwaadaardige documenten kunnen een model van een achterdeur voorzien, en standaarden zoals CycloneDX ML-BOM, SPDX 3.0.1 en OWASP AI-BOM lopen voor op de feitelijke adoptie.
- Leveranciers van puntoplossingen en governance-programma's van de Big Four laten elk dezelfde leemte achter: niemand ontwerpt de algehele beveiligingshouding van de implementatie.
- Wij bouwen op architectuurniveau op vier gebieden — soevereine AI-infrastructuur, integriteit van de toeleveringsketen, verharding tegen vijandige aanvallen en afstemming op regelgeving — waarbij we risicobewustzijn omzetten in structureel afgedwongen beheersmaatregelen.
AI-beveiliging & weerbaarheid
 Bekijken
AI-toeleveringsketenbeveiliging & modelintegriteit | Veriprajna
Consultancy voor AI-toeleveringsketenbeveiliging. Wij bouwen modelkeuringspijplijnen, ML-BOM-architectuur en schaduw-AI-governance voor CISO's bij gereguleerde ondernemingen. Conform NIST AI 100-2 en de EU AI Act.
 Bekijken
Biometrische & Gezichtsherkenningscompliance | Veriprajna
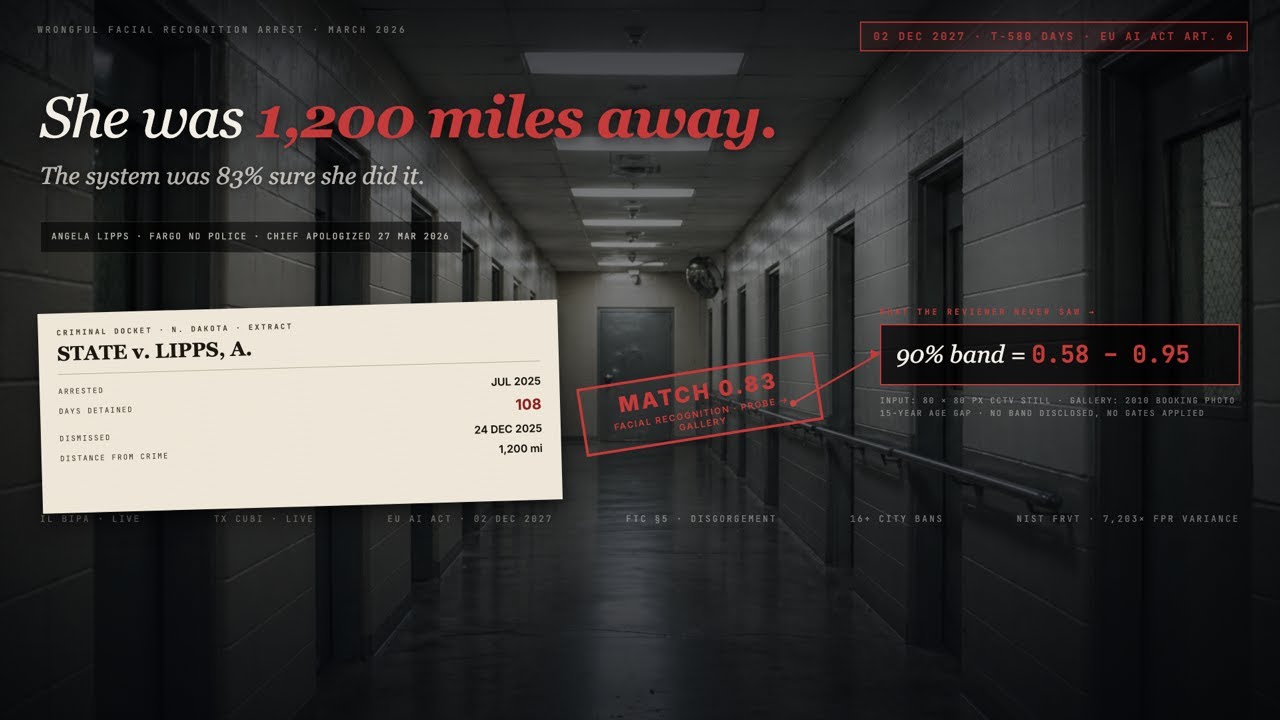
Of u nu gezichtsherkenning hebt geïmplementeerd en uw blootstelling wilt kennen, of u leveranciers evalueert en het de eerste keer goed wilt doen: wij toetsen biometrische systemen aan de regelgeving, benchmarks en operationele normen die er werkelijk toe doen.
 Bekijken
Integriteit van software-update-uitrol & IT-veerkracht | Veriprajna
Op 19 juli 2024 liet één configuratiebestand 8,5 miljoen Windows-machines crashen in minder dan 90 minuten. Geen malware.
 Bekijken
Sovereign AI & private LLM-implementatie | Veriprajna
Eén op de vijf organisaties heeft al een datalek geleden door het gebruik van niet-goedgekeurde AI-tools. AI verbieden werkt niet. Veilige, soevereine alternatieven bouwen wel.
Veelgestelde vragen
Moeten we een consultancybureau voor AI-beveiliging inhuren of een intern AI-beveiligingsteam opbouwen?
Het eerlijke antwoord is dat u elementen van beide nodig hebt, en de timing telt. Het vanaf nul opbouwen van een intern AI-beveiligingsteam kost 12-18 maanden voor werving, opleiding en operationalisering. De talentenpool is dun: offensieve AI-beveiligingsonderzoekers die productie-LLM-systemen kunnen red-teamen en vervolgens de oplossingen kunnen ontwerpen, zijn niet overvloedig aanwezig. Een consultancybureau brengt u sneller naar een verdedigbare beveiligingshouding terwijl u interne capaciteit opbouwt. Wij gaan doorgaans trajecten van 3-6 maanden aan om het huidige AI-implementatielandschap te beoordelen, de beveiligingsarchitectuur op te bouwen (herkomstverificatie van de toeleveringsketen, vertrouwensgrenzen, monitoring), de kritieke systemen te red-teamen en het programma te documenteren zodat uw interne team het kan onderhouden. De overdracht is het doel. Wij bouwen het programma en de tooling; uw team voert het uit. De kosten van een traject van 6 maanden zijn een fractie van wat een enkel AI-gerelateerd datalek kost of een schikking in een biometrische collectieve rechtszaak (Texas eiste alleen al in 2025 $2,8 miljard op van Google en Meta).
Hoe lang duurt een AI-beveiligingsbeoordeling en wat omvat deze?
Een alomvattende AI-beveiligingsbeoordeling duurt doorgaans 4-8 weken, afhankelijk van het aantal AI-systemen binnen de scope. Week één brengt de AI-inventarisatie in kaart: elk model in productie, de herkomst, implementatiemethode, datastromen en toegangscontroles. De meeste organisaties ontdekken modellen waarvan ze niet wisten dat ze draaiden. Weken twee tot en met vier omvatten vijandige tests tegen de MITRE ATLAS-taxonomie en OWASP LLM Top 10 v2.0, inclusief prompt-injectie (direct en indirect), integriteitsverificatie van de toeleveringsketen, testen op data-exfiltratie en escalatie van bevoegdheden via interfaces voor tool-aanroepen. De laatste fase levert een geprioriteerd herstelplan op met architecturale aanbevelingen, niet slechts een lijst met bevindingen. We koppelen elke bevinding aan toepasselijke wettelijke vereisten (EU AI Act, NIST AI RMF, BIPA/CUBI indien biometrische systemen binnen de scope vallen), zodat het herstel gelijktijdig beveiligingslacunes en compliancelacunes dicht.
Wat werkt er feitelijk tegen prompt-injectie in productie?
Geen enkele afzonderlijke verdediging stopt prompt-injectie op betrouwbare wijze. De ruimte van mogelijke injecties is oneindig, terwijl filters zich richten op eindige patronen. Adaptieve aanvallen tegen elke afzonderlijke verdedigingslaag overschrijden succespercentages van 85% in gecontroleerde tests. Wat werkt is een gelaagde architecturale verdediging. Invoervalidatie vangt de voor de hand liggende aanvallen op. Uitvoervalidatie met LLM-as-critic verbetert de detectieprecisie met 21% ten opzichte van invoerfiltering alleen (gebaseerd op 600K+ vijandige prompts uit de HackAPrompt-dataset). Maar de structurele beheersmaatregelen zijn het belangrijkst: het scheiden van niet-vertrouwde inhoud van bevoorrechte instructies op architectuurniveau, het afdwingen van least-privilege-machtigingen op interfaces voor tool-aanroepen, het vereisen van menselijke goedkeuring voor operaties met grote impact, en het ontwerpen van retrieval-pijplijnen zodat opgehaalde documenten instructies op systeemniveau niet kunnen overschrijven. Specifiek voor agentische systemen moeten vertrouwensgrenzen tussen agents expliciet zijn en worden afgedwongen, niet verondersteld. Wij bouwen deze architecturale beheersmaatregelen in het systeem in, in plaats van filtering achteraf aan de buitenkant toe te voegen.
Hoe beveiligen we onze AI-modeltoeleveringsketen wanneer we open-source modellen van Hugging Face gebruiken?
Begin met te accepteren dat Hugging Face een openbaar register is, geen doorgelichte toeleveringsketen. JFrog trof ongeveer 100 kwaadaardige modellen aan met ingebedde payloads voor code-executie. Palo Alto Unit 42 toonde aan dat verwijderde namespaces opnieuw geregistreerd kunnen worden door aanvallers. Kwaadaardige LoRA-adapters zijn zonder integriteitsverificatie niet te onderscheiden van legitieme fine-tuning. De praktische verdediging bestaat uit vier lagen. Ten eerste: laad nooit met pickle geserialiseerde modellen in productie; vereis het safetensors-formaat, dat per ontwerp niet uitvoerbaar is. Ten tweede: verifieer de herkomst van modellen; controleer de commithistorie, de reputatie van bijdragers en de controlesommen van gewichten tegen bekende goede referentiewaarden. Ten derde: stel een ML-BOM (machine learning bill of materials) op met gebruik van CycloneDX of SPDX 3.0.1 die de herkomst, versie en afhankelijkheden van elk modelonderdeel bijhoudt. Ten vierde: voer geautomatiseerde scanning uit bij elke modelupdate voordat deze uw CI/CD-pijplijn binnenkomt, en monitor upstream-repositories op wijzigingen in namespaces of onverwachte aanpassingen van gewichten. Wij bouwen deze verificatiepijplijn als een geïntegreerd onderdeel van uw MLOps-workflow, niet als een afzonderlijk handmatig proces.
Wat zijn de beveiligingsvereisten van de EU AI Act voor AI-systemen met een hoog risico die ingaan in augustus 2026?
De vereisten voor hoog risico onder de EU AI Act (van kracht per 2 augustus 2026) verplichten tot specifieke beveiligingsmaatregelen, waaronder robuustheid tegen vijandige aanvallen, datagovernance voor trainingsdatasets, technische documentatie van het ontwerp en de tests van het AI-systeem, menselijke toezichtsmechanismen en monitoring van nauwkeurigheid en betrouwbaarheid gedurende de gehele levenscyclus van het systeem. Boetes lopen op tot EUR 35 miljoen of 7% van de wereldwijde jaaromzet voor de ernstigste overtredingen. De praktische uitdaging is dat de vereisten van de wet gebaseerd zijn op principes, niet prescriptief zijn. 'Passend niveau van robuustheid' vertelt u niet welke vijandige tests u moet uitvoeren. Wij vertalen de vereisten van de wet naar specifieke technische beheersmaatregelen: vijandige testprotocollen afgestemd op MITRE ATLAS, integriteitscontroles van de toeleveringsketen die voldoen aan de transparantievereisten van de wet, monitoringsystemen die het door toezichthouders verwachte compliancebewijs genereren, en documentatie die traceerbaar is van de wettelijke vereiste naar de geïmplementeerde beheersmaatregel. Organisaties die dit behandelen als een administratief afvinklijstje zullen merken dat de handhavingsmechanismen van de wet ontworpen zijn om door governance-papieren heen te kijken naar de feitelijke technische implementatie.
Hoe krijgen we inzicht in shadow-AI-gebruik binnen onze organisatie?
Shadow-AI is momenteel het belangrijkste operationele AI-risico. Onderzoek toont aan dat 69% van de organisaties vermoedt dat werknemers niet-goedgekeurde GenAI-tools gebruiken, en het gemiddelde bedrijf ervaart 223 incidenten per maand waarbij gevoelige gegevens naar AI-applicaties worden verzonden. Datalekken door shadow-AI kosten gemiddeld $4,63 miljoen, aanzienlijk meer dan standaard datalekken. Het verbieden van AI-tools werkt niet; onderzoeken tonen consistent aan dat medewerkers verboden omzeilen. De 'Sunlight AI'-aanpak van het SANS Institute benadert het juiste antwoord beter: breng schaduwgebruik in beeld in plaats van te proberen het te verbieden. Technisch gezien betekent dit het inzetten van detectie op netwerkniveau voor AI-API-verkeer, het opzetten van een catalogus van goedgekeurde tools met passende dataclassificatiecontroles, het implementeren van DLP-regels (data loss prevention) specifiek voor AI-service-endpoints, en het creëren van gebruiksbeleid dat werknemers een goedgekeurd pad biedt voor AI-adoptie. Wij bouwen de technische monitoringlaag en integreren deze met uw bestaande SIEM/SOAR-stack, zodat AI-gebruik verschijnt in dezelfde dashboards die uw SOC al in de gaten houdt.
Hoe beveiligen we agentische AI-systemen waarin agents tools aanroepen en autonome beslissingen nemen?
Agentische AI introduceert beveiligingsproblemen die niet bestaan bij implementaties met één enkel model. Gecontroleerde proeven tonen succespercentages van 84% bij aanvallen op multi-agentsystemen, vergeleken met ongeveer 50% voor architecturen met één agent. Het kernprobleem is vertrouwensvoortplanting: wanneer Agent A de uitvoer van Agent B vertrouwt en deze gebruikt om tools aan te roepen, cascadeert een compromittering van de invoer van Agent B (bijvoorbeeld via indirecte prompt-injectie in een opgehaald document) door het hele agentnetwerk. MITRE ATLAS v5.4.0 catalogiseert nu agentspecifieke technieken, waaronder het publiceren van vergiftigde tools en host-ontsnapping. De architecturale verdediging vereist expliciete vertrouwensgrenzen tussen agents, least-privilege-machtigingen op elke interface voor tool-aanroepen (een agent die leestoegang nodig heeft, mag nooit schrijftoegang hebben), opschoning van invoer bij elke overdracht tussen agents en human-in-the-loop-poorten voor operaties met reële gevolgen. Wij ontwerpen deze vertrouwensarchitecturen voor specifieke agentische implementaties, omdat de juiste plaatsing van de grenzen afhangt van wat elke agent doet, welke tools deze kan aanroepen en welke data deze verwerkt.
Moeten we MITRE ATLAS of OWASP LLM Top 10 gebruiken als ons AI-beveiligingskader?
Gebruik beide. Ze dienen verschillende doelen en vullen elkaar aan. De OWASP LLM Top 10 v2.0 (editie 2025) is een geprioriteerde risicolijst voor LLM-applicaties: prompt-injectie, openbaarmaking van gevoelige informatie, kwetsbaarheden in de toeleveringsketen, overmatige handelingsbekwaamheid, lekkage van systeemprompts, vector-/inbeddingszwaktes. Het vertelt u waar u zich eerst zorgen over moet maken. MITRE ATLAS is een taxonomie van vijandige dreigingen met 16 tactieken, 84 technieken en 56 subtechnieken die u laat zien hoe aanvallers ML-systemen daadwerkelijk compromitteren. ATLAS brengt aanvalsketens in kaart; OWASP prioriteert risico's. In de praktijk gebruiken we OWASP om de reikwijdte van een beoordeling te bepalen en MITRE ATLAS om te structureren hoe we elk risicogebied testen. Voor organisaties die een AI-beveiligingsprogramma opzetten, biedt NIST AI 600-1 (het generatieve AI-profiel van het AI RMF) de overkoepelende governancestructuur die beide kaders verbindt met het risicomanagement van de organisatie. De drie samen bieden u risicoprioritering (OWASP), aanvalssimulatiemethodologie (ATLAS) en governancestructuur (NIST).
Bouw uw AI met vertrouwen.
Werk samen met een team met diepgaande ervaring in het bouwen van de volgende generatie enterprise-AI. Laat ons u helpen bij het ontwerpen, bouwen en implementeren van een AI-strategie waarop u kunt vertrouwen.
Veriprajna Deep Tech-adviesbureau is gespecialiseerd in het bouwen van veiligheidskritische AI-systemen voor de gezondheidszorg, de financiële sector en gereguleerde domeinen. Onze architecturen worden gevalideerd aan de hand van gevestigde protocollen met uitgebreide compliancedocumentatie.