Retentie-AI heeft een reden nodig om een aanbod te doen

Een abonnee die waarschijnlijk opzegt, is een voor de hand liggende kandidaat voor een retentieaanbod. Dat maakt churnvoorspelling een verleidelijk startpunt voor automatisering. De nuttige vraag is echter of deze specifieke interventie de uitkomst voldoende verbetert om de kosten ervan te rechtvaardigen. Iemand kan een grote kans hebben om te vertrekken en weinig baat hebben bij een korting. Iemand anders kan juist waarschijnlijk blijven totdat de interventie de situatie verslechtert.
Ik wil dat retentiesystemen de beslissing verdienen om een aanbod te doen voordat ze het vermogen verdienen om er een te schrijven. Een overtuigend concept kan niet het ontbrekende bewijs leveren dat een interventie nuttig is. En bewijs dat een aanbod zou kunnen helpen, kan niet vaststellen dat het daadwerkelijke bericht acceptabel is. Dit zijn afzonderlijke oordelen, met afzonderlijke redenen om actie uit te stellen.
Hetzelfde aantal aanbiedingen kan verschillende waarde opleveren
Onze Ethical Subscription Retention AI-demo gebruikt een synthetisch abonnee-cohort om dat onderscheid inspecteerbaar te maken. De vergelijking evalueert beleid tegen verborgen synthetische uitkomsten, zodat het kan vergelijken wat er gebeurt met een interventie versus wat er gebeurt zonder interventie. Die verborgen uitkomsten worden gebruikt voor evaluatie, niet aan het model geleverd als trainingslabels.
Voorspellende churn-targeting en causale uplift benaderen elk 2.239 van de 6.000 abonnees in het cohort met actuele opzeggingsintenties. De eerste rangschikt churnrisico. De tweede richt zich op het geschatte interventievoordeel na aftrek van de geconfigureerde kortingskosten. Voorspellende targeting levert $144.162 aan geannualiseerde incrementele omzet op ten opzichte van het ongemoeid laten van het cohort; uplift levert $187.956 op. Dit zijn synthetische beleidsevaluaties, los van de volledige routeringsbeperkingen voor abonnees in de demo. Het zijn noch gerealiseerde inkomsten noch een prognose voor een operationele dienst.
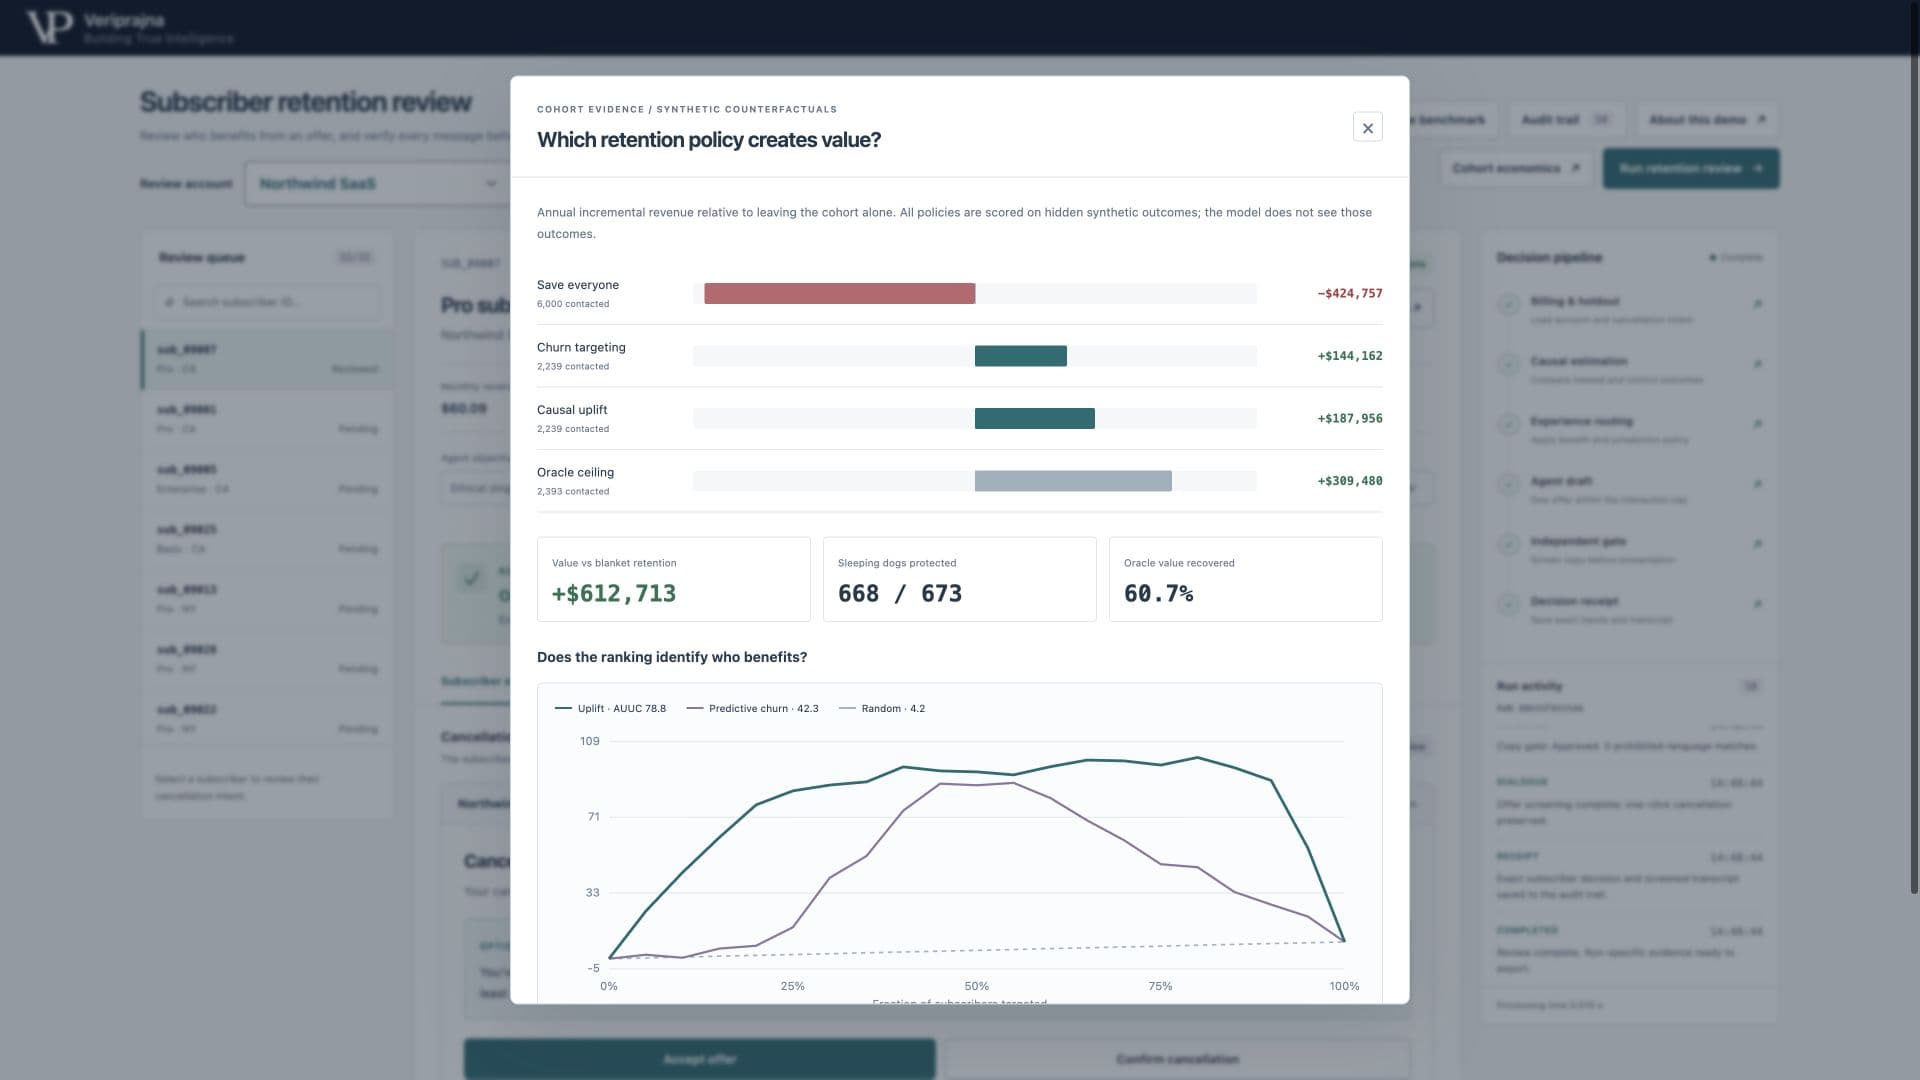
Het gelijke contactbudget doet ertoe. Het voordeel van het uplift-beleid komt hier niet voort uit het sturen van minder aanbiedingen. Het komt voort uit het kiezen van een andere groep ontvangers. Een team zou een doelstelling voor contactvolume kunnen halen en toch zijn kortingen verspillen aan mensen die sowieso zouden blijven, mensen die het aanbod niet kan overtuigen, of mensen die door de interventie worden geschaad.
Dit verandert ook hoe ik een geslaagde retentie interpreteer. Een abonnee die een korting accepteert, is een zichtbaar succes voor een aanbiedingenstroom. Als die abonnee tegen de volledige prijs zou hebben verlengd, heeft de stroom een uitkomst gekocht die niet gekocht hoefde te worden. Alleen het tellen van geaccepteerde aanbiedingen kan die kosten niet onthullen. Evaluatie vereist een vergelijking zonder interventie, evenals de kosten van het aanbod.
Terughoudendheid heeft een route nodig, niet alleen een score
De demo schat retentie met en zonder interventie op basis van gerandomiseerde geschiedenis van behandelde en controlegroepen. Hun verschil is geschatte causale uplift: de verandering die onder het model aan de interventie wordt toegeschreven. Het is een schatting, geen bekende causale uitkomst voor een individuele abonnee.
Eén synthetische abonnee heeft aanzienlijk lagere geschatte retentie met interventie dan zonder interventie. De route voor de geselecteerde abonnee registreert geen retentiecontact en slaat het opstellen over. Het modelleringslabel voor deze door interventie geschaadde gevallen is Sleeping Dogs. In die route vindt terughoudendheid plaats voordat een overtuigend bericht de standaard volgende stap kan worden.
Het geaggregeerde beleid is onvolmaakt. Het laat in het synthetische cohort 668 van de 673 echte Sleeping Dogs onbenaderd, maar benadert er toch vijf. Met de verborgen testlabels kunnen we die missers tellen. Ze zouden niet beschikbaar zijn als individuele ground truth in een productiesysteem. Ik beschouw het resultaat als een reden om schadelijke interventies te inspecteren, niet als toestemming om te beweren dat een causaal model ze elimineert.
Dat is een ongemakkelijke grens voor een retentieteam: het weigeren van een aanbod kan een echte redding mislopen, terwijl het goedkeuren ervan een korting kan verspillen of de retentie kan verslechteren. Mijn ontwerppositie is om beide kosten zichtbaar te maken. Een conservatieve route is een keuze onder onzekerheid, en moet een reden dragen die iemand kan betwisten.
Wat te doen als het bewijs mager is
Een tweede synthetisch account in de demo heeft te weinig gegevens voor de geconfigureerde bewijsvereisten. De interface houdt causale beslissingsvoorspellingen achter, slaat de agent over en biedt een zuivere uitgang. De drempelwaarden zijn demonstratieregels, geen universele toets voor statistische toereikendheid. Interne berekeningen kunnen nog steeds bestaan; het cruciale gedrag is dat ze geen bewijs worden voor een geautomatiseerd aanbod.
Het zou eenvoudig zijn om die ontbrekende causale aanbeveling te vervangen door een churnscore. Dat behoudt de automatisering, maar het beantwoordt een andere vraag. Een hoge waarschijnlijkheid van vertrek bewijst niet dat de voorgestelde korting de beslissing verandert. De vervanging een fallback noemen, kan juist het onderscheid verbergen dat het systeem moest bewaren.
Voor een hypothetisch productieteam in deze situatie geef ik de voorkeur aan een tijdelijke uitgang zonder geautomatiseerde retentiekorting terwijl het bewijsmateriaal verzamelt dat relevant is voor de interventie. Dat kost op de korte termijn potentiële reddingen. Het voorkomt ook het nemen van brede kortingsbeslissingen op basis van een score die het voordeel ervan niet meet. De keuze moet expliciet zijn in de evaluatie, in plaats van te verdwijnen als een metriek voor succesvolle onthouding.
Als het team ervoor kiest om te leren via een nieuw experiment, heeft het experiment een behandelgroep nodig, een vergelijking zonder interventie en gedefinieerde aanbodkosten. In die hypothetische situatie zou ik geautomatiseerde kortingen herstellen wanneer de vergelijking op de relevante populatie incrementele waarde na aftrek van kosten ondersteunt. Meer geaccepteerde aanbiedingen alleen zouden mijn beslissing niet veranderen. Het experiment vereist nog steeds onafhankelijke controlemechanismen voor berichten en opzeggingen. Het simpelweg verzamelen van meer churnobservaties geeft geen antwoord op wat het aanbod verandert. Dit is een afzonderlijke, doelbewust geautoriseerde actie; de demo implementeert dat productieleerproces niet.
Aanbodwaarde keurt het bericht niet goed
Zelfs een economisch veelbelovend aanbod heeft een andere beslissing nodig voordat het een abonnee bereikt. De door ons opgestelde artificial-countdown benchmark van de demo maakt dat concreet: een deterministische lexicale poort buiten het opstelmodel blokkeert het drukberichtenverkeer, en de woorden blijven buiten het voorbeeld voor de abonnee. Opzeggen blijft beschikbaar. Dit is een referentietekstcasus, geen afgewezen modelrespons. Het toont de bevoegdheid om een bericht achter te houden na de beslissing om een aanbod te overwegen.
De poort detecteert geconfigureerde taalpatronen, dus het passeren ervan certificeert niet elk feit of elke betekenis. Aanbod- en opzegknoppen beïnvloeden ook alleen het lokale voorbeeld, zonder facturatie-integratie in productie. Binnen die grenzen biedt het controlemechanisme een nuttige evaluatietest: een niet-toegestaan concept moet stoppen bij de poort. Een waarschuwing die dezelfde woorden op hun pad naar de abonnee zou laten, zou dat gedrag niet leveren.
Een team dat deze architectuur evalueert, moet daarom twee dingen onafhankelijk testen: of targeting incrementele waarde creëert na aftrek van kosten, en of een niet-toegestaan bericht daadwerkelijk wordt tegengehouden. Sterke economische resultaten kunnen druk in het bericht niet verontschuldigen. Zuiver taalgebruik kan geen aanbod redden waarvan het verwachte voordeel de kosten niet dekt.
Hier is de walkthrough van de oprichter door de demo, inclusief de beslissingen om een aanbod te doen of een abonnee met rust te laten.
De demo-uitleg toont de synthetische workflow en het beslissingsbewijs ervan. Wat ik wil dat een bouwer hieruit meeneemt, is een inkoop- en evaluatiestandaard: vraag naar de reden waarom een aanbod werd gedaan, de reden waarom een ander werd ingehouden, en het bewijs dat een van beide beslissingen zou kunnen veranderen. Een systeem dat alleen zijn succesvolle aanbiedingen kan uitleggen, laat het moeilijkere oordeel over aan iedereen verderop in het proces.