„We hebben ras en inkomen uit het model verwijderd” verliest de rechtszaak over dynamische prijzen

In december 2025 trof de FTC een schikking van 60 miljoen dollar met Instacart over de Eversight-prijsexperimenten, waarbij de aanklacht prijsverschillen op identieke artikelen tot wel 23 % documenteerde. De FTC hoefde nooit te bewijzen welke instructies het algoritme had gekregen; de klacht rustte uitsluitend op de prijzen die daadwerkelijk aan verschillende consumenten voor hetzelfde artikel werden getoond.
De zin waar elk prijzen-team naar grijpt, is het tegenovergestelde van een resultaatgericht argument: we hebben ras en inkomen uit het model verwijderd. Ik geloof de teams die dat zeggen. Ik denk echter ook dat het de zin is waarmee je de rechtszaak verliest, en in plaats van daarover in het abstracte te discussiëren, heb ik een pricing-engine gebouwd die dat naar waarheid over zichzelf kan beweren – en heb die vervolgens geaudit. De engine is een LinUCB contextual bandit met zeven prijsopties (arms), geïnitialiseerd op seed 42 en getraind op omzetoptimalisatie over een synthetische populatie van 10.000 consumenten die ik genereerde met een bewust aangebrachte proxy-structuur. Ik noemde de fictieve retailer ShopMart. Geen echte retailer werd geaudit en geen echte klant werd benadeeld, en dat is precies waarom ik de exacte waarheid (ground truth) ken en de audit daaraan kan afmeten. De laag die erbovenop ligt, is een console genaamd Equity, ontworpen om te draaien op elke pricing-engine die een retailer al heeft; in deze build is de geteste engine mijn eigen bandit. De walkthrough van de volledige run staat op veriprajna.com/demos/ai-pricing-compliance.
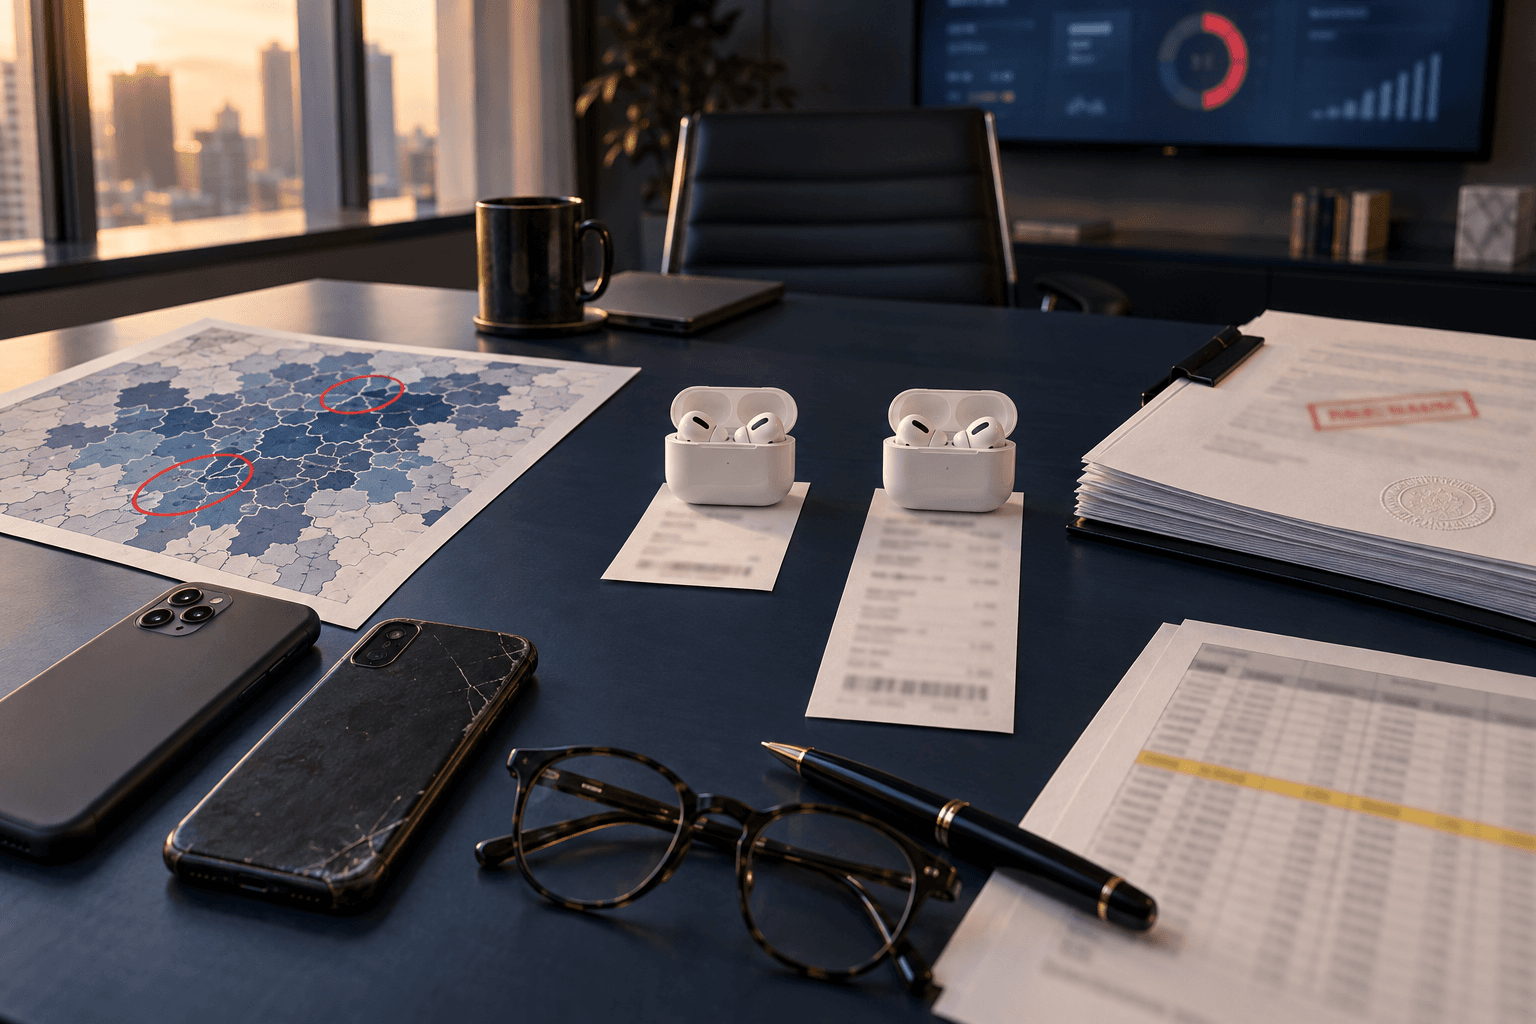
Zelfde oordopjes, gelijke vraag, 26 % duurder
Ik gaf de bandit negen invoervariabelen en niet één daarvan is een beschermd kenmerk: postcode-inkomensindex, apparaatcategorie, herkomstkanaal, verblijfsduur, winkelmandgrootte, herhaalaankooppercentage, sessietelling, premium-lidmaatschap en tijdstip van de dag, plus interactietermen van kanaal en verblijfsduur. Echte engines bevatten immers vaak interacties of beslisbomen, en mijn systeem moest dat eveneens kunnen. Vervolgens liet ik het de prijs bepalen voor één SKU, de Aura Wireless Earbuds, met een adviesprijs van 79.00 $, over alle 10.000 beslissingen.
De hoofdpaneelkaart op de console is het eerste wat op het scherm verschijnt voordat er iets draait. Twee cohorten, één product, afgestemde vraagsignalen. Besluitenset A is het cohort met hoge postcode-inkomens en een nieuw apparaat, 2.880 beslissingen, op de kaart vertegenwoordigd door een postcode uit de Upper East Side en een nieuwe iPhone: getoonde prijs 74.06 $. Besluitenset B is het cohort met een postcode met een overwegend minderheidsbevolking en een oud apparaat, 3.037 beslissingen, vertegenwoordigd door een postcode uit de South Bronx en een oude Android: 93.47 $. Gemeten variantie: +26.2 %. Dat zijn cohortgemiddelden over elk circa 3.000 beslissingen; dit toont het systematische gedrag van het beleid en niet de pech van één toevallige koper. De postcode en telefoon op elke kaart vormen het representatieve profiel van het cohort, niet de definitie ervan.
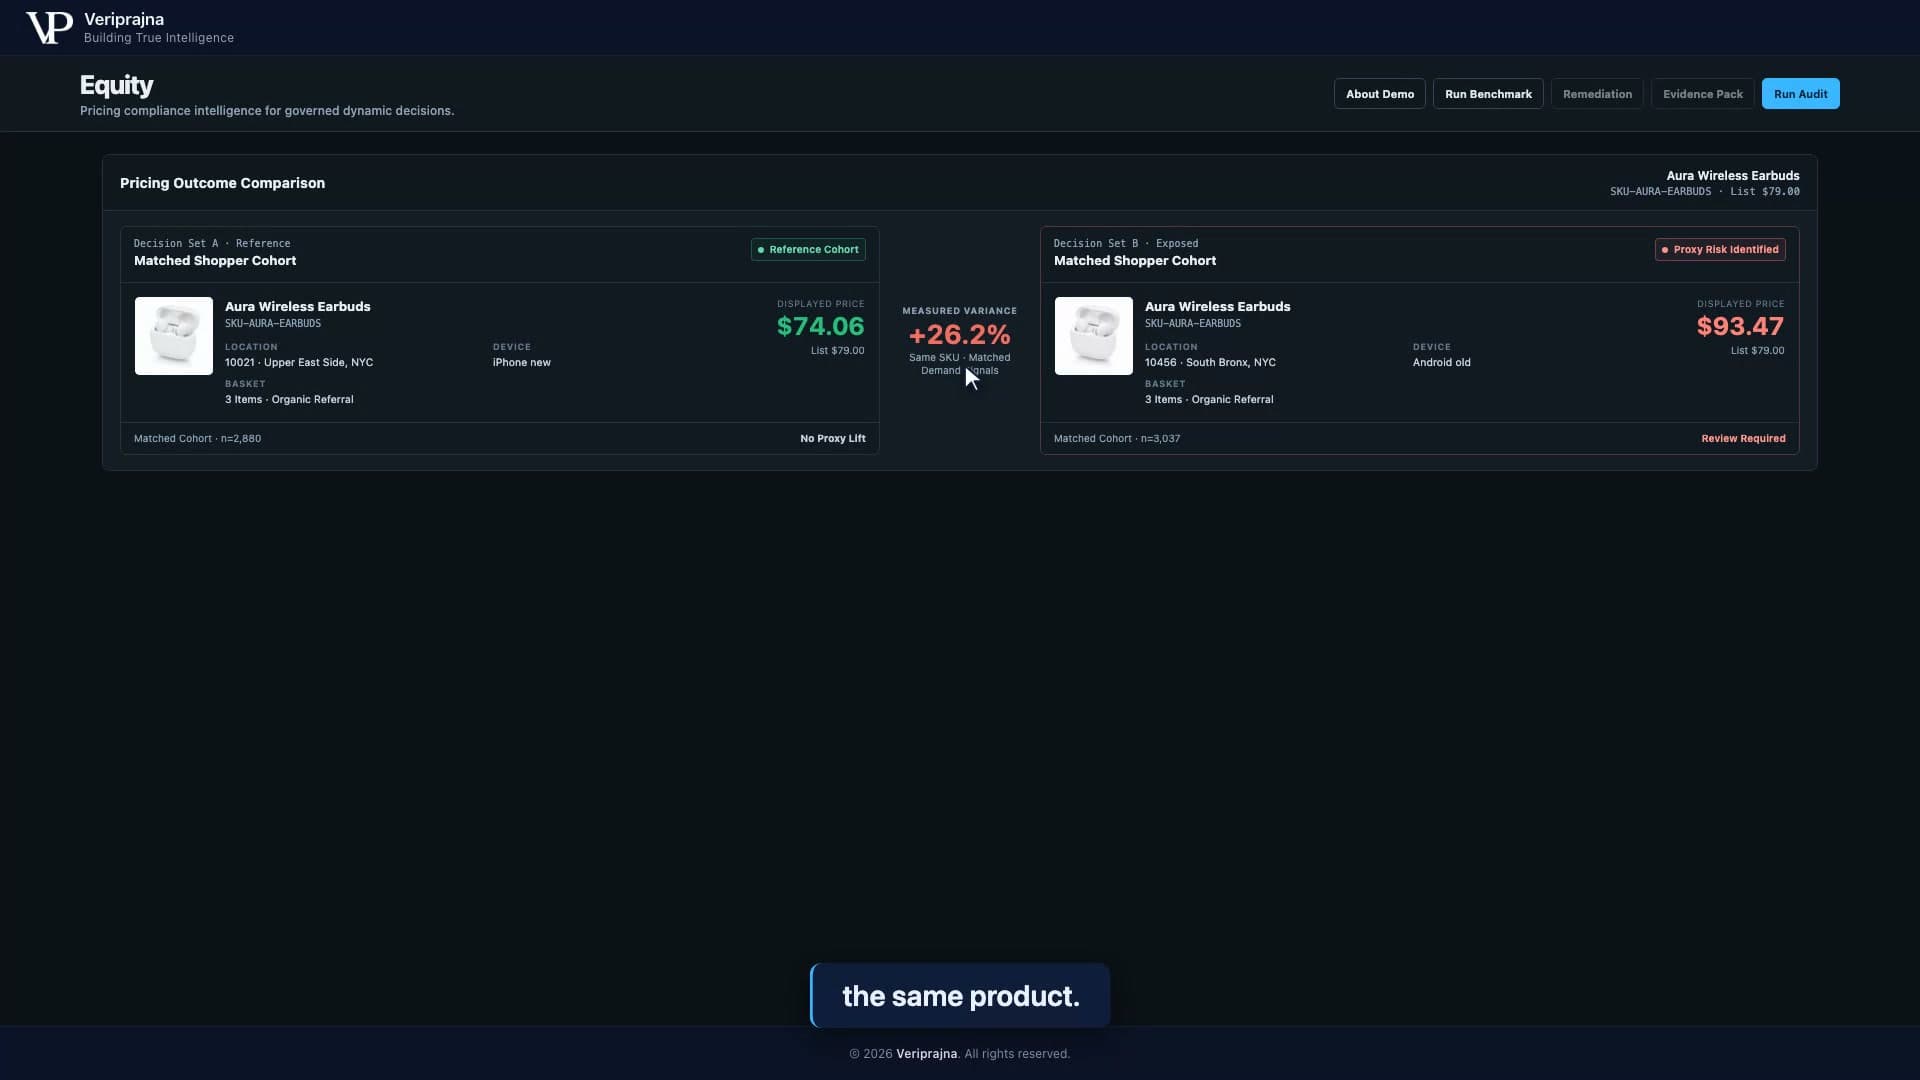
Wat mij verontrustte was dat ik niets had geschreven dat als een discriminerende regel kon worden aangemerkt. Ik bouwde een omzetmaximalisator en gaf die signalen mee die de betalingsbereidheid voorspellen. Postcode voorspelt inkomen, inkomen voorspelt prijsgevoeligheid, een oude Android voorspelt minder prijsvergelijking. Geen van die zaken is ras. Ze bewegen er echter allemaal mee mee, en een bandit die beloond wordt op omzet vindt ieder afzonderlijk signaal. Die 26 % is eenvoudigweg hoe omzetoptimalisatie eruitziet wanneer de signalen het cohort meedragen.
De proxy die schuilgaat tussen twee schone invoervariabelen
Ik ontwierp de audit om elke invoervariabele via drie methoden te beoordelen, omdat elke afzonderlijke test een blinde vlek had: absolute Pearson-correlatie met het beschermde cohort (een label dat de audit zelf nooit te zien krijgt), genormaliseerde wederzijdse informatie (NMI) en een contrafactuele prijs-replay. Bij die replay wordt die ene variabele voor het beschermde cohort overschreven met de referentiewaarde van het bevoordeelde cohort, blijven alle andere variabelen constant, draait het beleid van de engine opnieuw en meten we de prijsverandering. De replay is modelagnostisch: hij varieert de invoer en observeert de uitvoer, ongeacht of de engine een bandit, beslisboom of black box is.
De eerste twee rijen van de Input Audit-tabel zijn wat iedereen zou voorspellen. Postcode-inkomensindex: |r| 0.95, MI 1.00, contrafactueel +7.8 %, VIOLATION. De geografie codeert de beschermde klasse in deze populatie volledig en de engine baseert zijn tarieven daarop. Apparaatcategorie: 0.32, 0.08, +2.9 %, VIOLATION, een ogenschijnlijk neutraal signaal dat de drempels van 0.30 correlatie en 0.05 MI overschrijdt die ik in code had vastgelegd.
De derde VIOLATION is degene die een audit per individueel kenmerk niet kan detecteren. Herkomstkanaal afzonderlijk: |r| 0.00, MI 0.00, PASS. Verblijfsduur afzonderlijk: 0.17, 0.03, PASS. Een feature-voor-feature audit keurt beide goed en gaat door. De interactierij Herkomstkanaal × Verblijfsduur toont |r| 0.00, gezamenlijke MI van 0.73, contrafactueel +1.7 %, VIOLATION. Dat is een interactiewinst van 0.71 ten opzichte van de beste afzonderlijke component.
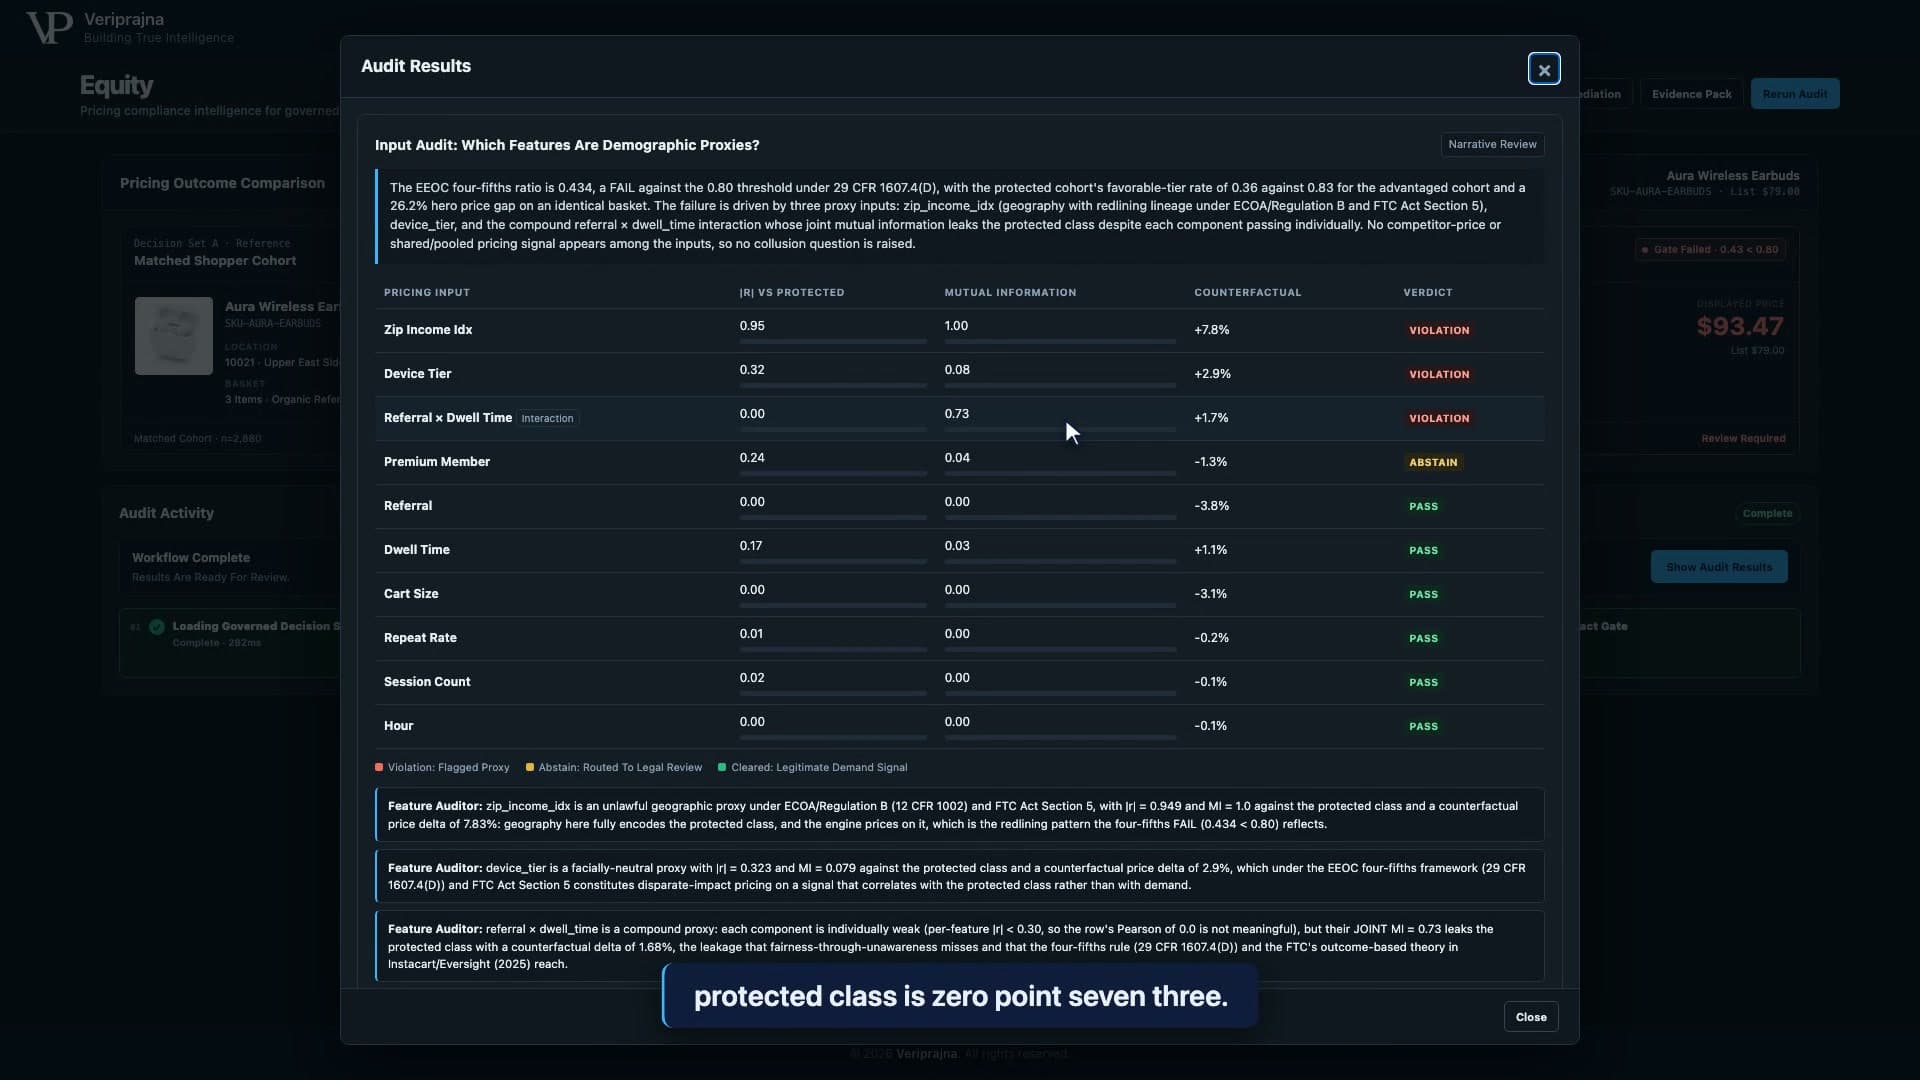
Ik had die structuur volgens een XOR-patroon aangebracht. Een organische herkomst met lange verblijfsduur markeert het beschermde cohort. Een vergelijkingsherkomst met korte verblijfsduur markeert dit eveneens. Organisch-kort en vergelijking-lang markeren het bevoordeelde cohort. Noch de herkomst noch de tijdsduur scheidt de groepen op zichzelf; het gecombineerde paar doet dat wel. Correlatie is een eendimensionaal instrument en kan dit niet zien. Wederzijdse informatie over het paar ziet dit wel. Een compliance-programma dat variabelen één voor één controleert auditeert het verkeerde object, en ik vond geen andere manier om dat te bewijzen dan door een populatie te bouwen waarin het stapsgewijze antwoord aantoonbaar onjuist is.
Het verweer dat ik vroeger zelf zou hebben aangedragen
Ik testte het verweer dat ik ooit zelf aan een toezichthouder zou hebben voorgelegd, namelijk fairness through unawareness: verwijder postcode en apparaat, train de engine opnieuw en rapporteer het resultaat. Ik wist dat de samengestelde proxy erin zat. Wat ik niet wist, was hoeveel van die 0.43 uitsluitend aan postcode en apparaat lag, en hoeveel aan het verborgen paar. Het weglaten van postcode en apparaat en opnieuw trainen verschoof de vier-vijfden-ratio van 0.43 naar 0.59. Nog steeds gezakt, en het resterende verschil is precies het deel dat elke controle per losse variabele overleeft. De benchmarkkaart noemt de oorzaak in vier woorden: Compound Proxy Still Leaks.
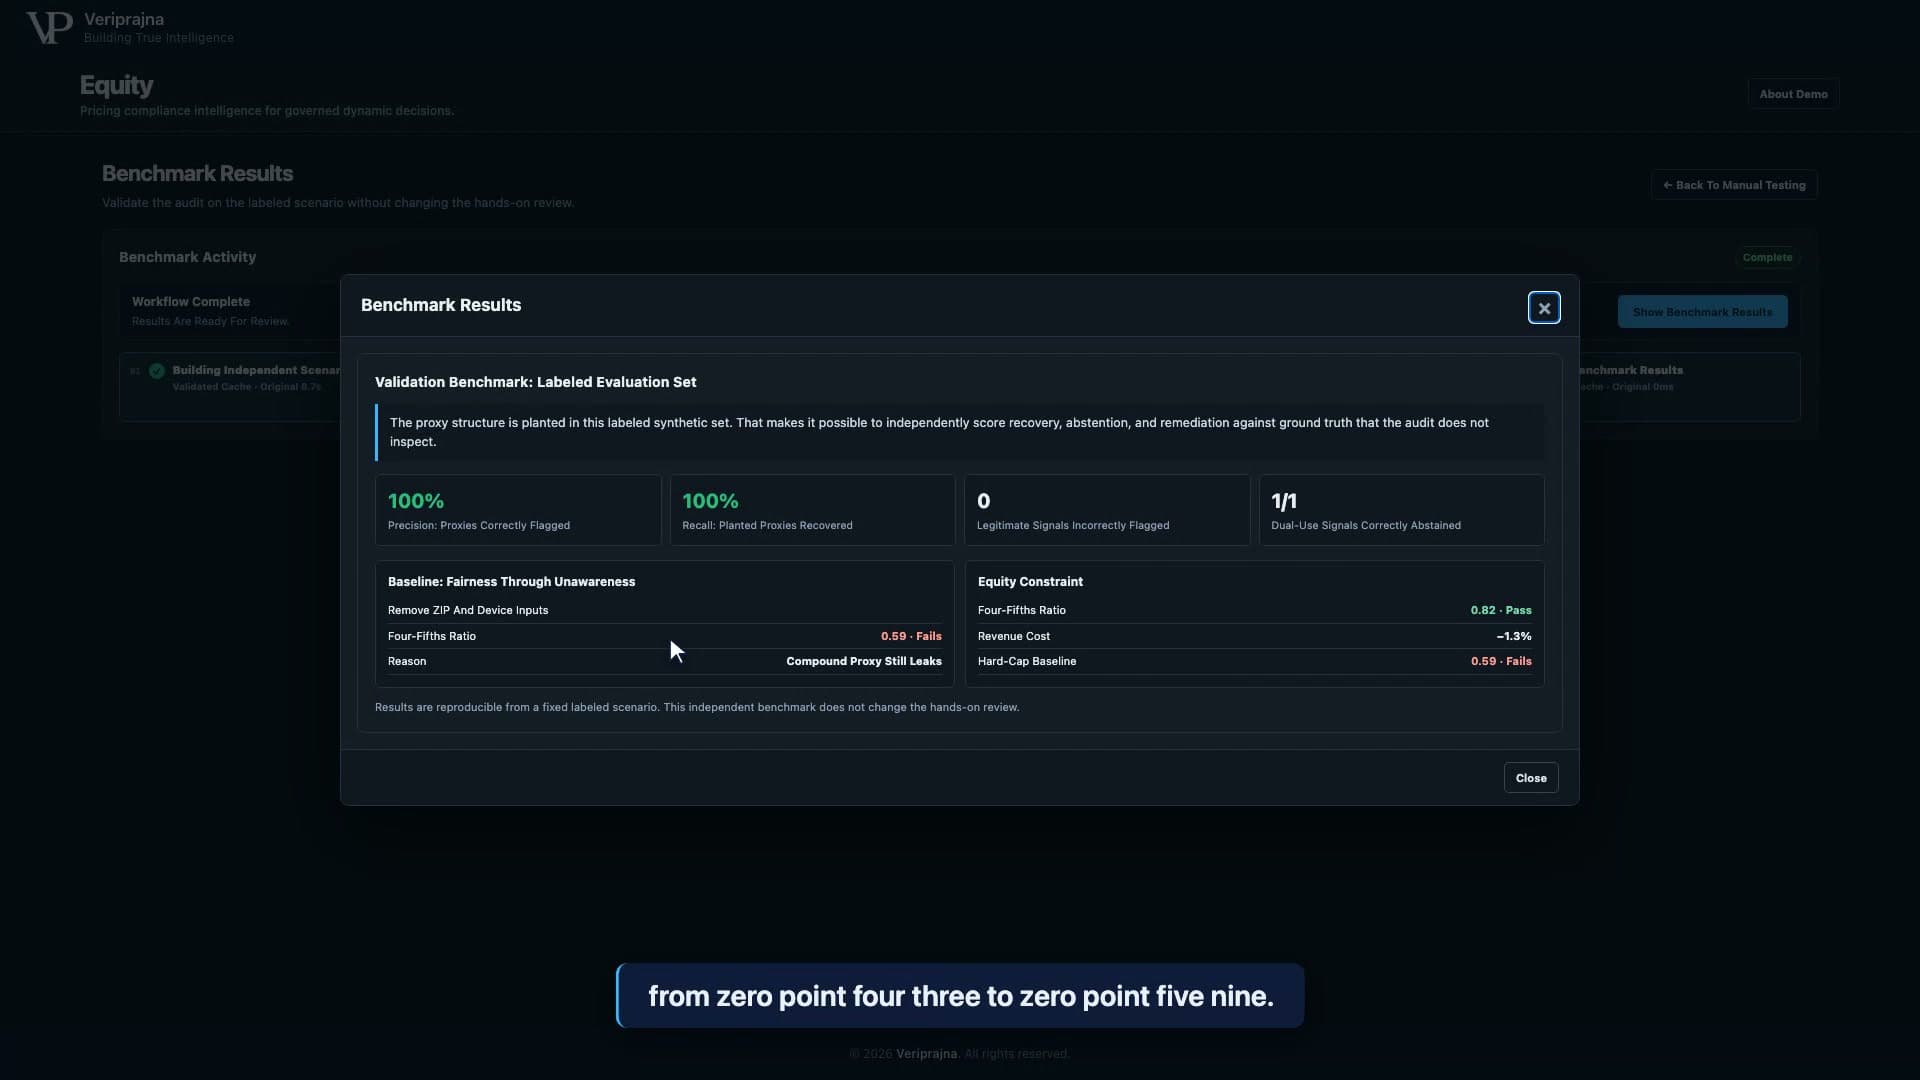
Die uitkomst veranderde mijn kijk op die zin. De engine vond het cohort immers alsnog, via twee signalen die elke één-kolomscontrole doorstaan, en hij zal het blijven vinden – want dat vinden is precies waarvoor een omzetmaximalisator wordt beloond. De unawareness-aanname kost het team niets om te beweren, maar levert een getal op dat ze later voor de rechter moeten uitleggen.
De 100 % op die kaart heeft een afgebakende betekenis. De benchmark herbouwt dezelfde populatie met seed 42 en toetst de audit aan de geplaatste labels; precisie en recall van 100 % betekenen 3 van de 3 geplaatste proxies herkend met 0 valse meldingen op die gelabelde synthetische set. Het is een interne verificatie tegen een bekende ground truth, die ik niet als accuraatheidscijfer zou aanhalen op echte verkoopdata van een bedrijf, vol verstorende variabelen die je niet kunt simuleren.
Wat 0.43 betekent en waarom ik geen model daarover liet beslissen
Ik weigerde een eigen fairness-getal te verzinnen, want een zelfbedacht getal hoeft een toezichthouder niet serieus te nemen. De drempelwaarde in Equity is een externe juridische standaard: de vier-vijfden-regel van de EEOC, 29 CFR 1607.4(D), vertaald van selectiepercentages naar prijsklassen. Gunstig betekent hier: niet de hoogste prijsklasse toegewezen krijgen. In de operationele engine krijgt 36 % van het beschermde cohort de gunstige prijsklasse tegenover 83 % van het bevoordeelde cohort. 0.36 gedeeld door 0.83 is 0.43, de wettelijke norm is 0.80, en de meter staat in het rood op Fail. Daarnaast: 64 % van het beschermde cohort in de hoogste prijsklasse en een gemiddelde opslag van +15.6 % ten opzichte van het bevoordeelde cohort.
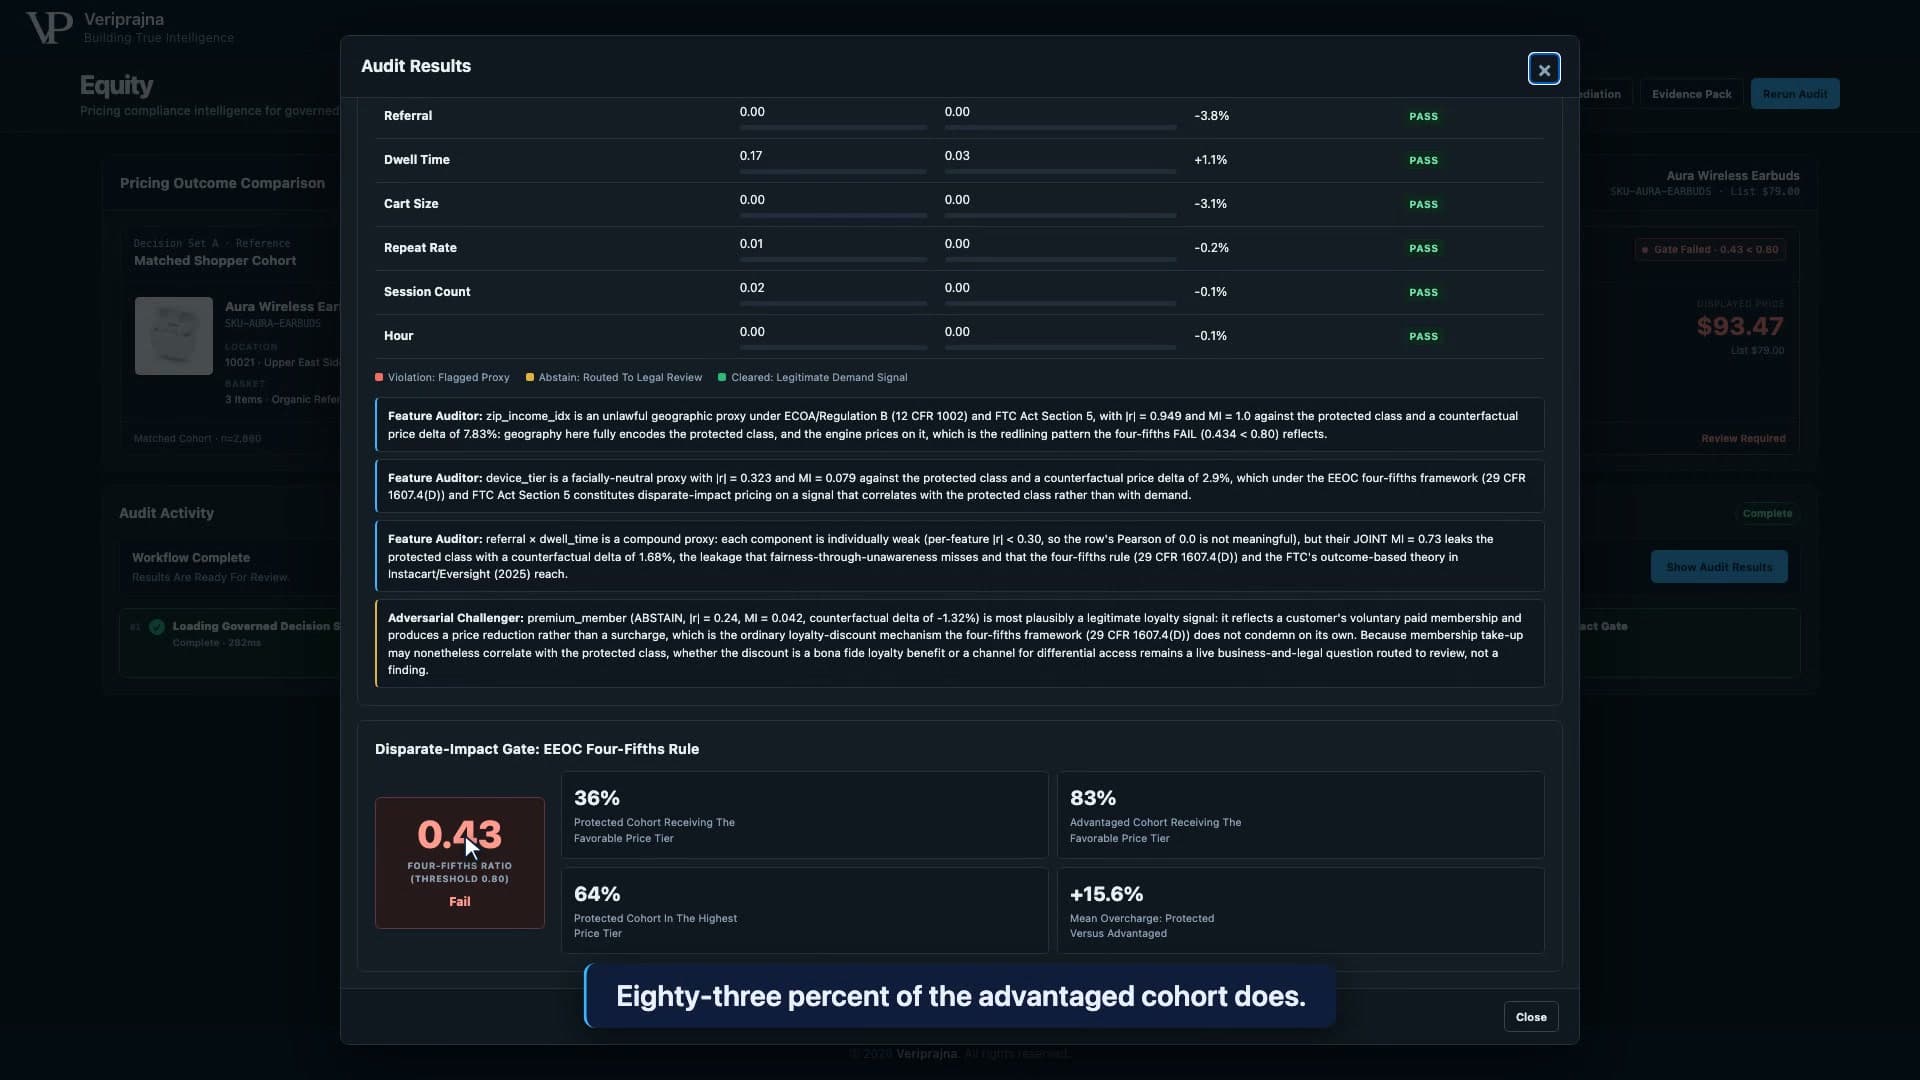
De beslislogica draait in pure NumPy, buiten de agent-laag, in een vaste volgorde die ik aan een rechter kan toelichten. Het dual-use-signaal wordt vóór de overtredingstest getoetst: Premium-lid correleert voor 0.24 met het beschermde cohort en is tegelijkertijd een legitiem loyaliteitssignaal. De code retourneert daarom ABSTAIN en verwijst dit naar juridische toetsing in plaats van het direct te beboeten of vrij te pleiten, en geen enkel vervolgproces mag dit eigenhandig tot overtreding promoveren. Daarna volgen de overtredingsdrempels, het onthoudingsbereik en tenslotte PASS. Winkelmandgrootte, herhaalaankoop, sessietelling en uur slagen allemaal. De audit keurt niet blindelings alles af, en een audit die overal over valt is even waardeloos bij een gerechtelijk informatieverzoek (Civil Investigative Demand) als eentje die niets opmerkt.
De agents in het team – een Feature Auditor en een Adversarial Challenger – formuleren argumenten; de derde rol in het ontwerp, de Regulatory Mapper, is in deze versie een vaste opzoektabel in plaats van een model. De taak van de Challenger is om het loyaliteitsvoordeel van de variabele Premium-lid maximaal te verdedigen, wat op het scherm ook gebeurt. Hij kan echter die 0.24 niet aanpassen, geen verdict wijzigen en niet bepalen of 0.43 onder 0.80 ligt. Die scheiding stond vanaf het begin vast: agents adviseren, code beslist, en het model mag zo overtuigend zijn als het wil over cijfers waar het niet aan mag komen.
De oplossing waarvan ik hoopte dat hij zou werken
De eerste ingreep die ik testte was een prijsplafond, omdat elk prijzen-team daar automatisch naar grijpt: vraag nooit meer dan 15 % boven de billijke referentieprijs. Ik bouwde dit als de Hard-Cap Baseline en verwachtte dat dit de nuchtere, toereikende oplossing zou zijn. Het kostte 0.2 % aan omzet en faalde bij de controle met 0.59. Het ontwijkingspatroon op de kaart maakt direct duidelijk waarom: 29 % van het beschermde cohort kreeg een prijs binnen 1 % van het plafond. Het oordeel luidt Gamed To The Boundary. Het plafond is goedkoop precies omdat de engine het benadeelde cohort net onder de grens herprijsde – en goedkoop-en-afgekeurd is een combinatie die aantrekkelijk oogt in een budgetvergadering maar sneuvelt bij de openbaarmaking van bewijsmateriaal.
Een omzetmaximalisator behandelt een plafond als een streefdoel.
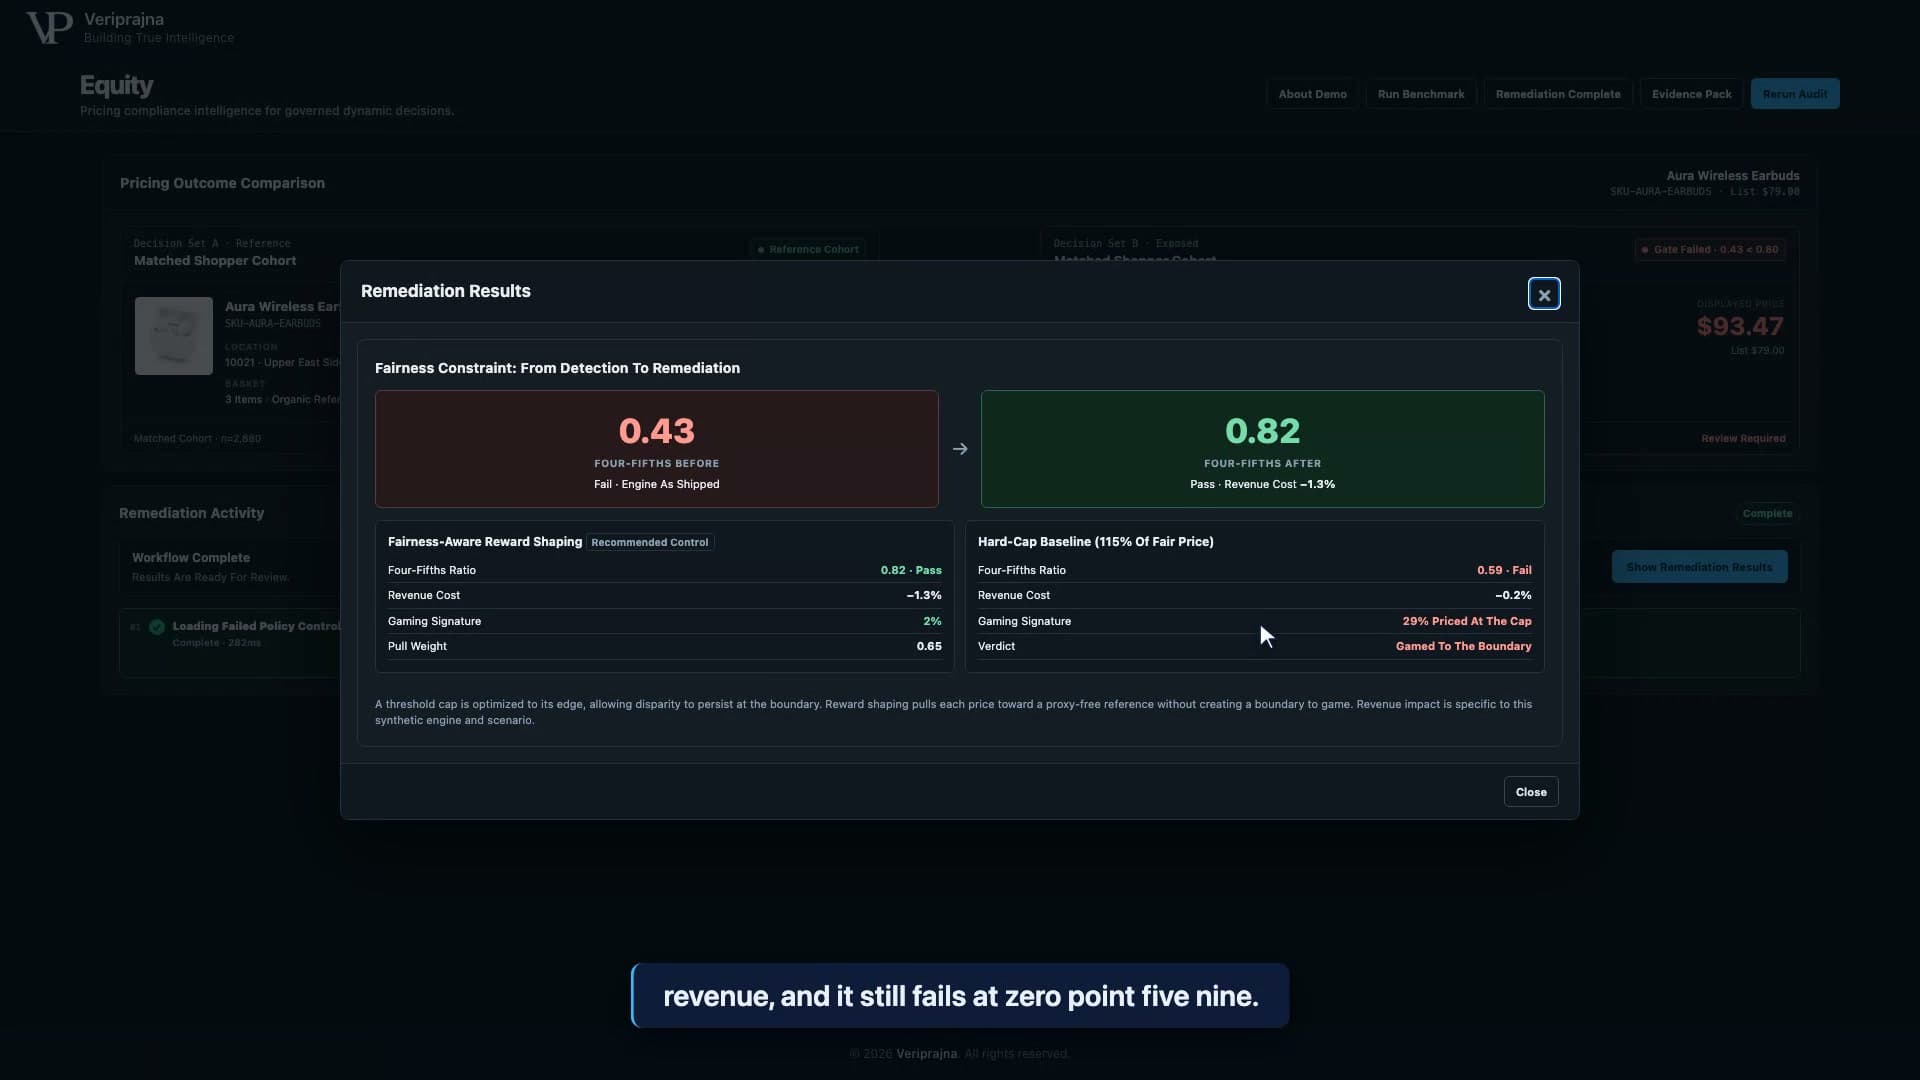
Het mechanisme dat standhield is Fairness-Aware Reward Shaping. In plaats van een rigide grens trekt het elke prijs continu naar een proxy-vrije referentieprijs – een tweede bandit die getraind is zonder de proxies maar met alle legitieme signalen – en zoekt binair het kleinste gewicht dat boven 0.80 uitkomt. Bij deze engine is dat gewicht 0.65; één stap lager, op 0.625, werd slechts 0.778 bereikt. Vier-vijfden-waarde na herstel: 0.82, Pass. Omzetkosten: 1.3 %. Ontwijkingssignatuur 2 %, want er is geen harde rand om te manipuleren. De kleine lettertjes op de console benadrukken dat de omzetimpact specifiek is voor deze synthetische engine, en ik herhaal dat met klem: 1.3 % is een meting op een testpopulatie, geen universele vaste prijs voor billijkheid.
Waar het dossier voor dient
Ik bouwde het bewijsdossier als laatste, want alles ervoor heeft alleen waarde als een jurist het kan indienen. Wanneer er een gerechtelijk informatieverzoek (CID) binnenkomt, besteedt het bedrijf dat de juiste gegevens niet vastlegde maanden aan forensische data-extractie. Equity verzegelt de auditresultaten in een JSON-pakket met afdrukbare HTML-versie: enginenaam en versie, de 10.000 geauditeerde beslissingen, de wettelijke norm, de representatieve dispariteit, de bevinding en motivatie van elke variabele, het herstelresultaat en een cryptografische SHA-256-hash van het dossier als garantie tegen manipulatie. Elke VIOLATION is gekoppeld aan vijf wetgevingskaders: de EEOC-vier-vijfden-regel, de New York Algorithmic Pricing Disclosure Act (in werking op 10 november 2025, civiele boete tot 1.000 $ per overtreding), de Colorado AI Act (SB 24-205, van kracht op 30 juni 2026), de EU AI Act artikelen 13 en 14 (hoog-risicoverplichtingen vanaf 2 augustus 2026) en FTC Act Section 5. De gereserveerde invoer linkt naar één juridische beoordelingslijn.
De regelgevingskoppeling is een vaste tabel. Het was eenvoudig geweest om die door een model te laten schrijven, maar ik zag daar bewust van af: elke VIOLATION krijgt exact dezelfde vijf juridische regels, de onthouding krijgt haar toetsingsregel en er wordt geen proza voor de koppeling gegenereerd. Een model dat redeneert over wetsartikelen redeneert bij de volgende release anders – en een dossier waarvan de juridische kwalificatie meebeweegt met het model is een dossier dat een toezichthouder zo onderuithaalt. De samenvattingen in het dossier worden gegenereerd door het model en gecachet; cijfers, oordelen en juridische koppelingen komen uit deterministische code. Het dossier blijft rechtsgeldig, ongeacht welk model eronder draait. De volledige toelichting, inclusief inspectie van het dossier op het scherm, staat op veriprajna.com/demos/ai-pricing-compliance.
Veriprajna bepaalt geen prijzen, vervangt noch Pricefx, PROS, Zilliant noch Competera, en velt geen juridisch vonnis. De engine van de klant blijft de prijzen bepalen. Ik lever het objectieve bewijsmateriaal; hun juridische team neemt het besluit.
En als u de auditrun liever in actie ziet dan dat u mijn beschrijving leest: hier is het complete systeem van begin tot eind.
Ik blijf terugkomen op die zin van het prijzen-team, want hij klopt feitelijk: ras en inkomen zitten niet in het model. In de engine die ik bouwde, staat die waarachtige zin echter naast een prijsverschil van 26 % op dezelfde oordopjes, een billijkheidsscore van 0.43 en een plafond dat faalde terwijl het leek te werken. Niemand vertelde de engine wie de koper was. Een omzetbeloning volstond, omdat het raden van het profiel van de koper de meest winstgevende schatting was – en de audit mat exact hoe ver dat ging. De zin die standhoudt in de rechtszaal is een veel veeleisendere: we wisten dat de engine het cohort zonder instructies kon afleiden, we hebben gemeten hoe ver hij ging, en dit waren de kosten om hem te corrigeren.